Gemini 1.5 Pro 是 Gemini 家族的一次重要升级。它引入了长上下文推理能力,使我们能够在多种模态(文本、视频和音频)中处理海量数据集。
在本教程中,我们将学习如何连接到 Gemini 1.5 Pro API。我们将学习执行诸如检索、长文档与视频问答、长上下文自动语音识别(ASR)以及上下文内学习等任务。
如果您想进一步了解 Gemini,请查看这篇文章:What is Google Gemini 。
Gemini 家族
Gemini AI 包含由 Google 多个团队(包括 Google Research 和 Google DeepMind)协作开发的一系列生成式 AI 模型。
这些模型具备强大的通用多模态任务能力,旨在帮助开发者进行内容生成和问题求解。每个模型变体都针对特定用例进行优化,确保在多样化场景中实现最佳表现。
Gemini AI 通过提供三种模型大小,在计算资源与功能性之间取得平衡:
Model
Size
Capabilities
Ideal Use Cases
Gemini Ultra
Largest
最强大,可处理高度复杂的任务
高要求应用、大型项目、复杂问题求解
Gemini Pro
Medium
多才多艺,适用于广泛任务,具备可扩展性
通用型应用,适配多样场景,需要在性能与效率间平衡的项目
Gemini Nano
Smallest
轻量高效,面向设备端与资源受限环境优化
移动应用、嵌入式系统、计算资源有限的任务、实时处理
pen_spark
我们的主要关注点将是 Gemini 1.5 系列中首个发布的模型——Gemini 1.5 Pro。
Gemini 1.5 Pro 的能力
Gemini 1.5 Pro 拥有高达至少 1000 万个 token 的超大上下文窗口,能够在真实世界的广泛应用场景中应对理解长上下文的挑战。
针对长依赖任务已进行了全面评估,以彻底检验 Gemini 1.5 Pro 的长上下文能力。Gemini 1.5 Pro 出色完成了具有挑战性的“针落草堆”任务,即便在跨越所有模态(涵盖文本、视频和音频)、规模达数百万 token 的“草堆”中,也能实现对“针”的近乎完美(>99%)召回。
即便在文本模态中“草堆”规模达到 1000 万个 token,这一召回表现也得以显著保持。
在需要理解跨越整段长内容、分散在多条证据之间相互依赖的任务(如长依赖问答 QA 实例)上,Gemini 1.5 Pro 超越了所有竞品模型,包括那些结合了外部检索方法的模型。
借助极长文本,Gemini 1.5 Pro 还展现了出色的上下文内学习能力,例如仅凭一份语言学文档就能学习将一种新语言进行翻译。
值得注意的是,Gemini 1.5 Pro 在长上下文性能上的进步并未牺牲其基础的多模态能力。与前代(1.0 Pro)相比,它在多个领域都有显著提升(数学、科学与推理等方面提升 +28.9%)。
它甚至在超过一半的基准上超越了顶级的 1.0 Ultra 模型,尤其在文本与视觉任务上表现突出(如下表所示)。同时,它所需资源更少,计算效率更高。
数据来源 。
如需更详细的洞见,建议查阅技术报告:“Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context ”。
Gemini 1.5 Pro 的应用
凭借处理数百万 token 的能力,新的实用型应用应运而生。
Gemini 1.5 Pro 可广泛用于软件工程 。在将整个 746,152 个 token 的 JAX 代码库置于上下文中时,Gemini 1.5 Pro 能定位到核心自动微分方法的具体位置。
在具备一本参考语法书和一份双语词表(合计约 25 万)的条件下,Gemini 1.5 Pro 能将英语翻译 成 Kalamang,其质量可与使用相同资源学习过的人工水平相当。
由于 Kalamang 的在线数据稀缺(使用者不足 200 人),Gemini 1.5 Pro 被迫完全依赖每个提示中提供的上下文来理解并翻译该语言。这一发现表明,具备扩展上下文能力的 LLM 在保护与复兴濒危语言、以及促进不同语言社群之间的沟通与理解方面具有可期的前景。
在提供整本《悲惨世界》全文(1382 页,73.2 万个 token)的前提下,Gemini 1.5 Pro 也能回答与图像 相关的查询。作为原生多模态模型,它能够根据手绘草图识别出一幕著名场景。
在提供一部 45 分钟的无声电影 《福尔摩斯二世》(以 1FPS 抽帧共 2,674 帧,68.4 万个 token)时,Gemini 1.5 Pro 能检索并从特定帧中提取文本信息,并给出相应时间戳。该模型也能根据手绘草图在影片中定位相应场景。
Gemini 1.5 Pro API:如何使用
了解了 Gemini 1.5 Pro 的能力与应用后,下面来学习如何连接到它的 API。
步骤 1:生成 API 密钥
首先,需要在 Google AI for Developers 页面获取 API 密钥(请确保您已登录 Google 账号)。点击 Get an API key 按钮即可:
接下来,需要创建项目并生成 API 密钥。
步骤 2:在 Python 中引入 API 库
我们先使用 pip 安装 Gemini 的 Python API 包。
% pip install google- generativeai技术支持 然后,启动 Jupyter notebook 并导入项目所需的核心 Python 库。
import google. generativeai as genai
from google. generativeai. types import ContentType
from PIL import Image
from IPython. display import Markdown
import time
import cv2技术支持 步骤 3:发起一次 API 调用
先将 API 密钥填入 GOOGLE_API_KEY 变量,并进行配置:
GOOGLE_API_KEY = ‘your- api- key- goes- here’
genai. configure( api_key= GOOGLE_API_KEY) 技术支持 在调用 API 之前,先通过免费 API 查看可用的模型。
for m in genai. list_models( ) :
if 'generateContent' in m. supported_generation_methods:
print ( m. name) 技术支持 models/gemini-1.0-pro
models/gemini-1.0-pro-001
models/gemini-1.0-pro-latest
models/gemini-1.0-pro-vision-latest
models/gemini-1.5-flash-latest
models/gemini-1.5-pro-latest
models/gemini-pro
models/gemini-pro-vision技术支持 让我们访问 gemini-1.5-pro-latest 模型:
model = genai. GenerativeModel( 'gemini-1.5-pro-latest' ) 技术支持 现在发起第一次 API 调用并向 Gemini 1.5 Pro 提示!
response = model. generate_content( "Please provide a list of the most influential people in the world." )
print ( response. text) 技术支持
只需几行代码,模型就给出了清晰而详细的回应。
Gemini AI 可以为一个提示生成多个称为候选项的响应,方便您选择最合适的一条。
Gemini 1.5 Pro API:图像提示
本节将学习如何借助 Gemini 1.5 Pro 自动从一张图片中提取书籍清单!
先来看这张图片:
一个摆放着多本书的书架图像。
我们先指示模型按照特定顺序识别并列出图中的书名:
text_prompt = "List all the books and help me organize them into three categories." 技术支持 接下来,使用 Image 类打开我们的 "bookshelf.jpeg" 图片,准备供模型分析。
bookshelf_image = Image. open ( 'bookshelf.jpeg' ) 技术支持 将 text_prompt 和 bookshelf_image 一并放入列表并提示模型:
prompt = [ text_prompt, bookshelf_image]
response = model. generate_content( prompt) 技术支持 为避免输出为 Markdown 格式,我们使用 IPython 的 Markdown 工具。
Markdown( response. text) 技术支持
模型已成功将上传图像中的所有书籍分成三个不同的类别。
结语
在本教程中,我们介绍了 Gemini 1.5 家族的首个发布版本——Gemini 1.5 Pro。除了多模态能力与高效率外,Gemini 1.5 Pro 还将内容窗口相较 Gemini 1.0 系列从 32k 扩展到数百万个 token。
无论是文本、图像、视频还是音频,Gemini 1.5 Pro API 都能灵活应对多种应用,从信息检索与问答到内容生成与翻译。
如果您想更多了解 AI,请查看包含六门课程的 AI Fundamentals 技能路径。


Gemini 1.5 Pro 是 Gemini 家族的一次重要升级。它引入了长上下文推理能力,使我们能够在多种模态(文本、视频和音频)中处理海量数据集。
在本教程中,我们将学习如何连接到 Gemini 1.5 Pro API。我们将学习执行诸如检索、长文档与视频问答、长上下文自动语音识别(ASR)以及上下文内学习等任务。
如果您想进一步了解 Gemini,请查看这篇文章:What is Google Gemini。
Gemini 家族
Gemini AI 包含由 Google 多个团队(包括 Google Research 和 Google DeepMind)协作开发的一系列生成式 AI 模型。
这些模型具备强大的通用多模态任务能力,旨在帮助开发者进行内容生成和问题求解。每个模型变体都针对特定用例进行优化,确保在多样化场景中实现最佳表现。
Gemini AI 通过提供三种模型大小,在计算资源与功能性之间取得平衡:
Model
Size
Capabilities
Ideal Use Cases
Gemini Ultra
Largest
最强大,可处理高度复杂的任务
高要求应用、大型项目、复杂问题求解
Gemini Pro
Medium
多才多艺,适用于广泛任务,具备可扩展性
通用型应用,适配多样场景,需要在性能与效率间平衡的项目
Gemini Nano
Smallest
轻量高效,面向设备端与资源受限环境优化
移动应用、嵌入式系统、计算资源有限的任务、实时处理
pen_spark
我们的主要关注点将是 Gemini 1.5 系列中首个发布的模型——Gemini 1.5 Pro。
Gemini 1.5 Pro 的能力
Gemini 1.5 Pro 拥有高达至少 1000 万个 token 的超大上下文窗口,能够在真实世界的广泛应用场景中应对理解长上下文的挑战。
针对长依赖任务已进行了全面评估,以彻底检验 Gemini 1.5 Pro 的长上下文能力。Gemini 1.5 Pro 出色完成了具有挑战性的“针落草堆”任务,即便在跨越所有模态(涵盖文本、视频和音频)、规模达数百万 token 的“草堆”中,也能实现对“针”的近乎完美(>99%)召回。
即便在文本模态中“草堆”规模达到 1000 万个 token,这一召回表现也得以显著保持。
在需要理解跨越整段长内容、分散在多条证据之间相互依赖的任务(如长依赖问答 QA 实例)上,Gemini 1.5 Pro 超越了所有竞品模型,包括那些结合了外部检索方法的模型。
借助极长文本,Gemini 1.5 Pro 还展现了出色的上下文内学习能力,例如仅凭一份语言学文档就能学习将一种新语言进行翻译。
值得注意的是,Gemini 1.5 Pro 在长上下文性能上的进步并未牺牲其基础的多模态能力。与前代(1.0 Pro)相比,它在多个领域都有显著提升(数学、科学与推理等方面提升 +28.9%)。
它甚至在超过一半的基准上超越了顶级的 1.0 Ultra 模型,尤其在文本与视觉任务上表现突出(如下表所示)。同时,它所需资源更少,计算效率更高。
如需更详细的洞见,建议查阅技术报告:“Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context”。
Gemini 1.5 Pro 的应用
凭借处理数百万 token 的能力,新的实用型应用应运而生。
Gemini 1.5 Pro 可广泛用于软件工程。在将整个 746,152 个 token 的 JAX 代码库置于上下文中时,Gemini 1.5 Pro 能定位到核心自动微分方法的具体位置。
在具备一本参考语法书和一份双语词表(合计约 25 万)的条件下,Gemini 1.5 Pro 能将英语翻译成 Kalamang,其质量可与使用相同资源学习过的人工水平相当。
由于 Kalamang 的在线数据稀缺(使用者不足 200 人),Gemini 1.5 Pro 被迫完全依赖每个提示中提供的上下文来理解并翻译该语言。这一发现表明,具备扩展上下文能力的 LLM 在保护与复兴濒危语言、以及促进不同语言社群之间的沟通与理解方面具有可期的前景。
在提供整本《悲惨世界》全文(1382 页,73.2 万个 token)的前提下,Gemini 1.5 Pro 也能回答与图像相关的查询。作为原生多模态模型,它能够根据手绘草图识别出一幕著名场景。
在提供一部 45 分钟的无声电影《福尔摩斯二世》(以 1FPS 抽帧共 2,674 帧,68.4 万个 token)时,Gemini 1.5 Pro 能检索并从特定帧中提取文本信息,并给出相应时间戳。该模型也能根据手绘草图在影片中定位相应场景。
Gemini 1.5 Pro API:如何使用
了解了 Gemini 1.5 Pro 的能力与应用后,下面来学习如何连接到它的 API。
步骤 1:生成 API 密钥
首先,需要在 Google AI for Developers 页面获取 API 密钥(请确保您已登录 Google 账号)。点击 Get an API key 按钮即可:
接下来,需要创建项目并生成 API 密钥。
步骤 2:在 Python 中引入 API 库
我们先使用
pip安装 Gemini 的 Python API 包。然后,启动 Jupyter notebook 并导入项目所需的核心 Python 库。
步骤 3:发起一次 API 调用
先将 API 密钥填入 GOOGLE_API_KEY 变量,并进行配置:
在调用 API 之前,先通过免费 API 查看可用的模型。
让我们访问
gemini-1.5-pro-latest模型:现在发起第一次 API 调用并向 Gemini 1.5 Pro 提示!
只需几行代码,模型就给出了清晰而详细的回应。
Gemini AI 可以为一个提示生成多个称为候选项的响应,方便您选择最合适的一条。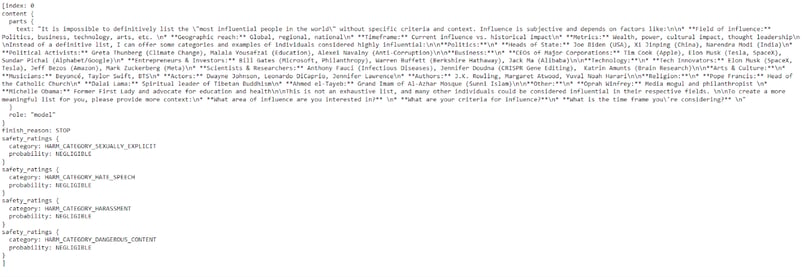
Gemini 1.5 Pro API:图像提示
本节将学习如何借助 Gemini 1.5 Pro 自动从一张图片中提取书籍清单!
先来看这张图片:
一个摆放着多本书的书架图像。
我们先指示模型按照特定顺序识别并列出图中的书名:
接下来,使用
Image类打开我们的 "bookshelf.jpeg" 图片,准备供模型分析。将
text_prompt和bookshelf_image一并放入列表并提示模型:为避免输出为 Markdown 格式,我们使用 IPython 的 Markdown 工具。
模型已成功将上传图像中的所有书籍分成三个不同的类别。
结语
在本教程中,我们介绍了 Gemini 1.5 家族的首个发布版本——Gemini 1.5 Pro。除了多模态能力与高效率外,Gemini 1.5 Pro 还将内容窗口相较 Gemini 1.0 系列从 32k 扩展到数百万个 token。
无论是文本、图像、视频还是音频,Gemini 1.5 Pro API 都能灵活应对多种应用,从信息检索与问答到内容生成与翻译。
如果您想更多了解 AI,请查看包含六门课程的 AI Fundamentals 技能路径。