Lộ trình
Cơ bản về Trí tuệ Nhân tạo
10 giờ
Gemini 1.5 Pro là một bước tiến đáng kể trong họ Gemini. Phiên bản này giới thiệu khả năng suy luận theo ngữ cảnh dài, cho phép chúng ta làm việc với các tập dữ liệu khổng lồ trên nhiều phương thức (văn bản, video và âm thanh).
Trong hướng dẫn này, chúng ta sẽ học cách kết nối với API Gemini 1.5 Pro. Chúng ta sẽ thực hành các tác vụ như truy xuất, hỏi đáp với tài liệu và video dài, nhận dạng giọng nói tự động (ASR) cho ngữ cảnh dài, và học trong ngữ cảnh.
Nếu bạn muốn tìm hiểu thêm về Gemini, hãy xem bài viết này: Google Gemini là gì.
Gemini AI bao gồm một loạt các mô hình AI sinh tổng hợp được phát triển chung bởi nhiều nhóm trong Google, bao gồm Google Research và Google DeepMind.
Các mô hình này, với năng lực mạnh cho các tác vụ đa phương thức đa dụng, được thiết kế để hỗ trợ nhà phát triển trong việc tạo nội dung và giải quyết vấn đề. Mỗi biến thể mô hình được tối ưu cho các trường hợp sử dụng cụ thể, đảm bảo hiệu năng tối ưu trên nhiều kịch bản.
Gemini AI cân bằng giữa tài nguyên tính toán và chức năng bằng cách cung cấp ba kích thước mô hình:
|
Mô hình |
Kích thước |
Khả năng |
Trường hợp sử dụng lý tưởng |
|
Gemini Ultra |
Lớn nhất |
Mạnh nhất, xử lý các tác vụ cực kỳ phức tạp |
Ứng dụng yêu cầu cao, dự án quy mô lớn, giải quyết vấn đề phức tạp |
|
Gemini Pro |
Trung bình |
Linh hoạt, phù hợp cho dải tác vụ rộng, có khả năng mở rộng |
Ứng dụng đa dụng, thích ứng với nhiều kịch bản, dự án cần cân bằng giữa sức mạnh và hiệu suất |
|
Gemini Nano |
Nhỏ nhất |
Gọn nhẹ và hiệu quả, tối ưu cho thiết bị cục bộ và môi trường hạn chế tài nguyên |
Ứng dụng di động, hệ thống nhúng, tác vụ với tài nguyên tính toán hạn chế, xử lý thời gian thực pen_spark |
Trọng tâm chính của chúng ta sẽ là Gemini 1.5 Pro, mô hình đầu tiên phát hành trong dòng Gemini 1.5.
Gemini 1.5 Pro, với cửa sổ ngữ cảnh lớn lên đến ít nhất 10 triệu token, có thể giải quyết thách thức hiểu ngữ cảnh dài trên một loạt ứng dụng trong các kịch bản thực tế.
Một đánh giá toàn diện về các tác vụ phụ thuộc dài đã được thực hiện để đánh giá kỹ lưỡng khả năng xử lý ngữ cảnh dài của mô hình Gemini 1.5 Pro. Mô hình Gemini 1.5 Pro đã xử lý khéo léo bài toán khó "kim trong đống rơm", đạt độ truy hồi gần như hoàn hảo (>99%) đối với "kim" ngay cả khi đống rơm trải dài hàng triệu token trên mọi phương thức, bao gồm văn bản, video và âm thanh.
Hiệu suất truy hồi này vẫn được duy trì đáng chú ý ngay cả với kích thước đống rơm đạt 10 triệu token trong phương thức văn bản.
Mô hình Gemini 1.5 Pro vượt qua tất cả các mô hình cạnh tranh, bao gồm cả những mô hình được tăng cường bằng phương pháp truy xuất bên ngoài, đặc biệt ở các tác vụ đòi hỏi hiểu sự phụ thuộc qua nhiều bằng chứng trải rộng khắp toàn bộ nội dung dài, như các trường hợp Hỏi-Đáp (QA) phụ thuộc dài.
Gemini 1.5 Pro cũng cho thấy khả năng đáng chú ý, được kích hoạt bởi văn bản rất dài, để học các tác vụ trong ngữ cảnh, chẳng hạn như dịch một ngôn ngữ mới chỉ từ một bộ tài liệu ngôn ngữ duy nhất.
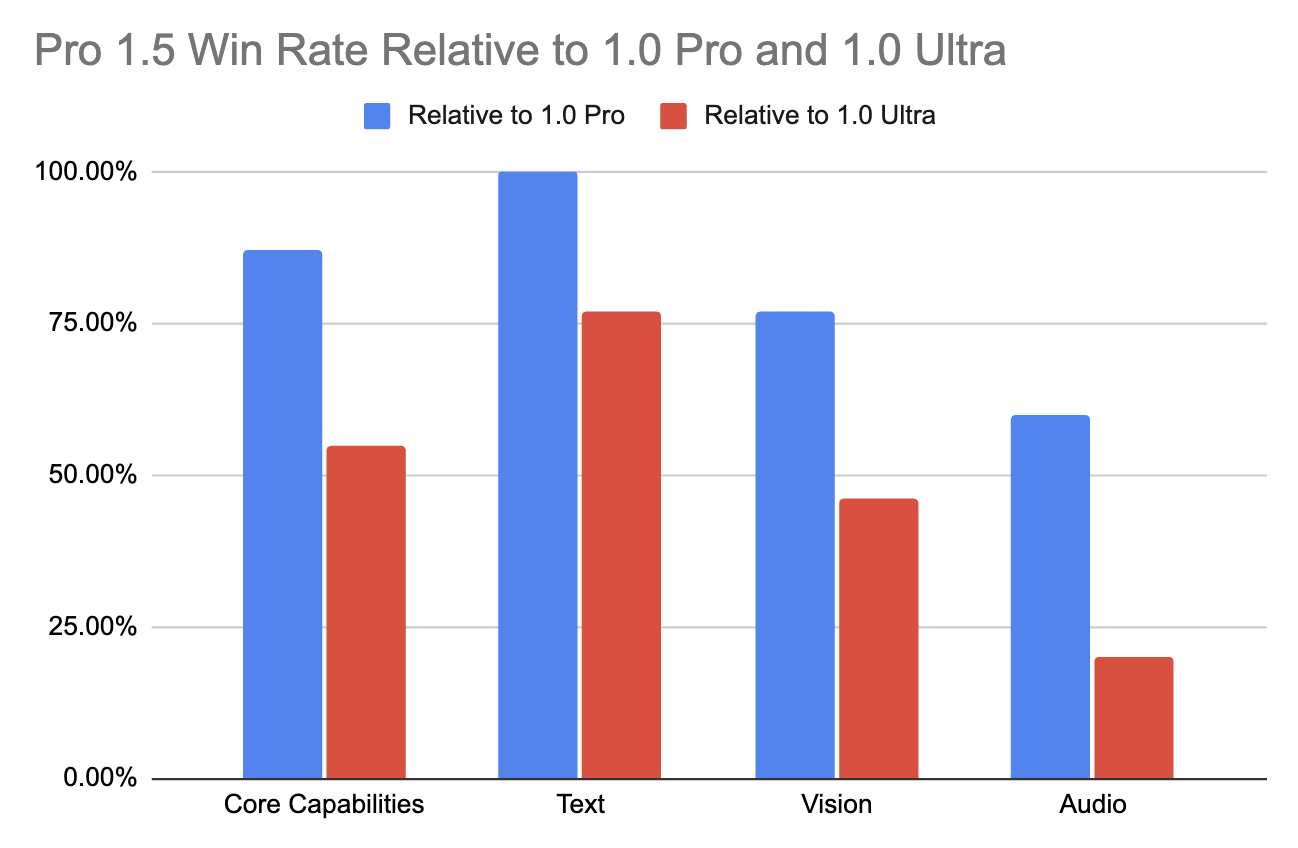
Sự tiến bộ trong hiệu năng ngữ cảnh dài của Gemini 1.5 Pro rất đáng chú ý, vì nó không làm tổn hại đến các khả năng đa phương thức cốt lõi của mô hình. So với tiền nhiệm (1.0 Pro), mô hình cải thiện đáng kể ở nhiều lĩnh vực (+28,9% về Toán, Khoa học và Lý luận).
Thậm chí, mô hình còn vượt qua phiên bản cao cấp 1.0 Ultra ở hơn một nửa số bài đánh giá, đặc biệt xuất sắc ở các tác vụ văn bản và thị giác (như trong bảng dưới đây). Điều này đạt được dù yêu cầu ít tài nguyên hơn và hiệu quả tính toán cao hơn.
Để có góc nhìn chi tiết hơn, tôi khuyến nghị tham khảo báo cáo kỹ thuật: “Gemini 1.5: Mở khóa hiểu biết đa phương thức trên hàng triệu token ngữ cảnh” để biết thêm chi tiết.
Với khả năng xử lý hàng triệu token, nhiều ứng dụng thực tiễn mới xuất hiện.
Gemini 1.5 Pro có thể được sử dụng rộng rãi trong kỹ thuật phần mềm. Với toàn bộ mã nguồn JAX gồm 746.152 token trong ngữ cảnh, Gemini 1.5 Pro có thể xác định vị trí cụ thể của một phương thức vi phân tự động cốt lõi.
Khi có quyền truy cập vào một sách ngữ pháp tham chiếu và một danh sách từ song ngữ (tổng cộng khoảng ∼250k), Gemini 1.5 Pro có thể dịch từ tiếng Anh sang Kalamang với chất lượng tương đương một người đã học bằng cùng nguồn tài liệu.
Dữ liệu trực tuyến hạn chế cho ngôn ngữ Kalamang (ít hơn 200 người nói) buộc Gemini 1.5 Pro chỉ dựa vào ngữ cảnh được cung cấp trong từng lời nhắc để hiểu và dịch ngôn ngữ này. Phát hiện này gợi mở cơ hội hứa hẹn cho việc sử dụng LLM với khả năng ngữ cảnh mở rộng nhằm hỗ trợ bảo tồn và phục hồi các ngôn ngữ đang nguy cấp, cũng như thúc đẩy giao tiếp và hiểu biết giữa các cộng đồng ngôn ngữ khác nhau.
Gemini 1.5 Pro cũng có thể trả lời một truy vấn hình ảnh khi được cung cấp toàn bộ văn bản của Les Misérables (1382 trang, 732k token). Nhờ khả năng đa phương thức gốc, mô hình có thể nhận diện một cảnh nổi tiếng từ bản phác thảo vẽ tay.
Với bộ phim câm dài 45 phút “Sherlock Jr.” (2.674 khung hình ở 1FPS, 684k token), Gemini 1.5 Pro truy xuất và trích xuất thông tin văn bản từ một khung hình cụ thể và cung cấp dấu thời gian tương ứng. Mô hình cũng có thể nhận diện một cảnh trong phim từ bản phác thảo vẽ tay.
Giờ đây khi đã biết về khả năng và ứng dụng của Gemini 1.5 Pro, hãy học cách kết nối với API của nó.
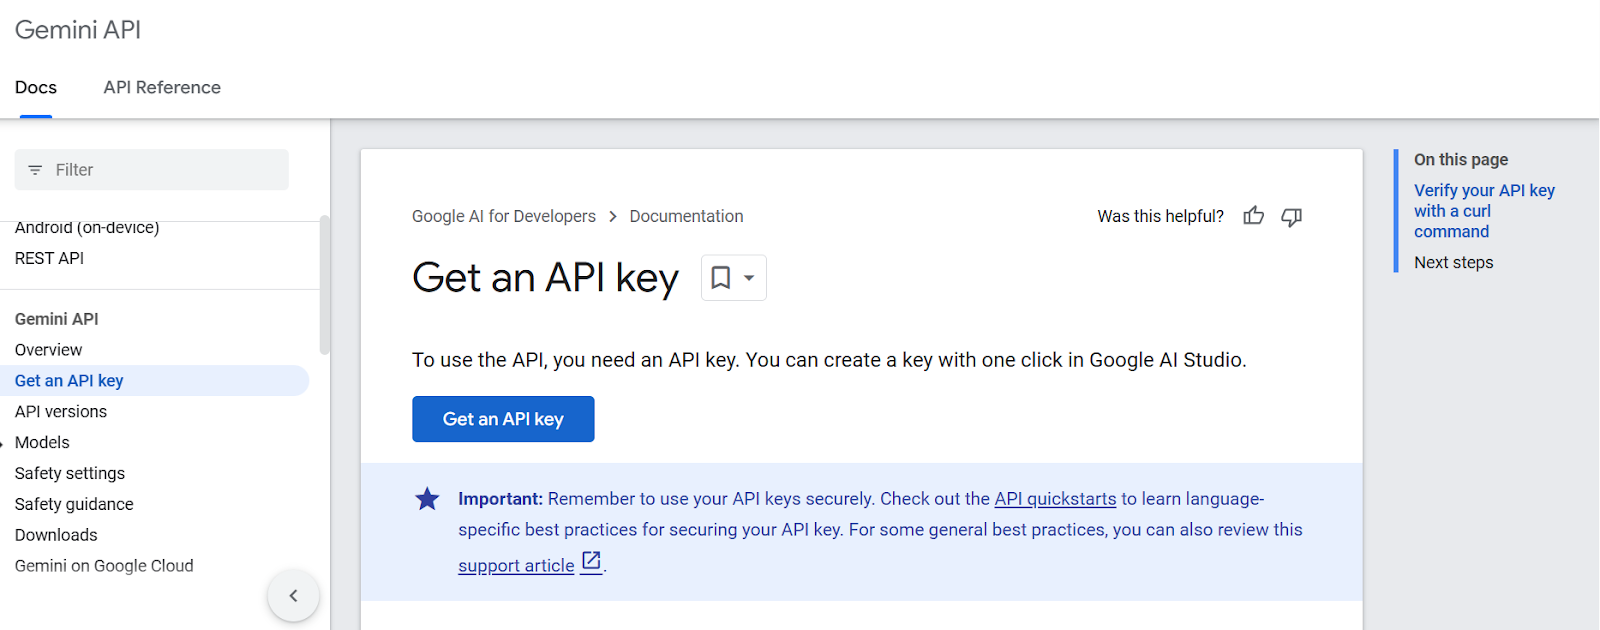
Trước hết, chúng ta cần lấy khóa API từ trang Google AI for Developers (hãy đảm bảo bạn đã đăng nhập tài khoản Google). Chúng ta có thể thực hiện bằng cách nhấp nút Get an API key:
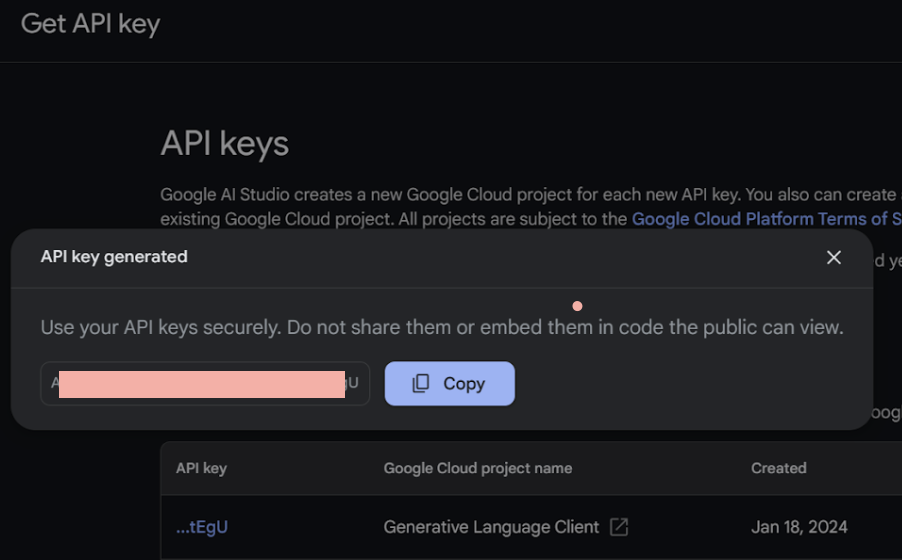
Tiếp theo, chúng ta cần thiết lập dự án và tạo khóa API.
Trước tiên, hãy cài đặt gói API Python của Gemini bằng pip.
%pip install google-generativeaiTiếp theo, chúng ta sẽ mở sổ tay Jupyter và nhập các thư viện Python thiết yếu cần cho dự án.
import google.generativeai as genai
from google.generativeai.types import ContentType
from PIL import Image
from IPython.display import Markdown
import time
import cv2Hãy bắt đầu bằng cách điền khóa API vào biến GOOGLE_API_KEY và cấu hình nó:
GOOGLE_API_KEY = ‘your-api-key-goes-here’
genai.configure(api_key=GOOGLE_API_KEY)
Trước khi gọi API, hãy kiểm tra các mô hình khả dụng thông qua API miễn phí.
for m in genai.list_models():
	if 'generateContent' in m.supported_generation_methods:
    	print(m.name)
models/gemini-1.0-pro
models/gemini-1.0-pro-001
models/gemini-1.0-pro-latest
models/gemini-1.0-pro-vision-latest
models/gemini-1.5-flash-latest
models/gemini-1.5-pro-latest
models/gemini-pro
models/gemini-pro-visionHãy truy cập mô hình gemini-1.5-pro-latest:
model = genai.GenerativeModel('gemini-1.5-pro-latest')Bây giờ hãy thực hiện cuộc gọi API đầu tiên và yêu cầu Gemini 1.5 Pro!
response = model.generate_content("Please provide a list of the most influential people in the world.")
print(response.text)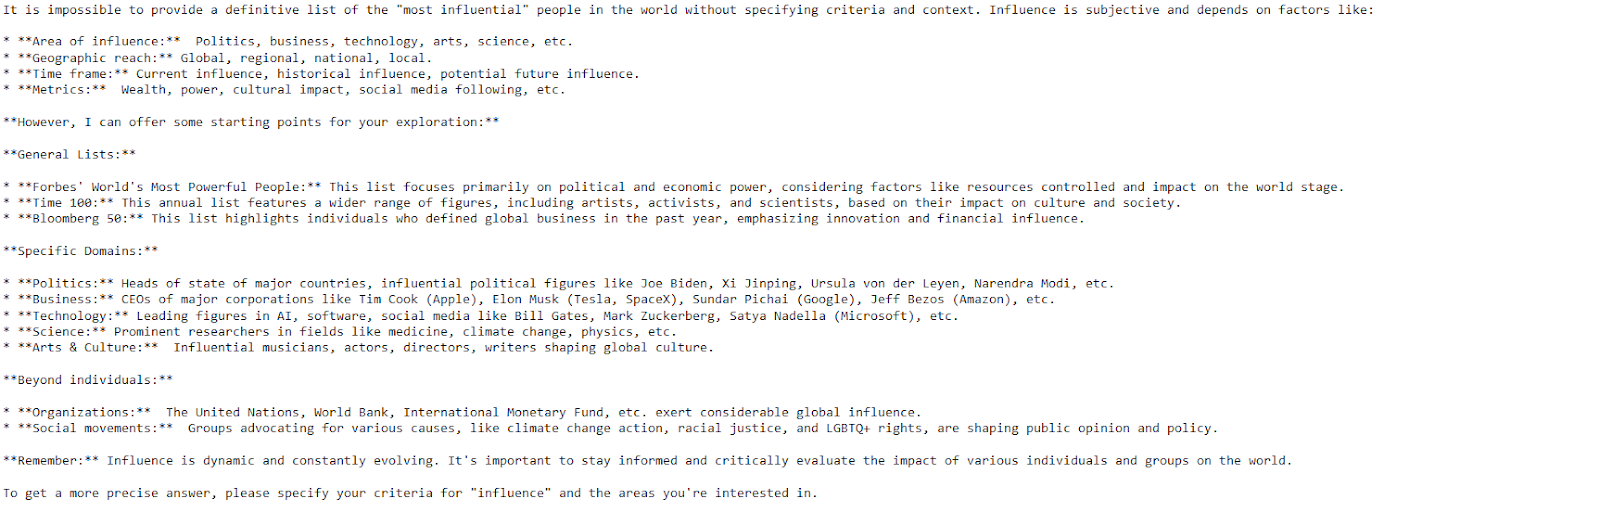
Mô hình đã cung cấp phản hồi rõ ràng và chi tiết chỉ với vài dòng mã.
Gemini AI có thể tạo nhiều phản hồi gọi là ứng viên cho một lời nhắc, cho phép bạn chọn phương án phù hợp nhất. 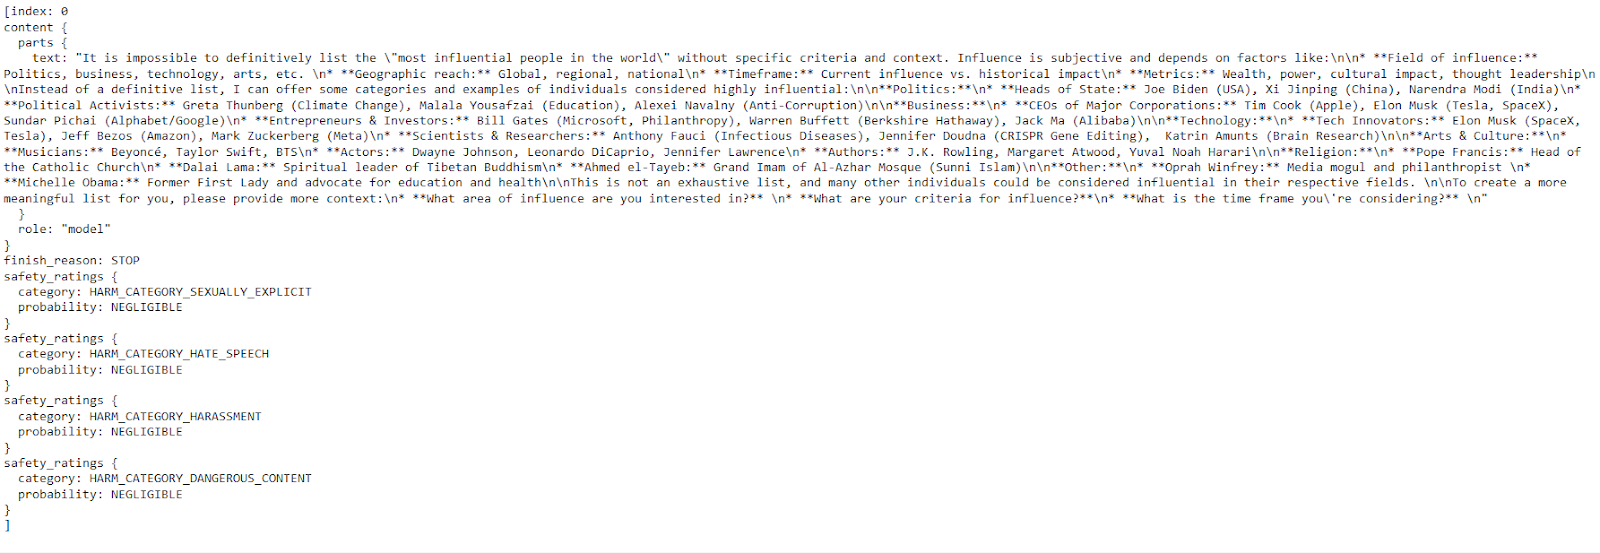
Trong phần này, chúng ta sẽ học cách tận dụng Gemini 1.5 Pro để tự động trích xuất danh sách sách từ một hình ảnh!
Trước hết, hãy xem xét hình ảnh này:
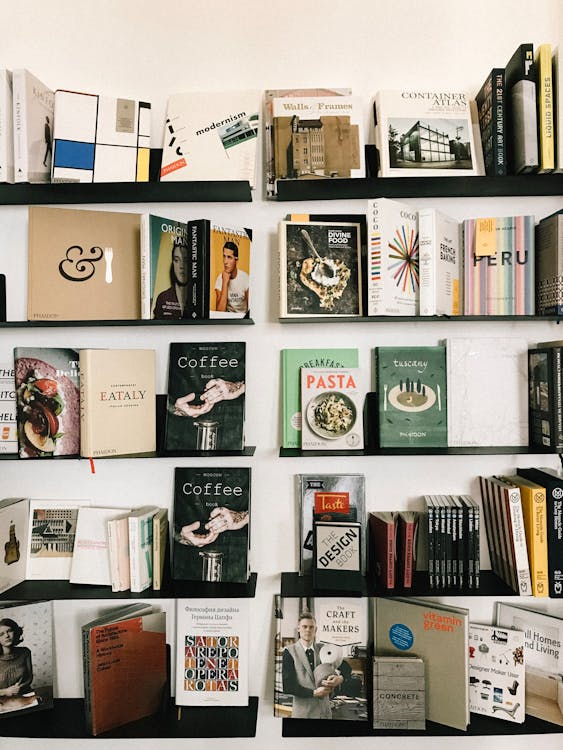
Hình ảnh một giá sách với nhiều cuốn sách xếp trên đó.
Hãy bắt đầu bằng cách hướng dẫn mô hình xác định và liệt kê các tựa sách trong hình theo một thứ tự cụ thể:
text_prompt = "List all the books and help me organize them into three categories."Tiếp theo, chúng ta sẽ mở hình "bookshelf.jpeg" bằng lớp Image, chuẩn bị cho quá trình phân tích của mô hình.
bookshelf_image = Image.open('bookshelf.jpeg')Hãy đưa cả text_prompt và bookshelf_image vào một danh sách và gửi lời nhắc cho mô hình:
prompt = [text_prompt, bookshelf_image]
response = model.generate_content(prompt)
Để tránh đầu ra ở định dạng Markdown, hãy dùng công cụ Markdown của IPython.
Markdown(response.text)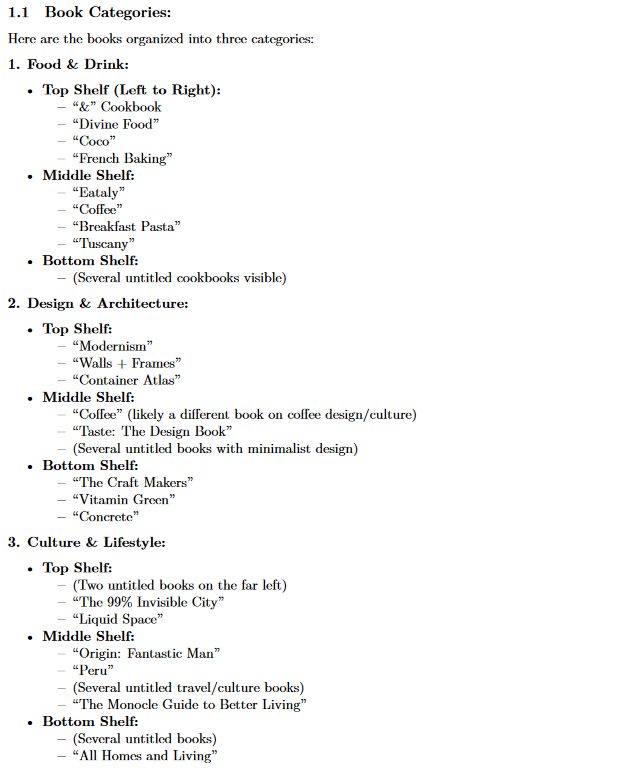
Mô hình đã phân loại thành công tất cả các cuốn sách trong hình ảnh đã tải lên thành ba nhóm khác nhau.
Trong hướng dẫn này, chúng tôi đã giới thiệu Gemini 1.5 Pro, bản phát hành đầu tiên từ họ Gemini 1.5. Vượt lên trên khả năng đa phương thức và hiệu suất, Gemini 1.5 Pro mở rộng cửa sổ nội dung so với dòng Gemini 1.0 từ 32k lên đến hàng triệu token.
Dù làm việc với văn bản, hình ảnh, video hay âm thanh, API Gemini 1.5 Pro mang lại sự linh hoạt để giải quyết nhiều ứng dụng, từ truy xuất thông tin và hỏi đáp đến tạo nội dung và dịch thuật.
Nếu bạn muốn tìm hiểu thêm về AI, hãy xem lộ trình kỹ năng gồm sáu khóa học AI Fundamentals.
Tìm hiểu thêm về LLM!
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
