谷歌近日发布了其全新的生成式 AI模型 Gemini。这是谷歌多个团队(包括 Google Research 成员)协作的成果。
谷歌称该模型是其迄今为止最强大、最通用的 AI,且在设计之初即为多模态。这意味着 Gemini 能够理解多种数据类型,如文本、音频、图像、视频和代码。
在本文的其余部分,我们将介绍:
- 什么是 Gemini?
- Gemini 有哪些版本?
- 如何访问 Gemini?
- Gemini 基准测试解读
- Gemini 与 GPT-4 对比
- Gemini 的应用场景
什么是 Google Gemini?
2023 年 12 月 6 日,Google DeepMind 宣布推出 Gemini 1.0。发布时,谷歌将其描述为最先进的一组大型语言模型(LLMs),取代了同年 5 月首次亮相的 Pathways Language Model(PaLM 2)。
Gemini 指代一系列多模态 LLM,能够理解文本、图像、视频和音频。据称它还能执行数学和物理领域的复杂任务,并能以多种编程语言生成高质量代码。
趣闻:谷歌联合创始人 Sergey Brin 亦被列为 Gemini 模型的贡献者之一。
直到最近,开发多模态模型的常规做法还是分别为不同模态训练独立组件,再将其拼接以模拟部分功能。此类模型偶尔会在某些任务上表现突出,比如图像描述,但在更复杂的推理方面往往力不从心。
Gemini 自设计之初即为原生多模态,因此从一开始就以多种模态进行预训练。为了进一步提升效果,谷歌又使用额外的多模态数据进行了微调。
因此,据谷歌及 Alphabet CEO Sundar Pichai 与 Google DeepMind CEO、联合创始人 Demis Hassabis 称,Gemini 自底层起就能更好地理解并推理广泛的输入,明显强于现有多模态模型。他们还表示,Gemini 的能力在几乎所有领域均达到“业界领先”。
Google Gemini 关键特性
Gemini 模型的关键特性包括:
1. 理解文本、图像、音频等多种数据
多模态 AI 是一种新兴并日益流行的范式,即将不同类型数据与多种算法结合以获得更高性能。Gemini 正是基于这一范式,能很好地整合多种数据类型。您可以输入图像、音频、文本及其他数据类型,从而与 AI 进行更自然的交互。
2. 可靠、可扩展且高效
Gemini 采用谷歌的 TPUv5 芯片,据称因此比 GPT-4 强大五倍。更快的处理速度使 Gemini 能相对轻松地应对复杂任务,并可同时处理多条请求。
3. 复杂推理能力
Gemini 在海量文本和代码数据上进行训练。这确保模型可以获取最新信息,并对您的问题给出准确且可靠的回答。根据谷歌的说法,该模型在多项智力测试(如 MMLU 基准)上优于 OpenAI 的 GPT-4 以及“专家级”人类。
4. 高级编程能力
Gemini 1.0 能够理解、解释并生成多种主流编程语言(如 Python、Java、C++ 和 Go)的高质量代码——这使其成为全球领先的编程基础模型之一。
该模型在多个编码基准上表现出色,包括备受业界认可、用于评估编码任务表现的HumanEval;它在谷歌内部留出的数据集上也有良好表现,该数据集采用作者原创代码而非网络信息。
5. 责任与安全
为适配 Gemini 的多模态能力,谷歌在其AI 原则和政策中新增了保护措施。谷歌表示:“Gemini 是迄今为止我们最全面进行安全评估的 AI 模型,包括偏见和有害性方面。”他们还称,“我们就网络攻防、劝服与自主性等潜在风险领域开展了前沿研究,并采用 Google Research 的一流对抗性测试技术,以在部署前识别关键安全问题。”
Gemini 有哪些版本?
谷歌称,作为LaMDA 与 PaLM 2 的继任者,Gemini 是其“迄今最灵活的模型——可高效运行于从数据中心到移动设备的各类环境”。他们也认为,Gemini 的前沿能力将改进开发者与企业客户构建和扩展 AI 的方式。
Gemini 的首个版本 Gemini 1.0,按惯例分为三种规格:
- Gemini Nano —— 面向设备端任务的最高效模型,适用于无需连接外部服务器即可高效处理 AI 的场景。换言之,它旨在在智能手机上运行,特别是 Google Pixel 8。
- Gemini Pro —— 跨各类任务实现规模化的最优模型。它为谷歌最新的 AI 聊天机器人Bard提供支持,因而能理解复杂查询并快速响应。
- Gemini Ultra —— 体量最大、能力最强的模型,面向复杂任务。在 32 项常用的大型语言模型(LLM)研发基准中有 30 项超越当前最先进水平。
如何访问 Gemini?
自 2023 年 12 月 13 日起,开发者与企业客户即可通过 Google AI Studio 或 Google Cloud Vertex AI 中的 Gemini API 访问 Gemini Pro。
需注意,Google AI Studio 是免费的基于浏览器的 IDE,开发者可用其对生成式模型进行原型开发,并使用 API 密钥轻松上线应用。另一方面,Google Cloud Vertex 是一站式托管的 AI 平台,提供构建与使用生成式 AI所需的全部工具。根据谷歌的说法,“Vertex AI 允许在完全数据可控的前提下定制 Gemini,并受益于 Google Cloud 在企业级安全、保障、隐私与数据治理及合规方面的附加功能。”
借助 Android 14 新增的系统特性 AICore,Android 开发者可从 Pixel 8 Pro 设备开始,使用面向设备端任务的最高效模型 Gemini Nano 开展开发。
Gemini 基准测试解读
在发布前,Gemini 模型经历了广泛测试,以评估其在大量任务上的表现。谷歌称,其 Gemini Ultra 模型在 32 项常用的大型语言模型(LLM)学术基准中有 30 项超越了现有最先进结果。需注意,这些任务涵盖自然图像、音频与视频理解到数学推理等。
在一篇 Gemini 介绍博文中,谷歌称 Gemini Ultra 是首个在大规模多任务语言理解(MMLU)上超越人类专家的模型,得分 90.0%。MMLU 涵盖 57 个不同学科,包括数学、物理、历史、法律、医学与伦理,以评估解决问题的能力与对世界的总体认知。
新的 MMLU 基准方法使 Gemini 能借助其推理能力在回答难题前进行更充分的思考,而非仅凭第一反应,从而实现显著提升。
以下是 Gemini 在文本任务上的表现:
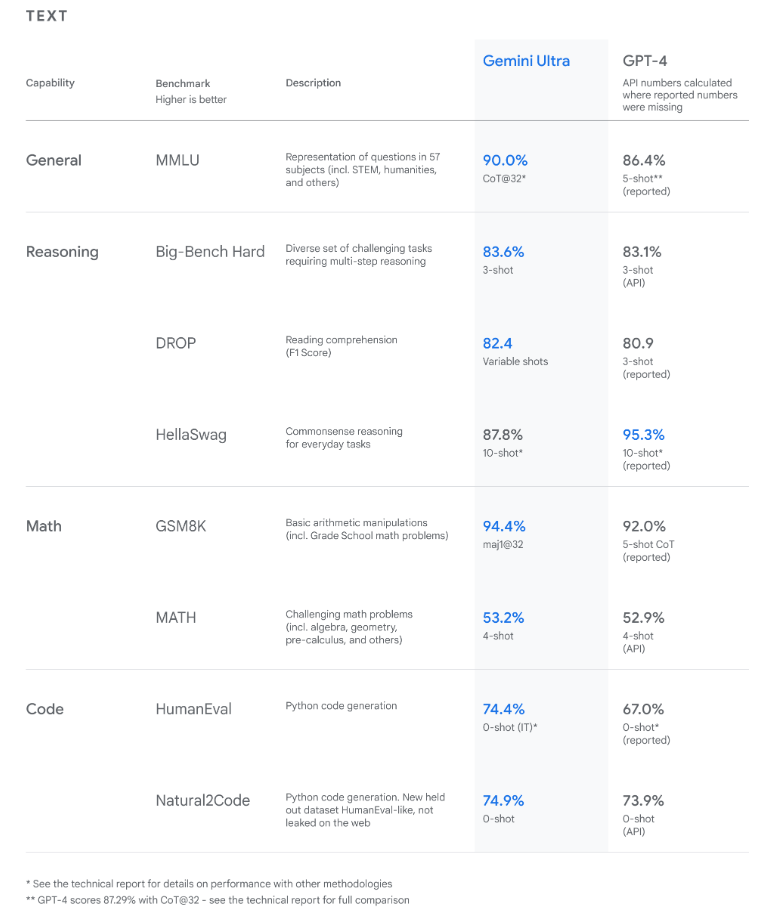
研究结果显示,Gemini 在包括文本与编码在内的多项基准上均超越当前最先进水平。[来源]
Gemini Ultra 模型还在全新的大规模多学科多模态理解(MMMU)基准上取得 59.4% 的成绩,达到领先水平。该评测由跨多个领域的多模态任务构成,要求进行审慎推理。
谷歌表示:“在我们测试的图像基准中,Gemini Ultra 未借助从图像中提取文本供后续处理的光学字符识别(OCR)系统,便已超越此前的最先进模型。”
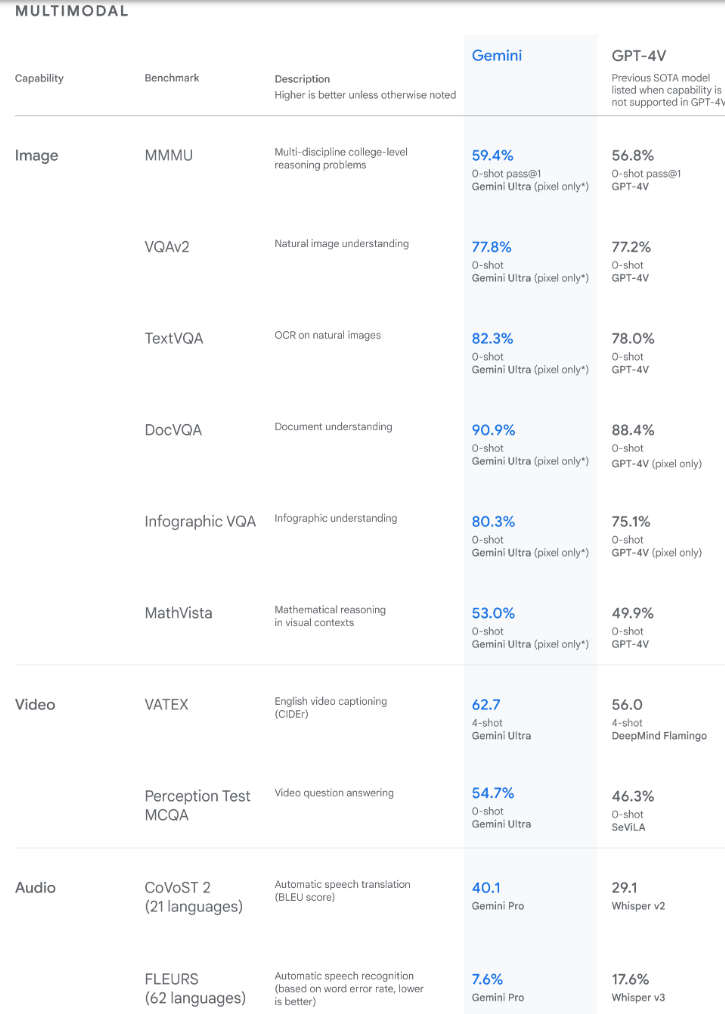
研究结果显示,Gemini 在广泛的多模态基准上同样超越当前最先进水平。[来源]
Gemini 刷新的这些基准展现了其原生多模态特性,并初步证明了其更复杂推理的潜力。
Gemini 与 GPT-4
接下来一个显而易见的问题通常是:“Gemini 与GPT-4相比如何?”
两者的功能集相近,均可处理并理解文本、图像、视频、音频与代码数据,使用户能将其应用于多种任务。
两款工具都支持事实核查,但实现方式不同。OpenAI 的 GPT-4 会为其论断提供来源链接;而 Gemini 则允许用户通过点击按钮执行一次 Google 搜索来验证回复。
两者也都可以通过扩展增强功能,但在撰文时,谷歌的 Gemini 在这方面受限更多。
例如,Gemini 可调用谷歌的航班、地图、YouTube 以及一系列 Workspace 应用;而 OpenAI 的 GPT-4 则有数量多得多的插件与扩展,其中大多数由第三方开发。GPT-4 还支持即时图像生成;Gemini 在设计上具备此类能力,但在撰文时尚未开放。
另一方面,Gemini 的响应速度通常快于 GPT-4;后者有时会因平台用户量过大而变慢甚至中断。
Gemini 的应用场景
谷歌的 Gemini 模型可在文本、音频、图像和视频理解等多种模态上执行多样任务。
借助其多模态特性,还可以组合不同模态来理解并生成输出。
Gemini 的应用示例包括:
文本摘要
Gemini 模型可以对多种数据类型的内容进行摘要。根据题为GEMINI: Controlling The Sentence-Level Summary Style in Abstractive Text Summarization的论文,Gemini 模型“整合了改写器与生成器,分别模拟句子改写与抽象生成技术”。
具体而言,Gemini 会自适应地选择是改写文档中的某个句子,还是从零生成一条摘要句。实验结果表明,Gemini 所采用的方法在三个基准数据集上均优于纯抽象式与纯改写式基线,并在 WikiHow 上取得最佳表现。
文本生成
Gemini 能根据用户提示生成文本输入——也可通过问答式聊天机器人界面进行。这使得 Gemini 能部署于客服咨询与辅助支持等场景,以自然而有吸引力的方式与用户互动,从而减轻人工坐席负担,让其投入到更复杂的任务中,并提升客户满意度。
它也可用于创意写作,例如协作写作长篇小说、以多种风格写诗,或为电影与戏剧生成剧本。这能显著提升创作者的生产力,缓解写作瓶颈带来的压力。
文本翻译与音频处理
凭借广泛的多语种能力,Gemini 模型能够理解并翻译 100 多种语言。根据谷歌的说法,Gemini 在一系列多模态基准(如自动语音识别(ASR)与自动语音翻译)上“超越了 Chat GPT-4V 的最先进表现”。
图像与视频处理
Gemini 能理解并解释图像,适用于图像描述与视觉问答等场景。该模型还能解析复杂的可视化内容,包括示意图、图形与图表,而无需外部 OCR 工具。
代码分析与生成
开发者可以使用 Gemini 解决复杂的编程任务并调试代码。该模型能够理解、解释并使用最常用的编程语言(如 Python、Java、C++ 和 Go)进行生成。
结语
谷歌全新的多模态大型语言模型(LLMs)Gemini,是 LaMDA 与 PaLM 2 的继任者。谷歌将其描述为最先进的一组 LLM,能够理解文本、图像、视频、音频以及数学与物理等复杂任务。Gemini 还可在多种主流编程语言中生成高质量代码。
该模型已在多项任务上达到最先进水平,许多谷歌人士认为,它代表着 AI 改善我们日常生活方式的一大飞跃。
继续通过以下资源学习:
在您离开前,别忘了订阅我们的YouTube 频道。我们涵盖最热门、最相关主题的优质内容,其中包括一篇关于 使用 Gemini 构建多模态应用 的教程,欢迎观看。


谷歌近日发布了其全新的生成式 AI模型 Gemini。这是谷歌多个团队(包括 Google Research 成员)协作的成果。
谷歌称该模型是其迄今为止最强大、最通用的 AI,且在设计之初即为多模态。这意味着 Gemini 能够理解多种数据类型,如文本、音频、图像、视频和代码。
在本文的其余部分,我们将介绍:
什么是 Google Gemini?
2023 年 12 月 6 日,Google DeepMind 宣布推出 Gemini 1.0。发布时,谷歌将其描述为最先进的一组大型语言模型(LLMs),取代了同年 5 月首次亮相的 Pathways Language Model(PaLM 2)。
Gemini 指代一系列多模态 LLM,能够理解文本、图像、视频和音频。据称它还能执行数学和物理领域的复杂任务,并能以多种编程语言生成高质量代码。
趣闻:谷歌联合创始人 Sergey Brin 亦被列为 Gemini 模型的贡献者之一。
直到最近,开发多模态模型的常规做法还是分别为不同模态训练独立组件,再将其拼接以模拟部分功能。此类模型偶尔会在某些任务上表现突出,比如图像描述,但在更复杂的推理方面往往力不从心。
Gemini 自设计之初即为原生多模态,因此从一开始就以多种模态进行预训练。为了进一步提升效果,谷歌又使用额外的多模态数据进行了微调。
因此,据谷歌及 Alphabet CEO Sundar Pichai 与 Google DeepMind CEO、联合创始人 Demis Hassabis 称,Gemini 自底层起就能更好地理解并推理广泛的输入,明显强于现有多模态模型。他们还表示,Gemini 的能力在几乎所有领域均达到“业界领先”。
Google Gemini 关键特性
Gemini 模型的关键特性包括:
1. 理解文本、图像、音频等多种数据
多模态 AI 是一种新兴并日益流行的范式,即将不同类型数据与多种算法结合以获得更高性能。Gemini 正是基于这一范式,能很好地整合多种数据类型。您可以输入图像、音频、文本及其他数据类型,从而与 AI 进行更自然的交互。
2. 可靠、可扩展且高效
Gemini 采用谷歌的 TPUv5 芯片,据称因此比 GPT-4 强大五倍。更快的处理速度使 Gemini 能相对轻松地应对复杂任务,并可同时处理多条请求。
3. 复杂推理能力
Gemini 在海量文本和代码数据上进行训练。这确保模型可以获取最新信息,并对您的问题给出准确且可靠的回答。根据谷歌的说法,该模型在多项智力测试(如 MMLU 基准)上优于 OpenAI 的 GPT-4 以及“专家级”人类。
4. 高级编程能力
Gemini 1.0 能够理解、解释并生成多种主流编程语言(如 Python、Java、C++ 和 Go)的高质量代码——这使其成为全球领先的编程基础模型之一。
该模型在多个编码基准上表现出色,包括备受业界认可、用于评估编码任务表现的HumanEval;它在谷歌内部留出的数据集上也有良好表现,该数据集采用作者原创代码而非网络信息。
5. 责任与安全
为适配 Gemini 的多模态能力,谷歌在其AI 原则和政策中新增了保护措施。谷歌表示:“Gemini 是迄今为止我们最全面进行安全评估的 AI 模型,包括偏见和有害性方面。”他们还称,“我们就网络攻防、劝服与自主性等潜在风险领域开展了前沿研究,并采用 Google Research 的一流对抗性测试技术,以在部署前识别关键安全问题。”
Gemini 有哪些版本?
谷歌称,作为LaMDA 与 PaLM 2 的继任者,Gemini 是其“迄今最灵活的模型——可高效运行于从数据中心到移动设备的各类环境”。他们也认为,Gemini 的前沿能力将改进开发者与企业客户构建和扩展 AI 的方式。
Gemini 的首个版本 Gemini 1.0,按惯例分为三种规格:
如何访问 Gemini?
自 2023 年 12 月 13 日起,开发者与企业客户即可通过 Google AI Studio 或 Google Cloud Vertex AI 中的 Gemini API 访问 Gemini Pro。
需注意,Google AI Studio 是免费的基于浏览器的 IDE,开发者可用其对生成式模型进行原型开发,并使用 API 密钥轻松上线应用。另一方面,Google Cloud Vertex 是一站式托管的 AI 平台,提供构建与使用生成式 AI所需的全部工具。根据谷歌的说法,“Vertex AI 允许在完全数据可控的前提下定制 Gemini,并受益于 Google Cloud 在企业级安全、保障、隐私与数据治理及合规方面的附加功能。”
借助 Android 14 新增的系统特性 AICore,Android 开发者可从 Pixel 8 Pro 设备开始,使用面向设备端任务的最高效模型 Gemini Nano 开展开发。
Gemini 基准测试解读
在发布前,Gemini 模型经历了广泛测试,以评估其在大量任务上的表现。谷歌称,其 Gemini Ultra 模型在 32 项常用的大型语言模型(LLM)学术基准中有 30 项超越了现有最先进结果。需注意,这些任务涵盖自然图像、音频与视频理解到数学推理等。
在一篇 Gemini 介绍博文中,谷歌称 Gemini Ultra 是首个在大规模多任务语言理解(MMLU)上超越人类专家的模型,得分 90.0%。MMLU 涵盖 57 个不同学科,包括数学、物理、历史、法律、医学与伦理,以评估解决问题的能力与对世界的总体认知。
新的 MMLU 基准方法使 Gemini 能借助其推理能力在回答难题前进行更充分的思考,而非仅凭第一反应,从而实现显著提升。
以下是 Gemini 在文本任务上的表现:
研究结果显示,Gemini 在包括文本与编码在内的多项基准上均超越当前最先进水平。[来源]
Gemini Ultra 模型还在全新的大规模多学科多模态理解(MMMU)基准上取得 59.4% 的成绩,达到领先水平。该评测由跨多个领域的多模态任务构成,要求进行审慎推理。
谷歌表示:“在我们测试的图像基准中,Gemini Ultra 未借助从图像中提取文本供后续处理的光学字符识别(OCR)系统,便已超越此前的最先进模型。”
研究结果显示,Gemini 在广泛的多模态基准上同样超越当前最先进水平。[来源]
Gemini 刷新的这些基准展现了其原生多模态特性,并初步证明了其更复杂推理的潜力。
Gemini 与 GPT-4
接下来一个显而易见的问题通常是:“Gemini 与GPT-4相比如何?”
两者的功能集相近,均可处理并理解文本、图像、视频、音频与代码数据,使用户能将其应用于多种任务。
两款工具都支持事实核查,但实现方式不同。OpenAI 的 GPT-4 会为其论断提供来源链接;而 Gemini 则允许用户通过点击按钮执行一次 Google 搜索来验证回复。
两者也都可以通过扩展增强功能,但在撰文时,谷歌的 Gemini 在这方面受限更多。
例如,Gemini 可调用谷歌的航班、地图、YouTube 以及一系列 Workspace 应用;而 OpenAI 的 GPT-4 则有数量多得多的插件与扩展,其中大多数由第三方开发。GPT-4 还支持即时图像生成;Gemini 在设计上具备此类能力,但在撰文时尚未开放。
另一方面,Gemini 的响应速度通常快于 GPT-4;后者有时会因平台用户量过大而变慢甚至中断。
Gemini 的应用场景
谷歌的 Gemini 模型可在文本、音频、图像和视频理解等多种模态上执行多样任务。
借助其多模态特性,还可以组合不同模态来理解并生成输出。
Gemini 的应用示例包括:
文本摘要
Gemini 模型可以对多种数据类型的内容进行摘要。根据题为GEMINI: Controlling The Sentence-Level Summary Style in Abstractive Text Summarization的论文,Gemini 模型“整合了改写器与生成器,分别模拟句子改写与抽象生成技术”。
具体而言,Gemini 会自适应地选择是改写文档中的某个句子,还是从零生成一条摘要句。实验结果表明,Gemini 所采用的方法在三个基准数据集上均优于纯抽象式与纯改写式基线,并在 WikiHow 上取得最佳表现。
文本生成
Gemini 能根据用户提示生成文本输入——也可通过问答式聊天机器人界面进行。这使得 Gemini 能部署于客服咨询与辅助支持等场景,以自然而有吸引力的方式与用户互动,从而减轻人工坐席负担,让其投入到更复杂的任务中,并提升客户满意度。
它也可用于创意写作,例如协作写作长篇小说、以多种风格写诗,或为电影与戏剧生成剧本。这能显著提升创作者的生产力,缓解写作瓶颈带来的压力。
文本翻译与音频处理
凭借广泛的多语种能力,Gemini 模型能够理解并翻译 100 多种语言。根据谷歌的说法,Gemini 在一系列多模态基准(如自动语音识别(ASR)与自动语音翻译)上“超越了 Chat GPT-4V 的最先进表现”。
图像与视频处理
Gemini 能理解并解释图像,适用于图像描述与视觉问答等场景。该模型还能解析复杂的可视化内容,包括示意图、图形与图表,而无需外部 OCR 工具。
代码分析与生成
开发者可以使用 Gemini 解决复杂的编程任务并调试代码。该模型能够理解、解释并使用最常用的编程语言(如 Python、Java、C++ 和 Go)进行生成。
结语
谷歌全新的多模态大型语言模型(LLMs)Gemini,是 LaMDA 与 PaLM 2 的继任者。谷歌将其描述为最先进的一组 LLM,能够理解文本、图像、视频、音频以及数学与物理等复杂任务。Gemini 还可在多种主流编程语言中生成高质量代码。
该模型已在多项任务上达到最先进水平,许多谷歌人士认为,它代表着 AI 改善我们日常生活方式的一大飞跃。
继续通过以下资源学习:
在您离开前,别忘了订阅我们的YouTube 频道。我们涵盖最热门、最相关主题的优质内容,其中包括一篇关于 使用 Gemini 构建多模态应用 的教程,欢迎观看。