Lernpfad
Grundlagen der KI
10 Std.
Gemini 1.5 Pro ist ein großer Schritt nach vorn innerhalb der Gemini-Familie. Es bringt Langkontext-Reasoning mit, sodass wir mit riesigen Datensätzen über verschiedene Modalitäten (Text, Video und Audio) arbeiten können.
In diesem Tutorial lernst du, wie du dich mit der Gemini 1.5 Pro API verbindest. Wir führen Aufgaben aus wie Retrieval, Fragenbeantwortung zu langen Dokumenten und Videos, automatische Spracherkennung (ASR) auf Langkontexten und In-Context Learning.
Wenn du mehr über Gemini erfahren möchtest, lies diesen Artikel: What is Google Gemini.
Gemini AI umfasst eine Reihe generativer KI-Modelle, die gemeinsam von mehreren Teams bei Google entwickelt wurden, darunter Google Research und Google DeepMind.
Die Modelle sind für allgemeine multimodale Aufgaben ausgelegt und unterstützen Entwickler bei Content-Erstellung und Problemlösung. Jede Modellvariante ist für bestimmte Anwendungsfälle optimiert und liefert so in unterschiedlichen Szenarien starke Ergebnisse.
Gemini AI balanciert Rechenaufwand und Funktionsumfang über drei Modellgrößen:
|
Modell |
Größe |
Fähigkeiten |
Ideale Einsatzszenarien |
|
Gemini Ultra |
Größtes |
Am leistungsfähigsten, meistert hochkomplexe Aufgaben |
Anspruchsvolle Anwendungen, große Projekte, komplexe Problemlösung |
|
Gemini Pro |
Mittel |
Vielseitig, für viele Aufgaben geeignet, skalierbar |
Allgemeine Anwendungen, flexibel für verschiedene Szenarien, Projekte mit ausgewogenem Verhältnis aus Leistung und Effizienz |
|
Gemini Nano |
Kleinstes |
Leichtgewichtig und effizient, für On-Device- und ressourcenarme Umgebungen optimiert |
Mobile Apps, Embedded-Systeme, Aufgaben mit begrenzten Ressourcen, Echtzeitverarbeitung pen_spark |
Unser Schwerpunkt liegt auf Gemini 1.5 Pro, dem ersten Modell der Gemini-1.5-Reihe.
Dank eines großen Kontextfensters von bis zu mindestens 10 Millionen Tokens kann Gemini 1.5 Pro die Herausforderung langer Kontexte in vielen realen Anwendungen meistern.
Eine umfassende Evaluation von Langabhängigkeitsaufgaben wurde durchgeführt, um die Langkontext-Fähigkeiten von Gemini 1.5 Pro zu prüfen. Das Modell löste die anspruchsvolle "Needle-in-a-Haystack"-Aufgabe und erreichte eine nahezu perfekte (>99%) Wiedererkennung der "Nadel" selbst in Heuhaufen mit mehreren Millionen Tokens über alle Modalitäten hinweg, also Text, Video und Audio.
Diese Recall-Leistung blieb selbst bei Heuhaufen-Größen von 10 Millionen Tokens in der Textmodalität erhalten.
Das Modell übertraf alle Konkurrenzmodelle, auch solche mit externen Retrieval-Methoden, insbesondere bei Aufgaben, die ein Verständnis von Abhängigkeiten über vielfältige Belege hinweg im gesamten langen Inhalt erfordern, etwa bei Long-Dependency-QA.
Gemini 1.5 Pro zeigte zudem dank sehr langer Texte starkes In-Context Learning, etwa indem es eine neue Sprache anhand eines einzigen linguistischen Dokumentsatzes übersetzen lernte.
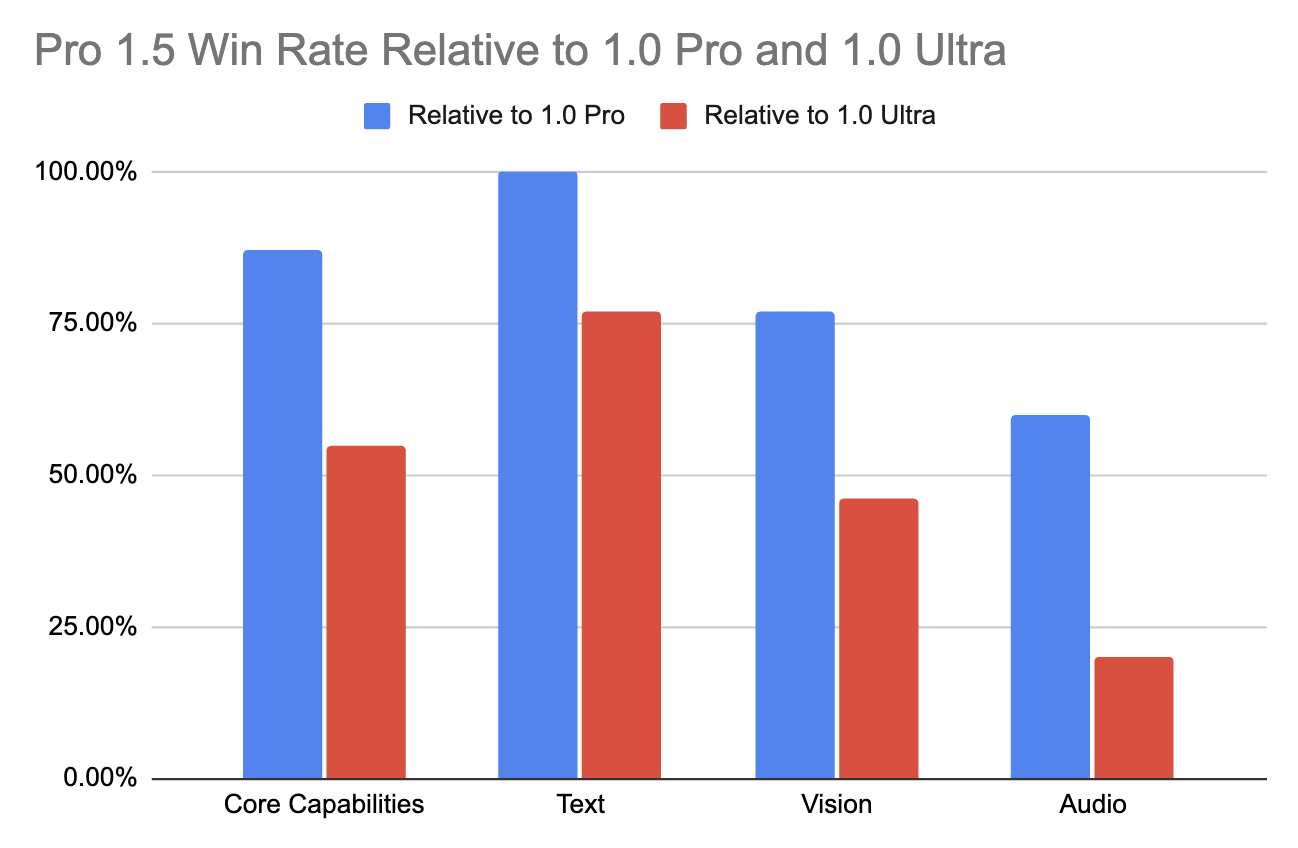
Bemerkenswert ist, dass diese Langkontext-Fortschritte nicht zulasten der grundlegenden multimodalen Fähigkeiten gehen. Gegenüber dem Vorgänger (1.0 Pro) gab es deutliche Verbesserungen in mehreren Bereichen (+28,9% in Mathe, Naturwissenschaften und Reasoning).
In über der Hälfte der Benchmarks übertrifft es sogar das Topmodell 1.0 Ultra, insbesondere bei Text- und Vision-Aufgaben (siehe Tabelle unten) – und das bei geringerem Ressourcenbedarf und höherer Recheneffizienz.
Für detaillierte Einblicke empfehle ich den Technical Report: “Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context”.
Mit der Fähigkeit, mehrere Millionen Tokens zu verarbeiten, werden neue praxisnahe Anwendungen möglich.
In der Softwareentwicklung ist Gemini 1.5 Pro breit einsetzbar. Mit dem gesamten JAX-Codefundus von 746.152 Tokens im Kontext kann das Modell die konkrete Stelle einer Kernmethode zur automatischen Differenzierung finden.
Mit Zugang zu einer Referenzgrammatik und einer zweisprachigen Wortliste (insgesamt ∼250k) kann Gemini 1.5 Pro übersetzen – von Englisch nach Kalamang – in einer Qualität, die mit der eines Menschen vergleichbar ist, der dieselben Ressourcen genutzt hat.
Da es online kaum Daten zu Kalamang gibt (weniger als 200 Sprecher), muss sich Gemini 1.5 Pro ausschließlich auf den Kontext in den jeweiligen Prompts stützen, um die Sprache zu verstehen und zu übersetzen. Das zeigt, dass LLMs mit erweitertem Kontext beim Erhalt bedrohter Sprachen helfen und die Verständigung zwischen Sprachgemeinschaften fördern können.
Gemini 1.5 Pro kann auch eine Bildanfrage beantworten, wenn der gesamte Text von Les Misérables (1.382 Seiten, 732k Tokens) vorliegt. Als nativ multimodales Modell erkennt es eine bekannte Szene anhand einer Handskizze.
Bei einem 45-minütigen Film „Sherlock Jr.“ (2.674 Frames bei 1 FPS, 684k Tokens) ruft Gemini 1.5 Pro Textinformationen aus einem bestimmten Frame ab, extrahiert sie und liefert den passenden Zeitstempel. Auch hier kann das Modell eine Filmszene anhand einer Handskizze identifizieren.
Nachdem wir die Fähigkeiten und Anwendungsfälle gesehen haben, verbinden wir uns nun mit der API.
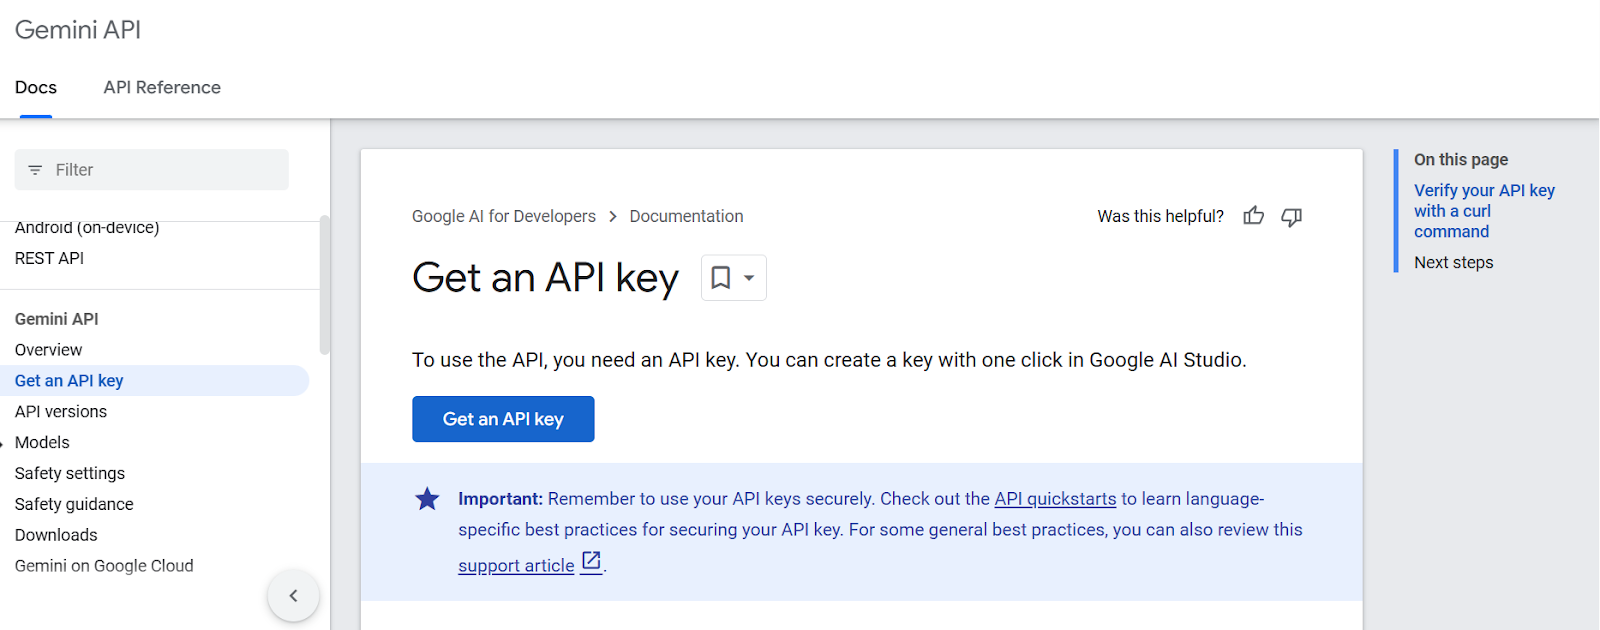
Zuerst besorgen wir uns einen API-Schlüssel über die Seite Google AI for Developers (achte darauf, dass du in deinem Google-Konto angemeldet bist). Klicke dazu auf Get an API key:
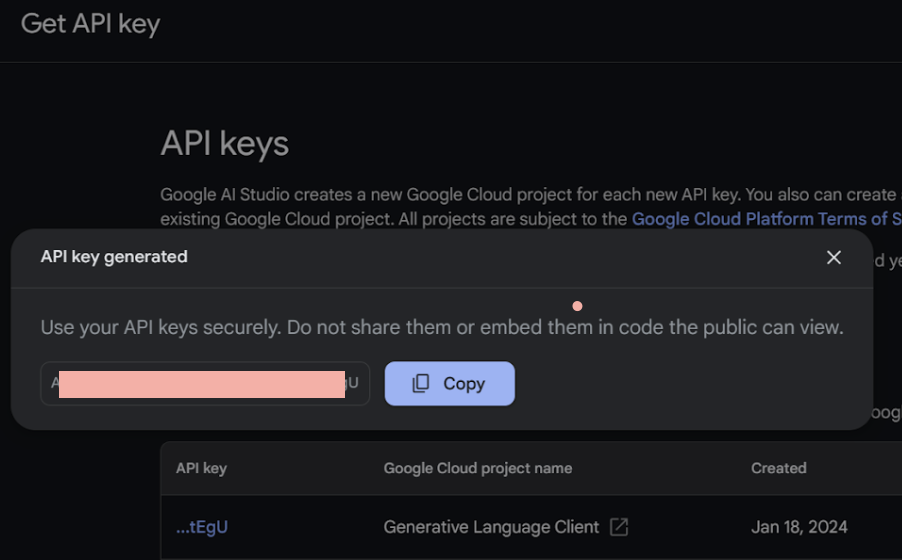
Als Nächstes legst du das Projekt an und erzeugst den API-Schlüssel.
Installieren wir zunächst das Gemini-Python-API-Paket mit pip.
%pip install google-generativeaiDann starten wir ein Jupyter-Notebook und importieren die für unser Projekt benötigten Python-Bibliotheken.
import google.generativeai as genai
from google.generativeai.types import ContentType
from PIL import Image
from IPython.display import Markdown
import time
import cv2Beginnen wir damit, unseren API-Schlüssel in die Variable GOOGLE_API_KEY einzutragen und zu konfigurieren:
GOOGLE_API_KEY = ‘your-api-key-goes-here’
genai.configure(api_key=GOOGLE_API_KEY)
Bevor wir die API aufrufen, prüfen wir die über die kostenlose API verfügbaren Modelle.
for m in genai.list_models():
	if 'generateContent' in m.supported_generation_methods:
    	print(m.name)
models/gemini-1.0-pro
models/gemini-1.0-pro-001
models/gemini-1.0-pro-latest
models/gemini-1.0-pro-vision-latest
models/gemini-1.5-flash-latest
models/gemini-1.5-pro-latest
models/gemini-pro
models/gemini-pro-visionGreifen wir auf das Modell gemini-1.5-pro-latest zu:
model = genai.GenerativeModel('gemini-1.5-pro-latest')Jetzt tätigen wir unseren ersten API-Call und prompten Gemini 1.5 Pro!
response = model.generate_content("Please provide a list of the most influential people in the world.")
print(response.text)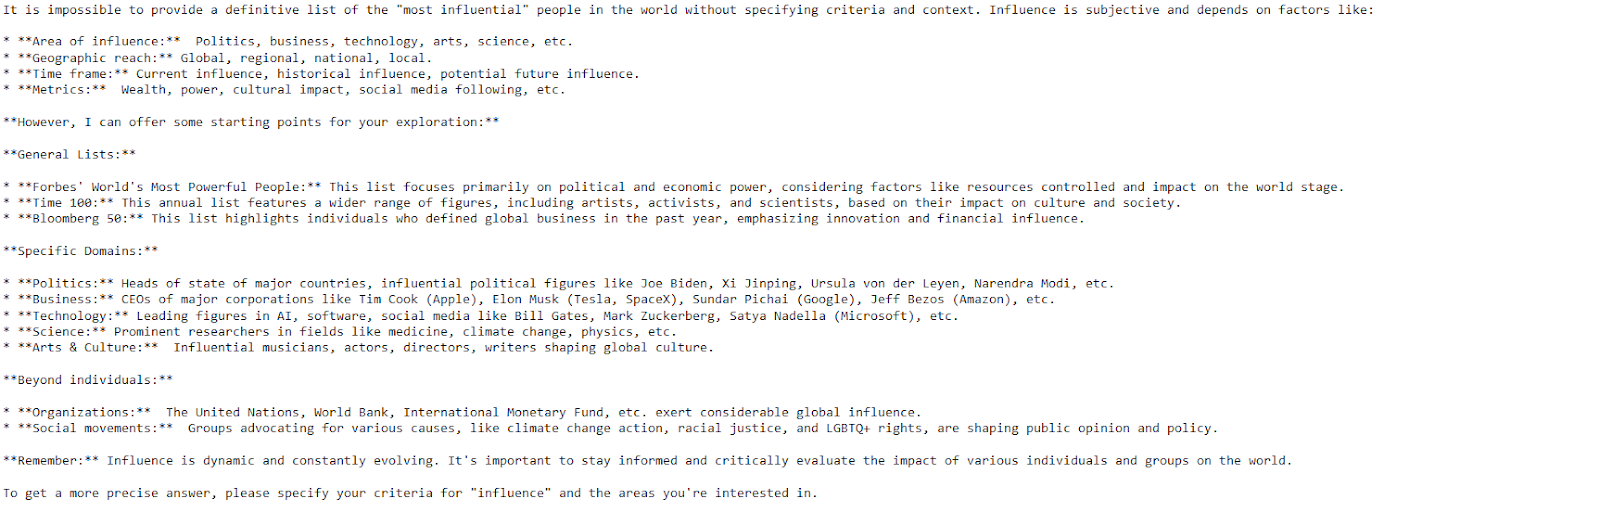
Mit nur wenigen Codezeilen liefert das Modell eine klare, detaillierte Antwort.
Gemini AI kann mehrere Antworten auf einen Prompt erzeugen, sogenannte Candidates, aus denen du die passendste auswählen kannst. 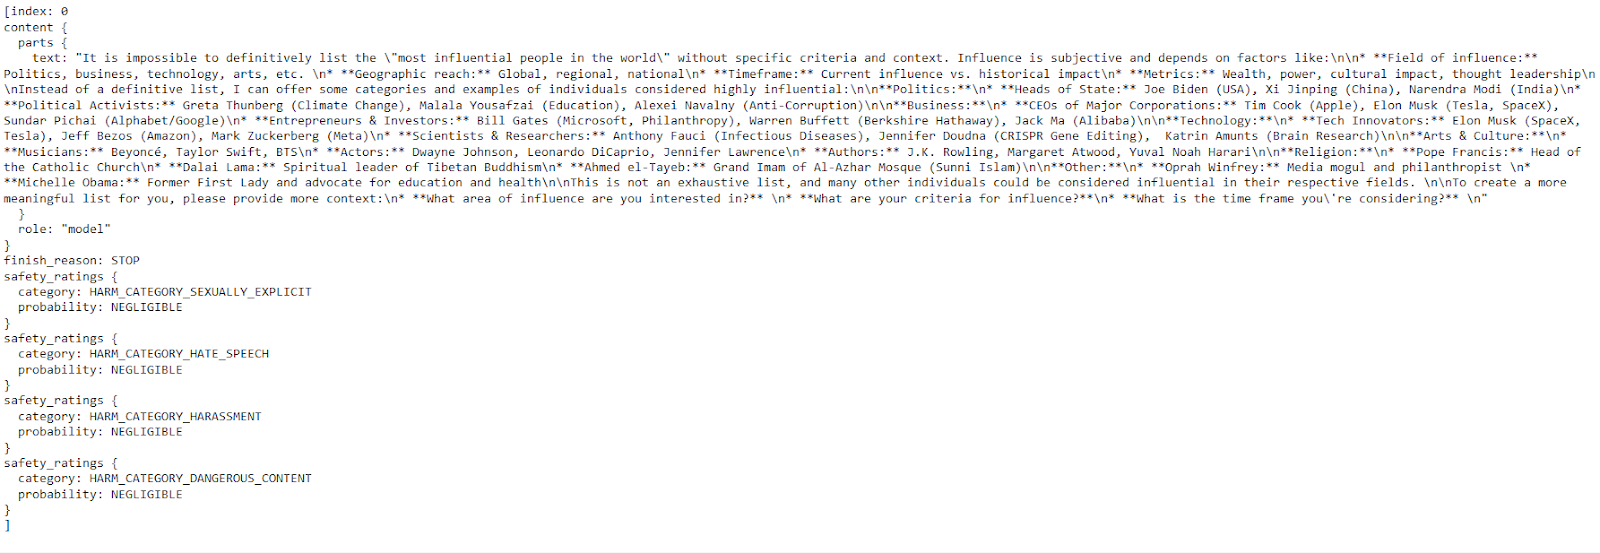
In diesem Abschnitt zeigen wir, wie du mit Gemini 1.5 Pro automatisch eine Liste von Büchern aus einem Bild extrahierst.
Betrachten wir zuerst dieses Bild:
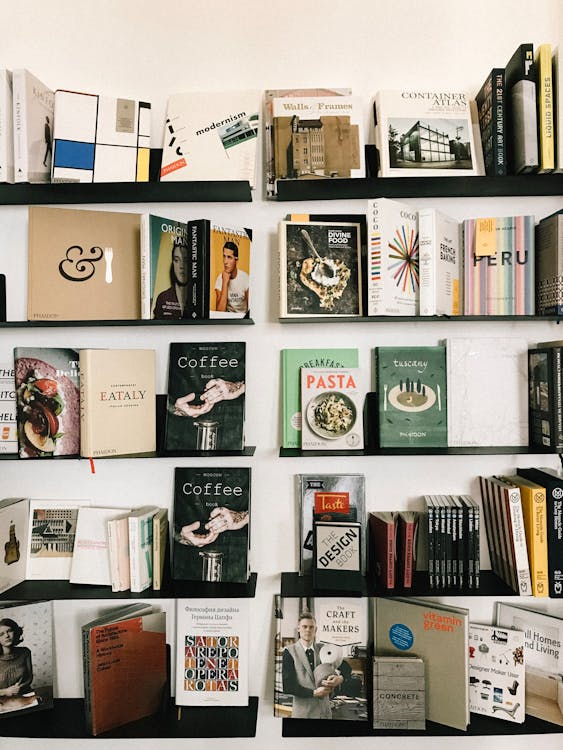
Ein Bild eines Bücherregals mit mehreren gestapelten Büchern.
Weisen wir das Modell an, die Buchtitel im Bild zu erkennen und in eine bestimmte Reihenfolge zu bringen:
text_prompt = "List all the books and help me organize them into three categories."Als Nächstes öffnen wir unsere Bilddatei "bookshelf.jpeg" mit der Klasse Image und bereiten sie für die Analyse durch das Modell vor.
bookshelf_image = Image.open('bookshelf.jpeg')Jetzt packen wir text_prompt und bookshelf_image in eine Liste und prompten das Modell:
prompt = [text_prompt, bookshelf_image]
response = model.generate_content(prompt)
Damit die Ausgabe nicht in Markdown formatiert ist, verwenden wir das IPython-Markdown-Tool.
Markdown(response.text)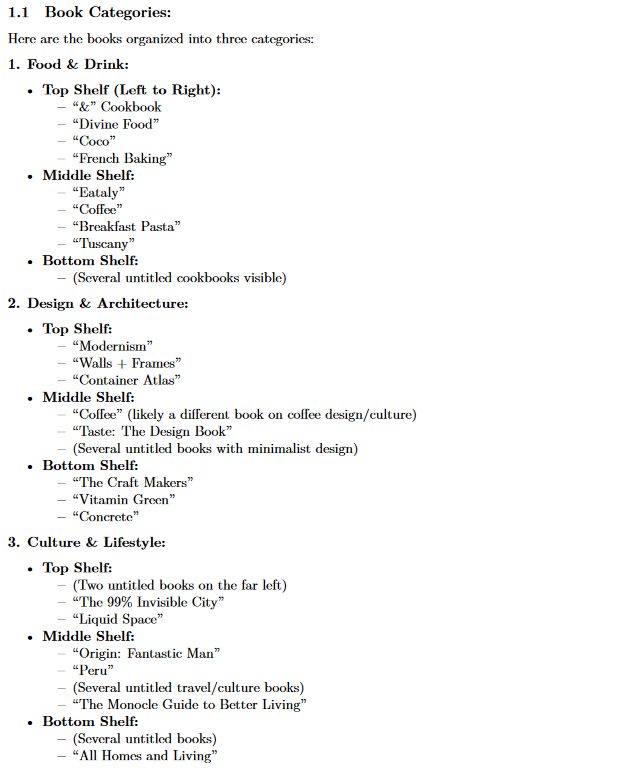
Das Modell hat alle im hochgeladenen Bild vorhandenen Bücher erfolgreich in drei Kategorien einsortiert.
In diesem Tutorial haben wir Gemini 1.5 Pro vorgestellt, die erste Veröffentlichung der Gemini-1.5-Familie. Neben den multimodalen Fähigkeiten und der Effizienz erweitert Gemini 1.5 Pro das Kontextfenster gegenüber der Gemini-1.0-Reihe von 32k auf mehrere Millionen Tokens.
Ob mit Text, Bildern, Video oder Audio – die Gemini 1.5 Pro API bietet die Flexibilität, viele Anwendungen abzudecken: von Information-Retrieval und Q&A bis zu Content-Erstellung und Übersetzung.
Wenn du tiefer in KI einsteigen willst, schau dir den sechsteiligen AI Fundamentals Lernpfad an.
Erfahre mehr über LLMs!
Lernpfad
Kurs
Kurs