Cursus
Principes fondamentaux de l'IA
10 h
Gemini 1.5 Pro marque une avancée majeure au sein de la famille Gemini. Il introduit un raisonnement sur de très longs contextes, ce qui nous permet de travailler avec d’immenses jeux de données sur plusieurs modalités (texte, vidéo et audio).
Dans ce tutoriel, nous allons apprendre à nous connecter à l’API Gemini 1.5 Pro. Nous verrons comment exécuter des tâches telles que la recherche, les questions-réponses sur de longs documents et des vidéos, la reconnaissance automatique de la parole (ASR) sur long contexte, ainsi que l’apprentissage en contexte.
Pour en savoir plus sur Gemini, consultez cet article : What is Google Gemini.
Gemini AI regroupe une série de modèles d’IA générative développés conjointement par plusieurs équipes de Google, notamment Google Research et Google DeepMind.
Ces modèles, dotés de solides capacités pour des tâches multimodales généralistes, sont conçus pour aider les développeurs en génération de contenu et en résolution de problèmes. Chaque variante est optimisée pour des cas d’usage spécifiques, afin d’offrir des performances optimales dans des contextes variés.
Gemini AI concilie ressources de calcul et fonctionnalités en proposant trois tailles de modèles :
|
Modèle |
Taille |
Capacités |
Cas d’usage idéaux |
|
Gemini Ultra |
La plus grande |
La plus performante, gère des tâches très complexes |
Applications exigeantes, projets à grande échelle, problématiques complexes |
|
Gemini Pro |
Intermédiaire |
Polyvalente, adaptée à un large éventail de tâches, scalable |
Applications généralistes, scénarios variés, projets nécessitant un bon équilibre entre puissance et efficacité |
|
Gemini Nano |
La plus petite |
Légère et efficace, optimisée pour l’exécution sur appareil et les environnements contraints |
Applications mobiles, systèmes embarqués, tâches avec ressources limitées, traitement en temps réel pen_spark |
Nous nous concentrerons principalement sur Gemini 1.5 Pro, le premier modèle publié de la série Gemini 1.5.
Avec sa fenêtre de contexte allant jusqu’à au moins 10 millions de tokens, Gemini 1.5 Pro relève le défi de la compréhension de très longs contextes dans un large éventail d’applications concrètes.
Une évaluation approfondie de tâches à longues dépendances a été menée pour analyser ses capacités sur longs contextes. Le modèle a brillamment réussi l’épreuve du « aiguille dans une botte de foin », atteignant un rappel quasi parfait (> 99 %) de « l’aiguille » au sein de bottes de foin de plusieurs millions de tokens, et ce sur toutes les modalités : texte, vidéo et audio.
Cette performance de rappel se maintient même pour des bottes de foin atteignant 10 millions de tokens en modalité texte.
Gemini 1.5 Pro a surpassé tous les modèles concurrents, y compris ceux dotés de méthodes de recherche externes, notamment sur des tâches exigeant la compréhension des interdépendances entre de multiples éléments de preuve répartis sur l’ensemble d’un long contenu, comme les questions-réponses à longues dépendances.
Gemini 1.5 Pro a également démontré une remarquable capacité d’apprentissage en contexte permise par des textes très longs, comme traduire une nouvelle langue à partir d’un unique jeu de documents linguistiques.
Cette progression sur les longs contextes est d’autant plus notable qu’elle ne compromet pas les capacités multimodales fondamentales du modèle. Par rapport à son prédécesseur (1.0 Pro), il s’améliore nettement dans plusieurs domaines (+28,9 % en mathématiques, sciences et raisonnement).
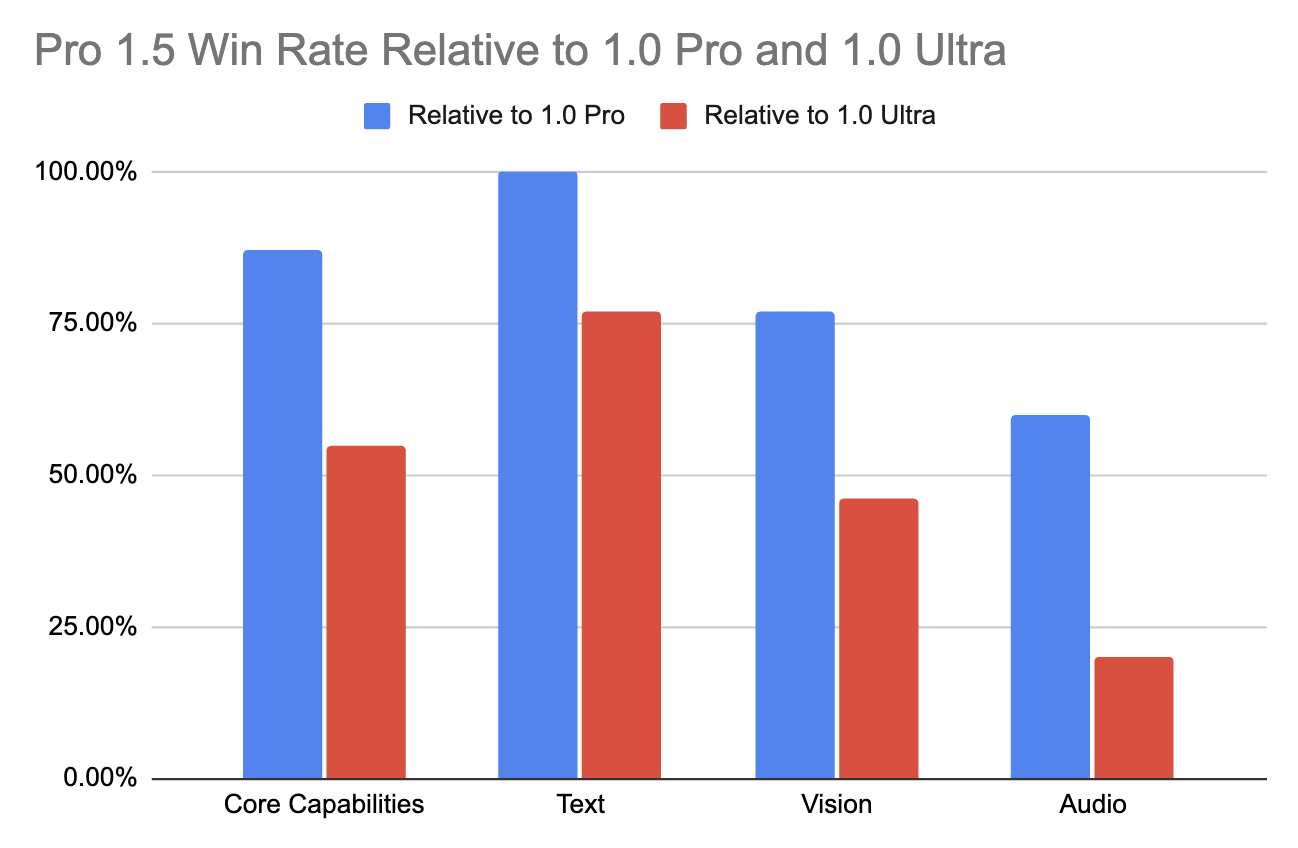
Il dépasse même le modèle haut de gamme 1.0 Ultra sur plus de la moitié des benchmarks, avec une performance particulièrement forte en tâches texte et vision (voir le tableau ci-dessous), tout en nécessitant moins de ressources et en étant plus économe en calcul.
Pour aller plus loin, je vous recommande le rapport technique : « Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context ».
La capacité à traiter plusieurs millions de tokens ouvre la voie à de nouvelles applications concrètes.
Gemini 1.5 Pro s’applique largement au génie logiciel. En ayant en contexte l’intégralité de la base de code JAX (746 152 tokens), il peut localiser précisément l’emplacement d’une méthode centrale de différenciation automatique.
Avec l’accès à une grammaire de référence et à une liste de mots bilingue (environ 250 000 au total), Gemini 1.5 Pro peut traduire de l’anglais vers le Kalamang avec une qualité comparable à celle d’une personne ayant étudié avec les mêmes ressources.
La très faible quantité de données en ligne disponibles pour le Kalamang (moins de 200 locuteurs) oblige Gemini 1.5 Pro à s’appuyer exclusivement sur le contexte fourni dans chaque prompt pour comprendre et traduire la langue. Ce résultat ouvre des perspectives prometteuses pour l’utilisation de LLM à contexte étendu afin d’aider à préserver et revitaliser des langues menacées, et de favoriser la communication et la compréhension entre différentes communautés linguistiques.
Gemini 1.5 Pro peut aussi répondre à une requête image en s’appuyant sur le texte intégral des Misérables (1 382 pages, 732 k tokens). Nativement multimodal, le modèle identifie une scène célèbre à partir d’un croquis à main levée.
Avec un film muet de 45 minutes, « Sherlock Jr. » (2 674 images à 1 FPS, 684 k tokens), Gemini 1.5 Pro retrouve et extrait l’information textuelle d’une image précise et fournit l’horodatage correspondant. Il peut également identifier une scène du film à partir d’un croquis à main levée.
Maintenant que nous connaissons les capacités et cas d’usage de Gemini 1.5 Pro, voyons comment se connecter à son API.
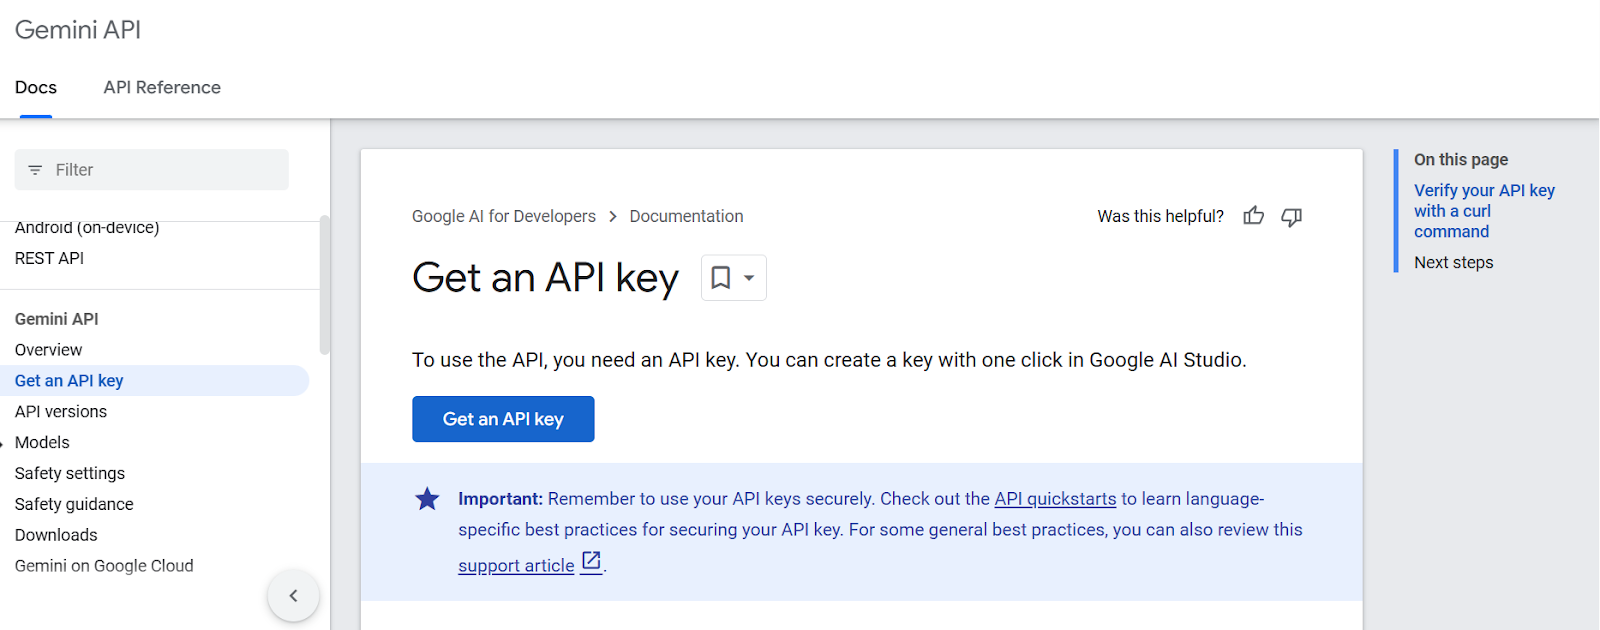
Commencez par récupérer une clé API depuis la page Google AI for Developers (assurez-vous d’être connecté à votre compte Google). Cliquez sur le bouton Get an API key :
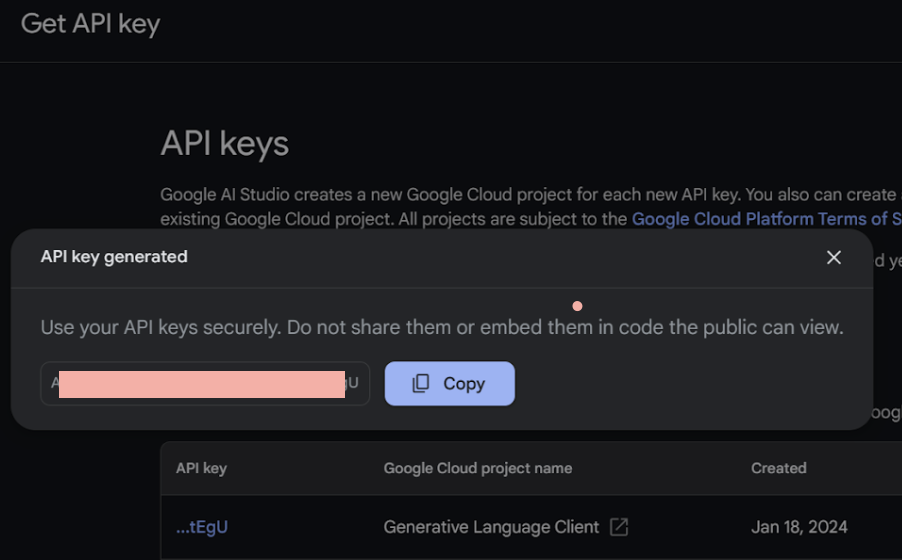
Ensuite, créez le projet et générez la clé API.
Installons d’abord le package Python de l’API Gemini avec pip.
%pip install google-generativeaiLançons ensuite notre notebook Jupyter et importons les bibliothèques Python essentielles pour le projet.
import google.generativeai as genai
from google.generativeai.types import ContentType
from PIL import Image
from IPython.display import Markdown
import time
import cv2Renseignez d’abord votre clé API dans la variable GOOGLE_API_KEY et configurez-la :
GOOGLE_API_KEY = ‘your-api-key-goes-here’
genai.configure(api_key=GOOGLE_API_KEY)
Avant d’appeler l’API, listons les modèles disponibles via l’API gratuite.
for m in genai.list_models():
	if 'generateContent' in m.supported_generation_methods:
    	print(m.name)
models/gemini-1.0-pro
models/gemini-1.0-pro-001
models/gemini-1.0-pro-latest
models/gemini-1.0-pro-vision-latest
models/gemini-1.5-flash-latest
models/gemini-1.5-pro-latest
models/gemini-pro
models/gemini-pro-visionAccédons au modèle gemini-1.5-pro-latest :
model = genai.GenerativeModel('gemini-1.5-pro-latest')Faisons maintenant notre premier appel API et sollicitons Gemini 1.5 Pro !
response = model.generate_content("Please provide a list of the most influential people in the world.")
print(response.text)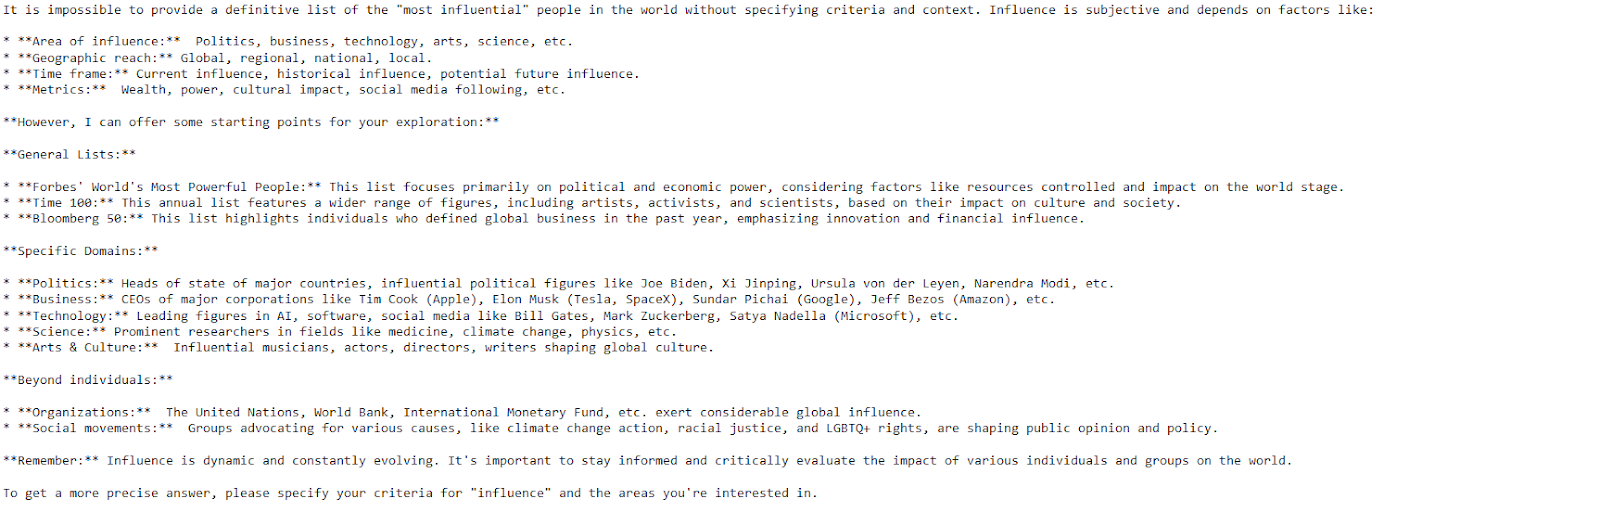
Le modèle fournit une réponse claire et détaillée avec seulement quelques lignes de code.
Gemini AI peut produire plusieurs réponses, appelées « candidats », pour un même prompt, ce qui vous permet de choisir la plus pertinente. 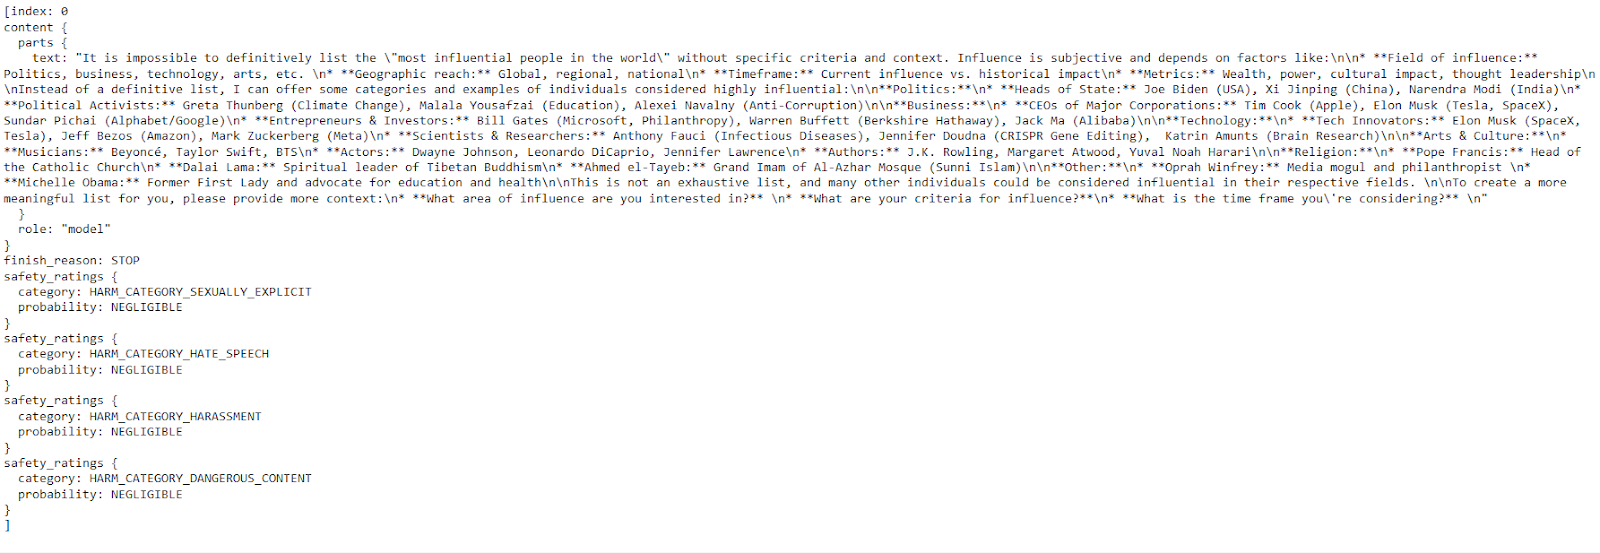
Dans cette section, nous allons voir comment exploiter Gemini 1.5 Pro pour automatiser l’extraction d’une liste de livres à partir d’une image !
Partons de cette image :
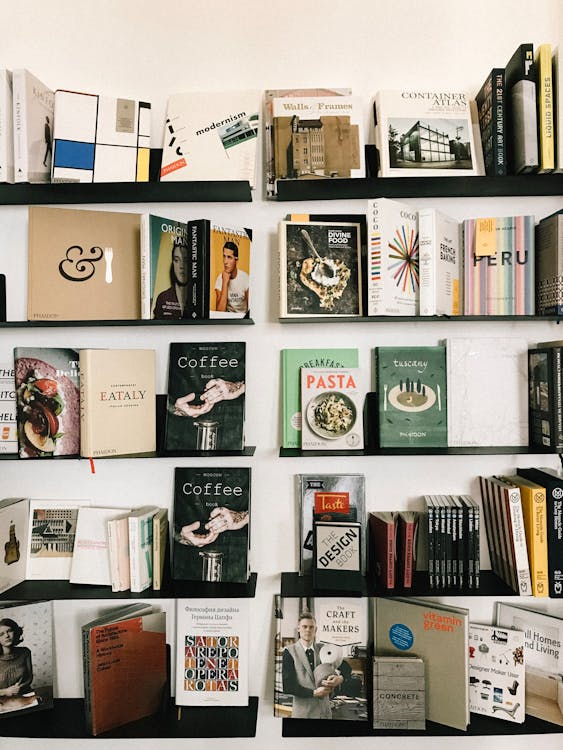
Une photo d’une étagère avec plusieurs livres empilés.
Demandons d’abord au modèle d’identifier et de lister les titres visibles dans l’image en suivant un ordre précis :
text_prompt = "List all the books and help me organize them into three categories."Ouvrons ensuite notre image "bookshelf.jpeg" avec la classe Image pour la préparer à l’analyse par le modèle.
bookshelf_image = Image.open('bookshelf.jpeg')Plaçons text_prompt et bookshelf_image dans une liste et interrogeons le modèle :
prompt = [text_prompt, bookshelf_image]
response = model.generate_content(prompt)
Pour éviter une sortie en format Markdown, utilisons l’outil Markdown d’IPython.
Markdown(response.text)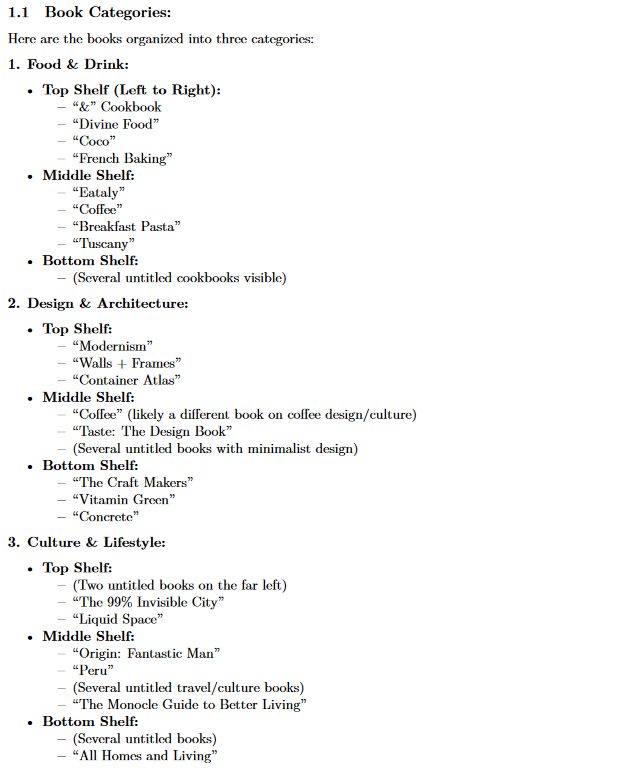
Le modèle a réussi à classer tous les livres présents dans l’image téléchargée en trois catégories distinctes.
Dans ce tutoriel, nous avons présenté Gemini 1.5 Pro, la première version de la famille Gemini 1.5. Au-delà de ses capacités multimodales et de son efficacité, Gemini 1.5 Pro élargit la fenêtre de contexte par rapport à la série Gemini 1.0, de 32 k à plusieurs millions de tokens.
Que vous travailliez avec du texte, des images, de la vidéo ou de l’audio, l’API Gemini 1.5 Pro offre la flexibilité nécessaire pour traiter de nombreuses applications, de la recherche d’information et des questions-réponses à la génération de contenu et à la traduction.
Pour approfondir vos connaissances en IA, découvrez ce parcours de compétences en six cours : AI Fundamentals.
Approfondissez vos connaissances sur les LLM !
Cursus
Cours
Cours
blog
Kurtis Pykes
9 min
Tutoriel
Tutoriel
Moez Ali
6 min
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Sejal Jaiswal
24 min
Tutoriel
Adel Nehme
3 min




