Programma
Nozioni di base sull'intelligenza artificiale
10 ore
Gemini 1.5 Pro rappresenta un avanzamento significativo nella famiglia Gemini. Introduce il ragionamento su contesti lunghi, che ci permette di lavorare con dataset enormi su varie modalità (testo, video e audio).
In questo tutorial impareremo come connetterci all'API di Gemini 1.5 Pro. Vedremo come eseguire attività come retrieval, question answering su documenti e video lunghi, riconoscimento vocale automatico (ASR) su contesti estesi e in-context learning.
Se vuoi saperne di più su Gemini, dai un'occhiata a questo articolo: Cos'è Google Gemini.
Gemini AI comprende una serie di modelli di AI generativa sviluppati in collaborazione da più team all'interno di Google, tra cui Google Research e Google DeepMind.
Questi modelli, dotati di solide capacità per compiti multimodali generici, sono progettati per supportare gli sviluppatori nella generazione di contenuti e nella risoluzione di problemi. Ogni variante è ottimizzata per casi d'uso specifici, garantendo prestazioni ottimali in scenari diversi.
Gemini AI bilancia risorse computazionali e funzionalità offrendo tre dimensioni di modelli:
|
Modello |
Dimensione |
Capacità |
Casi d'uso ideali |
|
Gemini Ultra |
La più grande |
La più capace, gestisce compiti altamente complessi |
Applicazioni impegnative, progetti su larga scala, problem solving complesso |
|
Gemini Pro |
Media |
Versatile, adatta a un'ampia gamma di compiti, scalabile |
Applicazioni generiche, adattabile a scenari diversi, progetti che richiedono un equilibrio tra potenza ed efficienza |
|
Gemini Nano |
La più piccola |
Leggera ed efficiente, ottimizzata per ambienti on-device e con risorse limitate |
Applicazioni mobile, sistemi embedded, compiti con risorse computazionali limitate, elaborazione in tempo reale pen_spark |
Il nostro focus principale sarà su Gemini 1.5 Pro, il primo modello rilasciato all'interno della serie Gemini 1.5.
Gemini 1.5 Pro, con una finestra di contesto ampia fino ad almeno 10 milioni di token, può affrontare la sfida di comprendere contesti lunghi in un ampio spettro di applicazioni nel mondo reale.
È stata condotta una valutazione completa di compiti a lunga dipendenza per esaminare a fondo le capacità di lungo contesto del modello Gemini 1.5 Pro. Il modello ha affrontato con destrezza il difficile compito della "pagliaio con ago", ottenendo un richiamo quasi perfetto (>99%) dell'"ago" anche in pagliai di diversi milioni di token in tutte le modalità, includendo testo, video e audio.
Queste prestazioni di richiamo sono state mantenute anche con pagliai che raggiungevano i 10 milioni di token nella modalità testo.
Il modello Gemini 1.5 Pro ha superato tutti i modelli concorrenti, inclusi quelli potenziati con metodi di retrieval esterni, soprattutto in compiti che richiedono la comprensione delle interdipendenze tra molteplici evidenze distribuite su tutto il contenuto lungo, come i casi di Question-Answer (QA) a lunga dipendenza.
Gemini 1.5 Pro ha inoltre mostrato la notevole capacità, abilitata dal testo molto lungo, di apprendere compiti in contesto, come tradurre una nuova lingua a partire da un unico set di documentazione linguistica.
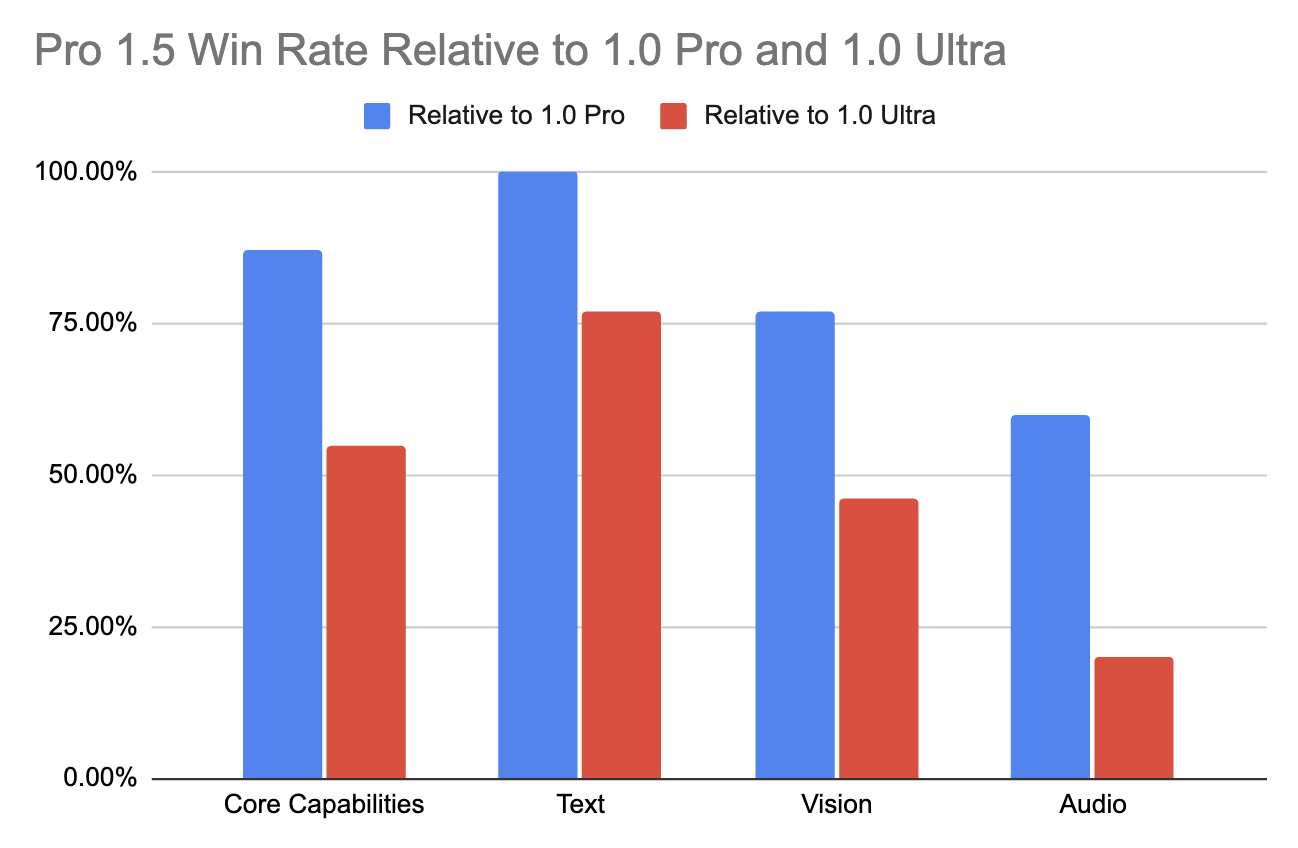
Questo progresso nelle prestazioni su contesti lunghi di Gemini 1.5 Pro è degno di nota perché non compromette le capacità multimodali fondamentali del modello. Rispetto al suo predecessore (1.0 Pro), migliora in modo sostanziale in varie aree (+28,9% in Matematica, Scienze e Ragionamento).
Supera persino il modello di punta 1.0 Ultra in oltre la metà dei benchmark, eccellendo in particolare nei compiti di testo e visione (come mostrato nella tabella sotto). Il tutto richiedendo meno risorse ed essendo più efficiente dal punto di vista computazionale.
Per approfondimenti più dettagliati, consiglio di consultare il rapporto tecnico: “Gemini 1.5: Unlocking multimodal understanding across millions of tokens of context”.
Con la capacità di elaborare diversi milioni di token, emergono nuove applicazioni pratiche.
Gemini 1.5 Pro può essere ampiamente utilizzato nell'ingegneria del software. Avendo in contesto l'intero codebase JAX da 746.152 token, Gemini 1.5 Pro può individuare l'esatta posizione di un metodo chiave di differenziazione automatica.
Con accesso a una grammatica di riferimento e a un glossario bilingue (per un totale di ~250k), Gemini 1.5 Pro può tradurre dall'inglese al Kalamang con una qualità paragonabile a quella di un essere umano che abbia studiato con le stesse risorse.
La disponibilità limitata di dati online per il Kalamang (meno di 200 parlanti) costringe Gemini 1.5 Pro a basarsi esclusivamente sul contesto fornito in ciascun prompt per comprendere e tradurre la lingua. Questo risultato suggerisce opportunità promettenti per utilizzare LLM con capacità contestuali estese per aiutare a preservare e rivitalizzare le lingue in pericolo e favorire la comunicazione e la comprensione tra comunità linguistiche diverse.
Gemini 1.5 Pro può anche rispondere a una query su un'immagine avendo a disposizione l'intero testo de I Miserabili (1382 pagine, 732k token). Essendo nativamente multimodale, il modello può identificare una scena famosa da uno schizzo a mano.
Dato un film muto di 45 minuti “Sherlock Jr.” (2.674 frame a 1 FPS, 684k token), Gemini 1.5 Pro recupera ed estrae informazioni testuali da un frame specifico e fornisce il relativo timestamp. Il modello può anche identificare una scena del film a partire da uno schizzo a mano.
Ora che conosciamo le capacità e le applicazioni di Gemini 1.5 Pro, vediamo come connetterci alla sua API.
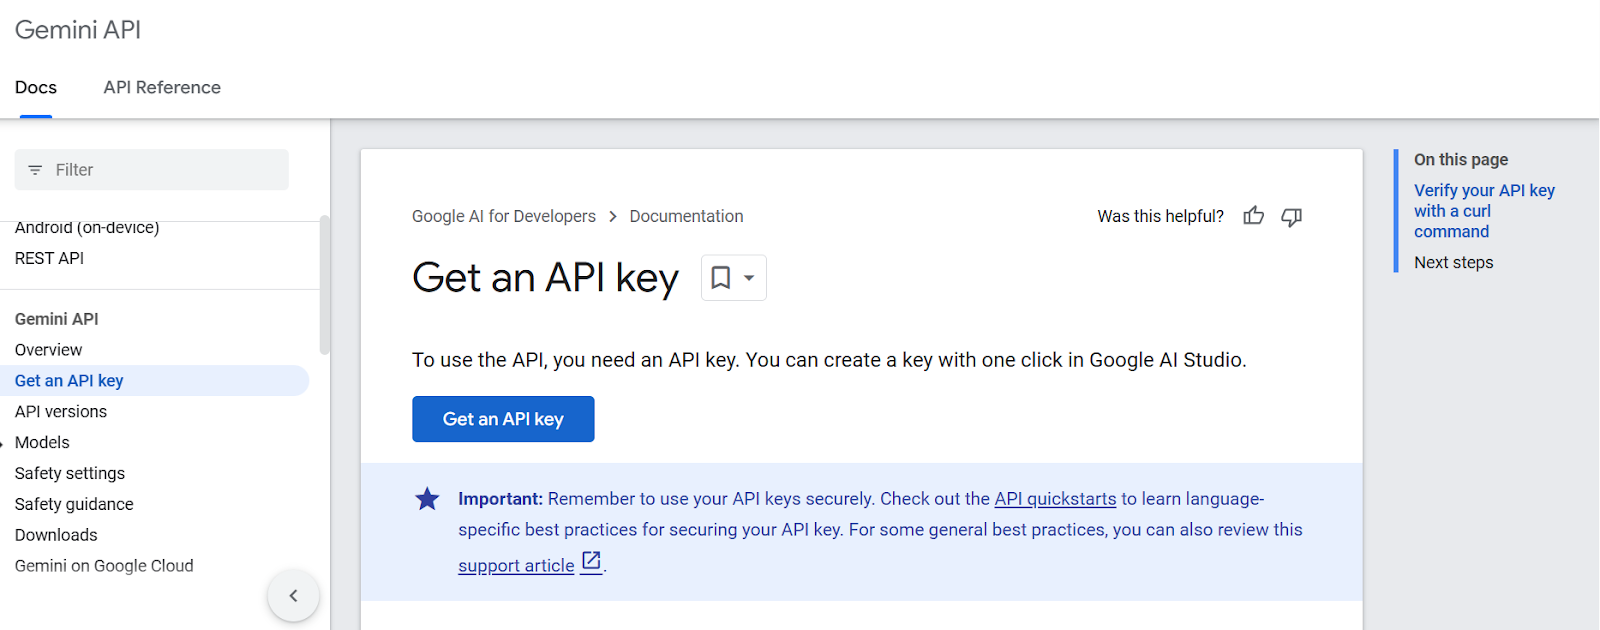
Per prima cosa dobbiamo ottenere una chiave API dalla pagina Google AI for Developers (assicurati di aver effettuato l'accesso al tuo account Google). Possiamo farlo cliccando sul pulsante Get an API key:
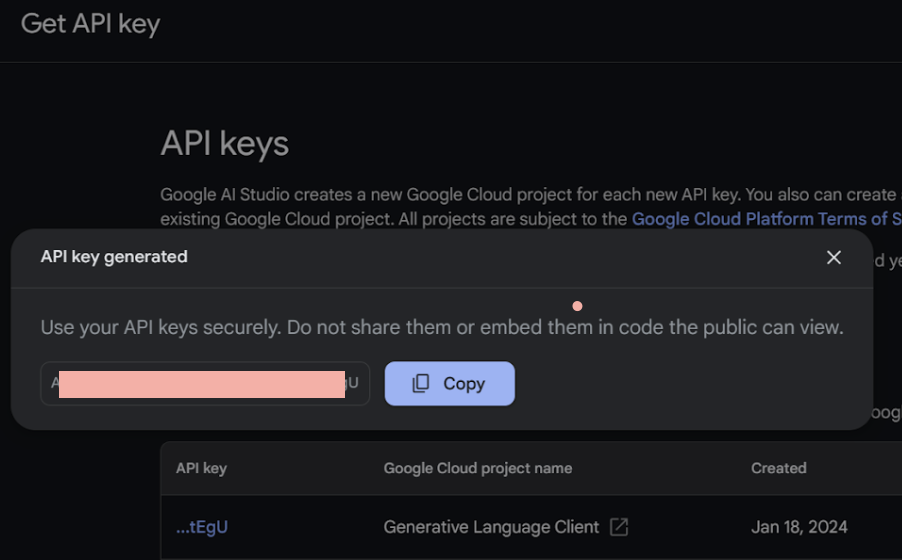
Successivamente, dobbiamo impostare il progetto e generare la chiave API.
Per prima cosa installiamo il pacchetto Python dell'API di Gemini usando pip.
%pip install google-generativeaiPoi apriamo il nostro notebook Jupyter e importiamo le librerie Python essenziali richieste per il progetto.
import google.generativeai as genai
from google.generativeai.types import ContentType
from PIL import Image
from IPython.display import Markdown
import time
import cv2Iniziamo inserendo la nostra chiave API nella variabile GOOGLE_API_KEY e configurandola:
GOOGLE_API_KEY = ‘your-api-key-goes-here’
genai.configure(api_key=GOOGLE_API_KEY)
Prima di chiamare l'API, verifichiamo i modelli disponibili tramite l'API gratuita.
for m in genai.list_models():
	if 'generateContent' in m.supported_generation_methods:
    	print(m.name)
models/gemini-1.0-pro
models/gemini-1.0-pro-001
models/gemini-1.0-pro-latest
models/gemini-1.0-pro-vision-latest
models/gemini-1.5-flash-latest
models/gemini-1.5-pro-latest
models/gemini-pro
models/gemini-pro-visionAccediamo al modello gemini-1.5-pro-latest:
model = genai.GenerativeModel('gemini-1.5-pro-latest')Ora effettuiamo la nostra prima chiamata API e chiediamo qualcosa a Gemini 1.5 Pro!
response = model.generate_content("Please provide a list of the most influential people in the world.")
print(response.text)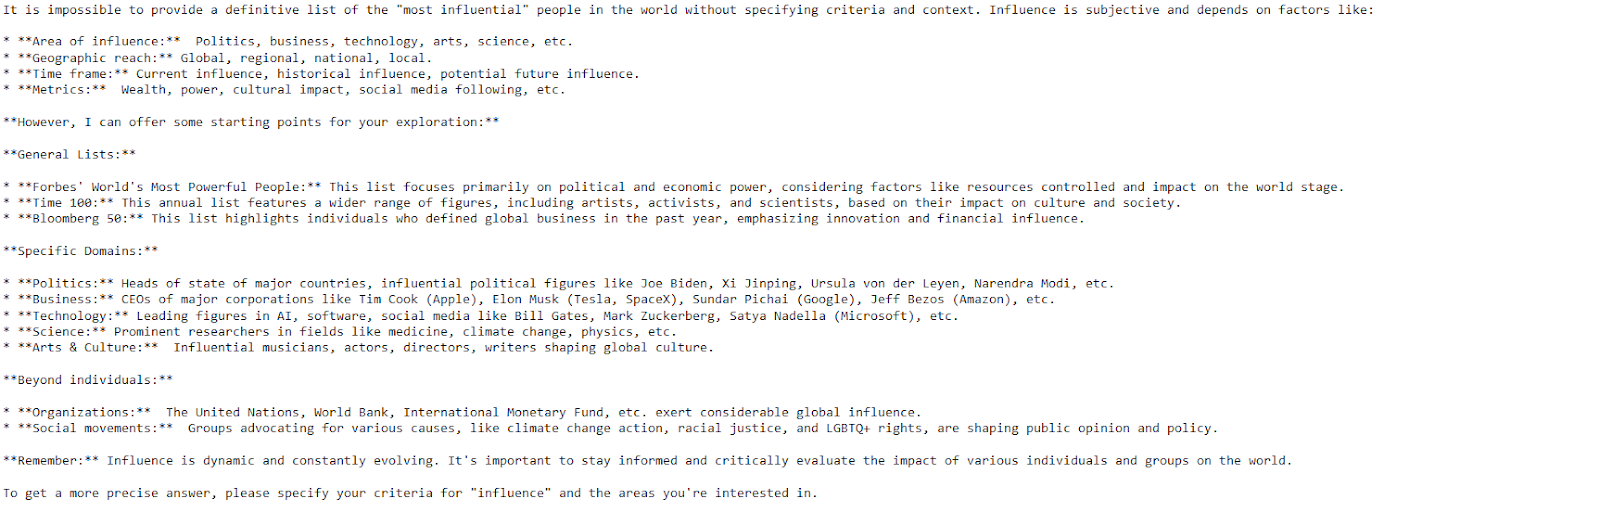
Il modello ha fornito una risposta chiara e dettagliata con poche righe di codice.
Gemini AI può produrre più risposte, chiamate candidate, a un prompt, permettendoti di selezionare quella più appropriata. 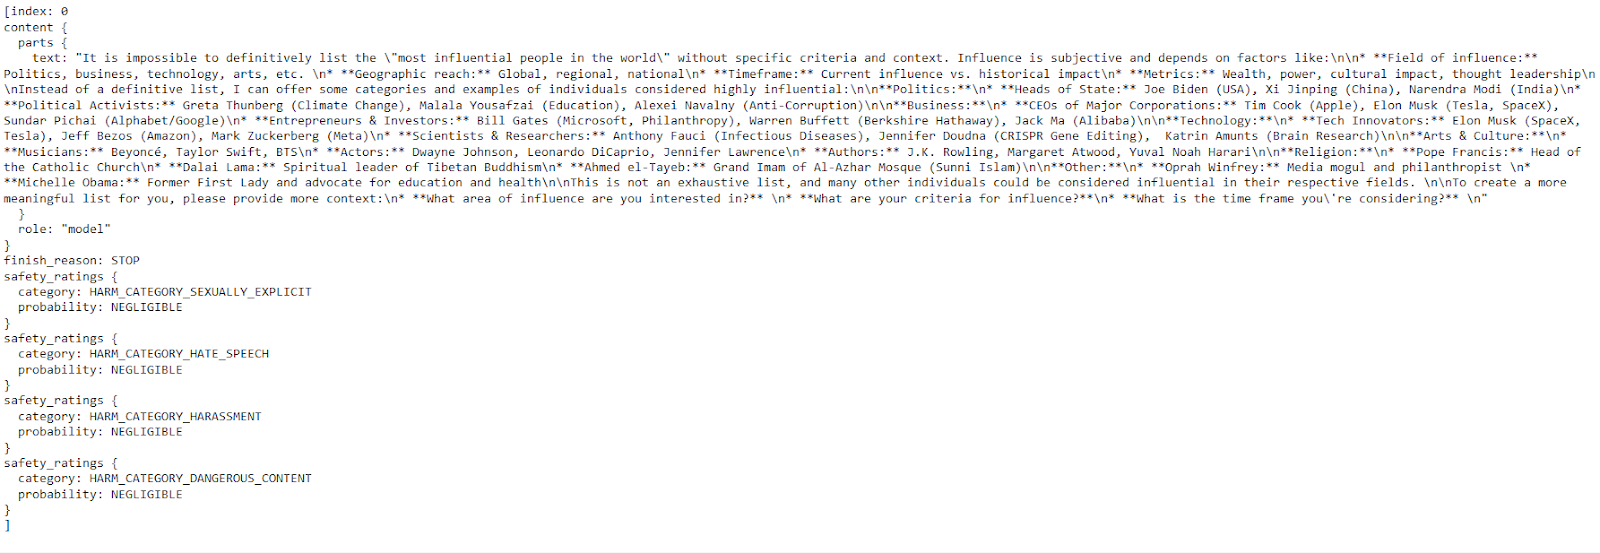
In questa sezione impareremo a sfruttare Gemini 1.5 Pro per automatizzare l'estrazione di un elenco di libri da un'immagine!
Consideriamo prima questa immagine:
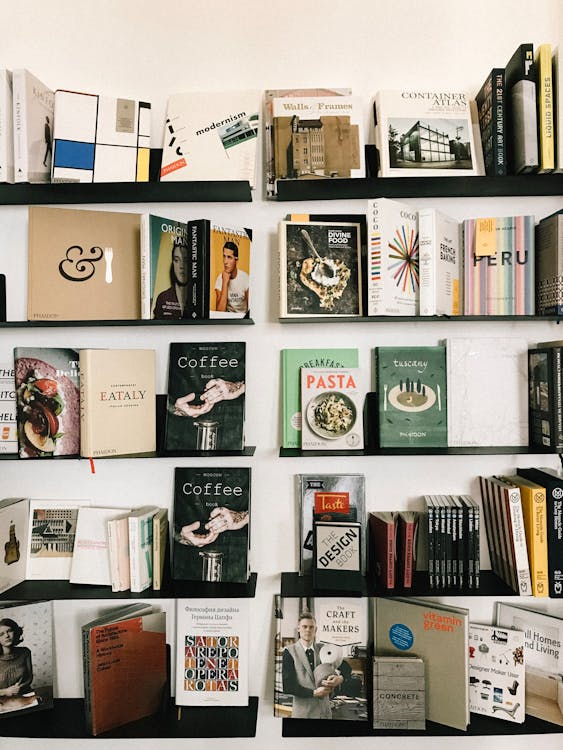
Un'immagine di una libreria con diversi libri impilati.
Istruiremo il modello a identificare ed elencare i titoli dei libri nell'immagine seguendo un ordine specifico:
text_prompt = "List all the books and help me organize them into three categories."Poi apriremo l'immagine "bookshelf.jpeg" usando la classe Image, preparandola all'analisi del modello.
bookshelf_image = Image.open('bookshelf.jpeg')Mettiamo sia text_prompt sia bookshelf_image in una lista e inviamo il prompt al modello:
prompt = [text_prompt, bookshelf_image]
response = model.generate_content(prompt)
Per evitare di avere l'output in formato Markdown, usiamo lo strumento Markdown di IPython.
Markdown(response.text)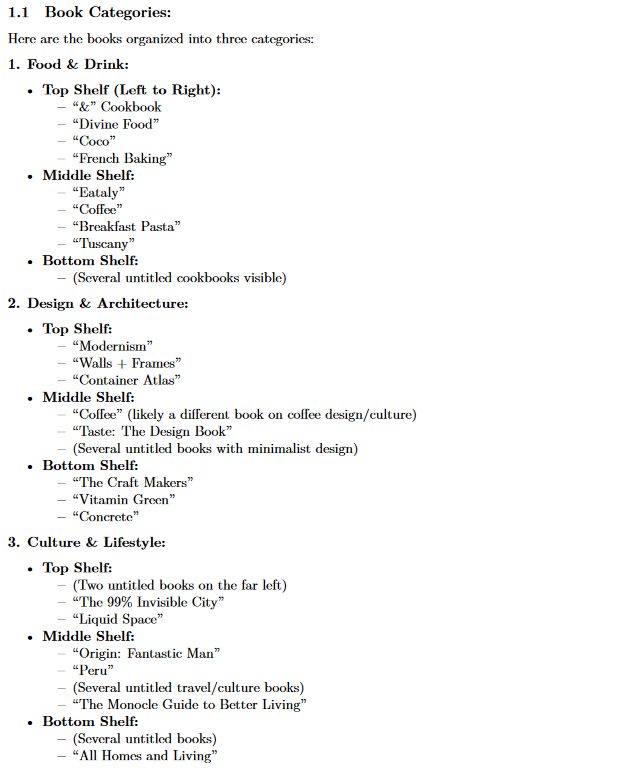
Il modello è riuscito a categorizzare con successo tutti i libri presenti nell'immagine caricata in tre categorie diverse.
In questo tutorial abbiamo presentato Gemini 1.5 Pro, il primo rilascio della famiglia Gemini 1.5. Oltre alle sue capacità multimodali e all'efficienza, Gemini 1.5 Pro amplia la finestra di contesto rispetto alla serie Gemini 1.0 da 32k a diversi milioni di token.
Che tu stia lavorando con testo, immagini, video o audio, l'API di Gemini 1.5 Pro offre la flessibilità per affrontare varie applicazioni, dal retrieval e question answering alla generazione di contenuti e alla traduzione.
Se vuoi saperne di più sull'AI, scopri questo percorso di competenze in sei corsi: AI Fundamentals.
Scopri di più sugli LLM!
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



