您正在进行一个数据分析项目,需要包含团队在另一个仓库中维护的共享工具库。您可以复制粘贴代码,但那样就失去了更新路径。您也可以用 Git 子模块(submodule),但您听说它们很复杂。还有第三个选项:git subtree。
git subtree 允许您将一个 Git 仓库作为子目录嵌入到另一个仓库中,同时保留完整历史并提供便捷的更新路径。
本指南将介绍何时使用 git subtree、其工作原理,以及常见工作流的实用示例。我们将使用数据科学项目中实际会遇到的情境。
什么是 git subtree?
Git subtree 会在您的项目下的特定文件夹中引入另一个 Git 仓库,同时保留其完整的提交历史。与复制代码或使用符号链接不同,subtree 会保持与原始仓库的连接,因此您可以拉取更新并在需要时将更改推回去。
它与简单复制代码的不同之处在于:
复制粘贴代码:
- 与原始仓库无任何连接
- 库发生变化时无更新路径
- 没有代码来源的历史记录
Git subtree:
- 保留原始仓库的完整提交历史
- 一条命令即可拉取更新
- 如需,可将更改推回原始仓库
- 所有内容都在一个仓库检出中
与 Git 子模块的关键区别在于:subtree 的内容直接提交进您的主仓库。别人克隆您的项目时,无需额外步骤即可得到全部内容。
这总体上意味着更简单的上手流程,以及更少的“只在我机器上能跑”的问题。
git subtree 的工作原理
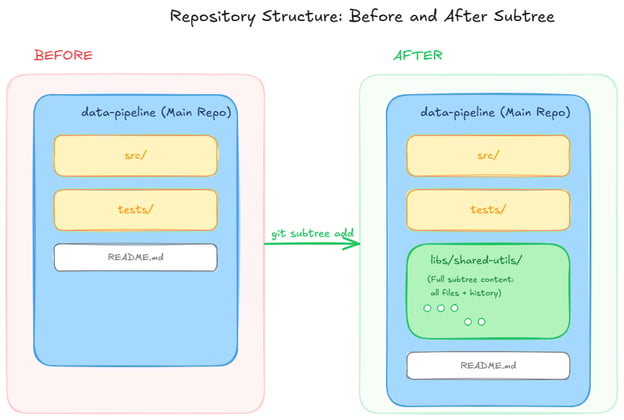
当您添加一个 subtree 时,Git 会做一件巧妙的事:把另一个仓库的历史合并进您项目的某个子目录。大致流程如下:
- Git 获取远程仓库的历史
- Git 重写这些提交,使其出现在您选择的子目录下
- Git 将这段重写后的历史合并到您当前分支
- 后续更新遵循相同模式:fetch、rewrite、merge
您的仓库包含来自 subtree 的实际文件和完整提交历史,而不仅是指针或引用。别人克隆您的项目或检出分支时,会立刻拥有所有代码。不需要单独“初始化子模块”的步骤。
取舍在于:您的仓库会变大,因为它包含您自己的代码以及 subtree 的代码和完整历史。是否值得?取决于具体情况,但对大多数数据科学团队来说,我认为值得。
如何使用 git subtree(常用命令)
现在了解了 subtree 的作用,我们来走一遍最常见的操作。我们采用一个真实场景:您在构建数据分析项目,需要包含一个共享的工具库。
示例设置:
git subtree add
add 命令用于首次将另一个仓库引入到您的项目中。
基础语法如下,供参考:
git subtree add --prefix=<directory> <remote-url> <branch> --squash技术支持
实际示例:
# 将 shared-utils 仓库添加到 libs/shared-utils 下
git subtree add --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash技术支持
其作用:
- 创建 libs/shared-utils 目录
- 将 shared-utils 中的所有文件复制进来
- 将一切提交到您的仓库
- 记录连接以便将来更新
参数说明:
何时使用 squash:除非您需要保留原仓库的详细提交归属,否则使用 --squash。对大多数带共享工具的数据项目来说,压缩后的历史更干净、更易用。我一直都用它。
运行后,您会在项目中看到一个新提交,消息类似于 “Add 'libs/shared-utils/' from commit 'abc123'”。目录 libs/shared-utils 现已包含所有文件,您可以立即使用。
git subtree pull
pull 命令用于用原始仓库的更改来更新您的 subtree。若共享库团队修复了一个 bug 或添加了功能,这就是获取更新的方式。
基础语法:
git subtree pull --prefix=<directory> <remote-url> <branch> --squash技术支持
实际示例:
# 从 shared-utils 拉取最新更改
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash技术支持
其作用:
- 从远程仓库获取新提交
- 将其合并到您的 libs/shared-utils 目录
- 在您的项目中创建一个合并提交
prefix 必须完全匹配。如果添加时用了 libs/shared-utils,那么 pull 也必须用 libs/shared-utils。用不同的前缀是行不通的。相信我。
关于 squash 的一致性:如果在 add 时使用了 --squash,之后每次 pull 都应使用 --squash。混用压缩和非压缩更新会让历史变得混乱。我是“踩过坑”才懂的。
处理冲突:如果您修改了 libs/shared-utils 中的文件,而上游也修改了相同文件,就会产生合并冲突。像处理任何 Git 合并冲突一样解决它们——编辑文件、暂存、更完成并合并。
在团队的 README 中记录是否使用 --squash,以保持一致性。
git subtree push
push 命令会将您在 subtree 文件夹中所做的更改推回到原始仓库。
基础语法:
git subtree push --prefix=<directory> <remote-url> <branch>技术支持
实际示例:
# 将 libs/shared-utils 中的更改推回原始仓库
git subtree push --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main技术支持
其作用:
- 仅提取影响了 libs/shared-utils 的提交
- 将它们重写为仿佛是在 shared-utils 仓库根目录完成
- 把这些提交推送到原始仓库
何时使用:当您在应用仓库中维护共享库,并希望将改进贡献回去。例如,您在 data-pipeline 项目中为 shared-utils 添加了一个有用的数据校验函数,其他项目也应从中受益。
可以把 push 看作 pull 的反向操作。pull 拉入更改;push 发送更改。Git 只提取相关历史,并将其转换回原始仓库的结构。相当巧妙。
您需要对原始仓库有写入权限。如果没有,您需要 fork 该仓库,推送到自己的 fork,然后创建一个 Pull Request。
git subtree split
split 命令会将某个子目录的历史提取到它自己的分支中。
基础语法:
git subtree split --prefix=<directory> -b <new-branch-name>技术支持
实际示例:
# 将 libs/shared-utils 提取为独立分支
git subtree split --prefix=libs/shared-utils -b shared-utils-extracted技术支持
其作用:
- 创建一个新分支,仅包含影响了 libs/shared-utils 的提交
- 该分支看起来像仅包含该目录的独立仓库
- 原分支保持不变
常见用例:
从单体仓库中剥离库:您的数据处理流水线规模扩大,想要将某个可复用组件提取为独立库。Split 会创建一个仅包含该组件历史的分支,随后您可以推送到新仓库。
将子目录发布为独立项目:您在分析项目中构建了一个有用的数据可视化模块,并希望以独立包的形式分享。Split 会在保留完整历史的前提下将其提取出来。
创建新独立仓库的示例流程:
# 提取子目录
git subtree split --prefix=libs/shared-utils -b shared-utils-standalone

# 创建新仓库并推送到该仓库
git remote add shared-utils-origin https://github.com/yourteam/shared-utils-new.git
git push shared-utils-origin shared-utils-standalone:main技术支持
现在,shared-utils-new 是一个完整的仓库,仅包含该子目录的完整历史。
git subtree 与 submodule
大家常问的问题:subtree 与 submodule 的比较。
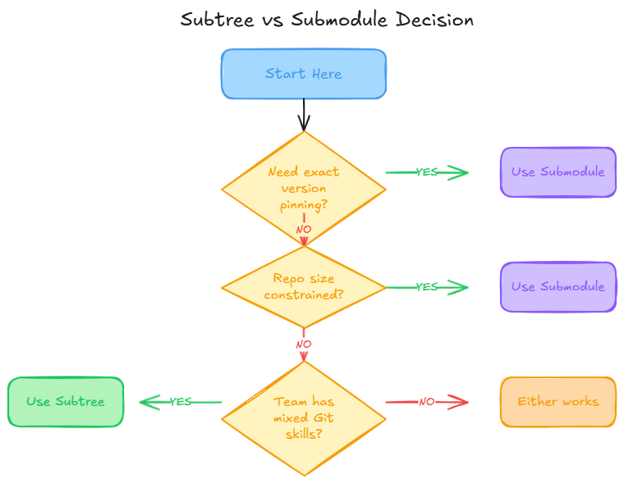
它们都能让您在仓库中包含外部代码,但存在差异。我如果您需要精确的版本固定,或仓库大小受限,请使用 submodule。如果团队 Git 水平参差不齐,且您追求简单,请使用 subtree。否则,两者皆可。
|
维度
|
git subtree
|
git submodule
|
|
设置复杂度
|
中等(命令直观)
|
高(需要单独的 init 步骤)
|
|
克隆体验
|
简单(一次克隆即可使用)
|
复杂(clone + git submodule update --init)
|
|
仓库大小
|
更大(包含 subtree 的完整内容与历史)
|
更小(仅指向另一个仓库的指针)
|
|
开发者入职
|
容易(克隆后即可使用)
|
更难(需理解子模块工作流)
|
|
CI/CD 复杂度
|
简单(克隆即可)
|
更复杂(必须初始化子模块)
|
|
版本固定
|
不那么精确(合并最新或特定提交)
|
精确(固定到具体提交哈希)
|
|
更新流程
|
git subtree pull(合并更改)
|
cd submodule && git pull(手动)
|
|
“只在我机器上能跑”的风险
|
更低(所有内容已提交)
|
更高(子模块状态可能分歧)
|
|
向上游回推更改
|
git subtree push
|
在子模块内正常 git push
|
|
关注点分离
|
混合(代码位于主仓库中)
|
清晰(子模块是独立仓库)
|
在以下情况下使用 git submodule:
- 严格的版本固定(必须使用库 Y 的确切提交 X)
- 项目之间需要清晰分离(它们确实彼此独立)
- 多个项目共享同一依赖但使用不同版本
- 您的工作流对主仓库体积很敏感
在以下情况下使用 git subtree:
- 无需额外初始化步骤
- 新成员克隆一次即可运行测试
- 团队需要学习的 Git 概念更少
- 供应依赖并偶尔拉取更新(vendoring)
两者没有谁永远更好。选择取决于您是否更看重简单性还是严格的版本控制。我的看法:对于多数专注分析而非 Git 内部机制的数据科学团队,subtree 常能降低摩擦;而对管理服务且有依赖要求的平台团队,submodule 更合适。
何时不该使用 git subtree
当仓库大小有硬性约束时,不要使用 git subtree。subtree 会膨胀您的仓库体积,因为它包含完整内容与历史。如果接近 Git 平台的限制,或网络速度尤为重要,子模块更轻量。
此外,如果您需要严格的版本固定,也不要使用 git subtree。您必须使用库的 2.3.1 版本且仅此版本。子模块可固定到精确提交;subtree 则是合并一段提交范围。
如果外部仓库频繁变更,也不要使用 git subtree。subtree 每天都有大量更新。不断拉取会造成凌乱的合并历史。请考虑是否真的需要嵌入,或者使用包管理器是否更清爽。
最后,如果需要组织层面的隔离,也不要使用 git subtree。subtree 的内容有不同的访问控制、许可或所有权。将它们保存在单独的仓库中会让边界更清晰。
git subtree 的优势
单一仓库的克隆体验:运行 git clone 就搞定了。所需的一切都已就绪。这降低了入职摩擦,尤其适合并非人人都是 Git 专家的团队。
比子模块更少的活动部件:无需单独的初始化步骤。无需解释分离的 HEAD 状态。没有“你的子模块不同步”的困惑。工作流更接近标准 Git 操作(add、pull、push)。
CI/CD 更简单:持续集成脚本更精简。用 subtree,克隆后直接跑测试。用子模块,需要克隆、递归初始化、再跑测试。多出的那步一旦被忘就会导致构建失败。
适合 Git 熟练度不一的团队:初级数据从业者无需理解子模块机制。使用熟悉的 Git 命令,一切正常运转。
适合“供应依赖、偶尔更新”的场景:您引入了某库的 1.2 版本。六个月后,1.3 版本有个您想要的修复。一条命令拉进来。既不被不维护的复制代码困住,也不必持续追踪上游变化。
git subtree 的局限与取舍
仓库体积显著增大:您的仓库同时包含您自己的代码与 subtree 的代码,以及完整提交历史(若使用 --squash 会有所缓解)。一个 50MB 的 subtree 大约会为仓库增加 50MB。
对于大型或多个 subtree,这些会累计。请考虑便利性是否值得磁盘空间和克隆时间的增加。
-
历史图复杂度:即使使用 --squash,subtree 更新带来的合并提交也会增加 Git 历史的复杂度。若您频繁拉取 subtree 更新,提交图会变得凌乱。
-
上游分歧困惑:如果您和上游都修改了 subtree 文件,就会发生合并冲突。解决 subtree 冲突可能更让人困惑,因为您是在把别人的仓库合并到您自己的某个子目录中。
-
Push 流程的坑:git subtree push 需要重写历史,对于大型 subtree 可能会很慢。如果您在 subtree 文件夹中做了很多次提交,push 可能要花些时间。耐心点。
-
合并冲突依然会发生:当您和上游都修改了同一文件,您仍需要解决冲突。这并非 subtree 独有,但 subtree 也无法“魔法般”避免 Git 冲突。
-
需要纪律性:使用不同的 --prefix 或不一致的 --squash 标志会带来问题。团队需要将工作流文档化并共同遵循。
这些限制并非致命,但值得事先了解。取舍在于:以更大的仓库体积和潜在的历史复杂度,换取更简单的工作流。
使用 git subtree 时的常见错误
开始使用 git subtree 时,请留意这些常见问题。一旦了解它们,其实很容易避免。
--squash 使用不一致
您在添加 subtree 时用了 --squash,但在 git subtree pull 时忘了。现在历史里同时有压缩和未压缩的 subtree 提交,令人困惑。
解决方法是在项目 README 中做好文档。例如写上:“对 shared-utils 的 subtree 一律使用 --squash。”
前缀错误或变更
您添加 subtree 时使用了 --prefix=libs/shared-utils,后来 pull 却用了 --prefix=libs/utils。这不行,因为 Git 找不到 subtree。
解决方法是每次都使用完全相同的前缀。考虑把它写进脚本,例如:
git subtree pull --prefix=libs/shared-utils \
https://github.com/yourteam/shared-utils.git \
main \
--squash技术支持
期望 subtree 像 submodule 一样工作
您以为可以 cd libs/shared-utils && git checkout 来切换版本。行不通,因为 subtree 的内容只是您仓库中的文件,而不是单独的 Git 仓库。
解决方法是理解 subtree 是合并特定提交。要“降级” subtree,您需要找到并合并更早的提交,或回滚 subtree 更新提交。
未文档化工作流
团队成员不知道是否要用 --squash、用哪个远程 URL、何时需要回推更改。若各行其是,就会造成不一致的历史。
解决方法是在 README 中添加一个章节:
git subtree pull --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git main --squash
git subtree push --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git main技术支持
最后,未做规划就修改 subtree 文件
您为了特定项目修改了 libs/shared-utils 下的文件,但从未回推。六个月后,您拉取更新时,因为您的修改与上游修改冲突而产生冲突。
解决方法是:如果您修改了 subtree 文件,要么把对大家都有用的更改回推到 shared-utils,要么接受在更新时需要处理冲突的现实。
结语
Git subtree 用更大的仓库体积和更复杂的历史,换来了更简单的工作流。对于多数专注分析而非 Git 细节的数据科学团队,subtree 能降低摩擦。新成员克隆仓库后便可立刻开始工作。
想进一步学习 Git 工作流,欢迎查看我们的 Introduction to Git 课程。


您正在进行一个数据分析项目,需要包含团队在另一个仓库中维护的共享工具库。您可以复制粘贴代码,但那样就失去了更新路径。您也可以用 Git 子模块(submodule),但您听说它们很复杂。还有第三个选项:
git subtree。git subtree允许您将一个 Git 仓库作为子目录嵌入到另一个仓库中,同时保留完整历史并提供便捷的更新路径。本指南将介绍何时使用 git subtree、其工作原理,以及常见工作流的实用示例。我们将使用数据科学项目中实际会遇到的情境。
什么是 git subtree?
Git subtree 会在您的项目下的特定文件夹中引入另一个 Git 仓库,同时保留其完整的提交历史。与复制代码或使用符号链接不同,subtree 会保持与原始仓库的连接,因此您可以拉取更新并在需要时将更改推回去。
它与简单复制代码的不同之处在于:
复制粘贴代码:
Git subtree:
与 Git 子模块的关键区别在于:subtree 的内容直接提交进您的主仓库。别人克隆您的项目时,无需额外步骤即可得到全部内容。
这总体上意味着更简单的上手流程,以及更少的“只在我机器上能跑”的问题。
git subtree 的工作原理
当您添加一个 subtree 时,Git 会做一件巧妙的事:把另一个仓库的历史合并进您项目的某个子目录。大致流程如下:
您的仓库包含来自 subtree 的实际文件和完整提交历史,而不仅是指针或引用。别人克隆您的项目或检出分支时,会立刻拥有所有代码。不需要单独“初始化子模块”的步骤。
取舍在于:您的仓库会变大,因为它包含您自己的代码以及 subtree 的代码和完整历史。是否值得?取决于具体情况,但对大多数数据科学团队来说,我认为值得。
如何使用 git subtree(常用命令)
现在了解了 subtree 的作用,我们来走一遍最常见的操作。我们采用一个真实场景:您在构建数据分析项目,需要包含一个共享的工具库。
示例设置:
主项目:
data-pipeline共享库:
shared-utils(位于https://github.com/yourteam/shared-utils.git)您希望将其包含在项目中的
libs/shared-utils/下git subtree add
add命令用于首次将另一个仓库引入到您的项目中。基础语法如下,供参考:
实际示例:
其作用:
参数说明:
--prefix=libs/shared-utils:subtree 在您项目中的位置。今后所有操作必须使用完全相同的前缀。改一次,凌晨 2 点您就可能在 Stack Overflow 上搜“为啥全坏了”。--squash:将 subtree 的全部提交历史压缩为项目中的单个提交,保持更清爽的历史。若不使用 --squash,您会在项目历史中看到原仓库的每一次提交,可能会让人不胜其烦。何时使用 squash:除非您需要保留原仓库的详细提交归属,否则使用 --squash。对大多数带共享工具的数据项目来说,压缩后的历史更干净、更易用。我一直都用它。
运行后,您会在项目中看到一个新提交,消息类似于 “Add 'libs/shared-utils/' from commit 'abc123'”。目录 libs/shared-utils 现已包含所有文件,您可以立即使用。
git subtree pull
pull 命令用于用原始仓库的更改来更新您的 subtree。若共享库团队修复了一个 bug 或添加了功能,这就是获取更新的方式。
基础语法:
实际示例:
其作用:
prefix 必须完全匹配。如果添加时用了 libs/shared-utils,那么 pull 也必须用 libs/shared-utils。用不同的前缀是行不通的。相信我。
关于 squash 的一致性:如果在 add 时使用了 --squash,之后每次 pull 都应使用 --squash。混用压缩和非压缩更新会让历史变得混乱。我是“踩过坑”才懂的。
处理冲突:如果您修改了 libs/shared-utils 中的文件,而上游也修改了相同文件,就会产生合并冲突。像处理任何 Git 合并冲突一样解决它们——编辑文件、暂存、更完成并合并。
在团队的 README 中记录是否使用 --squash,以保持一致性。
git subtree push
push 命令会将您在 subtree 文件夹中所做的更改推回到原始仓库。
基础语法:
实际示例:
其作用:
何时使用:当您在应用仓库中维护共享库,并希望将改进贡献回去。例如,您在 data-pipeline 项目中为 shared-utils 添加了一个有用的数据校验函数,其他项目也应从中受益。
可以把 push 看作 pull 的反向操作。pull 拉入更改;push 发送更改。Git 只提取相关历史,并将其转换回原始仓库的结构。相当巧妙。
您需要对原始仓库有写入权限。如果没有,您需要 fork 该仓库,推送到自己的 fork,然后创建一个 Pull Request。
git subtree split
split 命令会将某个子目录的历史提取到它自己的分支中。
基础语法:
实际示例:
其作用:
常见用例:
从单体仓库中剥离库:您的数据处理流水线规模扩大,想要将某个可复用组件提取为独立库。Split 会创建一个仅包含该组件历史的分支,随后您可以推送到新仓库。
将子目录发布为独立项目:您在分析项目中构建了一个有用的数据可视化模块,并希望以独立包的形式分享。Split 会在保留完整历史的前提下将其提取出来。
创建新独立仓库的示例流程:
现在,shared-utils-new 是一个完整的仓库,仅包含该子目录的完整历史。
git subtree 与 submodule
大家常问的问题:subtree 与 submodule 的比较。
它们都能让您在仓库中包含外部代码,但存在差异。我如果您需要精确的版本固定,或仓库大小受限,请使用
submodule。如果团队 Git 水平参差不齐,且您追求简单,请使用subtree。否则,两者皆可。维度
git subtree
git submodule
设置复杂度
中等(命令直观)
高(需要单独的
init步骤)克隆体验
简单(一次克隆即可使用)
复杂(
clone+git submodule update --init)仓库大小
更大(包含 subtree 的完整内容与历史)
更小(仅指向另一个仓库的指针)
开发者入职
容易(克隆后即可使用)
更难(需理解子模块工作流)
CI/CD 复杂度
简单(克隆即可)
更复杂(必须初始化子模块)
版本固定
不那么精确(合并最新或特定提交)
精确(固定到具体提交哈希)
更新流程
git subtree pull(合并更改)cd submodule && git pull(手动)“只在我机器上能跑”的风险
更低(所有内容已提交)
更高(子模块状态可能分歧)
向上游回推更改
git subtree push在子模块内正常 git push
关注点分离
混合(代码位于主仓库中)
清晰(子模块是独立仓库)
在以下情况下使用 git submodule:
在以下情况下使用 git subtree:
两者没有谁永远更好。选择取决于您是否更看重简单性还是严格的版本控制。我的看法:对于多数专注分析而非 Git 内部机制的数据科学团队,subtree 常能降低摩擦;而对管理服务且有依赖要求的平台团队,submodule 更合适。
何时不该使用 git subtree
当仓库大小有硬性约束时,不要使用
git subtree。subtree 会膨胀您的仓库体积,因为它包含完整内容与历史。如果接近 Git 平台的限制,或网络速度尤为重要,子模块更轻量。此外,如果您需要严格的版本固定,也不要使用
git subtree。您必须使用库的 2.3.1 版本且仅此版本。子模块可固定到精确提交;subtree 则是合并一段提交范围。如果外部仓库频繁变更,也不要使用
git subtree。subtree 每天都有大量更新。不断拉取会造成凌乱的合并历史。请考虑是否真的需要嵌入,或者使用包管理器是否更清爽。最后,如果需要组织层面的隔离,也不要使用
git subtree。subtree 的内容有不同的访问控制、许可或所有权。将它们保存在单独的仓库中会让边界更清晰。git subtree 的优势
单一仓库的克隆体验:运行 git clone 就搞定了。所需的一切都已就绪。这降低了入职摩擦,尤其适合并非人人都是 Git 专家的团队。
比子模块更少的活动部件:无需单独的初始化步骤。无需解释分离的 HEAD 状态。没有“你的子模块不同步”的困惑。工作流更接近标准 Git 操作(add、pull、push)。
CI/CD 更简单:持续集成脚本更精简。用 subtree,克隆后直接跑测试。用子模块,需要克隆、递归初始化、再跑测试。多出的那步一旦被忘就会导致构建失败。
适合 Git 熟练度不一的团队:初级数据从业者无需理解子模块机制。使用熟悉的 Git 命令,一切正常运转。
适合“供应依赖、偶尔更新”的场景:您引入了某库的 1.2 版本。六个月后,1.3 版本有个您想要的修复。一条命令拉进来。既不被不维护的复制代码困住,也不必持续追踪上游变化。
git subtree 的局限与取舍
仓库体积显著增大:您的仓库同时包含您自己的代码与 subtree 的代码,以及完整提交历史(若使用 --squash 会有所缓解)。一个 50MB 的 subtree 大约会为仓库增加 50MB。
对于大型或多个 subtree,这些会累计。请考虑便利性是否值得磁盘空间和克隆时间的增加。
历史图复杂度:即使使用
--squash,subtree 更新带来的合并提交也会增加 Git 历史的复杂度。若您频繁拉取 subtree 更新,提交图会变得凌乱。上游分歧困惑:如果您和上游都修改了 subtree 文件,就会发生合并冲突。解决 subtree 冲突可能更让人困惑,因为您是在把别人的仓库合并到您自己的某个子目录中。
Push 流程的坑:git subtree push 需要重写历史,对于大型 subtree 可能会很慢。如果您在 subtree 文件夹中做了很多次提交,push 可能要花些时间。耐心点。
合并冲突依然会发生:当您和上游都修改了同一文件,您仍需要解决冲突。这并非 subtree 独有,但 subtree 也无法“魔法般”避免 Git 冲突。
需要纪律性:使用不同的
--prefix或不一致的--squash标志会带来问题。团队需要将工作流文档化并共同遵循。这些限制并非致命,但值得事先了解。取舍在于:以更大的仓库体积和潜在的历史复杂度,换取更简单的工作流。
使用 git subtree 时的常见错误
开始使用 git subtree 时,请留意这些常见问题。一旦了解它们,其实很容易避免。
--squash 使用不一致
您在添加 subtree 时用了
--squash,但在 git subtree pull 时忘了。现在历史里同时有压缩和未压缩的 subtree 提交,令人困惑。解决方法是在项目 README 中做好文档。例如写上:“对 shared-utils 的 subtree 一律使用 --squash。”
前缀错误或变更
您添加 subtree 时使用了
--prefix=libs/shared-utils,后来 pull 却用了--prefix=libs/utils。这不行,因为 Git 找不到 subtree。解决方法是每次都使用完全相同的前缀。考虑把它写进脚本,例如:
期望 subtree 像 submodule 一样工作
您以为可以 cd libs/shared-utils && git checkout 来切换版本。行不通,因为 subtree 的内容只是您仓库中的文件,而不是单独的 Git 仓库。
解决方法是理解 subtree 是合并特定提交。要“降级” subtree,您需要找到并合并更早的提交,或回滚 subtree 更新提交。
未文档化工作流
团队成员不知道是否要用
--squash、用哪个远程 URL、何时需要回推更改。若各行其是,就会造成不一致的历史。解决方法是在 README 中添加一个章节:
最后,未做规划就修改 subtree 文件
您为了特定项目修改了
libs/shared-utils下的文件,但从未回推。六个月后,您拉取更新时,因为您的修改与上游修改冲突而产生冲突。解决方法是:如果您修改了 subtree 文件,要么把对大家都有用的更改回推到 shared-utils,要么接受在更新时需要处理冲突的现实。
结语
Git subtree 用更大的仓库体积和更复杂的历史,换来了更简单的工作流。对于多数专注分析而非 Git 细节的数据科学团队,subtree 能降低摩擦。新成员克隆仓库后便可立刻开始工作。
想进一步学习 Git 工作流,欢迎查看我们的 Introduction to Git 课程。