Corso
Introduzione a Git
2 ore
100.4K
Stai lavorando a un progetto di analisi dei dati e devi includere una libreria di utility condivisa che il tuo team mantiene in un altro repository. Potresti copiare e incollare il codice, ma così perderesti la possibilità di aggiornare. Potresti usare i submodule di Git, ma hai sentito dire che sono complicati. C’è una terza opzione: git subtree.
git subtree ti permette di incorporare un repository Git dentro un altro come sottodirectory, mantenendo l’intera cronologia e una via semplice per gli aggiornamenti.
Questa guida spiega quando usare git subtree, come funziona e include esempi pratici per i flussi di lavoro più comuni. Useremo scenari realistici che potresti incontrare davvero nei progetti di data science.
Git subtree include un altro repository Git sotto una cartella specifica del tuo progetto mantenendone l’intera cronologia dei commit. Diversamente dal copiare il codice o usare link simbolici, subtree mantiene una connessione con il repository originale così puoi eseguire pull degli aggiornamenti e spingere le modifiche indietro.
Ecco cosa lo rende diverso dal semplice copiare codice:
Copia e incolla del codice:
Git subtree:
La differenza chiave dai submodule di Git: il contenuto del subtree è committato direttamente nel tuo repository principale. Quando qualcuno clona il tuo progetto, ottiene tutto in un solo checkout senza passaggi aggiuntivi.
Tutto ciò si traduce in onboarding più semplice e meno problemi del tipo "sul mio computer funziona".
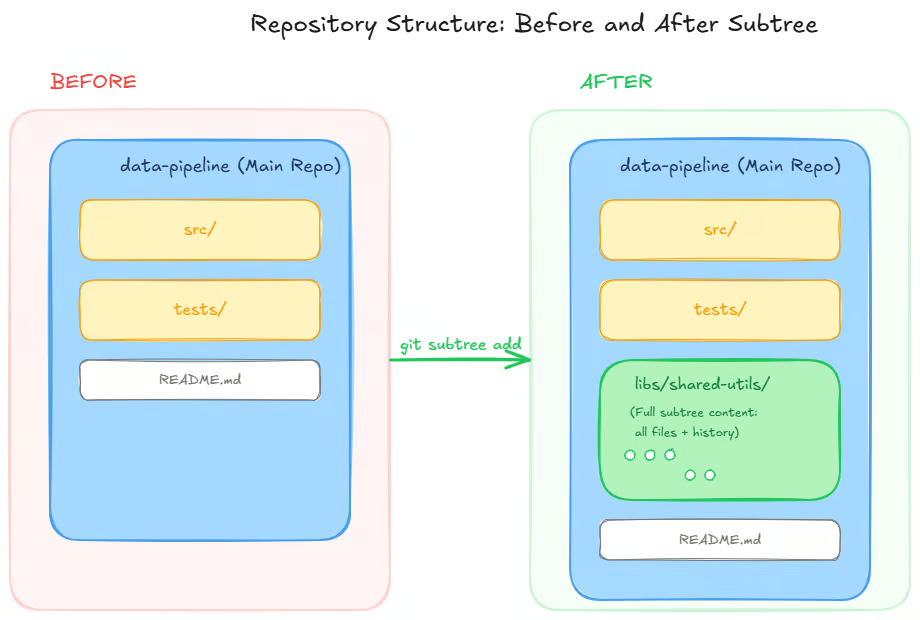
Quando aggiungi un subtree, Git fa qualcosa di intelligente: unisce la cronologia di un altro repository in una sottodirectory del tuo progetto. Ecco cosa succede:
Il tuo repository contiene file reali e la cronologia completa dei commit del subtree, non solo un puntatore o riferimento. Quando qualcuno clona il tuo progetto o fa il checkout di un branch, ha subito tutto il codice. Non c’è un passaggio separato "inizializza submodule".
Il compromesso: il tuo repository cresce perché contiene sia il tuo codice sia quello del subtree con la sua cronologia completa. Ne vale la pena? Dipende dalla situazione, ma per la maggior parte dei team di data science direi di sì.
Ora che sai cosa fa subtree, vediamo le operazioni più comuni. Useremo uno scenario realistico in cui stai costruendo un progetto di analisi dei dati e devi includere una libreria di utility condivisa.
Setup di esempio:
Progetto principale: data-pipeline
Libreria condivisa: shared-utils (si trova su https://github.com/yourteam/shared-utils.git)
Vuoi includerla sotto libs/shared-utils/ nel tuo progetto
Il comando add include un altro repository nel tuo progetto per la prima volta.
La sintassi di base, per riferimento, è questa:
git subtree add --prefix=<directory> <remote-url> <branch> --squashEsempio reale:
# Aggiungi il repo shared-utils sotto libs/shared-utils
git subtree add --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
Cosa fa:
Capire le opzioni:
--prefix=libs/shared-utils: Dove vive il subtree nel tuo progetto. Devi usare esattamente lo stesso prefix per tutte le operazioni future. Cambiarlo una volta e ti ritroverai a cercare su Stack Overflow alle 2 di notte per capire perché si è rotto tutto.
--squash: Combina tutta la cronologia del subtree in un singolo commit nel tuo progetto. Mantiene la cronologia più pulita. Senza --squash, vedresti ogni commit del repo originale nella cronologia del tuo progetto, e può essere troppo.
Quando fare squash: Usa --squash a meno che tu non abbia bisogno di preservare l’attribuzione dettagliata dei commit del repo originale. Per la maggior parte dei progetti dati con utility condivise, una cronologia compressa è più pulita e facile da gestire. Io la uso sempre.
Dopo aver eseguito questo, vedrai un nuovo commit nel tuo progetto con un messaggio tipo "Add 'libs/shared-utils/' from commit 'abc123'". La directory libs/shared-utils ora contiene tutti i file e puoi usarli subito.
Il comando pull aggiorna il tuo subtree con le modifiche dal repository originale. Se il team della libreria condivisa corregge un bug o aggiunge una feature, è così che ottieni quegli aggiornamenti.
Sintassi di base:
git subtree pull --prefix=<directory> <remote-url> <branch> --squashEsempio reale:
# Prendi le ultime modifiche da shared-utils
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
Cosa fa:
Il prefix deve combaciare esattamente. Se hai usato libs/shared-utils durante add, devi usare libs/shared-utils per pull. Usare un prefix diverso non funziona. Fidati.
Coerenza dello squash: se hai usato --squash durante add, dovresti usare --squash per ogni pull. Mischiare aggiornamenti compressi e non compressi crea una cronologia confusa. L’ho imparato a mie spese.
Gestione dei conflitti: se hai modificato file in libs/shared-utils e gli stessi file sono cambiati upstream, avrai conflitti di merge. Risolvili come faresti con qualsiasi conflitto Git: modifica i file, mettili in stage e completa il merge.
Documenta nel README del tuo team se usi --squash o no, così tutti restano allineati.
Il comando push invia al repository originale le modifiche che hai fatto nella cartella del subtree.
Sintassi di base:
git subtree push --prefix=<directory> <remote-url> <branch>Esempio reale:
# Invia le modifiche da libs/shared-utils al repo originale
git subtree push --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main
Cosa fa:
Quando usarlo: stai mantenendo una libreria condivisa dentro il repository della tua applicazione e vuoi contribuire miglioramenti a monte. Metti che hai aggiunto una funzione utile di validazione dei dati a shared-utils mentre lavoravi al progetto data-pipeline, e anche altri progetti dovrebbero beneficiarne.
Pensa a push come all’inverso di pull. Pull porta dentro le modifiche; push le invia fuori. Git estrae solo la cronologia rilevante e la traduce nella struttura del repository originale. Piuttosto ingegnoso.
Ti serve l’accesso in scrittura al repository originale. Se non hai i permessi, dovrai forkare il repo, fare push sul tuo fork e creare una pull request.
Il comando split estrae la cronologia di una sottodirectory in un proprio branch.
Sintassi di base:
git subtree split --prefix=<directory> -b <new-branch-name>Ecco un esempio reale:
# Estrai libs/shared-utils in un proprio branch
git subtree split --prefix=libs/shared-utils -b shared-utils-extracted
Cosa fa:
Casi d’uso comuni:
Scorporare una libreria da un monorepo: la tua pipeline di elaborazione dati è cresciuta e vuoi estrarre un componente riutilizzabile come libreria standalone. Split crea un branch con la sola cronologia di quel componente, che poi puoi pushare in un nuovo repository.
Pubblicare una sottodirectory come progetto a sé: hai creato un modulo utile di visualizzazione dati dentro il tuo progetto di analisi e vuoi condividerlo come pacchetto standalone. Split lo estrae mantenendo intatta la cronologia.
Workflow di esempio per creare un nuovo repo standalone:
# Estrai la sottodirectory
git subtree split --prefix=libs/shared-utils -b shared-utils-standalone

# Crea un nuovo repo e fai push
git remote add shared-utils-origin https://github.com/yourteam/shared-utils-new.git
git push shared-utils-origin shared-utils-standalone:main
Ora shared-utils-new è un repository completo con la cronologia intera di quella sola sottodirectory.
Ecco la domanda che fanno sempre tutti: subtree contro submodule.
Entrambi permettono di includere codice esterno nel tuo repository, ma ci sono differenze. Se ti serve il pinning esatto delle versioni o se la dimensione del repo è un vincolo, usa submodule. Se il tuo team ha competenze Git eterogenee e vuoi semplicità, usa subtree. Altrimenti, entrambi vanno bene.
|
Aspetto |
git subtree |
git submodule |
|
Complessità di setup |
Media (comandi lineari) |
Alta (richiede passaggio |
|
Esperienza di clone |
Semplice (un clone, tutto funziona) |
Complessa ( |
|
Dimensione del repository |
Maggiore (include contenuto + cronologia del subtree) |
Minore (solo un puntatore a un altro repo) |
|
Onboarding degli sviluppatori |
Facile (tutto funziona dopo il clone) |
Più difficile (serve capire il workflow dei submodule) |
|
Complessità CI/CD |
Semplice (cloni e vai) |
Più complessa (devi inizializzare i submodule) |
|
Version pinning |
Meno preciso (unisce l’ultimo o un commit specifico) |
Preciso (hash del commit esatto) |
|
Workflow di aggiornamento |
|
|
|
Rischio "sul mio computer funziona" |
Inferiore (tutto è committato) |
Superiore (lo stato del submodule può divergere) |
|
Inviare modifiche a monte |
|
Normale git push dentro il submodule |
|
Separazione delle responsabilità |
Mista (il codice vive nel repo principale) |
Chiara (il submodule è un repo separato) |
Usa git submodule quando ti serve:
Usa git subtree quando vuoi:
Nessuno dei due è sempre migliore. La scelta dipende dal valore che dai alla semplicità rispetto al controllo rigoroso delle versioni. La mia opinione: per team di data science in cui la maggior parte si concentra sull’analisi più che sui dettagli interni di Git, subtree spesso riduce gli attriti. Per team di piattaforma che gestiscono servizi con requisiti sulle dipendenze, i submodule hanno senso.
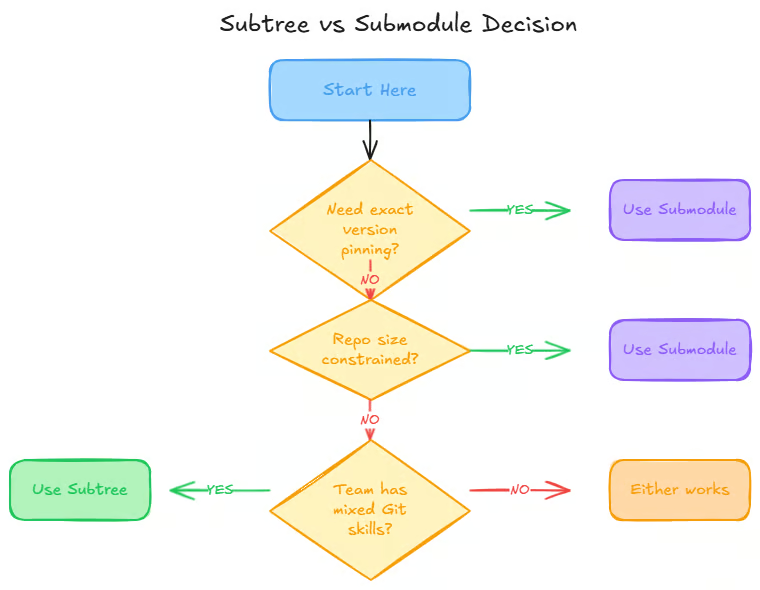
Non usare git subtree quando la dimensione del repository è un vincolo rigido. Subtree gonfia la dimensione del tuo repo perché include contenuto e cronologia completi. Se sei vicino ai limiti della piattaforma Git o se la velocità di rete conta molto, i submodule sono più leggeri.
Inoltre, non usare git subtree se ti serve un pinning rigoroso della versione. Devi usare esattamente la versione 2.3.1 della libreria e nient’altro. I submodule fissano commit esatti; subtree unisce intervalli di commit.
Non usare git subtree se il repo esterno cambia spesso. Il subtree viene aggiornato quotidianamente con modifiche significative. Eseguire pull costanti crea una cronologia di merge disordinata. Valuta se ti serve davvero incorporarlo o se un package manager sarebbe più pulito.
Infine, non usare git subtree se serve separazione organizzativa. Il contenuto del subtree ha controlli di accesso, licenze o proprietà diverse. Tenerli in repository separati rende i confini più chiari.
Esperienza di clone di un solo repository: esegui git clone e hai finito. C’è tutto ciò che ti serve. Questo riduce l’attrito in onboarding per team in cui non tutti sono esperti di Git.
Meno parti in gioco rispetto ai submodule: nessun passaggio di inizializzazione separato. Niente stati di HEAD staccata da spiegare. Niente confusione "il tuo submodule non è sincronizzato". Il workflow è più vicino alle normali operazioni Git (add, pull, push).
Semplicità in CI/CD: gli script di integrazione continua sono più semplici. Con subtree, cloni ed esegui i test. Con i submodule, cloni, inizializzi ricorsivamente e poi esegui i test. Quel passaggio extra fa fallire le build quando viene dimenticato.
Funziona bene per team con confidenza mista con Git: i professionisti junior dei dati non devono capire la meccanica dei submodule. Usano i comandi Git familiari e tutto funziona.
Buono per vendorizzare con aggiornamenti occasionali: includi la versione 1.2 di una libreria. Sei mesi dopo, la versione 1.3 ha una correzione di bug che vuoi. La porti dentro con un comando. Non resti bloccato con codice copiato e non mantenuto, ma non segui nemmeno costantemente i cambiamenti a monte.
Il repository cresce sensibilmente: il tuo repo contiene sia il tuo codice sia quello del subtree più la cronologia completa dei commit (a meno che tu non usi --squash, che aiuta). Un subtree da 50 MB aggiunge ~50 MB alla dimensione del repo.
Per subtree grandi o multipli, questo si accumula. Valuta se la comodità vale lo spazio su disco e il tempo di clone.
Complessità del grafo di cronologia: anche con --squash, i commit di merge per gli aggiornamenti del subtree aggiungono complessità alla cronologia Git. Se fai pull del subtree frequentemente, il grafo dei commit diventa disordinato.
Confusione per divergenza upstream: se modifichi file del subtree e anche upstream li cambia, capitano conflitti di merge. Risolverli può essere confuso perché stai unendo il repo di qualcun altro in una sottodirectory del tuo.
Il workflow di push ha delle insidie: git subtree push deve riscrivere la cronologia, e può essere lento per subtree grandi. Se hai fatto molti commit nella cartella del subtree, push può richiedere tempo. Abbi pazienza.
I conflitti di merge capitano comunque: se tu e upstream modificate lo stesso file, dovrai risolvere i conflitti. Non è specifico di subtree, ma subtree non impedisce magicamente i conflitti Git.
Serve disciplina: usare --prefix diversi o flag --squash incoerenti crea problemi. Il team deve documentare e seguire lo stesso workflow.
Queste limitazioni non sono blocchi totali, ma è bene conoscerle in anticipo. Il compromesso è: workflow più semplice in cambio di un repo più grande e una cronologia potenzialmente più complessa.
Quando inizi a usare git subtree, fai attenzione a questi problemi comuni. È facile evitarli una volta che li conosci.
Hai usato --squash quando hai aggiunto il subtree ma te ne sei dimenticato durante git subtree pull. Ora la tua cronologia ha sia commit compressi che non compressi dal subtree, creando confusione.
La soluzione è documentare le cose nel README del progetto. Scrivi note tipo: "Usa sempre --squash con il subtree shared-utils."
Hai aggiunto il subtree con --prefix=libs/shared-utils ma poi hai provato a fare pull con --prefix=libs/utils. Non funziona perché Git non trova il subtree.
La soluzione è usare ogni volta esattamente lo stesso prefix. Valuta di documentarlo in uno script, così:
# scripts/update-subtree.sh
#!/bin/bash
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
--squashPensavi di poter fare cd libs/shared-utils && git checkout per cambiare versione. Non funziona perché il contenuto del subtree sono solo file nel tuo repo, non un repository Git separato.
La soluzione è capire che subtree unisce commit specifici. Per "fare downgrade" di un subtree, dovresti trovare e unire un commit più vecchio o revertare i commit di aggiornamento del subtree.
I membri del team non sanno se usare --squash, quale URL remoto usare o quando fare push delle modifiche indietro. Se o quando ognuno lo fa in modo diverso, si crea una cronologia incoerente.
La soluzione è aggiungere una sezione al README:
## Aggiornare shared-utils

## Per prendere le ultime modifiche:
git subtree pull --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git main --squash

## Per inviare le modifiche indietro:
git subtree push --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git mainModifichi file in libs/shared-utils per il tuo progetto specifico, ma non fai mai push indietro. Sei mesi dopo, fai pull degli aggiornamenti e ottieni conflitti perché le tue modifiche e quelle a monte collidono.
La soluzione è: se modifichi file del subtree, o spingi le modifiche su shared-utils se sono utili a tutti, oppure accetta che dovrai gestire conflitti durante gli aggiornamenti.
Git subtree scambia dimensione del repository e complessità della cronologia con semplicità del workflow. Per team di data science in cui la maggior parte si concentra sull’analisi più che sui dettagli interni di Git, subtree riduce gli attriti. I nuovi membri del team clonano il repo e iniziano subito a lavorare.
Per approfondire i workflow Git, esplora il nostro corso Introduction to Git.
Impara Git con DataCamp
Corso
Corso
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



