Last chance! 50% off DataCamp Premium
Sale ends in
Je werkt aan een data-analyseproject en moet een gedeelde utilities-bibliotheek opnemen die je team in een andere repository onderhoudt. Je zou de code kunnen kopiëren en plakken, maar dan verlies je het pad voor updates. Je zou Git-submodules kunnen gebruiken, maar je hebt gehoord dat die ingewikkeld zijn. Er is een derde optie: git subtree.
git subtree laat je één Git-repository in een andere insluiten als een submap, met behoud van de volledige geschiedenis en een eenvoudige route voor updates.
Deze gids behandelt wanneer je git subtree gebruikt, hoe het werkt, en praktische voorbeelden voor veelvoorkomende workflows. We gebruiken realistische scenario's die je in datascienceprojecten daadwerkelijk tegenkomt.
Git subtree neemt een andere Git-repository op onder een specifieke map in je project, terwijl de volledige commitgeschiedenis behouden blijft. In tegenstelling tot code kopiëren of symbolische links gebruiken, behoudt subtree een verbinding met de originele repository zodat je updates kunt binnenhalen en wijzigingen terug kunt pushen.
Hierdoor verschilt het van simpelweg code kopiëren:
Code kopiëren en plakken:
Git subtree:
Het belangrijkste verschil met Git-submodules: subtree-inhoud wordt direct in je hoofdrepository gecommit. Wanneer iemand je project clonet, krijgt diegene alles in één checkout zonder extra setupstappen.
Dit alles zorgt voor eenvoudiger onboarding en minder "werkt op mijn machine"-issues.
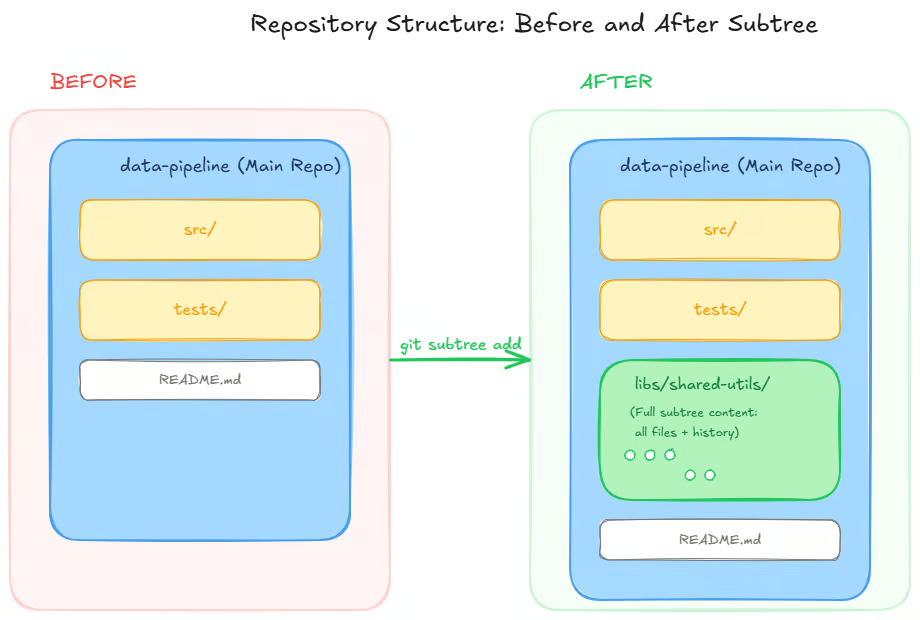
Wanneer je een subtree toevoegt, doet Git iets slims: het voegt de geschiedenis van een andere repository samen in een submap van je project. Dit gebeurt er:
Je repository bevat echte bestanden en volledige commitgeschiedenis van de subtree, niet alleen een verwijzing. Wanneer iemand je project clonet of een branch uitcheckt, is alle code direct beschikbaar. Er is geen aparte stap "submodules initialiseren".
De keerzijde: je repository groeit omdat die zowel jouw code als de code van de subtree plus de volledige geschiedenis bevat. Is het de moeite waard? Hangt af van je situatie, maar voor de meeste datascienceteams zou ik denken van wel.
Nu je begrijpt wat subtree doet, lopen we de meest voorkomende handelingen door. We gebruiken een realistisch scenario waarin je een data-analyseproject bouwt en een gedeelde utilities-bibliotheek moet opnemen.
Voorbeeldsetup:
Hoofdproject: data-pipeline
Gedeelde bibliotheek: shared-utils (staat op https://github.com/yourteam/shared-utils.git)
Je wilt deze opnemen onder libs/shared-utils/ in je project
Het commando add neemt voor het eerst een andere repository in je project op.
De basis-syntaxis, ter referentie, ziet er zo uit:
git subtree add --prefix=<directory> <remote-url> <branch> --squashEcht voorbeeld:
# Voeg de shared-utils-repo toe onder libs/shared-utils
git subtree add --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
Wat dit doet:
De flags begrijpen:
--prefix=libs/shared-utils: Waar de subtree in je project leeft. Je moet exact dezelfde prefix voor alle toekomstige handelingen gebruiken. Verander je die een keer, dan zit je om 2 uur 's nachts op Stack Overflow te zoeken waarom alles stuk is.
--squash: Combineert de hele commitgeschiedenis van de subtree tot één commit in je project. Dit houdt de geschiedenis van je project schoner. Zonder --squash zie je elke commit uit de originele repo in de geschiedenis van je project, wat overweldigend kan zijn.
Wanneer squashen: Gebruik --squash, tenzij je gedetailleerde committoeschrijvingen uit de originele repo moet behouden. Voor de meeste dataprojecten met gedeelde utilities is een gesquashte geschiedenis schoner en prettiger. Ik gebruik het altijd.
Na dit commando zie je een nieuwe commit in je project met een bericht zoals "Add 'libs/shared-utils/' from commit 'abc123'". De map libs/shared-utils bevat nu alle bestanden, en je kunt ze meteen gebruiken.
Het commando pull werkt je subtree bij met wijzigingen uit de oorspronkelijke repository. Als het team van de gedeelde bibliotheek een bug fixt of een feature toevoegt, haal je die updates hiermee binnen.
Basis-syntaxis:
git subtree pull --prefix=<directory> <remote-url> <branch> --squashEcht voorbeeld:
# Haal de laatste wijzigingen op uit shared-utils
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
Wat dit doet:
De prefix moet exact overeenkomen. Als je libs/shared-utils gebruikte bij add, moet je libs/shared-utils gebruiken voor pull. Een andere prefix gebruiken werkt niet. Geloof me.
Consistent squashen: Als je --squash gebruikte bij add, moet je --squash bij elke pull gebruiken. Gesquashte en niet-gesquashte updates mixen zorgt voor verwarrende geschiedenis. Dat heb ik op de harde manier geleerd.
Conflicten afhandelen: Als je bestanden in libs/shared-utils hebt aangepast en diezelfde bestanden zijn upstream veranderd, krijg je mergeconflicten. Los ze op zoals je elk Git-mergeconflict zou oplossen—bewerk de bestanden, stage ze en voltooi de merge.
Leg in de README van je team vast of je --squash gebruikt of niet, zodat iedereen consistent blijft.
Het commando push stuurt wijzigingen die je in de subtree-map hebt gemaakt terug naar de originele repository.
Basis-syntaxis:
git subtree push --prefix=<directory> <remote-url> <branch>Echt voorbeeld:
# Push wijzigingen uit libs/shared-utils terug naar de originele repo
git subtree push --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main
Wat dit doet:
Wanneer je dit gebruikt: Je onderhoudt een gedeelde bibliotheek binnen je applicatierepository en wilt verbeteringen terug bijdragen. Stel dat je een handige datavalidatiefunctie aan shared-utils hebt toegevoegd terwijl je aan je data-pipeline-project werkte, en andere projecten moeten daarvan profiteren.
Zie push als het omgekeerde van pull. Pull haalt wijzigingen binnen; push stuurt wijzigingen weg. Git extraheert alleen de relevante geschiedenis en vertaalt die terug naar de structuur van de originele repository. Best slim.
Je hebt schrijfrechten nodig op de originele repository. Als je geen toestemming hebt, moet je de repo forken, naar je fork pushen en een pull request aanmaken.
Het commando split extraheert de geschiedenis van een submap naar een eigen branch.
Basis-syntaxis:
git subtree split --prefix=<directory> -b <new-branch-name>Hier is een echt voorbeeld:
# Extraheer libs/shared-utils naar een eigen branch
git subtree split --prefix=libs/shared-utils -b shared-utils-extracted
Wat dit doet:
Veelvoorkomende use-cases:
Een bibliotheek uit een monorepo snijden: Je datapijplijn is groot geworden en je wilt een herbruikbare component als zelfstandige bibliotheek extraheren. Split maakt een branch met alleen de geschiedenis van die component, die je vervolgens naar een nieuwe repository kunt pushen.
Een submap als eigen project publiceren: Je hebt een handige datavisualisatiemodule in je analyseproject gebouwd en wilt die als zelfstandig pakket delen. Split extraheert deze met volledige geschiedenis intact.
Voorbeeldworkflow om een nieuwe zelfstandige repo te maken:
# Extraheer de submap
git subtree split --prefix=libs/shared-utils -b shared-utils-standalone

# Maak een nieuwe repo en push ernaartoe
git remote add shared-utils-origin https://github.com/yourteam/shared-utils-new.git
git push shared-utils-origin shared-utils-standalone:main
shared-utils-new is nu een volledige repository met de volledige geschiedenis van alleen die submap.
Dit is wat mensen altijd vragen: subtree versus submodule.
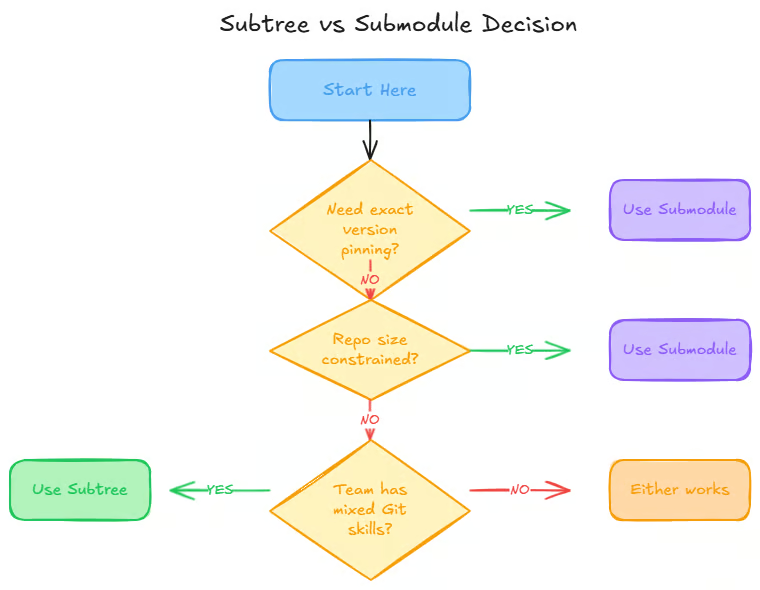
Ze laten allebei externe code in je repository opnemen, maar er zijn verschillen. Als je exacte versievergrendeling nodig hebt, of als de repo-grootte beperkt is, gebruik dan submodule. Als je team gemengde Git-vaardigheden heeft en je eenvoud wilt, gebruik dan subtree. Anders werken beide.
|
Aspect |
git subtree |
git submodule |
|
Complexiteit van setup |
Gemiddeld (eenvoudige commando's) |
Hoog (aparte |
|
Clone-ervaring |
Simpel (één clone, alles werkt) |
Complex ( |
|
Repositorygrootte |
Groter (bevat volledige subtree-inhoud + geschiedenis) |
Kleiner (alleen een verwijzing naar een andere repo) |
|
Onboarding van developers |
Makkelijk (alles werkt na clone) |
Lastiger (moet submodule-workflow snappen) |
|
CI/CD-complexiteit |
Simpel (clonen en gaan) |
Complexer (submodules moeten geïnitialiseerd worden) |
|
Versievergrendeling |
Minder precies (merged de laatste of specifieke commit) |
Precies (exacte commit-hash) |
|
Updateworkflow |
|
|
|
Risico "werkt op mijn machine" |
Lager (alles is gecommit) |
Hoger (submodulestatus kan afwijken) |
|
Wijzigingen terug pushen |
|
Normale git push binnen submodule |
|
Scheiding van verantwoordelijkheden |
Gemengd (code leeft in hoofdrepo) |
Duidelijk (submodule is aparte repo) |
Gebruik git submodule wanneer je nodig hebt:
Gebruik git subtree wanneer je wilt:
Geen van beide is altijd beter. De keuze hangt af van of je eenvoud belangrijker vindt dan strikte versiecontrole. Mijn mening: Voor datascienceteams waar de meesten zich richten op analyse in plaats van Git-internals, vermindert subtree frictie. Voor platformteams die services met dependency-eisen beheren, zijn submodules logisch.
Gebruik git subtree niet wanneer repositorygrootte een harde beperking is. Subtree vergroot je repo omdat het volledige inhoud en geschiedenis bevat. Als je dicht bij de limieten van je Git-platform zit of als netwerksnelheid veel uitmaakt, zijn submodules lichter.
Gebruik git subtree ook niet als je strikte versievergrendeling nodig hebt. Je moet exact versie 2.3.1 van de bibliotheek gebruiken en niets anders. Submodules pinnen aan exacte commits; subtree merged reeksen commits.
Gebruik git subtree niet als de externe repo vaak verandert. De subtree wordt dagelijks met significante wijzigingen bijgewerkt. Constant updates binnenhalen creëert een rommelige mergegeschiedenis. Overweeg of je dit echt moet inbedden of dat een pakketmanager schoner zou zijn.
Gebruik git subtree tot slot niet als organisatorische scheiding vereist is. De subtree-inhoud heeft andere toegangscontroles, licenties of eigenaarschap. Ze in aparte repositories houden maakt grenzen duidelijker.
Één repository-clone-ervaring: Voer git clone uit, en je bent klaar. Alles wat je nodig hebt is er. Dit vermindert onboardingfrictie voor teams waar niet iedereen Git-expert is.
Minder bewegende delen dan submodules: Geen aparte initialisatiestap. Geen detached HEAD-states om uit te leggen. Geen verwarring "je submodule is niet gesynchroniseerd". De workflow ligt dichter bij standaard Git-operaties (add, pull, push).
CI/CD-eenvoud: Je continuous integration-scripts zijn simpeler. Met subtree clone je en draai je tests. Met submodules clone je, initialiseer je recursief en dan pas draai je tests. Die extra stap breekt builds als die wordt vergeten.
Werkt goed voor teams met uiteenlopend Git-comfort: Junior dataprofessionals hoeven submodulemechanieken niet te begrijpen. Ze gebruiken bekende Git-commando's en alles werkt.
Geschikt voor vendoring met af en toe updates: Je neemt versie 1.2 van een bibliotheek op. Zes maanden later bevat versie 1.3 een bugfix die je wilt. Haal die binnen met één commando. Je zit niet vast aan ongeonderhouden gekopieerde code, maar je volgt ook niet constant upstreamwijzigingen.
Repository groeit aanzienlijk: Je repo bevat zowel jouw code als de code van de subtree plus de volledige commitgeschiedenis (tenzij je --squash gebruikt, wat helpt). Een subtree van 50 MB voegt ~50 MB toe aan je repo.
Bij grote of meerdere subtrees telt dit op. Overweeg of het gemak de schijfruimte en clonetijd waard is.
Complexiteit van de geschiedenisgrafiek: Zelfs met --squash voegen mergecommits voor subtree-updates complexiteit toe aan je Git-geschiedenis. Als je vaak subtree-updates binnenhaalt, wordt je commitgrafiek rommelig.
Verwarring door upstreamdivergentie: Als jij subtree-bestanden wijzigt en upstream die ook verandert, ontstaan mergeconflicten. Conflicten in een subtree oplossen kan verwarrend zijn omdat je iemands anders repo in een submap van de jouwe aan het mergen bent.
Push-workflow heeft valkuilen: git subtree push moet geschiedenis herschrijven, wat traag kan zijn bij grote subtrees. Als je veel commits in de subtree-map hebt gemaakt, kan push even duren. Wees geduldig.
Mergeconflicten gebeuren nog steeds: Als jij en upstream hetzelfde bestand wijzigen, moet je conflicten oplossen. Dit is niet subtree-specifiek, maar subtree voorkomt Git-conflicten niet magisch.
Discipline vereist: Verschillende --prefix-waarden of inconsistente --squash-flags gebruiken veroorzaakt problemen. Het team moet dezelfde workflow documenteren en volgen.
Deze beperkingen zijn geen showstoppers, maar het is goed ze vooraf te kennen. De trade-off is: eenvoudigere workflow in ruil voor grotere repo en mogelijke geschiedeniscomplexiteit.
Let bij het gebruik van git subtree op deze veelvoorkomende issues. Ze zijn makkelijk te vermijden zodra je ervan weet.
Je gebruikte --squash bij het toevoegen van de subtree maar vergat het tijdens git subtree pull. Nu bevat je geschiedenis zowel gesquashte als niet-gesquashte commits uit de subtree, wat verwarrend is.
De oplossing is om dit in je project-README te documenteren. Schrijf notities zoals: "Gebruik altijd --squash bij de shared-utils-subtree."
Je hebt de subtree toegevoegd met --prefix=libs/shared-utils maar later geprobeerd te pullen met --prefix=libs/utils. Dit werkt niet omdat Git de subtree niet kan vinden.
De oplossing is om elke keer exact dezelfde prefix te gebruiken. Overweeg dit in een script te documenteren, zoals dit:
# scripts/update-subtree.sh
#!/bin/bash
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
--squashJe dacht dat je kon cd libs/shared-utils && git checkout om van versie te wisselen. Dat werkt niet omdat subtree-inhoud gewoon bestanden in je repo zijn, geen aparte Git-repository.
De oplossing is begrijpen dat subtree specifieke commits samenvoegt. Om een subtree te "downgraden", moet je een oudere commit zoeken en mergen of de subtree-updatecommits terugdraaien.
Teamleden weten niet of ze --squash moeten gebruiken, welke remote-URL ze moeten gebruiken, of wanneer ze wijzigingen moeten terugpushen. Als of wanneer iedereen het anders doet, ontstaat er een inconsistente geschiedenis.
De oplossing is een sectie aan je README toe te voegen:
## shared-utils bijwerken

## Om de laatste wijzigingen op te halen:
git subtree pull --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git main --squash

## Om wijzigingen terug te pushen:
git subtree push --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git mainJe bewerkt bestanden in libs/shared-utils voor je specifieke project, maar pusht nooit terug. Zes maanden later haal je updates binnen en krijg je conflicten omdat jouw wijzigingen en upstreamwijzigingen botsen.
De oplossing is deze: Als je subtree-bestanden wijzigt, push de wijzigingen terug naar shared-utils als ze voor iedereen nuttig zijn, of accepteer dat je tijdens updates conflicten moet beheren.
Git subtree ruilt repositorygrootte en geschiedeniscomplexiteit in voor workfloweenvoud. Voor datascienceteams waar de meesten zich richten op analyse in plaats van Git-internals, vermindert subtree frictie. Nieuwe teamleden clonen de repo en kunnen meteen aan de slag.
Wil je meer leren over Git-workflows, bekijk dan onze Introduction to Git-cursus.
Leer Git met DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min