Last chance! 50% off DataCamp Premium
Sale ends in
आप एक डेटा विश्लेषण प्रोजेक्ट पर काम कर रहे हैं और आपको एक साझा यूटिलिटीज़ लाइब्रेरी शामिल करनी है जिसे आपकी टीम किसी दूसरे रेपोज़िटरी में मेंटेन करती है। आप कोड को कॉपी-पेस्ट कर सकते हैं, लेकिन तब अपडेट्स का रास्ता खो जाएगा। आप Git submodules का उपयोग कर सकते हैं, लेकिन आपने सुना है कि वे जटिल होते हैं। एक तीसरा विकल्प है: git subtree.
git subtree आपको एक Git रेपोज़िटरी को दूसरी के अंदर एक सबडायरेक्टरी के रूप में एम्बेड करने देता है, पूरी हिस्ट्री के साथ और आसान अपडेट पाथ बनाए रखते हुए।
यह गाइड बताती है कि git subtree कब उपयोग करें, यह कैसे काम करता है, और आम वर्कफ़्लो के लिए व्यावहारिक उदाहरण। हम ऐसे यथार्थपरक परिदृश्यों का उपयोग करेंगे जिनका सामना आप वास्तव में डेटा साइंस प्रोजेक्ट्स में करते हैं।
Git subtree आपके प्रोजेक्ट में किसी विशेष फ़ोल्डर के तहत दूसरी Git रेपोज़िटरी को शामिल करता है, उसकी पूरी कमिट हिस्ट्री को बनाए रखते हुए। कोड को कॉपी करने या symbolic links का उपयोग करने के विपरीत, subtree मूल रेपोज़िटरी से कनेक्शन बनाए रखता है ताकि आप अपडेट्स पुल कर सकें और ज़रूरत पड़ने पर बदलाव वापस पुश कर सकें।
यहां बताया गया है कि यह सिर्फ कोड कॉपी करने से कैसे अलग है:
कोड कॉपी-पेस्ट करना:
Git subtree:
Git submodules से मुख्य अंतर: subtree की सामग्री सीधे आपकी मुख्य रेपोज़िटरी में कमिट होती है। जब कोई आपका प्रोजेक्ट क्लोन करता है, तो उसे एक ही चेकआउट में सब कुछ मिल जाता है—कोई अतिरिक्त सेटअप स्टेप नहीं।
इन सबका मतलब है सरल ऑनबोर्डिंग और कम "मेरी मशीन पर तो चलता है" वाली समस्याएं।
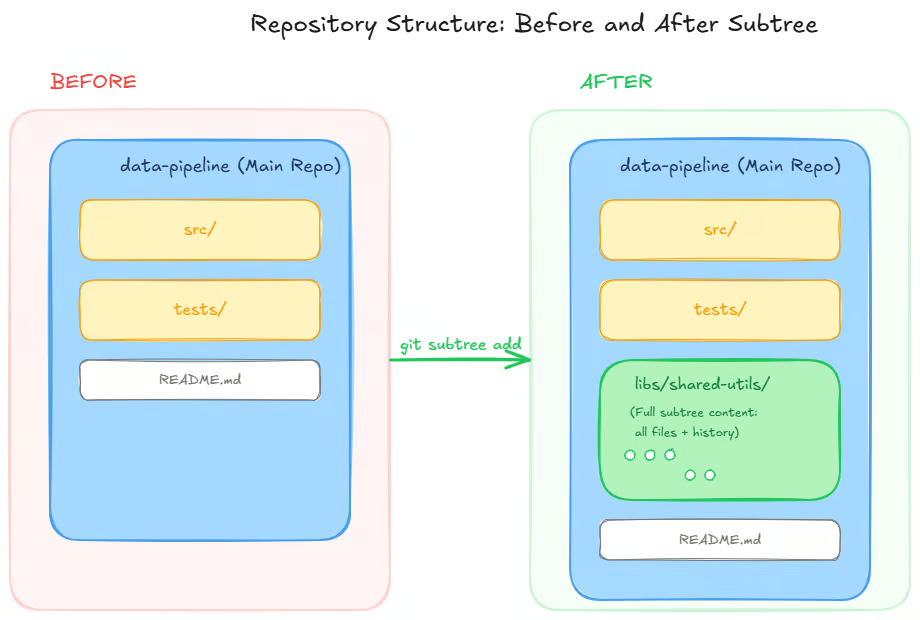
जब आप एक subtree जोड़ते हैं, Git एक चतुर काम करता है: वह किसी दूसरी रेपोज़िटरी की हिस्ट्री को आपके प्रोजेक्ट की एक सबडायरेक्टरी में मर्ज कर देता है। यह होता क्या है:
आपकी रेपोज़िटरी में subtree से वास्तविक फाइलें और पूरी कमिट हिस्ट्री होती है, केवल एक पॉइंटर या संदर्भ नहीं। जब कोई आपका प्रोजेक्ट क्लोन करता है या किसी ब्रांच को चेकआउट करता है, तो उन्हें तुरंत सारा कोड मिल जाता है। कोई अलग "initialize submodules" स्टेप नहीं।
ट्रेड-ऑफ: आपकी रेपोज़िटरी बढ़ती है क्योंकि इसमें आपका कोड और subtree का कोड साथ ही उसकी पूरी हिस्ट्री भी होती है। क्या यह वाजिब है? आपकी स्थिति पर निर्भर करता है, लेकिन ज़्यादातर डेटा साइंस टीमों के लिए, मेरा मानना है हाँ।
अब जब आप समझ गए कि subtree क्या करता है, तो आइए सबसे आम ऑपरेशंस से गुजरते हैं। हम एक यथार्थपरक परिदृश्य लेंगे जहां आप एक डेटा विश्लेषण प्रोजेक्ट बना रहे हैं और आपको एक साझा यूटिलिटीज़ लाइब्रेरी शामिल करनी है।
उदाहरण सेटअप:
मुख्य प्रोजेक्ट: data-pipeline
साझा लाइब्रेरी: shared-utils (यह यहां मौजूद है: https://github.com/yourteam/shared-utils.git)
आप इसे अपने प्रोजेक्ट में libs/shared-utils/ के तहत शामिल करना चाहते हैं
add कमांड किसी दूसरी रेपोज़िटरी को पहली बार आपके प्रोजेक्ट में शामिल करता है।
आधारभूत सिंटैक्स, संदर्भ के लिए, इस तरह दिखता है:
git subtree add --prefix=<directory> <remote-url> <branch> --squashवास्तविक उदाहरण:
# shared-utils रेपो को libs/shared-utils के तहत जोड़ें
git subtree add --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
यह क्या करता है:
फ़्लैग्स को समझना:
--prefix=libs/shared-utils: आपके प्रोजेक्ट में subtree कहां रहेगा। आपको भविष्य के सभी ऑपरेशंस में बिल्कुल यही prefix उपयोग करना होगा। इसे एक बार बदल दिया तो आप रात 2 बजे Stack Overflow पर खोज रहे होंगे कि चीजें क्यों टूट गईं।
--squash: subtree की पूरी कमिट हिस्ट्री को आपके प्रोजेक्ट में एक ही कमिट में समेट देता है। इससे आपके प्रोजेक्ट की हिस्ट्री साफ़ रहती है। बिना --squash के, आपको अपने प्रोजेक्ट की हिस्ट्री में मूल रेपो के हर कमिट दिखेंगे, जो भारी लग सकता है।
कब squash करें: --squash का उपयोग करें जब तक कि आपको मूल रेपो की विस्तृत कमिट एट्रिब्यूशन को संरक्षित करने की आवश्यकता न हो। ज्यादातर साझा यूटिलिटीज़ वाले डेटा प्रोजेक्ट्स में, squashed हिस्ट्री साफ़ और उपयोग में आसान होती है। मैं हमेशा इसका उपयोग करता/करती हूँ।
यह चलाने के बाद, आपको अपने प्रोजेक्ट में ऐसा नया कमिट दिखेगा: "Add 'libs/shared-utils/' from commit 'abc123'". अब libs/shared-utils डायरेक्टरी में सारी फाइलें हैं, और आप उन्हें तुरंत इस्तेमाल कर सकते हैं।
pull कमांड आपके subtree को मूल रेपोज़िटरी से आए बदलावों के साथ अपडेट करता है। यदि साझा लाइब्रेरी टीम कोई बग फिक्स करती है या कोई फीचर जोड़ती है, तो आप ऐसे अपडेट्स इसी तरह लेंगे।
आधारभूत सिंटैक्स:
git subtree pull --prefix=<directory> <remote-url> <branch> --squashवास्तविक उदाहरण:
# shared-utils से नवीनतम बदलाव पुल करें
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
यह क्या करता है:
prefix बिल्कुल मैच करना चाहिए। यदि आपने add के दौरान libs/shared-utils उपयोग किया, तो pull के लिए भी libs/shared-utils ही उपयोग करना होगा। अलग prefix उपयोग करने से काम नहीं होगा। इस पर मेरा भरोसा कीजिए।
Squash की संगति: यदि आपने add के दौरान --squash उपयोग किया है, तो हर pull में --squash उपयोग करें। squashed और non-squashed अपडेट्स मिलाने से हिस्ट्री उलझ जाती है। यह मैंने कठिन तरीके से सीखा।
कॉन्फ्लिक्ट हैंडल करना: यदि आपने libs/shared-utils में फाइलें संशोधित की हैं और वही फाइलें upstream में भी बदली हैं, तो मर्ज कॉन्फ्लिक्ट मिलेंगे। उन्हें वैसे ही सुलझाएं जैसे किसी भी Git मर्ज कॉन्फ्लिक्ट को—फाइलें एडिट करें, स्टेज करें, और मर्ज पूरा करें।
अपनी टीम के README में दस्तावेज़ करें कि आप --squash उपयोग कर रहे हैं या नहीं, ताकि सभी एकसमान रहें।
push कमांड subtree फ़ोल्डर में किए गए आपके बदलावों को मूल रेपोज़िटरी में वापस भेजता है।
आधारभूत सिंटैक्स:
git subtree push --prefix=<directory> <remote-url> <branch>वास्तविक उदाहरण:
# libs/shared-utils में किए बदलाव मूल रेपो में वापस पुश करें
git subtree push --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main
यह क्या करता है:
कब उपयोग करें: आप अपनी एप्लिकेशन रेपोज़िटरी के अंदर एक साझा लाइब्रेरी मेंटेन कर रहे हैं और सुधारों को वापस योगदान देना चाहते हैं। मान लें आपने data-pipeline पर काम करते हुए shared-utils में एक उपयोगी डेटा वैलिडेशन फ़ंक्शन जोड़ा, और अन्य प्रोजेक्ट्स को भी इसका लाभ मिलना चाहिए।
push को pull का उलटा समझें। Pull बदलाव अंदर लाता है; push बदलाव बाहर भेजता है। Git केवल प्रासंगिक हिस्ट्री निकालता है और उसे मूल रेपोज़िटरी की संरचना में अनुवादित कर देता है। काफ़ी चतुर।
आपको मूल रेपोज़िटरी पर लिखने की अनुमति चाहिए। यदि अनुमति नहीं है, तो आपको रेपो को fork करना होगा, अपने fork पर पुश करना होगा, और एक pull request बनानी होगी।
split कमांड किसी सबडायरेक्टरी की हिस्ट्री निकालकर उसे अपनी अलग ब्रांच में बदल देता है।
आधारभूत सिंटैक्स:
git subtree split --prefix=<directory> -b <new-branch-name>यह रहा एक वास्तविक उदाहरण:
# libs/shared-utils को उसकी अपनी ब्रांच में एक्सट्रैक्ट करें
git subtree split --prefix=libs/shared-utils -b shared-utils-extracted
यह क्या करता है:
सामान्य उपयोग के मामले:
मोनोरेपो से लाइब्रेरी अलग करना: आपका डेटा प्रोसेसिंग पाइपलाइन बड़ा हो गया है, और आप एक पुन: उपयोग योग्य घटक को standalone लाइब्रेरी के रूप में निकालना चाहते हैं। Split उस घटक की हिस्ट्री के साथ एक ब्रांच बनाता है, जिसे आप नई रेपोज़िटरी में पुश कर सकते हैं।
किसी सबडायरेक्टरी को एक अलग प्रोजेक्ट के रूप में प्रकाशित करना: आपने अपने विश्लेषण प्रोजेक्ट के अंदर एक उपयोगी डेटा विज़ुअलाइज़ेशन मॉड्यूल बनाया है और उसे standalone पैकेज के रूप में साझा करना चाहते हैं। Split इसे पूरी हिस्ट्री के साथ निकाल देता है।
नए standalone रेपो बनाने का उदाहरण वर्कफ़्लो:
# सबडायरेक्टरी निकालें
git subtree split --prefix=libs/shared-utils -b shared-utils-standalone

# नई रेपो बनाएं और उसमें पुश करें
git remote add shared-utils-origin https://github.com/yourteam/shared-utils-new.git
git push shared-utils-origin shared-utils-standalone:main
अब shared-utils-new केवल उसी सबडायरेक्टरी की पूरी हिस्ट्री के साथ एक संपूर्ण रेपोज़िटरी है।
वह सवाल जो लोग अक्सर पूछते हैं: subtree बनाम submodule।
दोनों आपको अपनी रेपोज़िटरी में बाहरी कोड शामिल करने देते हैं, लेकिन अंतर हैं। अगर आपको सटीक वर्ज़न पिनिंग चाहिए, या रेपो का आकार सीमित है, तो submodule उपयोग करें। यदि आपकी टीम में Git कौशल मिश्रित हैं और आप सादगी चाहते हैं, तो subtree उपयोग करें। अन्यथा, दोनों चल सकते हैं।
|
पहलू |
git subtree |
git submodule |
|
सेटअप जटिलता |
मध्यम (सीधे-सादे कमांड्स) |
उच्च (अलग |
|
क्लोन अनुभव |
सरल (एक क्लोन, सब कुछ काम करता है) |
जटिल ( |
|
रेपोज़िटरी आकार |
बड़ा (पूरी subtree सामग्री + हिस्ट्री शामिल) |
छोटा (सिर्फ दूसरी रेपो का पॉइंटर) |
|
डेवलपर ऑनबोर्डिंग |
आसान (क्लोन के बाद सब काम करता है) |
ज्यादा कठिन (submodule वर्कफ़्लो समझना पड़ता है) |
|
CI/CD जटिलता |
सरल (क्लोन करें और शुरू हो जाएं) |
ज़्यादा जटिल (submodules इनिशियलाइज़ करने पड़ते हैं) |
|
वर्ज़न पिनिंग |
कम सटीक (नवीनतम या किसी विशेष कमिट को मर्ज करता है) |
सटीक (एकदम वही कमिट हैश) |
|
अपडेट वर्कफ़्लो |
|
|
|
"मेरी मशीन पर चलता है" का जोखिम |
कम (सब कुछ कमिटेड होता है) |
ज़्यादा (submodule की स्थिति अलग हो सकती है) |
|
बदलाव वापस पुश करना |
|
submodule के अंदर सामान्य git push |
|
दायित्वों का पृथक्करण |
मिश्रित (कोड मुख्य रेपो में रहता है) |
साफ़ (submodule अलग रेपो है) |
git submodule का उपयोग करें जब आपको चाहिए:
git subtree का उपयोग करें जब आप चाहते हैं:
कोई भी हमेशा बेहतर नहीं है। विकल्प इस पर निर्भर करता है कि आप कड़े वर्ज़न नियंत्रण की तुलना में सादगी को कितना महत्व देते हैं। मेरा मत: डेटा साइंस टीमों के लिए जहां ज़्यादातर लोग Git की बारीकियों से अधिक विश्लेषण पर ध्यान देते हैं, subtree आमतौर पर घर्षण कम करता है। प्लेटफ़ॉर्म टीमों के लिए जो निर्भरताओं की आवश्यकताओं के साथ सर्विसेज़ मैनेज करती हैं, submodules समझ में आते हैं।
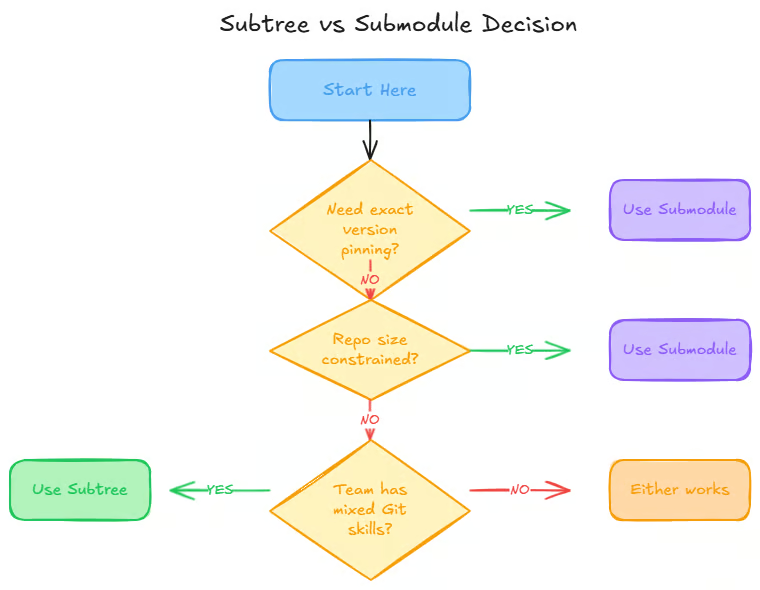
जब रेपोज़िटरी का आकार कड़ा प्रतिबंध हो, तब git subtree का उपयोग न करें। Subtree आपके रेपो आकार को बढ़ाता है क्योंकि यह पूरी सामग्री और हिस्ट्री शामिल करता है। यदि आप Git प्लेटफ़ॉर्म लिमिट्स के पास हैं या नेटवर्क स्पीड बहुत मायने रखती है, तो submodules हल्के हैं।
इसके अलावा, यदि आपको कड़ी वर्ज़न पिनिंग चाहिए, तो git subtree का उपयोग न करें। आपको लाइब्रेरी के ठीक संस्करण 2.3.1 का ही उपयोग करना है और कुछ नहीं। Submodules सटीक कमिट्स को पिन करते हैं; subtree कमिट्स की रेंज को मर्ज करता है।
यदि बाहरी रेपो बार-बार बदलता है, तो git subtree का उपयोग न करें। Subtree को रोज़ाना भारी बदलावों के साथ अपडेट करना पड़ता है। लगातार अपडेट्स पुल करने से गंदी मर्ज हिस्ट्री बनती है। सोचें कि क्या सच में इसे एम्बेड करने की ज़रूरत है या कोई पैकेज मैनेजर ज़्यादा साफ़ रहेगा।
अंत में, यदि संगठनात्मक अलगाव आवश्यक है तो git subtree का उपयोग न करें। Subtree सामग्री के अलग एक्सेस कंट्रोल, लाइसेंसिंग, या स्वामित्व हैं। उन्हें अलग रेपोज़िटरी में रखना सीमाएं स्पष्ट करता है।
एकल रेपोज़िटरी क्लोन अनुभव: git clone चलाएं, और काम पूरा। जो चाहिए वह सब मौजूद है। इससे उन टीमों में ऑनबोर्डिंग का घर्षण घटता है जहां हर कोई Git विशेषज्ञ नहीं है।
submodules की तुलना में कम चलती पुर्जियां: कोई अलग इनिशियलाइज़ेशन स्टेप नहीं। समझाने के लिए कोई detached HEAD स्टेट नहीं। "आपका submodule सिंक से बाहर है" जैसी उलझन नहीं। वर्कफ़्लो मानक Git ऑपरेशंस (add, pull, push) के करीब है।
CI/CD सादगी: आपकी कंटिन्युअस इंटीग्रेशन स्क्रिप्ट्स सरल होती हैं। Subtree के साथ, आप क्लोन करते हैं और टेस्ट चलाते हैं। Submodules के साथ, आपको क्लोन करना, रिकर्सिवली इनिशियलाइज़ करना, फिर टेस्ट चलाना पड़ता है। वह अतिरिक्त स्टेप भूल जाने पर बिल्ड्स टूटती हैं।
मिश्रित Git सहजता वाली टीमों के लिए उपयुक्त: जूनियर डेटा प्रैक्टिशनर्स को submodule मैकेनिक्स समझने की ज़रूरत नहीं। वे परिचित Git कमांड्स उपयोग करते हैं और सब काम करता है।
कभी-कभार अपडेट्स के साथ वेन्डरिंग के लिए अच्छा: आपने किसी लाइब्रेरी का संस्करण 1.2 शामिल किया। छह महीने बाद, संस्करण 1.3 में एक बग फिक्स है जिसे आप चाहते हैं। एक कमांड से उसे पुल करें। आप अप्रबंधित कॉपी किए गए कोड में फंसते नहीं, और साथ ही लगातार upstream बदलावों को भी ट्रैक नहीं करते।
रेपोज़िटरी उल्लेखनीय रूप से बढ़ती है: आपकी रेपो में आपका कोड और subtree का कोड साथ ही उसकी पूरी कमिट हिस्ट्री होती है (जब तक आप --squash उपयोग न करें, जो मदद करता है)। 50MB का subtree आपके रेपो आकार में ~50MB जोड़ता है।
बड़े या कई subtrees के लिए, यह जोड़ काफी बढ़ सकता है। सोचें कि क्या सुविधा डिस्क स्पेस और क्लोन समय के लायक है।
हिस्ट्री ग्राफ जटिलता: --squash के बावजूद, subtree अपडेट्स के लिए मर्ज कमिट्स आपकी Git हिस्ट्री में जटिलता जोड़ते हैं। यदि आप बार-बार subtree अपडेट्स पुल करते हैं, तो आपका कमिट ग्राफ गंदा हो सकता है।
Upstream डाइवर्जेंस की उलझन: यदि आप subtree फाइलें संशोधित करते हैं और upstream भी उन्हें बदलता है, तो मर्ज कॉन्फ्लिक्ट्स होंगे। subtree में कॉन्फ्लिक्ट्स सुलझाना उलझा सकता है क्योंकि आप किसी और की रेपो को अपनी सबडायरेक्टरी में मर्ज कर रहे हैं।
Push वर्कफ़्लो में पेचीदगियां: git subtree push को हिस्ट्री फिर लिखनी पड़ती है, जो बड़े subtrees के लिए धीमा हो सकता है। यदि आपने subtree फ़ोल्डर में बहुत सारे कमिट्स किए हैं, तो push में समय लग सकता है। धैर्य रखें।
मर्ज कॉन्फ्लिक्ट्स फिर भी होंगे: यदि आप और upstream दोनों एक ही फाइल बदलते हैं, तो आपको कॉन्फ्लिक्ट्स सुलझाने होंगे। यह subtree-विशेष नहीं है, लेकिन subtree जादुई रूप से Git कॉन्फ्लिक्ट्स को रोकता नहीं।
अनुशासन आवश्यक: अलग-अलग --prefix मान या असंगत --squash फ़्लैग्स समस्याएं पैदा करते हैं। टीम को वही वर्कफ़्लो दस्तावेज़ित करना और उसका पालन करना चाहिए।
ये सीमाएं निर्णायक नहीं हैं, लेकिन पहले से जानना उपयोगी है। ट्रेड-ऑफ यह है: बड़े रेपो आकार और संभावित हिस्ट्री जटिलता के बदले सरल वर्कफ़्लो।
जब आप git subtree का उपयोग शुरू करते हैं, तो इन सामान्य मुद्दों पर ध्यान दें। इनके बारे में पता होते ही इन्हें टालना आसान है।
आपने subtree जोड़ते समय --squash उपयोग किया, लेकिन git subtree pull के दौरान भूल गए। अब आपकी हिस्ट्री में subtree से आए squashed और non-squashed दोनों तरह के कमिट्स हैं, जो उलझन पैदा करते हैं।
उपाय है कि इसे अपने प्रोजेक्ट README में दस्तावेज़ करें। जैसे नोट लिखें, "shared-utils subtree के साथ हमेशा --squash उपयोग करें।"
आपने --prefix=libs/shared-utils के साथ subtree जोड़ा लेकिन बाद में --prefix=libs/utils के साथ pull करने की कोशिश की। यह काम नहीं करता क्योंकि Git subtree नहीं ढूंढ पाता।
उपाय है कि हर बार बिल्कुल वही prefix उपयोग करें। इसे किसी स्क्रिप्ट में दस्तावेज़ करने पर विचार करें, जैसे:
# scripts/update-subtree.sh
#!/bin/bash
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
--squashआपने सोचा कि आप cd libs/shared-utils && git checkout करके वर्ज़न बदल सकते हैं। यह काम नहीं करता क्योंकि subtree की सामग्री आपकी रेपो में सिर्फ फाइलें हैं, कोई अलग Git रेपोज़िटरी नहीं।
उपाय है समझना कि subtree विशिष्ट कमिट्स को मर्ज करता है। subtree को "डाउनग्रेड" करने के लिए, आपको कोई पुराना कमिट ढूंढकर मर्ज करना होगा या subtree अपडेट कमिट्स को रिवर्ट करना होगा।
टीम के सदस्यों को पता नहीं कि --squash उपयोग करना है या नहीं, कौन-सा रिमोट URL उपयोग करना है, या कब बदलाव वापस पुश करने हैं। जब हर कोई अलग ढंग से करेगा, तो हिस्ट्री असंगत हो जाएगी।
उपाय है कि अपने README में एक सेक्शन जोड़ें:
## shared-utils अपडेट करना

## नवीनतम बदलाव पुल करने के लिए:
git subtree pull --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git main --squash

## बदलाव वापस पुश करने के लिए:
git subtree push --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git mainआपने अपने विशेष प्रोजेक्ट के लिए libs/shared-utils में फाइलें एडिट कीं, लेकिन कभी पुश नहीं किया। छह महीने बाद, आपने अपडेट्स पुल किए और कॉन्फ्लिक्ट्स मिल गए क्योंकि आपके बदलाव और upstream बदलाव टकरा गए।
उपाय यह है: यदि आप subtree फाइलें संशोधित करते हैं, तो या तो बदलाव shared-utils में वापस पुश करें यदि वे सभी के लिए उपयोगी हैं, या यह स्वीकार करें कि अपडेट्स के दौरान आपको कॉन्फ्लिक्ट्स मैनेज करने होंगे।
Git subtree वर्कफ़्लो की सादगी के बदले रेपोज़िटरी आकार और हिस्ट्री जटिलता की अदला-बदली करता है। डेटा साइंस टीमों के लिए जहां ज़्यादातर लोग Git की बारीकियों की बजाय विश्लेषण पर ध्यान देते हैं, subtree घर्षण कम करता है। नए टीम सदस्य रेपो क्लोन करते हैं और तुरंत काम शुरू कर देते हैं।
Git वर्कफ़्लोज़ के बारे में और सीखने के लिए, हमारा Introduction to Git कोर्स देखें।
DataCamp के साथ Git सीखें
कोर्स
कोर्स
लर्निंग पाथ