Curso
Introdução ao Git
2 h
98.2K
Você está trabalhando em um projeto de análise de dados e precisa incluir uma biblioteca de utilitários compartilhada que seu time mantém em outro repositório. Você até poderia copiar e colar o código, mas perderia a trilha de atualizações. Poderia usar submódulos do Git, mas já ouviu dizer que são complicados. Existe uma terceira opção: git subtree.
git subtree permite incorporar um repositório Git dentro de outro como um subdiretório, mantendo todo o histórico e um caminho simples para atualizações.
Neste guia, você vai ver quando usar git subtree, como ele funciona e exemplos práticos para fluxos de trabalho comuns. Vamos usar cenários realistas que você realmente encontra em projetos de data science.
Git subtree inclui outro repositório Git em uma pasta específica do seu projeto, preservando todo o histórico de commits. Diferente de copiar código ou usar links simbólicos, o subtree mantém uma conexão com o repositório original, permitindo puxar atualizações e enviar mudanças de volta.
Veja o que o torna diferente de simplesmente copiar código:
Copiar e colar código:
Git subtree:
A principal diferença em relação a submódulos do Git: o conteúdo do subtree é commitado diretamente no seu repositório principal. Quando alguém clona seu projeto, recebe tudo em um único checkout, sem etapas extras de configuração.
Tudo isso resulta em onboarding mais simples e menos problemas do tipo "funciona na minha máquina".
Quando você adiciona um subtree, o Git faz algo inteligente: ele mescla o histórico de outro repositório em um subdiretório do seu projeto. Acontece o seguinte:
Seu repositório contém arquivos reais e o histórico completo do subtree, não apenas um ponteiro ou referência. Quando alguém clona seu projeto ou faz checkout de um branch, já tem todo o código. Não existe a etapa separada de "inicializar submódulos".
O trade-off: seu repositório cresce porque passa a conter tanto o seu código quanto o do subtree, além do histórico completo. Vale a pena? Depende do seu contexto, mas para a maioria dos times de data science, eu diria que sim.
Agora que você entendeu o que o subtree faz, vamos passar pelas operações mais comuns. Vamos usar um cenário realista em que você está construindo um projeto de análise de dados e precisa incluir uma biblioteca de utilitários compartilhada.
Exemplo de configuração:
Projeto principal: data-pipeline
Biblioteca compartilhada: shared-utils (em https://github.com/yourteam/shared-utils.git)
Você quer incluí-la em libs/shared-utils/ no seu projeto
O comando add inclui outro repositório no seu projeto pela primeira vez.
A sintaxe básica, para referência, é assim:
git subtree add --prefix=<directory> <remote-url> <branch> --squashExemplo real:
# Adiciona o repositório shared-utils em libs/shared-utils
git subtree add --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
O que isso faz:
Entendendo as flags:
--prefix=libs/shared-utils: onde o subtree vive no seu projeto. Você deve usar exatamente o mesmo prefix em todas as operações futuras. Mudar uma vez e você vai estar no Stack Overflow às 2 da manhã tentando descobrir por que tudo quebrou.
--squash: combina todo o histórico do subtree em um único commit no seu projeto. Isso mantém o histórico mais limpo. Sem --squash, você veria cada commit do repositório original no histórico do seu projeto, o que pode ser demais.
Quando usar squash: use --squash a menos que você precise preservar a atribuição detalhada de commits do repositório original. Para a maioria dos projetos de dados com utilitários compartilhados, o histórico comprimido é mais limpo e fácil de lidar. Eu sempre uso.
Depois de rodar o comando, você verá um novo commit no seu projeto com uma mensagem como "Add 'libs/shared-utils/' from commit 'abc123'". O diretório libs/shared-utils agora contém todos os arquivos, e você já pode usá-los.
O comando pull atualiza seu subtree com mudanças do repositório original. Se o time da biblioteca compartilhada corrigir um bug ou adicionar um recurso, é assim que você traz essas atualizações.
Sintaxe básica:
git subtree pull --prefix=<directory> <remote-url> <branch> --squashExemplo real:
# Puxa as mudanças mais recentes de shared-utils
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
O que isso faz:
O prefix precisa bater exatamente. Se você usou libs/shared-utils no add, precisa usar libs/shared-utils no pull. Usar um prefix diferente não funciona. Pode confiar.
Consistência com squash: se você usou --squash no add, deve usar --squash em todos os pulls. Misturar updates com e sem squash cria um histórico confuso. Aprendi isso na prática.
Tratando conflitos: se você modificou arquivos em libs/shared-utils e esses mesmos arquivos mudaram no upstream, você terá conflitos de merge. Resolva como qualquer conflito no Git — edite os arquivos, faça o stage e conclua o merge.
Documente no README do time se vocês usam --squash ou não, para todo mundo manter a consistência.
O comando push envia mudanças que você fez na pasta do subtree de volta ao repositório original.
Sintaxe básica:
git subtree push --prefix=<directory> <remote-url> <branch>Exemplo real:
# Envia mudanças de libs/shared-utils para o repositório original
git subtree push --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main
O que isso faz:
Quando usar: você mantém uma biblioteca compartilhada dentro do repositório da aplicação e quer contribuir melhorias de volta. Por exemplo, você adicionou uma função útil de validação de dados em shared-utils enquanto trabalhava no data-pipeline, e outros projetos também devem se beneficiar.
Pense no push como o inverso do pull. Pull traz mudanças; push envia mudanças. O Git extrai apenas o histórico relevante e o traduz de volta para a estrutura do repositório original. Bem esperto.
Você precisa de permissão de escrita no repositório original. Se não tiver, será necessário fazer um fork, dar push no seu fork e abrir um pull request.
O comando split extrai o histórico de um subdiretório para um branch próprio.
Sintaxe básica:
git subtree split --prefix=<directory> -b <new-branch-name>Exemplo real:
# Extrai libs/shared-utils para um branch próprio
git subtree split --prefix=libs/shared-utils -b shared-utils-extracted
O que isso faz:
Casos de uso comuns:
Separar uma biblioteca de um monorepo: seu pipeline de processamento de dados cresceu e você quer extrair um componente reutilizável como uma biblioteca independente. O split cria um branch só com o histórico desse componente, que você pode enviar para um novo repositório.
Publicar um subdiretório como projeto próprio: você criou um módulo útil de visualização de dados dentro do seu projeto de análise e quer compartilhá-lo como um pacote independente. O split extrai tudo com o histórico intacto.
Exemplo de fluxo para criar um novo repositório independente:
# Extrai o subdiretório
git subtree split --prefix=libs/shared-utils -b shared-utils-standalone

# Cria um novo repositório e faz push para ele
git remote add shared-utils-origin https://github.com/yourteam/shared-utils-new.git
git push shared-utils-origin shared-utils-standalone:main
Agora shared-utils-new é um repositório completo com o histórico apenas daquele subdiretório.
Essa é a pergunta que sempre aparece: subtree versus submodule.
Ambos permitem incluir código externo no seu repositório, mas há diferenças. Se você precisa fixar versões com precisão, ou se o tamanho do repo é um limitante, use submodule. Se seu time tem níveis variados de domínio do Git e você busca simplicidade, use subtree. Caso contrário, os dois funcionam.
|
Aspecto |
git subtree |
git submodule |
|
Complexidade de setup |
Média (comandos diretos) |
Alta (etapa |
|
Experiência ao clonar |
Simples (um clone, tudo funciona) |
Mais complexa ( |
|
Tamanho do repositório |
Maior (inclui conteúdo completo do subtree + histórico) |
Menor (apenas um ponteiro para outro repo) |
|
Onboarding de desenvolvedores |
Fácil (tudo funciona após o clone) |
Mais difícil (precisa entender o fluxo de submódulos) |
|
Complexidade de CI/CD |
Simples (clonou e rodou) |
Mais complexa (precisa inicializar submódulos) |
|
Fixação de versão |
Menos precisa (mescla o último ou um commit específico) |
Precisa (hash exato do commit) |
|
Fluxo de atualização |
|
|
|
Risco de "funciona na minha máquina" |
Menor (tudo está commitado) |
Maior (estado do submódulo pode divergir) |
|
Enviar mudanças de volta |
|
Git push normal dentro do submódulo |
|
Separação de responsabilidades |
Mista (código vive no repo principal) |
Clara (submódulo é repo separado) |
Use git submodule quando você precisa de:
Use git subtree quando você quer:
Nenhum é sempre melhor. A escolha depende do que você valoriza mais: simplicidade ou controle estrito de versão. Minha visão: para times de data science em que a maioria foca mais em análise do que em detalhes do Git, subtree costuma reduzir atritos. Para times de plataforma que gerenciam serviços com requisitos rígidos de dependência, submodules fazem sentido.
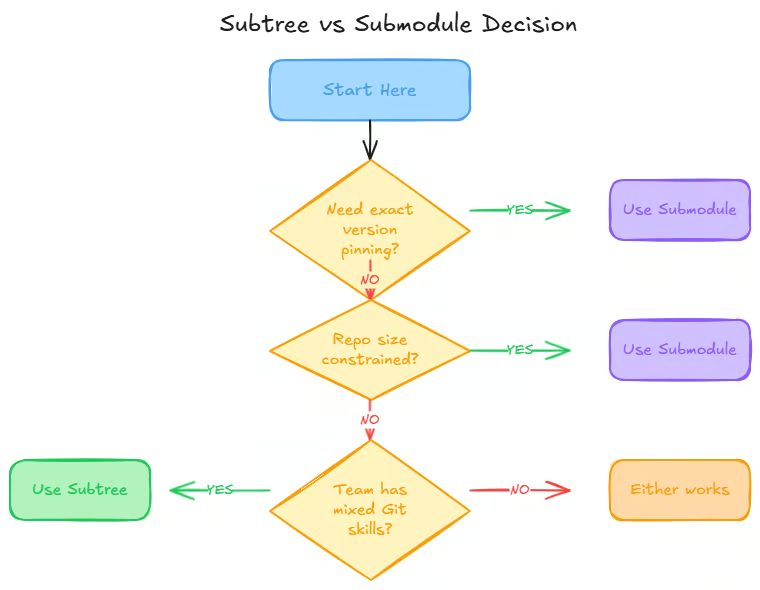
Não use git subtree quando o tamanho do repositório for um limitante rígido. Subtree aumenta o tamanho do repo porque inclui o conteúdo completo e o histórico. Se você está perto dos limites da plataforma Git ou se a velocidade de rede importa muito, submodules são mais leves.
Também não use git subtree se você precisa de fixação estrita de versão. Você deve usar exatamente a versão 2.3.1 da biblioteca e nada além disso. Submodules fixam em commits exatos; subtree mescla intervalos de commits.
Não use git subtree se o repo externo muda com muita frequência. O subtree é atualizado diariamente com mudanças significativas. Puxar atualizações o tempo todo cria um histórico de merges bagunçado. Avalie se você realmente precisa incorporá-lo ou se um gerenciador de pacotes não seria mais limpo.
Por fim, não use git subtree se for necessária separação organizacional. O conteúdo do subtree tem controles de acesso, licenças ou propriedade diferentes. Mantê-los em repositórios separados deixa as fronteiras mais claras.
Experiência de clone único: rode git clone e pronto. Tudo que você precisa está lá. Isso reduz o atrito de onboarding em times onde nem todo mundo é expert em Git.
Menos peças móveis do que submódulos: sem etapa separada de inicialização. Sem estados de HEAD destacado para explicar. Sem confusão de "seu submódulo está fora de sincronia". O fluxo é mais próximo das operações padrão do Git (add, pull, push).
Simplicidade no CI/CD: seus scripts de integração contínua ficam mais simples. Com subtree, você clona e roda testes. Com submodules, você clona, inicializa recursivamente e só então roda testes. Esse passo extra quebra builds quando é esquecido.
Funciona bem para times com diferentes níveis de conforto com Git: profissionais juniores não precisam entender a mecânica de submódulos. Eles usam comandos familiares do Git e tudo funciona.
Bom para vendorizar com atualizações ocasionais: você inclui a versão 1.2 de uma biblioteca. Seis meses depois, a versão 1.3 traz um bug fix que você quer. Traga com um comando. Você não fica preso a código copiado e sem manutenção, mas também não fica acompanhando as mudanças upstream o tempo todo.
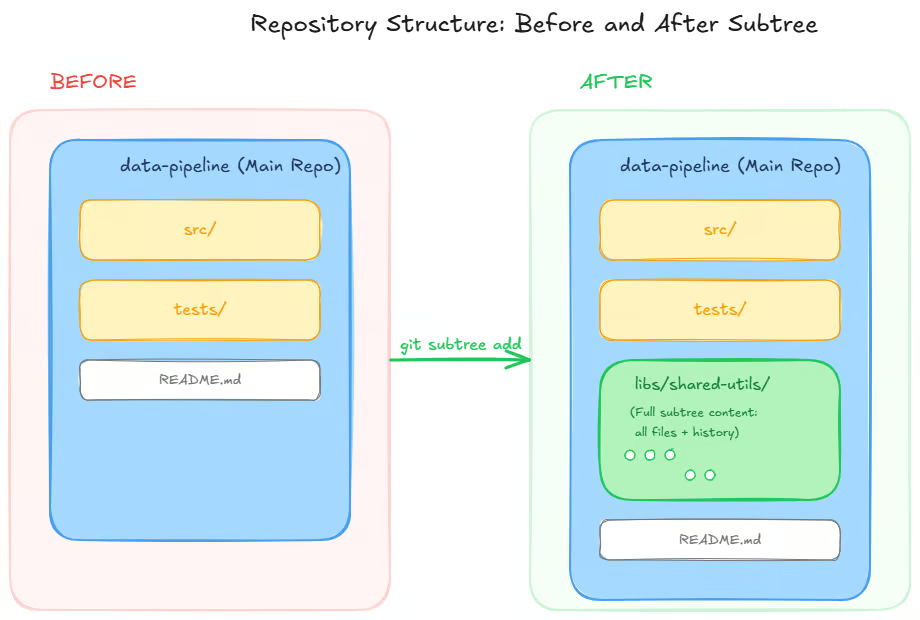
Repositório cresce significativamente: seu repo contém tanto o seu código quanto o do subtree, além do histórico completo (a menos que você use --squash, o que ajuda). Um subtree de 50 MB adiciona ~50 MB ao seu repo.
Para subtrees grandes ou múltiplos subtrees, isso se acumula. Avalie se a conveniência compensa o espaço em disco e o tempo de clone.
Complexidade do grafo de histórico: mesmo com --squash, commits de merge para updates do subtree adicionam complexidade ao histórico. Se você puxa updates com frequência, o grafo de commits fica bagunçado.
Confusão com divergência upstream: se você modifica arquivos do subtree e o upstream também altera, surgem conflitos. Resolver conflitos em um subtree pode confundir porque você está mesclando o repo de outra pessoa em um subdiretório do seu.
Push tem pegadinhas: git subtree push precisa reescrever histórico, o que pode ser lento em subtrees grandes. Se você fez muitos commits na pasta do subtree, o push pode demorar. Tenha paciência.
Conflitos de merge ainda acontecem: se você e o upstream modificarem o mesmo arquivo, será preciso resolver conflitos. Isso não é específico do subtree, e ele não impede conflitos do Git.
Disciplina é necessária: usar --prefix diferentes ou flags --squash inconsistentes gera problemas. O time precisa documentar e seguir o mesmo fluxo.
Essas limitações não são impeditivas, mas vale conhecer de antemão. O trade-off é: fluxo mais simples em troca de repo maior e histórico potencialmente mais complexo.
Ao começar a usar git subtree, fique atento a estes problemas comuns. Eles são fáceis de evitar quando você já sabe deles.
Você usou --squash ao adicionar o subtree, mas esqueceu no git subtree pull. Agora seu histórico tem commits com e sem squash do subtree, deixando tudo confuso.
A solução é documentar isso no README do projeto. Escreva algo como: "Sempre use --squash com o subtree shared-utils".
Você adicionou o subtree com --prefix=libs/shared-utils, mas depois tentou fazer pull com --prefix=libs/utils. Não funciona porque o Git não encontra o subtree.
A solução é usar exatamente o mesmo prefix sempre. Considere documentar isso em um script, assim:
# scripts/update-subtree.sh
#!/bin/bash
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
--squashVocê achou que podia rodar cd libs/shared-utils && git checkout para trocar de versão. Isso não funciona porque o conteúdo do subtree são apenas arquivos no seu repo, não um repositório Git separado.
A solução é entender que o subtree mescla commits específicos. Para "voltar" uma versão, você precisa encontrar e mesclar um commit mais antigo ou reverter os commits de atualização do subtree.
Os membros do time não sabem se devem usar --squash, qual URL remota usar ou quando enviar mudanças de volta. Se cada um fizer de um jeito, o histórico vira uma colcha de retalhos.
A solução é adicionar uma seção ao seu README:
## Atualizando shared-utils

## Para puxar as últimas mudanças:
git subtree pull --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git main --squash

## Para enviar mudanças de volta:
git subtree push --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git mainVocê edita arquivos em libs/shared-utils para o seu projeto específico, mas nunca envia de volta. Seis meses depois, você faz pull e aparecem conflitos porque suas mudanças e as do upstream colidem.
A solução é: se você modificar arquivos do subtree, ou faça push de volta para shared-utils se for útil para todos, ou aceite que precisará lidar com conflitos nas atualizações.
Git subtree troca tamanho de repositório e complexidade do histórico por simplicidade no fluxo de trabalho. Para times de data science em que a maioria foca mais em análise do que em detalhes do Git, subtree reduz atritos. Novos membros clonam o repo e começam a trabalhar na hora.
Para aprender mais sobre fluxos de trabalho com Git, explore nosso Introduction to Git course.
Aprenda Git com a DataCamp
Curso
Curso
Programa
blog
Summer Worsley
14 min
Tutorial
Olivia Smith
13 min
Tutorial
Tutorial
Abid Ali Awan
9 min
Tutorial
Tutorial