Curso
Introducción a Git
2 h
98.2K
Estás trabajando en un proyecto de análisis de datos y necesitas incluir una biblioteca de utilidades compartidas que tu equipo mantiene en otro repositorio. Podrías copiar y pegar el código, pero perderías la vía de actualización. Podrías usar submódulos de Git, pero has oído que son complicados. Hay una tercera opción: git subtree.
git subtree te permite incrustar un repositorio de Git dentro de otro como un subdirectorio, conservando todo su historial y con una ruta de actualización sencilla.
Esta guía explica cuándo usar git subtree, cómo funciona y ejemplos prácticos para flujos de trabajo habituales. Usaremos escenarios realistas que te encontrarás en proyectos de ciencia de datos.
Git subtree incluye otro repositorio de Git bajo una carpeta concreta de tu proyecto y mantiene todo su historial de commits. A diferencia de copiar código o usar enlaces simbólicos, subtree mantiene una conexión con el repositorio original para que puedas traer actualizaciones y enviar cambios de vuelta.
Esto es lo que lo diferencia de simplemente copiar código:
Copiar y pegar código:
Git subtree:
La gran diferencia con los submódulos de Git: el contenido del subtree se confirma directamente en tu repositorio principal. Cuando alguien clona tu proyecto, lo obtiene todo de una vez, sin pasos extra de configuración.
Todo esto se traduce en una incorporación más sencilla y menos problemas de «en mi máquina funciona».
Cuando añades un subtree, Git hace algo ingenioso: fusiona el historial de otro repositorio en un subdirectorio de tu proyecto. Esto es lo que ocurre:
Tu repositorio contiene archivos reales y el historial completo del subtree, no solo un puntero o referencia. Cuando alguien clona tu proyecto o cambia de rama, tiene todo el código al instante. No hay un paso aparte de «inicializar submódulos».
La contrapartida: tu repositorio crece porque contiene tanto tu código como el del subtree y su historial completo. ¿Compensa? Depende de tu situación, pero para la mayoría de equipos de data, diría que sí.
Ahora que sabes qué hace subtree, veamos las operaciones más comunes. Usaremos un escenario realista en el que construyes un proyecto de análisis de datos y necesitas incluir una biblioteca de utilidades compartidas.
Configuración de ejemplo:
Proyecto principal: data-pipeline
Biblioteca compartida: shared-utils (existe en https://github.com/yourteam/shared-utils.git)
Quieres incluirla en libs/shared-utils/ dentro de tu proyecto
El comando add incluye otro repositorio en tu proyecto por primera vez.
La sintaxis básica, como referencia, es esta:
git subtree add --prefix=<directory> <remote-url> <branch> --squashEjemplo real:
# Añadir el repo shared-utils bajo libs/shared-utils
git subtree add --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
Qué hace esto:
Entendiendo las flags:
--prefix=libs/shared-utils: dónde vivirá el subtree en tu proyecto. Debes usar exactamente el mismo prefijo en todas las operaciones futuras. Si lo cambias, acabarás buscando en Stack Overflow a las 2 de la mañana por qué se ha roto todo.
--squash: combina todo el historial del subtree en un único commit en tu proyecto. Mantiene el historial más limpio. Sin --squash, verías cada commit del repo original en el historial de tu proyecto, lo que puede ser abrumador.
Cuándo hacer squash: usa --squash salvo que necesites preservar la atribución detallada de commits del repo original. Para la mayoría de proyectos de datos con utilidades compartidas, un historial comprimido es más limpio y manejable. Yo lo uso siempre.
Tras ejecutarlo, verás un nuevo commit en tu proyecto con un mensaje tipo «Add 'libs/shared-utils/' from commit 'abc123'». El directorio libs/shared-utils ya contiene todos los archivos y puedes usarlos al instante.
El comando pull actualiza tu subtree con cambios del repositorio original. Si el equipo de la biblioteca compartida corrige un bug o añade una funcionalidad, así traes esas actualizaciones.
Sintaxis básica:
git subtree pull --prefix=<directory> <remote-url> <branch> --squashEjemplo real:
# Traer los últimos cambios de shared-utils
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
  --squash
Qué hace esto:
El prefijo debe coincidir exactamente. Si usaste libs/shared-utils al añadir, debes usar libs/shared-utils para pull. Usar un prefijo distinto no funcionará. Créeme.
Coherencia con squash: si usaste --squash al añadir, deberías usar --squash en cada pull. Mezclar actualizaciones comprimidas y no comprimidas genera un historial confuso. Lo aprendí por las malas.
Gestión de conflictos: si has modificado archivos en libs/shared-utils y esos mismos archivos han cambiado upstream, tendrás conflictos de merge. Resuélvelos como cualquier conflicto de Git: edita los archivos, añádelos al índice y completa el merge.
Documenta en el README de tu equipo si usáis --squash o no, para que todo el mundo sea consistente.
El comando push envía los cambios que hayas hecho en la carpeta del subtree de vuelta al repositorio original.
Sintaxis básica:
git subtree push --prefix=<directory> <remote-url> <branch>Ejemplo real:
# Enviar cambios desde libs/shared-utils al repo original
git subtree push --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main
Qué hace esto:
Cuándo usarlo: mantienes una biblioteca compartida dentro de tu repositorio de aplicación y quieres aportar mejoras de vuelta. Por ejemplo, añadiste una función útil de validación de datos a shared-utils mientras trabajabas en data-pipeline y otros proyectos deberían beneficiarse.
Piensa en push como el inverso de pull. Pull trae cambios; push los envía. Git extrae solo el historial relevante y lo traduce a la estructura del repositorio original. Bastante ingenioso.
Necesitas permisos de escritura en el repositorio original. Si no los tienes, tendrás que hacer un fork, enviar a tu fork y crear un pull request.
El comando split extrae el historial de un subdirectorio en su propia rama.
Sintaxis básica:
git subtree split --prefix=<directory> -b <new-branch-name>Ejemplo real:
# Extraer libs/shared-utils a su propia rama
git subtree split --prefix=libs/shared-utils -b shared-utils-extracted
Qué hace esto:
Casos de uso comunes:
Extraer una biblioteca de un monorepo: tu canalización de procesamiento de datos ha crecido y quieres sacar un componente reutilizable como biblioteca independiente. Split crea una rama con el historial de ese componente, que luego puedes enviar a un repositorio nuevo.
Publicar un subdirectorio como proyecto propio: has creado un módulo de visualización de datos útil dentro de tu proyecto de análisis y quieres compartirlo como paquete independiente. Split lo extrae con el historial completo intacto.
Flujo de trabajo de ejemplo para crear un repo independiente:
# Extraer el subdirectorio
git subtree split --prefix=libs/shared-utils -b shared-utils-standalone

# Crear un repo nuevo y enviar a él
git remote add shared-utils-origin https://github.com/yourteam/shared-utils-new.git
git push shared-utils-origin shared-utils-standalone:main
Ahora shared-utils-new es un repositorio completo con el historial íntegro solo de ese subdirectorio.
La eterna pregunta: subtree frente a submodule.
Ambos te permiten incluir código externo en tu repositorio, pero hay diferencias. Si necesitas fijar versiones exactas o si el tamaño del repo es un límite, usa submodule. Si tu equipo tiene niveles de Git variados y quieres simplicidad, usa subtree. En caso contrario, ambos sirven.
|
Aspecto |
git subtree |
git submodule |
|
Complejidad de configuración |
Media (comandos directos) |
Alta (requiere paso de |
|
Experiencia al clonar |
Sencilla (un solo clone, todo funciona) |
Compleja ( |
|
Tamaño del repositorio |
Mayor (incluye contenido + historial del subtree) |
Menor (solo un puntero a otro repo) |
|
Onboarding de desarrolladores |
Fácil (todo funciona tras clonar) |
Más difícil (hay que entender el flujo de submódulos) |
|
Complejidad en CI/CD |
Simple (clonar y listo) |
Más compleja (hay que inicializar submódulos) |
|
Fijación de versión |
Menos precisa (fusiona el último o un commit específico) |
Precisa (hash de commit exacto) |
|
Flujo de actualización |
|
|
|
Riesgo de «en mi máquina funciona» |
Menor (todo está confirmado en el repo) |
Mayor (el estado del submódulo puede divergir) |
|
Enviar cambios de vuelta |
|
git push normal dentro del submódulo |
|
Separación de responsabilidades |
Mixta (el código vive en el repo principal) |
Clara (el submódulo es un repo aparte) |
Usa git submodule cuando necesites:
Usa git subtree cuando quieras:
Ninguna opción es siempre mejor. La elección depende de si valoras la simplicidad frente al control estricto de versiones. Mi opinión: para equipos de ciencia de datos donde la mayoría se centra en el análisis más que en las tripas de Git, subtree reduce fricción. Para equipos de plataforma que gestionan servicios con requisitos de dependencias, los submódulos tienen sentido.
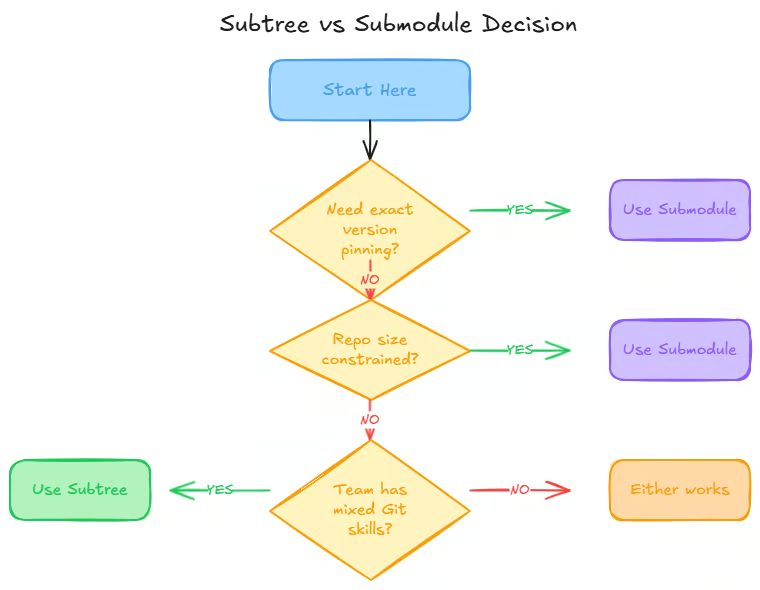
No uses git subtree cuando el tamaño del repositorio sea una restricción dura. Subtree infla el tamaño porque incluye contenido e historial completos. Si estás cerca de los límites de la plataforma Git o si la velocidad de red importa mucho, los submódulos son más ligeros.
Tampoco lo uses si necesitas fijación estricta de versión. Debes usar exactamente la versión 2.3.1 de la biblioteca y nada más. Los submódulos fijan commits exactos; subtree fusiona rangos de commits.
No lo uses si el repo externo cambia con mucha frecuencia. El subtree se actualiza a diario con cambios importantes. Estar trayendo actualizaciones constantemente crea un historial de merges sucio. Valora si realmente necesitas incrustarlo o si un gestor de paquetes sería más limpio.
Por último, no lo uses si necesitas separación organizativa. El contenido del subtree tiene controles de acceso, licencias u operativas distintas. Mantenerlos en repositorios separados deja los límites más claros.
Experiencia de clonación en un único repositorio: ejecuta git clone y listo. Tienes todo lo que necesitas. Reduce la fricción de onboarding en equipos donde no todo el mundo es experto en Git.
Menos piezas móviles que los submódulos: sin paso de inicialización aparte. Sin estados de HEAD desacoplado que explicar. Sin el lío de «tu submódulo está desincronizado». El flujo se parece más a las operaciones estándar de Git (add, pull, push).
Simplicidad en CI/CD: tus scripts de integración continua son más simples. Con subtree, clonas y ejecutas las pruebas. Con submódulos, clonas, inicializas recursivamente y luego pruebas. Ese paso extra rompe builds cuando se olvida.
Funciona bien para equipos con comodidad dispar con Git: las personas junior en datos no necesitan entender la mecánica de los submódulos. Usan comandos de Git conocidos y todo funciona.
Ideal para vendorizar con actualizaciones puntuales: incluyes la versión 1.2 de una biblioteca. Seis meses después, la 1.3 trae un fix que te interesa. La traes con un comando. No te quedas con código copiado sin mantenimiento, pero tampoco sigues cada cambio upstream.
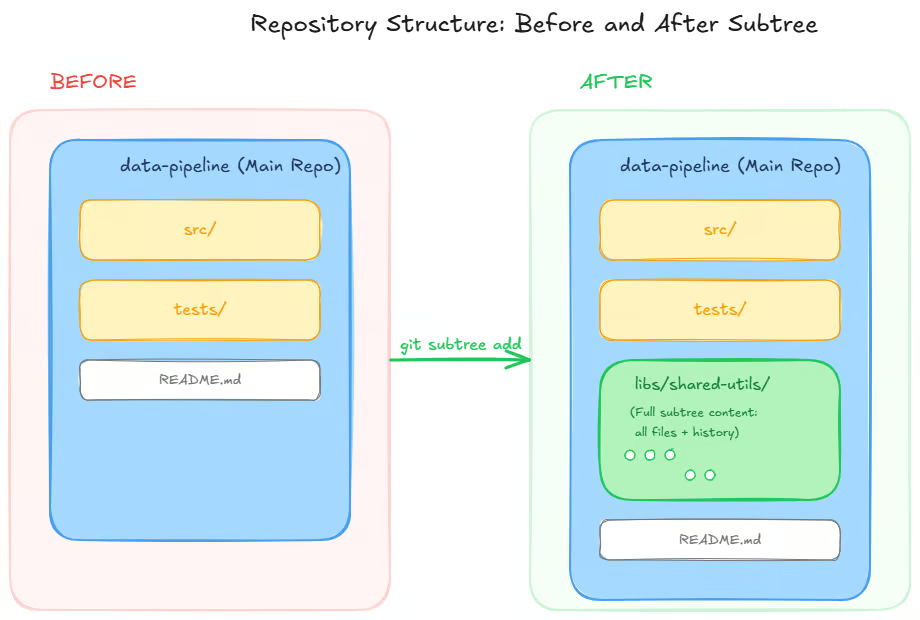
El repositorio crece de forma notable: tu repo contiene tu código y el del subtree con su historial completo (a menos que uses --squash, que ayuda). Un subtree de 50 MB añade ~50 MB a tu repo.
Con subtrees grandes o múltiples, esto se acumula. Valora si la comodidad compensa el espacio en disco y el tiempo de clonación.
Complejidad del grafo de historial: incluso con --squash, los commits de merge para actualizaciones del subtree añaden complejidad a tu historial de Git. Si traes actualizaciones con frecuencia, el grafo se ensucia.
Confusión por divergencia upstream: si modificas archivos del subtree y upstream también los cambia, habrá conflictos de merge. Resolverlos puede ser confuso porque estás fusionando el repo de otra persona en un subdirectorio del tuyo.
El flujo de push tiene sus truquitos: git subtree push necesita reescribir historial, lo que puede ser lento con subtrees grandes. Si has hecho muchos commits en la carpeta del subtree, el push puede tardar. Paciencia.
Los conflictos de merge siguen ocurriendo: si tú y upstream tocáis el mismo archivo, tendrás que resolverlos. No es algo específico de subtree, y tampoco lo evita por arte de magia.
Requiere disciplina: usar distintos valores de --prefix o flags --squash inconsistentes crea problemas. El equipo debe documentar y seguir el mismo flujo.
Estas limitaciones no son decisivas, pero conviene conocerlas. El intercambio es: flujo más sencillo a cambio de un repo más grande y un historial potencialmente más complejo.
Cuando empieces con git subtree, evita estos problemas típicos. Son fáciles de sortear una vez los conoces.
Usaste --squash al añadir el subtree pero lo olvidaste durante git subtree pull. Ahora tu historial mezcla commits comprimidos y no comprimidos del subtree, lo que lo hace confuso.
La solución es documentarlo en el README del proyecto. Escribe notas como «Usa siempre --squash con el subtree shared-utils».
Añadiste el subtree con --prefix=libs/shared-utils pero luego intentaste hacer pull con --prefix=libs/utils. No funciona porque Git no encuentra el subtree.
La solución es usar siempre el mismo prefijo. Plantéate documentarlo en un script, por ejemplo:
# scripts/update-subtree.sh
#!/bin/bash
git subtree pull --prefix=libs/shared-utils \
  https://github.com/yourteam/shared-utils.git \
  main \
--squashPensabas que podías hacer cd libs/shared-utils && git checkout para cambiar de versión. No funciona porque el contenido del subtree son solo archivos en tu repo, no un repositorio de Git aparte.
La solución es entender que subtree fusiona commits específicos. Para «volver» a otra versión, tendrías que encontrar y fusionar un commit antiguo o revertir los commits de actualización del subtree.
Las personas del equipo no saben si usar --squash, qué URL remota usar o cuándo enviar cambios de vuelta. Si cada quien lo hace distinto, crearéis un historial inconsistente.
La solución es añadir una sección al README:
## Actualizar shared-utils

## Para traer los últimos cambios:
git subtree pull --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git main --squash

## Para enviar cambios de vuelta:
git subtree push --prefix=libs/shared-utils https://github.com/yourteam/shared-utils.git mainEditas archivos en libs/shared-utils para tu proyecto concreto, pero nunca los envías de vuelta. Seis meses después, haces pull y aparecen conflictos porque tus cambios chocan con los de upstream.
La solución: si modificas archivos del subtree, o bien envía los cambios a shared-utils si son útiles para todos, o asume que tendrás que gestionar conflictos en futuras actualizaciones.
Git subtree intercambia tamaño de repo y complejidad del historial por simplicidad de flujo de trabajo. Para equipos de ciencia de datos donde la mayoría se centra en el análisis más que en las tripas de Git, subtree reduce la fricción. Las personas nuevas clonan el repo y se ponen a trabajar al momento.
Si quieres aprender más sobre flujos de trabajo con Git, explora nuestro Introduction to Git course.
Aprende Git con DataCamp
Curso
Curso
programa
Tutorial
Olivia Smith
13 min
Tutorial
Tutorial
Zoumana Keita
10 min
Tutorial
Abid Ali Awan
9 min
Tutorial
Tutorial

