设想您正在训练一个机器学习模型,但不确定它在新的、未见过的数据上会有怎样的表现。这正是 K 折交叉验证大显身手的地方。它能让您提前一窥模型在真实世界中的表现。这一技术有助于确保您的预测并非偶然一次成功,而是在新的、未见过的数据集上也能稳定可靠。
在本指南中,我们将拆解 K 折交叉验证的基础概念,并与更简单的训练/测试划分方法进行比较。您将使用 Python 探索多种交叉验证方法,并理解为何选择合适的方法会对项目结果产生巨大影响。最后,您将能够使用 scikit-Learn 应用这些策略。
让我们开始吧,一起学习如何让您的机器学习工作更值得信赖!
什么是 K 折交叉验证?
K 折交叉验证是一种用于评估机器学习模型性能的稳健技术。通过在多次迭代中使用数据集的不同部分进行训练和测试,它有助于确保模型能够很好地泛化到未见过的数据。
K 折交叉验证 vs. 训练/测试划分
K 折交叉验证将数据集划分为多个子集,迭代地训练和测试模型;而训练/测试划分方法仅将数据集分成两部分:一部分用于训练,另一部分用于测试。训练/测试划分简单、实现快速,但性能估计高度依赖于具体的划分方式,可能导致结果方差较大。
下方的图片展示了这两种方法在结构上的差异。第一张图展示了训练/测试划分方法,其中数据集被划分为 80% 的训练集和 20% 的测试集。
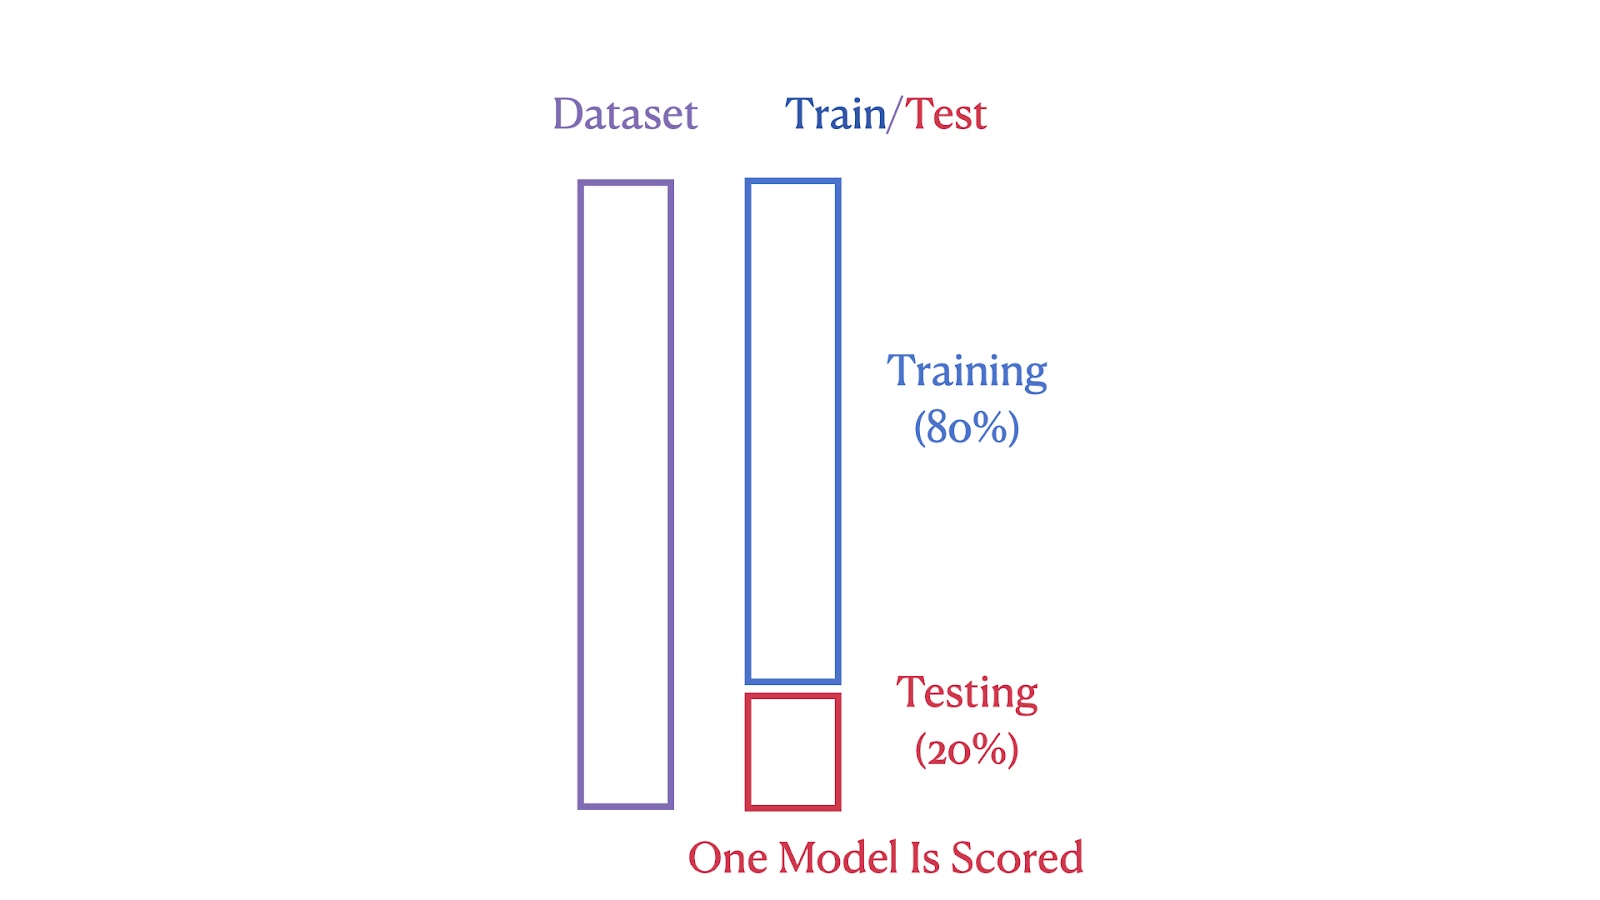
训练/测试划分示意图。图片作者自制
第二张图展示了 5 折交叉验证,数据集被划分为五个部分,每个部分都会在五次迭代中的一次充当测试集,从而确保每个分段都既用于训练又用于测试。
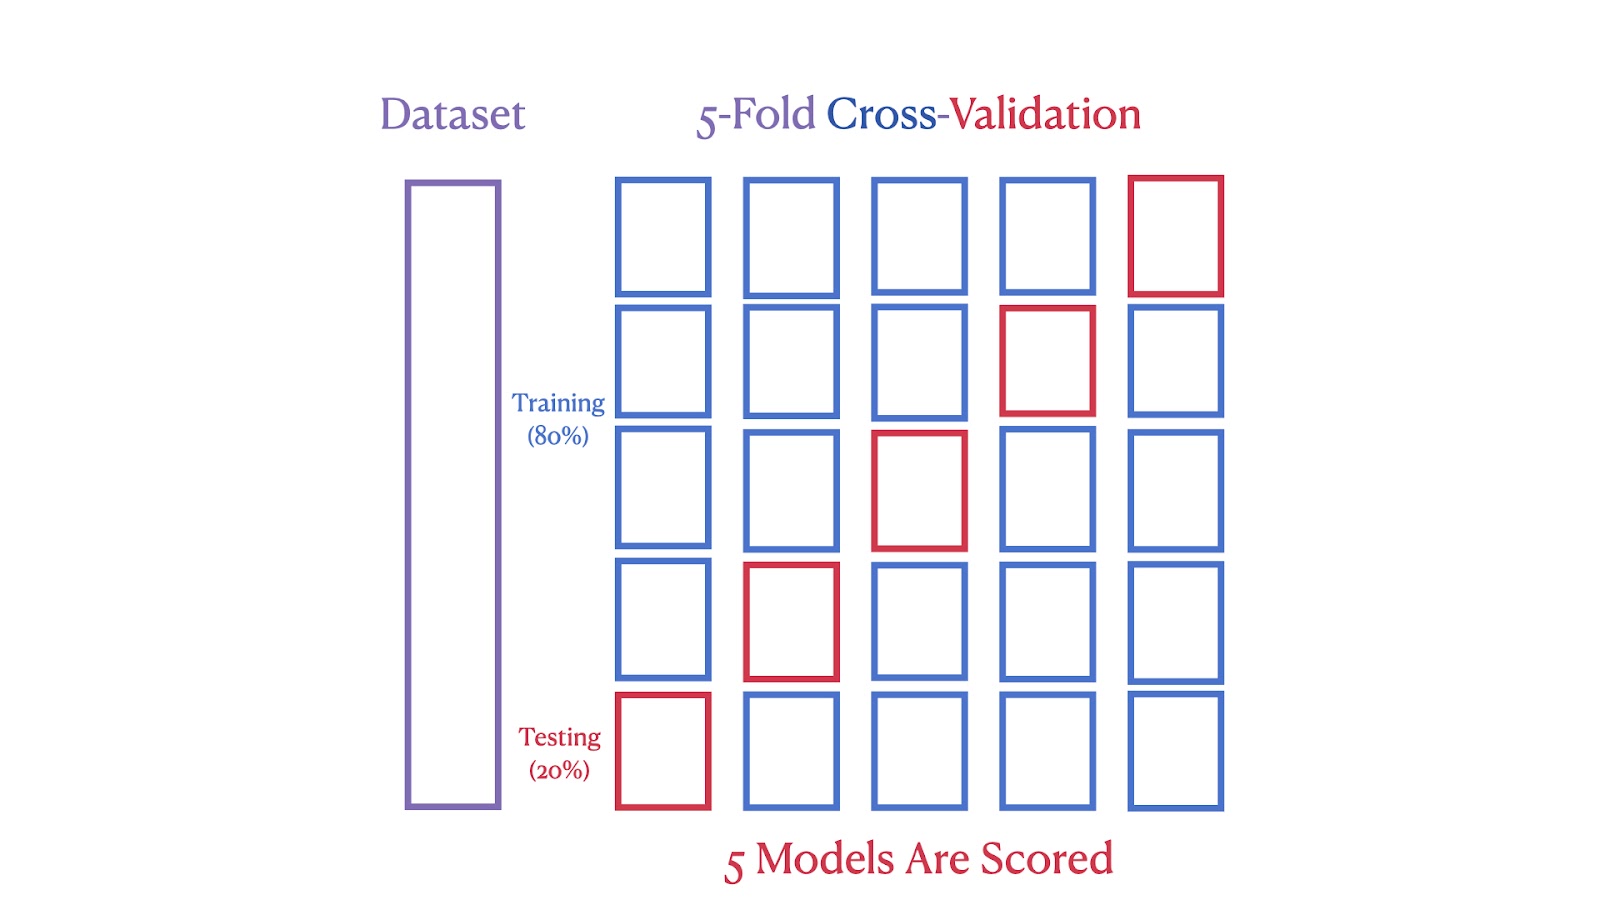
5 折交叉验证示意图。图片作者自制
可以看出,K 折交叉验证能提供更稳健、更可靠的性能估计,因为它降低了数据变异性的影响。通过多次训练与测试循环,它将模型过拟合于某一次特定划分的风险降到最低。该方法还确保每个数据点都被用于训练和验证,从而对模型性能进行更全面的评估。
在 Python 中使用 scikit-learn 实现 K 折交叉验证
现在让我们使用 California Housing 数据集来演示 K 折交叉验证,以评估线性回归模型的表现。此方法通过在数据集的不同子集上迭代测试,为模型准确性提供稳健的估计,确保评估全面。
California Housing 数据集概览
California Housing 数据集由 Pace 和 Barry(1997)整理,包含 1990 年美国人口普查中关于加州住房的数据。它包含 20,640 条观测,特征包括地理位置、房龄和人口等。目标变量为加州各学区的房价中位数。
该数据集包含多样的地理、人口与经济特征,非常适合数据科学与机器学习应用。我们将从 scikit-Learn 库直接下载它,开始代码示例。
加载数据集
在开始模型训练与评估之前,我们需要先加载数据集。
from sklearn.datasets import fetch_california_housing
data = fetch_california_housing()
这段代码从 sklearn.datasets 导入 fetch_california_housing 函数,并调用它来加载 California Housing 数据集。该数据集被存储在变量 data 中,其中包含特征和目标变量。
数据准备
加载完成后,下一步是为分析准备数据。
import pandas as pd
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target
这里我们使用 pandas 库创建 DataFrame X,其中包含 data.data 的特征数据。DataFrame 的列名使用 data.feature_names 标注。目标变量(表示房价中位数)单独存放在 y 中。
设置 K 折交叉验证
现在是设置模型的时候了,包括选择 K 的取值。选择合适的 K 是一个重要步骤,我们将在下文详细介绍。
from sklearn.model_selection import KFold
k = 5
kf = KFold(n_splits=k, shuffle=True, random_state=42)
这段代码使用 sklearn.model_selection 中的 KFold 类初始化 K 折交叉验证。我们将实例 kf 设为 5 折。shuffle=True 用于随机打乱数据点顺序,random_state=42 确保在多次运行中这种打乱保持一致。这样的设置通常足以开始使用交叉验证评估模型性能。
初始化模型
在准备好数据并设置好交叉验证后,下一步是选择并初始化模型。
from sklearn.linear_model import LinearRegression
model = LinearRegression()
我们从 sklearn.linear_model 导入 LinearRegression 类并创建一个实例 model。该模型将用于对数据集执行线性回归。
执行交叉验证
模型初始化完成后,我们可以进入“精彩部分”,通过交叉验证来评估它在不同数据子集上的表现。
from sklearn.model_selection import cross_val_score
scores = cross_val_score(model, X, y, cv=kf, scoring='r2')
这行代码使用 cross_val_score 函数来评估模型在数据集 X 和目标 y 上的表现。交叉验证采用 Kfold 实例 kf,模型性能通过 R² 分数进行度量。
计算平均 R2 分数
我们可以使用决定系数(R-squared)作为评估指标,衡量自变量对因变量方差的可解释比例,从而了解回归模型的拟合优度。
import numpy as np

average_r2 = np.mean(scores)

print(f"R² Score for each fold: {[round(score, 4) for score in scores]}")
print(f"Average R² across {k} folds: {average_r2:.2f}")
此部分计算所有折次的平均 R² 分数。先打印每一折的分数,再输出平均分。使用 np.mean() 对交叉验证期间收集的分数取平均。
展示最终结果
现在我们汇总结果,以全面了解模型表现。平均 R² 分数提供了一个衡量模型有效性的单一指标。
R² Score for each fold: [0.5758, 0.6137, 0.6086, 0.6213, 0.5875]
Average R² across 5 folds: 0.60
这是上一步代码的输出。它显示了每一折的 R² 分数以及平均 R² 分数。
K 折交叉验证中的“K”代表什么?
在 K 折交叉验证中,“K”表示将数据集划分成的组数。这个数字决定了模型需要经历多少轮测试,并确保每个分段都恰好作为一次测试集。
这里有一个经验法则:
- K = 2 或 3:当计算资源有限或需要更快速的评估时,这样的选择可能更合适。它们减少训练循环次数,从而节省时间和算力,同时仍能给出合理的性能估计。
- K = 5 或 10:选择 K = 5 或 K = 10 很受欢迎,因为它们在计算效率与性能估计之间取得了良好平衡。
- K = 20:较大的 K 值可以提供更细致的性能评估。然而,这会增加计算负担,如果子集过小,还可能导致更高的方差。
想进一步了解模型性能估计,可参考我们的综合课程 Model Validation in Python。
使用 K 折交叉验证时的关键考量
“K” 对 K 折交叉验证的影响
K(折数)会同时影响验证过程的细粒度和计算负载。较小的 K(如 3–5)速度更快,但由于每折代表的数据比例更大,可能给出不太可靠的估计,易错过多样的数据情境。较大的 K(如 10)能提供更细致的评估,但计算成本更高。常见的起点是 K=5 或 K=10,往往无需过多计算就能得到可靠估计。
在 K 折交叉验证中打乱数据的重要性
强烈建议在 K 折交叉验证中打乱数据,以提升模型评估的有效性。通过设置 shuffle=True,打乱可以打破数据集中可能存在的固有顺序,避免在验证过程中引入偏差。这确保每一折都能代表整个数据集,对于评估模型对新数据的泛化能力至关重要。但需要注意的是,在数据点的顺序具有实际意义的场景(如时间序列)中,应避免打乱以保持学习过程的完整性。
确保 K 折交叉验证的可复现性
确保 K 折交叉验证结果可复现对于验证模型稳定性和性能至关重要。可以通过设置 random_state 参数来实现,这样能确保不同运行中的数据打乱方式一致,从而得到相同的数据划分并实现结果可复现。
标准 K 折 vs. 其他交叉验证方法
选择合适的交叉验证技术对构建可靠的机器学习模型至关重要。选择很大程度上取决于数据集的具体特征和所处理的机器学习任务类型。不同技术旨在应对诸如类别不平衡或分组数据结构等各种挑战。
下表对多种最常用的交叉验证方法进行了全面比较,突出其独特特性与最佳使用场景,帮助您为特定建模需求选择最有效的技术。
| 交叉验证类型 | 适用范围 | 描述 | 何时使用 |
|---|---|---|---|
| 标准 K 折交叉验证 | 回归与分类 | 将数据集划分为 k 个等大小的折。每一折都会被用作一次测试集。 | 最适合平衡数据集,以确保对模型进行全面评估。 |
| 分层 K 折交叉验证 | 主要用于分类 | 确保每一折中的类别标签比例与原始数据集保持一致。 | 非常适合类别不平衡的分类任务,以维持类别比例。 |
| 留一法交叉验证(LOOCV) | 回归与分类 | 每个数据点都会被单独作为一次测试集,其余数据用于训练。 | 非常适合小数据集,以最大化训练数据,但计算开销较大。 |
| 留 P 法交叉验证 | 回归与分类 | 类似于 LOOCV,但每次留出 p 个数据点作为测试集。 | 适合小数据集,用于检验样本变化对模型稳定性的影响。 |
| 分组 K 折交叉验证 | 带有分组的回归与分类 | 确保同一分组不会同时出现在训练集和测试集中,适用于数据点非独立的情形。 | 适合具有逻辑分组的数据集,用于评估在独立分组上的表现。 |
| 分层分组 K 折交叉验证 | 主要用于带分组的分类 | 结合分层与分组完整性,确保分组不会被拆分到不同折中。 | 适合既有分组又类别不平衡的数据集,同时保持类别与分组完整性。 |
结论
本指南向您展示了 K 折交叉验证是评估机器学习模型的有力工具。与简单的训练/测试划分相比,它在数据的不同部分对模型进行测试,帮助您更有信心地认为模型在未见数据上也能表现良好。
如果您正投身机器学习,以下资源将对您大有裨益:
- DataCamp 的 Supervised Learning with Scikit-Learn 课程:该课程帮助您掌握预测建模。注重动手实践,非常适合入门。点击查看课程。
- Machine Learning with Python 教程:本教程拆解关键的机器学习概念并演示如何应用。非常适合巩固所学。点击阅读教程。
- Scikit-Learn 速查表:随手可查的工具。在项目中需要快速回忆机器学习函数用法时非常有用。获取速查表。
- DataCamp 的 Kaggle 竞赛课程:如果您想检验自己的技能,这门课程很合适。它教您如何在 Kaggle 竞赛中脱颖而出,将所学应用于有趣且富有竞争性的场景中。从这里开始。
无论您是刚刚起步还是想要复习提升,这些资源都可以为您提供指导。它们兼具理论与实践技巧,助您更好地构建与打磨精确的模型。