मान लीजिए आप एक मशीन लर्निंग मॉडल को प्रशिक्षित कर रहे हैं, लेकिन यह निश्चित नहीं है कि वह नए, अनदेखे डेटा पर कैसा प्रदर्शन करेगा। ऐसे में K-Fold Cross-Validation काम आता है। यह आपको इस बात की झलक देता है कि आपका मॉडल वास्तविक दुनिया में कैसा कर सकता है। यह तकनीक सुनिश्चित करने में मदद करती है कि आपकी भविष्यवाणियाँ सिर्फ एक बार की सफलता न हों, बल्कि नए, अनदेखे डेटासेट्स पर भी लगातार भरोसेमंद रहें।
इस मार्गदर्शक में, हम K-Fold Cross-Validation की मूल बातें समझेंगे और इसे Train-Test Split जैसी सरल विधियों से तुलना करेंगे। आप Python का उपयोग करके विभिन्न क्रॉस-वैलिडेशन विधियों का पता लगाएंगे और समझेंगे कि सही विधि चुनना आपके प्रोजेक्ट्स पर कितना प्रभाव डाल सकता है। अंत तक, आप इन रणनीतियों को scikit-learn के साथ लागू करने के लिए तैयार होंगे।
चलिए शुरू करते हैं और सीखते हैं कि अपनी मशीन लर्निंग कोशिशों को सच में भरोसेमंद कैसे बनाएं!
K-Fold Cross-Validation क्या है?
K-Fold Cross-Validation मशीन लर्निंग मॉडलों के प्रदर्शन का आकलन करने की एक सशक्त तकनीक है। यह विभिन्न इटरेशन में प्रशिक्षण और परीक्षण के लिए डेटासेट के अलग-अलग हिस्सों का उपयोग करके सुनिश्चित करता है कि मॉडल अनदेखे डेटा पर भी अच्छी तरह जनरलाइज़ करे।
K-Fold Cross-Validation बनाम Train-Test Split
जहाँ K-Fold Cross-Validation डेटासेट को कई उपसमूहों में बाँटकर मॉडल को क्रमिक रूप से प्रशिक्षित और परीक्षण करता है, वहीं Train-Test Split विधि डेटासेट को केवल दो भागों में विभाजित करती है: एक प्रशिक्षण के लिए और दूसरा परीक्षण के लिए। Train-Test Split सरल और जल्दी लागू की जा सकती है, लेकिन प्रदर्शन का अनुमान विशेष स्प्लिट पर अत्यधिक निर्भर हो सकता है, जिससे परिणामों में उच्च वैरिएंस आ सकता है।
नीचे दी गई छवियाँ इन दोनों विधियों के संरचनात्मक अंतर दिखाती हैं। पहली छवि Train-Test Split विधि दिखाती है, जिसमें डेटासेट को 80% प्रशिक्षण और 20% परीक्षण खंडों में विभाजित किया गया है।
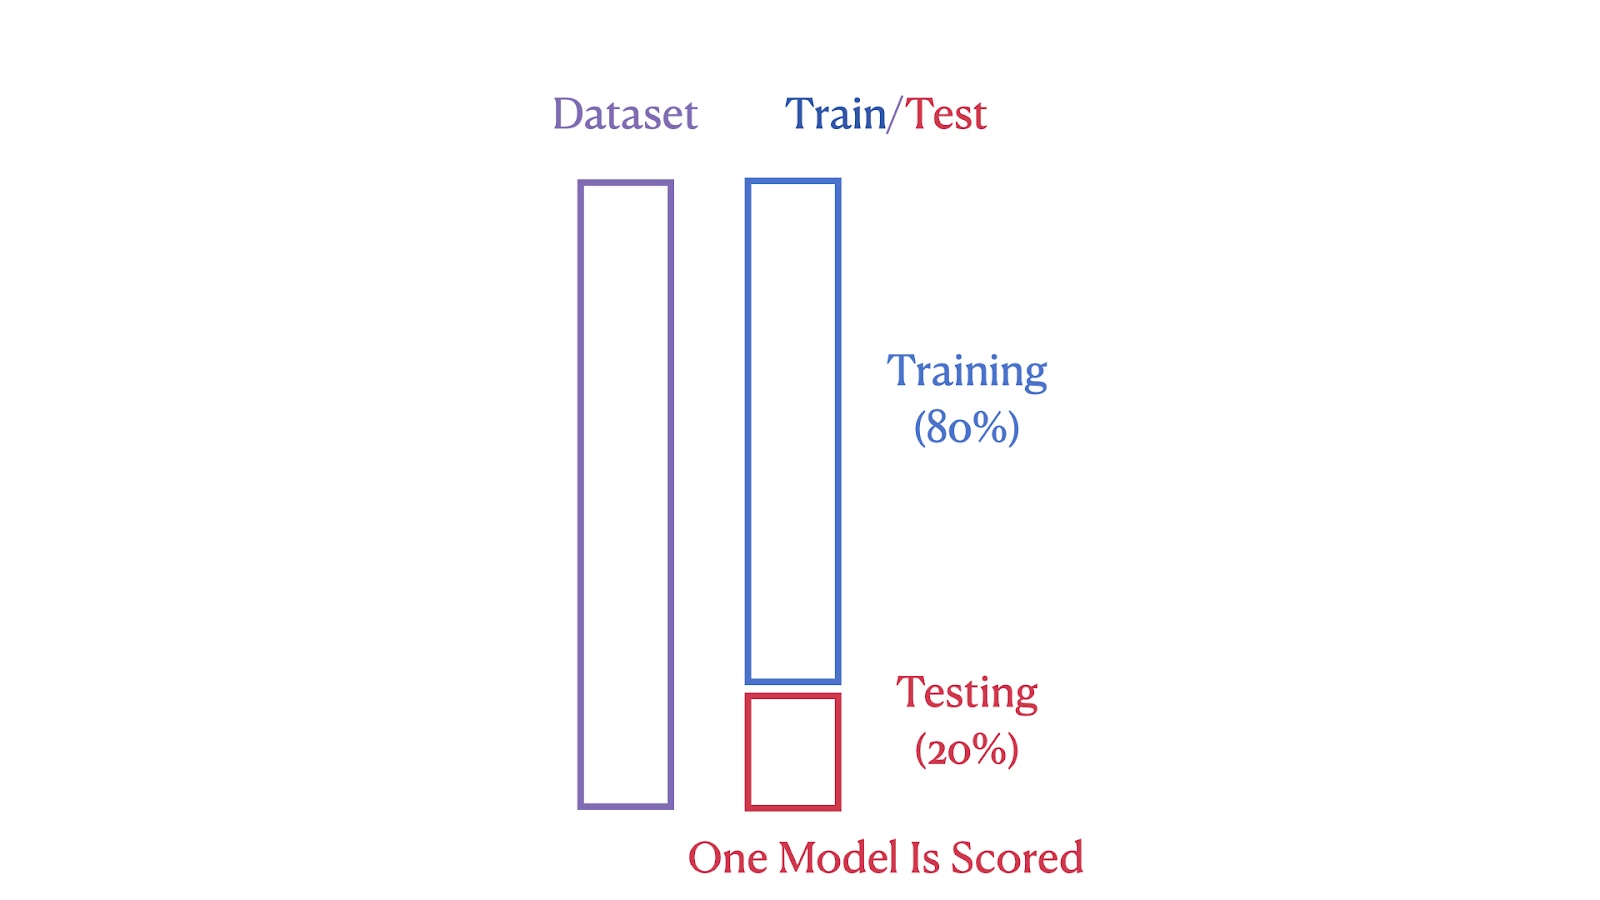
Train/Test Split का चित्रण। चित्र: लेखक
दूसरी छवि 5-Fold Cross-Validation दिखाती है, जहाँ डेटासेट को पाँच भागों में बाँटा जाता है, और प्रत्येक भाग पाँचों इटरेशन में से एक में टेस्ट सेट के रूप में काम करता है, जिससे यह सुनिश्चित होता है कि हर खंड प्रशिक्षण और परीक्षण दोनों के लिए उपयोग हो।
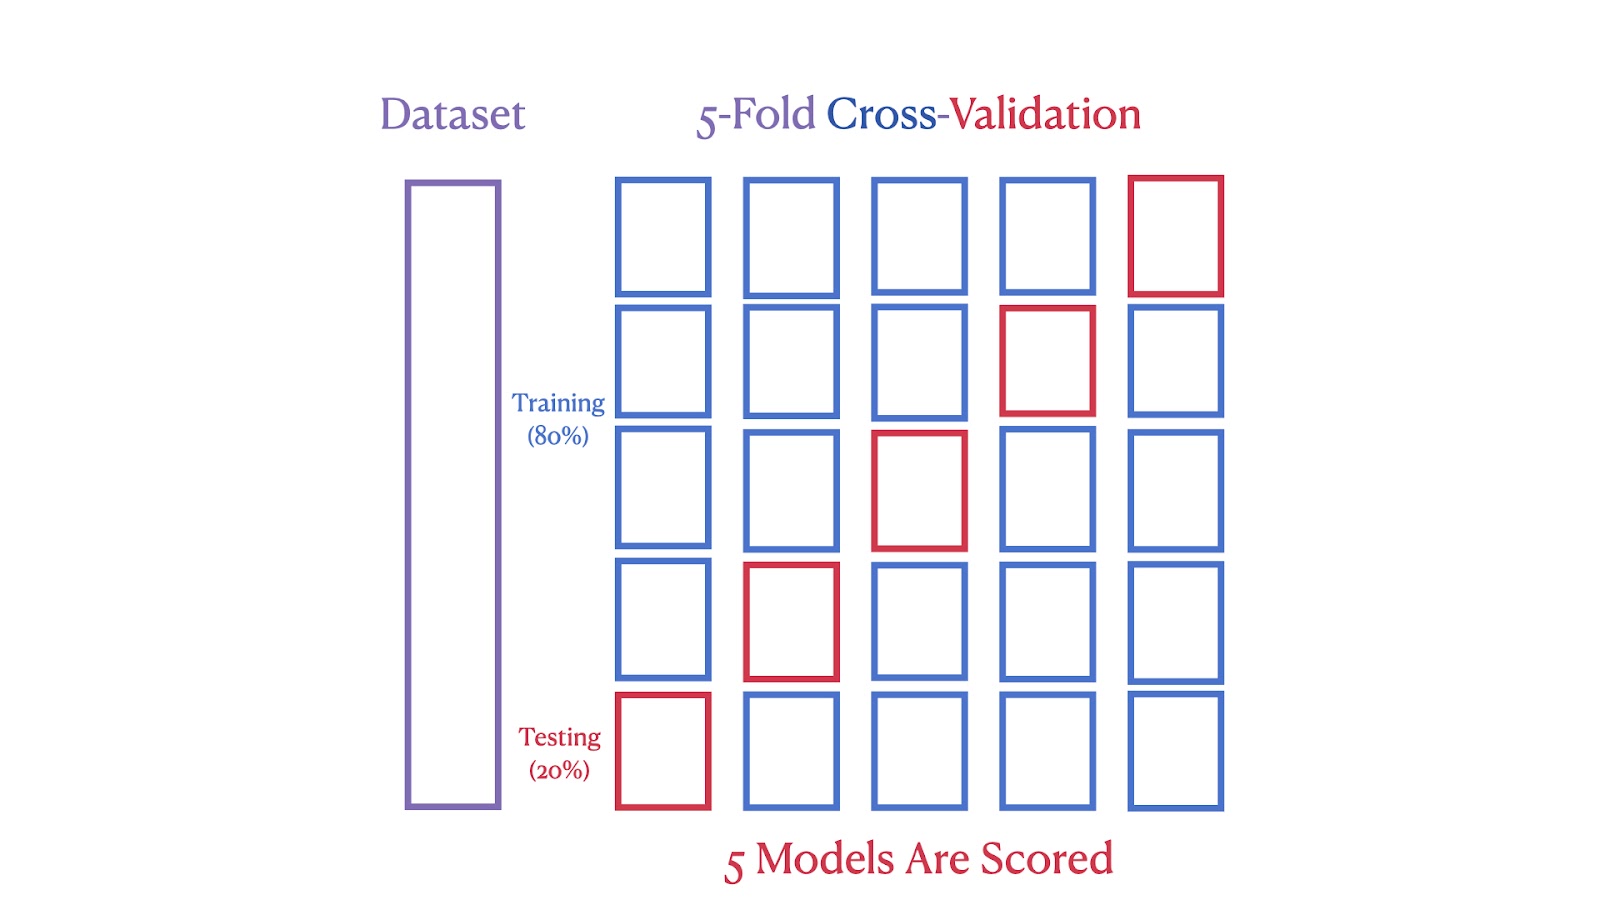
5-Fold Cross-Validation योजना। चित्र: लेखक
हम देख सकते हैं कि K-Fold Cross-Validation डेटा की परिवर्तनशीलता के प्रभाव को घटाकर अधिक सुदृढ़ और विश्वसनीय प्रदर्शन का अनुमान प्रदान करता है। कई प्रशिक्षण और परीक्षण चक्रों का उपयोग करके, यह किसी विशेष डेटा स्प्लिट पर ओवरफिटिंग के जोखिम को कम करता है। यह विधि यह भी सुनिश्चित करती है कि हर डेटा पॉइंट प्रशिक्षण और वैलिडेशन दोनों के लिए उपयोग हो, जिससे मॉडल के प्रदर्शन का अधिक व्यापक मूल्यांकन मिलता है।
scikit-learn का उपयोग करते हुए Python में K-Fold Cross-Validation लागू करना
अब हम California Housing डेटासेट का उपयोग करते हुए एक रैखिक प्रतिगमन मॉडल के प्रदर्शन का आकलन करने के लिए K-Fold Cross-Validation प्रदर्शित करेंगे। यह विधि डेटासेट के अलग-अलग उपसमूहों पर क्रमिक रूप से परीक्षण करके मॉडल की सटीकता का सुदृढ़ अनुमान प्रदान करती है, जिससे व्यापक मूल्यांकन सुनिश्चित होता है।
California Housing डेटासेट का अवलोकन
California Housing Dataset, Pace और Barry (1997) द्वारा संकलित, 1990 के अमेरिकी जनगणना से कैलिफ़ोर्निया में आवास से संबंधित डेटा शामिल करता है। इसमें 20,640 ऑब्ज़र्वेशन हैं जिनमें स्थान, आवास की आयु और जनसंख्या जैसी विशेषताएँ शामिल हैं। लक्ष्य चर कैलिफ़ोर्निया जिलों के लिए मध्यमान घर का मूल्य है।
डेटासेट भौगोलिक, जनसांख्यिकीय और आर्थिक विशेषताओं का विविध सेट प्रदान करता है, जो इसे डेटा साइंस और मशीन लर्निंग अनुप्रयोगों के लिए उपयुक्त बनाता है। हम अपना कोडिंग उदाहरण scikit-learn लाइब्रेरी से इसे सीधे डाउनलोड करके शुरू करेंगे।
डेटासेट लोड करना
मॉडल प्रशिक्षण और मूल्यांकन शुरू करने से पहले, हमें डेटासेट लोड करना होगा।
from sklearn.datasets import fetch_california_housing
data = fetch_california_housing()
यह कोड sklearn.datasets से fetch_california_housing फ़ंक्शन इम्पोर्ट करता है और फिर इसे कॉल करके California Housing डेटासेट लोड करता है। यह डेटासेट data नामक वेरिएबल में संग्रहीत होता है, जिसमें फीचर्स और लक्ष्य चर दोनों शामिल हैं।
डेटा तैयार करना
डेटासेट लोड होने के बाद, अगला चरण विश्लेषण के लिए डेटा तैयार करना है।
import pandas as pd
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target
यहाँ, हम pandas लाइब्रेरी का उपयोग करके X नाम का एक DataFrame बनाते हैं जिसमें data.data से फीचर डेटा शामिल है। DataFrame के कॉलम data.feature_names का उपयोग करके लेबल किए गए हैं। मध्यमान घर मूल्यों का प्रतिनिधित्व करने वाला लक्ष्य चर अलग से y में संग्रहीत है।
K-Fold Cross-Validation सेट करना
अब हमारा मॉडल सेट करने का समय है, जिसमें K का मान चुनना भी शामिल है। K का सही मान चुनना एक महत्वपूर्ण चरण है जिसे हम नीचे विस्तार से कवर करेंगे।
from sklearn.model_selection import KFold
k = 5
kf = KFold(n_splits=k, shuffle=True, random_state=42)
यह कोड sklearn.model_selection की KFold क्लास का उपयोग करके K-Fold Cross-Validation को इनिशियलाइज़ करता है। हम 5 स्प्लिट के साथ kf इंस्टेंस सेट करते हैं। shuffle=True विकल्प डेटा पॉइंट्स के क्रम को यादृच्छिक बनाता है, और random_state=42 यह सुनिश्चित करता है कि यह शफ़लिंग कई रन में सुसंगत रहे। यह सेटअप आमतौर पर क्रॉस-वैलिडेशन के साथ किसी मॉडल के प्रदर्शन का आकलन शुरू करने के लिए पर्याप्त होता है।
मॉडल इनिशियलाइज़ करना
डेटा तैयार होने और क्रॉस-वैलिडेशन सेट हो जाने के बाद, अगला चरण मॉडल चुनना और इनिशियलाइज़ करना है।
from sklearn.linear_model import LinearRegression
model = LinearRegression()
हम sklearn.linear_model से LinearRegression क्लास इम्पोर्ट करते हैं और model नाम का एक इंस्टेंस बनाते हैं। यह मॉडल डेटासेट पर रैखिक प्रतिगमन करने के लिए उपयोग किया जाएगा।
क्रॉस-वैलिडेशन करना
अब जब मॉडल इनिशियलाइज़ हो गया है, तो हम आगे बढ़ते हैं और डेटा के अलग-अलग उपसमूहों पर इसके प्रदर्शन का मूल्यांकन करने के लिए क्रॉस-वैलिडेशन करते हैं।
from sklearn.model_selection import cross_val_score
scores = cross_val_score(model, X, y, cv=kf, scoring='r2')
यह लाइन cross_val_score फ़ंक्शन का उपयोग करके X डेटासेट और लक्ष्य y के साथ मॉडल का मूल्यांकन करती है। क्रॉस-वैलिडेशन Kfold इंस्टेंस kf का उपयोग करके किया जाता है, और मॉडल के प्रदर्शन को R² स्कोर से मापा जाता है।
औसत R2 स्कोर की गणना
हम आश्रित चर में उस वैरिएंस के अनुपात का मूल्यांकन करने के लिए R-squared का उपयोग कर सकते हैं जो स्वतंत्र चरों से भविष्यवाणी योग्य है, जिससे प्रतिगमन मॉडल के goodness of fit की समझ मिलती है।
import numpy as np

average_r2 = np.mean(scores)

print(f"R² Score for each fold: {[round(score, 4) for score in scores]}")
print(f"Average R² across {k} folds: {average_r2:.2f}")
यह भाग सभी फोल्ड्स के लिए औसत R² स्कोर की गणना करता है। पहले प्रत्येक फोल्ड के स्कोर प्रिंट होते हैं, उसके बाद औसत स्कोर। np.mean() का उपयोग क्रॉस-वैलिडेशन के दौरान एकत्र किए गए स्कोर का औसत निकालने के लिए किया जाता है।
अंतिम परिणाम प्रदर्शित करना
अब हम परिणामों को समेकित करते हैं ताकि मॉडल के प्रदर्शन की समग्र समझ मिल सके। औसत R² स्कोर मॉडल की प्रभावशीलता को दर्शाने वाला एक एकल मीट्रिक प्रदान करता है।
R² Score for each fold: [0.5758, 0.6137, 0.6086, 0.6213, 0.5875]
Average R² across 5 folds: 0.60
यह पिछले चरण के कोड का आउटपुट है। यह प्रत्येक फोल्ड के R² स्कोर और औसत R² स्कोर को दिखाता है।
K-Fold Cross-Validation में ‘K’ क्या दर्शाता है?
K-Fold Cross-Validation में ‘K’ उस समूहों की संख्या को दर्शाता है जिनमें डेटासेट विभाजित किया गया है। यह संख्या निर्धारित करती है कि मॉडल कितने राउंड के परीक्षण से गुजरेगा, जिससे हर खंड एक बार टेस्ट सेट के रूप में उपयोग हो सके।
यहाँ एक सामान्य मार्गदर्शक है:
- K = 2 या 3: जब कंप्यूटेशनल संसाधन सीमित हों या तेज़ मूल्यांकन चाहिए, तब ये विकल्प लाभदायक हो सकते हैं। ये प्रशिक्षण चक्रों की संख्या घटाते हैं, जिससे समय और कम्प्यूटिंग शक्ति की बचत होती है, फिर भी मॉडल प्रदर्शन का यथोचित अनुमान मिलता है।
- K = 5 या 10: K = 5 या K = 10 लोकप्रिय विकल्प हैं क्योंकि ये कम्प्यूटेशनल दक्षता और मॉडल प्रदर्शन अनुमान के बीच अच्छा संतुलन प्रदान करते हैं।
- K = 20: K का बड़ा मान अधिक विस्तृत प्रदर्शन मूल्यांकन दे सकता है। हालाँकि, यह कम्प्यूटेशनल बोझ बढ़ाता है और यदि उपसमूह बहुत छोटे हों तो उच्च वैरिएंस का कारण बन सकता है।
मॉडल प्रदर्शन अनुमान पर अधिक जानकारी के लिए, हमारा व्यापक Model Validation in Python कोर्स देखें।
K-Fold Cross-Validation का उपयोग करते समय प्रमुख विचार
K-Fold Cross-Validation में 'K' का प्रभाव
K-Fold Cross-Validation में फोल्ड्स की संख्या, या 'K', वैलिडेशन प्रक्रिया की सूक्ष्मता और कम्प्यूटेशनल लोड दोनों को प्रभावित करती है। छोटा K (जैसे, 3–5) तेज़ हो सकता है लेकिन कम विश्वसनीय अनुमान दे सकता है क्योंकि प्रत्येक फोल्ड डेटासेट का बड़ा हिस्सा दर्शाता है, जिससे विविध डेटा परिदृश्यों का छूटना संभव है। बड़ा K (जैसे, 10) अधिक विस्तृत मूल्यांकन देता है, लेकिन कम्प्यूटेशन बढ़ जाता है। एक सामान्य शुरुआती बिंदु K=5 या K=10 होता है, जो बिना अत्यधिक कम्प्यूटेशन के पर्याप्त विश्वसनीय अनुमान देता है।
K-Fold Cross-Validation में डेटा को शफ़ल करने का महत्व
K-Fold Cross-Validation में डेटा को शफ़ल करना मॉडल मूल्यांकन की वैधता बढ़ाने के लिए अत्यधिक अनुशंसित है। shuffle=True सेट करने से शफ़लिंग डेटासेट में किसी भी अंतर्निहित क्रम को तोड़ देती है जो वैलिडेशन प्रक्रिया के दौरान पक्षपात ला सकता है। इससे प्रत्येक फोल्ड पूरे डेटासेट का प्रतिनिधि बनता है, जो यह आकलन करने के लिए महत्वपूर्ण है कि मॉडल नए डेटा पर कितना अच्छा जनरलाइज़ करता है। हालाँकि, जहाँ डेटा बिंदुओं का क्रम अर्थपूर्ण हो, जैसे टाइम-सीरीज़ डेटा में, वहाँ सीखने की प्रक्रिया की अखंडता बनाए रखने के लिए शफ़लिंग से बचना महत्वपूर्ण है।
K-Fold Cross-Validation में पुनरुत्पादनयोग्यता सुनिश्चित करना
K-Fold Cross-Validation के परिणामों की पुनरुत्पादनयोग्यता सुनिश्चित करना मॉडल की स्थिरता और प्रदर्शन की पुष्टि के लिए महत्वपूर्ण है। यह random_state पैरामीटर सेट करके हासिल किया जा सकता है, जो विभिन्न रन में डेटा की सुसंगत शफ़लिंग सुनिश्चित करता है, जिससे समान डेटा स्प्लिट मिलते हैं और इस प्रकार पुनरुत्पादनयोग्य परिणाम प्राप्त होते हैं।
मानक K-Fold बनाम अन्य Cross-Validation विधियाँ
विश्वसनीय मशीन लर्निंग मॉडल बनाने में सही क्रॉस-वैलिडेशन तकनीक चुनना महत्वपूर्ण है। चुनाव काफी हद तक डेटासेट की विशिष्ट विशेषताओं और हाथ में मौजूद मशीन लर्निंग कार्य के प्रकार पर निर्भर करता है। अलग-अलग तकनीकें असंतुलित डेटा या समूहित डेटा संरचनाओं जैसी विभिन्न चुनौतियों को संभालने के लिए डिज़ाइन की गई हैं।
नीचे दी गई तालिका सबसे लोकप्रिय विभिन्न क्रॉस-वैलिडेशन विधियों की व्यापक तुलना प्रदान करती है, उनकी विशिष्ट विशेषताओं और सर्वोत्तम उपयोग मामलों को उजागर करती है ताकि आप अपनी विशिष्ट मॉडलिंग आवश्यकताओं के लिए सबसे प्रभावी तकनीक का चयन कर सकें।
| CV का प्रकार | उपयोग | विवरण | कब उपयोग करें |
|---|---|---|---|
| मानक K-Fold Cross-Validation | प्रतिगमन और वर्गीकरण दोनों | डेटासेट को k समान आकार के फोल्ड्स में विभाजित करता है। प्रत्येक फोल्ड एक बार टेस्ट सेट के रूप में उपयोग होता है। | समग्र मॉडल मूल्यांकन सुनिश्चित करने के लिए संतुलित डेटासेट्स के लिए सर्वोत्तम। |
| Stratified K-Fold Cross-Validation | मुख्यतः वर्गीकरण | प्रत्येक फोल्ड में मूल डेटासेट के समान वर्ग लेबल अनुपात बनाए रखता है। | असंतुलित क्लासेस वाले वर्गीकरण कार्यों के लिए उत्कृष्ट, ताकि समूह अनुपात बने रहें। |
| Leave-One-Out Cross-Validation (LOOCV) | प्रतिगमन और वर्गीकरण दोनों | प्रत्येक डेटा पॉइंट एक बार टेस्ट सेट के रूप में उपयोग होता है, शेष प्रशिक्षण हेतु। | छोटे डेटासेट्स के लिए बढ़िया ताकि प्रशिक्षण डेटा अधिकतम हो, हालांकि कम्प्यूटेशनल रूप से भारी। |
| Leave-P-Out Cross-Validation | प्रतिगमन और वर्गीकरण दोनों | LOOCV के समान, लेकिन टेस्ट सेट के लिए p डेटा पॉइंट्स छोड़ता है। | छोटे डेटासेट्स के लिए उपयुक्त, ताकि डेटा सैंपल्स में बदलाव से मॉडल स्थिरता पर प्रभाव जाँचा जा सके। |
| Group K-Fold Cross-Validation | समूहों के साथ प्रतिगमन और वर्गीकरण दोनों | सुनिश्चित करता है कि कोई भी समूह प्रशिक्षण और टेस्ट सेट दोनों में न हो, जो तब उपयोगी है जब डेटा पॉइंट्स स्वतंत्र न हों। | तार्किक समूहों वाले डेटासेट्स के लिए उत्कृष्ट, ताकि स्वतंत्र समूहों पर प्रदर्शन जाँचा जा सके। |
| Stratified Group K-Fold Cross-Validation | मुख्यतः समूहित डेटा के साथ वर्गीकरण | स्तरीकरण और समूह अखंडता को जोड़ता है, सुनिश्चित करता है कि समूह फोल्ड्स में विभाजित न हों। | समूहित और असंतुलित डेटासेट्स के लिए उत्कृष्ट, ताकि क्लास और समूह दोनों की अखंडता बनी रहे। |
निष्कर्ष
इस मार्गदर्शक ने दिखाया कि K-Fold Cross-Validation मशीन लर्निंग मॉडलों का मूल्यांकन करने का एक सशक्त उपकरण है। यह साधारण Train-Test Split से बेहतर है क्योंकि यह आपके डेटा के विभिन्न भागों पर मॉडल का परीक्षण करता है, जिससे यह भरोसा बढ़ता है कि वह अनदेखे डेटा पर भी अच्छा करेगा।
यदि आप मशीन लर्निंग में उतर रहे हैं, तो ये कुछ बेहतरीन संसाधन आपकी मदद करेंगे:
- DataCamp का Supervised Learning with Scikit-Learn कोर्स: यह कोर्स आपको प्रेडिक्टिव मॉडलिंग समझने में मदद करता है। यह हाथों-हाथ और व्यावहारिक है, आपकी यात्रा शुरू करने के लिए उपयुक्त। कोर्स यहाँ देखें।
- Machine Learning with Python ट्यूटोरियल: यह ट्यूटोरियल प्रमुख मशीन लर्निंग अवधारणाओं को आसान बनाता है और उन्हें लागू करना दिखाता है। यह आपके ज्ञान को पुख्ता करने के लिए उपयुक्त है। ट्यूटोरियल यहाँ पढ़ें।
- Scikit-Learn Cheat Sheet: इसे पास रखें। यह प्रोजेक्ट्स पर काम करते समय मशीन लर्निंग फ़ंक्शंस के उपयोग की त्वरित याद दिलाने के लिए बेहतरीन है। चीट शीट यहाँ पाएं।
- DataCamp का Kaggle Competition कोर्स: यदि आप अपने कौशल की परीक्षा लेना चाहते हैं, तो यह कोर्स बढ़िया है। यह सिखाता है कि Kaggle प्रतियोगिताओं में कैसे बेहतर करें, जहाँ आप सीखी हुई चीज़ों को मज़ेदार, प्रतिस्पर्धी तरीके से लागू कर सकते हैं। कोर्स यहाँ से शुरू करें।
ये संसाधन आपकी राह दिखाने के लिए हैं, चाहे आप अभी शुरुआत कर रहे हों या अपने कौशल को तराशना चाहते हों। ये सिद्धांत और व्यावहारिक सुझावों का मिश्रण पेश करते हैं, ताकि आप सटीक मॉडल बनाने और निखारने के लिए अच्छी तरह तैयार रहें।