LangChain 是一个开源框架,用于构建将大语言模型(LLM)与工具相结合的智能体应用。1.0 版本标志着核心能力向生产级演进:API 更加简化、边界更清晰,并在各供应商间实现标准化的消息处理。
在本教程中,我们将构建一个基于 Streamlit 的自动会议纪要助手:输入原始笔记,生成简明扼要的纪要与行动项,并在人工批准后,将纪要追加到 Google 文档。过程中,您将看到全新的 create_agent 流程、标准内容块,以及更精简的 v1 命名空间如何协同工作。
什么是 LangChain v1?
LangChain v1 是一次面向生产的重构发布,聚焦于用于构建智能体的一小块稳定核心。它引入了:
以 create_agent 作为启动智能体的标准方式(比旧版预构建智能体更干净)。
通过 content_blocks 标准化内容,使消息在不同供应商之间保持一致。
结构化输出与中间件,实现类型化响应与安全、经人工批准的动作。
langchain 包专注于智能体积木,老模块迁移至 langchain-classic,便于发现与升级。
与 v0.x 相比,v1 通过标准化消息内容与智能体编排,降低了心智负担与供应商差异。无论使用 OpenAI、Anthropic 等,您都能获得一致的思维模型。
LangChain v1 的关键技术增强
最初的 LangChain v0.x 提供了多种构建智能体的模式,而 v1 将它们整合为使用 create_agent 的一条清晰路径,让您的智能体更易于理解、测试与发布。 它配备更干净的工具接口,并通过标准化内容与可预期的智能体循环,简化调试。
以下是该版本纳入的一些关键技术增强:
create_agent 工作流:这是一条适用于生产的智能体循环,让模型自行决定何时调用工具、何时结束。因此我们不再需要在多种模式间切换,定制也更加容易。
标准内容块:一种与供应商无关的消息读取方式——推理轨迹、工具调用、引文,甚至多模态内容,都通过统一的 content_blocks API 呈现。不同供应商下的工具与日志表现一致。
结构化输出:最新版本对类型化架构提供一等支持,让您无需脆弱的正则即可依赖可预期的 JSON。可减少解析错误与额外调用。
中间件:挂接在智能体循环中,用于批准风险动作、在历史过长时总结、以及在调用前去除敏感信息(PII)。
精简命名空间:langchain 包现在聚焦于核心智能体积木,而 LangGraph 在底层提供持久化与时光回溯等可靠性能力。
演示:用 LangChain v1 构建自动会议纪要助手
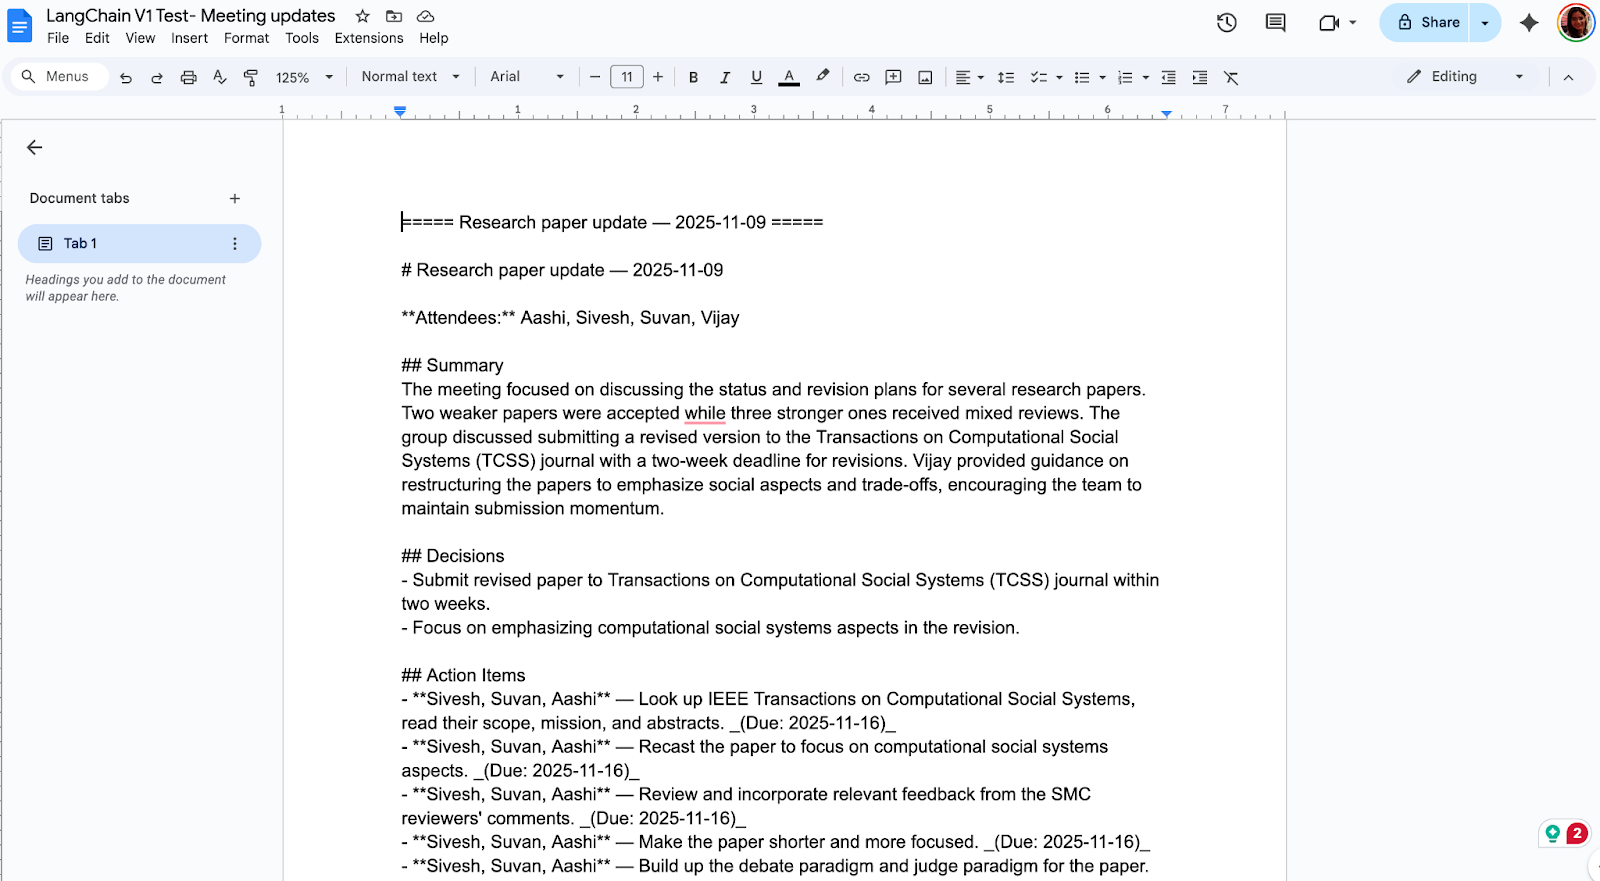
本节我们将实现一个从头到尾自动化会议纪要的 Streamlit 应用。应用接收原始会议笔记及可选元数据(标题、日期、与会者),随后生成一个类型化的 RecapDoc,包含标题、摘要、决策与行动项,并以结构化输出呈现。经单击确认后,带有会议日期前缀的已批准纪要将被追加到指定的 Google 文档。
步骤 1:先决条件
在构建自动会议纪要助手前,我们需要一套最小工具包涵盖 UI、LLM、类型验证与 Google Docs 访问。以下命令安装所需组件并设置模型密钥,以便应用与供应商通信。
pip install -U streamlit langchain langchain-openai pydantic python-dotenv
pip install -U google-api-python-client google-auth google-auth-oauthlib google-auth-httplib2
export OPENAI_API_KEY=...技术支持
各个先决条件的作用如下:
Streamlit:用于在本地运行配有简洁 Python 风格 UI 的网页应用。
langchain 和 langchain-openai:提供 LangChain v1 的简化表层(init_chat_model、结构化输出)与 OpenAI 供应商桥接。
pydantic:用于定义严格的 RecapDoc 架构,使模型返回类型化字段。
Python-dotenv:在开发期间从 .env 文件加载环境变量。
google-auth:用于处理 OAuth 与 Google Docs API,以便我们将纪要追加到文档。
OPENAI_API_KEY:OpenAI API Key 用于验证 LLM 调用,将其设置为环境变量(或使用密钥管理器)。
注意: 如果使用其他供应商(Anthropic、Google 或本地模型),请安装相应的 langchain-* 集成并设置该供应商的 API 密钥。
安装好这些依赖并设置 OPENAI_API_KEY 后,环境就绪。接下来我们将通过 Google Cloud 配置 Google Docs API。
步骤 2:启用 Google Docs API
为了将每次会议纪要保存到一个持续更新的文档,应用需要写入 Google Docs 的权限。此步骤将端到端配置该访问。首先,我们:
从 Google Cloud 获取 OAuth 客户端 文件(credentials.json)
然后,确定您要追加内容的 Google 文档 ID
最后,在您于浏览器中批准访问的首次运行后,让应用创建可复用的 token.json
完成以上三步后,应用即可一键将纪要追加到您指定的 Google 文档。您可随时删除 token.json 以撤销或重新授权,然后再次运行应用。
步骤 2.1:从 Google Cloud 获取 credentials.json
credentials.json 文件是您的应用访问 Google Docs API 的钥匙。您只需在 Google Cloud Console 里生成一次,作为桌面应用的 OAuth 客户端。开始步骤如下:
创建/选择项目
启用 Google Docs API
项目已创建。现在启用写入 Google Docs 所需的 API。
前往 APIs & Services,找到 Library。您也可以使用搜索。
搜索 Google Docs API 并点击 Enable。注意为避免不必要的费用,使用完毕后可停用该 API。
配置 OAuth 同意屏幕
启用 API 后,需要为您的首选邮箱设置认证。
前往 APIs & Services,点击 OAuth consent screen 。
选择 External 并填写基础应用信息。
在 Audience / Test users 部分,点击 Add users ,添加将要使用的 Gmail 账号,然后保存。
开发阶段将应用保持在 Testing 模式即可。
创建 OAuth 客户端凭据
最后一步是生成并下载 credentials.json 文件。步骤如下:
在 Application type 下选择 Desktop app 并点击 Create 。
至此,您已有一个桌面版 OAuth 客户端,应用可用它触发基于浏览器的登录,并代表您请求访问 Google Docs 的权限。
步骤 2.2:Google 文档 ID
应用需要知道要追加到哪个文档。该文档由 URL 中的唯一 ID 标识。本步骤:
设置正确的文档 ID 后,应用会将纪要写入您所选的那份文档。
步骤 2.3:Token.json
首次追加时,应用需要您明确批准访问文档。批准后,Google 会返回一个令牌,应用将其本地保存为 token.json。其生成方式如下:
运行应用并点击 Append to Google Doc。
浏览器窗口将打开,请使用前一步添加的测试用户之一登录,并批准相应的权限范围(scope)。
确认后,应用会在代码旁写入 token.json。该文件包含可复用的访问/刷新令牌。
注意:若需切换账号或重新进行同意流程,只需删除 token.json,再次点击 Append to Google Doc 。
步骤 3:导入模块
在编写逻辑前,先导入用于构建 UI、类型化数据契约、模型调用与 Google Docs 集成的模块。按用途分组导入可保持代码库可读性,并在出错时更容易定位问题层次。
import os
import io
import json
from datetime import date
from typing import List, Optional
import streamlit as st
from pydantic import BaseModel, Field
from dotenv import load_dotenv
from langchain. agents import create_agent
from langchain. messages import SystemMessage, HumanMessage
from langchain. chat_models import init_chat_model
from google. oauth2. credentials import Credentials
from google_auth_oauthlib. flow import InstalledAppFlow
from googleapiclient. discovery import build技术支持 本步骤仅导入应用所需内容,即标准工具如 os、io、json、date,以及用于路径、缓冲区与轻量序列化的类型提示。然后导入用于 UI 的 Streamlit ,用于定义类型化 RecapDoc 架构的 Pydantic ,以及用于加载环境变量的 dotenv。LangChain v1 表层中的 init_chat_model 与 create_agent 用于初始化与供应商无关的聊天模型与组织提示,最后是Google Docs API 相关组件,处理 OAuth 并提供已认证的客户端,以便将纪要追加到目标文档。
步骤 4:定义结构化输出
为使模型响应可靠且易用,我们为纪要定义一个类型化契约。使用 Pydantic 模型可确保 LLM 返回可预测字段,便于 UI 渲染、API 存储与自动化校验。
class ActionItem ( BaseModel) :
owner: str = Field( . . . , description= "Person responsible" )
task: str = Field( . . . , description= "Short, specific task" )
due_date: str = Field( . . . , description= "ISO date (YYYY-MM-DD) or natural language like 'next Friday'" )
class RecapDoc ( BaseModel) :
title: str
date: str
attendees: List[ str ]
summary: str
decisions: List[ str ]
action_items: List[ ActionItem] 技术支持 上述代码块的关键组件包括:
在 LangChain v1 中,您可直接通过 with_structured_output(RecapDoc) 请求该架构,减少脆弱的字符串解析、提升校验效果,并在字段缺失时快速失败。
步骤 5:系统提示
系统提示为助手设定规则。它明确告知模型需要产出什么、避免什么、以及如何组织输出,以确保后续步骤每次都稳定运行。
SYSTEM_PROMPT = """You are a precise assistant that produces concise, high-signal meeting recaps.
Return a structured RecapDoc with:
- title, date, attendees
- a brief summary (3–6 sentences)
- explicit decisions (bullet-style)
- action_items (each has owner, task, due_date)
Rules:
- Only include info supported by the notes or explicit user inputs.
- Keep action items specific with clear owners and due dates.
- If something is unknown, say "Unknown" rather than inventing details.
""" 技术支持 系统提示让助手更精准、简洁,聚焦高信息密度的纪要,而非逐字记录。它要求输出清晰的架构:标题、日期、与会者、摘要、决策与行动项,并设定了 3–6 句摘要、项目符号式决策、以及包含负责人、任务与截止日期的行动项等规则。
有了清晰的系统提示,模型通常首次就能稳定地产出可用的结构化纪要。
步骤 6:Google OAuth 助手
本步骤我们定义一个助手函数,建立到 Google Docs 的可信、可复用连接,以便应用将纪要追加到您选择的文档。它仅请求 Docs 作用域,并处理首次同意、令牌刷新与服务构建。
SCOPES = [ "https://www.googleapis.com/auth/documents" ]
def get_google_docs_service (
credentials_path: Optional[ str ] ,
token_path: str = "token.json" ,
use_secrets: bool = False
) :
creds = None
if use_secrets:
try :
if "google_credentials_json" in st. secrets:
with open ( "credentials_temp.json" , "w" ) as f:
f. write( st. secrets[ "google_credentials_json" ] )
credentials_path = "credentials_temp.json"
except Exception:
pass
if os. path. exists( token_path) :
creds = Credentials. from_authorized_user_file( token_path, SCOPES)
if not creds or not creds. valid:
if creds and creds. expired and creds. refresh_token:
try :
creds. refresh( Request( ) )
except Exception:
pass
if not creds or not creds. valid:
if not credentials_path or not os. path. exists( credentials_path) :
raise RuntimeError(
"Missing Google OAuth credentials. Provide 'credentials.json' "
"or set st.secrets['google_credentials_json']."
)
flow = InstalledAppFlow. from_client_secrets_file( credentials_path, SCOPES)
creds = flow. run_local_server( port= 0 )
with open ( token_path, "w" ) as token:
token. write( creds. to_json( ) )
return build( "docs" , "v1" , credentials= creds) 技术支持 get_google_docs_service() 函数通过以下方式处理 OAuth 与服务创建:
限定权限 :使用预定义 SCOPES 将权限限制在 Google Docs。
加载凭据 :从本地 credentials.json 或 st.secrets["google_credentials_json"] 读取(当 use_secrets=True 时)。
复用令牌 :若存在 token.json,则加载;若令牌过期且可刷新,则静默刷新。
首次同意 :如无有效令牌,则启动桌面 InstalledAppFlow,在浏览器中提示用户认证,并保存 token.json 以便后续使用。
返回客户端 :最后通过 build() 构建并返回已认证的 Docs 客户端。
配置完成后,您可复用同一 token.json 进行认证,或自动刷新令牌。若需重置访问,只需删除 token.json 并重新运行应用。
步骤 7:追加工具与 Markdown 渲染
接下来,我们将类型化的 RecapDoc 渲染为整洁的 Markdown,并追加到目标 Google 文档。一个函数负责渲染纪要,另一个函数在文档末尾执行已认证的写入。
def append_plaintext_to_doc ( docs_service, document_id: str , text: str ) :
doc = docs_service. documents( ) . get( documentId= document_id) . execute( )
end_index = doc. get( "body" , { } ) . get( "content" , [ ] ) [ - 1 ] [ "endIndex" ]
requests = [
{
"insertText" : {
"location" : { "index" : end_index - 1 } ,
"text" : text + "\n"
}
}
]
return docs_service. documents( ) . batchUpdate(
documentId= document_id,
body= { "requests" : requests}
) . execute( )
def recap_to_markdown ( recap: RecapDoc) - > str :
lines = [
f"# { recap. title} — { recap. date} " ,
"" ,
f"**Attendees:** { ', ' . join( recap. attendees) if recap. attendees else 'Unknown' } " ,
"" ,
"## Summary" ,
recap. summary. strip( ) ,
"" ,
"## Decisions" ,
]
if recap. decisions:
for d in recap. decisions:
lines. append( f"- { d} " )
else :
lines. append( "- None recorded" )
lines. append( "" )
lines. append( "## Action Items" )
if recap. action_items:
for ai in recap. action_items:
lines. append( f"- ** { ai. owner} ** — { ai. task} _(Due: { ai. due_date} )_" )
else :
lines. append( "- None recorded" )
return "\n" . join( lines) 技术支持 以上两个助手的协作方式如下:
recap_to_markdown() 函数用于构建可读性良好的摘要。包含带日期的标题、与会者、简明摘要,以及包含负责人、任务与截止日期的行动项。当字段缺失时,将回退为 “Unknown” 或 “None recorded”。
append_plaintext_to_doc() 函数会获取文档、找到当前结束索引,并通过 documents() 发出单个 insertText 请求。文本会以换行结尾,确保后续条目另起一行。
注意:对于空文档,如 endIndex 不可用,可考虑将插入位置默认为 1。
有了 Markdown 渲染与追加能力,接下来我们构建纪要生成器。
步骤 8:纪要生成器
该函数是应用的核心。它接收原始笔记与可选元数据,调用聊天模型,返回类型化的 RecapDoc,确保后续环节可预期。
def generate_recap ( model_name: str , notes: str , title: str , date_str: str , attendees_csv: str ) - > RecapDoc:
model = init_chat_model( model= model_name)
structured_llm = model. with_structured_output( RecapDoc)
attendees_hint = [ a. strip( ) for a in attendees_csv. split( "," ) ] if attendees_csv. strip( ) else [ ]
user_prompt = (
"You will receive meeting notes and metadata.\n\n"
f"Title: { title or 'Unknown' } \n" f"Date: { date_str or 'Unknown' } \n" f"Attendees: { attendees_hint if attendees_hint else 'Unknown' } \n\n" "Notes:\n"
f" { notes. strip( ) } \n" )
messages = [
SystemMessage( content= SYSTEM_PROMPT) ,
HumanMessage( content= user_prompt)
]
try :
recap = structured_llm. invoke( messages)
except Exception as e:
st. error( f"Error generating recap: { e} " )
recap = RecapDoc(
title= title or "Unknown" ,
date= date_str or "Unknown" ,
attendees= attendees_hint or [ ] ,
summary= f"Error generating summary: { str ( e) } " ,
decisions= [ ] ,
action_items= [ ]
)
return recap技术支持 纪要生成器包含三大要点:
模型初始化 :使用 init_chat_model() 按所选供应商创建聊天模型。随后调用 with_structured_output() 指定返回结构。输出将是一个匹配 RecapDoc 字段的 Python 对象。
提示拼装 :我们规范化输入,并发送两条消息:包含严格规则的 SystemMessage(系统提示)与携带标题、日期、与会者与原始笔记的 HumanMessage。
结构化生成 :structured_llm.invoke() 返回一个已验证的 RecapDoc,避免解析工作并降低幻觉风险。
通过 LangChain 的结构化输出封装调用 GPT 模型,纪要步骤将变得可靠,并可直接用于 Markdown 渲染,无需修改任何下游逻辑。
步骤 9:Streamlit 界面
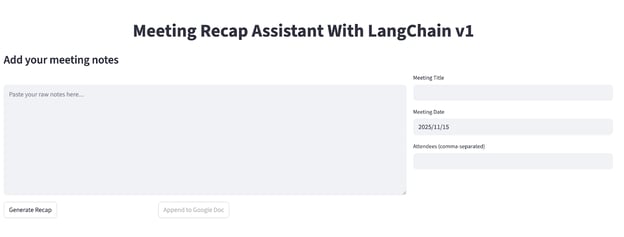
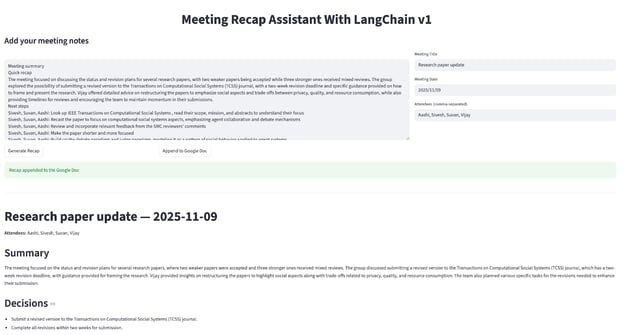
本步骤将整个演示接入到单页 Streamlit 应用中。用户粘贴笔记、补充可选元数据、生成结构化纪要、以 Markdown 预览,并一键追加到 Google 文档。
def main ( ) :
load_dotenv( )
st. set_page_config( page_title= "Meeting Recap Assistant (LangChain v1)" , page_icon= " " , layout= "wide" )
st. markdown( "<h1 style='text-align: center;'>Meeting Recap Assistant With LangChain v1</h1>" , unsafe_allow_html= True )
model_name = os. getenv( "LC_MODEL" , "gpt-4o-mini" )
document_id = "10G1k8-2JG_phkpjWM3xZEy2wNg5trUO0SJ2WN7kR3po"
cred_mode = "credentials.json file"
credentials_path = os. getenv( "GOOGLE_CREDENTIALS_JSON" , "credentials.json" )
st. subheader( " Add your meeting notes" )
colL, colR = st. columns( [ 2 , 1 ] )
with colL:
notes = st. text_area( " " , height= 300 , placeholder= "Paste your raw notes here..." )
with colR:
title = st. text_input( "Meeting Title" , value= "" )
date_str = st. date_input( "Meeting Date" , value= date. today( ) )
attendees_csv = st. text_input( "Attendees (comma-separated)" , value= "" )
if "recap" not in st. session_state:
st. session_state. recap = None
if "markdown_text" not in st. session_state:
st. session_state. markdown_text = None
col1, col2, col3 = st. columns( [ 1 , 1 , 2 ] )
with col1:
generate_btn = st. button( "Generate Recap" )
with col2:
append_btn = st. button( "Append to Google Doc" , disabled= ( st. session_state. recap is None ) )
if generate_btn:
if not notes. strip( ) :
st. error( "Please paste some notes." )
st. stop( )
try :
recap = generate_recap(
model_name= model_name,
notes= notes,
title= title,
date_str= str ( date_str) ,
attendees_csv= attendees_csv,
)
st. session_state. recap = recap
st. session_state. markdown_text = recap_to_markdown( recap)
st. rerun( )
except Exception as e:
st. exception( e)
st. stop( )
if append_btn and st. session_state. recap is not None :
try :
use_secrets = ( cred_mode == "Streamlit secrets" )
service = get_google_docs_service(
credentials_path= credentials_path if cred_mode == "credentials.json file" else None ,
use_secrets= use_secrets
)
final_text = f"\n\n===== { st. session_state. recap. title} — { st. session_state. recap. date} =====\n\n" + st. session_state. markdown_text
append_plaintext_to_doc( service, document_id, final_text)
st. success( "Recap appended to the Google Doc" )
except Exception as e:
st. exception( e)
if st. session_state. recap is not None :
st. markdown( "---" )
st. markdown( st. session_state. markdown_text)
if __name__ == "__main__" :
main( ) 技术支持 该 Streamlit 应用将“生成纪要”这一动作接入到模型,并暴露于本地 Web 界面,具体包括:
输入(左右分栏) :左侧为大的 st.text_area 输入原始笔记;右侧填写标题、日期与与会者。
输出(预览区) :当生成了纪要,应用会显示分隔线并以 Markdown 预览结构化纪要,便于快速审阅。
界面联动(动作) :这些动作构成应用的核心组件,包括:
状态 :通过 st.session_state 存储最新的 RecapDoc 与 markdown_text,使界面在重跑间保持稳定。
应用设置 :load_dotenv() 读取环境变量,st.set_page_config() 设置布局,凭据路径来自环境或默认值。
将文件保存为 app.py,并在终端运行以下命令。
streamlit run app.py技术支持 至此,您已拥有一个端到端的会议纪要工具,效果如下所示:



LangChain 是一个开源框架,用于构建将大语言模型(LLM)与工具相结合的智能体应用。1.0 版本标志着核心能力向生产级演进:API 更加简化、边界更清晰,并在各供应商间实现标准化的消息处理。
在本教程中,我们将构建一个基于 Streamlit 的自动会议纪要助手:输入原始笔记,生成简明扼要的纪要与行动项,并在人工批准后,将纪要追加到 Google 文档。过程中,您将看到全新的
create_agent流程、标准内容块,以及更精简的 v1 命名空间如何协同工作。什么是 LangChain v1?
LangChain v1 是一次面向生产的重构发布,聚焦于用于构建智能体的一小块稳定核心。它引入了:
以
create_agent作为启动智能体的标准方式(比旧版预构建智能体更干净)。通过
content_blocks标准化内容,使消息在不同供应商之间保持一致。结构化输出与中间件,实现类型化响应与安全、经人工批准的动作。
langchain 包专注于智能体积木,老模块迁移至 langchain-classic,便于发现与升级。
与 v0.x 相比,v1 通过标准化消息内容与智能体编排,降低了心智负担与供应商差异。无论使用 OpenAI、Anthropic 等,您都能获得一致的思维模型。
LangChain v1 的关键技术增强
最初的 LangChain v0.x 提供了多种构建智能体的模式,而 v1 将它们整合为使用
create_agent的一条清晰路径,让您的智能体更易于理解、测试与发布。 它配备更干净的工具接口,并通过标准化内容与可预期的智能体循环,简化调试。以下是该版本纳入的一些关键技术增强:
create_agent工作流:这是一条适用于生产的智能体循环,让模型自行决定何时调用工具、何时结束。因此我们不再需要在多种模式间切换,定制也更加容易。标准内容块:一种与供应商无关的消息读取方式——推理轨迹、工具调用、引文,甚至多模态内容,都通过统一的
content_blocksAPI 呈现。不同供应商下的工具与日志表现一致。结构化输出:最新版本对类型化架构提供一等支持,让您无需脆弱的正则即可依赖可预期的 JSON。可减少解析错误与额外调用。
中间件:挂接在智能体循环中,用于批准风险动作、在历史过长时总结、以及在调用前去除敏感信息(PII)。
精简命名空间:
langchain包现在聚焦于核心智能体积木,而 LangGraph 在底层提供持久化与时光回溯等可靠性能力。演示:用 LangChain v1 构建自动会议纪要助手
本节我们将实现一个从头到尾自动化会议纪要的 Streamlit 应用。应用接收原始会议笔记及可选元数据(标题、日期、与会者),随后生成一个类型化的
RecapDoc,包含标题、摘要、决策与行动项,并以结构化输出呈现。经单击确认后,带有会议日期前缀的已批准纪要将被追加到指定的 Google 文档。步骤 1:先决条件
在构建自动会议纪要助手前,我们需要一套最小工具包涵盖 UI、LLM、类型验证与 Google Docs 访问。以下命令安装所需组件并设置模型密钥,以便应用与供应商通信。
各个先决条件的作用如下:
Streamlit:用于在本地运行配有简洁 Python 风格 UI 的网页应用。langchain和langchain-openai:提供 LangChain v1 的简化表层(init_chat_model、结构化输出)与 OpenAI 供应商桥接。pydantic:用于定义严格的RecapDoc架构,使模型返回类型化字段。Python-dotenv:在开发期间从.env文件加载环境变量。google-auth:用于处理 OAuth 与 Google Docs API,以便我们将纪要追加到文档。OPENAI_API_KEY:OpenAI API Key 用于验证 LLM 调用,将其设置为环境变量(或使用密钥管理器)。注意:如果使用其他供应商(Anthropic、Google 或本地模型),请安装相应的
langchain-*集成并设置该供应商的 API 密钥。安装好这些依赖并设置
OPENAI_API_KEY后,环境就绪。接下来我们将通过 Google Cloud 配置 Google Docs API。步骤 2:启用 Google Docs API
为了将每次会议纪要保存到一个持续更新的文档,应用需要写入 Google Docs 的权限。此步骤将端到端配置该访问。首先,我们:
从 Google Cloud 获取OAuth 客户端文件(
credentials.json)然后,确定您要追加内容的 Google 文档 ID
最后,在您于浏览器中批准访问的首次运行后,让应用创建可复用的
token.json完成以上三步后,应用即可一键将纪要追加到您指定的 Google 文档。您可随时删除
token.json以撤销或重新授权,然后再次运行应用。步骤 2.1:从 Google Cloud 获取 credentials.json
credentials.json文件是您的应用访问 Google Docs API 的钥匙。您只需在 Google Cloud Console 里生成一次,作为桌面应用的 OAuth 客户端。开始步骤如下:创建/选择项目
启用 Google Docs API
项目已创建。现在启用写入 Google Docs 所需的 API。
配置 OAuth 同意屏幕
启用 API 后,需要为您的首选邮箱设置认证。
创建 OAuth 客户端凭据
最后一步是生成并下载 credentials.json 文件。步骤如下:
前往 APIs & Services,点击 Credentials。
点击
+ CREATE CREDENTIALS,进入 OAuth client ID。生成客户端 ID 与密钥以及可下载的 JSON 文件可能需要最多 5 分钟。
将该 JSON 文件保存为
credentials.json,与app.py放在同一文件夹(或在应用设置中提供其路径)。至此,您已有一个桌面版 OAuth 客户端,应用可用它触发基于浏览器的登录,并代表您请求访问 Google Docs 的权限。
步骤 2.2:Google 文档 ID
应用需要知道要追加到哪个文档。该文档由 URL 中的唯一 ID 标识。本步骤:
在浏览器中打开目标 Google 文档。
复制 URL 中
/d/与/edit之间的字符串,例如:https://docs.google.com/document/d/<THIS_IS_THE_ID>/edit将该文档 ID粘贴到应用的“Google Doc ID”字段(或相应配置变量)。
设置正确的文档 ID 后,应用会将纪要写入您所选的那份文档。
步骤 2.3:Token.json
首次追加时,应用需要您明确批准访问文档。批准后,Google 会返回一个令牌,应用将其本地保存为
token.json。其生成方式如下:运行应用并点击 Append to Google Doc。
浏览器窗口将打开,请使用前一步添加的测试用户之一登录,并批准相应的权限范围(scope)。
确认后,应用会在代码旁写入
token.json。该文件包含可复用的访问/刷新令牌。注意:若需切换账号或重新进行同意流程,只需删除
token.json,再次点击 Append to Google Doc。步骤 3:导入模块
在编写逻辑前,先导入用于构建 UI、类型化数据契约、模型调用与 Google Docs 集成的模块。按用途分组导入可保持代码库可读性,并在出错时更容易定位问题层次。
本步骤仅导入应用所需内容,即标准工具如 os、io、json、date,以及用于路径、缓冲区与轻量序列化的类型提示。然后导入用于 UI 的 Streamlit,用于定义类型化
RecapDoc架构的 Pydantic,以及用于加载环境变量的dotenv。LangChain v1 表层中的init_chat_model与create_agent用于初始化与供应商无关的聊天模型与组织提示,最后是Google Docs API 相关组件,处理 OAuth 并提供已认证的客户端,以便将纪要追加到目标文档。步骤 4:定义结构化输出
为使模型响应可靠且易用,我们为纪要定义一个类型化契约。使用 Pydantic 模型可确保 LLM 返回可预测字段,便于 UI 渲染、API 存储与自动化校验。
上述代码块的关键组件包括:
ActionItem类:用于捕捉后续任务要素,如owner、task与due_date,并附以简短明确的描述,便于模型干净填充。允许 ISO 日期或自然语言短语,既保持输入灵活,又便于后续解析。RecapDoc类:将整份纪要表示为一个对象,包含title、date、attendees、简明summary、明确的decisions,以及action_items列表。在 LangChain v1 中,您可直接通过
with_structured_output(RecapDoc)请求该架构,减少脆弱的字符串解析、提升校验效果,并在字段缺失时快速失败。步骤 5:系统提示
系统提示为助手设定规则。它明确告知模型需要产出什么、避免什么、以及如何组织输出,以确保后续步骤每次都稳定运行。
系统提示让助手更精准、简洁,聚焦高信息密度的纪要,而非逐字记录。它要求输出清晰的架构:标题、日期、与会者、摘要、决策与行动项,并设定了 3–6 句摘要、项目符号式决策、以及包含负责人、任务与截止日期的行动项等规则。
有了清晰的系统提示,模型通常首次就能稳定地产出可用的结构化纪要。
步骤 6:Google OAuth 助手
本步骤我们定义一个助手函数,建立到 Google Docs 的可信、可复用连接,以便应用将纪要追加到您选择的文档。它仅请求 Docs 作用域,并处理首次同意、令牌刷新与服务构建。
get_google_docs_service()函数通过以下方式处理 OAuth 与服务创建:限定权限:使用预定义
SCOPES将权限限制在 Google Docs。加载凭据:从本地
credentials.json或st.secrets["google_credentials_json"]读取(当use_secrets=True时)。复用令牌:若存在
token.json,则加载;若令牌过期且可刷新,则静默刷新。首次同意:如无有效令牌,则启动桌面
InstalledAppFlow,在浏览器中提示用户认证,并保存token.json以便后续使用。返回客户端:最后通过
build()构建并返回已认证的 Docs 客户端。配置完成后,您可复用同一
token.json进行认证,或自动刷新令牌。若需重置访问,只需删除token.json并重新运行应用。步骤 7:追加工具与 Markdown 渲染
接下来,我们将类型化的
RecapDoc渲染为整洁的 Markdown,并追加到目标 Google 文档。一个函数负责渲染纪要,另一个函数在文档末尾执行已认证的写入。以上两个助手的协作方式如下:
recap_to_markdown()函数用于构建可读性良好的摘要。包含带日期的标题、与会者、简明摘要,以及包含负责人、任务与截止日期的行动项。当字段缺失时,将回退为 “Unknown” 或 “None recorded”。append_plaintext_to_doc()函数会获取文档、找到当前结束索引,并通过documents()发出单个insertText请求。文本会以换行结尾,确保后续条目另起一行。注意:对于空文档,如
endIndex不可用,可考虑将插入位置默认为 1。有了 Markdown 渲染与追加能力,接下来我们构建纪要生成器。
步骤 8:纪要生成器
该函数是应用的核心。它接收原始笔记与可选元数据,调用聊天模型,返回类型化的
RecapDoc,确保后续环节可预期。纪要生成器包含三大要点:
模型初始化:使用
init_chat_model()按所选供应商创建聊天模型。随后调用with_structured_output()指定返回结构。输出将是一个匹配RecapDoc字段的 Python 对象。提示拼装:我们规范化输入,并发送两条消息:包含严格规则的
SystemMessage(系统提示)与携带标题、日期、与会者与原始笔记的HumanMessage。结构化生成:
structured_llm.invoke()返回一个已验证的RecapDoc,避免解析工作并降低幻觉风险。通过 LangChain 的结构化输出封装调用 GPT 模型,纪要步骤将变得可靠,并可直接用于 Markdown 渲染,无需修改任何下游逻辑。
步骤 9:Streamlit 界面
本步骤将整个演示接入到单页 Streamlit 应用中。用户粘贴笔记、补充可选元数据、生成结构化纪要、以 Markdown 预览,并一键追加到 Google 文档。
该 Streamlit 应用将“生成纪要”这一动作接入到模型,并暴露于本地 Web 界面,具体包括:
输入(左右分栏):左侧为大的
st.text_area输入原始笔记;右侧填写标题、日期与与会者。输出(预览区):当生成了纪要,应用会显示分隔线并以 Markdown 预览结构化纪要,便于快速审阅。
界面联动(动作):这些动作构成应用的核心组件,包括:
生成纪要:校验笔记,调用 generate_recap() 并转换为 Markdown,随后用
st.rerun()刷新。追加到 Google 文档:创建经认证的客户端
get_google_docs_service(),添加带日期的标题,并追加到目标文档。状态:通过
st.session_state存储最新的RecapDoc与markdown_text,使界面在重跑间保持稳定。应用设置:
load_dotenv()读取环境变量,st.set_page_config()设置布局,凭据路径来自环境或默认值。将文件保存为
app.py,并在终端运行以下命令。至此,您已拥有一个端到端的会议纪要工具,效果如下所示: