
Cursus
LLM-toepassingen ontwikkelen met LangChain
3 uur
51.3K
LangChain is een open-source framework voor het bouwen van agentische AI-applicaties die LLM’s combineren met tools. Versie 1.0 markeert een verschuiving naar een productieklare kern met een vereenvoudigde API, duidelijkere afbakeningen en gestandaardiseerde berichtafhandeling over providers heen.
In deze tutorial bouwen we een Streamlit Auto Meeting Recap Assistant die ruwe notities inneemt, een beknopt verslag met actiepunten produceert en na goedkeuring door een mens het verslag aan een Google-document toevoegt. Onderweg zie je de nieuwe create_agent-flow, standaard content blocks en de slankere v1-namespace in actie.
LangChain v1 is een herstructuurde, productiegerichte release met focus op een klein, stabiel oppervlak voor het bouwen van agents. Het introduceert:
create_agent als de standaard manier om agents te starten (schoner dan verouderde, voorgebouwde agents).
Gestandaardiseerde content via content_blocks zodat berichten consistent zijn over providers heen.
Gestructureerde output en middleware voor getypeerde reacties en veilige, door mensen goedgekeurde acties.
Het langchain-pakket focust op agent-bouwstenen, terwijl de legacy-modules naar langchain-classic verplaatsen, wat vindbaarheid en upgrades vereenvoudigt.
Vergeleken met v0.x vermindert v1 de cognitieve belasting en provider-eigenaardigheden door berichtcontent en agent-orkestratie te standaardiseren. Je krijgt hetzelfde denkkader, of je nu met OpenAI, Anthropic of anderen werkt.
De oorspronkelijke LangChain v0.x-versie bood veel patronen voor het bouwen van agents, maar v1 consolideert die tot één duidelijke route via het create_agent-blok, zodat je agents makkelijker te doorgronden, te testen en te lanceren zijn. Het komt met schonere tooling, makkelijker debuggen via gestandaardiseerde content en een voorspelbare agentloop.
Hier zijn enkele belangrijke technische verbeteringen die deel uitmaken van deze laatste release:
create_agent-workflow: Deze productieklare agentloop laat het model beslissen wanneer tools aan te roepen en wanneer te stoppen. We hoeven dus niet langer meerdere patronen te jongleren, wat maatwerk eenvoudiger maakt.
Standaard content blocks: Een providersonafhankelijke manier om berichten te lezen is via redeneertraces, tool-calls, citaties, zelfs multimodale stukjes, allemaal via een uniforme content_blocks-API. Tooling en logs zien er hetzelfde uit bij alle providers.
Gestructureerde output: De nieuwste release biedt first-class ondersteuning voor getypeerde schema’s zodat je kunt vertrouwen op voorspelbare JSON zonder harde regex. Dit vermindert parse-fouten en extra calls.
Middleware: Deze haken in op de agentloop om risicovolle acties goed te keuren, de geschiedenis samen te vatten als die lang wordt, en PII te redigeren vóór calls.
Vereenvoudigde namespace: Het langchain-pakket focust nu op essentiële agent-bouwstenen, terwijl LangGraph onder de motorkap betrouwbaarheid biedt, zoals persistentie en time-travel.
In deze sectie implementeren we een Streamlit-app die vergaderrapporten end-to-end automatiseert. De app accepteert ruwe vergadernotities met optionele metadata (titel, datum en deelnemers). Vervolgens wordt een getypeerde RecapDoc gegenereerd met titel, samenvatting, beslissingen en actiepunten als gestructureerde output. Met één klik wordt het goedgekeurde verslag (voorafgegaan door de vergaderdatum) aan een aangewezen Google Doc toegevoegd.
Voordat we de Auto Meeting Recap Assistant bouwen, hebben we een minimale toolkit nodig voor de UI, de LLM, getypeerde validatie en toegang tot Google Docs. De onderstaande commando’s installeren alles wat nodig is en stellen de modelsleutel in zodat je app met de provider kan praten.
pip install -U streamlit langchain langchain-openai pydantic python-dotenv
pip install -U google-api-python-client google-auth google-auth-oauthlib google-auth-httplib2
export OPENAI_API_KEY=...
Dit is wat elke vereiste doet:
Streamlit: Hiermee draai je lokaal de webapp met een eenvoudige, Pythonic UI.
langchain en langchain-openai: Deze bieden LangChain v1’s vereenvoudigde oppervlak (init_chat_model, gestructureerde output) en de OpenAI-providerbrug.
pydantic: Deze bibliotheek definieert het strikte RecapDoc-schema zodat het model getypeerde velden retourneert.
Python-dotenv: Laadt omgevingsvariabelen uit een .env-bestand tijdens ontwikkeling.
google-auth: Wordt gebruikt voor OAuth en de Google Docs API zodat we het verslag aan een document kunnen toevoegen.
OPENAI_API_KEY: OpenAI API-sleutel die onze LLM-calls autenticeert; stel deze in als omgevingsvariabele (of gebruik een secrets manager).
Let op: Gebruik je een andere provider (Anthropic, Google of een lokaal model), installeer dan de bijpassende langchain-*-integratie en stel de API-sleutel van die provider in.
Met deze afhankelijkheden geïnstalleerd en OPENAI_API_KEY ingesteld, is de omgeving klaar. In de volgende stappen zetten we de Google Docs API op via Google Cloud.
Om elk vergaderverslag in een levend document op te slaan, heeft de app toestemming nodig om naar Google Docs te schrijven. Deze stap regelt die toegang end-to-end. Eerst:
Verkrijg een OAuth-client-bestand (credentials.json) van Google Cloud
Identificeer vervolgens de Google Doc-ID waar je aan wilt toevoegen
Laat tot slot de app bij de eerste run na je goedkeuring in de browser een herbruikbare token.json aanmaken.
Zodra deze drie onderdelen op hun plek zijn, kan de app met één klik verslagen aan je gekozen Google Doc toevoegen. Je kunt toegang op elk moment intrekken of vernieuwen door token.json te verwijderen en de app opnieuw te draaien.
Het credentials.json-bestand is de sleutel van je app tot de Google Docs API. Je genereert het eenmalig in Google Cloud Console als een Desktop App OAuth-client. Om te beginnen:
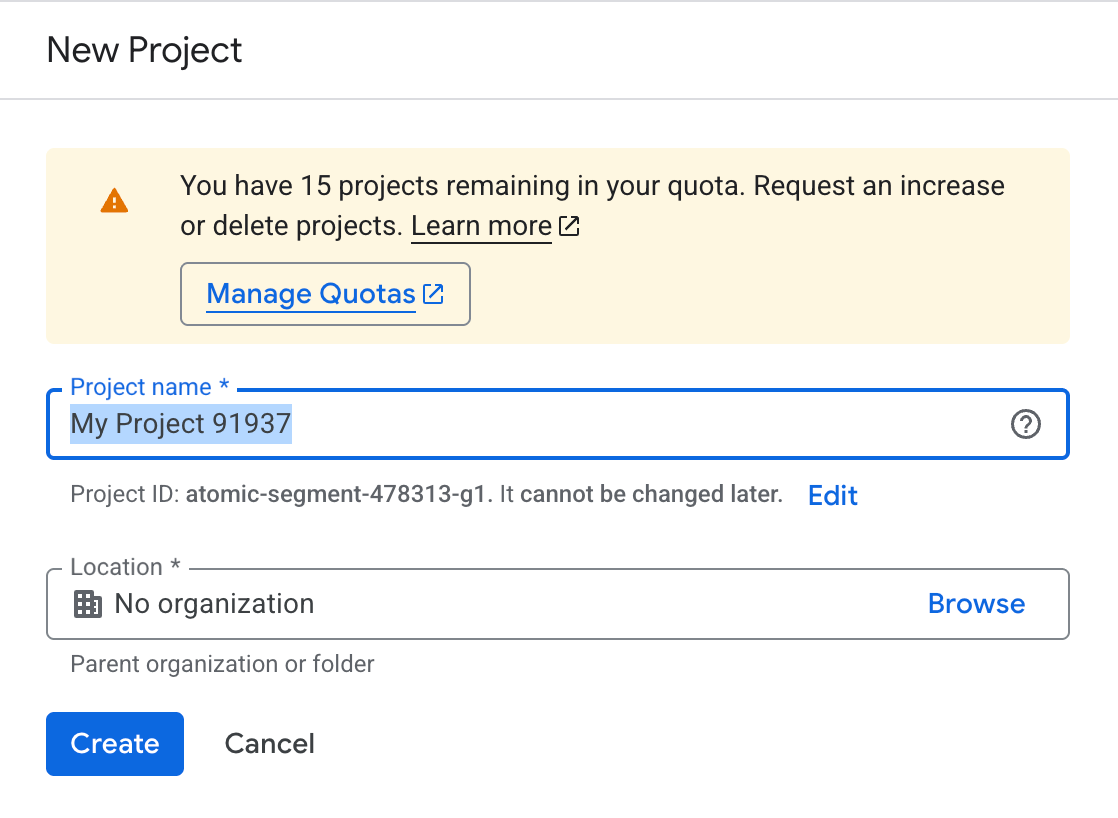
Nu ons project is aangemaakt. Laten we de API inschakelen die nodig is om in Google Docs te schrijven.
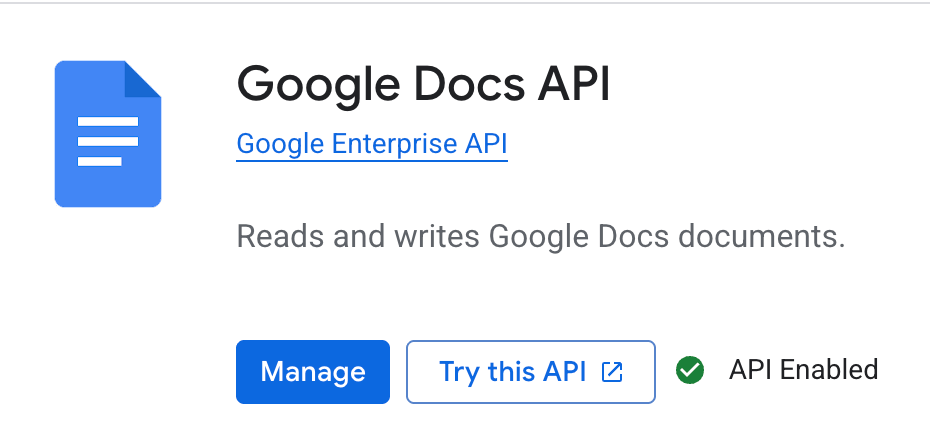
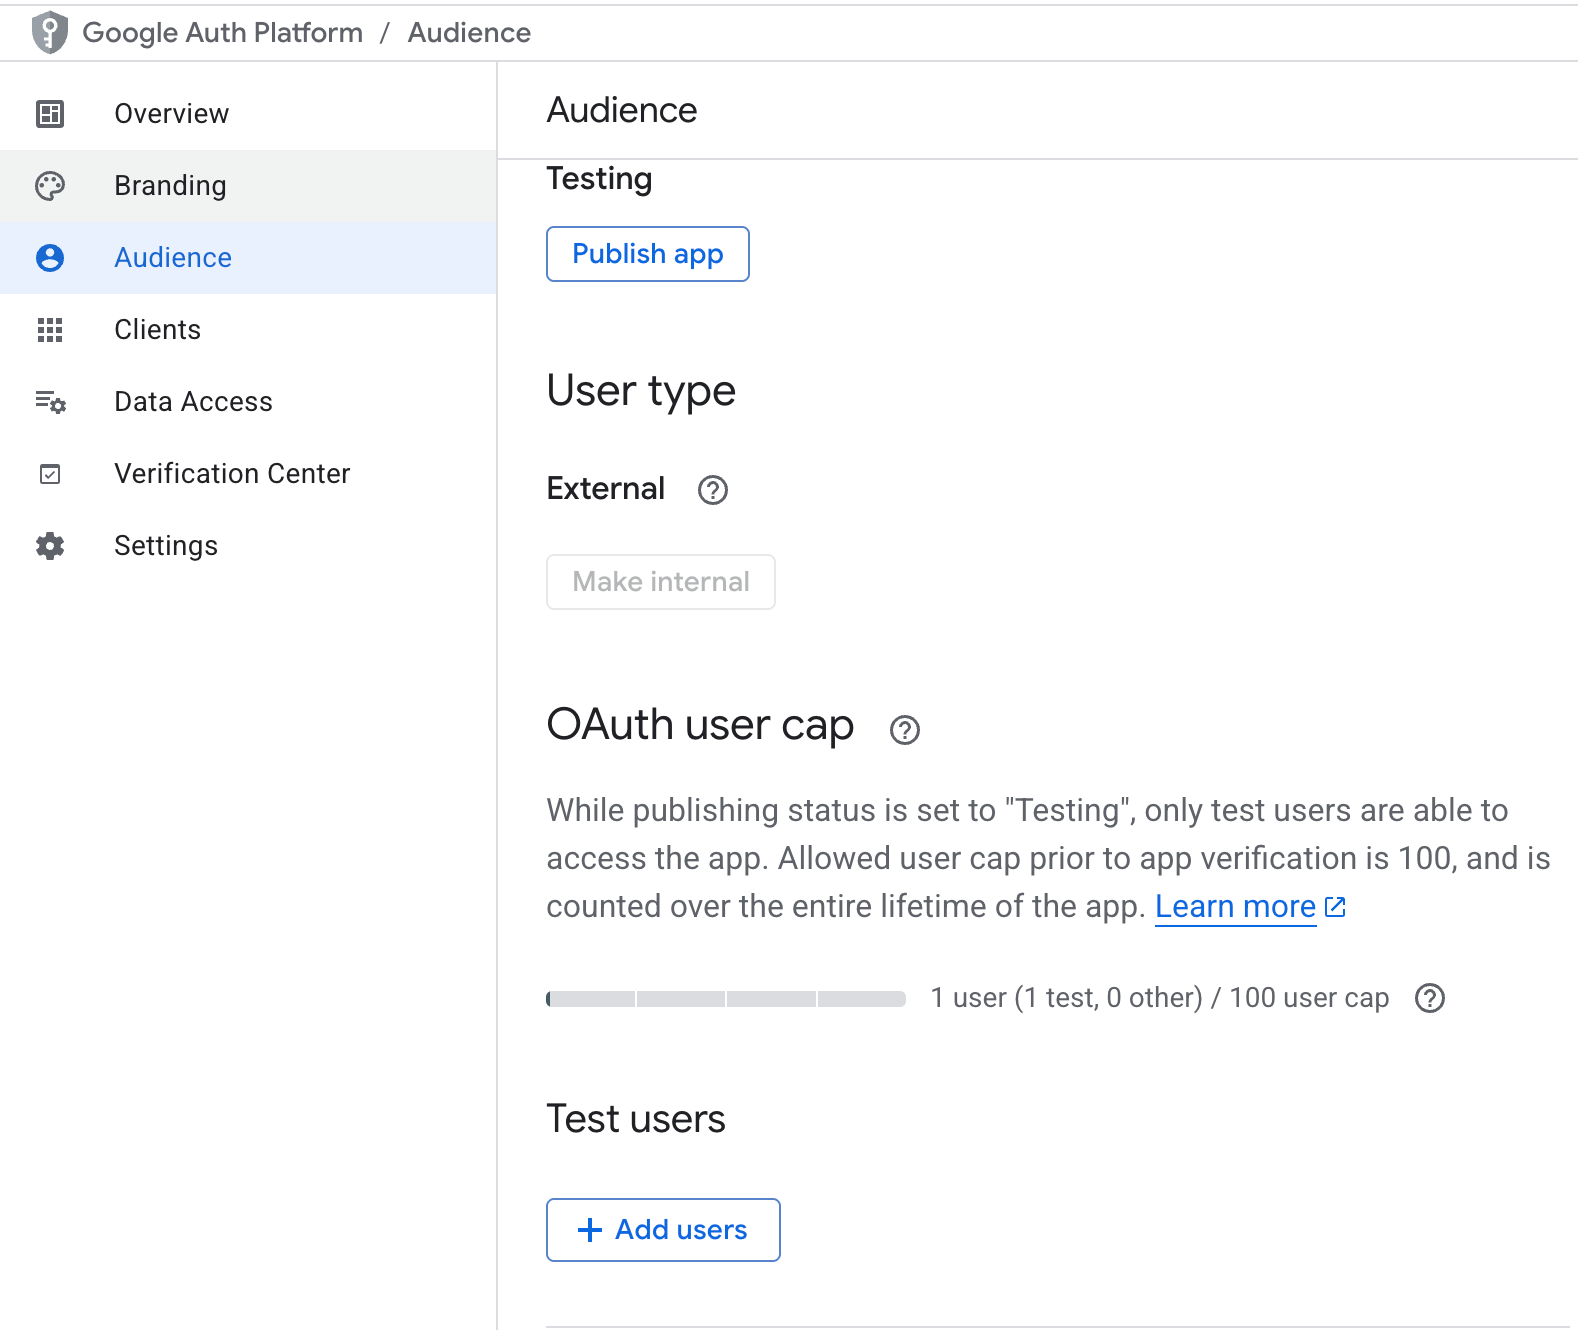
Zodra de API is ingeschakeld, moeten we authenticatie instellen voor onze voorkeursmail.
De laatste stap is het genereren en downloaden van het credentials.json-bestand. Hiervoor:
Ga naar APIs & Services en klik op Credentials.
Klik op + CREATE CREDENTIALS wat je naar OAuth-client-ID leidt.
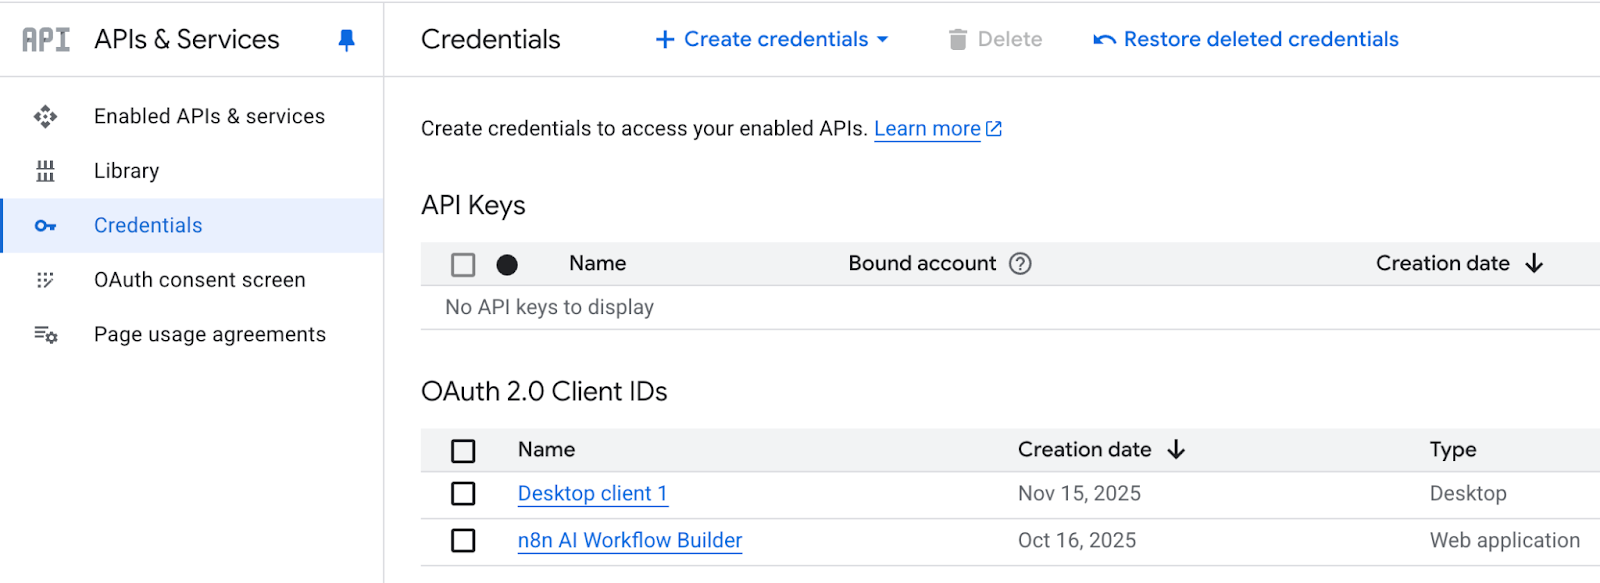
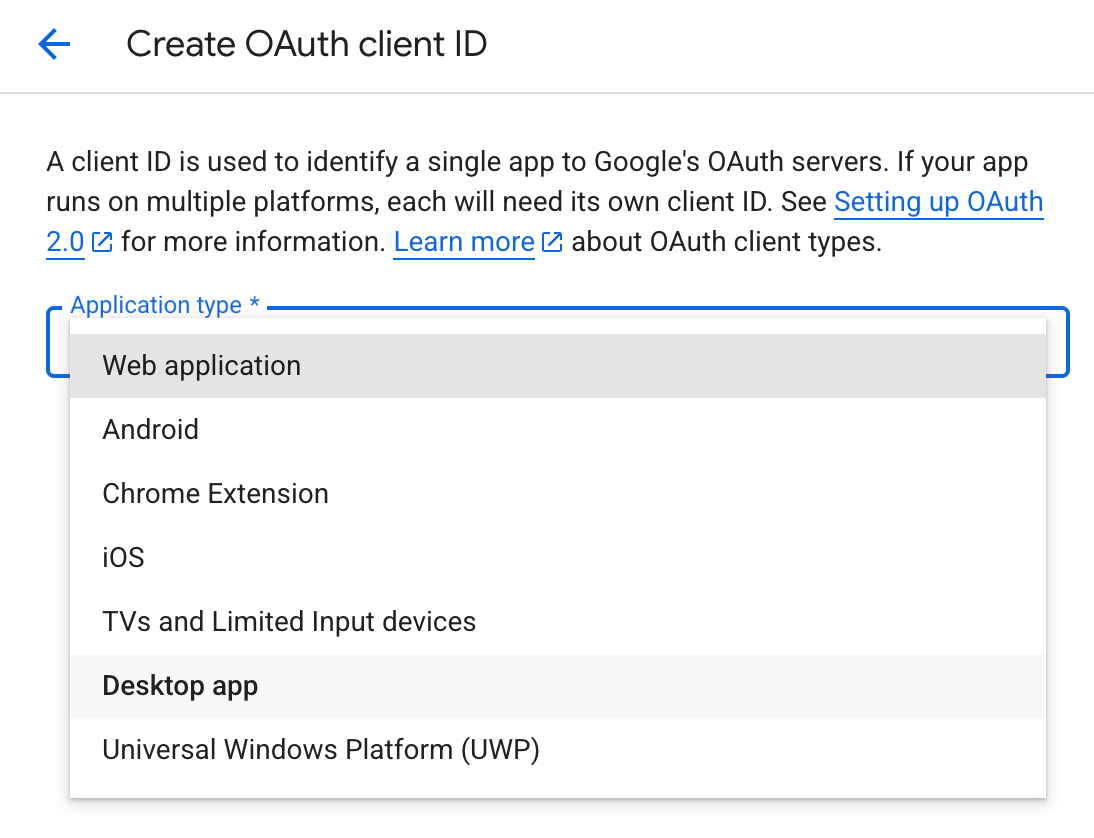
Het kan tot 5 minuten duren om de client-ID en secret te genereren, samen met een downloadbaar JSON-bestand.
Sla het JSON-bestand op als credentials.json in dezelfde map als je app.py (of geef het pad op in je app-instellingen).
Je hebt nu een Desktop OAuth-client die de app kan gebruiken om een browsergebaseerde aanmelding te starten en toestemming te vragen om namens jou toegang te krijgen tot Google Docs.
De app moet weten aan welk document moet worden toegevoegd. Dat document wordt geïdentificeerd door een unieke ID in de URL. Voor deze stap,
Open je doel-Google Doc in een browser.
Kopieer de tekenreeks in de URL tussen /d/ en /edit, bijvoorbeeld: https://docs.google.com/document/d/<THIS_IS_THE_ID>/edit
Plak deze Doc-ID in het veld “Google Doc ID” van de app (of de juiste configvariabele).
Met de juiste Doc-ID schrijft de app verslagen naar precies het door jou geselecteerde document.
Bij de eerste toevoeging heeft de app je expliciete goedkeuring nodig om toegang te krijgen tot het document. Nadat je goedkeurt, geeft Google een token terug dat de app lokaal opslaat als token.json. Zo wordt dit bestand gegenereerd:
Draai de app en klik op Append to Google Doc.
Er opent een browservenster waarin je je aanmeldt met een van de testgebruikers die je in de vorige stap hebt toegevoegd en de scope goedkeurt.
Nadat je bevestigt, schrijft de app token.json naast je code. Dit bestand bevat je herbruikbare access/refresh tokens.
Let op: Als je ooit van account wilt wisselen of toestemming opnieuw wilt doorlopen, verwijder dan gewoon token.json en klik opnieuw op Append to Google Doc.
Voordat we logica schrijven, importeren we de modules die de UI, getypeerde datacontracten, modelcalls en Google Docs-integratie aandrijven. Imports groeperen per doel houdt de codebase leesbaar en maakt meteen duidelijk welke laag je moet troubleshooten als er iets stukgaat.
import os
import io
import json
from datetime import date
from typing import List, Optional
import streamlit as st
from pydantic import BaseModel, Field
from dotenv import load_dotenv
# ---- LangChain v1 surface ----
from langchain.agents import create_agent
from langchain.messages import SystemMessage, HumanMessage
from langchain.chat_models import init_chat_model
# ---- Google Docs API ----
from google.oauth2.credentials import Credentials
from google_auth_oauthlib.flow import InstalledAppFlow
from googleapiclient.discovery import build
Voor deze stap importeren we alleen wat de app nodig heeft, dus standaardhulpmiddelen zoals os, io, json, date en typing-hints voor paden, buffers en lichte serialisatie. Dan importeren we Streamlit voor de UI, Pydantic voor de getypeerde RecapDoc-schema’s en dotenv om omgevingsvariabelen te laden. Het LangChain v1-oppervlak init_chat_model en create_agent om een providersonafhankelijk chatmodel te initialiseren en prompts te structureren, en tot slot de Google Docs API-onderdelen die OAuth afhandelen en ons een geauthenticeerde client geven om verslagen aan het gekozen document toe te voegen.
Om de respons van het model betrouwbaar en makkelijk bruikbaar te maken, definiëren we een getypeerd contract voor het verslag. Met Pydantic-modellen zorg je dat de LLM voorspelbare velden retourneert die onze UI kan renderen, een API kan opslaan en automatiseringen kunnen valideren.
class ActionItem(BaseModel):
    owner: str = Field(..., description="Person responsible")
    task: str = Field(..., description="Short, specific task")
    due_date: str = Field(..., description="ISO date (YYYY-MM-DD) or natural language like 'next Friday'")
class RecapDoc(BaseModel):
    title: str
    date: str
    attendees: List[str]
    summary: str
    decisions: List[str]
    action_items: List[ActionItem]
Dit zijn de belangrijkste onderdelen van het bovenstaande codeblok:
ActionItem-klasse: Deze legt de essentie van een vervolgtaak vast zoals owner, task en due_date met korte, expliciete beschrijvingen zodat het model ze netjes invult. ISO-datums toestaan of natuurlijke zinnen houdt invoer flexibel en toch downstream parseerbaar.
RecapDoc klasse: Deze klasse representeert het volledige verslag als één object, inclusief title, date, attendees, een beknopte summary, expliciete decisions en een lijst met action_items.
Met LangChain v1 kun je dit schema direct opvragen via with_structured_output(RecapDoc), wat broze stringparsing vermindert, validatie verbetert en je snel laat falen wanneer velden ontbreken.
De systeemprompt zet de spelregels voor je assistent. Het vertelt het model exact wat te produceren, wat te vermijden en hoe de output te structureren zodat downstream-stappen elke keer betrouwbaar werken.
SYSTEM_PROMPT = """You are a precise assistant that produces concise, high-signal meeting recaps.
Return a structured RecapDoc with:
- title, date, attendees
- a brief summary (3–6 sentences)
- explicit decisions (bullet-style)
- action_items (each has owner, task, due_date)
Rules:
- Only include info supported by the notes or explicit user inputs.
- Keep action items specific with clear owners and due dates.
- If something is unknown, say "Unknown" rather than inventing details.
"""
De systeemprompt maakt de assistent precies en beknopt, gericht op high-signal verslagen in plaats van transcripten. Het geeft een strak schema met titel, datum, deelnemers, samenvatting, beslissingen, actie_items met regels zoals: samenvatting van 3–6 zinnen, bullet-beslissingen en actiepunten met eigenaar, taak en deadline.
Met een duidelijke systeemprompt produceert het model consequent bruikbare, gestructureerde verslagen bij de eerste poging.
In deze stap definiëren we een helperfunctie die een vertrouwde, herbruikbare verbinding met Google Docs tot stand brengt zodat de app verslagen aan je gekozen document kan toevoegen. Hij vraagt alleen de Docs-scope en handelt eerste toestemming, tokenvernieuwing en serviceconstructie af.
SCOPES = ["https://www.googleapis.com/auth/documents"]
def get_google_docs_service(
    credentials_path: Optional[str],
    token_path: str = "token.json",
    use_secrets: bool = False
):
    creds = None
    if use_secrets:
        try:
            if "google_credentials_json" in st.secrets:
                with open("credentials_temp.json", "w") as f:
                    f.write(st.secrets["google_credentials_json"])
                credentials_path = "credentials_temp.json"
        except Exception:
            pass
    if os.path.exists(token_path):
        creds = Credentials.from_authorized_user_file(token_path, SCOPES)
    if not creds or not creds.valid:
        if creds and creds.expired and creds.refresh_token:
            try:
                creds.refresh(Request())
            except Exception:
                pass
        if not creds or not creds.valid:
            if not credentials_path or not os.path.exists(credentials_path):
                raise RuntimeError(
                    "Missing Google OAuth credentials. Provide 'credentials.json' "
                    "or set st.secrets['google_credentials_json']."
                )
            flow = InstalledAppFlow.from_client_secrets_file(credentials_path, SCOPES)
            creds = flow.run_local_server(port=0)
            with open(token_path, "w") as token:
                token.write(creds.to_json())
    return build("docs", "v1", credentials=creds)
De get_google_docs_service()-functie handelt OAuth en servicecreatie af door:
Toegang af te bakenen: De bovenstaande functie gebruikt vooraf gedefinieerde SCOPES om machtigingen tot Google Docs te beperken.
Credentials te laden: Hij leest uit een lokale credentials.json of uit st.secrets["google_credentials_json"] wat de geheimenopslag van Streamlit is wanneer use_secrets=True.
Tokens te hergebruiken: Als token.json bestaat, laadt de code deze en als het token verlopen is, wordt het stilzwijgend vernieuwd.
Eerste toestemming: Als er geen geldig token is, starten we de Desktop-InstalledAppFlow, die de gebruiker in de browser vraagt te authenticeren en daarna token.json opslaat voor toekomstige runs.
Een client terug te geven: Tot slot bouwen en retourneren we een geauthenticeerde Docs-client via de build()-functie.
Eenmaal geconfigureerd, kun je hetzelfde token.json blijven gebruiken voor authenticatie of het token automatisch verversen. Om toegang te resetten, verwijder je gewoon token.json en draai je de app opnieuw.
Vervolgens zetten we een getypeerde RecapDoc om in schone Markdown die wordt toegevoegd aan de doel-Google Doc. Één functie rendert het verslag, de andere voert de geauthenticeerde schrijfopdracht aan het einde van het document uit.
def append_plaintext_to_doc(docs_service, document_id: str, text: str):
    doc = docs_service.documents().get(documentId=document_id).execute()
    end_index = doc.get("body", {}).get("content", [])[-1]["endIndex"]
    requests = [
        {
            "insertText": {
                "location": {"index": end_index - 1},
                "text": text + "\n"
            }
        }
    ]
    return docs_service.documents().batchUpdate(
        documentId=document_id,
        body={"requests": requests}
    ).execute()
def recap_to_markdown(recap: RecapDoc) -> str:
    lines = [
        f"# {recap.title} — {recap.date}",
        "",
        f"**Attendees:** {', '.join(recap.attendees) if recap.attendees else 'Unknown'}",
        "",
        "## Summary",
        recap.summary.strip(),
        "",
        "## Decisions",
    ]
    if recap.decisions:
        for d in recap.decisions:
            lines.append(f"- {d}")
    else:
        lines.append("- None recorded")
    lines.append("")
    lines.append("## Action Items")
    if recap.action_items:
        for ai in recap.action_items:
            lines.append(f"- **{ai.owner}** — {ai.task} _(Due: {ai.due_date})_")
    else:
        lines.append("- None recorded")
    return "\n".join(lines)
De bovenstaande twee helpers werken als volgt samen:
De functie recap_to_markdown() bouwt een leesbare samenvatting. Hij bevat een titel met datum, deelnemers, een beknopte samenvatting en actiepunten met eigenaar, taak en deadline. Ook valt hij terug op “Unknown” of “None recorded” als velden ontbreken.
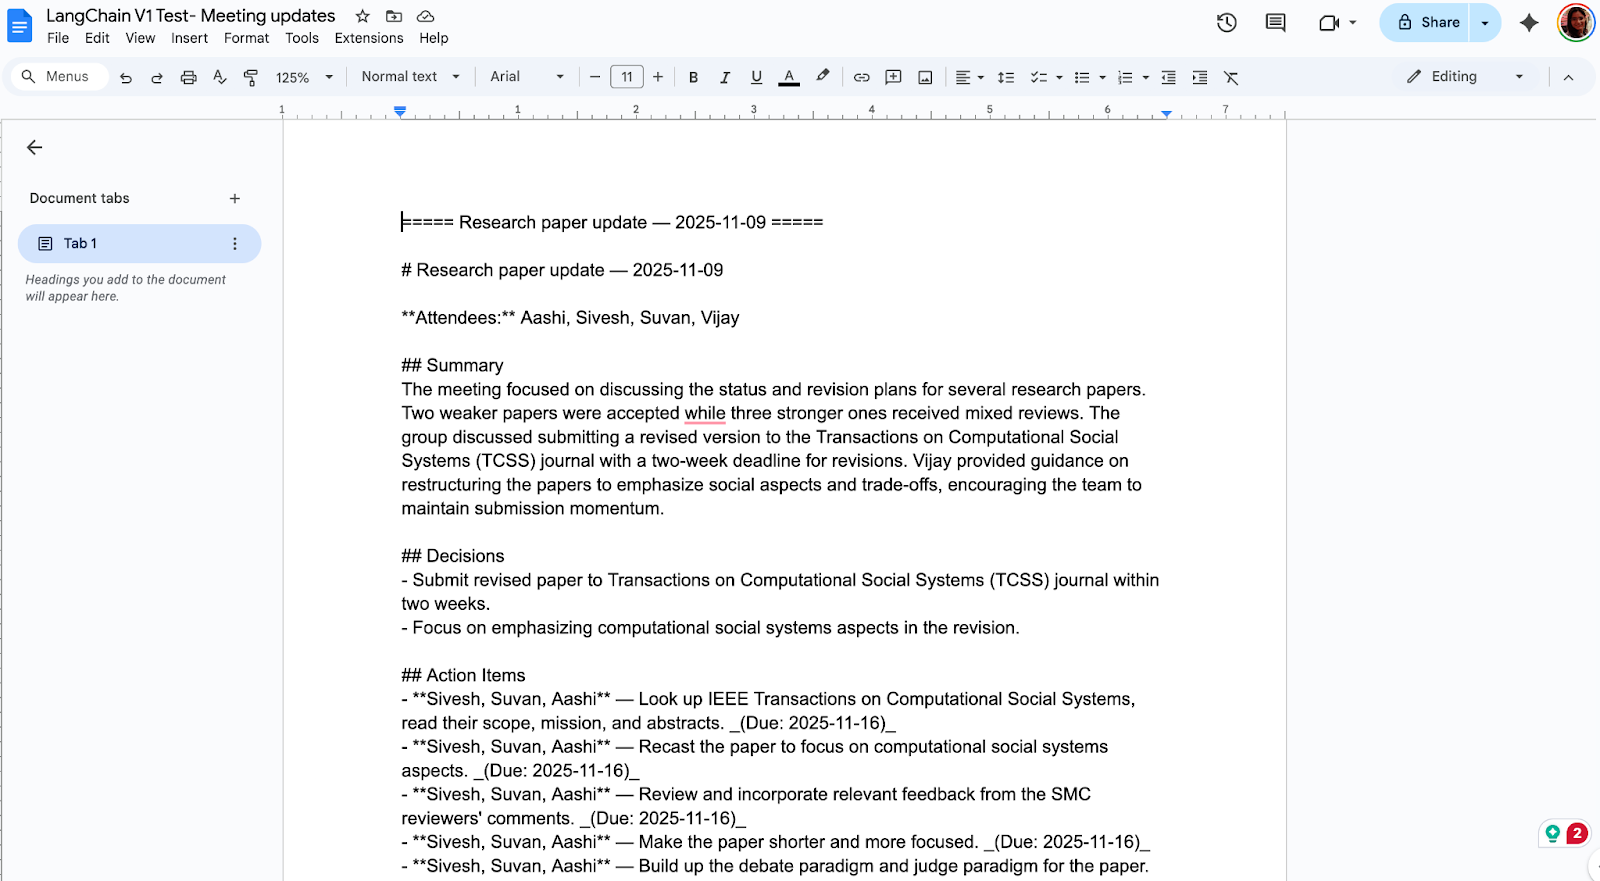
De functie append_plaintext_to_doc() haalt het document op, vindt de huidige eindindex en doet een enkele insertText-aanvraag via documents(). De tekst wordt toegevoegd met een afsluitende newline zodat volgende items op een nieuwe regel beginnen.
Let op: Voor lege documenten kun je overwegen de invoegindex standaard op 1 te zetten als endIndex niet beschikbaar is.
Met Markdown-rendering en toevoegen geregeld, zetten we nu onze verslaggenerator op.
Deze functie is het hart van de app. Hij neemt ruwe notities en optionele metadata, roept een chatmodel aan en retourneert een getypeerde RecapDoc zodat alles downstream voorspelbaar blijft.
def generate_recap(model_name: str, notes: str, title: str, date_str: str, attendees_csv: str) -> RecapDoc:
    model = init_chat_model(model=model_name)
    structured_llm = model.with_structured_output(RecapDoc)
    attendees_hint = [a.strip() for a in attendees_csv.split(",")] if attendees_csv.strip() else []
    user_prompt = (
        "You will receive meeting notes and metadata.\n\n"
        f"Title: {title or 'Unknown'}\n"
        f"Date: {date_str or 'Unknown'}\n"
        f"Attendees: {attendees_hint if attendees_hint else 'Unknown'}\n\n"
        "Notes:\n"
        f"{notes.strip()}\n"
    )
    messages = [
        SystemMessage(content=SYSTEM_PROMPT),
        HumanMessage(content=user_prompt)
    ]
    try:
        recap = structured_llm.invoke(messages)
    except Exception as e:
        st.error(f"Error generating recap: {e}")
        recap = RecapDoc(
            title=title or "Unknown",
            date=date_str or "Unknown",
            attendees=attendees_hint or [],
            summary=f"Error generating summary: {str(e)}",
            decisions=[],
            action_items=[]
        )
    return recap
De verslaggenerator bevat drie kernonderdelen:
Modelinitialisatie: De functie init_chat_model() maakt een chatmodel voor je gekozen provider. Vervolgens roepen we with_structured_output() aan om het model precies te vertellen welke vorm het moet retourneren. Het geeft een Python-object terug dat overeenkomt met de velden van RecapDoc.
Promptopbouw: We normaliseren invoer en sturen twee berichten: een SystemMessage met strikte regels (de systeemprompt) en een HumanMessage met titel, datum, deelnemers en ruwe notities.
Gestructureerde generatie: De functie structured_llm.invoke() retourneert een gevalideerde RecapDoc, waardoor parsing overbodig wordt en hallucinaties afnemen.
Door je GPT-model via LangChains wrapper voor gestructureerde output te laten lopen, wordt de verslagstap betrouwbaar en klaar voor Markdown-rendering zonder dat downstream-logica hoeft te veranderen.
In deze stap verbinden we de hele demo tot een one-page Streamlit-app. De gebruiker plakt notities, voegt optionele metadata toe, genereert een gestructureerd verslag, bekijkt een Markdown-preview en voegt het met een klik toe aan een Google Doc.
def main():
    load_dotenv()
    st.set_page_config(page_title="Meeting Recap Assistant (LangChain v1)", page_icon=" ", layout="wide")
    st.markdown("<h1 style='text-align: center;'>Meeting Recap Assistant With LangChain v1</h1>", unsafe_allow_html=True)
    model_name = os.getenv("LC_MODEL", "gpt-4o-mini")
    document_id = "10G1k8-2JG_phkpjWM3xZEy2wNg5trUO0SJ2WN7kR3po"
    cred_mode = "credentials.json file"
    credentials_path = os.getenv("GOOGLE_CREDENTIALS_JSON", "credentials.json")
    st.subheader(" Add your meeting notes")
    colL, colR = st.columns([2, 1])
    with colL:
        notes = st.text_area(" ", height=300, placeholder="Paste your raw notes here...")
    with colR:
        title = st.text_input("Meeting Title", value="")
        date_str = st.date_input("Meeting Date", value=date.today())
        attendees_csv = st.text_input("Attendees (comma-separated)", value="")
    if "recap" not in st.session_state:
        st.session_state.recap = None
    if "markdown_text" not in st.session_state:
        st.session_state.markdown_text = None
    col1, col2, col3 = st.columns([1, 1, 2])
    with col1:
        generate_btn = st.button("Generate Recap")
    with col2:
        append_btn = st.button("Append to Google Doc", disabled=(st.session_state.recap is None))
    if generate_btn:
        if not notes.strip():
            st.error("Please paste some notes.")
            st.stop()
        try:
            recap = generate_recap(
                model_name=model_name,
                notes=notes,
                title=title,
                date_str=str(date_str),
                attendees_csv=attendees_csv,
            )
            st.session_state.recap = recap
            st.session_state.markdown_text = recap_to_markdown(recap)
            st.rerun()
        except Exception as e:
            st.exception(e)
            st.stop()
    if append_btn and st.session_state.recap is not None:
        try:
            use_secrets = (cred_mode == "Streamlit secrets")
            service = get_google_docs_service(
                credentials_path=credentials_path if cred_mode == "credentials.json file" else None,
                use_secrets=use_secrets
            )
            final_text = f"\n\n===== {st.session_state.recap.title} — {st.session_state.recap.date} =====\n\n" + st.session_state.markdown_text
            append_plaintext_to_doc(service, document_id, final_text)
            st.success("Recap appended to the Google Doc")
        except Exception as e:
            st.exception(e)

    if st.session_state.recap is not None:
        st.markdown("---")
        st.markdown(st.session_state.markdown_text)
if __name__ == "__main__":
    main()
De Streamlit-app koppelt een enkele actie “Generate Recap” aan het model en stelt die bloot aan een lokale web-UI, door gebruik te maken van:
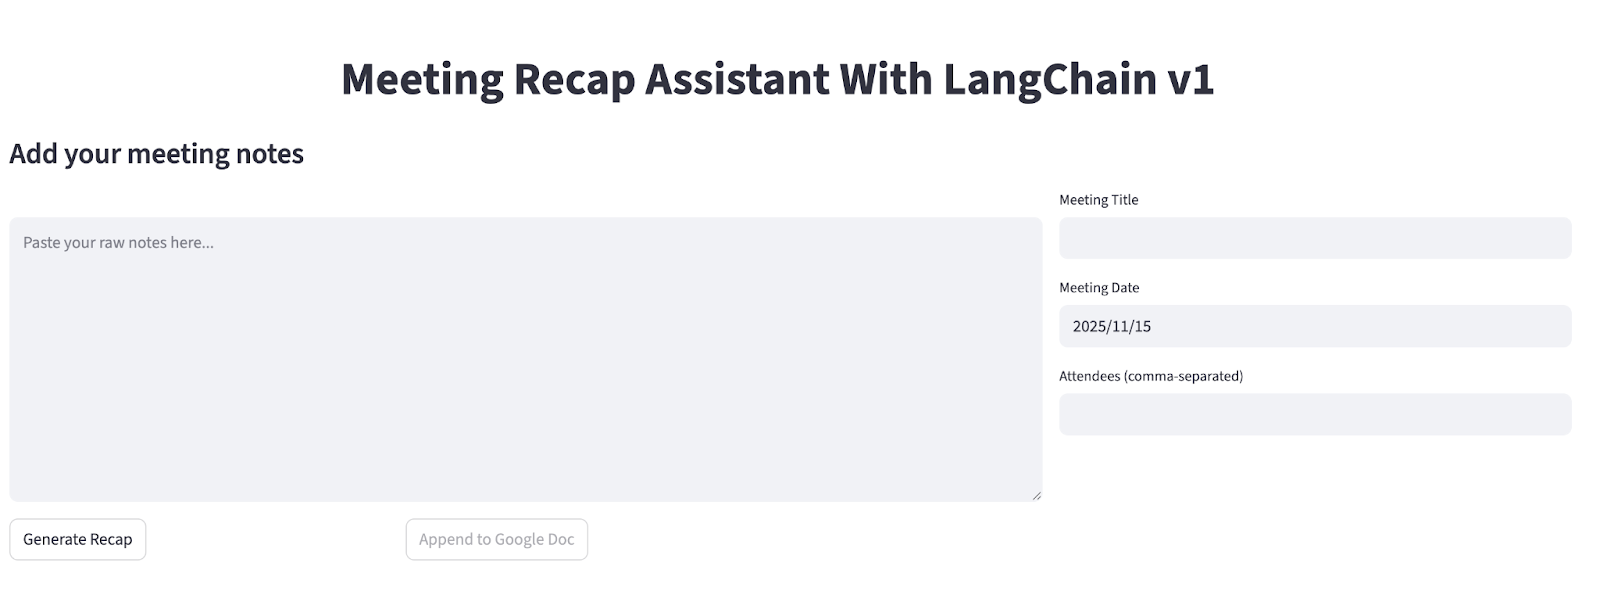
Inputs (linker/rechter kolommen): In het linkerdeel een grote st.text_area voor ruwe notities. Het rechterdeel vangt titel, datum en deelnemers.
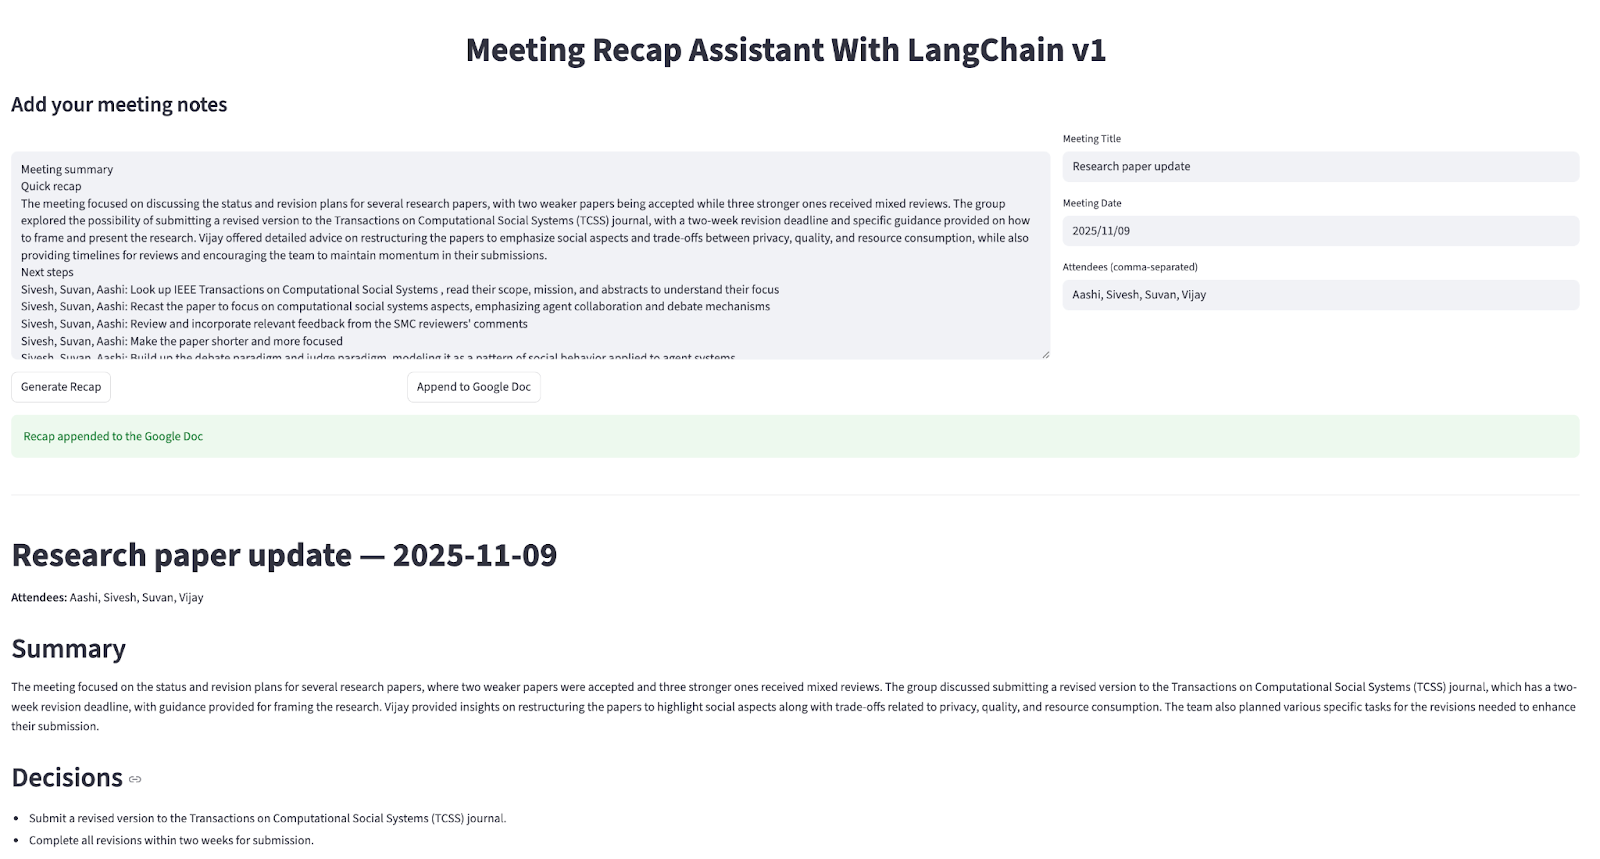
Outputs (voorbeeldweergave): Wanneer er een verslag is, toont de app een scheidingslijn en een Markdown-preview van het gestructureerde verslag voor snelle controle.
Interfacekoppeling (acties): Deze acties vormen de kern van onze app. Ze omvatten:
Generate recap: Valideert notities, roept de functie generate_recap() aan, zet om naar Markdown en gebruikt st.rerun() om te verversen.
Append to Google Doc: Daarna maken we een geauthenticeerde client met get_google_docs_service() die een gedateerde kop toevoegt en aan het doeldocument toevoegt.
State: Met st.session_state slaan we de laatste RecapDoc en markdown_text op zodat de UI stabiel blijft over herstarts.
App-instellingen: Tot slot leest load_dotenv() omgevingsvariabelen, st.set_page_config() zet de layout en paden naar credentials komen uit de omgeving of defaults.
Sla op als app.py en draai het volgende commando in de terminal.
streamlit run app.pyJe hebt nu een end-to-end tool voor vergaderrapporten die er zo uitziet:
LangChain v1 stroomlijnt het bouwen van agents met eenvoudigere imports en betrouwbaardere resultaten dankzij gestructureerde output en standaard content blocks. Kom je van v0, behandel de upgrade dan als elke productiechange met versiepins, geherstructureerde imports en nieuwe primitieven.
Een paar zaken om in gedachten te houden:
LangChain v1 gebruikt create_agent in plaats van de oude voorgebouwde agents, die vertrouwen op standaard content blocks en gestructureerde output; let erop dat sommige oudere onderdelen zijn verplaatst naar langchain-classic.
Pin bij het upgraden langchain>=1.0 en gebruik Python 3.10+. Geef de voorkeur aan Pydantic-modellen voor outputs, voeg middleware alleen toe waar het helpt (goedkeuringen, PII-redactie, samenvattingen) en behoud langchain-classic als je nog legacy-retrievers nodig hebt.
Stuur tot slot eerst een kleine invoer en bekijk traces en fouten terwijl je de afhankelijkheden gepind houdt.
LangChain v1 geeft je schonere bouwstenen voor echte apps, gestructureerde output die je kunt vertrouwen, standaard content blocks over providers heen en een uniforme manier om agents te bouwen. Hieronder staan praktische toepassingen, plus enkele hobbels die je tijdens adoptie kunt verwachten.
Enkele use-cases met grote impact in deze versie zijn:
Bij use-cases met grote impact horen enkele uitdagingen:
Vooruitkijkend kunnen we blijvende persistentie, time-travel en observability (via LangGraph en LangSmith) verwachten, samen met bredere providerondersteuning voor standaard content blocks en duidelijkere controles voor productieteams.
LangChain v1 is een solide basis voor het bouwen van betrouwbare en onderhoudbare agents. Deze Auto Meeting Recap Assistant laat zien hoe create_agent, standaard content blocks en gestructureerde output samenkomen om een echte workflow af te handelen met menselijke goedkeuring in de lus en een naadloze overdracht naar Google Docs. Gebruik de officiële migratiegidsen om legacy-code te moderniseren en begin klein met een tutorialapp zoals deze om vertrouwen op te bouwen.
Wil je graag meer hands-on aan de slag met het maken van AI-gedreven applicaties, dan raad ik onze cursus Developing Applications with LangChain aan.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

