जानें कि LangChain v1 के साथ ऐसा ऑटो मीटिंग रिकैप असिस्टेंट कैसे बनाएं जो मीटिंग्स को समरीज़ करे, एक्शन आइटम्स निकाले, और create_agent व कंटेंट ब्लॉक्स जैसी नवीनतम सुविधाओं का उपयोग करके अनुमोदित रिकैप्स को Google Doc में भेज दे।
LangChain एक ओपन-सोर्स फ्रेमवर्क है जो LLMs को टूल्स के साथ मिलाकर एजेंटिक AI एप्लिकेशन बनाने में मदद करता है। संस्करण 1.0 एक प्रोडक्शन-ग्रेड कोर की ओर बदलाव को चिह्नित करता है, जिसमें एक सरल API, स्पष्ट सीमाएँ, और प्रदाताओं के बीच मानकीकृत संदेश हैंडलिंग शामिल है।
इस ट्युटोरियल में, हम एक Streamlit ऑटो मीटिंग रिकैप असिस्टेंट बनाएंगे जो कच्चे नोट्स लेता है, एक संक्षिप्त रिकैप और एक्शन आइटम्स तैयार करता है, और मानवीय अनुमोदन के बाद, उस रिकैप को Google Doc में जोड़ देता है। इस दौरान, आप नए create_agent फ्लो, मानक कंटेंट ब्लॉक्स, और हल्के v1 नेमस्पेस को क्रियान्वयन में देखेंगे।
LangChain v1 क्या है?
LangChain v1 एजेंट बनाने के लिए एक छोटा, स्थिर सरफेस देने पर केंद्रित एक पुनर्गठित, प्रोडक्शन-उन्मुख रिलीज़ है। यह पेश करता है:
create_agent को एजेंट शुरू करने का मानक तरीका (लेगेसी प्रीबिल्ट एजेंट्स से ज्यादा साफ-सुथरा)।
content_blocks के जरिए मानकीकृत कंटेंट ताकि संदेश प्रदाताओं के बीच सुसंगत रहें।
टाइप किए हुए उत्तरों और सुरक्षित, मानवीय-अनुमोदित कार्रवाइयों के लिए स्ट्रक्चर्ड आउटपुट और मिडलवेयर।
langchain पैकेज एजेंट बिल्डिंग ब्लॉक्स पर केंद्रित है ताकि लेगेसी मॉड्यूल्स langchain-classic में चले जाएँ, जिससे डिस्कवरबिलिटी और अपग्रेड आसान हों।
v0.x की तुलना में, v1 संदेश कंटेंट और एजेंट ऑर्केस्ट्रेशन का मानकीकरण करके कॉग्निटिव लोड और प्रदाता-विशेष विचित्रताओं को कम करता है। आप OpenAI, Anthropic या अन्य किसी भी प्रदाता पर हों—मानसिक मॉडल वही रहता है।
LangChain v1 में प्रमुख तकनीकी उन्नयन
मूल LangChain v0.x संस्करण ने एजेंट बनाने के कई पैटर्न दिए थे, जबकि v1 उन्हें एक स्पष्ट मार्ग में समेकित करता है—create_agent ब्लॉक—ताकि आपके एजेंट्स को समझना, परीक्षण करना और शिप करना आसान हो। इसके साथ टूलिंग और भी साफ है, मानकीकृत कंटेंट और अनुमानित एजेंट लूप के जरिए डिबगिंग सरल हो जाती है।
इस नवीनतम रिलीज़ के कुछ प्रमुख तकनीकी उन्नयन यहाँ हैं:
create_agent वर्कफ़्लो: यह प्रोडक्शन-रेडी एजेंट लूप मॉडल को यह तय करने देता है कि कब टूल कॉल करने हैं और कब समाप्त करना है। अब हमें कई पैटर्न नहीं संभालने पड़ते—कस्टमाइजेशन आसान हो जाता है।
स्टैंडर्ड कंटेंट ब्लॉक्स: प्रदाता-निरपेक्ष तरीके से संदेश पढ़ना—रीजनिंग ट्रेसेस, टूल कॉल्स, सिटेशंस, यहाँ तक कि मल्टीमोडल अंश—सब एकीकृत content_blocks API के जरिए। टूलिंग और लॉग्स सभी प्रदाताओं में एक जैसे दिखते हैं।
स्ट्रक्चर्ड आउटपुट: नवीनतम रिलीज़ टाइप्ड स्कीमाज़ के लिए प्रथम-श्रेणी सपोर्ट देता है ताकि आप बिना कड़े regex के पूर्वानुमेय JSON पर निर्भर कर सकें। इससे पार्सिंग त्रुटियाँ और अतिरिक्त कॉल्स घटते हैं।
मिडलवेयर: ये एजेंट लूप में हुक होते हैं—जोखिमभरी कार्रवाइयों को अप्रूव करना, इतिहास लंबा होने पर उसे समरी करना, और कॉल्स से पहले PII को रीडैक्ट करना।
सरल नेमस्पेस: langchain पैकेज अब आवश्यक एजेंट बिल्डिंग ब्लॉक्स पर केंद्रित है, जबकि अंदरूनी तौर पर LangGraph परसिस्टेंस और टाइम-ट्रैवल जैसी विश्वसनीयता सुविधाएँ देता है।
डेमो: LangChain v1 के साथ ऑटो मीटिंग रिकैप असिस्टेंट बनाना
इस भाग में, हम एक Streamlit एप्लिकेशन लागू करेंगे जो एंड-टू-एंड मीटिंग रिकैप्स को ऑटोमेट करता है। ऐप कच्चे मीटिंग नोट्स और वैकल्पिक मेटाडेटा (शीर्षक, तिथि, और प्रतिभागी) स्वीकार करता है। फिर यह एक टाइप्ड RecapDoc जनरेट करता है—शीर्षक, सारांश, निर्णय, और एक्शन आइटम्स सहित—स्ट्रक्चर्ड आउटपुट में। एक क्लिक में, अनुमोदित रिकैप (मीटिंग तिथि के प्रीफ़िक्स के साथ) निर्दिष्ट Google Doc में जोड़ दिया जाता है।
चरण 1: पूर्वापेक्षाएँ
ऑटो मीटिंग रिकैप असिस्टेंट बनाने से पहले, हमें UI, LLM, टाइप्ड वेलिडेशन, और Google Docs एक्सेस के लिए न्यूनतम टूलकिट चाहिए। नीचे दिए गए कमांड सब कुछ इंस्टॉल करते हैं और मॉडल की-सेट करते हैं ताकि आपका ऐप प्रदाता से बात कर सके।
प्रत्येक पूर्वापेक्षा क्या करती है, यहाँ बताया गया है:
Streamlit: यह एक सरल, Pythonic UI के साथ वेब ऐप को लोकली चलाता है।
langchainऔर langchain-openai: ये LangChain v1 का सरल सरफेस (init_chat_model, स्ट्रक्चर्ड आउटपुट) और OpenAI प्रदाता ब्रिज उपलब्ध कराते हैं।
pydantic: यह लाइब्रेरी सख्त RecapDoc स्कीमा परिभाषित करती है ताकि मॉडल टाइप्ड फील्ड्स लौटाए।
Python-dotenv: यह विकास के दौरान .env फाइल से एनवायरनमेंट वेरिएबल्स लोड करता है।
google-auth: यह OAuth और Google Docs API को संभालने के लिए उपयोग होता है ताकि हम रिकैप को डॉक्युमेंट में जोड़ सकें।
OPENAI_API_KEY: OpenAI API Key हमारी LLM कॉल्स को प्रमाणित करता है—इसे एनवायरनमेंट वेरिएबल के रूप में सेट करें (या सीक्रेट्स मैनेजर का उपयोग करें)।
ध्यान दें: यदि आप किसी अन्य प्रदाता (Anthropic, Google, या लोकल मॉडल) का उपयोग कर रहे हैं, तो मिलते-जुलते langchain-* इंटीग्रेशन को इंस्टॉल करें और उस प्रदाता की API key सेट करें।
इन निर्भरताओं के इंस्टॉल होने और OPENAI_API_KEY सेट होने के साथ, वातावरण तैयार है। अगले चरणों में, हम Google Cloud के जरिए Google Docs API सेट करेंगे।
चरण 2: Google Docs API सक्षम करें
हर मीटिंग रिकैप को एक लाइव दस्तावेज़ में सहेजने के लिए, ऐप को Google Docs में लिखने की अनुमति चाहिए। यह चरण एंड-टू-एंड उस एक्सेस को सेट करता है। पहले, हम:
Google Cloud से OAuth क्लाइंट फाइल (credentials.json) प्राप्त करते हैं
फिर, उस Google Doc ID की पहचान करते हैं जिसमें आपको जोड़ना है
अंत में, पहली रन पर ब्राउज़र में एक्सेस स्वीकृति के बाद, ऐप एक पुन: उपयोग योग्य token.json बनाता है।
इन तीनों चीज़ों के तैयार होते ही, ऐप एक क्लिक में आपके चुने हुए Google Doc में रिकैप जोड़ सकता है। आप कभी भी token.json हटाकर और ऐप फिर चलाकर एक्सेस रद्द या रिन्यू कर सकते हैं।
चरण 2.1: Google Cloud से credentials.json प्राप्त करें
credentials.json फाइल आपके ऐप की Google Docs API तक कुंजी है। आप इसे Google Cloud Console में Desktop App OAuth क्लाइंट के रूप में एक बार जनरेट करते हैं। शुरू करने के लिए:
अपनी आवश्यकता अनुसार नाम दें, फिर Create पर क्लिक करें।
Google Docs API सक्षम करें
अब हमारा प्रोजेक्ट बन गया है। चलिए Google Docs में लिखने के लिए आवश्यक API सक्षम करते हैं।
APIs & Services पर जाएँ और Library देखें। आप सर्च भी कर सकते हैं।
Google Docs API खोजें और Enable पर क्लिक करें। ध्यान दें कि अनावश्यक शुल्क से बचने के लिए उपयोग के बाद आपको API को डिसएबल भी करना पड़ सकता है।
OAuth consent स्क्रीन कॉन्फ़िगर करें
API सक्षम होने के बाद, अगला कदम हमारी पसंदीदा ईमेल के लिए ऑथेंटिकेशन सेट करना है।
APIs & Services पर जाएँ और OAuthconsentscreen पर क्लिक करें।
External चुनें और बेसिक ऐप जानकारी भरें।
Audience / Test users खंड के तहत, Addusers पर क्लिक करें और वह Gmail खाता/खाते जोड़ें जिनका आप उपयोग करेंगे, फिर सेव करें।
विकास के लिए ऐप को Testing मोड में छोड़ना ठीक है।
OAuth क्लाइंट क्रेडेंशियल्स बनाएं
अंतिम चरण credentials.json फाइल बनाना और डाउनलोड करना है। इसके लिए:
APIs & Services पर जाएँ और Credentials पर क्लिक करें।
+ CREATE CREDENTIALS पर क्लिक करें, जो आपको OAuth client ID तक ले जाएगा।
Applicationtype के तहत Desktopapp चुनें और Create पर क्लिक करें।
क्लाइंट ID और सीक्रेट तैयार होने में, तथा डाउनलोड योग्य JSON फाइल बनने में, 5 मिनट तक लग सकते हैं।
JSON फाइल को credentials.json नाम से अपने app.py के उसी फ़ोल्डर में सहेजें (या ऐप सेटिंग्स में इसका पाथ दें)।
अब आपके पास एक Desktop OAuth क्लाइंट है जिसका उपयोग ऐप ब्राउज़र-आधारित साइन-इन शुरू करने और आपकी ओर से Google Docs एक्सेस का अनुरोध करने के लिए कर सकता है।
चरण 2.2: Google Doc ID
ऐप को यह पता होना चाहिए कि किस दस्तावेज़ में जोड़ना है। उस दस्तावेज़ की पहचान URL में एम्बेडेड एक यूनिक ID से होती है। इस चरण के लिए,
अपने लक्षित Google Doc को ब्राउज़र में खोलें।
URL में /d/ और /edit के बीच की स्ट्रिंग कॉपी करें, उदाहरण: https://docs.google.com/document/d/<THIS_IS_THE_ID>/edit
इस Doc ID को ऐप के “Google Doc ID” फ़ील्ड (या उपयुक्त कॉन्फ़िग वेरिएबल) में चिपकाएँ।
सही Doc ID के साथ, ऐप ठीक उसी दस्तावेज़ में रिकैप लिखेगा जिसे आपने चुना है।
चरण 2.3: Token.json
पहली बार जोड़ते समय, ऐप को दस्तावेज़ तक पहुँच के लिए आपकी स्पष्ट स्वीकृति चाहिए। अनुमोदन के बाद, Google एक टोकन लौटाता है जिसे ऐप लोकली token.json के रूप में सहेजता है। यह फाइल ऐसे जनरेट होती है:
ऐप चलाएँ और Append to Google Doc पर क्लिक करें।
एक ब्राउज़र विंडो खुलेगी जो आपसे पिछले चरण में जोड़े गए किसी टेस्ट यूज़र से साइन-इन करने और स्कोप अप्रूव करने को कहेगी।
पुष्टि करने के बाद, ऐप आपके कोड के पास token.json लिख देता है। इस फाइल में आपके पुन: उपयोग योग्य एक्सेस/रिफ्रेश टोकन होते हैं।
ध्यान दें: यदि आपको कभी अकाउंट बदलना हो या कन्सेंट फिर से चलाना हो, तो बस token.json हटाएँ और फिर से Appendto GoogleDoc पर क्लिक करें।
चरण 3: इम्पोर्ट्स
कोई भी लॉजिक लिखने से पहले, हम वे मॉड्यूल इम्पोर्ट करते हैं जो UI, टाइप्ड डेटा कॉन्ट्रैक्ट्स, मॉडल कॉल्स, और Google Docs इंटीग्रेशन को शक्ति देते हैं। उद्देश्य के अनुसार इम्पोर्ट्स को ग्रुप करना कोडबेस को पढ़ने योग्य रखता है और यह स्पष्ट करता है कि कुछ टूटने पर किस लेयर को ट्रबलशूट करना है।
import os
import io
import json
from datetime import date
from typing import List, Optional
import streamlit as st
from pydantic import BaseModel, Field
from dotenv import load_dotenv
# ---- LangChain v1 surface ----from langchain.agents import create_agent
from langchain.messages import SystemMessage, HumanMessage
from langchain.chat_models import init_chat_model
# ---- Google Docs API ----from google.oauth2.credentials import Credentials
from google_auth_oauthlib.flow import InstalledAppFlow
from googleapiclient.discovery import buildसंचालित द्वारा
इस चरण में, हम वही इम्पोर्ट करते हैं जो ऐप को चाहिए, जैसे os, io, json, date जैसे मानक यूटिलिटीज़ और पाथ्स, बफर्स, तथा हल्की-फुल्की सीरियलाइज़ेशन के लिए टाइपिंग हिंट्स। फिर UI के लिए Streamlit, टाइप्ड RecapDoc स्कीमा के लिए Pydantic, और एनवायरनमेंट वेरिएबल्स लोड करने के लिए dotenv। LangChain v1 सरफेस init_chat_model और create_agent प्रदाता-निरपेक्ष चैट मॉडल इनिशियलाइज़ और प्रॉम्प्ट्स स्ट्रक्चर करने के लिए, और अंत में Google Docs API के हिस्से जो OAuth संभालते हैं और हमें लक्ष्य दस्तावेज़ में रिकैप जोड़ने के लिए प्रमाणित क्लाइंट देते हैं।
चरण 4: स्ट्रक्चर्ड आउटपुट परिभाषित करें
मॉडल की प्रतिक्रिया को विश्वसनीय और उपयोग में आसान बनाने के लिए, हम रिकैप के लिए एक टाइप्ड कॉन्ट्रैक्ट परिभाषित करते हैं। Pydantic मॉडल्स का उपयोग सुनिश्चित करता है कि LLM ऐसे पूर्वानुमेय फील्ड्स लौटाए जिन्हें हमारा UI रेंडर कर सके, API स्टोर कर सके, और ऑटोमेशन वेलिडेट कर सकें।
classActionItem(BaseModel):
owner:str= Field(..., description="Person responsible")
task:str= Field(..., description="Short, specific task")
due_date:str= Field(..., description="ISO date (YYYY-MM-DD) or natural language like 'next Friday'")classRecapDoc(BaseModel):
title:str
date:str
attendees: List[str]
summary:str
decisions: List[str]
action_items: List[ActionItem]संचालित द्वारा
ऊपर दिए गए कोड ब्लॉक के प्रमुख घटक ये हैं:
ActionItem क्लास: यह फॉलो-अप टास्क की आवश्यक बातें कैप्चर करता है जैसे owner, task, और due_dateछोटी, स्पष्ट विवरणों के साथ ताकि मॉडल इन्हें साफ़-सुथरे ढंग से भरे। ISO तिथियाँ या प्राकृतिक वाक्यांशों की अनुमति देने से इनपुट लचीला रहता है जबकि डाउनस्ट्रीम पार्सिंग संभव रहती है।
RecapDocक्लास: यह क्लास पूरे रिकैप को एक ऑब्जेक्ट के रूप में दर्शाती है, जिसमें title, date, attendees, संक्षिप्त summary, स्पष्ट decisions, और action_items की सूची शामिल है।
LangChain v1 के साथ, आप सीधे with_structured_output(RecapDoc) के जरिए यही स्कीमा अनुरोध कर सकते हैं, जो नाजुक स्ट्रिंग पार्सिंग को घटाता है, वेलिडेशन सुधारता है, और फील्ड्स गायब होने पर जल्दी असफल होने देता है।
चरण 5: सिस्टम प्रॉम्प्ट
सिस्टम प्रॉम्प्ट आपके असिस्टेंट के लिए आधार नियम तय करता है। यह मॉडल को सटीक बताता है कि क्या बनाना है, क्या नहीं करना है, और आउटपुट कैसे स्ट्रक्चर करना है ताकि अगले चरण हर बार विश्वसनीय रूप से काम करें।
SYSTEM_PROMPT ="""You are a precise assistant that produces concise, high-signal meeting recaps.
Return a structured RecapDoc with:
- title, date, attendees
- a brief summary (3–6 sentences)
- explicit decisions (bullet-style)
- action_items (each has owner, task, due_date)
Rules:
- Only include info supported by the notes or explicit user inputs.
- Keep action items specific with clear owners and due dates.
- If something is unknown, say "Unknown" rather than inventing details.
"""संचालित द्वारा
सिस्टम प्रॉम्प्ट असिस्टेंट को सटीक और संक्षिप्त बनाता है, ताकि वह ट्रांसक्रिप्ट्स की बजाय उच्च-सिग्नल रिकैप दे। यह स्पष्ट स्कीमा देता है जिसमें शीर्षक, तिथि, प्रतिभागी, सारांश, निर्णय, और action_items शामिल हैं—नियमों के साथ जैसे 3–6 वाक्यों का सारांश, बुलेट निर्णय, और एक्शन आइटम्स में ओनर, टास्क, और देय तिथि।
एक स्पष्ट सिस्टम प्रॉम्प्ट के साथ, मॉडल पहली बार में ही उपयोगी, स्ट्रक्चर्ड रिकैप लगातार तैयार करता है।
चरण 6: Google OAuth हेल्पर
इस चरण में, हम एक हेल्पर फ़ंक्शन परिभाषित करते हैं जो Google Docs के लिए एक विश्वसनीय, पुन: उपयोग योग्य कनेक्शन स्थापित करता है ताकि ऐप आपके चुने हुए दस्तावेज़ में रिकैप जोड़ सके। यह केवल Docs स्कोप का अनुरोध करता है और पहली बार की कन्सेंट, टोकन रिफ्रेश, और सर्विस कंस्ट्रक्शन को संभालता है।
SCOPES =["https://www.googleapis.com/auth/documents"]defget_google_docs_service(
credentials_path: Optional[str],
token_path:str="token.json",
use_secrets:bool=False):
creds =Noneif use_secrets:try:if"google_credentials_json"in st.secrets:withopen("credentials_temp.json","w")as f:
f.write(st.secrets["google_credentials_json"])
credentials_path ="credentials_temp.json"except Exception:passif os.path.exists(token_path):
creds = Credentials.from_authorized_user_file(token_path, SCOPES)ifnot creds ornot creds.valid:if creds and creds.expired and creds.refresh_token:try:
creds.refresh(Request())except Exception:passifnot creds ornot creds.valid:ifnot credentials_path ornot os.path.exists(credentials_path):raise RuntimeError("Missing Google OAuth credentials. Provide 'credentials.json' ""or set st.secrets['google_credentials_json'].")
flow = InstalledAppFlow.from_client_secrets_file(credentials_path, SCOPES)
creds = flow.run_local_server(port=0)withopen(token_path,"w")as token:
token.write(creds.to_json())return build("docs","v1", credentials=creds)संचालित द्वारा
get_google_docs_service() फ़ंक्शन OAuth और सर्विस क्रिएशन को इस तरह संभालता है:
एक्सेस स्कोपिंग: यह फ़ंक्शन पूर्व-परिभाषित SCOPES का उपयोग करके अनुमतियों को Google Docs तक सीमित करता है।
क्रेडेंशियल्स लोड करना: यह लोकल credentials.json या st.secrets["google_credentials_json"]से पढ़ता है जब use_secrets=True हो—यह Streamlit का सीक्रेट होल्डर है।
टोकन का पुन: उपयोग: यदि token.json मौजूद है, तो कोड उसे लोड करता है और टोकन एक्सपायर होने पर उसे चुपचाप रिफ्रेश कर देता है।
पहली बार कन्सेंट: यदि कोई मान्य टोकन नहीं मिलता, तो हम Desktop InstalledAppFlow लॉन्च करते हैं, जो ब्राउज़र में यूज़र को ऑथेंटिकेट करने के लिए प्रॉम्प्ट करता है, फिर भविष्य के लिए token.json सेव कर देता है।
क्लाइंट लौटाना: अंत में, हम build() फ़ंक्शन के जरिए एक ऑथेंटिकेटेड Docs क्लाइंट बनाकर लौटाते हैं।
कन्फ़िगर होने के बाद, आप प्रमाणीकरण के लिए वही token.json पुन: उपयोग कर सकते हैं या टोकन को स्वतः रिफ्रेश कर सकते हैं। एक्सेस रीसेट करने के लिए, बस token.json हटाएँ और ऐप फिर चलाएँ।
चरण 7: अपेंड यूटिलिटी और Markdown रेंडरर
अब, हम एक टाइप्ड RecapDoc को साफ-सुथरे Markdown में बदलते हैं, जो लक्ष्य Google Doc में जोड़ दिया जाता है। एक फ़ंक्शन रिकैप को रेंडर करता है जबकि दूसरा दस्तावेज़ के अंत में ऑथेंटिकेटेड राइट करता है।
defappend_plaintext_to_doc(docs_service, document_id:str, text:str):
doc = docs_service.documents().get(documentId=document_id).execute()
end_index = doc.get("body",{}).get("content",[])[-1]["endIndex"]
requests =[{"insertText":{"location":{"index": end_index -1},"text": text +"\n"}}]return docs_service.documents().batchUpdate(
documentId=document_id,
body={"requests": requests}).execute()defrecap_to_markdown(recap: RecapDoc)->str:
lines =[f"# {recap.title} — {recap.date}","",f"**Attendees:** {', '.join(recap.attendees)if recap.attendees else'Unknown'}","","## Summary",
recap.summary.strip(),"","## Decisions",]if recap.decisions:for d in recap.decisions:
lines.append(f"- {d}")else:
lines.append("- None recorded")
lines.append("")
lines.append("## Action Items")if recap.action_items:for ai in recap.action_items:
lines.append(f"- **{ai.owner}** — {ai.task} _(Due: {ai.due_date})_")else:
lines.append("- None recorded")return"\n".join(lines)संचालित द्वारा
ऊपर के दोनों हेल्पर्स इस तरह साथ काम करते हैं:
recap_to_markdown() फ़ंक्शन एक पढ़ने योग्य सारांश बनाता है। इसमें तिथि सहित शीर्षक, प्रतिभागी, संक्षिप्त सारांश, और ओनर, टास्क, देय तिथि वाले एक्शन आइटम्स शामिल होते हैं। फील्ड्स गायब होने पर यह “Unknown” या “None recorded” पर फॉलबैक करता है।
वहीं append_plaintext_to_doc() फ़ंक्शन दस्तावेज़ लाता है, वर्तमान एंड इंडेक्स ढूंढता है, और documents() के जरिए एकल insertText रिक्वेस्ट जारी करता है। टेक्स्ट के अंत में एक नई लाइन जोड़ दी जाती है ताकि अगली एंट्री नई लाइन से शुरू हो।
ध्यान दें: खाली दस्तावेज़ों के लिए, यदि endIndex उपलब्ध न हो, तो इंसर्शन इंडेक्स को 1 पर डिफॉल्ट करने पर विचार करें।
Markdown रेंडरिंग और अपेंड तैयार होने के साथ, अब हम अपना रिकैप जनरेटर सेटअप करते हैं।
चरण 8: रिकैप जनरेटर
यह फ़ंक्शन ऐप का हृदय है। यह कच्चे नोट्स और वैकल्पिक मेटाडेटा लेता है, एक चैट मॉडल को कॉल करता है, और एक टाइप्ड RecapDoc लौटाता है ताकि डाउनस्ट्रीम सब कुछ पूर्वानुमेय रहे।
defgenerate_recap(model_name:str, notes:str, title:str, date_str:str, attendees_csv:str)-> RecapDoc:
model = init_chat_model(model=model_name)
structured_llm = model.with_structured_output(RecapDoc)
attendees_hint =[a.strip()for a in attendees_csv.split(",")]if attendees_csv.strip()else[]
user_prompt =("You will receive meeting notes and metadata.\n\n"f"Title: {title or'Unknown'}\n"f"Date: {date_str or'Unknown'}\n"f"Attendees: {attendees_hint if attendees_hint else'Unknown'}\n\n""Notes:\n"f"{notes.strip()}\n")
messages =[
SystemMessage(content=SYSTEM_PROMPT),
HumanMessage(content=user_prompt)]try:
recap = structured_llm.invoke(messages)except Exception as e:
st.error(f"Error generating recap: {e}")
recap = RecapDoc(
title=title or"Unknown",
date=date_str or"Unknown",
attendees=attendees_hint or[],
summary=f"Error generating summary: {str(e)}",
decisions=[],
action_items=[])return recapसंचालित द्वारा
रिकैप जनरेटर में तीन प्रमुख घटक हैं:
मॉडल इनिशियलाइज़ेशन: init_chat_model() आपके चुने प्रदाता के लिए चैट मॉडल बनाता है। फिर हम with_structured_output() कॉल करके मॉडल को बताते हैं कि किस आकार का आउटपुट लौटाना है। यह RecapDoc फील्ड्स से मेल खाता एक Python ऑब्जेक्ट आउटपुट करता है।
प्रॉम्प्ट असेम्बली: हम इनपुट्स को नॉर्मलाइज़ करते हैं और दो संदेश भेजते हैं—कड़े नियमों वाला SystemMessage (सिस्टम प्रॉम्प्ट) और HumanMessage जिसमें शीर्षक, तिथि, प्रतिभागी और कच्चे नोट्स होते हैं।
स्ट्रक्चर्ड जेनरेशन: structured_llm.invoke() एक वेलिडेटेड RecapDoc लौटाता है, जिससे पार्सिंग से बचते हैं और भ्रम-जनन कम होता है।
अपने GPT मॉडल को LangChain के स्ट्रक्चर्ड-आउटपुट रैपर से गुजारने पर रिकैप चरण विश्वसनीय बन जाता है और बिना किसी डाउनस्ट्रीम लॉजिक बदले सीधे Markdown रेंडरिंग के लिए तैयार रहता है।
चरण 9: Streamlit UI
यह चरण पूरे डेमो को एक पेज के Streamlit ऐप में वायर करता है। उपयोगकर्ता नोट्स पेस्ट करता है, वैकल्पिक मेटाडेटा जोड़ता है, एक स्ट्रक्चर्ड रिकैप जनरेट करता है, उसे Markdown के रूप में प्रीव्यू करता है, और एक क्लिक में उसे Google Doc में जोड़ देता है।
defmain():
load_dotenv()
st.set_page_config(page_title="Meeting Recap Assistant (LangChain v1)", page_icon=" ", layout="wide")
st.markdown("<h1 style='text-align: center;'>Meeting Recap Assistant With LangChain v1</h1>", unsafe_allow_html=True)
model_name = os.getenv("LC_MODEL","gpt-4o-mini")
document_id ="10G1k8-2JG_phkpjWM3xZEy2wNg5trUO0SJ2WN7kR3po"
cred_mode ="credentials.json file"
credentials_path = os.getenv("GOOGLE_CREDENTIALS_JSON","credentials.json")
st.subheader(" Add your meeting notes")
colL, colR = st.columns([2,1])with colL:
notes = st.text_area(" ", height=300, placeholder="Paste your raw notes here...")with colR:
title = st.text_input("Meeting Title", value="")
date_str = st.date_input("Meeting Date", value=date.today())
attendees_csv = st.text_input("Attendees (comma-separated)", value="")if"recap"notin st.session_state:
st.session_state.recap =Noneif"markdown_text"notin st.session_state:
st.session_state.markdown_text =None
col1, col2, col3 = st.columns([1,1,2])with col1:
generate_btn = st.button("Generate Recap")with col2:
append_btn = st.button("Append to Google Doc", disabled=(st.session_state.recap isNone))if generate_btn:ifnot notes.strip():
st.error("Please paste some notes.")
st.stop()try:
recap = generate_recap(
model_name=model_name,
notes=notes,
title=title,
date_str=str(date_str),
attendees_csv=attendees_csv,)
st.session_state.recap = recap
st.session_state.markdown_text = recap_to_markdown(recap)
st.rerun()except Exception as e:
st.exception(e)
st.stop()if append_btn and st.session_state.recap isnotNone:try:
use_secrets =(cred_mode =="Streamlit secrets")
service = get_google_docs_service(
credentials_path=credentials_path if cred_mode =="credentials.json file"elseNone,
use_secrets=use_secrets
)
final_text =f"\n\n===== {st.session_state.recap.title} — {st.session_state.recap.date} =====\n\n"+ st.session_state.markdown_text
append_plaintext_to_doc(service, document_id, final_text)
st.success("Recap appended to the Google Doc")except Exception as e:
st.exception(e)if st.session_state.recap isnotNone:
st.markdown("---")
st.markdown(st.session_state.markdown_text)if __name__ =="__main__":
main()संचालित द्वारा
Streamlit ऐप एक “Generate Recap” एक्शन को मॉडल से जोड़ता है और उसे लोकल वेब UI पर एक्सपोज़ करता है, इस प्रकार:
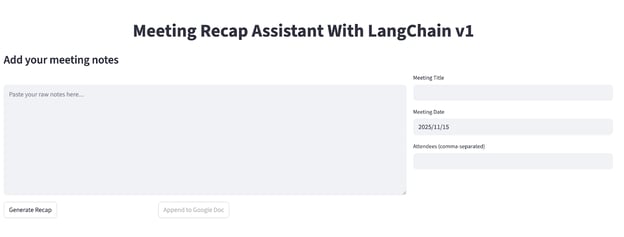
इनपुट्स (बाएँ/दाएँ कॉलम): बायाँ पैनल कच्चे नोट्स के लिए बड़ा st.text_area है। दायाँ पैनल शीर्षक, तिथि, और प्रतिभागी कैप्चर करता है।
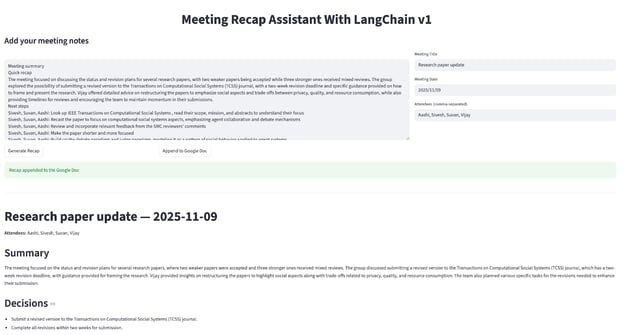
आउटपुट्स (प्रीव्यू एरिया): जब रिकैप मौजूद हो, तो ऐप एक डिवाइडर दिखाता है और त्वरित समीक्षा के लिए स्ट्रक्चर्ड रिकैप का Markdown प्रीव्यू देता है।
इंटरफेस वायरिंग (एक्शन): ये एक्शन हमारे ऐप के कोर हैं। इनमें शामिल हैं:
Generate recap: यह नोट्स वेलिडेट करता है, generate_recap() को कॉल करता है, Markdown में बदलता है, और st.rerun() से रीफ़्रेश करता है।
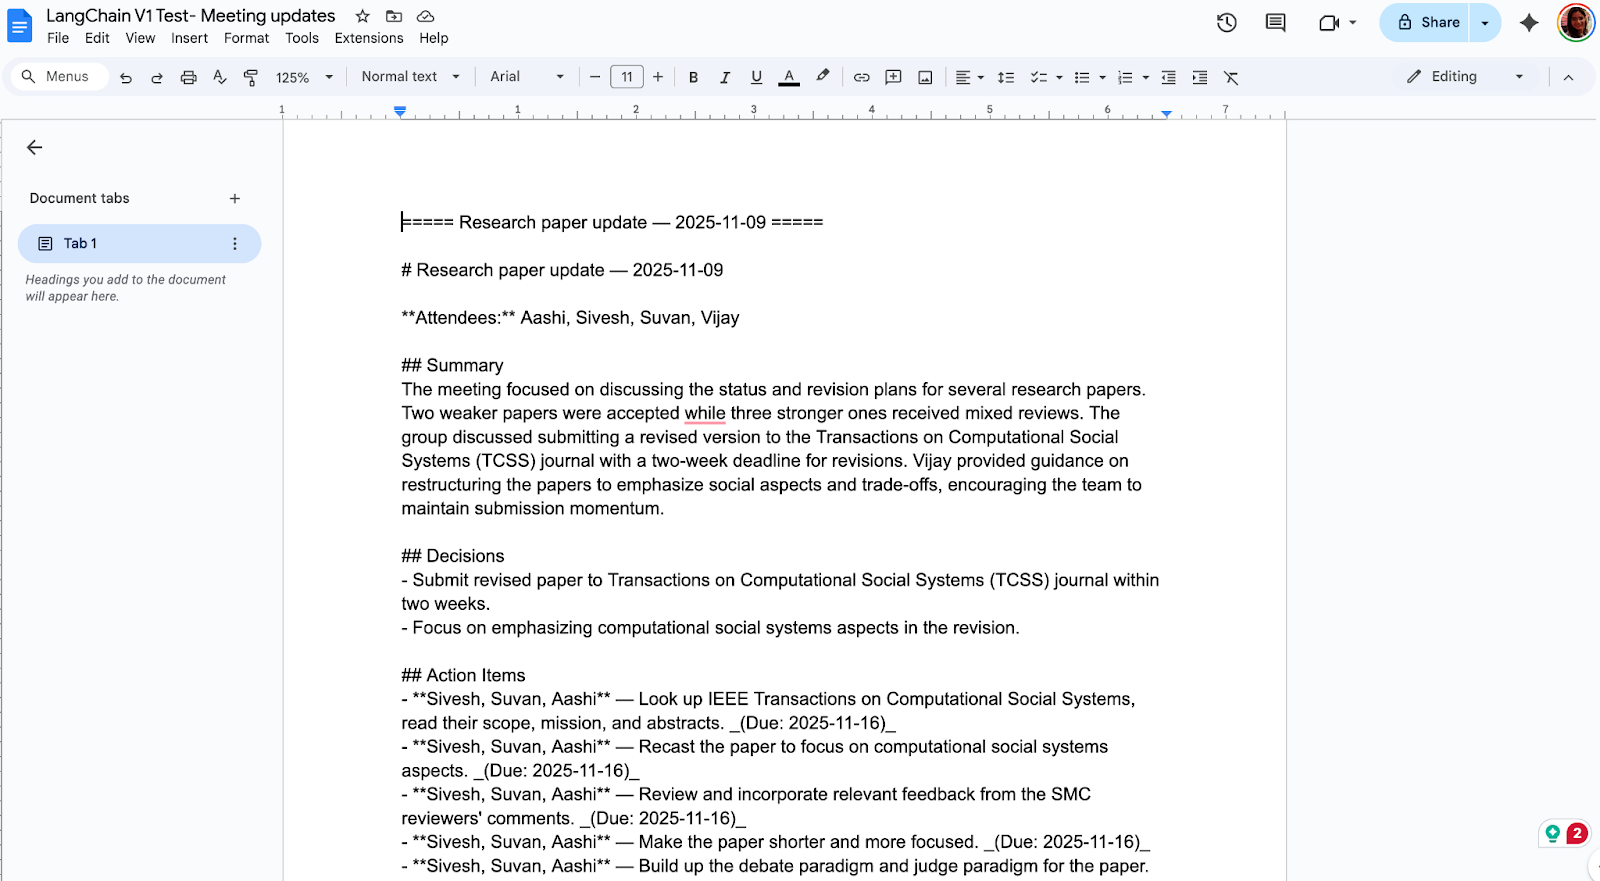
Append to Google Doc: इसके बाद, हम get_google_docs_service() से एक ऑथेंटिकेटेड क्लाइंट बनाते हैं, एक दिनांकित हेडर जोड़ते हैं, और डेस्टिनेशन डॉक में अपेंड करते हैं।
स्टेट: st.session_state नवीनतम RecapDoc और markdown_text स्टोर करता है ताकि UI रीरन्स के बीच स्थिर रहे।
ऐप सेटअप: अंततः, load_dotenv() एनव वेरिएबल्स पढ़ता है, st.set_page_config() लेआउट सेट करता है, और क्रेडेंशियल पाथ्स एनव या डिफॉल्ट्स से आते हैं।
इसे app.py के रूप में सेव करें और टर्मिनल में यह कमांड चलाएँ।
अब आपके पास एक एंड-टू-एंड मीटिंग रिकैप टूल है जो कुछ ऐसा दिखता है:
माइग्रेशन और अपनाने से जुड़ी बातों पर विचार
LangChain v1 सरल इम्पोर्ट्स और इसकी स्ट्रक्चर्ड आउटपुट तथा स्टैंडर्ड कंटेंट ब्लॉक्स के कारण अधिक विश्वसनीय परिणामों के साथ एजेंट बनाना सुगम बनाता है। यदि आप v0 से आ रहे हैं, तो किसी भी प्रोडक्शन बदलाव की तरह अपग्रेड को संभालें—वर्ज़न पिन करें, इम्पोर्ट्स रिफैक्टर करें, और नए प्रिमिटिव्स अपनाएँ।
ध्यान रखने योग्य कुछ बातें:
LangChain v1 पुराने प्रीबिल्ट एजेंट्स की जगह create_agent का उपयोग करता है, जो स्टैंडर्ड कंटेंट ब्लॉक्स और स्ट्रक्चर्ड आउटपुट पर निर्भर है; ध्यान दें कि कुछ पुराने हिस्से langchain-classic में चले गए हैं।
अपग्रेड करते समय, langchain>=1.0 पिन करें और Python 3.10+ का उपयोग करें। आउटपुट्स के लिए Pydantic मॉडल्स को प्राथमिकता दें, मिडलवेयर केवल वहीं जोड़ें जहाँ वह सहायक हो (अप्रूवल्स, PII रीडैक्शन, समरीज़), और यदि आपको अब भी लेगेसी रिट्रीवर्स चाहिए तो langchain-classic रखें।
अंततः, पहले छोटा इनपुट भेजें और ट्रेसेस व एरर्स देखें, निर्भरताएँ पिन रखते हुए।
LangChain v1 के अतिरिक्त उपयोग के मामले और चुनौतियाँ
LangChain v1 आपको वास्तविक ऐप्स के लिए साफ-सुथरे प्रिमिटिव्स, भरोसेमंद स्ट्रक्चर्ड आउटपुट, प्रदाताओं में स्टैंडर्ड कंटेंट ब्लॉक्स, और एजेंट बनाने का एकीकृत तरीका देता है। नीचे इसके व्यावहारिक उपयोग बताए गए हैं, साथ ही अपनाने के दौरान आने वाली कुछ दिक्कतें भी।
उच्च-प्रभाव वाले उपयोग के मामले
इस संस्करण के कुछ उच्च-प्रभाव वाले उपयोग मामलों में शामिल हैं:
स्वचालित रिपोर्ट्स: साप्ताहिक प्रोजेक्ट सारांशों को स्ट्रक्चर्ड सेक्शंस के रूप में जनरेट करें, उन्हें त्वरित मानवीय अप्रूवल से गुजारें, फिर Google Docs या Sheets में प्रकाशित करें।
कस्टमर सपोर्ट समरीज़: लंबे टिकट थ्रेड्स को अगले कदमों के साथ स्पष्ट ब्रीफ्स में संघनित करें, जबकि टूल कॉल्स को ऑडिटेबल तरीके से रिकॉर्ड करें।
रिसर्च असिस्टेंट्स: स्रोत जुटाएँ, सिटेशंस निकालें, और सुरक्षा के लिए मानवीय अप्रूवल स्टेप शामिल करके एक टाइप्ड लिटरेचर ग्रिड आउटपुट करें।
चुनौतियाँ
उच्च-प्रभाव वाले उपयोग मामलों के साथ कुछ चुनौतियाँ भी आती हैं:
माइग्रेशन में घर्षण: अपडेटेड इम्पोर्ट पाथ्स और एड-हॉक पैटर्न्स की रिटायरमेंट अक्सर कोड रिफैक्टर्स माँगती है, जिससे घर्षण होता है।
निर्भरताएँ संरेखित होनी चाहिए: हमें सुनिश्चित करना होता है कि प्रदाता SDKs v1 की अपेक्षाओं से मेल खाएँ ताकि रनटाइम मिसमैच न हों।
टूल सेफ़्टी: अंततः, स्वचालित कार्रवाइयों को टेस्ट्स, गार्डरेल्स, और ह्यूमन-इन-द-लूप चेकपॉइंट्स से कवर करना चाहिए।
आगे देखते हुए, हम (LangGraph और LangSmith के जरिए) परसिस्टेंस, टाइम-ट्रैवल, और ऑब्ज़र्वबिलिटी में निरंतरता की उम्मीद कर सकते हैं, साथ ही स्टैंडर्ड कंटेंट ब्लॉक्स के लिए व्यापक प्रदाता समर्थन और प्रोडक्शन टीमों के लिए स्पष्ट कंट्रोल्स।
निष्कर्ष
LangChain v1 विश्वसनीय और मेंटेन करने योग्य एजेंट बनाने की ठोस नींव है। यह ऑटो मीटिंग रिकैप असिस्टेंट दिखाता है कि कैसे create_agent, स्टैंडर्ड कंटेंट ब्लॉक्स, और स्ट्रक्चर्ड आउटपुट मानवीय अप्रूवल-इन-द-लूप के साथ एक वास्तविक वर्कफ्लो संभालते हैं और Google Docs को सहज हैंडऑफ देते हैं। आधिकारिक माइग्रेशन गाइड्स का उपयोग करके लेगेसी कोड को मॉडर्नाइज़ करें, और आत्मविश्वास बनाने के लिए ऐसे ट्युटोरियल ऐप से छोटा शुरू करें।
यदि आप AI-संचालित एप्लिकेशन बनाने में और अधिक हाथ-से-हाथ सीखना चाहते हैं, तो मैं हमारे Developing Applications with LangChain कोर्स की सिफारिश करता/करती हूँ।
मैं एमएल (Gen AI) में Google Developers Expert, Kaggle 3x Expert, और Women Techmakers एंबेसडर हूँ, तथा तकनीक क्षेत्र में 3+ वर्षों का अनुभव रखती हूँ। मैंने 2020 में एक हेल्थ-टेक स्टार्टअप की सह-स्थापना की और वर्तमान में Georgia Tech से कंप्यूटर विज्ञान में मास्टर कर रही हूँ, जिसमें मेरा विशेषज्ञता क्षेत्र मशीन लर्निंग है।



LangChain एक ओपन-सोर्स फ्रेमवर्क है जो LLMs को टूल्स के साथ मिलाकर एजेंटिक AI एप्लिकेशन बनाने में मदद करता है। संस्करण 1.0 एक प्रोडक्शन-ग्रेड कोर की ओर बदलाव को चिह्नित करता है, जिसमें एक सरल API, स्पष्ट सीमाएँ, और प्रदाताओं के बीच मानकीकृत संदेश हैंडलिंग शामिल है।
इस ट्युटोरियल में, हम एक Streamlit ऑटो मीटिंग रिकैप असिस्टेंट बनाएंगे जो कच्चे नोट्स लेता है, एक संक्षिप्त रिकैप और एक्शन आइटम्स तैयार करता है, और मानवीय अनुमोदन के बाद, उस रिकैप को Google Doc में जोड़ देता है। इस दौरान, आप नए
create_agentफ्लो, मानक कंटेंट ब्लॉक्स, और हल्के v1 नेमस्पेस को क्रियान्वयन में देखेंगे।LangChain v1 क्या है?
LangChain v1 एजेंट बनाने के लिए एक छोटा, स्थिर सरफेस देने पर केंद्रित एक पुनर्गठित, प्रोडक्शन-उन्मुख रिलीज़ है। यह पेश करता है:
create_agentको एजेंट शुरू करने का मानक तरीका (लेगेसी प्रीबिल्ट एजेंट्स से ज्यादा साफ-सुथरा)।content_blocksके जरिए मानकीकृत कंटेंट ताकि संदेश प्रदाताओं के बीच सुसंगत रहें।टाइप किए हुए उत्तरों और सुरक्षित, मानवीय-अनुमोदित कार्रवाइयों के लिए स्ट्रक्चर्ड आउटपुट और मिडलवेयर।
langchain पैकेज एजेंट बिल्डिंग ब्लॉक्स पर केंद्रित है ताकि लेगेसी मॉड्यूल्स langchain-classic में चले जाएँ, जिससे डिस्कवरबिलिटी और अपग्रेड आसान हों।
v0.x की तुलना में, v1 संदेश कंटेंट और एजेंट ऑर्केस्ट्रेशन का मानकीकरण करके कॉग्निटिव लोड और प्रदाता-विशेष विचित्रताओं को कम करता है। आप OpenAI, Anthropic या अन्य किसी भी प्रदाता पर हों—मानसिक मॉडल वही रहता है।
LangChain v1 में प्रमुख तकनीकी उन्नयन
मूल LangChain v0.x संस्करण ने एजेंट बनाने के कई पैटर्न दिए थे, जबकि v1 उन्हें एक स्पष्ट मार्ग में समेकित करता है—
create_agentब्लॉक—ताकि आपके एजेंट्स को समझना, परीक्षण करना और शिप करना आसान हो। इसके साथ टूलिंग और भी साफ है, मानकीकृत कंटेंट और अनुमानित एजेंट लूप के जरिए डिबगिंग सरल हो जाती है।इस नवीनतम रिलीज़ के कुछ प्रमुख तकनीकी उन्नयन यहाँ हैं:
create_agentवर्कफ़्लो: यह प्रोडक्शन-रेडी एजेंट लूप मॉडल को यह तय करने देता है कि कब टूल कॉल करने हैं और कब समाप्त करना है। अब हमें कई पैटर्न नहीं संभालने पड़ते—कस्टमाइजेशन आसान हो जाता है।स्टैंडर्ड कंटेंट ब्लॉक्स: प्रदाता-निरपेक्ष तरीके से संदेश पढ़ना—रीजनिंग ट्रेसेस, टूल कॉल्स, सिटेशंस, यहाँ तक कि मल्टीमोडल अंश—सब एकीकृत
content_blocksAPI के जरिए। टूलिंग और लॉग्स सभी प्रदाताओं में एक जैसे दिखते हैं।स्ट्रक्चर्ड आउटपुट: नवीनतम रिलीज़ टाइप्ड स्कीमाज़ के लिए प्रथम-श्रेणी सपोर्ट देता है ताकि आप बिना कड़े regex के पूर्वानुमेय JSON पर निर्भर कर सकें। इससे पार्सिंग त्रुटियाँ और अतिरिक्त कॉल्स घटते हैं।
मिडलवेयर: ये एजेंट लूप में हुक होते हैं—जोखिमभरी कार्रवाइयों को अप्रूव करना, इतिहास लंबा होने पर उसे समरी करना, और कॉल्स से पहले PII को रीडैक्ट करना।
सरल नेमस्पेस:
langchainपैकेज अब आवश्यक एजेंट बिल्डिंग ब्लॉक्स पर केंद्रित है, जबकि अंदरूनी तौर पर LangGraph परसिस्टेंस और टाइम-ट्रैवल जैसी विश्वसनीयता सुविधाएँ देता है।डेमो: LangChain v1 के साथ ऑटो मीटिंग रिकैप असिस्टेंट बनाना
इस भाग में, हम एक Streamlit एप्लिकेशन लागू करेंगे जो एंड-टू-एंड मीटिंग रिकैप्स को ऑटोमेट करता है। ऐप कच्चे मीटिंग नोट्स और वैकल्पिक मेटाडेटा (शीर्षक, तिथि, और प्रतिभागी) स्वीकार करता है। फिर यह एक टाइप्ड
RecapDocजनरेट करता है—शीर्षक, सारांश, निर्णय, और एक्शन आइटम्स सहित—स्ट्रक्चर्ड आउटपुट में। एक क्लिक में, अनुमोदित रिकैप (मीटिंग तिथि के प्रीफ़िक्स के साथ) निर्दिष्ट Google Doc में जोड़ दिया जाता है।चरण 1: पूर्वापेक्षाएँ
ऑटो मीटिंग रिकैप असिस्टेंट बनाने से पहले, हमें UI, LLM, टाइप्ड वेलिडेशन, और Google Docs एक्सेस के लिए न्यूनतम टूलकिट चाहिए। नीचे दिए गए कमांड सब कुछ इंस्टॉल करते हैं और मॉडल की-सेट करते हैं ताकि आपका ऐप प्रदाता से बात कर सके।
प्रत्येक पूर्वापेक्षा क्या करती है, यहाँ बताया गया है:
Streamlit: यह एक सरल, Pythonic UI के साथ वेब ऐप को लोकली चलाता है।langchainऔरlangchain-openai: ये LangChain v1 का सरल सरफेस (init_chat_model, स्ट्रक्चर्ड आउटपुट) और OpenAI प्रदाता ब्रिज उपलब्ध कराते हैं।pydantic: यह लाइब्रेरी सख्तRecapDocस्कीमा परिभाषित करती है ताकि मॉडल टाइप्ड फील्ड्स लौटाए।Python-dotenv: यह विकास के दौरान.envफाइल से एनवायरनमेंट वेरिएबल्स लोड करता है।google-auth: यह OAuth और Google Docs API को संभालने के लिए उपयोग होता है ताकि हम रिकैप को डॉक्युमेंट में जोड़ सकें।OPENAI_API_KEY: OpenAI API Key हमारी LLM कॉल्स को प्रमाणित करता है—इसे एनवायरनमेंट वेरिएबल के रूप में सेट करें (या सीक्रेट्स मैनेजर का उपयोग करें)।ध्यान दें: यदि आप किसी अन्य प्रदाता (Anthropic, Google, या लोकल मॉडल) का उपयोग कर रहे हैं, तो मिलते-जुलते
langchain-*इंटीग्रेशन को इंस्टॉल करें और उस प्रदाता की API key सेट करें।इन निर्भरताओं के इंस्टॉल होने और
OPENAI_API_KEYसेट होने के साथ, वातावरण तैयार है। अगले चरणों में, हम Google Cloud के जरिए Google Docs API सेट करेंगे।चरण 2: Google Docs API सक्षम करें
हर मीटिंग रिकैप को एक लाइव दस्तावेज़ में सहेजने के लिए, ऐप को Google Docs में लिखने की अनुमति चाहिए। यह चरण एंड-टू-एंड उस एक्सेस को सेट करता है। पहले, हम:
Google Cloud से OAuth क्लाइंट फाइल (
credentials.json) प्राप्त करते हैंफिर, उस Google Doc ID की पहचान करते हैं जिसमें आपको जोड़ना है
अंत में, पहली रन पर ब्राउज़र में एक्सेस स्वीकृति के बाद, ऐप एक पुन: उपयोग योग्य
token.jsonबनाता है।इन तीनों चीज़ों के तैयार होते ही, ऐप एक क्लिक में आपके चुने हुए Google Doc में रिकैप जोड़ सकता है। आप कभी भी
token.jsonहटाकर और ऐप फिर चलाकर एक्सेस रद्द या रिन्यू कर सकते हैं।चरण 2.1: Google Cloud से credentials.json प्राप्त करें
credentials.jsonफाइल आपके ऐप की Google Docs API तक कुंजी है। आप इसे Google Cloud Console में Desktop App OAuth क्लाइंट के रूप में एक बार जनरेट करते हैं। शुरू करने के लिए:Create/select a project
Google Docs API सक्षम करें
अब हमारा प्रोजेक्ट बन गया है। चलिए Google Docs में लिखने के लिए आवश्यक API सक्षम करते हैं।
OAuth consent स्क्रीन कॉन्फ़िगर करें
API सक्षम होने के बाद, अगला कदम हमारी पसंदीदा ईमेल के लिए ऑथेंटिकेशन सेट करना है।
OAuth क्लाइंट क्रेडेंशियल्स बनाएं
अंतिम चरण credentials.json फाइल बनाना और डाउनलोड करना है। इसके लिए:
APIs & Services पर जाएँ और Credentials पर क्लिक करें।
+ CREATE CREDENTIALSपर क्लिक करें, जो आपको OAuth client ID तक ले जाएगा।क्लाइंट ID और सीक्रेट तैयार होने में, तथा डाउनलोड योग्य JSON फाइल बनने में, 5 मिनट तक लग सकते हैं।
JSON फाइल को
credentials.jsonनाम से अपनेapp.pyके उसी फ़ोल्डर में सहेजें (या ऐप सेटिंग्स में इसका पाथ दें)।अब आपके पास एक Desktop OAuth क्लाइंट है जिसका उपयोग ऐप ब्राउज़र-आधारित साइन-इन शुरू करने और आपकी ओर से Google Docs एक्सेस का अनुरोध करने के लिए कर सकता है।
चरण 2.2: Google Doc ID
ऐप को यह पता होना चाहिए कि किस दस्तावेज़ में जोड़ना है। उस दस्तावेज़ की पहचान URL में एम्बेडेड एक यूनिक ID से होती है। इस चरण के लिए,
अपने लक्षित Google Doc को ब्राउज़र में खोलें।
URL में
/d/और/editके बीच की स्ट्रिंग कॉपी करें, उदाहरण:https://docs.google.com/document/d/<THIS_IS_THE_ID>/editइस Doc ID को ऐप के “Google Doc ID” फ़ील्ड (या उपयुक्त कॉन्फ़िग वेरिएबल) में चिपकाएँ।
सही Doc ID के साथ, ऐप ठीक उसी दस्तावेज़ में रिकैप लिखेगा जिसे आपने चुना है।
चरण 2.3: Token.json
पहली बार जोड़ते समय, ऐप को दस्तावेज़ तक पहुँच के लिए आपकी स्पष्ट स्वीकृति चाहिए। अनुमोदन के बाद, Google एक टोकन लौटाता है जिसे ऐप लोकली
token.jsonके रूप में सहेजता है। यह फाइल ऐसे जनरेट होती है:ऐप चलाएँ और Append to Google Doc पर क्लिक करें।
एक ब्राउज़र विंडो खुलेगी जो आपसे पिछले चरण में जोड़े गए किसी टेस्ट यूज़र से साइन-इन करने और स्कोप अप्रूव करने को कहेगी।
पुष्टि करने के बाद, ऐप आपके कोड के पास
token.jsonलिख देता है। इस फाइल में आपके पुन: उपयोग योग्य एक्सेस/रिफ्रेश टोकन होते हैं।ध्यान दें: यदि आपको कभी अकाउंट बदलना हो या कन्सेंट फिर से चलाना हो, तो बस
token.jsonहटाएँ और फिर से Append to Google Doc पर क्लिक करें।चरण 3: इम्पोर्ट्स
कोई भी लॉजिक लिखने से पहले, हम वे मॉड्यूल इम्पोर्ट करते हैं जो UI, टाइप्ड डेटा कॉन्ट्रैक्ट्स, मॉडल कॉल्स, और Google Docs इंटीग्रेशन को शक्ति देते हैं। उद्देश्य के अनुसार इम्पोर्ट्स को ग्रुप करना कोडबेस को पढ़ने योग्य रखता है और यह स्पष्ट करता है कि कुछ टूटने पर किस लेयर को ट्रबलशूट करना है।
इस चरण में, हम वही इम्पोर्ट करते हैं जो ऐप को चाहिए, जैसे os, io, json, date जैसे मानक यूटिलिटीज़ और पाथ्स, बफर्स, तथा हल्की-फुल्की सीरियलाइज़ेशन के लिए टाइपिंग हिंट्स। फिर UI के लिए Streamlit, टाइप्ड
RecapDocस्कीमा के लिए Pydantic, और एनवायरनमेंट वेरिएबल्स लोड करने के लिएdotenv। LangChain v1 सरफेसinit_chat_modelऔरcreate_agentप्रदाता-निरपेक्ष चैट मॉडल इनिशियलाइज़ और प्रॉम्प्ट्स स्ट्रक्चर करने के लिए, और अंत में Google Docs API के हिस्से जो OAuth संभालते हैं और हमें लक्ष्य दस्तावेज़ में रिकैप जोड़ने के लिए प्रमाणित क्लाइंट देते हैं।चरण 4: स्ट्रक्चर्ड आउटपुट परिभाषित करें
मॉडल की प्रतिक्रिया को विश्वसनीय और उपयोग में आसान बनाने के लिए, हम रिकैप के लिए एक टाइप्ड कॉन्ट्रैक्ट परिभाषित करते हैं। Pydantic मॉडल्स का उपयोग सुनिश्चित करता है कि LLM ऐसे पूर्वानुमेय फील्ड्स लौटाए जिन्हें हमारा UI रेंडर कर सके, API स्टोर कर सके, और ऑटोमेशन वेलिडेट कर सकें।
ऊपर दिए गए कोड ब्लॉक के प्रमुख घटक ये हैं:
ActionItemक्लास: यह फॉलो-अप टास्क की आवश्यक बातें कैप्चर करता है जैसेowner,task, औरdue_dateछोटी, स्पष्ट विवरणों के साथ ताकि मॉडल इन्हें साफ़-सुथरे ढंग से भरे। ISO तिथियाँ या प्राकृतिक वाक्यांशों की अनुमति देने से इनपुट लचीला रहता है जबकि डाउनस्ट्रीम पार्सिंग संभव रहती है।RecapDocक्लास: यह क्लास पूरे रिकैप को एक ऑब्जेक्ट के रूप में दर्शाती है, जिसमेंtitle,date,attendees, संक्षिप्तsummary, स्पष्टdecisions, औरaction_itemsकी सूची शामिल है।LangChain v1 के साथ, आप सीधे
with_structured_output(RecapDoc)के जरिए यही स्कीमा अनुरोध कर सकते हैं, जो नाजुक स्ट्रिंग पार्सिंग को घटाता है, वेलिडेशन सुधारता है, और फील्ड्स गायब होने पर जल्दी असफल होने देता है।चरण 5: सिस्टम प्रॉम्प्ट
सिस्टम प्रॉम्प्ट आपके असिस्टेंट के लिए आधार नियम तय करता है। यह मॉडल को सटीक बताता है कि क्या बनाना है, क्या नहीं करना है, और आउटपुट कैसे स्ट्रक्चर करना है ताकि अगले चरण हर बार विश्वसनीय रूप से काम करें।
सिस्टम प्रॉम्प्ट असिस्टेंट को सटीक और संक्षिप्त बनाता है, ताकि वह ट्रांसक्रिप्ट्स की बजाय उच्च-सिग्नल रिकैप दे। यह स्पष्ट स्कीमा देता है जिसमें शीर्षक, तिथि, प्रतिभागी, सारांश, निर्णय, और action_items शामिल हैं—नियमों के साथ जैसे 3–6 वाक्यों का सारांश, बुलेट निर्णय, और एक्शन आइटम्स में ओनर, टास्क, और देय तिथि।
एक स्पष्ट सिस्टम प्रॉम्प्ट के साथ, मॉडल पहली बार में ही उपयोगी, स्ट्रक्चर्ड रिकैप लगातार तैयार करता है।
चरण 6: Google OAuth हेल्पर
इस चरण में, हम एक हेल्पर फ़ंक्शन परिभाषित करते हैं जो Google Docs के लिए एक विश्वसनीय, पुन: उपयोग योग्य कनेक्शन स्थापित करता है ताकि ऐप आपके चुने हुए दस्तावेज़ में रिकैप जोड़ सके। यह केवल Docs स्कोप का अनुरोध करता है और पहली बार की कन्सेंट, टोकन रिफ्रेश, और सर्विस कंस्ट्रक्शन को संभालता है।
get_google_docs_service()फ़ंक्शन OAuth और सर्विस क्रिएशन को इस तरह संभालता है:एक्सेस स्कोपिंग: यह फ़ंक्शन पूर्व-परिभाषित
SCOPESका उपयोग करके अनुमतियों को Google Docs तक सीमित करता है।क्रेडेंशियल्स लोड करना: यह लोकल
credentials.jsonयाst.secrets["google_credentials_json"]से पढ़ता है जबuse_secrets=Trueहो—यह Streamlit का सीक्रेट होल्डर है।टोकन का पुन: उपयोग: यदि
token.jsonमौजूद है, तो कोड उसे लोड करता है और टोकन एक्सपायर होने पर उसे चुपचाप रिफ्रेश कर देता है।पहली बार कन्सेंट: यदि कोई मान्य टोकन नहीं मिलता, तो हम Desktop
InstalledAppFlowलॉन्च करते हैं, जो ब्राउज़र में यूज़र को ऑथेंटिकेट करने के लिए प्रॉम्प्ट करता है, फिर भविष्य के लिएtoken.jsonसेव कर देता है।क्लाइंट लौटाना: अंत में, हम
build()फ़ंक्शन के जरिए एक ऑथेंटिकेटेड Docs क्लाइंट बनाकर लौटाते हैं।कन्फ़िगर होने के बाद, आप प्रमाणीकरण के लिए वही
token.jsonपुन: उपयोग कर सकते हैं या टोकन को स्वतः रिफ्रेश कर सकते हैं। एक्सेस रीसेट करने के लिए, बसtoken.jsonहटाएँ और ऐप फिर चलाएँ।चरण 7: अपेंड यूटिलिटी और Markdown रेंडरर
अब, हम एक टाइप्ड
RecapDocको साफ-सुथरे Markdown में बदलते हैं, जो लक्ष्य Google Doc में जोड़ दिया जाता है। एक फ़ंक्शन रिकैप को रेंडर करता है जबकि दूसरा दस्तावेज़ के अंत में ऑथेंटिकेटेड राइट करता है।ऊपर के दोनों हेल्पर्स इस तरह साथ काम करते हैं:
recap_to_markdown()फ़ंक्शन एक पढ़ने योग्य सारांश बनाता है। इसमें तिथि सहित शीर्षक, प्रतिभागी, संक्षिप्त सारांश, और ओनर, टास्क, देय तिथि वाले एक्शन आइटम्स शामिल होते हैं। फील्ड्स गायब होने पर यह “Unknown” या “None recorded” पर फॉलबैक करता है।वहीं
append_plaintext_to_doc()फ़ंक्शन दस्तावेज़ लाता है, वर्तमान एंड इंडेक्स ढूंढता है, औरdocuments()के जरिए एकलinsertTextरिक्वेस्ट जारी करता है। टेक्स्ट के अंत में एक नई लाइन जोड़ दी जाती है ताकि अगली एंट्री नई लाइन से शुरू हो।ध्यान दें: खाली दस्तावेज़ों के लिए, यदि
endIndexउपलब्ध न हो, तो इंसर्शन इंडेक्स को 1 पर डिफॉल्ट करने पर विचार करें।Markdown रेंडरिंग और अपेंड तैयार होने के साथ, अब हम अपना रिकैप जनरेटर सेटअप करते हैं।
चरण 8: रिकैप जनरेटर
यह फ़ंक्शन ऐप का हृदय है। यह कच्चे नोट्स और वैकल्पिक मेटाडेटा लेता है, एक चैट मॉडल को कॉल करता है, और एक टाइप्ड
RecapDocलौटाता है ताकि डाउनस्ट्रीम सब कुछ पूर्वानुमेय रहे।रिकैप जनरेटर में तीन प्रमुख घटक हैं:
मॉडल इनिशियलाइज़ेशन:
init_chat_model()आपके चुने प्रदाता के लिए चैट मॉडल बनाता है। फिर हमwith_structured_output()कॉल करके मॉडल को बताते हैं कि किस आकार का आउटपुट लौटाना है। यहRecapDocफील्ड्स से मेल खाता एक Python ऑब्जेक्ट आउटपुट करता है।प्रॉम्प्ट असेम्बली: हम इनपुट्स को नॉर्मलाइज़ करते हैं और दो संदेश भेजते हैं—कड़े नियमों वाला
SystemMessage(सिस्टम प्रॉम्प्ट) औरHumanMessageजिसमें शीर्षक, तिथि, प्रतिभागी और कच्चे नोट्स होते हैं।स्ट्रक्चर्ड जेनरेशन:
structured_llm.invoke()एक वेलिडेटेडRecapDocलौटाता है, जिससे पार्सिंग से बचते हैं और भ्रम-जनन कम होता है।अपने GPT मॉडल को LangChain के स्ट्रक्चर्ड-आउटपुट रैपर से गुजारने पर रिकैप चरण विश्वसनीय बन जाता है और बिना किसी डाउनस्ट्रीम लॉजिक बदले सीधे Markdown रेंडरिंग के लिए तैयार रहता है।
चरण 9: Streamlit UI
यह चरण पूरे डेमो को एक पेज के Streamlit ऐप में वायर करता है। उपयोगकर्ता नोट्स पेस्ट करता है, वैकल्पिक मेटाडेटा जोड़ता है, एक स्ट्रक्चर्ड रिकैप जनरेट करता है, उसे Markdown के रूप में प्रीव्यू करता है, और एक क्लिक में उसे Google Doc में जोड़ देता है।
Streamlit ऐप एक “Generate Recap” एक्शन को मॉडल से जोड़ता है और उसे लोकल वेब UI पर एक्सपोज़ करता है, इस प्रकार:
इनपुट्स (बाएँ/दाएँ कॉलम): बायाँ पैनल कच्चे नोट्स के लिए बड़ा
st.text_areaहै। दायाँ पैनल शीर्षक, तिथि, और प्रतिभागी कैप्चर करता है।आउटपुट्स (प्रीव्यू एरिया): जब रिकैप मौजूद हो, तो ऐप एक डिवाइडर दिखाता है और त्वरित समीक्षा के लिए स्ट्रक्चर्ड रिकैप का Markdown प्रीव्यू देता है।
इंटरफेस वायरिंग (एक्शन): ये एक्शन हमारे ऐप के कोर हैं। इनमें शामिल हैं:
Generate recap: यह नोट्स वेलिडेट करता है,
generate_recap()को कॉल करता है, Markdown में बदलता है, औरst.rerun()से रीफ़्रेश करता है।Append to Google Doc: इसके बाद, हम
get_google_docs_service()से एक ऑथेंटिकेटेड क्लाइंट बनाते हैं, एक दिनांकित हेडर जोड़ते हैं, और डेस्टिनेशन डॉक में अपेंड करते हैं।स्टेट:
st.session_stateनवीनतमRecapDocऔरmarkdown_textस्टोर करता है ताकि UI रीरन्स के बीच स्थिर रहे।ऐप सेटअप: अंततः,
load_dotenv()एनव वेरिएबल्स पढ़ता है,st.set_page_config()लेआउट सेट करता है, और क्रेडेंशियल पाथ्स एनव या डिफॉल्ट्स से आते हैं।इसे
app.pyके रूप में सेव करें और टर्मिनल में यह कमांड चलाएँ।अब आपके पास एक एंड-टू-एंड मीटिंग रिकैप टूल है जो कुछ ऐसा दिखता है: