

要点速览
- 损失函数衡量模型预测与真实目标值之间的差距,引导算法调整权重以提升准确率。
- 在回归中,若需严惩大误差请选择MSE,若希望对离群点一视同仁请选择MAE,而Huber 损失可在两者之间取得平衡。
- 在分类中,二分类可用二元交叉熵,多分类用类别交叉熵,基于间隔的分类器(如 SVM)可用合页损失。
- scikit-learn、TensorFlow 与 PyTorch 等库内置了最常用的损失函数。
损失函数概述
损失函数为评估机器学习模型性能与准确性的可度量方式。在此意义上,损失函数为模型或算法的学习过程提供了方向指引。
损失函数在模型训练中至关重要,其作用包括:
- 性能度量:通过量化预测与真实结果的差异,损失函数为评价模型性能提供清晰指标。
- 改进方向:损失函数引导算法迭代调整参数(权重),以降低损失、改进预测。
- 平衡偏差与方差:有效的损失函数有助于平衡模型偏差(过度简化)与方差(过拟合),从而提升对新数据的泛化能力。
- 影响模型行为:某些损失函数会影响模型行为,例如增强对离群点的鲁棒性,或优先考虑特定类型的错误。
后文将结合具体损失函数的角色展开,逐步建立对损失函数的直观认识与理解。
什么是损失函数?
损失函数(亦称误差函数)是机器学习中的关键组成,用于量化算法预测输出与真实目标值之间的差异。
例如,在基于历史数据预测汽车价格的回归问题中,损失函数会基于训练集中的一个样本评估神经网络的预测。损失函数量化网络预测的车价与真实价格之间的差距或误差幅度。
得到的数值即损失,反映模型预测的准确性。训练过程中,诸如反向传播这类学习算法会利用损失函数关于模型参数的梯度来调整参数、最小化损失,从而有效提升模型在数据集上的表现。
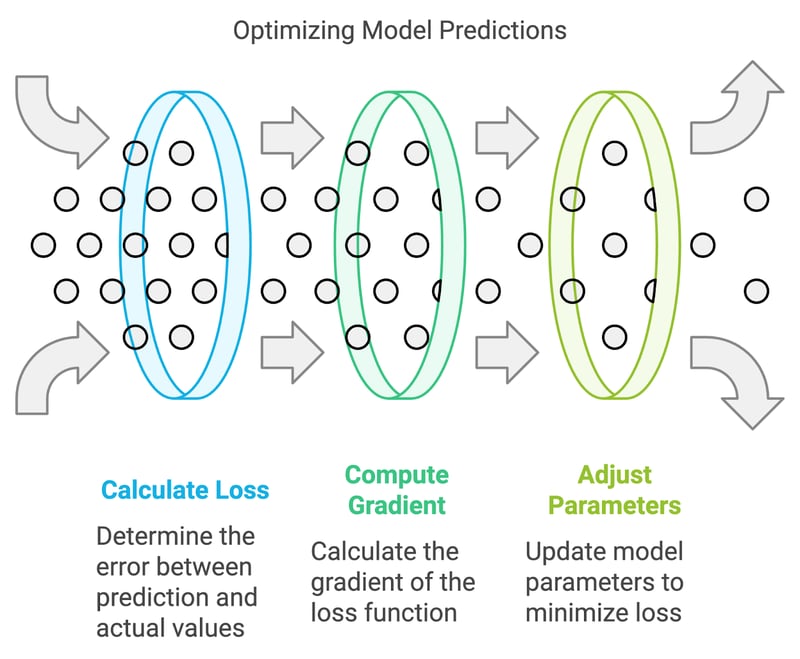
人们常将损失函数与代价函数交替使用,然而二者仍有明确区分:
如前所述,损失函数(误差函数)量化的是机器学习算法对单一样本的预测与真实目标值的契合程度。关键在于,损失函数作用于单个训练样本,并在整体学习过程中提供信号,促使学习算法更新权重与参数。
代价函数(亦称目标函数)是整个训练集中多个训练样本的损失函数的平均。代价函数量化模型在整个训练数据集上的整体表现。
接下来进一步探讨损失函数的工作机制。
损失函数的工作机制
尽管损失函数类型多样,但其本质都是量化模型预测与数据集中真实目标值之间的差异。对此数值化量度的正式术语是“预测误差”。模型中的学习算法与机制旨在最小化预测误差,这意味着在计算出由预测误差决定的损失值之后,学习算法会据此进行权重与参数更新,从而在下一次训练迭代中实现更低的预测误差。
探讨损失函数、机器学习算法与神经网络学习过程时,常会涉及经验风险最小化(ERM)。ERM 是一种选择机器学习算法最优参数以最小化经验风险的方法,此处的经验风险即基于训练数据集。
ERM 的风险最小化部分,指内部学习算法使模型在已知数据集上的预测误差最小化,以期模型在面对未见数据或与训练数据统计分布相近的样本时,仍能保持预期的性能与准确性。
损失函数的类型
机器学习中的损失函数可按适用任务进行分类。多数损失函数适用于回归与分类问题。回归任务中,模型需预测连续输出值;而分类任务中,模型需输出与数据集类别相对应的离散标签。
下表列出常见损失函数,并按其适配的问题类型进行归类。本文稍后将对其中大部分进行详细介绍。
|
损失函数 |
分类任务适用性 |
回归任务适用性 |
|
均方误差(MSE)/ L2 损失 |
✖️ |
✔️ |
|
平均绝对误差(MAE)/ L1 损失 |
✖️ |
✔️ |
|
二元交叉熵 / 对数损失 |
✔️ |
✖️ |
|
类别交叉熵 |
✔️ |
✖️ |
|
合页损失(Hinge Loss) |
✔️ |
✖️ |
|
Huber 损失 / 平滑 MAE |
✖️ |
✔️ |
|
对数损失 |
✔️ |
✖️ |
回归中的损失函数
均方误差(MSE)/ L2 损失
均方误差(MSE)或 L2 损失通过计算预测值与目标值之差的平方的平均值,来量化机器学习算法预测与真实输出之间误差的大小。对差值进行平方会对偏离目标值较大的误差施加更高惩罚;取平均则将总误差按数据集样本数进行归一化。
MSE(L2 损失)的数学表达式为:
MSE = (1/n) * Σ(yᵢ - ȳ)²其中:
- n 为数据集中的样本数量
- yᵢ 为第 i 个样本的预测值
- ȳ 为第 i 个样本的目标值
何时使用 MSE
在模型开发中把握 MSE 的适用场景至关重要。MSE 是多数回归任务的常用损失函数,因为它引导模型最小化预测与目标之间的平方差。
当需要在学习过程中对离群点施加较强惩罚时,推荐使用 MSE。然而,当离群点更多源于数据噪声而非有意义信号时,MSE 的这一特性可能并不适用。
例如在房价预测等更广泛的预测建模中,常用房间数量、地段、面积、与配套设施的距离等特征。某一地区的房价通常近似正态分布,因此对离群点进行惩罚对提升模型预测准确性至关重要。
在房地产场景中,细小的百分比误差也可能对应巨额金额。例如,20 万美元房价的 5% 误差即 1 万美元,影响显著。因此通过平方误差(MSE 的做法)放大大误差的影响,可以促使模型对高价房产的预测更加精确。
平均绝对误差(MAE)/ L1 损失
平均绝对误差(MAE),也称 L1 损失,是一种用于回归任务的损失函数,计算模型预测值与真实目标值之间绝对差的平均值。不同于 MSE,MAE 不进行平方,因此不按误差大小加权,所有误差权重相同。
MAE(L1 损失)的数学表达式为:
其中:
- n 为数据集中的样本数量
- yᵢ 为第 i 个样本的预测值
- ȳ 为第 i 个样本的目标值
何时使用 MAE
MAE 衡量预测值与真实值之间绝对差的平均值。不同于 MSE,MAE 不进行平方,因此对离群点不敏感。与均方误差(MSE)相比,平均绝对误差(MAE)对离群点天生更不敏感,因为其对所有误差一视同仁,不因幅度大小而赋予更高权重。
这意味着离群点在 MSE 中因平方而造成的巨大误差贡献会显著拉高整体误差,而在 MAE 中影响更可控。使用 MAE 作为损失函数时,离群点对整体误差度量的影响较小;相反,MSE 因平方项会放大离群点效应,从而更大程度影响误差估计。
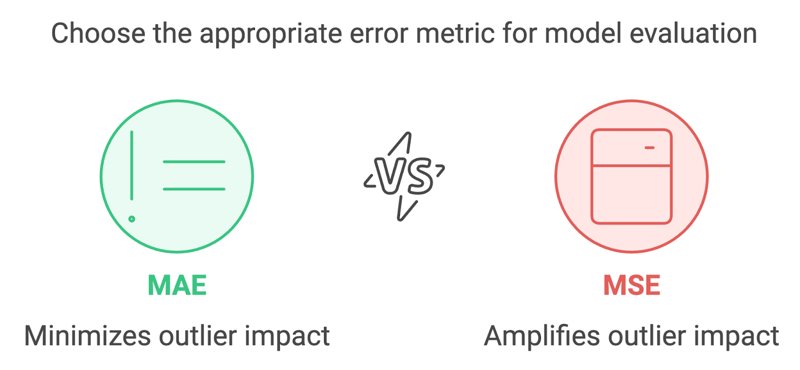
MAE 适用于不希望对离群点大幅惩罚甚至不惩罚的场景,例如外卖平台的配送时长预测。
像 UberEats、Deliveroo 或 DoorDash 等配送服务公司可能会构建配送时长估计模型以提升客户满意度。配送时长会受到天气、交通事故、道路施工等多种因素影响。
妥善处理这些因素对时长估计至关重要。一种做法是将这些事件视为离群点,并选择不让其影响模型训练。在此场景下,MAE 是合适的损失函数,因为它会以较低严重度对由施工或罕见事件导致的离群点进行处理,从而减弱离群点对误差度量与模型学习过程的影响。
需要注意的是,MAE 对所有数据点施加均匀的误差权重;在上述场景中,若对离群点过度惩罚,可能导致系统性高估或低估配送时间。
Huber 损失 / 平滑平均绝对误差
Huber 损失(平滑 MAE)融合了 MAE 与 MSE 的有利特性于一体。其混合特性使其像 MAE 一样对离群点不那么敏感,同时又像 MSE 那样对小误差进行惩罚。Huber 损失同样用于回归任务。
Huber 损失的数学表达如下:
L(δ, y, f(x)) = (1/2) * (f(x) - y)^2 if |f(x) - y| <= δ
= δ * |f(x) - y| - (1/2) * δ^2 if |f(x) - y| > δ其中:
- L 表示 Huber 损失函数
- δ 为阈值参数,用于决定损失函数在二次与线性部分之间切换的界限
- y 为真实值或目标值
- f(x) 为预测值
何时使用 Huber 损失 / 平滑 MAE
Huber 损失通过两个组成部分以不同方式处理误差,并由阈值 δ 决定两者的切换点:
- 小误差的二次部分:当误差小于 δ 时,采用二次项
(1/2) * (f(x) - y)^2 - 大误差的线性部分:当误差大于 δ 时,采用线性项
δ * |f(x) - y| - (1/2) * δ^2
Huber 损失会根据预测与真实值差异的大小在两种模式间切换。关键参数是 delta(δ),它决定 Huber 损失采取二次惩罚还是线性惩罚的数值边界。
Huber 损失中的二次部分承接了 MSE 的优势,即对误差进行更强惩罚;在 Huber 中,这适用于小于 δ 的误差,有助于提升模型精度。
若计算得到的误差(真实值与预测值之差)大于 δ,Huber 损失则转为类似 MAE 的线性计算,对误差大小不那么敏感,从而避免模型对大误差过度惩罚,尤其当数据集中包含离群点或低概率事件时更为合适。
分类中的损失函数
二元交叉熵 / 对数损失
二元交叉熵(BCE)是用于评估分类模型的指标,模型输出通常是 0 到 1 之间的概率值,对应某个样本属于某一类的可能性。在 BCE 中仅有两个类别。需要注意的是,交叉熵损失的变体——类别交叉熵适用于多类别分类场景。
理解二元交叉熵(有时称对数损失)有必要先拆解相关术语:
- 损失:机器学习算法预测与真实目标值之间差距的量化。
- 熵:系统中随机性或无序程度的度量。
- 交叉熵:信息论中常用的概念,用于衡量两个概率分布之间的差异,可用于区分观测。
- 二元:以 0 和 1 两种状态表达数值;延伸至二分类,即用 0/1 表达两个类别(A 与 B),例如将 A 记作 0、B 记作 1。
二元交叉熵(或对数损失)量化机器学习算法预测与真实目标之间的差异,其计算是对模型针对每个样本给出的预测概率取对数并求和,再取负值并按样本数取平均。BCE 常见于逻辑回归问题,以及在利用Sigmoid 激活函数的神经网络中,用于预测样本属于某一类的概率。
二元交叉熵(又称对数损失)的数学表达为:
L(y, f(x)) = -[y * log(f(x)) + (1 - y) * log(1 - f(x))]其中:
- L 表示二元交叉熵损失函数
- y 为真实的二元标签(0 或 1)
- f(x) 为预测为正类的概率(介于 0 与 1 之间)
何时使用二元交叉熵 / 对数损失
上述公式适用于模型需在两类之间进行判别的二分类场景。
如公式中负号所示:“-”,BCE 通过以下两项的负值(对多样本取平均)来计算损失:
- 当正类出现时,模型预测概率的对数:y * log(f(x))
- 负类情况下,1 减去预测概率的对数:(1 - y) * log(1 - f(x))
BCE 会惩罚不准确的预测,即与正类相差较大的预测(也可理解为高熵)。在作为学习算法一部分时,BCE 会促使模型在训练中不断微调,使其输出更符合正确类别的概率分布。
合页损失(Hinge Loss)
合页损失用于训练旨在最大化样本到决策边界间距的分类器,因此主要用于最大间隔分类。为保证数据点与边界之间的最大间隔,合页损失会惩罚被错误分类(落在间隔边界错误一侧)的预测,也会惩罚虽然被正确分类但距离决策边界过近的预测。
合页损失的这一特性,确保模型不仅能正确分类,还能以超过决策边界阈值的置信度进行判断。这种学习方式增强了模型的泛化能力,使其能更有把握地对数据点进行准确分类。
合页损失的数学表达式为:
L(y, f(x)) = max(0, 1 - y * f(x))其中:
- L 表示合页损失
- y 为真实标签或目标值(-1 或 1)
- f(x) 为预测值或决策函数输出
如何选择合适的损失函数
为机器学习算法选择恰当的损失函数至关重要,模型性能很大程度取决于算法如何学习或调整内在权重以拟合数据集。
模型(或算法)的性能由所用损失函数所界定,主要因为损失函数会影响用于最小化误差(或代价)值的学习算法。本质上,损失函数影响模型的学习能力与对内部权重的自适应,从而更好地拟合数据集中的模式。
若选择得当,损失函数能帮助学习算法在训练阶段有效收敛至较优损失,并对未见样本有良好泛化。合适的损失函数如同指南,指引学习算法走向准确与可靠,既能捕捉数据中的潜在规律,又能避免过拟合或欠拟合。
选择损失函数需考虑的因素
首先需明确机器学习问题类型,以此决定应使用的损失函数类别。不同损失函数适用于不同的问题类型。
分类 vs 回归
分类任务通常涉及将数据点分配给特定类别标签。此类任务中,模型输出通常是一组概率,表示数据点属于某一标签的可能性。
交叉熵损失常用于分类任务。对于回归任务,目标是依据一组输入给出预测,则更适合使用均方误差或平均绝对误差等损失函数。
二分类 vs 多分类
二分类将样本划分为两个不同类别;多分类则是两个以上类别。对于仅含两类的分类问题,适合使用二元交叉熵;当类别数超过两个时,应使用类别交叉熵。
敏感度
另一个考虑因素是损失函数对离群点的敏感度。在某些场景中,希望在训练时对破坏整体统计分布的离群点进行惩罚,此时均方误差等损失较为适合。
而当离群点属于“极少发生”的事件或不太可能重现时,过度惩罚可能反而使模型性能变差。在此类目标下,更低离群点敏感度的 MAE 更为合适。若希望兼顾两者,可考虑 Huber 损失:对小误差(潜在离群)施加一定惩罚,同时降低对大误差离群点的敏感度。
计算效率
计算资源在机器学习的商业与科研领域都十分宝贵。充足的计算力能让从业者更灵活地试验大数据集并解决更复杂的问题。一些损失函数的计算量较大,尤其在数据集规模很大时。因此,在选择损失函数时应考虑其计算效率。
|
因素 |
说明 |
|
学习问题类型 |
分类 vs 回归;二分类 vs 多分类。 |
|
对离群点的敏感度 |
有的损失函数更敏感(如 MSE),有的更稳健(如 MAE)。 |
|
期望的模型行为 |
影响模型行为,例如 SVM 中的合页损失侧重最大化间隔。 |
|
计算效率 |
部分损失函数计算量更大,需结合可用资源进行权衡。 |
|
收敛性质 |
损失函数的平滑性与凸性会影响训练的难易与速度。 |
|
任务规模 |
大规模任务需选择可良好扩展、易于优化的损失函数。 |
离群点与数据分布的影响
离群点是落在数据集整体统计分布之外的样本,也称异常或不规则点。如何处理离群点,会显著影响最终训练模型的性能与准确性。
如前所述,离群点会影响损失函数中的误差值,而影响程度取决于所用损失函数。离群点对损失函数的影响将传导至学习过程的结果,进而可能导致模型产生预期或非预期的行为。
例如,均方误差会对离群点产生较高的误差项,训练中模型的权重会相应调整以“照顾”这些离群点。若这并非期望的模型行为,则最终训练出的模型在未见数据上的泛化会很差。若需降低离群点影响,更适合使用 MAE 与 Huber 损失等函数。
|
损失函数 |
分类任务适用性 |
回归任务适用性 |
对离群点的敏感度 |
|
均方误差(MSE) |
✖️ |
✔️ |
高 |
|
平均绝对误差(MAE) |
✖️ |
✔️ |
低 |
|
交叉熵 |
✔️ |
✖️ |
中 |
|
合页损失 |
✔️ |
✖️ |
低 |
|
Huber 损失 |
✖️ |
✔️ |
中 |
|
对数损失 |
✔️ |
✖️ |
中 |
实现损失函数
常见损失函数的实现示例
在 Python 中实现 MAE
# Python implementation of Mean Absolute Error (MAE)
def mean_absolute_error(actual:list, predicted:list) -> float:
"""
Calculate the Mean Absolute Error between actual and predicted values
:param actual: list, actual values
:param predicted: list, predicted values
:return: float, the calculated MAE
"""
# Ensure the length of the two lists are the same
if len(actual) != len(predicted):
raise ValueError("The length of actual values and predicted values must be the same")
# Calculate the absolute differences
absolute_diffs = [abs(act - pred) for act, pred in zip(actual, predicted)]
# Calculate the mean of the absolute differences
mae = sum(absolute_diffs) / len(actual)
return mae
# Example usage:
# actual values
y_true = [3, -0.5, 2, 7]
# predicted values
y_pred = [2.5, 0.0, 2, 8]
# Calculate MAE
mae_value = mean_absolute_error(y_true, y_pred)
print(mae_value)
# 0.5在 Python 中实现 MSE
# Python implementation of Mean Squared Error (MSE) / L2 Loss
def mean_squared_error(actual:list, predicted:list) -> float:
"""
Calculate the Mean Squared Error between actual and predicted values
:param actual: list, actual values
:param predicted: list ,predicted values
:return: float, the calculated MSE
"""
# Ensure the length of the two lists are the same
if len(actual) != len(predicted):
raise ValueError("The length of actual values and predicted values must be the same")
# Calculate the squared differences
# (yᵢ - ȳ)²
squared_diffs = [(act - pred) ** 2 for act, pred in zip(actual, predicted)]
# Calculate the mean of the squared differences
mse = sum(squared_diffs) / len(actual)
return mse
# Example usage:
# actual values
y_true = [1, 2, 3, 4, 5]
# predicted values
y_pred = [1.1, 2.2, 2.9, 4.1, 4.9]
# Calculate MSE
mse_value = mean_squared_error(y_true, y_pred)
print(mse_value)
# 0.015999999999999993使用库来实现损失函数
虽然可以自定义实现损失函数,且 TensorFlow、PyTorch 等深度学习库也支持在神经网络中使用自定义损失,但如 Scikit-learn、TensorFlow、PyTorch 等库已内置常用损失函数的实现。
这些内置功能便于直接调用,屏蔽了许多实现细节的复杂性,从而简化模型开发流程。
相较于纯 Python 实现,使用这些深度学习库具有以下优势:
- 易用性
- 高效与优化
- 支持 GPU 与并行计算
- 开发者社区支持
使用 scikit-learn 计算 MAE
from sklearn.metrics import mean_absolute_error
# actual values
y_true = [3, -0.5, 2, 7]
# predicted values
y_pred = [2.5, 0.0, 2, 8]
# Calculate MAE using scikit-learn
mae_value = mean_absolute_error(y_true, y_pred)
print(mae_value)
#0.5使用 scikit-learn 计算 MSE
from sklearn.metrics import mean_squared_error
# actual values
y_true = [1, 2, 3, 4, 5]
# predicted values
y_pred = [1.1, 2.2, 2.9, 4.1, 4.9]
# Calculate MSE using scikit-learn
mse_value = mean_squared_error(y_true, y_pred)
print(mse_value)
# 0.016结论
总之,选择合适的损失函数是有效训练机器学习模型的关键。本文概述了主要损失函数、它们在算法中的作用及其在不同任务中的适配性。从 MSE 到 Huber 损失,每种函数都各有优势,比如处理离群点,或在偏差与方差之间取得平衡。
选择自定义实现还是使用 Scikit-learn、TensorFlow、PyTorch 等库中的预置损失函数,取决于具体项目需求、计算效率与使用者经验。这些库提供了便捷实现、持续的社区支持与定期更新。
尽管机器学习不断演进,损失函数的重要性始终不变。未来或将出现更为专门化的损失函数,但基本原理大体会延续。若想更深入学习机器学习及其应用,欢迎探索 DataCamp 的Machine Learning Scientist with Python学习路径。
常见问题解答
同一机器学习问题可以使用不同的损失函数吗?
可以。您可以针对同一问题试验不同损失函数,以比较哪一种效果更好。例如在回归任务中,可同时尝试均方误差(MSE)与 Huber 损失,以在离群点敏感度与整体表现之间取得平衡。损失函数的选择取决于数据集与问题本身的具体特征。
损失函数如何影响模型在训练过程中的收敛?
损失函数会影响模型在训练过程中的收敛平滑性与速度。例如,具有非凸或不连续梯度的损失函数可能导致训练停滞或收敛到次优解;而梯度平滑、性质良好的损失函数(如 MSE 或交叉熵)通常更利于基于梯度的方法进行优化。
输出数据的尺度在选择损失函数时起什么作用?
输出数据的尺度会显著影响损失函数的选择。例如,当目标值尺度很大或很小时,像 MSE 这类会对误差进行平方的损失函数,可能会不成比例地强调大数值。在这种情况下,对数据进行归一化,或使用对尺度更不敏感的损失函数(如 MAE 或 Huber 损失),有助于实现更均衡的优化。

Richmond Alake 是 MongoDB 的开发者倡导者,专注于 AI/ML 技术。他为开发者和 MongoDB 用户创作教育内容,帮助他们借助 MongoDB 的能力(包括向量搜索和大型语言模型(LLM))构建 AI 解决方案。Richmond 具有深厚的 AI、计算机视觉和软件开发背景。他还撰写了大量技术文章,并教授与 AI 相关的课程。在加入 MongoDB 之前,他曾在 Slalom Build 担任机器学习架构师,在 Emeritus 担任项目负责人,并在 Loveshark 担任计算机视觉工程师。
机器学习及其相关算法与技术,核心在于设计、实现并训练算法,使其能够在所接触的数据中识别模式并进行预测或分类。
机器学习算法的学习方式各不相同,但其中一个学习过程的基石是损失函数。损失函数是一种数学过程,用于量化模型预测与真实目标值之间的误差幅度。本文后续将详细探讨损失函数。