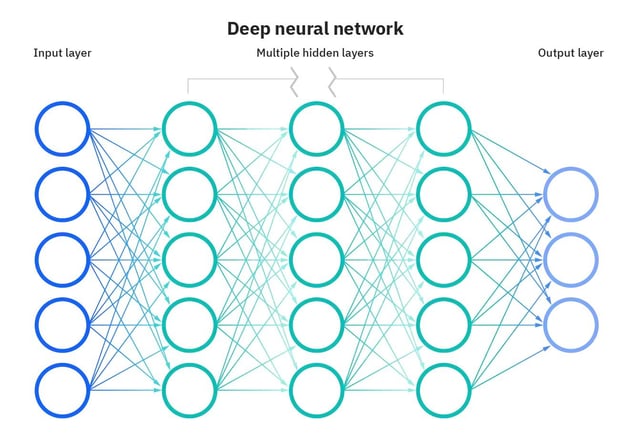
神经网络示意图。图片来源
什么是激活函数?
激活函数是神经网络的关键构件,帮助其学习数据中的复杂模式。它将神经网络中某个节点的输入信号转换为输出信号,再传递到下一层。如果没有激活函数,神经网络将只能拟合输入与输出之间的线性关系。
激活函数引入非线性,使神经网络能够学习输入与输出之间高度复杂的映射关系。
选择合适的激活函数对于训练具有良好泛化能力并能给出准确预测的神经网络至关重要。本文将概述最常见的激活函数、它们的作用,以及如何针对不同用例选择合适的激活函数。
无论您刚开始学习深度学习,还是已是经验丰富的实践者,深入理解激活函数都将有助于建立直觉并提升您对神经网络的应用能力。
为什么激活函数必不可少?
如果没有激活函数,神经网络就只包含诸如矩阵乘法之类的线性运算。所有层都只是对输入做线性变换,不会引入任何非线性。
大多数现实世界的数据都是非线性的。例如,房价与面积、收入与消费等之间的关系并非线性。如果神经网络没有激活函数,就无法学习现实数据中存在的复杂非线性模式。
激活函数通过引入非线性行为,使神经网络能够学习这些非线性关系。这大大提升了神经网络对复杂细微数据进行建模的灵活性与能力。
激活函数的类型
神经网络会利用多种激活函数来引入非线性并学习复杂模式。每种激活函数都有其独特性质,适用于特定用例。
例如,sigmoid 适合二元分类问题,softmax 适合多类别预测,而 ReLU 有助于缓解梯度消失问题。
针对任务使用正确的激活函数可带来更快的训练速度和更好的性能。
下面来看一些常见的激活函数:
线性激活
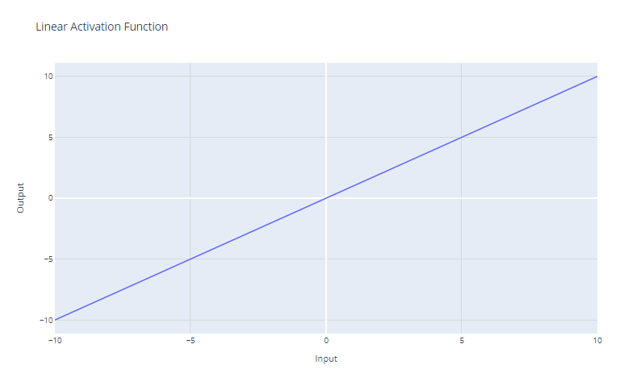
线性激活函数。作者制图
线性激活函数是最简单的一类,定义为:
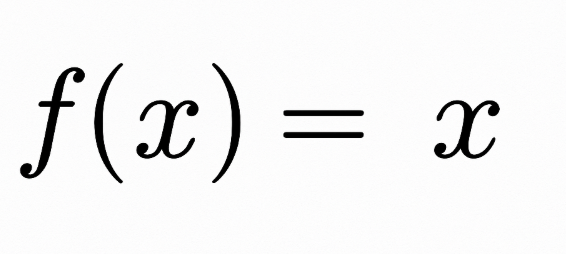
它直接将输入 x 原样输出。从图形上看,就是斜率为 1 的直线。
线性激活函数的主要用例是在用于回归的神经网络的输出层。对于希望预测数值的回归问题,在输出层使用线性激活函数可确保网络输出一个数值。由于线性激活不会压缩或变换输出,因此会返回真实的预测值。
不过,线性激活函数很少用于神经网络的隐藏层,因为它不提供任何非线性。而隐藏层的意义就在于学习输入特征的非线性组合。若始终使用线性激活,模型只能学习对输入的线性变换。
Sigmoid 激活
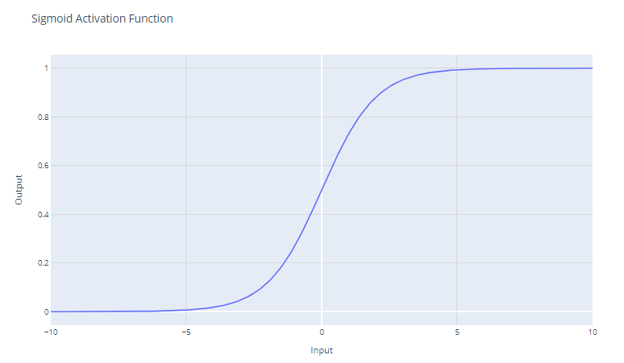
Sigmoid 激活函数。作者制图
Sigmoid 激活函数通常记作 σ(x),是一种平滑、处处可导的函数,在神经网络的发展史上具有重要地位。Sigmoid 激活函数的数学形式为:
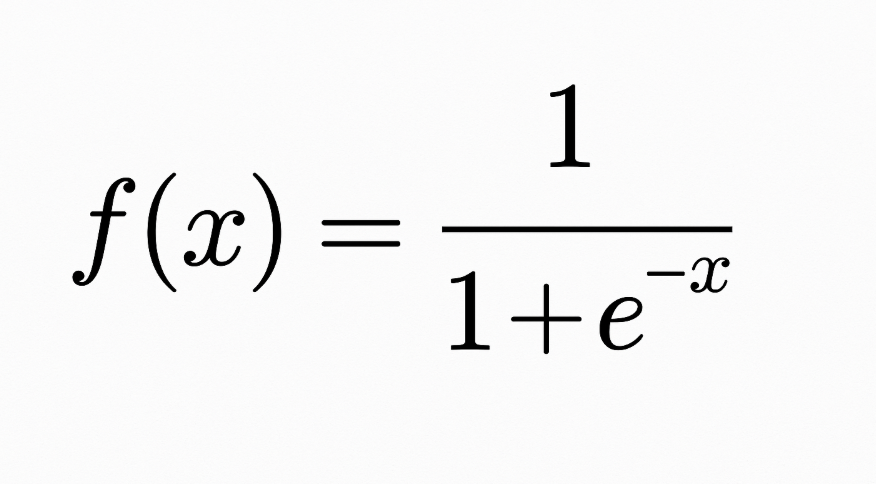
它将实数输入压缩到 0 到 1 之间。Sigmoid 的曲线呈“S”形,对于很大的负数趋近于 0,对于很大的正数趋近于 1。其输出易于解释为概率,因此非常适合二元分类问题。
早期神经网络中 Sigmoid 单元很流行,因为当单元输出接近 0.5 时梯度最强,有利于高效的反向传播训练。然而,Sigmoid 单元会遭遇“梯度消失”问题,从而阻碍深层网络的学习。
当输入值显著为正或为负时,函数在 0 或 1 处饱和,曲线斜率极其平缓。在这些区域,梯度非常接近于零。这会导致反向传播时权重更新幅度极小,尤其是深层网络早期层的神经元,使得学习过程极其缓慢,甚至停滞。这就是神经网络中的梯度消失问题。
Sigmoid 的主要用例是作为二元分类模型输出层的激活函数。它将输出压缩到 0 到 1 之间,可解释为输入属于某个特定类别的概率。
Tanh(双曲正切)激活
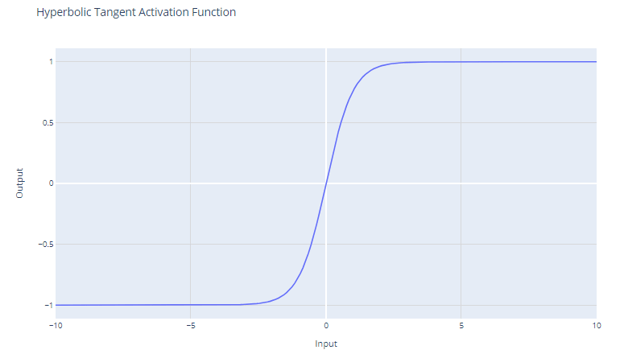
Tanh 激活函数。作者制图
Tanh(双曲正切)激活函数定义为:
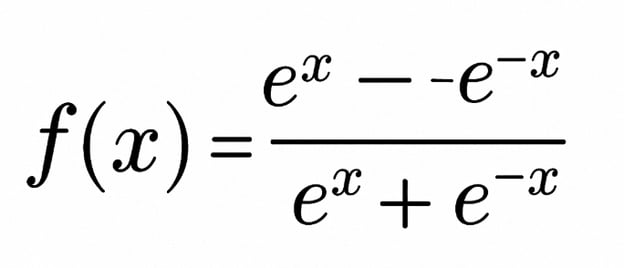
Tanh 的输出范围为 -1 到 +1。这意味着它比输出范围为 0 到 1 的 Sigmoid 更能有效处理负值。
与 Sigmoid 不同,Tanh 以 0 为中心,即其输出围绕坐标原点对称。这通常被视为优势,因为有助于学习算法更快收敛。
由于 Tanh 的输出在 -1 到 +1 之间,相比 Sigmoid,它的梯度更强。更强的梯度通常会带来更快的学习速度和更好的收敛性,因为与 Sigmoid 的梯度相比,它更不易遭遇梯度消失问题。
尽管有这些优势,Tanh 仍然会受到梯度消失问题的影响。反向传播时,Tanh 的梯度可能变得非常小(接近 0)。这一问题在层数较多的深层网络中尤为明显:损失函数的梯度在回传到初始层时可能过小,无法对权重产生显著更新。这会极大地拖慢训练过程,并导致较差的收敛特性。
Tanh 常用于神经网络的隐藏层。由于其以 0 为中心的特性,当数据也被标准化为均值为 0 时,往往能带来更高效的训练。
在没有特殊偏好的情况下,需要在 Sigmoid 与 Tanh 之间二选一时,基于上述原因,通常 Tanh 是更好的选择。不过,最终决策也会受到具体用例以及网络在初始实验中的表现影响。
您可以按照我们的教程,用 PyTorch 从零搭建一个简单的神经网络(作者:Kurtis Pykes);或者如果您是高级用户,可以学习我们的《用 PyTorch 进行深度学习》课程。
ReLU(修正线性单元)激活
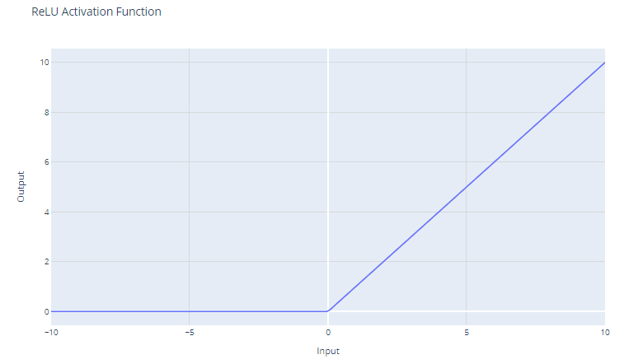
修正线性单元(ReLU)激活函数。 作者制图
修正线性单元(ReLU)激活函数的形式为:
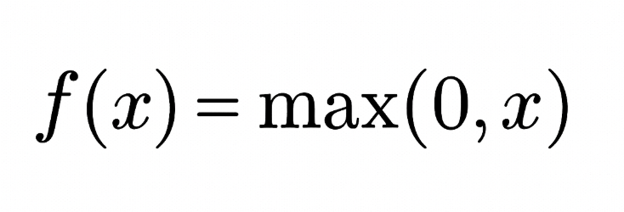
它在 0 处设定阈值:对负值输出 0,对正值则原样输出输入值。
当输入大于 0 时,ReLU 表现为梯度为 1 的线性函数。这意味着它不改变正输入的尺度,并允许梯度在反向传播时不变形地通过。这个特性对于缓解梯度消失问题至关重要。
尽管 ReLU 在其一半的输入空间上是线性的,但从技术上讲它是非线性函数,因为在 x=0 处不可导,函数值出现突变。这种非线性使得神经网络能够学习复杂模式。
由于 ReLU 对所有负输入输出为 0,自然会导致稀疏激活;任一时刻只有一部分神经元被激活,从而提升计算效率。
ReLU 的计算成本很低,因为它只需在 0 处做简单阈值运算。与 Tanh 或 Sigmoid 等更复杂函数相比,这使网络可以扩展到许多层而不会显著增加计算负担。
Softmax 激活
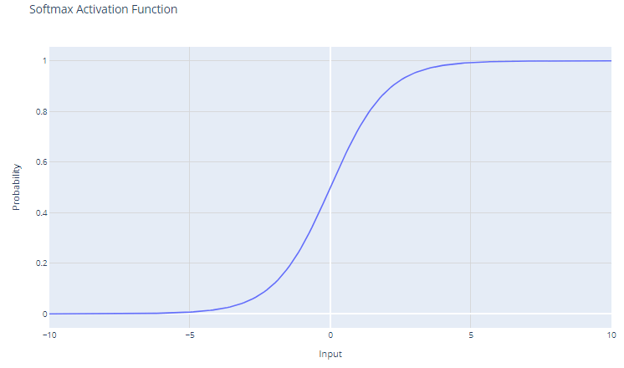
Softmax 激活函数。作者制图
Softmax 激活函数也称为归一化指数函数,尤其适用于多类别分类问题。该函数作用于一个向量(常称为 logits),该向量表示神经网络前面各层为每个类别计算得到的原始预测或分数。
对于元素为 x1、x2、...、xC 的输入向量 x,Softmax 定义为:
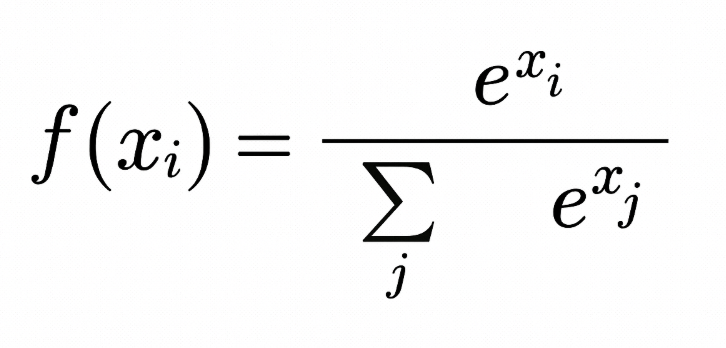
Softmax 的输出是一个概率分布,其各元素之和为1。输出向量的每个元素表示输入属于某一特定类别的概率。
指数函数的使用确保所有输出均为非负数。这一点至关重要,因为概率不能为负。
Softmax 会放大输入向量中的差异。即便输入值差异很小,也可能导致输出概率出现显著差别,其中较大的输入值往往会在最终概率分布中占据主导地位。
当任务需要将输入归类到多个(超过两个)可能类别之一时(多类别分类),Softmax 通常用于神经网络的输出层。
Softmax 产生的概率可视为各类别的置信度分数,帮助我们了解模型对其预测的确定程度。
由于 Softmax 会放大差异,它对离群点或极端值可能较为敏感。例如,如果输入向量存在一个非常大的值,Softmax 可能会“挤压”其他类别的概率,导致模型过于自信。
如何选择合适的激活函数
激活函数的选择取决于您要解决的问题类型。以下是一些指南:
对于二元分类
在输出层使用 Sigmoid 激活函数。它会将输出压缩到 0 到 1 之间,表示两个类别的概率。
对于多类别分类
在输出层使用 Softmax 激活函数。它会输出所有类别上的概率分布。
如果不确定
在隐藏层使用 ReLU 激活函数。ReLU 是最常见的默认选择,通常表现良好。
结语
我们探讨了激活函数在神经网络训练中的关键作用。它们并非可有可无的附加项,而是使神经网络能够捕捉并建模现实数据复杂性的核心要素。从简单而有效的 ReLU,到可提供概率解释的 Softmax,不同激活函数在网络的不同层及各类问题领域各有其位置与用途。
随着神经网络的不断演进,关于激活函数的探索无疑也会扩展,或将出现新的形式来应对新兴架构的特定挑战。然而,本文讨论的原则与函数在可预见的未来仍可能是神经网络设计的核心。
对激活函数的精心选择是一种平衡之道——既依赖科学理解,也仰赖经验直觉——并会显著影响神经网络的性能。
想用 Keras 框架学习深度学习?欢迎查看我们的《Keras 深度学习入门》课程。


神经网络示意图。图片来源
什么是激活函数?
激活函数是神经网络的关键构件,帮助其学习数据中的复杂模式。它将神经网络中某个节点的输入信号转换为输出信号,再传递到下一层。如果没有激活函数,神经网络将只能拟合输入与输出之间的线性关系。
激活函数引入非线性,使神经网络能够学习输入与输出之间高度复杂的映射关系。
选择合适的激活函数对于训练具有良好泛化能力并能给出准确预测的神经网络至关重要。本文将概述最常见的激活函数、它们的作用,以及如何针对不同用例选择合适的激活函数。
无论您刚开始学习深度学习,还是已是经验丰富的实践者,深入理解激活函数都将有助于建立直觉并提升您对神经网络的应用能力。
为什么激活函数必不可少?
如果没有激活函数,神经网络就只包含诸如矩阵乘法之类的线性运算。所有层都只是对输入做线性变换,不会引入任何非线性。
大多数现实世界的数据都是非线性的。例如,房价与面积、收入与消费等之间的关系并非线性。如果神经网络没有激活函数,就无法学习现实数据中存在的复杂非线性模式。
激活函数通过引入非线性行为,使神经网络能够学习这些非线性关系。这大大提升了神经网络对复杂细微数据进行建模的灵活性与能力。
激活函数的类型
神经网络会利用多种激活函数来引入非线性并学习复杂模式。每种激活函数都有其独特性质,适用于特定用例。
例如,sigmoid 适合二元分类问题,softmax 适合多类别预测,而 ReLU 有助于缓解梯度消失问题。
针对任务使用正确的激活函数可带来更快的训练速度和更好的性能。
下面来看一些常见的激活函数:
线性激活
线性激活函数。作者制图
线性激活函数是最简单的一类,定义为:
它直接将输入 x 原样输出。从图形上看,就是斜率为 1 的直线。
线性激活函数的主要用例是在用于回归的神经网络的输出层。对于希望预测数值的回归问题,在输出层使用线性激活函数可确保网络输出一个数值。由于线性激活不会压缩或变换输出,因此会返回真实的预测值。
不过,线性激活函数很少用于神经网络的隐藏层,因为它不提供任何非线性。而隐藏层的意义就在于学习输入特征的非线性组合。若始终使用线性激活,模型只能学习对输入的线性变换。
Sigmoid 激活
Sigmoid 激活函数。作者制图
Sigmoid 激活函数通常记作 σ(x),是一种平滑、处处可导的函数,在神经网络的发展史上具有重要地位。Sigmoid 激活函数的数学形式为:
它将实数输入压缩到 0 到 1 之间。Sigmoid 的曲线呈“S”形,对于很大的负数趋近于 0,对于很大的正数趋近于 1。其输出易于解释为概率,因此非常适合二元分类问题。
早期神经网络中 Sigmoid 单元很流行,因为当单元输出接近 0.5 时梯度最强,有利于高效的反向传播训练。然而,Sigmoid 单元会遭遇“梯度消失”问题,从而阻碍深层网络的学习。
当输入值显著为正或为负时,函数在 0 或 1 处饱和,曲线斜率极其平缓。在这些区域,梯度非常接近于零。这会导致反向传播时权重更新幅度极小,尤其是深层网络早期层的神经元,使得学习过程极其缓慢,甚至停滞。这就是神经网络中的梯度消失问题。
Sigmoid 的主要用例是作为二元分类模型输出层的激活函数。它将输出压缩到 0 到 1 之间,可解释为输入属于某个特定类别的概率。
Tanh(双曲正切)激活
Tanh 激活函数。作者制图
Tanh(双曲正切)激活函数定义为:
Tanh 的输出范围为 -1 到 +1。这意味着它比输出范围为 0 到 1 的 Sigmoid 更能有效处理负值。
与 Sigmoid 不同,Tanh 以 0 为中心,即其输出围绕坐标原点对称。这通常被视为优势,因为有助于学习算法更快收敛。
由于 Tanh 的输出在 -1 到 +1 之间,相比 Sigmoid,它的梯度更强。更强的梯度通常会带来更快的学习速度和更好的收敛性,因为与 Sigmoid 的梯度相比,它更不易遭遇梯度消失问题。
尽管有这些优势,Tanh 仍然会受到梯度消失问题的影响。反向传播时,Tanh 的梯度可能变得非常小(接近 0)。这一问题在层数较多的深层网络中尤为明显:损失函数的梯度在回传到初始层时可能过小,无法对权重产生显著更新。这会极大地拖慢训练过程,并导致较差的收敛特性。
Tanh 常用于神经网络的隐藏层。由于其以 0 为中心的特性,当数据也被标准化为均值为 0 时,往往能带来更高效的训练。
在没有特殊偏好的情况下,需要在 Sigmoid 与 Tanh 之间二选一时,基于上述原因,通常 Tanh 是更好的选择。不过,最终决策也会受到具体用例以及网络在初始实验中的表现影响。
您可以按照我们的教程,用 PyTorch 从零搭建一个简单的神经网络(作者:Kurtis Pykes);或者如果您是高级用户,可以学习我们的《用 PyTorch 进行深度学习》课程。
ReLU(修正线性单元)激活
修正线性单元(ReLU)激活函数。 作者制图
修正线性单元(ReLU)激活函数的形式为:
它在 0 处设定阈值:对负值输出 0,对正值则原样输出输入值。
当输入大于 0 时,ReLU 表现为梯度为 1 的线性函数。这意味着它不改变正输入的尺度,并允许梯度在反向传播时不变形地通过。这个特性对于缓解梯度消失问题至关重要。
尽管 ReLU 在其一半的输入空间上是线性的,但从技术上讲它是非线性函数,因为在 x=0 处不可导,函数值出现突变。这种非线性使得神经网络能够学习复杂模式。
由于 ReLU 对所有负输入输出为 0,自然会导致稀疏激活;任一时刻只有一部分神经元被激活,从而提升计算效率。
ReLU 的计算成本很低,因为它只需在 0 处做简单阈值运算。与 Tanh 或 Sigmoid 等更复杂函数相比,这使网络可以扩展到许多层而不会显著增加计算负担。
Softmax 激活
Softmax 激活函数。作者制图
Softmax 激活函数也称为归一化指数函数,尤其适用于多类别分类问题。该函数作用于一个向量(常称为 logits),该向量表示神经网络前面各层为每个类别计算得到的原始预测或分数。
对于元素为 x1、x2、...、xC 的输入向量 x,Softmax 定义为:
Softmax 的输出是一个概率分布,其各元素之和为1。输出向量的每个元素表示输入属于某一特定类别的概率。
指数函数的使用确保所有输出均为非负数。这一点至关重要,因为概率不能为负。
Softmax 会放大输入向量中的差异。即便输入值差异很小,也可能导致输出概率出现显著差别,其中较大的输入值往往会在最终概率分布中占据主导地位。
当任务需要将输入归类到多个(超过两个)可能类别之一时(多类别分类),Softmax 通常用于神经网络的输出层。
Softmax 产生的概率可视为各类别的置信度分数,帮助我们了解模型对其预测的确定程度。
由于 Softmax 会放大差异,它对离群点或极端值可能较为敏感。例如,如果输入向量存在一个非常大的值,Softmax 可能会“挤压”其他类别的概率,导致模型过于自信。
如何选择合适的激活函数
激活函数的选择取决于您要解决的问题类型。以下是一些指南:
对于二元分类
在输出层使用 Sigmoid 激活函数。它会将输出压缩到 0 到 1 之间,表示两个类别的概率。
对于多类别分类
在输出层使用 Softmax 激活函数。它会输出所有类别上的概率分布。
如果不确定
在隐藏层使用 ReLU 激活函数。ReLU 是最常见的默认选择,通常表现良好。
结语
我们探讨了激活函数在神经网络训练中的关键作用。它们并非可有可无的附加项,而是使神经网络能够捕捉并建模现实数据复杂性的核心要素。从简单而有效的 ReLU,到可提供概率解释的 Softmax,不同激活函数在网络的不同层及各类问题领域各有其位置与用途。
随着神经网络的不断演进,关于激活函数的探索无疑也会扩展,或将出现新的形式来应对新兴架构的特定挑战。然而,本文讨论的原则与函数在可预见的未来仍可能是神经网络设计的核心。
对激活函数的精心选择是一种平衡之道——既依赖科学理解,也仰赖经验直觉——并会显著影响神经网络的性能。
想用 Keras 框架学习深度学习?欢迎查看我们的《Keras 深度学习入门》课程。