MongoDB 是一款广受欢迎的 NoSQL 数据库,强调灵活性与性能。不同于使用结构化表和 SQL 的传统关系型数据库,MongoDB 以灵活的、类 JSON 的文档来存储数据。这使其非常适合处理动态或半结构化数据的开发者。
在 MongoDB 中,您最重要的操作之一就是查询数据,其中使用最广泛的方法就是 find()。无论您刚刚入门还是希望提升查询技巧,理解 find() 的工作方式都对您高效导航和操作 MongoDB 数据至关重要。
想象一下,您正在浏览一个电影数据库。您想找到 2000 年之后上映的所有科幻片,或者列出某个时间段内用户发表的所有评论。这正是 find() 大显身手的场景。
在本文中,您将学习如何使用 find() 方法从集合中检索文档、应用过滤条件、投影字段、排序结果并优化性能——我们将基于 sample_mflix 数据集贯穿讲解。
若想实践式学习如何在数据科学工作流中使用 MongoDB,请查看 Introduction to MongoDB in Python 课程。
MongoDB 中的 find() 简介
find() 方法是 MongoDB 从集合中检索文档的主要方式。它会返回一个游标(cursor),指向符合条件的文档。之后您可以根据应用需求迭代该游标,或将其转换为数组。
完整语法如下:
db. collection. find ( < query> , < projection> , < options> ) 技术支持 参数
query(可选):用于定义筛选条件的文档。如果省略或传入空文档({}),find() 将返回集合中的所有文档。projection(可选):指定返回哪些字段的文档。可以包含(1)或排除(0)字段。默认情况下,MongoDB 返回所有字段,包括 _id。options(可选):用于配置查询行为的附加文档。可以设置排序、分页限制、超时和索引提示等。
示例
为使概念尽可能清晰并可落地,我们将使用MongoDB Atlas 示例数据集 ——具体是 sample_mflix 数据库。该数据集包含 movies、comments、users 和 theaters 等集合,我们将贯穿全文引用它们进行演示。
db. books. find (
{ year : { $gte : 2000 } } ,
{ title : 1 , author : 1 , _id : 0 } ,
{ sort : { title : 1 } , limit : 5 }
) 技术支持 该查询会:
筛选出版年份在 2000 年及以后的书籍。
仅返回 title 和 author 字段(排除 _id)。
按标题字母顺序(A–Z)排序结果。
将输出限制为前 5 本符合条件的书籍。
图 1。 该查询查找 2000 年后上映的电影,按标题排序并限制为 5 条结果。
结果是一个游标,它会在您迭代时按需惰性加载匹配的文档。您可以使用 .toArray() 或 .forEach() 来处理结果。
如果您通过 MongoDB shell(mongosh)连接且未将结果赋值给变量,默认只会显示前 20 个文档。要查看更多文档,请继续按回车。这一过程会从游标中获取下一批数据。
> 注意:上述是 shell 特有的行为,并非 MongoDB 的限制。在大多数 MongoDB 驱动(如 Node.js、Python、Java)中,调用 .toArray() 或迭代游标会自动获取所有匹配结果。游标行为可能因环境和语言而异。
图 2。 该查询检索所有电影,仅返回 _id 字段,并通过游标获取更多结果。
如果您是 NoSQL 新手, Introduction to NoSQL 课程提供了与本教程互补的基础概念。
编写您的第一个查询
继续电影示例,假设您想获取所有科幻(Sci-Fi)类型的电影。可以这样做:
db. movies. find ( { genres : "Sci-Fi" } ) 技术支持 现在,您只想要 2000 年及以后上映的电影:
db. movies. find ( { year : { $gte : 2000 } } ) 技术支持 如果两者都要?将条件组合起来:
db. movies. find ( { genres : "Sci-Fi" , year : { $gte : 2000 } } ) 技术支持 或者,您也可以用 $and 显式写出:
db. movies. find ( { $and : [ { genres : "Sci-Fi" } , { year : { $gte : 2000 } } ] } ) 技术支持 两种查询返回相同结果——类型为 Sci-Fi 且上映年份为 2000 年及以后的文档。第一种形式更简洁,字段不同时更推荐使用。
图 3。 这些是编写同一查询的不同方式,都会产生相同结果。
将 find() 当作过滤漏斗——每个条件都在收缩结果范围。
使用比较与逻辑操作符
现在,让我们回顾如何使用比较与逻辑操作符,将查询提升到新层次。
比较操作符
$eq、$ne:等于、不等于$gt、$gte、$lt、$lte:大于/小于(或等于)$in、$nin:在数组中/不在数组中
设想您在跟踪客户订单,想要总额介于 100 美元到 500 美元之间的订单:
db. orders. find ( { total : { $gte : 100 , $lte : 500 } } ) 技术支持 逻辑操作符
现在,假设您想展示“Books”品类的产品,或价格低于 20 美元的产品。示例查询如下:
db. products. find ( { $or : [ { category : "Books" } , { price : { $lt : 20 } } ] } ) 技术支持 查询嵌套字段
您可以使用点号表示法访问嵌套字段:
db. customers. find ( { "address.city" : "Chicago" } ) 技术支持 投影字段
投影可以让您只返回所需内容,从而显著提升性能与可读性。
db. movies. find ( { } , { directors : 1 , languages : 1 , _id : 0 } ) 技术支持 重要提示:指定投影时,MongoDB 要求在两种模式中二选一:要么包含特定字段(1),要么排除特定字段(0)。不能在同一投影中混用两种风格,_id 字段除外,即使包含其他字段也可将其排除。
✅ 合法(仅包含):
db. movies. find ( { } , { directors : 1 , languages : 1 } ) 技术支持 ✅ 合法(仅排除):
db. movies. find ( { } , { directors : 0 , _id : 0 } ) 技术支持 ❌ 非法(混用包含与排除):
db. movies. find ( { } , { directors : 1 , languages : 0 } ) 技术支持 唯一的例外是 _id 字段,包含其他字段时也可将其排除:
db. movies. find ( { } , { directors : 1 , _id : 0 } ) 技术支持
图 4。 该示例展示了在单个投影中混用字段包含与排除所触发的报错,MongoDB 不允许这样做,除 _id 外。
排序、限制与跳过结果
处理大型数据集时,常见的做法是一次只向用户展示一部分数据——这称为分页。例如,流媒体应用可能每页显示 10 部电影,而不是一次性加载成千上万条。这样不仅提升性能,也能改善用户体验。
在 MongoDB 中,分页通常结合使用 sort()、limit() 和 skip() 来实现。
SQL 与 MongoDB:基础对比
如果您有 SQL 背景,以下是常见分页概念的对应关系:
SQL 中的基础查询:
SELECT * FROM movies WHERE year >= 2000 技术支持 在 MongoDB 中可表示为:
db. movies. find ( { year : { $gte : 2000 } } ) 技术支持 SQL 中的字段选择:
SELECT title, year FROM movies技术支持 MongoDB 中的字段选择:
db. movies. find ( { } , { title : 1 , year : 1 , _id : 0 } ) 技术支持 现在,再看一些常见查询操作:
排序:
SQL:ORDER BY title ASC
MongoDB:.sort({ title: 1 })
限制:
SQL:LIMIT 10 MongoDB:.limit(10)
跳过:
SQL:OFFSET 10 MongoDB:.skip(10)
理解这些对应关系,有助于 SQL 用户更顺畅地过渡到 MongoDB 的文档式查询体系。
排序结果
排序可帮助您按某个字段组织结果——例如,按电影标题的字母顺序排序:
db. movies. find ( ) . sort ( { title : 1 } ) 技术支持
1 表示升序(A–Z,0–9)-1 表示降序(Z–A,9–0)
限制结果
仅返回一定数量的结果——例如前 10 条:
db. movies. find ( ) . limit ( 10 ) 技术支持 这在实现“Top 10”列表或初始视图时很有用。
跳过结果
用于跳过若干文档。通常与 limit() 搭配用于分页:
db. movies. find ( ) . skip ( 10 ) . limit ( 10 ) 技术支持 这会跳过前 10 条文档并返回接下来的 10 条,相当于在 pageSize = 10 时显示第 2 页。
分页公式:
skip = ( pageNumber - 1 ) * pageSize技术支持 > 注意:对于深度分页(如 skip(10000)),skip() 可能效率较低,因为 MongoDB 仍需扫描并丢弃被跳过的文档。对于大型数据集,更好的做法是基于已建立索引的字段(如 _id)进行区间分页。
组合示例:第 3 页,每页 10 条,按标题排序
db. movies. find ( )
. sort ( { title : 1 } )
. skip ( 20 )
. limit ( 10 ) 技术支持 该模式同样适用于“加载更多”或无限滚动等功能。
图 5。 该查询获取第 3 页的结果(每页 10 部电影),并按标题排序。
使用游标
find() 方法返回一个游标——指向结果集的指针。您可以对其进行迭代:
const cursor = db. movies. find ( { type : "movie" } ) ;
cursor. forEach ( doc => print ( doc. name) ) ; 技术支持 或者将其转换为数组:
const results = db. collection. find ( ) . toArray ( ) ; 技术支持
图 6。 调用 find() 后,您会得到一个游标。您可以用它迭代文档,或将整个结果集转换为数组。
> 注意:游标对象可在 mongosh 或各语言驱动(如 Node.js、Python)中使用。像 MongoDB Compass 这样的图形化工具会在内部处理游标,您不会直接访问或迭代它们。
高级游标选项
为更精细地调整查询,您可以使用其他游标方法:
db. users. find ( { age : { $gte : 30 } } )
. sort ( { name : 1 } )
. limit ( 10 )
. skip ( 5 )
. maxTimeMS ( 200 )
. hint ( { age : 1 } ) 技术支持
maxTimeMS(ms):若查询耗时过长则中止 hint():强制 MongoDB 使用特定索引 batchSize(n):控制每批次返回的文档数量
在准备面试?不妨看看 Top 25 MongoDB Interview Questions and Answers ,检验您对 find() 等核心概念的理解。
索引与性能优化
索引就像“速查表”——它们能帮助 MongoDB 更快地检索文档。
创建索引
db. movies. createIndex ( { type : 1 } ) 技术支持 使用 .explain()
db. users. find ( { type : "movie" } ) . explain ( ) 技术支持 这可以显示是否使用了索引,以及查询效率如何。
未使用索引:
图 7。 在建立索引前,对查询运行 explain()。
创建索引:
图 8 。在 type 字段上创建一个简单索引。
使用索引后:
图 9。 在使用索引的情况下,对同一查询运行 explain()。
您会看到,此前的 CollScan(全表扫描)阶段变为 Fetch + IXSCAN,这基本上表示利用了索引并同时查找不在索引中的其他数据(因为我们返回的是全部内容)。
使用 MongoDB Compass 可视化查询
如果您更偏好可视化工具,MongoDB Compass 是官方 GUI 客户端。它可以:
通过筛选器可视化构建查询。
预览文档与索引。
优化并验证查询性能。
您甚至可以切换到“JSON 视图”,将查询复制/粘贴到代码中。
使用 Atlas + AI 生成查询
如果您使用的是 MongoDB Atlas ,可以借助 Atlas Search 与 AI 驱动的查询生成器。
只需输入类似这样的自然语言提示:
“展示上个月来自巴西且下单金额超过 100 美元的所有客户。”
Atlas 会基于 find() 或 $search 给出相应的 MongoDB 查询建议。尤其在您不确定语法时,这能极大提升效率。
图 10。 使用 Compass 通过自然语言生成查询。
常见陷阱与规避方法
在未索引字段上查询 → 会导致性能缓慢 结果集过大 → 使用分页(limit + skip) 低效投影 → 始终只投影必要字段 类型不匹配 → 确保字段类型一致(如数字 vs. 字符串) 在投影中混用包含与排除 → 不允许,_id 除外
对比 MongoDB find() 与 SQL
如果您来自 SQL 背景,了解 MongoDB 的 find() 如何对应熟悉的 SQL 查询将有助于更容易过渡。以下是常见操作的 一般对比:
概念
SQL 示例
MongoDB 对应
基础查询
SELECT * FROM users WHERE age >= 18
db.users.find({ age: { $gte: 18 } })
字段选择
SELECT name, email FROM users
db.users.find({}, { name: 1, email: 1, _id: 0 })
排序
ORDER BY created_at DESC
.sort({ createdAt: -1 })
限制
LIMIT 10
.limit(10)
跳过
OFFSET 10
.skip(10)
如您所见,MongoDB 的语法更偏向 JavaScript 风格,并以 JSON 形式更具表达力,而 SQL 则更偏声明式与结构化。了解这些对应关系将帮助您更快上手 MongoDB。
总结与最佳实践
将 find() 当作数据过滤器——组合条件以获得精确结果。 始终只投影必要字段,以提升清晰度与性能。 使用索引以避免慢速扫描。 若偏好可视化反馈与更快迭代,请使用 Compass。 利用 MongoDB Atlas 的 AI 助手更快生成查询。 探索高级游标选项,以细粒度控制结果。
无论您是在构建创业项目的仪表盘、数据分析工具,还是电商后端,掌握 find() 都将让您的 MongoDB 体验更顺畅、更高效。
敬请期待后续更多 MongoDB 深入解读!
想要验证您的 MongoDB 技能? 阅读 Complete Guide to MongoDB Certification ,探索可选路径。


MongoDB 是一款广受欢迎的 NoSQL 数据库,强调灵活性与性能。不同于使用结构化表和 SQL 的传统关系型数据库,MongoDB 以灵活的、类 JSON 的文档来存储数据。这使其非常适合处理动态或半结构化数据的开发者。
在 MongoDB 中,您最重要的操作之一就是查询数据,其中使用最广泛的方法就是
find()。无论您刚刚入门还是希望提升查询技巧,理解find()的工作方式都对您高效导航和操作 MongoDB 数据至关重要。想象一下,您正在浏览一个电影数据库。您想找到 2000 年之后上映的所有科幻片,或者列出某个时间段内用户发表的所有评论。这正是
find()大显身手的场景。在本文中,您将学习如何使用
find()方法从集合中检索文档、应用过滤条件、投影字段、排序结果并优化性能——我们将基于sample_mflix数据集贯穿讲解。若想实践式学习如何在数据科学工作流中使用 MongoDB,请查看 Introduction to MongoDB in Python 课程。
MongoDB 中的 find() 简介
find()方法是 MongoDB 从集合中检索文档的主要方式。它会返回一个游标(cursor),指向符合条件的文档。之后您可以根据应用需求迭代该游标,或将其转换为数组。完整语法如下:
参数
query(可选):用于定义筛选条件的文档。如果省略或传入空文档({}),find()将返回集合中的所有文档。projection(可选):指定返回哪些字段的文档。可以包含(1)或排除(0)字段。默认情况下,MongoDB 返回所有字段,包括_id。options(可选):用于配置查询行为的附加文档。可以设置排序、分页限制、超时和索引提示等。示例
为使概念尽可能清晰并可落地,我们将使用MongoDB Atlas 示例数据集——具体是
sample_mflix数据库。该数据集包含 movies、comments、users 和 theaters 等集合,我们将贯穿全文引用它们进行演示。该查询会:
_id)。图 1。 该查询查找 2000 年后上映的电影,按标题排序并限制为 5 条结果。
结果是一个游标,它会在您迭代时按需惰性加载匹配的文档。您可以使用
.toArray()或.forEach()来处理结果。如果您通过 MongoDB shell(
mongosh)连接且未将结果赋值给变量,默认只会显示前 20 个文档。要查看更多文档,请继续按回车。这一过程会从游标中获取下一批数据。> 注意:上述是 shell 特有的行为,并非 MongoDB 的限制。在大多数 MongoDB 驱动(如 Node.js、Python、Java)中,调用
.toArray()或迭代游标会自动获取所有匹配结果。游标行为可能因环境和语言而异。图 2。 该查询检索所有电影,仅返回
_id字段,并通过游标获取更多结果。如果您是 NoSQL 新手, Introduction to NoSQL 课程提供了与本教程互补的基础概念。
编写您的第一个查询
继续电影示例,假设您想获取所有科幻(Sci-Fi)类型的电影。可以这样做:
现在,您只想要 2000 年及以后上映的电影:
如果两者都要?将条件组合起来:
或者,您也可以用
$and显式写出:两种查询返回相同结果——类型为 Sci-Fi 且上映年份为 2000 年及以后的文档。第一种形式更简洁,字段不同时更推荐使用。
图 3。 这些是编写同一查询的不同方式,都会产生相同结果。
将
find()当作过滤漏斗——每个条件都在收缩结果范围。使用比较与逻辑操作符
现在,让我们回顾如何使用比较与逻辑操作符,将查询提升到新层次。
比较操作符
$eq、$ne:等于、不等于$gt、$gte、$lt、$lte:大于/小于(或等于)$in、$nin:在数组中/不在数组中设想您在跟踪客户订单,想要总额介于 100 美元到 500 美元之间的订单:
逻辑操作符
$and、$or、$nor、$not现在,假设您想展示“Books”品类的产品,或价格低于 20 美元的产品。示例查询如下:
查询嵌套字段
您可以使用点号表示法访问嵌套字段:
投影字段
投影可以让您只返回所需内容,从而显著提升性能与可读性。
重要提示:指定投影时,MongoDB 要求在两种模式中二选一:要么包含特定字段(1),要么排除特定字段(0)。不能在同一投影中混用两种风格,
_id字段除外,即使包含其他字段也可将其排除。✅ 合法(仅包含):
✅ 合法(仅排除):
❌ 非法(混用包含与排除):
唯一的例外是
_id字段,包含其他字段时也可将其排除:图 4。 该示例展示了在单个投影中混用字段包含与排除所触发的报错,MongoDB 不允许这样做,除
_id外。排序、限制与跳过结果
处理大型数据集时,常见的做法是一次只向用户展示一部分数据——这称为分页。例如,流媒体应用可能每页显示 10 部电影,而不是一次性加载成千上万条。这样不仅提升性能,也能改善用户体验。
在 MongoDB 中,分页通常结合使用
sort()、limit()和skip()来实现。SQL 与 MongoDB:基础对比
如果您有 SQL 背景,以下是常见分页概念的对应关系:
SQL 中的基础查询:
在 MongoDB 中可表示为:
SQL 中的字段选择:
MongoDB 中的字段选择:
现在,再看一些常见查询操作:
排序:
ORDER BY title ASC.sort({ title: 1 })限制:
LIMIT 10.limit(10)跳过:
OFFSET 10.skip(10)理解这些对应关系,有助于 SQL 用户更顺畅地过渡到 MongoDB 的文档式查询体系。
排序结果
排序可帮助您按某个字段组织结果——例如,按电影标题的字母顺序排序:
1表示升序(A–Z,0–9)-1表示降序(Z–A,9–0)限制结果
仅返回一定数量的结果——例如前 10 条:
这在实现“Top 10”列表或初始视图时很有用。
跳过结果
用于跳过若干文档。通常与 limit() 搭配用于分页:
这会跳过前 10 条文档并返回接下来的 10 条,相当于在 pageSize = 10 时显示第 2 页。
分页公式:
> 注意:对于深度分页(如
skip(10000)),skip()可能效率较低,因为 MongoDB 仍需扫描并丢弃被跳过的文档。对于大型数据集,更好的做法是基于已建立索引的字段(如_id)进行区间分页。组合示例:第 3 页,每页 10 条,按标题排序
该模式同样适用于“加载更多”或无限滚动等功能。
图 5。 该查询获取第 3 页的结果(每页 10 部电影),并按标题排序。
使用游标
find()方法返回一个游标——指向结果集的指针。您可以对其进行迭代:或者将其转换为数组:
图 6。 调用
find()后,您会得到一个游标。您可以用它迭代文档,或将整个结果集转换为数组。> 注意:游标对象可在
mongosh或各语言驱动(如 Node.js、Python)中使用。像 MongoDB Compass 这样的图形化工具会在内部处理游标,您不会直接访问或迭代它们。高级游标选项
为更精细地调整查询,您可以使用其他游标方法:
maxTimeMS(ms):若查询耗时过长则中止hint():强制 MongoDB 使用特定索引batchSize(n):控制每批次返回的文档数量在准备面试?不妨看看 Top 25 MongoDB Interview Questions and Answers,检验您对
find()等核心概念的理解。索引与性能优化
索引就像“速查表”——它们能帮助 MongoDB 更快地检索文档。
创建索引
使用 .explain()
这可以显示是否使用了索引,以及查询效率如何。
未使用索引: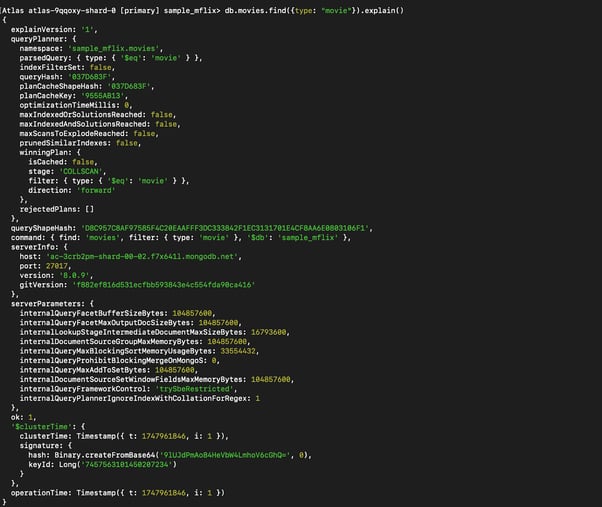
图 7。 在建立索引前,对查询运行
explain()。创建索引:
图 8。在 type 字段上创建一个简单索引。
使用索引后:
图 9。 在使用索引的情况下,对同一查询运行
explain()。您会看到,此前的
CollScan(全表扫描)阶段变为Fetch + IXSCAN,这基本上表示利用了索引并同时查找不在索引中的其他数据(因为我们返回的是全部内容)。使用 MongoDB Compass 可视化查询
如果您更偏好可视化工具,MongoDB Compass 是官方 GUI 客户端。它可以:
您甚至可以切换到“JSON 视图”,将查询复制/粘贴到代码中。
使用 Atlas + AI 生成查询
如果您使用的是 MongoDB Atlas,可以借助 Atlas Search 与 AI 驱动的查询生成器。
只需输入类似这样的自然语言提示:
“展示上个月来自巴西且下单金额超过 100 美元的所有客户。”
Atlas 会基于
find()或$search给出相应的 MongoDB 查询建议。尤其在您不确定语法时,这能极大提升效率。图 10。 使用 Compass 通过自然语言生成查询。
常见陷阱与规避方法
limit+skip)_id除外对比 MongoDB find() 与 SQL
如果您来自 SQL 背景,了解 MongoDB 的
find()如何对应熟悉的 SQL 查询将有助于更容易过渡。以下是常见操作的一般对比:概念
SQL 示例
MongoDB 对应
基础查询
SELECT * FROM users WHERE age >= 18db.users.find({ age: { $gte: 18 } })字段选择
SELECT name, email FROM usersdb.users.find({}, { name: 1, email: 1, _id: 0 })排序
ORDER BY created_at DESC.sort({ createdAt: -1 })限制
LIMIT 10.limit(10)跳过
OFFSET 10.skip(10)如您所见,MongoDB 的语法更偏向 JavaScript 风格,并以 JSON 形式更具表达力,而 SQL 则更偏声明式与结构化。了解这些对应关系将帮助您更快上手 MongoDB。
总结与最佳实践
find()当作数据过滤器——组合条件以获得精确结果。无论您是在构建创业项目的仪表盘、数据分析工具,还是电商后端,掌握
find()都将让您的 MongoDB 体验更顺畅、更高效。敬请期待后续更多 MongoDB 深入解读!
想要验证您的 MongoDB 技能? 阅读 Complete Guide to MongoDB Certification,探索可选路径。