Last chance! 50% off DataCamp Premium
Sale ends in
MongoDB, esneklik ve performans için tasarlanmış popüler bir NoSQL veritabanıdır. Yapılandırılmış tablolar ve SQL kullanan geleneksel ilişkisel veritabanlarının aksine, MongoDB verileri esnek, JSON benzeri dökümanlarda saklar. Bu da onu dinamik veya yarı yapılandırılmış verilerle çalışan geliştiriciler için ideal kılar.
MongoDB’de en önemli işlemlerden biri veri sorgulamadır ve bunun için en yaygın kullanılan yöntem find()’dır. İster yeni başlıyor olun ister sorgu becerilerinizi geliştirmek isteyin, find()’ın nasıl çalıştığını anlamak MongoDB verinizi etkili biçimde gezmek ve yönetmek için kritik önemdedir.
Bir film veritabanını keşfettiğinizi hayal edin. 2000 yılından sonra vizyona giren tüm bilim kurgu filmlerini bulmak ya da belirli bir zaman aralığında yapılan tüm kullanıcı yorumlarını listelemek istiyorsunuz. İşte find() burada parlıyor.
Bu yazıda, bir koleksiyondan dökümanları çekmek, filtre uygulamak, alan projeksiyonu yapmak, sonuçları sıralamak ve performansı optimize etmek için find() yöntemini nasıl kullanacağınızı—hepsini sample_mflix veri kümesiyle çalışırken—öğreneceksiniz.
MongoDB’yi veri bilimi iş akışlarında uygulamalı olarak görmek için Python ile MongoDB’ye Giriş kursuna göz atın.
find() yöntemi, MongoDB’nin bir koleksiyondan dökümanları getirmek için birincil yoludur. Belirtilen sorguyla eşleşen dökümanlara işaret eden bir imleç (cursor) döndürür. Uygulamanızın ihtiyaçlarına göre bu imleci üzerinde yineleyebilir veya bir diziye dönüştürebilirsiniz.
Tam sözdizimi şöyledir:
db.collection.find(<query>, <projection>, <options>)query (opsiyonel): Dökümanları seçme ölçütlerini tanımlayan bir döküman. Bu parametreyi atlar veya boş bir döküman ({}) gönderirseniz, find() koleksiyondaki tüm dökümanları döndürür.projection (opsiyonel): Hangi alanların döndürüleceğini belirleyen bir döküman. Alanları dahil edebilir (1) veya hariç tutabilirsiniz (0). Varsayılan olarak MongoDB tüm alanları, _id dahil, döndürür.options (opsiyonel): Sorgu davranışını yapılandırmak için ek bir döküman. Sıralama düzeni, sayfalama limitleri, zaman aşımları ve indeks ipuçları gibi ayarlar yapabilirsiniz.Kavramları olabildiğince açık ve uygulanabilir kılmak için MongoDB Atlas örnek veri kümesini—özellikle sample_mflix veritabanını—kullanacağız. Bu veri kümesi; filmler, yorumlar, kullanıcılar ve sinemalar gibi koleksiyonlar içerir ve her örneği göstermek için makale boyunca bunlara atıfta bulunacağız.
db.books.find(
  { year: { $gte: 2000 } },              // query: books published in or after 2000
  { title: 1, author: 1, _id: 0 },        // projection: include only title and author
  { sort: { title: 1 }, limit: 5 }       // options: sort by title, return only 5 books
)
Bu sorgu şunları yapar:
_id hariç tutulur).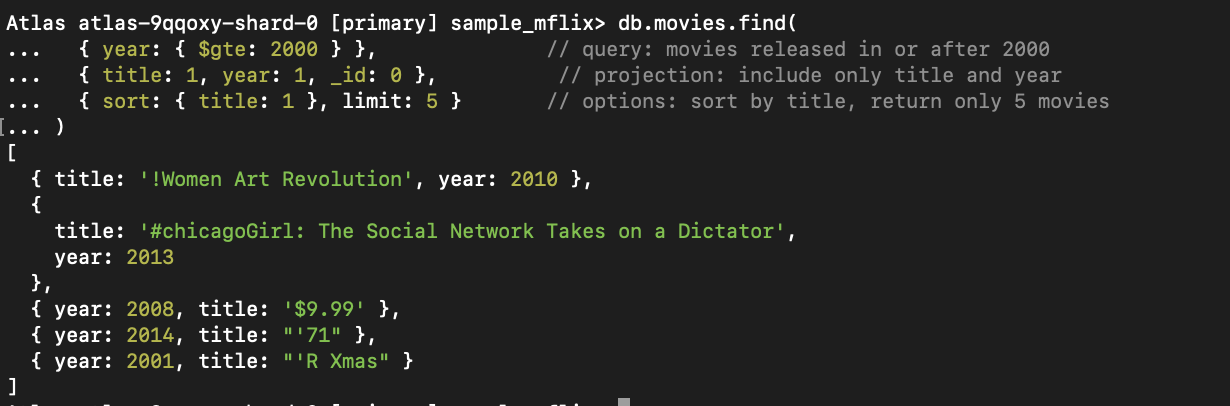
Şekil 1. Bu sorgu, 2000 sonrası vizyona giren filmleri başlığa göre sıralar ve beş sonuçla sınırlar.
Sonuç bir imleçtir; üzerinde yineledikçe eşleşen dökümanları tembel yükleme (lazy loading) ile getirir. Sonuçları işlemek için .toArray() veya .forEach() kullanabilirsiniz.
MongoDB kabuğuna (mongosh) bağlıysanız ve sonucu bir değişkene atamazsanız, varsayılan olarak yalnızca ilk 20 döküman görüntülenir. Ek dökümanları görmek için yazıp Enter’a basın. Bu işlem, imleçten bir sonraki partiyi getirmeye devam edecektir.
> Not: Yukarıdaki, MongoDB’nin bir kısıtı değil, kabuğa özgü bir davranıştır. Çoğu MongoDB sürücüsünde (ör. Node.js, Python, Java) .toArray() çağırmak veya imleç üzerinde yinelemek tüm eşleşen sonuçları otomatik olarak getirir. İmleç davranışı, kullandığınız ortama ve dile bağlı olarak değişebilir.
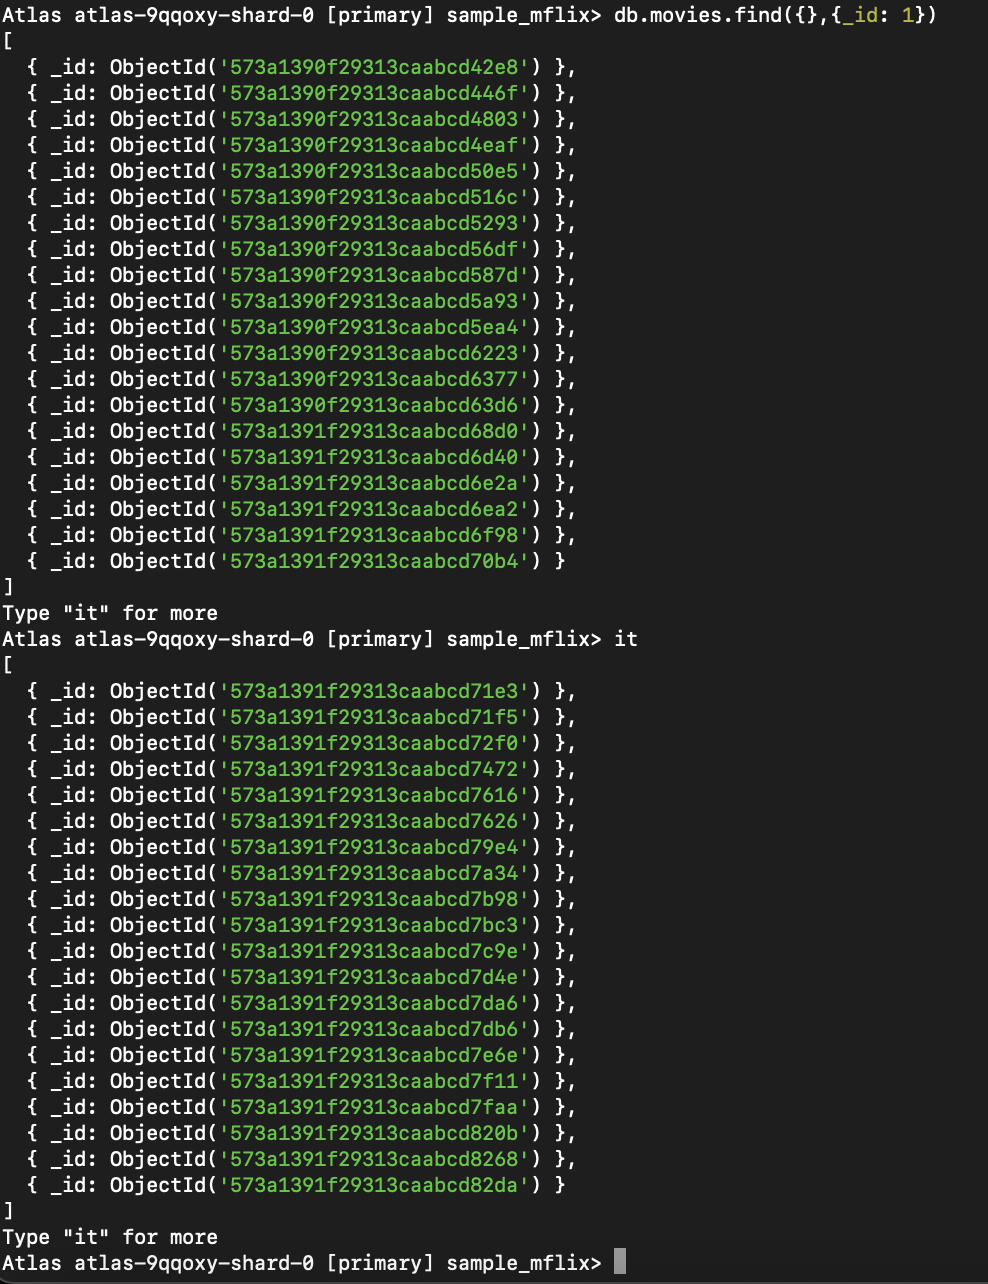
Şekil 2. Bu sorgu tüm filmleri getirir, yalnızca _id alanını döndürür ve ek sonuçları almak için imleci kullanır.
NoSQL veritabanlarına yeniyseniz, NoSQL’e Giriş kursu bu eğitimle uyumlu temel kavramlar sunar.
Film örneğiyle devam edelim; Bilim Kurgu türündeki tüm filmleri getirmek istediğinizi varsayalım. Bunu şöyle yaparsınız:
db.movies.find({ genres: "Sci-Fi" })Şimdi, yalnızca 2000 yılı ve sonrasında vizyona giren filmleri istiyorsunuz:
db.movies.find({ year: { $gte: 2000 } })Peki ikisini birden isterseniz? Koşulları birleştirin:
db.movies.find({ genres: "Sci-Fi", year: { $gte: 2000 } })Alternatif olarak, bunu $and kullanarak açıkça yazabilirsiniz:
db.movies.find({ $and: [ { genres: "Sci-Fi" }, { year: { $gte: 2000 } } ] })Her iki sorgu da aynı sonucu döndürür—türü Sci-Fi olan ve 2000 veya sonrasında vizyona giren filmler. Alanlar farklı olduğunda ilk biçim daha kısa ve tercih edilir.

Şekil 3. Aynı sonucu üreten sorguyu yazmanın farklı yolları.
find()’ı bir filtre hunisi gibi kullanın—her koşul sonuçlarınızı daraltır.
Şimdi sorgularınızı bir üst seviyeye taşımak için karşılaştırma ve mantıksal operatörleri nasıl kullanacağınızı gözden geçirelim.
$eq, $ne: eşit, eşit değil$gt, $gte, $lt, $lte: büyüktür/küçüktür (veya eşit)$in, $nin: dizide var/yokMüşteri siparişlerini takip ettiğinizi ve 100$ ile 500$ arasındaki siparişleri istediğinizi düşünün:
db.orders.find({ total: { $gte: 100, $lte: 500 } })$and, $or, $nor, $notŞimdi de “Books” kategorisindeki ya da fiyatı 20$’ın altında olan ürünleri göstermek istediğinizi düşünün. İşte örnek bir sorgu:
db.products.find({ $or: [ { category: "Books" }, { price: { $lt: 20 } } ] })Nokta gösterimini kullanarak iç içe alanlara erişebilirsiniz:
db.customers.find({ "address.city": "Chicago" })Projeksiyon, yalnızca ihtiyacınız olanları döndürmenizi sağlar; bu da performansı ve okunabilirliği önemli ölçüde iyileştirebilir.
db.movies.find({}, { directors: 1, languages: 1, _id: 0 })Önemli: Bir projeksiyon belirtirken MongoDB sizden iki moddan birini seçmenizi ister: Ya belirli alanları dahil edin (1) ya da belirli alanları hariç tutun (0). Aynı projeksiyonda iki stili karıştıramazsınız; yalnızca _id alanı bir istisnadır ve diğer alanları dahil ederken hariç tutulabilir.
✅ Geçerli (yalnızca dahil):
db.movies.find({}, { directors: 1, languages: 1 })✅ Geçerli (yalnızca hariç):
db.movies.find({}, { directors: 0, _id: 0 })❌ Geçersiz (dahil ve hariç karışık):
db.movies.find({}, { directors: 1, languages: 0 }) // Not allowedTek istisna, diğer alanları dahil ederken hariç tutabileceğiniz _id alanıdır:
db.movies.find({}, { directors: 1, _id: 0 }) // Allowed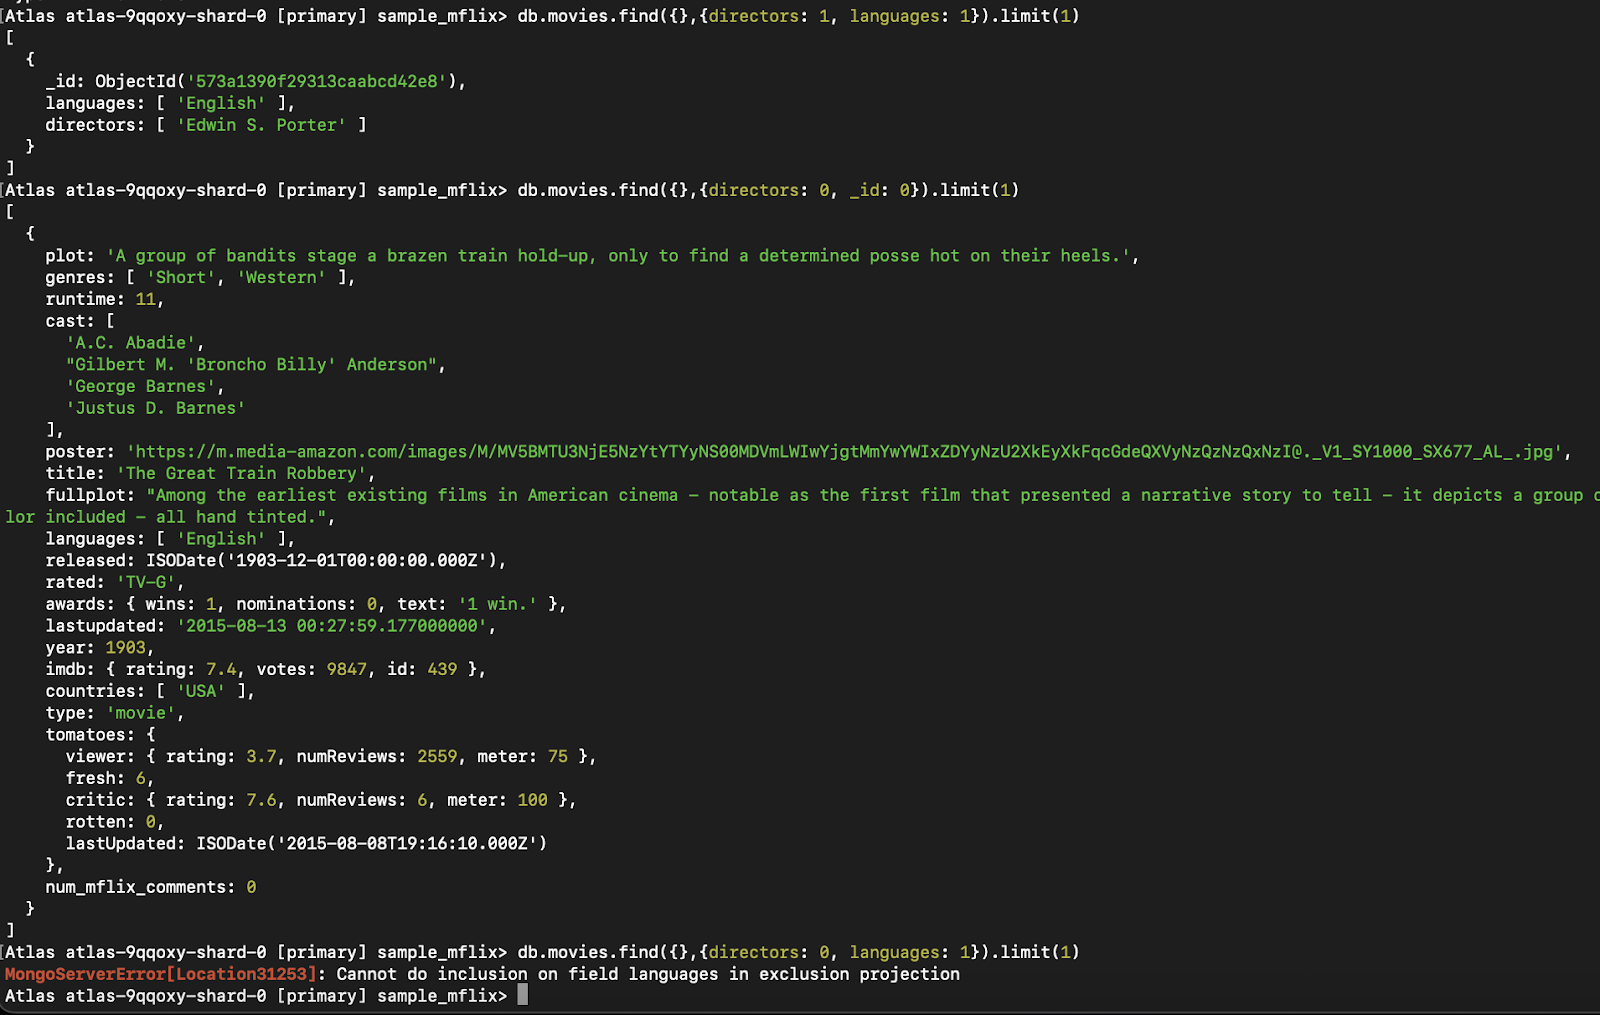
Şekil 4. Bu örnek, MongoDB’nin _id dışında tek bir projeksiyonda alan dahil etme ve hariç tutmayı karıştırmaya izin vermemesinin tetiklediği hatayı gösterir.
Büyük veri kümeleriyle çalışırken, kullanıcılara verinin yalnızca bir kısmını aynı anda göstermek yaygındır—sayfalama (pagination) olarak bilinen bir teknik. Örneğin bir yayın platformu, binlercesini bir kerede yüklemek yerine sayfa başına 10 film gösterebilir. Bu yalnızca performansı iyileştirmekle kalmaz, kullanıcı deneyimini de artırır.
MongoDB’de sayfalama, sort(), limit() ve skip() kombinasyonuyla gerçekleştirilir.
SQL geçmişiniz varsa, yaygın sayfalama kavramlarının nasıl karşılık geldiği şöyledir:
SQL’de temel sorgu:
SELECT * FROM movies WHERE year >= 2000Aynısı MongoDB’de şu şekilde ifade edilebilir:
db.movies.find({ year: { $gte: 2000 } })SQL’de alan seçimi:
SELECT title, year FROM moviesMongoDB’de alan seçimi:
db.movies.find({}, { title: 1, year: 1, _id: 0 })Şimdi, yaygın sorgu işlemlerine birkaç örnek daha bakalım:
Sıralama:
ORDER BY title ASC.sort({ title: 1 })Sınırlandırma:
LIMIT 10.limit(10)Atlama:
OFFSET 10.skip(10)Bu paralellikleri anlamak, SQL kullanıcılarının MongoDB’nin döküman tabanlı sorgu sistemine daha kolay geçiş yapmasına yardımcı olur.
Sıralama, sonuçlarınızı belirli bir alana göre düzenlemenize yardımcı olur—örneğin filmleri başlığa göre alfabetik olarak sıralamak için:
db.movies.find().sort({ title: 1 }) // ascending (A–Z)1 artan sıralama anlamına gelir (A-Z, 0-9)-1 azalan sıralama anlamına gelir (Z-A, 9-0)Yalnızca belirli sayıda sonuç döndürün—örneğin ilk 10’u:
db.movies.find().limit(10)Bu, “İlk 10” listeleri veya ilk görünümler için kullanışlıdır.
Dökümanları atlamak için kullanın. Genellikle sayfalama için limit() ile birlikte kullanılır:
db.movies.find().skip(10).limit(10)Bu, ilk 10 dökümanı atlar ve sonraki 10’u döndürür; sayfaBoyutu = 10 iken etkili biçimde Sayfa 2’yi gösterir.
Sayfalama formülü:
skip = (pageNumber - 1) * pageSize> Not: Derin sayfalama için skip() kullanmak (ör. skip(10000)) verimsiz olabilir; MongoDB yine de atlanan dökümanları tarar ve eler. Büyük veri kümelerinde daha iyi performans için, _id gibi indeksli alanları kullanarak aralık tabanlı sayfalamayı düşünün.
db.movies.find()
  .sort({ title: 1 })
  .skip(20)
  .limit(10)
Bu desen, “daha fazla yükle” veya sonsuz kaydırma gibi özellikler için de kullanışlıdır.
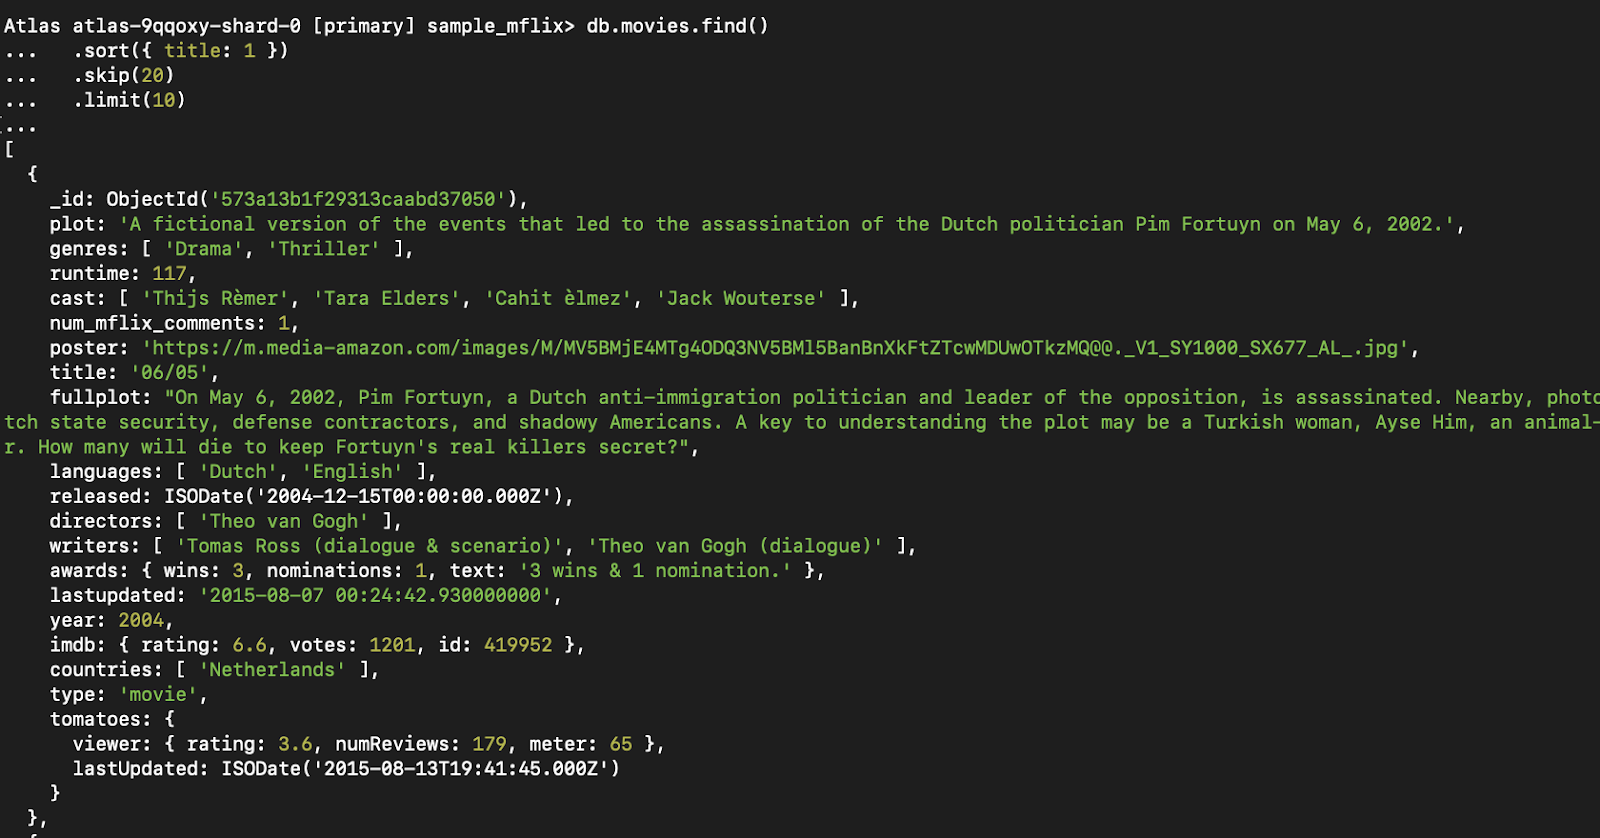
Şekil 5. Bu sorgu, sonuçların üçüncü sayfasını (sayfa başına 10 film) başlığa göre sıralı olarak getirir.
find() yöntemi, sonuç kümesine işaret eden bir imleç döndürür. Üzerinde yineleyebilirsiniz:
const cursor = db.movies.find({ type: "movie" });
cursor.forEach(doc => print(doc.name));
Ya da bir diziye dönüştürebilirsiniz:
const results = db.collection.find().toArray();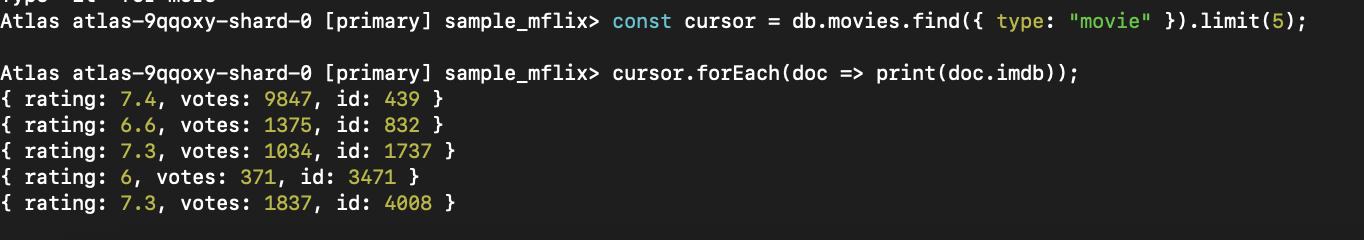
Şekil 6. find() çağrısından sonra bir imleç alırsınız. Dökümanlar üzerinde yinelemek veya tüm sonuç kümesini bir diziye dönüştürmek için kullanabilirsiniz.
> Not: İmleç nesnesi mongosh’ta veya sürücüler (ör. Node.js, Python) üzerinden kodda mevcuttur. MongoDB Compass gibi GUI araçları imleçleri dahili olarak yönetir. Onlara doğrudan erişmez veya yinelemezsiniz.
Sorgularınızı ince ayar yapmak için ek imleç yöntemlerini kullanabilirsiniz:
db.users.find({ age: { $gte: 30 } })
  .sort({ name: 1 })
  .limit(10)
  .skip(5)
  .maxTimeMS(200)
.hint({ age: 1 })maxTimeMS(ms): sorgu çok uzun sürerse iptal ederhint(): MongoDB’nin belirli bir indeksi kullanmasını zorlarbatchSize(n): parti başına döküman sayısını kontrol ederMülakatlara mı hazırlanıyorsunuz? En İyi 25 MongoDB Mülakat Sorusu ve Cevabını inceleyerek find() gibi temel kavramlara hakimiyetinizi test edin.
İndeksler, kopya kağıdı gibidir—MongoDB’nin dökümanları daha hızlı getirmesine yardımcı olur.
db.movies.createIndex({ type: 1 })db.users.find({ type: "movie" }).explain()Bu, indekslerin kullanılıp kullanılmadığını ve sorgunuzun ne kadar verimli olduğunu gösterir.
İndekssiz: 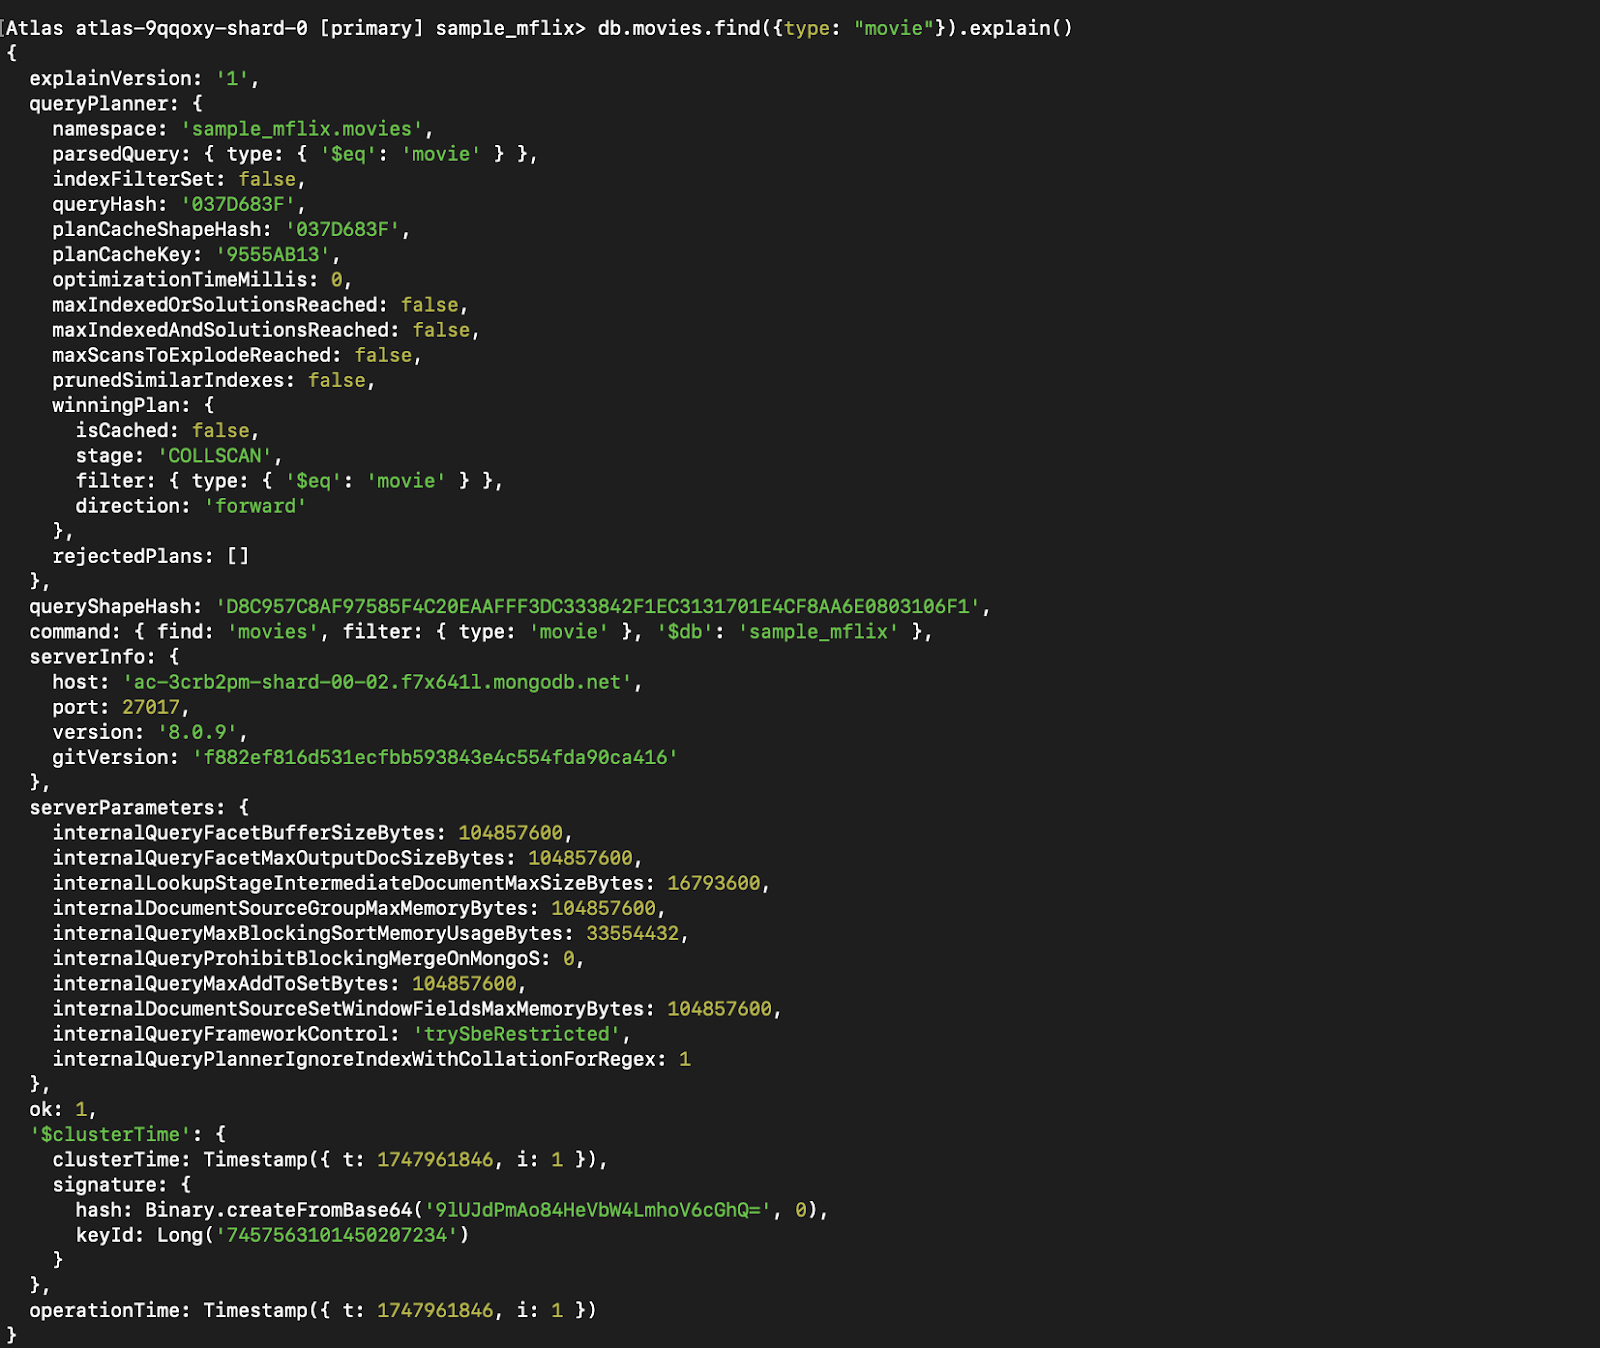
Şekil 7. İndekslemeden önce sorguda explain() çalıştırın.
Bir indeks oluşturma:

Şekil 8. type alanı üzerinde basit bir indeks oluşturun.
İndeksle:
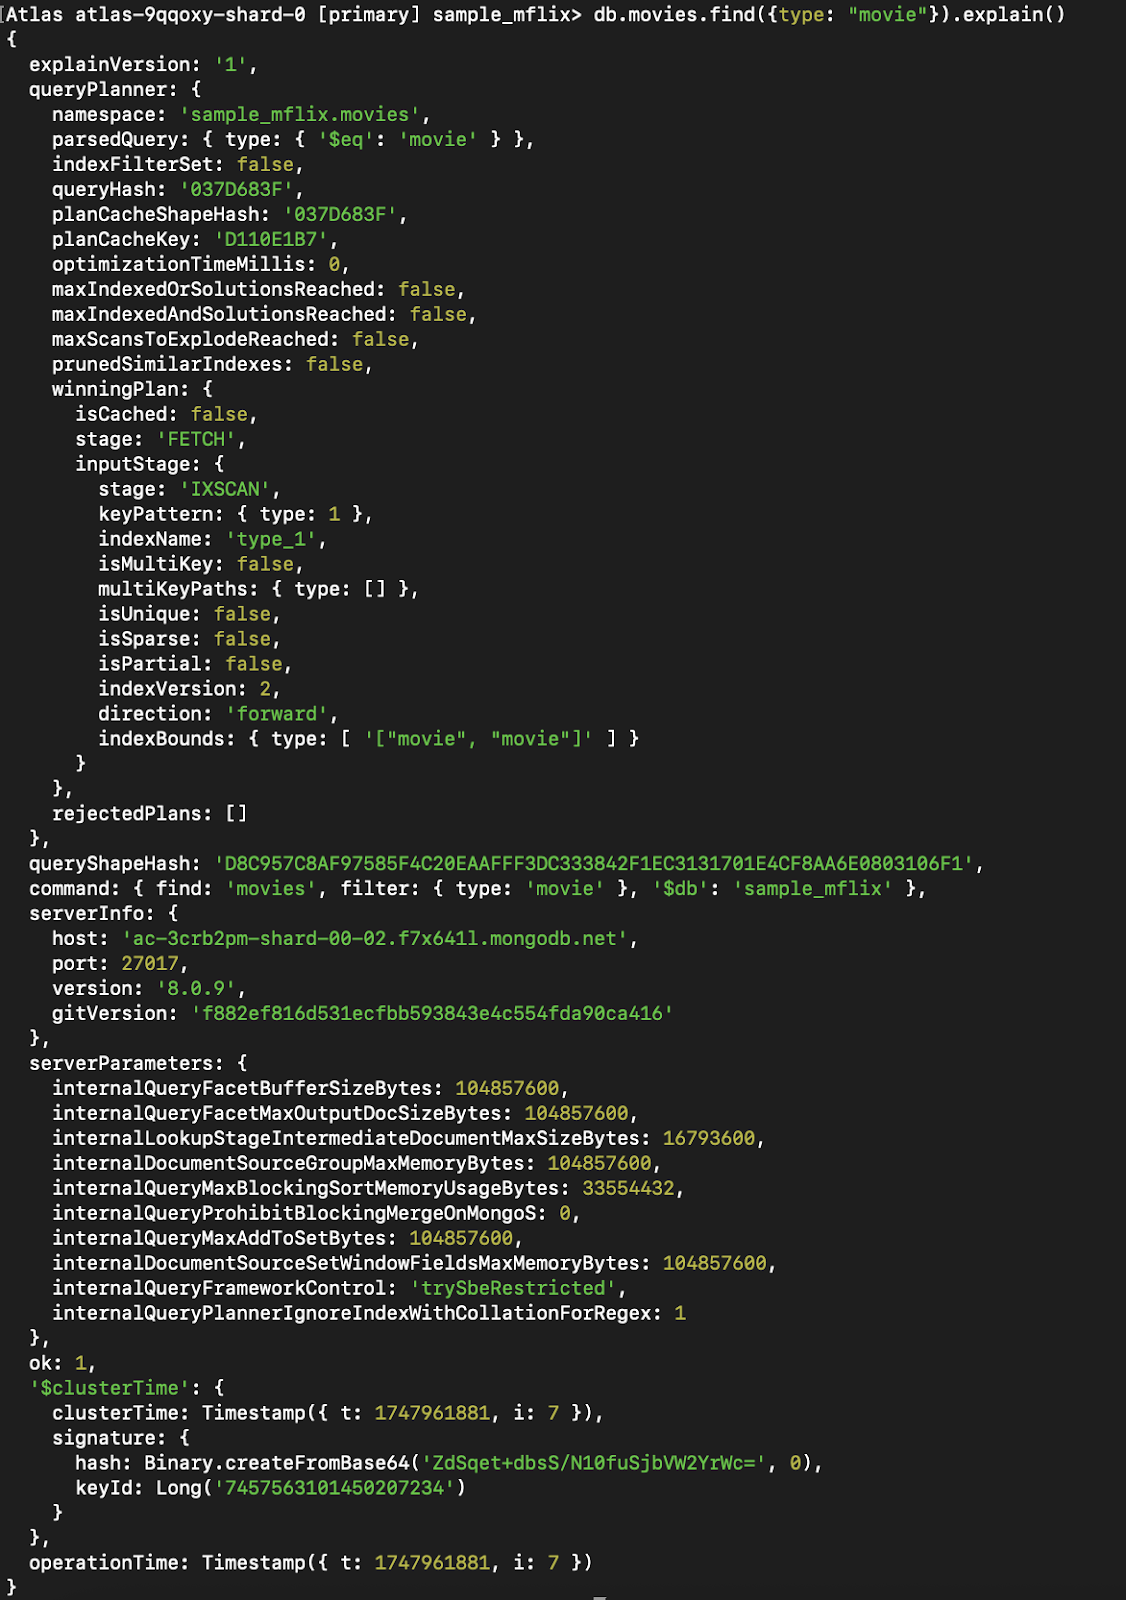
Şekil 9. Aynı sorguyu bu kez bir indeks kullanarak explain() ile çalıştırın.
Daha önce CollScan (koleksiyonu tarama) olan aşamanın Fetch + IXSCAN’e dönüştüğünü görebilirsiniz; bu temelde indeksi kullanma + indekste yer almayan diğer verileri aramadır (çünkü her şeyi döndürüyoruz).
Görsel araçları tercih ediyorsanız, MongoDB Compass resmi GUI istemcisidir. Şunları yapmanıza olanak tanır:
Hatta “JSON görünümü”ne geçerek sorguları kodunuza kopyalayıp yapıştırabilirsiniz.
MongoDB Atlas kullanıyorsanız, yapay zekâ destekli sorgu oluşturucuyla Atlas Search’ten yararlanabilirsiniz.
Sadece şu türde doğal dilde bir istem yazın:
"Geçen ay 100$’ın üzerinde sipariş veren Brezilya’daki tüm müşterileri göster."
Atlas, find() veya $search kullanarak eşleşen bir MongoDB sorgusu önerir. Özellikle sözdiziminden emin olmadığınızda mükemmel bir üretkenlik artırıcıdır.
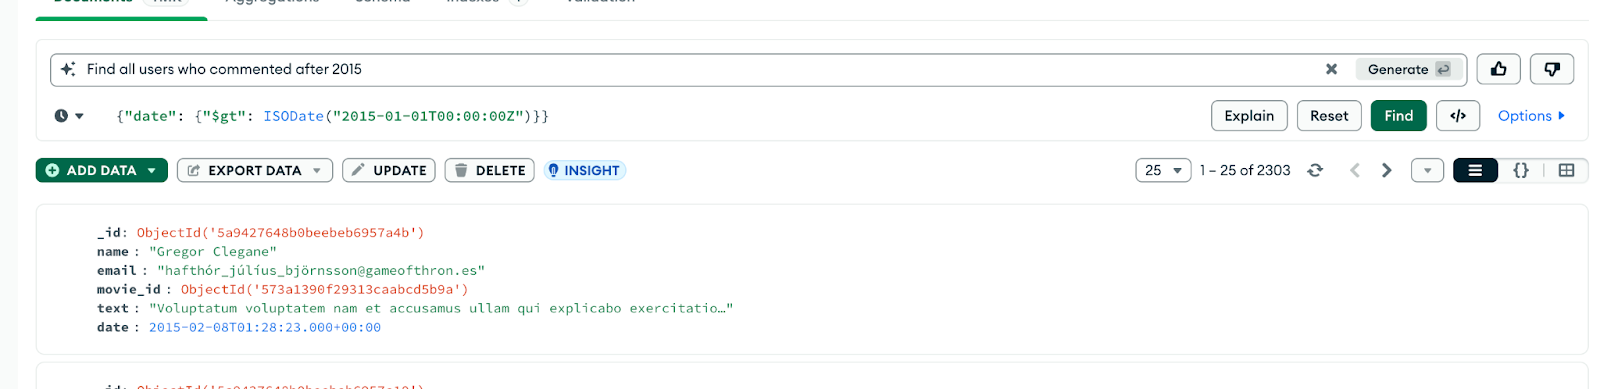
Şekil 10. Doğal dilden bir sorgu üretmek için Compass’ı kullanın.
limit + skip)_id dışında izin verilmezSQL geçmişiniz varsa, MongoDB’nin find()’ının aşina olduğunuz SQL sorgularıyla nasıl karşılaştırıldığını anlamak geçişi kolaylaştırabilir. İşte yaygın işlemlerin genel bir karşılaştırması:
|
Kavram |
SQL Örneği |
MongoDB Karşılığı |
|
Temel sorgu |
|
|
|
Alan seçimi |
|
|
|
Sıralama |
|
|
|
Sınırlandırma |
|
|
|
Atlama |
|
|
Gördüğünüz gibi, MongoDB’nin sözdizimi JSON formatında daha JavaScript benzeri ve ifadeliyken, SQL daha bildirimseldir ve yapılandırılmıştır. Bu paralellikleri bilmek, MongoDB’ye daha hızlı alışmanıza yardımcı olacaktır.
find()’ı veri filtreniz olarak düşünün—kesin sonuçlar için koşulları birleştirin.İster bir girişim panosu, ister bir veri analizi aracı, ister bir e-ticaret arka ucu inşa ediyor olun, find()’a hakim olmak MongoDB deneyiminizi daha sorunsuz, daha hızlı ve daha etkili hale getirecektir.
Gelecek yazılarda daha fazla MongoDB içgörüsü için bizi takip edin!
MongoDB becerilerinizi belgelemek mi istiyorsunuz? Seçeneklerinizi keşfetmek için Kapsamlı MongoDB Sertifikasyon Rehberini okuyun.
MongoDB ve veritabanları hakkında daha fazlasını bu kurslarla öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme