कोर्स
Python में MongoDB परिचय
3 घंटा
24.4K
MongoDB एक लोकप्रिय NoSQL डेटाबेस है जिसे लचीलापन और प्रदर्शन के लिए डिज़ाइन किया गया है। संरचित टेबल और SQL पर आधारित पारंपरिक रिलेशनल डेटाबेस के विपरीत, MongoDB डेटा को लचीले, JSON-जैसे डॉक्यूमेंट्स में संग्रहीत करता है। यह डेवलपर्स के लिए आदर्श है जो डायनेमिक या अर्द्ध-संरचित डेटा के साथ काम करते हैं।
MongoDB में आप जो सबसे महत्वपूर्ण कार्य करेंगे, उनमें से एक है डेटा को क्वेरी करना, और ऐसा करने के लिए सबसे सामान्य रूप से उपयोग किया जाने वाला मेथड है find()। चाहे आप अभी शुरुआत कर रहे हों या अपनी क्वेरी स्किल्स को बेहतर बनाना चाहते हों, find() कैसे काम करता है, यह समझना आपके MongoDB डेटा को प्रभावी ढंग से नेविगेट और मैनीपुलेट करने के लिए आवश्यक है।
कल्पना कीजिए कि आप एक मूवी डेटाबेस का अन्वेषण कर रहे हैं। आप वर्ष 2000 के बाद रिलीज़ हुई सभी विज्ञान-कथा फ़िल्में ढूँढना चाहते हैं, या शायद किसी विशिष्ट समयावधि में किए गए सभी उपयोगकर्ता कमेंट्स की सूची बनाना चाहते हैं। यहीं पर find() चमकता है।
इस लेख में, आप सीखेंगे कि find() मेथड का उपयोग करके किसी कलेक्शन से डॉक्यूमेंट्स कैसे प्राप्त करें, फ़िल्टर लागू करें, फ़ील्ड्स प्रोजेक्ट करें, परिणामों को सॉर्ट करें, और प्रदर्शन को ऑप्टिमाइज़ करें—वह भी sample_mflix डेटासेट के साथ काम करते हुए।
डेटा साइंस वर्कफ़्लो में MongoDB का हाथ-से-हाथ परिचय चाहें तो Introduction to MongoDB in Python कोर्स देखें।
find() मेथड किसी कलेक्शन से डॉक्यूमेंट्स प्राप्त करने का MongoDB का प्राथमिक तरीका है। यह निर्दिष्ट क्वेरी से मेल खाने वाले डॉक्यूमेंट्स के लिए एक कर्सर लौटाता है। इसके बाद आप इस कर्सर पर इटरेट कर सकते हैं, या अपनी एप्लिकेशन की ज़रूरत के अनुसार इसे एक एरे में बदल सकते हैं।
पूरा सिंटैक्स इस प्रकार है:
db.collection.find(<query>, <projection>, <options>)query (वैकल्पिक): एक डॉक्यूमेंट जो डॉक्यूमेंट्स को चुनने के मानदंड परिभाषित करता है। यदि आप इस पैरामीटर को छोड़ देते हैं या एक खाली डॉक्यूमेंट ({}) पास करते हैं, तो find() कलेक्शन के सभी डॉक्यूमेंट्स लौटाएगा।projection (वैकल्पिक): एक डॉक्यूमेंट जो यह निर्दिष्ट करता है कि कौन-से फ़ील्ड्स लौटाए जाएँ। आप फ़ील्ड्स को शामिल (1) या बाहर (0) कर सकते हैं। डिफ़ॉल्ट रूप से, MongoDB सभी फ़ील्ड्स लौटाता है, जिसमें _id भी शामिल है।options (वैकल्पिक): क्वेरी के व्यवहार को कॉन्फ़िगर करने के लिए एक अतिरिक्त डॉक्यूमेंट। आप इसमें सॉर्ट ऑर्डर, पेजिनेशन सीमाएँ, टाइमआउट्स, और इंडेक्स हिंट्स जैसी सेटिंग्स कर सकते हैं।संकल्पनाओं को यथासंभव स्पष्ट और लागू रखने के लिए, हम MongoDB Atlas का सैंपल डेटासेट—विशेष रूप से sample_mflix डेटाबेस—का उपयोग करेंगे। इस डेटासेट में movies, comments, users, और theaters जैसी कलेक्शंस शामिल हैं, जिनका हम पूरे लेख में प्रत्येक उदाहरण को दर्शाने के लिए संदर्भ देंगे।
db.books.find(
  { year: { $gte: 2000 } },              // query: books published in or after 2000
  { title: 1, author: 1, _id: 0 },        // projection: include only title and author
  { sort: { title: 1 }, limit: 5 }       // options: sort by title, return only 5 books
)
यह क्वेरी:
_id को छोड़कर)।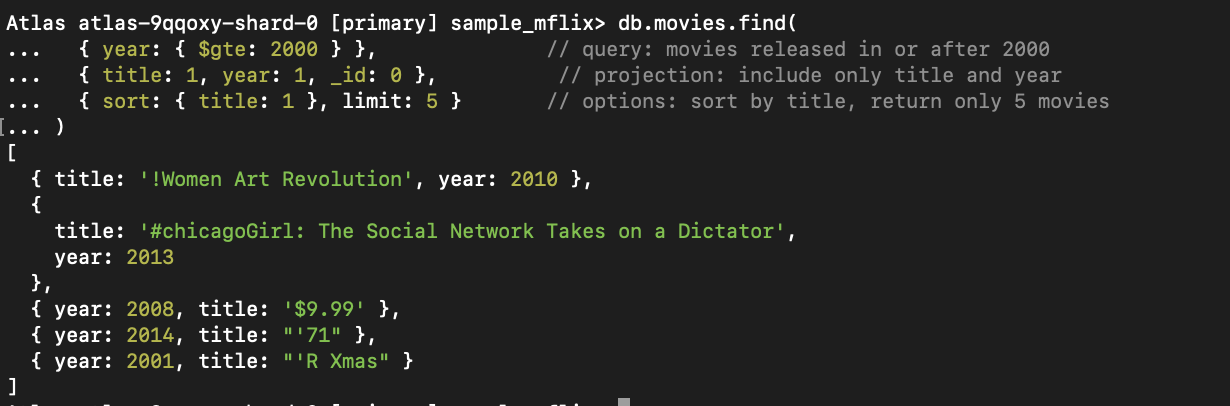
Figure 1. यह क्वेरी 2000 के बाद रिलीज़ हुई फ़िल्में ढूँढती है, शीर्षक के अनुसार सॉर्ट करती है और परिणामों को पाँच तक सीमित करती है।
परिणाम एक कर्सर होता है, जो इटरेट करते समय मेल खाते डॉक्यूमेंट्स को लेज़ी तरीके से लोड करता है। आप परिणामों को प्रोसेस करने के लिए .toArray() या .forEach() का उपयोग कर सकते हैं।
यदि आप MongoDB शेल (mongosh) के माध्यम से जुड़े हैं और परिणाम को किसी वेरिएबल में असाइन नहीं करते हैं, तो डिफ़ॉल्ट रूप से केवल पहले 20 डॉक्यूमेंट्स दिखेंगे। अतिरिक्त डॉक्यूमेंट्स देखने के लिए it टाइप करें और Enter दबाएँ। यह प्रक्रिया कर्सर से अगला बैच लाती रहेगी।
> नोट: उपरोक्त शेल-विशिष्ट व्यवहार है, MongoDB की सीमा नहीं। अधिकांश MongoDB ड्राइवर्स (जैसे, Node.js, Python, Java) में .toArray() कॉल करने या कर्सर पर इटरेट करने से सभी मेल खाते परिणाम स्वतः फ़ेच हो जाते हैं। कर्सर का व्यवहार आपके उपयोग किए जा रहे वातावरण और भाषा के अनुसार भिन्न हो सकता है।
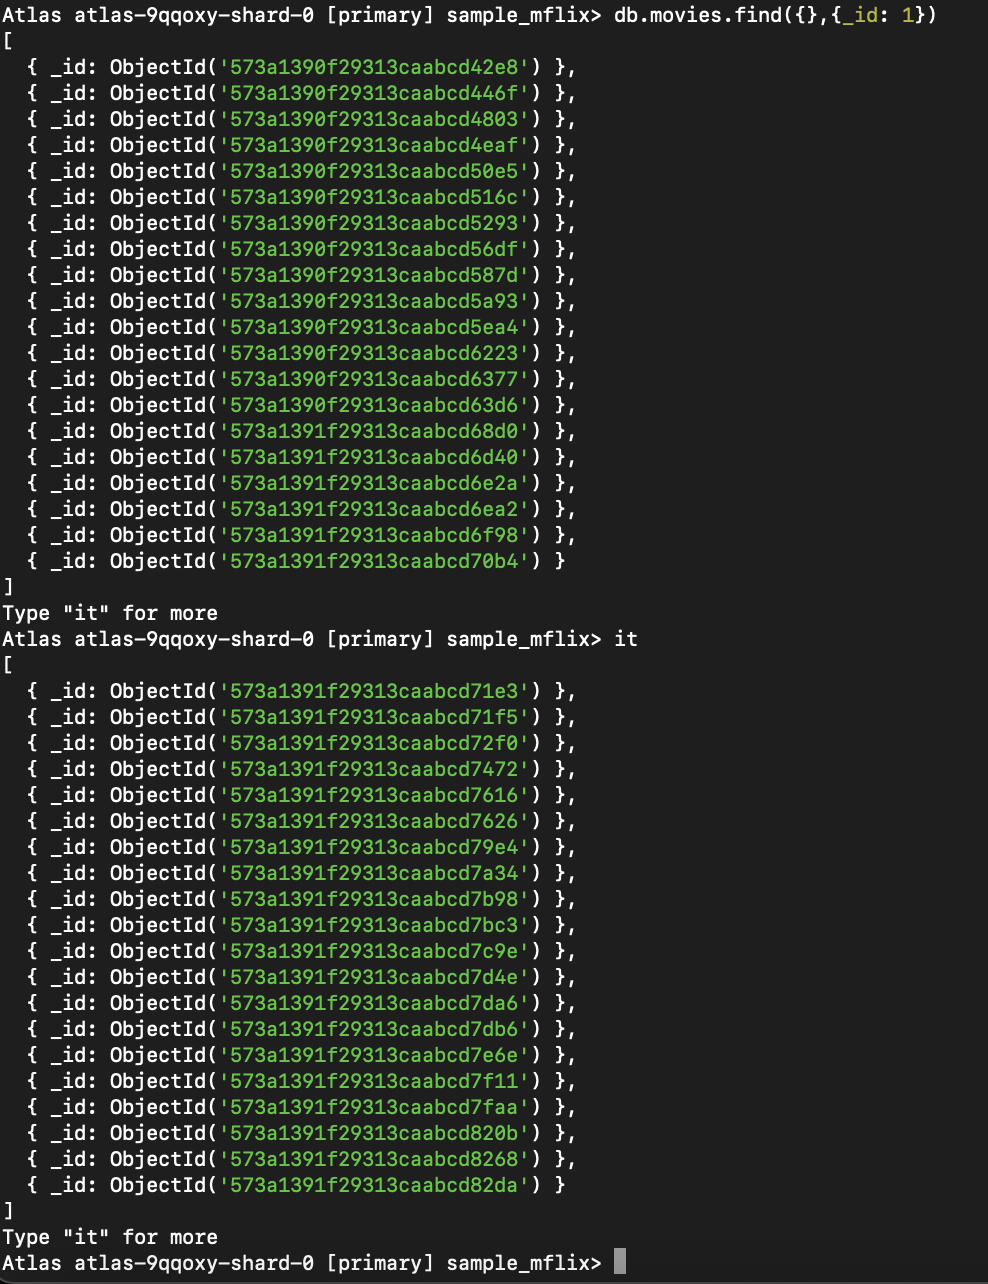
Figure 2. यह क्वेरी सभी फ़िल्में प्राप्त करती है, केवल _id फ़ील्ड लौटाती है और अतिरिक्त परिणाम फ़ेच करने के लिए कर्सर का उपयोग करती है।
यदि आप NoSQL डेटाबेस में नए हैं, तो Introduction to NoSQL कोर्स इस ट्यूटोरियल को पूरक करने वाली बुनियादी अवधारणाएँ प्रदान करता है।
मूवी उदाहरण के साथ जारी रखते हुए, मान लीजिए आप Sci-Fi जेनर की सभी फ़िल्में लाना चाहते हैं। यह ऐसे करेंगे:
db.movies.find({ genres: "Sci-Fi" })अब, आप केवल वे फ़िल्में चाहते हैं जो वर्ष 2000 या उसके बाद रिलीज़ हुई हों:
db.movies.find({ year: { $gte: 2000 } })और यदि आप दोनों चाहते हैं? शर्तें संयोजित करें:
db.movies.find({ genres: "Sci-Fi", year: { $gte: 2000 } })वैकल्पिक रूप से, आप इसे $and का उपयोग करके स्पष्ट रूप से लिख सकते हैं:
db.movies.find({ $and: [ { genres: "Sci-Fi" }, { year: { $gte: 2000 } } ] })दोनों क्वेरियाँ समान परिणाम लौटाती हैं—ऐसे डॉक्यूमेंट्स जिनका जेनर Sci-Fi है और रिलीज़ वर्ष 2000 या बाद का है। पहला रूप अधिक संक्षिप्त है और जब फ़ील्ड अलग-अलग हों तो प्राथमिकता दी जाती है।

Figure 3. ये एक ही परिणाम देने वाली क्वेरी लिखने के अलग-अलग तरीके हैं।
find() को एक फ़िल्टर फ़नल की तरह उपयोग करें—हर शर्त आपके परिणामों को सीमित करती जाती है।
अब, आइए देखें कि अपनी क्वेरियों को अगले स्तर पर ले जाने के लिए comparison और logical ऑपरेटर्स का उपयोग कैसे करें।
$eq, $ne: बराबर, बराबर नहीं$gt, $gte, $lt, $lte: बड़ा/छोटा (या बराबर)$in, $nin: एरे के भीतर या एरे के भीतर नहींकल्पना कीजिए कि आप ग्राहक ऑर्डर ट्रैक कर रहे हैं और $100 और $500 के बीच के ऑर्डर चाहते हैं:
db.orders.find({ total: { $gte: 100, $lte: 500 } })$and, $or, $nor, $notअब मान लें कि आप ऐसे उत्पाद दिखाना चाहते हैं जो "Books" श्रेणी में हों या जिनकी कीमत $20 से कम हो। यहाँ एक उदाहरण क्वेरी है:
db.products.find({ $or: [ { category: "Books" }, { price: { $lt: 20 } } ] })आप डॉट नोटेशन का उपयोग करके नेस्टेड फ़ील्ड्स तक पहुँच सकते हैं:
db.customers.find({ "address.city": "Chicago" })प्रोजेक्शन आपको केवल वही लौटाने देता है जिसकी आपको ज़रूरत है, जो प्रदर्शन और स्पष्टता दोनों में उल्लेखनीय सुधार कर सकता है।
db.movies.find({}, { directors: 1, languages: 1, _id: 0 })महत्वपूर्ण: प्रोजेक्शन निर्दिष्ट करते समय, MongoDB आपसे दो मोड्स में से एक चुनने की अपेक्षा करता है: या तो विशिष्ट फ़ील्ड्स को शामिल करें (1) या विशिष्ट फ़ील्ड्स को बाहर करें (0)। आप एक ही प्रोजेक्शन में दोनों शैलियों को मिला नहीं सकते, सिवाय _id फ़ील्ड के, जिसे आप अन्य फ़ील्ड्स को शामिल करते समय भी बाहर कर सकते हैं।
✅ मान्य (केवल inclusion):
db.movies.find({}, { directors: 1, languages: 1 })✅ मान्य (केवल exclusion):
db.movies.find({}, { directors: 0, _id: 0 })❌ अमान्य (inclusion और exclusion का मिश्रण):
db.movies.find({}, { directors: 1, languages: 0 }) // Not allowedएकमात्र अपवाद _id फ़ील्ड है, जिसे आप अन्य फ़ील्ड्स को शामिल करते समय भी बाहर कर सकते हैं:
db.movies.find({}, { directors: 1, _id: 0 }) // Allowed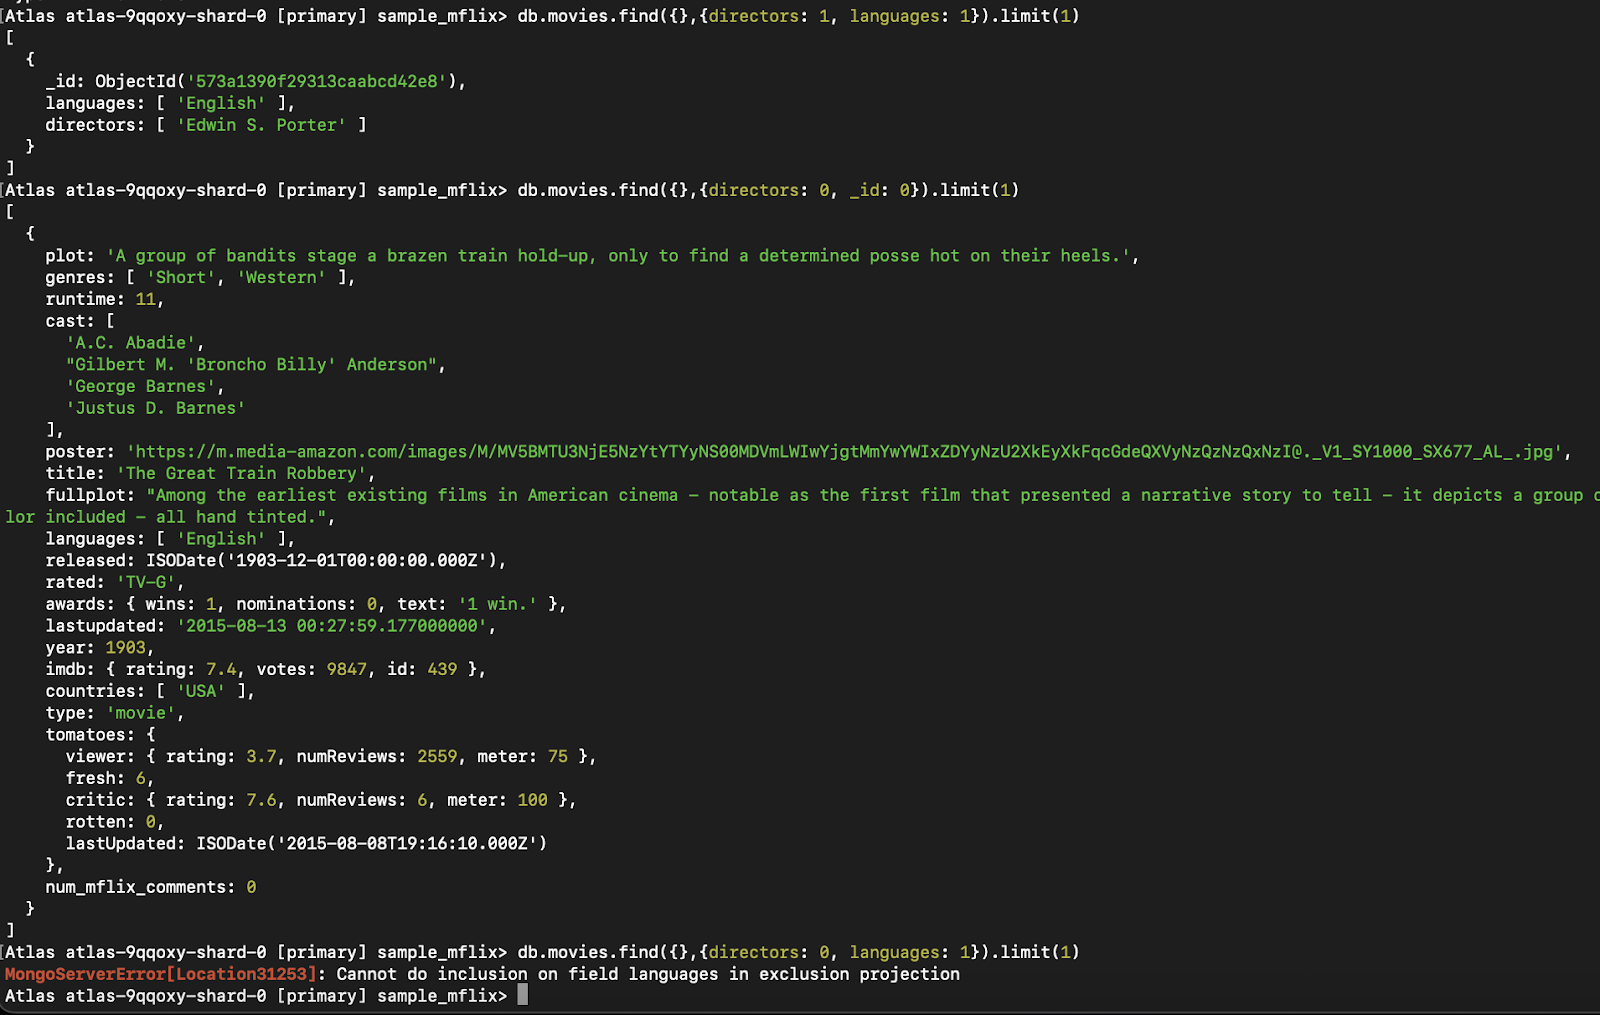
Figure 4. यह उदाहरण एक ही प्रोजेक्शन में फ़ील्ड inclusion और exclusion मिलाने से उत्पन्न त्रुटि दिखाता है, जिसे MongoDB अनुमति नहीं देता, सिवाय `_id` के।
बड़े डेटासेट्स के साथ काम करते समय, उपयोगकर्ताओं को एक समय में केवल डेटा का कुछ हिस्सा दिखाना आम है—इसे पेजिनेशन कहा जाता है। उदाहरण के लिए, कोई स्ट्रीमिंग ऐप एक बार में हज़ारों लोड करने के बजाय प्रति पेज 10 फ़िल्में दिखा सकता है। इससे न केवल प्रदर्शन बेहतर होता है बल्कि उपयोगकर्ता अनुभव भी सुधरता है।
MongoDB में, पेजिनेशन sort(), limit(), और skip() के संयोजन से हासिल किया जाता है।
यदि आप SQL पृष्ठभूमि से आते हैं, तो सामान्य पेजिनेशन अवधारणाएँ इस प्रकार तुलनीय हैं:
SQL में बुनियादी क्वेरी:
SELECT * FROM movies WHERE year >= 2000MongoDB में इसे इस प्रकार व्यक्त किया जा सकता है:
db.movies.find({ year: { $gte: 2000 } })SQL में फ़ील्ड चयन:
SELECT title, year FROM moviesMongoDB में फ़ील्ड चयन:
db.movies.find({}, { title: 1, year: 1, _id: 0 })अब, कुछ और सामान्य क्वेरी ऑपरेशनों के उदाहरण देखते हैं:
सॉर्टिंग:
ORDER BY title ASC.sort({ title: 1 })लिमिट करना:
LIMIT 10.limit(10)स्किप करना:
OFFSET 10.skip(10)इन समानताओं को समझना SQL उपयोगकर्ताओं को MongoDB के डॉक्यूमेंट-आधारित क्वेरी सिस्टम में आसानी से स्थानांतरित होने में मदद कर सकता है।
सॉर्टिंग आपको किसी विशेष फ़ील्ड के आधार पर परिणामों को व्यवस्थित करने में मदद करती है—उदाहरण के लिए, शीर्षक के अनुसार फ़िल्मों को वर्णानुक्रम में सॉर्ट करना:
db.movies.find().sort({ title: 1 }) // ascending (A–Z)1 का मतलब आरोही क्रम (A-Z, 0-9)-1 का मतलब अवरोही क्रम (Z-A, 9-0)केवल निश्चित संख्या में परिणाम लौटाएँ—उदाहरण के लिए, पहले 10:
db.movies.find().limit(10)यह “टॉप 10” सूचियाँ या प्रारंभिक दृश्य लागू करते समय उपयोगी है।
डॉक्यूमेंट्स को छोड़ने के लिए इसका उपयोग करें। यह अक्सर पेजिनेशन के लिए limit() के साथ उपयोग किया जाता है:
db.movies.find().skip(10).limit(10)यह पहले 10 डॉक्यूमेंट्स को छोड़ता है और अगले 10 लौटाता है, प्रभावी रूप से pageSize = 10 होने पर पेज 2 दिखाता है।
पेजिनेशन फ़ॉर्मूला:
skip = (pageNumber - 1) * pageSize> नोट: गहरी पेजिनेशन के लिए skip() का उपयोग (उदा., skip(10000)) अक्षम हो सकता है, क्योंकि MongoDB छोड़े गए डॉक्यूमेंट्स को भी स्कैन करके त्यागता है। बड़े डेटासेट्स के साथ बेहतर प्रदर्शन के लिए, _id जैसे इंडेक्स्ड फ़ील्ड्स का उपयोग करके रेंज-आधारित पेजिनेशन पर विचार करें।
db.movies.find()
  .sort({ title: 1 })
  .skip(20)
  .limit(10)
यह पैटर्न “और लोड करें” या अनंत स्क्रॉल जैसी सुविधाओं के लिए भी सहायक है।
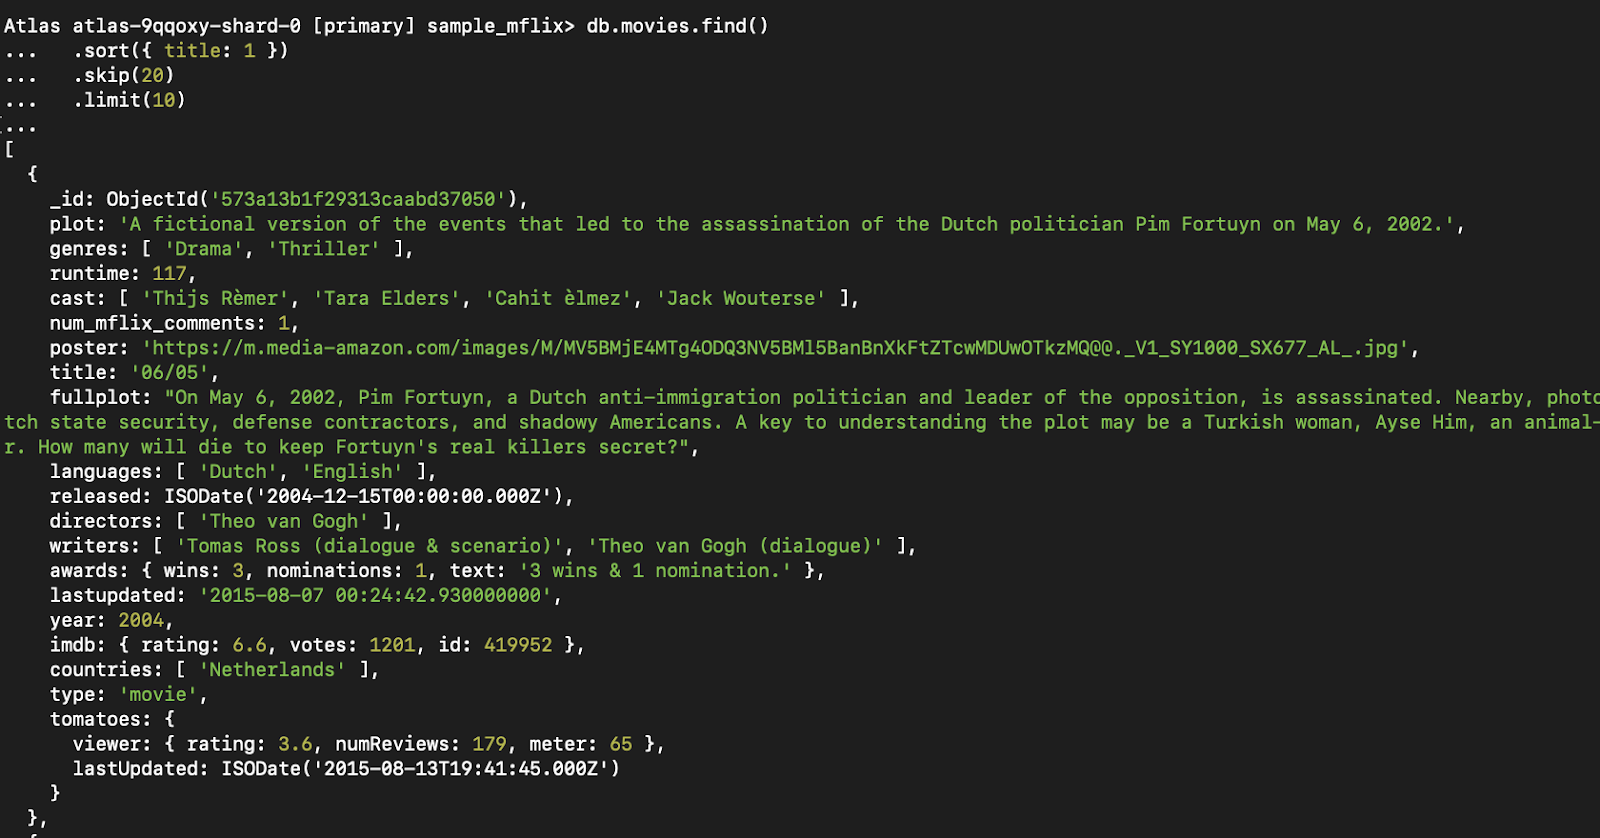
Figure 5. यह क्वेरी तीसरे पेज के परिणाम (प्रति पेज 10 फ़िल्में) शीर्षक के अनुसार क्रमबद्ध करके प्राप्त करती है।
find() मेथड एक कर्सर लौटाता है—जो रिज़ल्ट सेट का पॉइंटर होता है। आप इस पर इटरेट कर सकते हैं:
const cursor = db.movies.find({ type: "movie" });
cursor.forEach(doc => print(doc.name));
या इसे एरे में बदल सकते हैं:
const results = db.collection.find().toArray();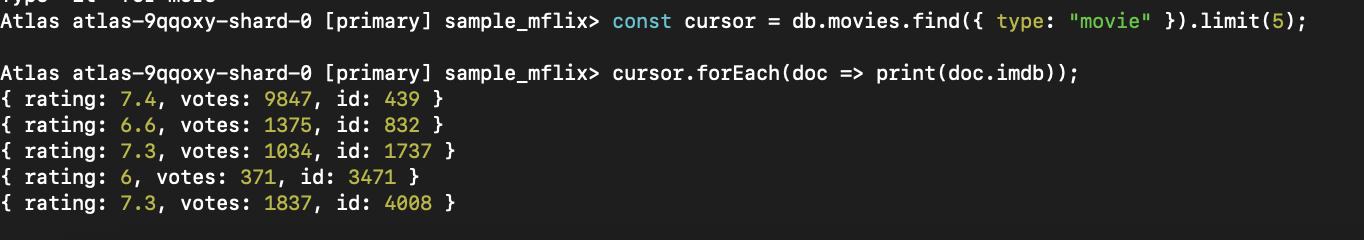
Figure 6. find() कॉल करने के बाद, आपको एक कर्सर मिलता है। आप इसका उपयोग डॉक्यूमेंट्स पर इटरेट करने या पूरे रिज़ल्ट सेट को एक एरे में बदलने के लिए कर सकते हैं।
> नोट: कर्सर ऑब्जेक्ट mongosh में या ड्राइवर्स (जैसे, Node.js, Python) के माध्यम से कोड में उपलब्ध होता है। MongoDB Compass जैसे GUI टूल्स कर्सर्स को आंतरिक रूप से हैंडल करते हैं। आप उन्हें सीधे एक्सेस या इटरेट नहीं करेंगे।
अपनी क्वेरियों को फाइन-ट्यून करने के लिए, आप अतिरिक्त कर्सर मेथड्स का उपयोग कर सकते हैं:
db.users.find({ age: { $gte: 30 } })
  .sort({ name: 1 })
  .limit(10)
  .skip(5)
  .maxTimeMS(200)
.hint({ age: 1 })maxTimeMS(ms): क्वेरी बहुत समय ले तो उसे निरस्त करता हैhint(): MongoDB को किसी विशिष्ट इंडेक्स का उपयोग करने के लिए बाध्य करता हैbatchSize(n): प्रति बैच डॉक्यूमेंट्स की संख्या नियंत्रित करता हैइंटरव्यू की तैयारी कर रहे हैं? Top 25 MongoDB Interview Questions and Answers देखें और अपनी कोर अवधारणाओं जैसे find() की समझ को परखें।
इंडेक्स चीट शीट्स की तरह होते हैं—वे MongoDB को डॉक्यूमेंट्स को तेज़ी से पुनर्प्राप्त करने में मदद करते हैं।
db.movies.createIndex({ type: 1 })db.users.find({ type: "movie" }).explain()यह दर्शाता है कि इंडेक्स उपयोग हो रहे हैं या नहीं और आपकी क्वेरी कितनी कुशल है।
इंडेक्स के बिना: 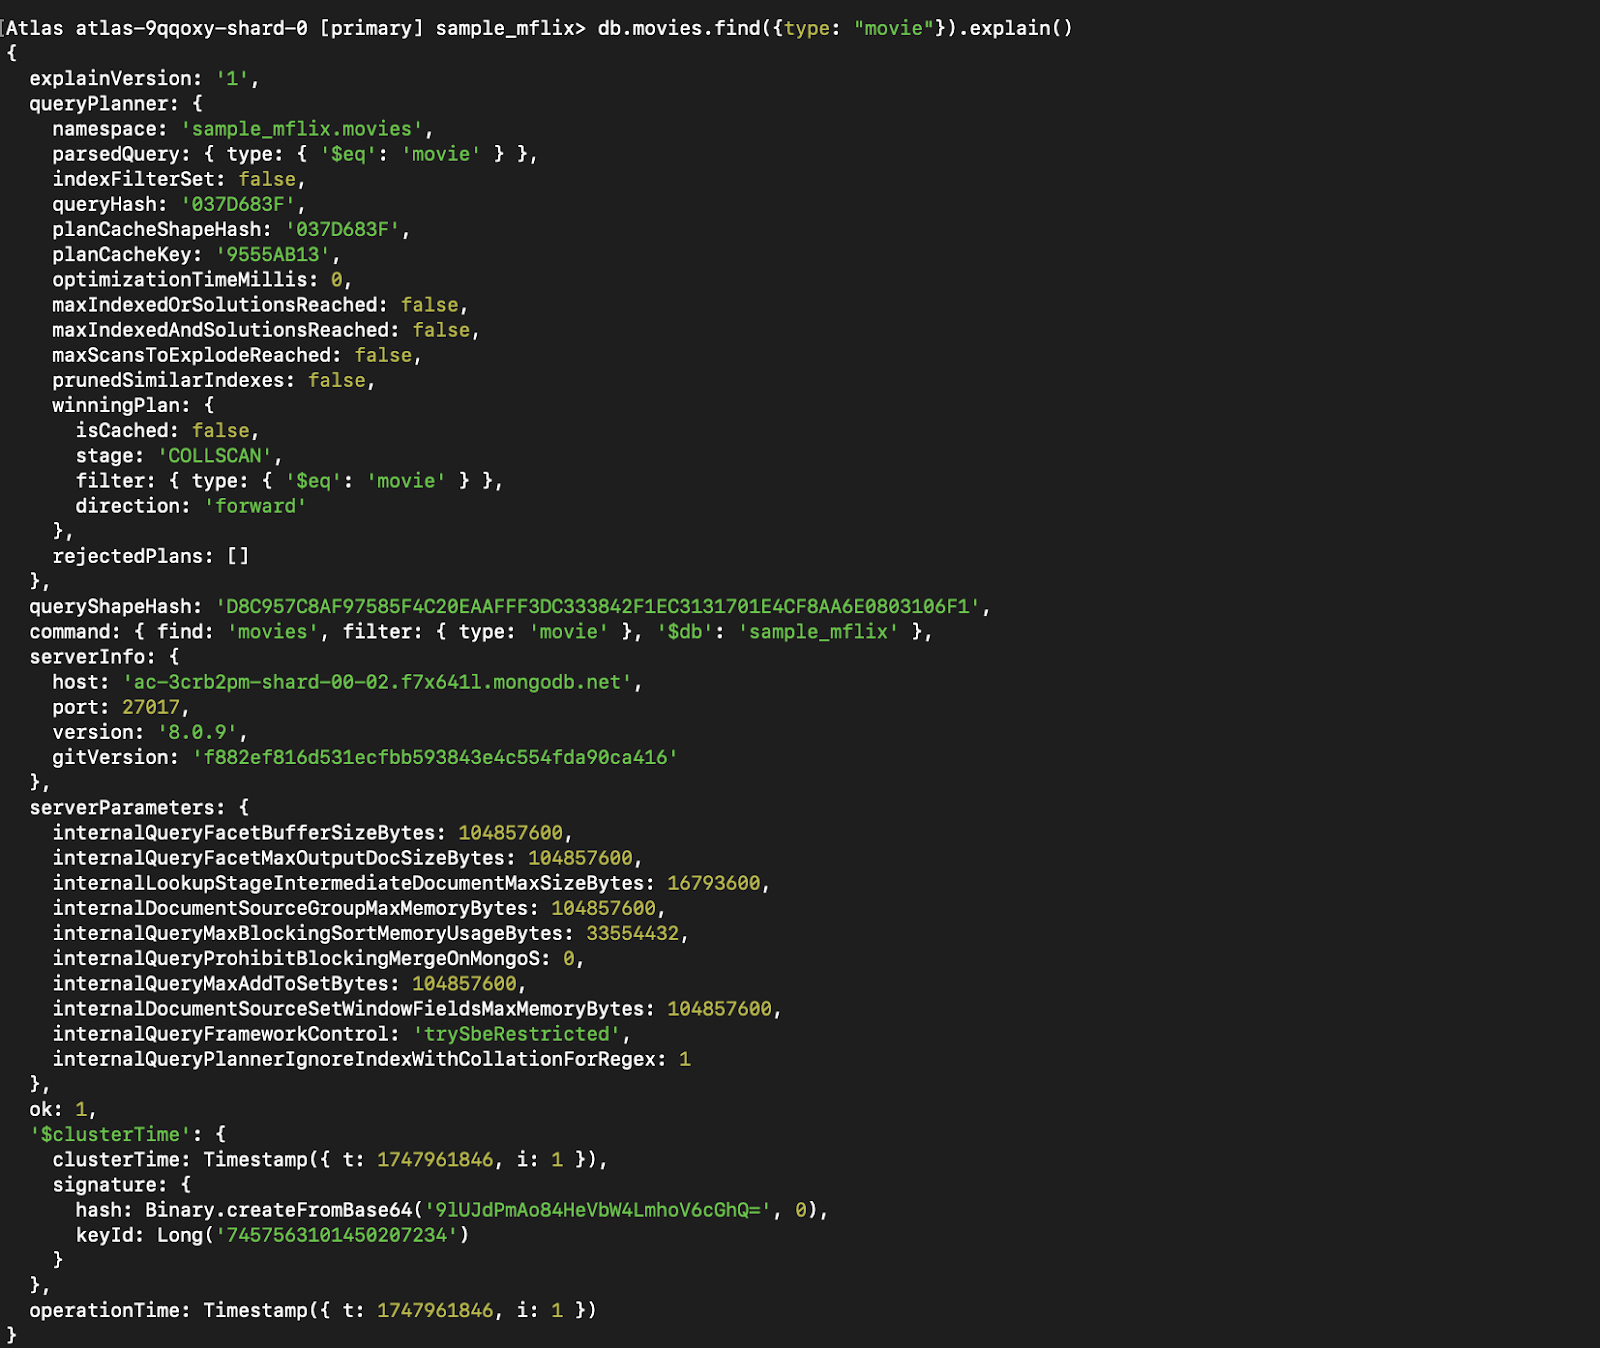
Figure 7. इंडेक्सिंग से पहले क्वेरी पर `explain()` चलाएँ।
इंडेक्स बनाना:

Figure 8. type फ़ील्ड पर एक सरल इंडेक्स बनाएँ।
इंडेक्स के साथ:
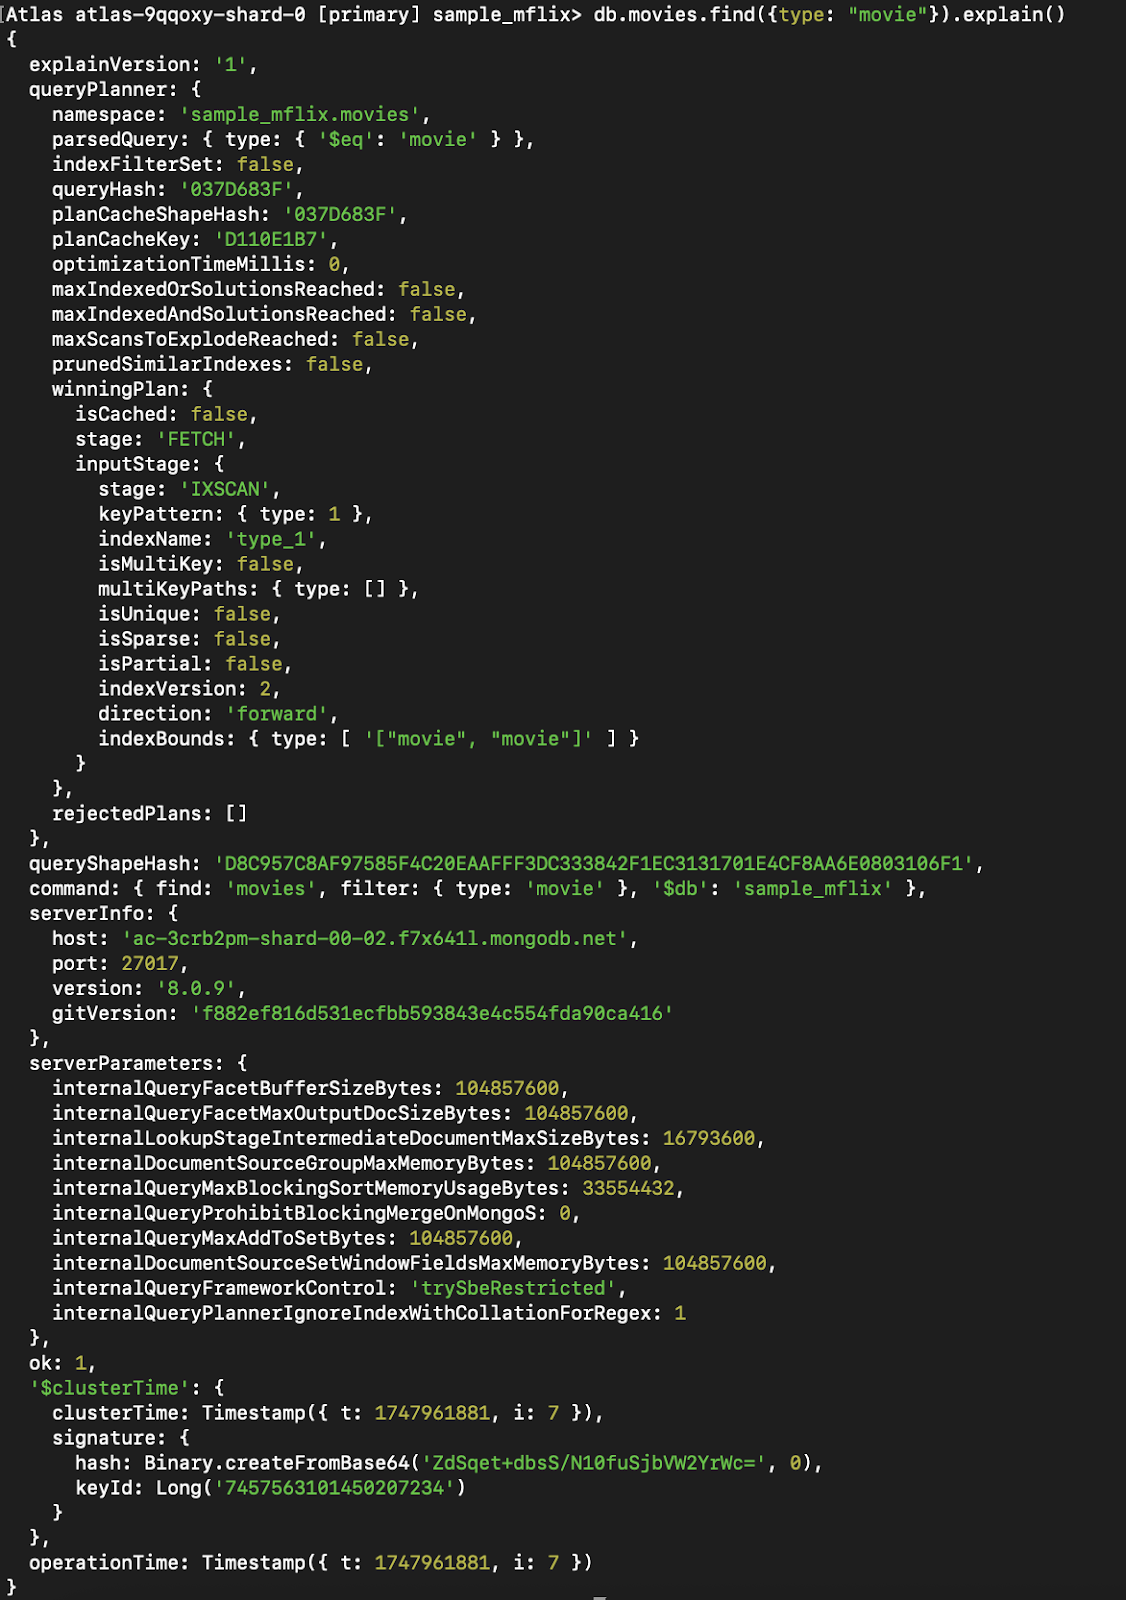
Figure 9. अब उसी क्वेरी को `explain()` के साथ चलाएँ, जो इंडेक्स का उपयोग कर रही है।
आप देख सकते हैं कि पहले जो स्टेज CollScan (कलेक्शन स्कैन करना) था, वह Fetch + IXSCAN बन गया है, जिसका अर्थ है इंडेक्स का उपयोग + उस अन्य डेटा की खोज जो इंडेक्स का हिस्सा नहीं है (क्योंकि हम सब कुछ लौटा रहे हैं)।
यदि आप विज़ुअल टूल्स पसंद करते हैं, तो MongoDB Compass आधिकारिक GUI क्लाइंट है। यह आपको सक्षम बनाता है:
आप “JSON view” पर स्विच करके क्वेरियों को अपने कोड में कॉपी/पेस्ट भी कर सकते हैं।
यदि आप MongoDB Atlas का उपयोग कर रहे हैं, तो आप AI-संचालित क्वेरी बिल्डर के साथ Atlas Search का लाभ उठा सकते हैं।
बस इस तरह का प्राकृतिक-भाषा प्रॉम्प्ट टाइप करें:
"पिछले महीने ब्राज़ील से आने वाले सभी ग्राहकों को दिखाएँ जिन्होंने $100 से अधिक के ऑर्डर दिए।"
Atlas find() या $search का उपयोग करते हुए मिलती-जुलती MongoDB क्वेरी सुझाता है। जब आप सिंटैक्स को लेकर अनिश्चित हों, तब यह उत्पादकता में बेहतरीन बढ़ोतरी देता है।
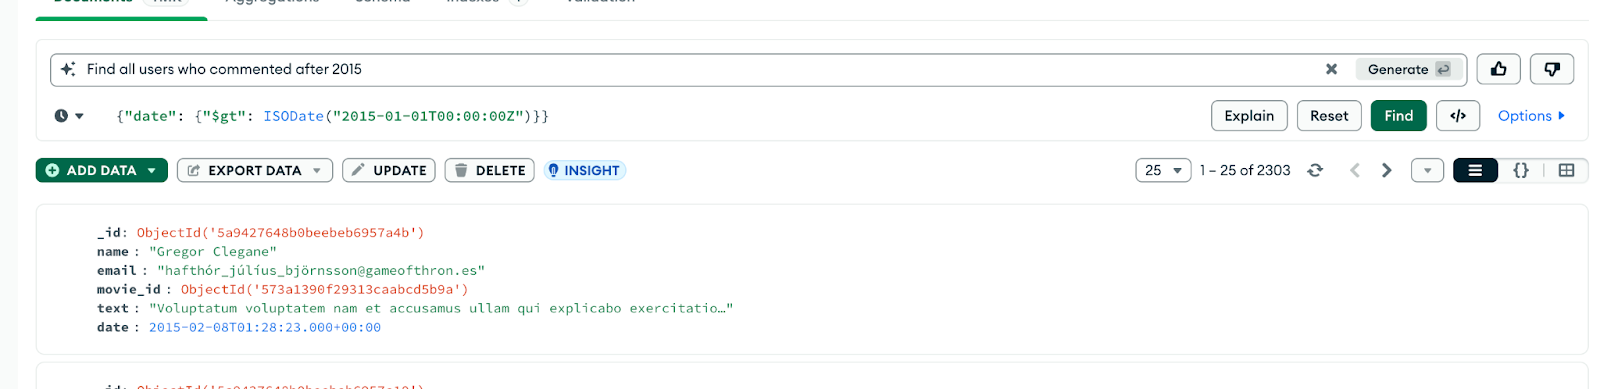
Figure 10. प्राकृतिक भाषा से क्वेरी जेनरेट करने के लिए Compass का उपयोग करें।
limit + skip)_id केयदि आपका बैकग्राउंड SQL में है, तो यह समझना कि MongoDB का find() परिचित SQL क्वेरियों से कैसे तुलना करता है, ट्रांजिशन को आसान बना सकता है। यहाँ सामान्य ऑपरेशंस की एक सामान्य तुलना दी गई है:
|
अवधारणा |
SQL उदाहरण |
समकक्ष MongoDB |
|
बेसिक क्वेरी |
|
|
|
फ़ील्ड चयन |
|
|
|
सॉर्टिंग |
|
|
|
लिमिटिंग |
|
|
|
स्किप करना |
|
|
जैसा कि आप देख सकते हैं, MongoDB का सिंटैक्स अधिक JavaScript-जैसा है और JSON फॉर्मेट में अधिक व्यक्तिशील है, जबकि SQL अधिक घोषणात्मक और संरचित है। इन समानताओं को जानने से आप MongoDB में जल्दी सहज महसूस करेंगे।
find() को अपने डेटा फ़िल्टर की तरह समझें—सटीक परिणामों के लिए शर्तों को संयोजित करें।चाहे आप एक स्टार्टअप डैशबोर्ड, डेटा एनालिटिक्स टूल, या ई-कॉमर्स बैकएंड बना रहे हों, find() में महारत हासिल करना आपकी MongoDB यात्रा को और भी सहज, तेज़, और प्रभावी बनाएगा।
आने वाले लेखों में MongoDB पर और जानकारियाँ पाने के लिए जुड़े रहें!
क्या आप अपनी MongoDB स्किल्स को प्रमाणित करना चाहते हैं? अपनी संभावनाएँ जानने के लिए Complete Guide to MongoDB Certification पढ़ें।
इन कोर्सेज़ के साथ MongoDB और डेटाबेस के बारे में और जानें!
कोर्स
कोर्स
कोर्स