

什么是 Nano Banana 2 Lite?
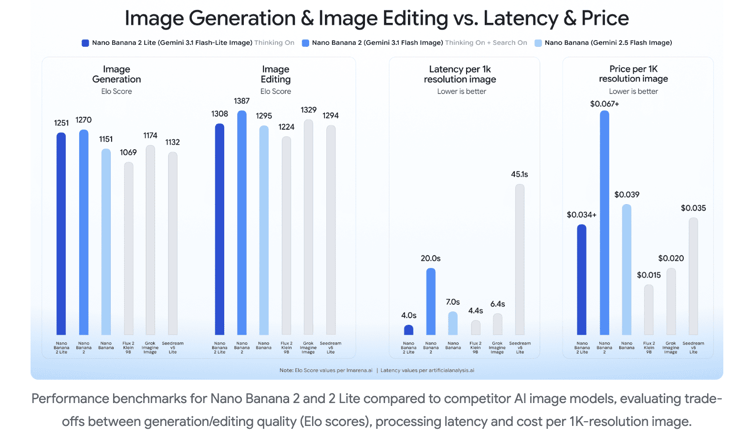
Nano Banana 2 Lite(gemini-3.1-flash-lite-image)是迄今为止 Google 速度最快、成本效益最高的图像生成模型。
它专为高速开发流水线和高吞吐应用而建,针对以低延迟与严格成本为主要约束的场景进行了优化。
对于目前使用 Google 旧版模型(gemini-2.5-flash-image)的平台,Nano Banana 2 Lite 可直接替换,并在速度、成本与视觉保真度上带来立竿见影的提升。
关键性能指标
- 超低延迟:约 4 秒即可完成文生图输出,适用于交互式原型和实时用户应用。
- 高性价比:每张 1K 分辨率图像定价 $0.034,大幅降低大规模生成的门槛。
- 质量保持:在追求速度的同时,模型依然具备良好的提示遵循度、角色一致性以及可靠的图内文字生成。
什么是 Gemini Omni Flash?
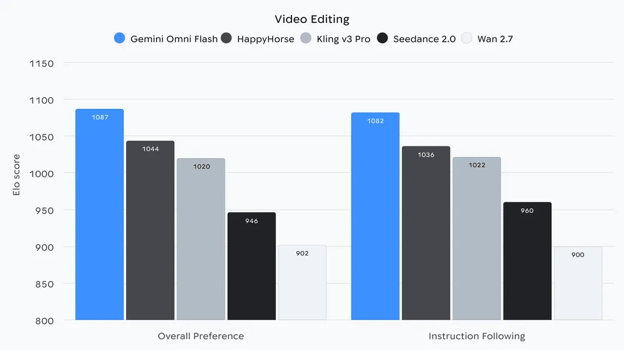
Gemini Omni Flash(gemini-omni-flash-preview)是 Google 面向视频生成与对话式视频编辑的高性价比模型。
不同于严格依赖静态文本提示的独立视频生成器,Omni Flash 将 Gemini 的核心多模态推理直接引入视频创作流程。
它原生接受文本、图像与视频的组合输入,让我们以前所未有的精度以编程方式控制视频生成。
Omni Flash 的核心能力与定价
- 具竞争力的定价:每秒视频输出 $0.10,和 Veo 3.1 Fast 相当。
- 对话式视频编辑:不必为小改动从头重生视频,应用可用自然语言指令对既有片段进行细化。
- 多模态引用:可将文本提示与参考图像或片段结合,确保视觉一致性并对场景元素进行精细控制。
- 真实世界基线:借助 Gemini 的基础知识,模型基于逻辑与物理构建逼真的动画。
- 文字与动作同步:通过简单提示将屏幕文字与图形叠加直接关联到视频动作。
如何生成并设置 Gemini API 密钥
在使用 Gemini API 之前,我们需要创建并设置一个 API 密钥,使代码可以与 API 通信。
最简单的方法是:
- 访问Google 的 AI Studio API 密钥页面并登录。
- 点击右上角的“Create API key(创建 API 密钥)”按钮。
- 将 API 密钥复制到与 Python 代码同一文件夹中的
.env文件,格式如下:
GEMINI_API_KEY=replace_with_api_key注意:使用 API 会产生费用。为此,我们需要在Google 的 AI Studio 结算页面配置支付方式。
如何在 Python 中使用 Nano Banana 2 Lite 生成图像
Python AI 图像生成的先决条件
在开始编写 Python AI 图像生成器之前,请确保已准备好以下工具:
- Python 3.9+ 已安装在系统中。
- Google Gemini API 密钥:有效的 Google Gemini API 密钥用于请求鉴权。参见上文步骤创建并配置密钥。
- 所需 Python 库:我们将使用官方
google-genaiSDK 进行 API 集成,并用 Pillow 处理图像输出。
可通过 pip 安装必要的 Python 包:
pip install google-genai pillow python-dotenv步骤 1:导入模块并加载环境变量
创建一个新文件(例如 generate_image.py),添加以下导入与加载流程来完成环境设置:
import io
from dotenv import load_dotenv
from google.genai import types
from PIL import Image
from google.genai import Client
# Load environment variables from the .env file
load_dotenv()步骤 2:初始化 Google GenAI 客户端
要与 Nano Banana 2 Lite 模型交互,我们首先需要初始化 Google GenAI 客户端。
由于 SDK 会自动从系统环境变量中读取 GEMINI_API_KEY(在上一步已从 .env 文件加载),因此我们可以在代码中不显式传入 API 密钥即可初始化客户端。
# Initialize the Gemini API client
client = Client()步骤 3:编写 AI 图像生成函数
接下来是 Python 脚本的核心逻辑。我们将编写一个独立的 Python 函数 generate_image(),传入已初始化的客户端与文本提示作为输入。
通过指定 model="gemini-3.1-flash-lite-image" 来调用 Nano Banana 2 Lite。我们配置 API 请求以期望图像模态,并指定所需的图像纵横比。
def generate_image(client, prompt: str, ratio: str = "1:1") -> Image.Image | None:
"""
Generates an AI image using the Nano Banana 2 Lite model via the Gemini API.
"""
print(f"Generating AI image for prompt: '{prompt}'...")
# 1. Call the Nano Banana 2 Lite model
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=prompt,
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=ratio),
),
)
# 2. Extract and convert the generated image data
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
# Load the bytes into a PIL Image and convert to RGB
image = Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return image
return None理解这次 Python 图像生成请求:
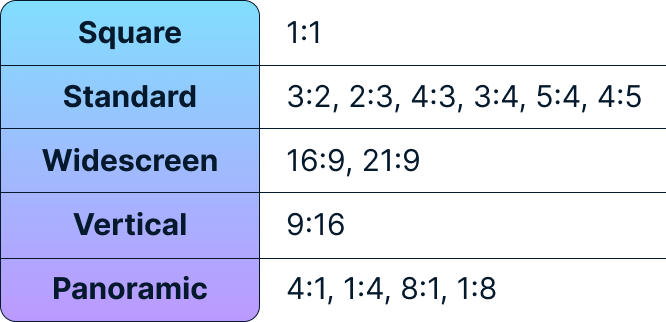
response_modalities:强制 Google Gemini 模型返回图像而非文本。inline_data:Gemini API 以原始字节形式返回生成的图像。我们使用 Python 的io.BytesIO包装这些字节,以便 Pillow(Image.open)将其读取为标准图像文件。image_config:我们将aspect_ratio设为 "1:1"(方形),您可根据具体应用场景轻松调整。
支持的纵横比:
步骤 4:运行 Python 图像生成脚本
让我们把所有部分组合起来,让 Nano Banana 2 Lite 生成一张图像!
我们将给出一个具创意的提示,对结果图像调用 show() 函数以查看 AI 生成的作品,并关闭客户端释放资源。
if __name__ == "__main__":
# Define our creative prompt for the AI model
my_prompt = "A futuristic city skyline at sunset, cyberpunk style, highly detailed"
# Generate the AI image
result_image = generate_image(client, my_prompt)
# Display the resulting image
if result_image:
print("AI Image generated successfully!")
result_image.show()
else:
print("Failed to generate AI image.")
# Close the client to prevent shutdown exceptions
client.close()以下是 Nano Banana 2 Flash 生成的图像:
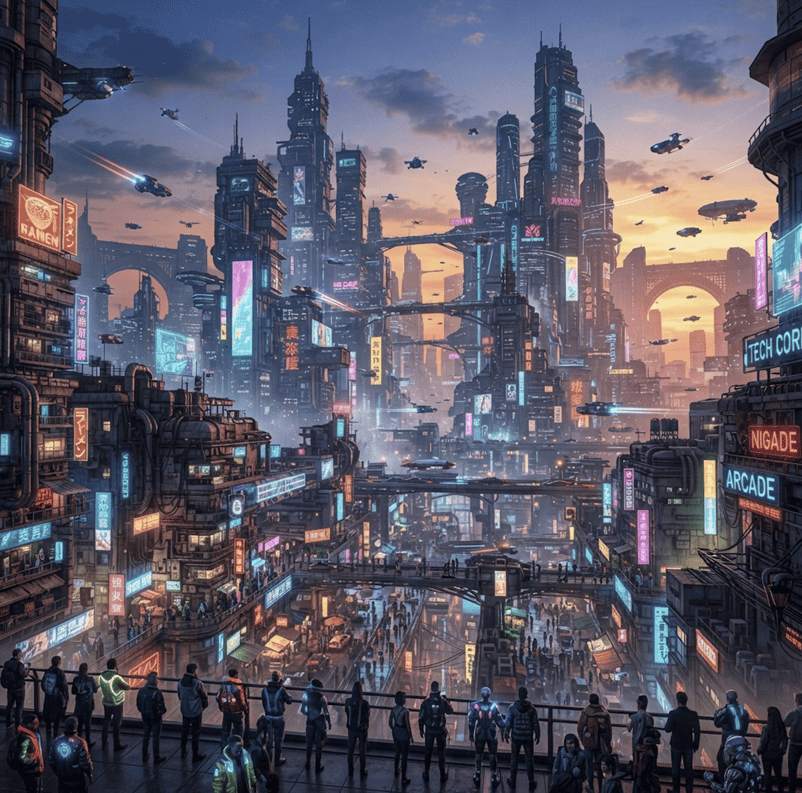
正如 Google 在公告中承诺的那样,模型只用了几秒钟就生成了图像。第一印象确实比我目前尝试过的其他模型快得多。
完整脚本可在generate_image.py(本教程仓库)中找到。
扩展脚本以进行图像编辑
我们来编写一个 edit_image() 函数用于编辑图像。唯一需要更改的是:在请求中将图像与提示一并通过 contents 参数以列表 [image, prompt] 形式提供。
def edit_image(client, image: Image.Image, prompt: str, aspect_ratio: str = "1:1") -> Image.Image | None:
"""
Edits an AI image using the Gemini 3.1 Flash Lite model via the Gemini API.
"""
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=[image, prompt],
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=aspect_ratio),
),
)
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
return Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return None测试 Nano Banana 2 Flash
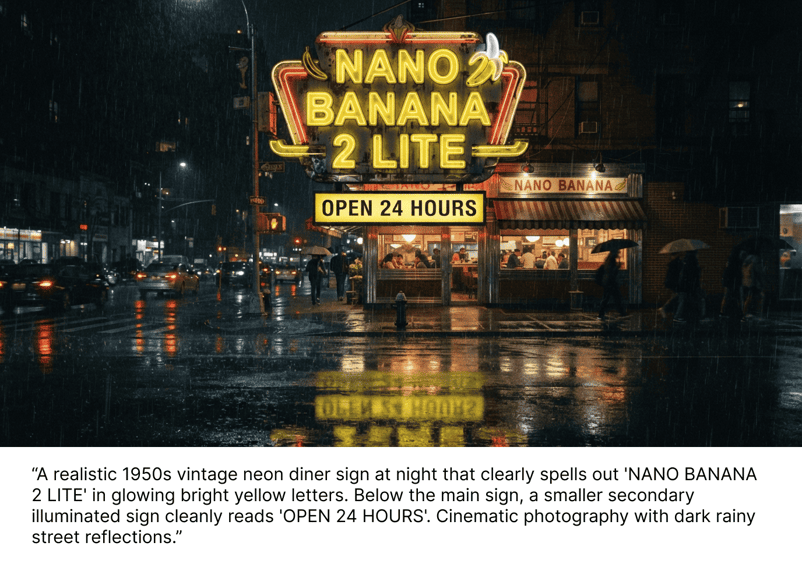
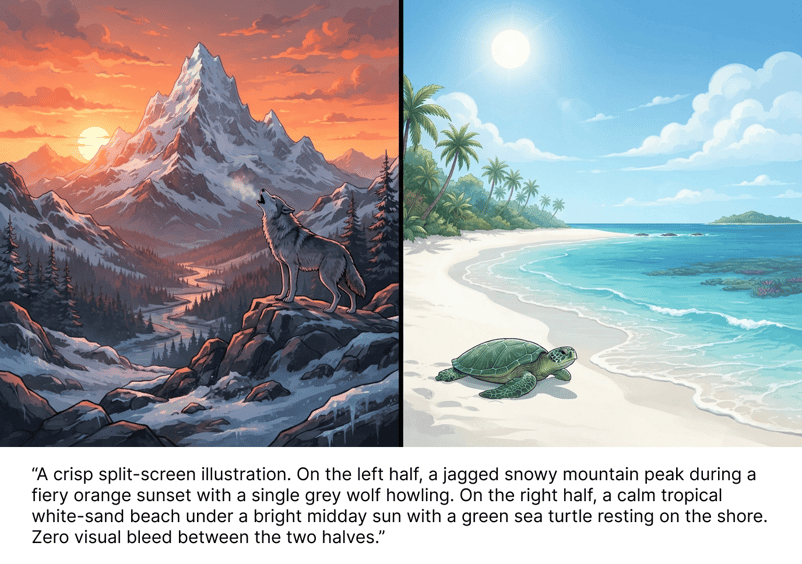
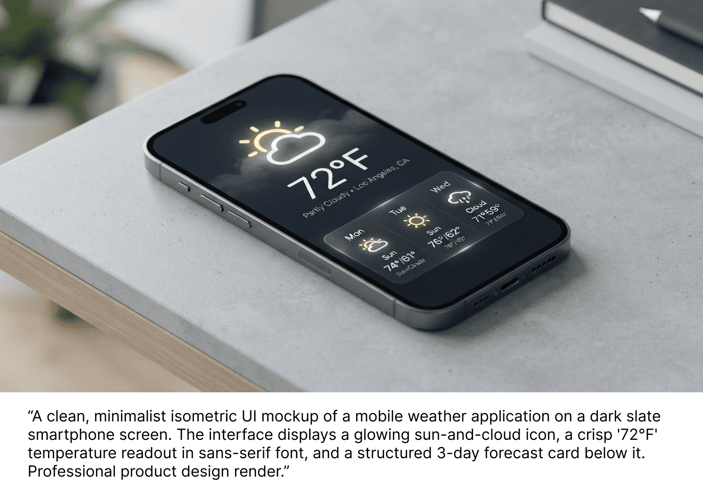
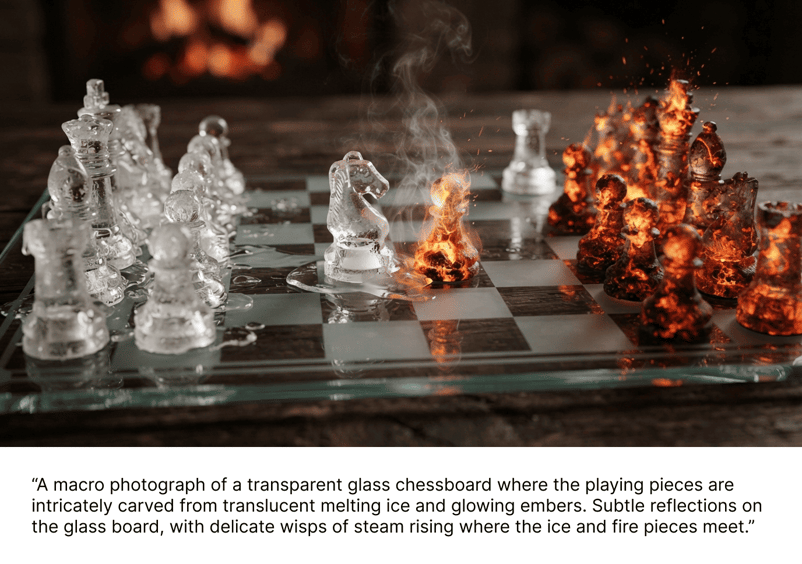
我们通过一系列有针对性的压力测试来评估该模型的真实世界表现。
重点考察其处理复杂视觉任务的能力,例如清晰的图内文字渲染、严格的空间布局保持,以及在多轮交互中的一致性,以判断它是否真正实现了高速生成下的高保真承诺。
测试图内文字的可读性渲染
测试严格空间控制与双主体遵循
测试快速 UI 原型与布局精度
测试复杂材质对比与光照
测试多轮交互中的角色一致性
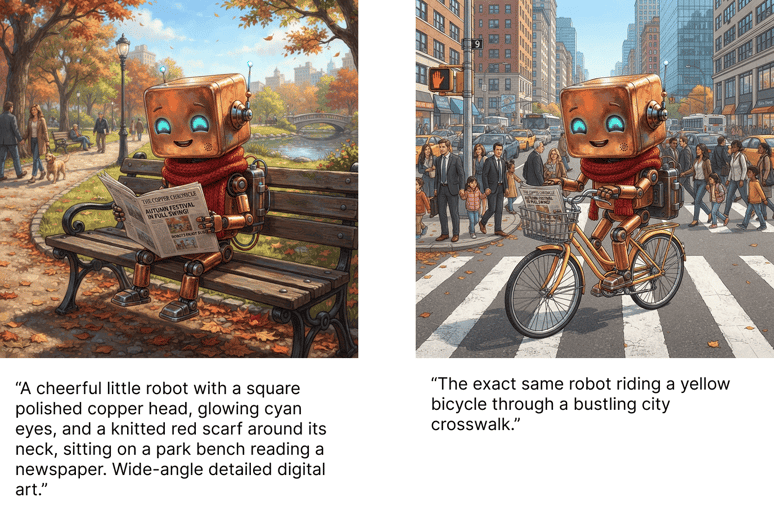
坦白说,以如此高速的模型而言,这些结果让我印象深刻。在最后一个示例中,模型甚至在一定程度上保持了报纸中文本的一致性。
以我的经验来看,要让图像生成模型真正有用,一致性是最重要的能力之一。
如何在 Python 中使用 Gemini Omni Flash 生成视频
本节将演示如何编写一个 Python 脚本来生成视频,从简单的文生视频开始,再扩展到引入参考图像。
与标准图像生成不同,使用 Gemini Omni Flash 生成视频是通过 SDK 的 Interactions API(client.interactions.create)完成的。该端点专为处理丰富的多轮、多模态交互而设计。
由于所需的 SDK 导入、环境变量设置与 Google GenAI 客户端初始化与上一节图像生成过程相同,我们可以直接专注于编写视频生成函数。
步骤 1:文生视频(简单的提示生成视频)
仅根据文本提示生成视频时,我们向 Interactions API 传入单个文本输入块。可以编写一个简单的 Python 函数来处理:
def text_to_video(client, prompt: str, aspect_ratio: str = "16:9", duration: str = "5s"):
"""
Generates a video from a text prompt using Gemini Omni Flash.
"""
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=[{"type": "text", "text": prompt}],
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
"duration": duration,
},
)
return interaction我们可以调用该函数并将返回的视频字节保存为文件,如下所示:
if __name__ == "__main__":
import base64
# Define a creative video prompt
text_prompt = """
Generate a first person view of what daily life would look like in the year
1000 at this location: 41.89030621184054, 12.492266126772481
"""
# Call the video generator
interaction = text_to_video(
client=client,
prompt=text_prompt,
aspect_ratio="16:9",
duration="5s"
)
# Extract and save the generated video file
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
# Decode the base64-encoded video data returned by the API
video_bytes = base64.b64decode(interaction.output_video.data)
# Save the bytes locally as an MP4 file
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)
else:
print("Failed to generate video.")我们使用的提示是:
Generate a first-person view of what daily life would look like in the year 1000 at this location: 41.89030621184054, 12.492266126772481该具体位置是罗马斗兽场。我使用坐标来测试模型的世界知识。以下是生成的视频:
相较之下,当我把年份从 1000 年改为 1980 年时,模型生成了如下内容:
在我看来相当有意思。查看text_to_video.py 文件以获取完整脚本。
步骤 2:实现图像转视频能力
要为静态图像添加动画,或将其用作驱动视频生成的参考,我们必须同时向模型传入图像和文本提示。
由于 Interactions API 期望图像输入为 base64 编码,我们先定义一个辅助函数,将 PIL Image 对象转换为 base64 字符串:
import io
from PIL import Image
import base64
def _image_to_base64(img: Image.Image) -> str:
"""
Converts a PIL Image object to a base64-encoded string.
"""
buffered = io.BytesIO()
img.save(buffered, format="PNG")
return base64.b64encode(buffered.getvalue()).decode()现在,我们可以构建一个更通用的函数 generate_video(),同时处理可选图像与文本提示。
from google.genai import types
def generate_video(client, valid_images: list[Image.Image], animation_prompt: str, aspect_ratio: str):
"""
Generates a commercial-quality AI video using Google's Gemini Omni Flash model.
Supports image-to-video and text-to-video multimodal inputs using the Gemini API.
"""
omni_inputs = []
# 1. Base64 encode and append any input images
for img in valid_images:
img_b64 = _image_to_base64(img)
omni_inputs.append({
"type": "image",
"data": img_b64,
"mime_type": "image/png",
})
# 2. Append the text animation prompt
omni_inputs.append({"type": "text", "text": animation_prompt})
# 3. Request video generation from the interactions endpoint
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=omni_inputs,
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
},
)
return interaction最后,以下展示如何使用这些函数,为我用 Gemini 生成的这只甲虫图像制作动画视频:
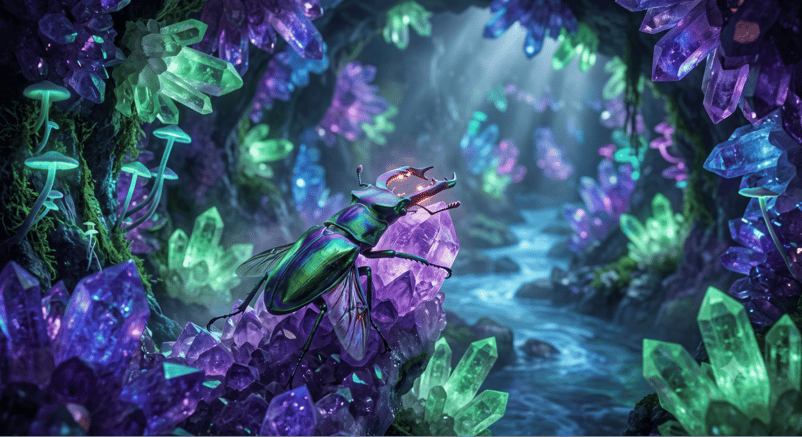
if __name__ == "__main__":
# Load our reference image
reference_image = Image.open("images/beetle.png").convert("RGB")
# Describe how we want the image to be animated
animation_prompt = """
A detailed, close-up photograph of an iridescent biomechanical stag beetle,
shimmering with metallic green, blue, and violet hues, as it traverses a
rugged amethyst crystal formation in a subterranean grotto.
The cavern walls are lined with a dense matrix of glowing crystals emitting
deep purple, blue, and green light. The air is misty, with bioluminescent
flora clinging to the rock. As the camera maintains focus, the beetle
subtly activates a soft internal orange glow from its mandibles, begins
vibrating its wings, and slowly crawls upward across the crystalline
surface, reflecting the surrounding light.
"""
# Call the generator with the reference image
interaction = generate_video(
client=client,
valid_images=[reference_image],
animation_prompt=animation_prompt,
aspect_ratio="16:9"
)
# Extract and save the animated video
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
video_bytes = base64.b64decode(interaction.output_video.data)
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)这是生成的视频:
完整脚本见此处。
步骤 3:实现视频转视频的编辑
借助 Gemini Omni Flash API 的交互机制,对视频进行对话式编辑变得非常容易。生成视频时,我们会获得一个交互标识符,可通过 interaction.id 访问。
要编辑视频,我们提供一个提示和前一交互的标识符。若是第一次编辑,就提供生成视频时对应交互的标识符;后续编辑则提供上一次编辑的交互标识符。
client.interactions.create(
model="gemini-omni-flash-preview",
input=edit_prompt,
previous_interaction_id=previous_interaction_id,
)构建交互式 AI 视频工作室:架构与多模型协同
在前面几节中,我们学会了如何使用 Nano Banana 2 Lite 以编程方式生成图像,以及使用 Gemini Omni Flash 生成视频。现在,我们将把这些能力整合到一个统一的交互式 Web 应用中:AI 视频工作室。
AI 视频工作室的架构
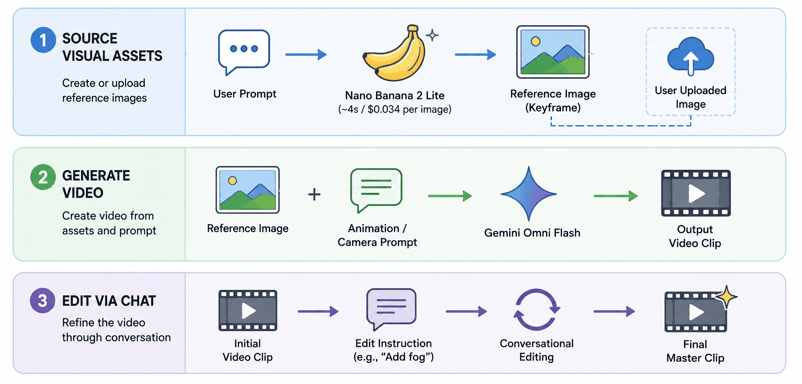
高质量 AI 视频的创作通常需要大量试错。AI 视频工作室通过实现一个两阶段、多模型的管道来解决这一问题,充分发挥两类模型的独特优势:
- 素材获取:由 Nano Banana 2 Lite 驱动,用户可快速生成资源与参考图像,并与已有图片组合。
- 视频生成:我们使用 Gemini Omni Flash 根据这些素材生成视频。
- 视频编辑:视频生成后,可以通过对话式方式进行编辑。
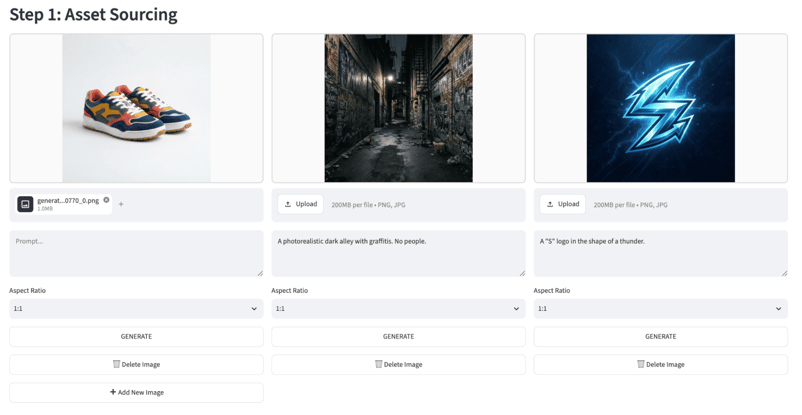
阶段一:使用 Nano Banana 2 Lite 快速原型
在第一阶段,应用允许我们获取参考图像(关键帧)。我们既可以上传本地图像,也可以即时生成。
这正是 Nano Banana 2 Lite 的强项。
不到 4 秒的延迟、每张图仅几美分的一小部分成本,使其成为超快的沙盒环境。我们可以快速打样数十种不同的视觉风格、构图和主题,直到获得理想的关键帧。
阶段二:使用 Gemini Omni Flash 进行多模态生成
当我们获得理想的参考图像后,即可进入视频制作阶段。
参考图像与动画提示(例如描述镜头运动、光线变化或动作)将以 base64 编码,并通过 SDK 的 Interactions API 发送至 Gemini Omni Flash。
Gemini Omni Flash 对这些输入进行处理,并返回高保真视频片段,支持横屏(16:9)或竖屏(9:16)格式。
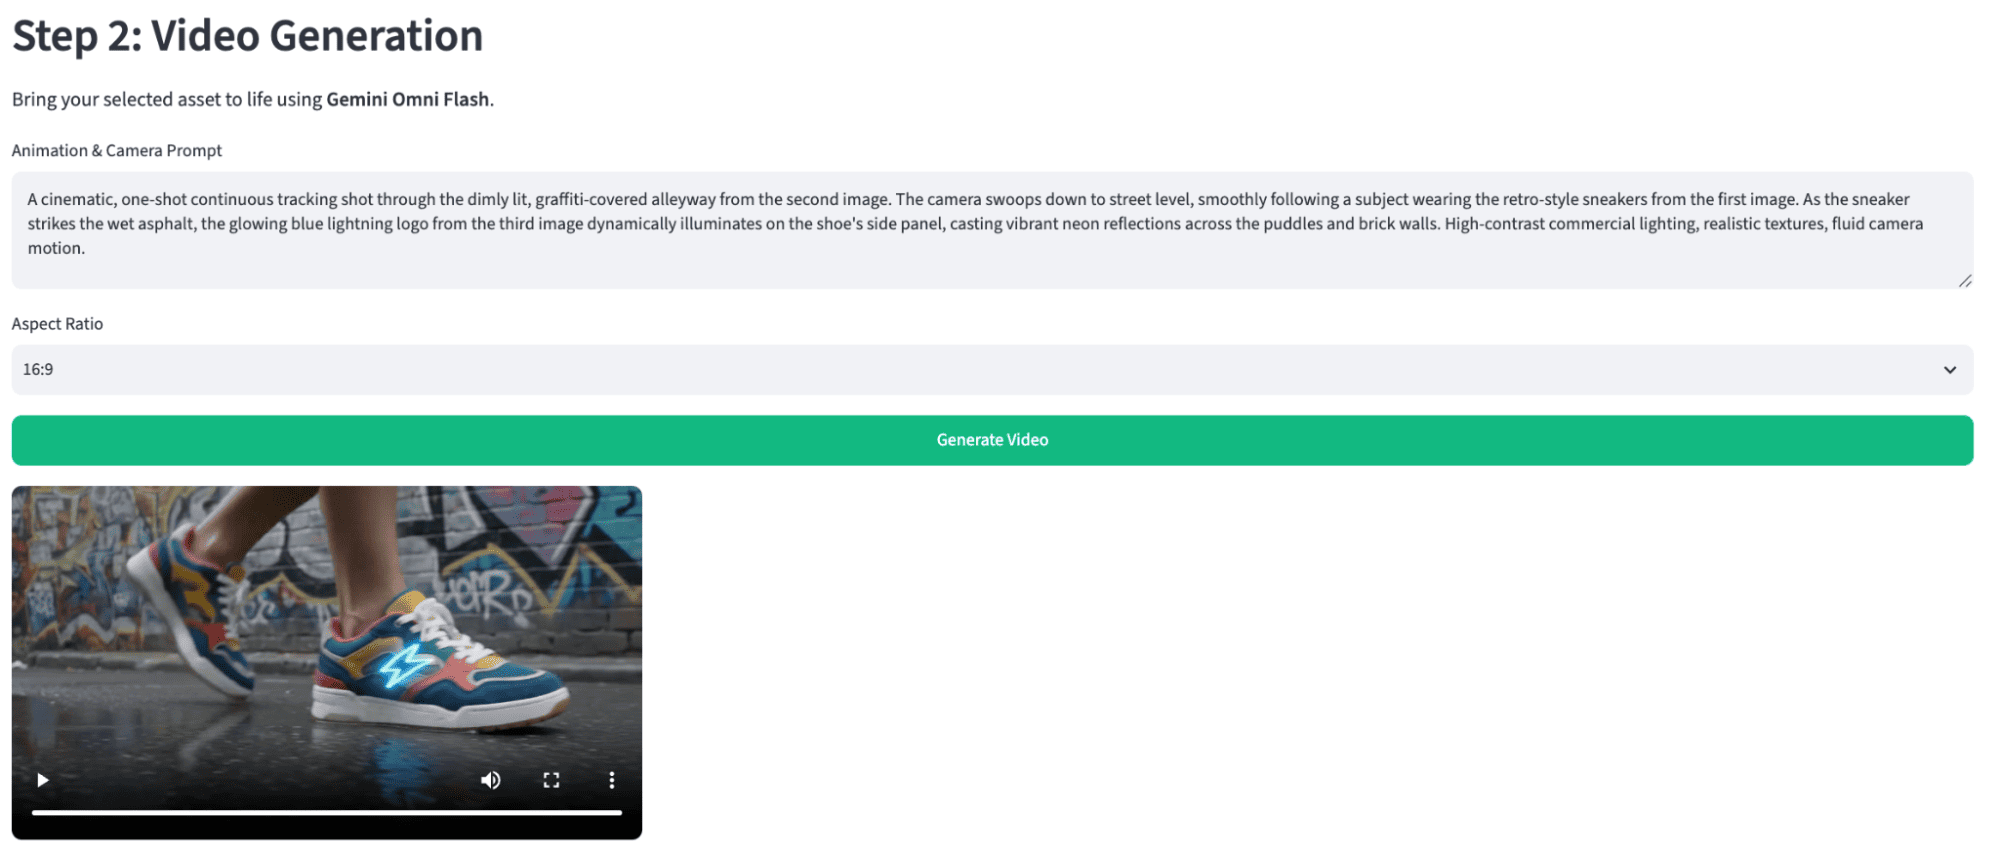
这是我们得到的视频:
Streamlit 视频生成应用的实现
我们使用 Streamlit 构建用户界面。它是一个广受欢迎的开源 Python 框架,可极其轻松地构建可分享的机器学习与数据科学 Web 应用。
如果您是 Streamlit 新手或需要回顾其工作方式,强烈建议阅读这篇Python Streamlit 教程。
我们不聚焦于 Streamlit 的 UI 代码本身,而是关注视频生成管道的架构,并探索将这两款强大模型结合的创作潜力。
上述用于生成图像与视频的函数位于gemini_api.py 脚本中。用户界面使用 Streamlit 在app.py 脚本中实现。
如果您想在本地运行并进行实验,请执行以下操作:
git clone [email protected]:fran-aubry/nano-banana-2-flash-tutorial.git
pip install -r requirement.txt
streamlit run app.py下面是一个完整的工作流示例:将一张虚构茶饮品牌的现有图片与生成的茶园图像结合,制作该茶罐的商业镜头。
随后我们再通过提示编辑该视频。
视频生成过程中的片段已做加速处理,因为生成可能需要几分钟。
结论
Google 对其新模型 Nano Banana 2 Lite 的速度宣称属实。
该模型速度极快,正逐步接近实时生成图像的能力。尽管其生成的图像质量不错,但称不上颠覆性。它的主要创新无疑在于令人印象深刻的速度,而非突破性的图像质量。
当二者搭配使用时,Gemini Omni Flash 与 Nano Banana 2 Lite 能构成强大的管道。Omni 模型在保持对参考素材的忠实度方面尤其出色。
如需进一步了解 Nano Banana 2,请阅读这篇文章:Nano Banana 2:Python 全面指南。
若想更深入了解 Gemini Omni 系列,推荐阅读Gemini Omni:一款覆盖文本、图像、音频与视频的模型。
FAQs
Nano Banana 2 Lite 和 Gemini Omni Flash 的用途有何不同?
Nano Banana 2 Lite 专注于高速、低成本的图像生成(适合快速原型),而 Gemini Omni Flash 面向多模态视频生成与对话式视频编辑。
我可以不从头开始就编辑视频吗?
可以。Gemini Omni Flash 支持对话式视频编辑。您只需提供一个提示以及前一次交互的 ID,即可使用自然语言对现有视频片段进行细化。
Nano Banana 2 Lite 是否适用于实时用户应用?
其延迟约为每张图 4 秒,专为以速度与预算为首要约束的交互式应用而构建。
这些模型的主要成本考量是什么?
两款模型都以成本效益为优先。Nano Banana 2 Lite 每张 1K 分辨率图像为 $0.034;Gemini Omni Flash 每秒视频输出为 $0.10,适合高吞吐管道。

Google 近日发布了 Nano Banana 2 Lite 和 Gemini Omni Flash,这两款模型旨在重新定义 AI 开发中的速度与多模态能力。
它们提供了超低延迟的图像生成与灵活的对话式视频编辑的强大组合。
在本文中,我将探讨这些模型的核心能力,并构建一个完整的 AI 视频编辑管道:用户先用 Nano Banana 2 Lite 选择并生成图像,再将其合成为视频。
以下是我们将要构建的应用的演示视频: