

O que é o Nano Banana 2 Lite?
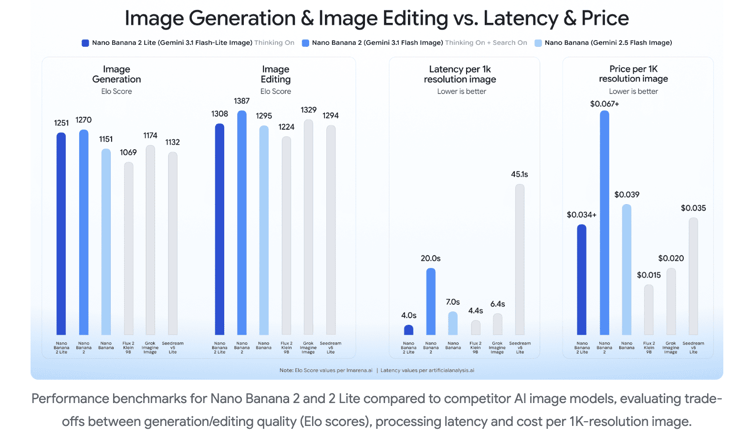
O Nano Banana 2 Lite (gemini-3.1-flash-lite-image) é o modelo de geração de imagens mais rápido e econômico do Google até agora.
Criado especificamente para pipelines de desenvolvimento de alta velocidade e aplicações de alto throughput, ele é otimizado para cenários em que baixa latência e orçamento enxuto são requisitos primários.
Para plataformas que usam o modelo legado do Google (gemini-2.5-flash-image), o Nano Banana 2 Lite funciona como um substituto direto, trazendo melhorias imediatas em velocidade, custo e fidelidade visual.
Principais métricas de performance
- Latência ultrabaixa: entrega resultados de texto para imagem em aproximadamente 4 segundos, ideal para prototipagem interativa e apps em tempo quase real.
- Custo-benefício: preço de US$ 0,034 por imagem em resolução 1K, reduzindo significativamente a barreira para geração em alto volume.
- Qualidade consistente: mesmo priorizando velocidade, o modelo mantém boa aderência ao prompt, consistência de personagens e geração confiável de texto dentro da imagem.
O que é o Gemini Omni Flash?
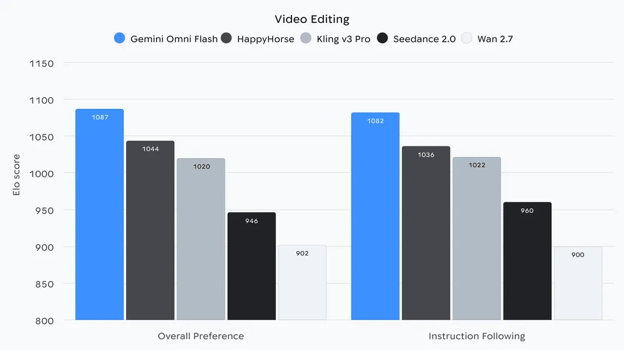
O Gemini Omni Flash (gemini-omni-flash-preview) é o modelo econômico do Google para geração de vídeos e edição de vídeo conversacional.
Diferente de geradores de vídeo autônomos que dependem apenas de prompts de texto estáticos, o Omni Flash leva o raciocínio multimodal central do Gemini diretamente para o processo de criação do vídeo.
Ele aceita nativamente combinações de entradas de texto, imagem e vídeo, permitindo controle programático sobre a geração com uma precisão sem precedentes.
Recursos centrais e preços do Omni Flash
- Preço competitivo: US$ 0,10 por segundo de vídeo gerado, equiparando a taxa do Veo 3.1 Fast.
- Edição de vídeo conversacional: em vez de regenerar vídeos do zero para pequenos ajustes, os apps podem usar instruções em linguagem natural para refinar sequências existentes.
- Referência multimodal: prompts de texto podem ser combinados com imagens ou clipes de referência para garantir consistência visual e controle granular dos elementos de cena.
- Aderência ao mundo real: aproveitando o conhecimento de base do Gemini, o modelo constrói animações realistas baseadas em lógica e física.
- Sincronização de texto e ação: textos na tela e overlays gráficos podem ser vinculados diretamente às ações do vídeo com prompts simples.
Como gerar e configurar uma chave da API do Gemini
Antes de usar a API do Gemini, precisamos criar e configurar uma chave de API para que nosso código se comunique com a API.
A forma mais simples de fazer isso é:
- Acesse a página de chaves da API do AI Studio do Google e faça login.
- Clique no botão “Create API key” no canto superior direito.
- Copie a chave de API para um arquivo chamado
.envna mesma pasta do código Python, no seguinte formato:
GEMINI_API_KEY=replace_with_api_keyObservação: o uso da API gera custos. Para utilizá-la, garanta que há um método de pagamento configurado na página de cobrança do AI Studio do Google.
Como gerar imagens com o Nano Banana 2 Lite em Python
Pré-requisitos para geração de imagens com IA em Python
Antes de começar a codar nosso gerador de imagens em Python, confira se as seguintes ferramentas estão prontas:
- Python 3.9+ instalado no sistema.
- Chave da API do Google Gemini: uma chave válida do Google Gemini para autenticar as requisições. Veja acima como criar e configurar a chave.
- Bibliotecas Python necessárias: usaremos o SDK oficial
google-genaipara integração com a API e Pillow para manipular a imagem gerada.
Instale os pacotes necessários com pip:
pip install google-genai pillow python-dotenvPasso 1: importando módulos e carregando variáveis de ambiente
Crie um novo arquivo (por exemplo, generate_image.py) e adicione as importações abaixo, além do carregamento do ambiente:
import io
from dotenv import load_dotenv
from google.genai import types
from PIL import Image
from google.genai import Client
# Load environment variables from the .env file
load_dotenv()Passo 2: inicializando o cliente Google GenAI
Para interagir com o modelo Nano Banana 2 Lite, primeiro precisamos inicializar o cliente Google GenAI.
Como o SDK verifica automaticamente a variável de ambiente do sistema GEMINI_API_KEY (carregada do arquivo .env no passo anterior), podemos inicializar o cliente sem passar a chave explicitamente no código.
# Initialize the Gemini API client
client = Client()Passo 3: escrevendo a função de geração de imagem com IA
Agora, a lógica central do nosso script. Vamos escrever uma função Python dedicada, generate_image(), que recebe o cliente inicializado e um prompt de texto como entradas.
O Nano Banana 2 Lite é chamado especificando model="gemini-3.1-flash-lite-image". Configuramos a requisição para esperar a modalidade imagem e definimos a proporção desejada para a geração.
def generate_image(client, prompt: str, ratio: str = "1:1") -> Image.Image | None:
"""
Generates an AI image using the Nano Banana 2 Lite model via the Gemini API.
"""
print(f"Generating AI image for prompt: '{prompt}'...")
# 1. Call the Nano Banana 2 Lite model
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=prompt,
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=ratio),
),
)
# 2. Extract and convert the generated image data
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
# Load the bytes into a PIL Image and convert to RGB
image = Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return image
return NoneEntendendo a requisição de geração de imagem em Python:
response_modalities: força o modelo Google Gemini a retornar uma imagem em vez de texto.inline_data: a API do Gemini retorna a imagem gerada como bytes brutos. Usamosio.BytesIOpara empacotar esses bytes e o Pillow (Image.open) ler como um arquivo de imagem padrão.image_config: definimos oaspect_ratiocomo "1:1" (quadrado), mas isso pode ser ajustado para o caso de uso específico.
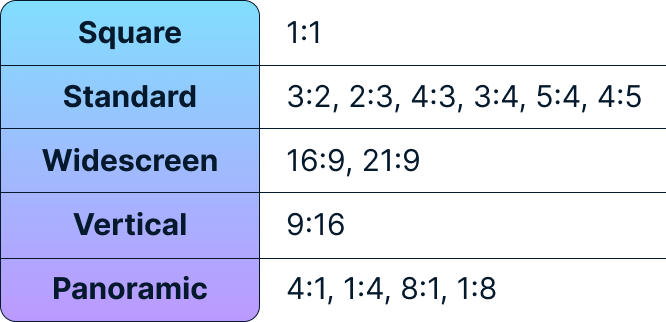
Proporções suportadas:
Passo 4: executando o script de geração de imagem em Python
Vamos juntar tudo e pedir para o Nano Banana 2 Lite gerar uma imagem!
Vamos enviar um prompt criativo, chamar a função show() na imagem resultante para visualizar a arte gerada com IA e fechar o cliente para liberar recursos.
if __name__ == "__main__":
# Define our creative prompt for the AI model
my_prompt = "A futuristic city skyline at sunset, cyberpunk style, highly detailed"
# Generate the AI image
result_image = generate_image(client, my_prompt)
# Display the resulting image
if result_image:
print("AI Image generated successfully!")
result_image.show()
else:
print("Failed to generate AI image.")
# Close the client to prevent shutdown exceptions
client.close()Veja a imagem gerada pelo Nano Banana 2 Flash:
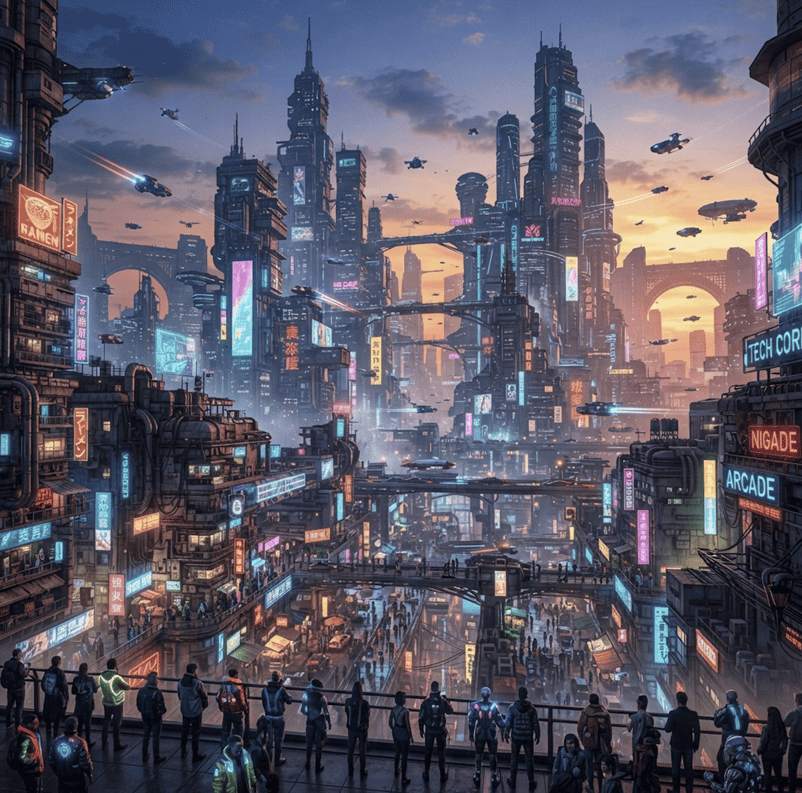
Como o Google prometeu no anúncio, o modelo levou apenas alguns segundos para gerar a imagem. À primeira vista, parece bem mais rápido do que qualquer outro que testei até agora.
O script completo está no generate_image.py do repositório deste tutorial.
Estendendo o script para edição de imagem
Vamos escrever uma função edit_image() para editar uma imagem. A única mudança na requisição é fornecer a imagem junto com o prompt no parâmetro contents como uma lista [image, prompt].
def edit_image(client, image: Image.Image, prompt: str, aspect_ratio: str = "1:1") -> Image.Image | None:
"""
Edits an AI image using the Gemini 3.1 Flash Lite model via the Gemini API.
"""
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=[image, prompt],
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=aspect_ratio),
),
)
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
return Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return NoneTestando o Nano Banana 2 Flash
Avaliamos o desempenho do modelo no mundo real conduzindo uma série de testes de estresse direcionados.
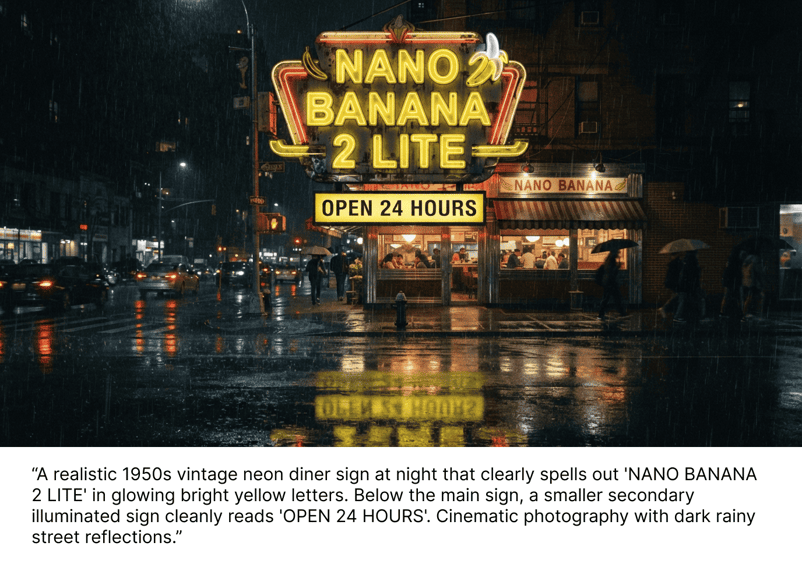
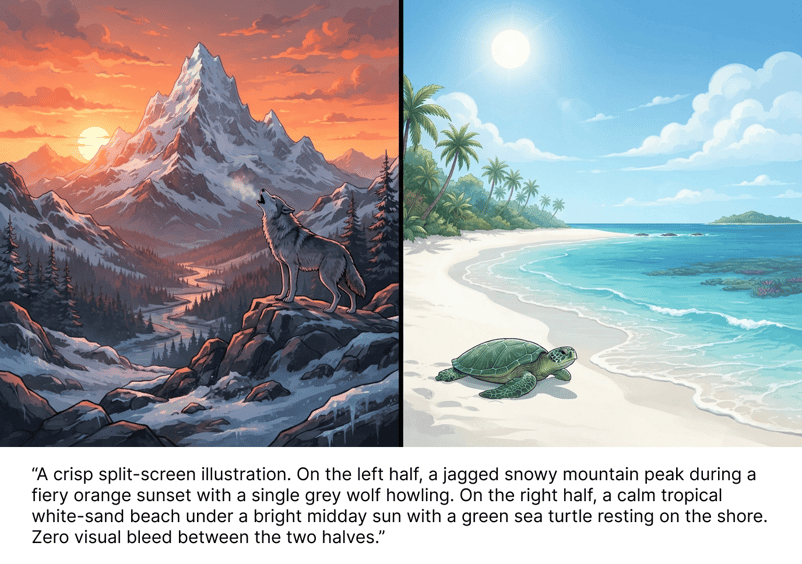
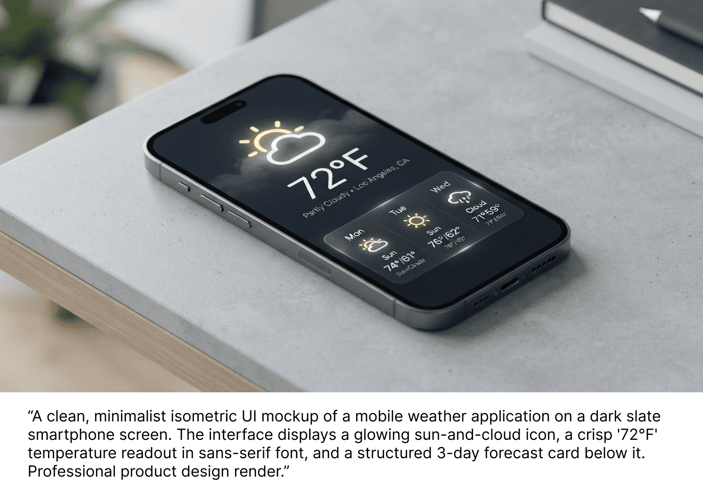
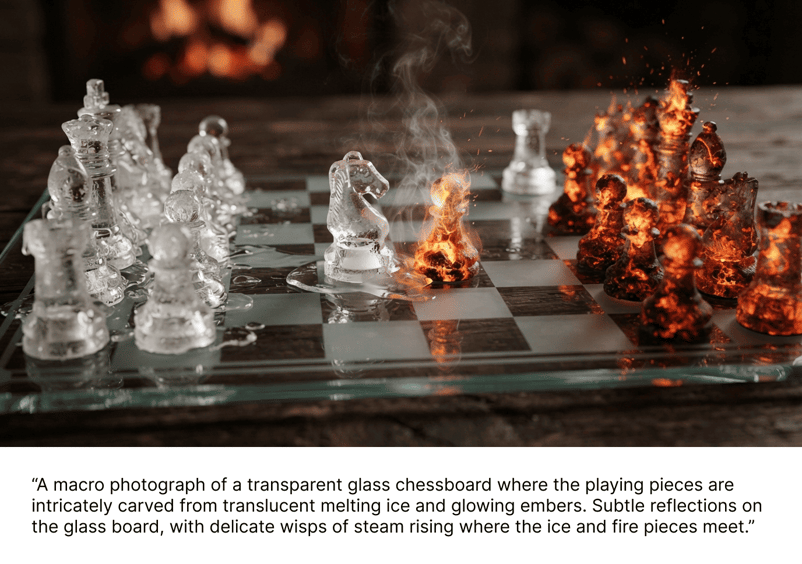
Essas avaliações focam na capacidade do modelo de lidar com tarefas visuais complexas, como renderizar texto legível, manter layout espacial rigoroso e garantir consistência em interações de múltiplas etapas, para verificar se ele realmente cumpre a promessa de alta fidelidade com alta velocidade.
Teste de renderização de texto legível dentro da imagem
Teste de controle espacial rigoroso e aderência a dois sujeitos
Teste de prototipagem rápida de UI e precisão de layout
Teste de contrastes de materiais complexos e iluminação
Teste de consistência de personagem em múltiplas etapas
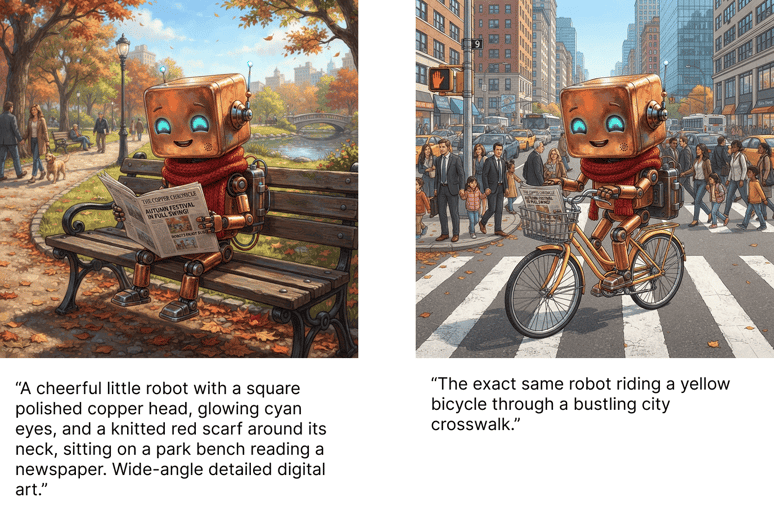
Sinceramente, fiquei bem impressionado com os resultados para um modelo tão rápido. No último exemplo, o modelo até conseguiu manter, de certa forma, a consistência do texto no jornal.
Na minha experiência, consistência é um dos fatores mais importantes que um modelo de geração de imagens precisa acertar para ser realmente útil.
Como gerar vídeos com o Gemini Omni Flash em Python
Nesta seção, vamos ver como criar um script em Python para gerar vídeos, começando com um simples prompt de texto para vídeo e depois incluindo imagens de referência.
Diferente da geração de imagens padrão, a geração de vídeos com o Gemini Omni Flash é feita pela Interactions API do SDK (client.interactions.create). Esse endpoint foi projetado para lidar com interações ricas, multimodais e de múltiplas etapas.
Como as importações, a configuração de variáveis de ambiente e a inicialização do cliente Google GenAI são idênticas ao processo de imagens descrito antes, podemos focar diretamente nas funções de geração de vídeo.
Passo 1: texto para vídeo (prompt simples)
Para gerar um vídeo apenas a partir de um prompt de texto, passamos um único bloco de texto para a Interactions API. Podemos escrever uma função simples para isso:
def text_to_video(client, prompt: str, aspect_ratio: str = "16:9", duration: str = "5s"):
"""
Generates a video from a text prompt using Gemini Omni Flash.
"""
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=[{"type": "text", "text": prompt}],
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
"duration": duration,
},
)
return interactionPodemos chamar essa função e salvar os bytes do vídeo retornado em um arquivo, assim:
if __name__ == "__main__":
import base64
# Define a creative video prompt
text_prompt = """
Generate a first person view of what daily life would look like in the year
1000 at this location: 41.89030621184054, 12.492266126772481
"""
# Call the video generator
interaction = text_to_video(
client=client,
prompt=text_prompt,
aspect_ratio="16:9",
duration="5s"
)
# Extract and save the generated video file
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
# Decode the base64-encoded video data returned by the API
video_bytes = base64.b64decode(interaction.output_video.data)
# Save the bytes locally as an MP4 file
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)
else:
print("Failed to generate video.")O prompt que usamos foi:
Generate a first-person view of what daily life would look like in the year 1000 at this location: 41.89030621184054, 12.492266126772481Esse local específico é o Coliseu Romano. Usei coordenadas para testar o conhecimento de mundo do modelo. Este foi o vídeo gerado:
Em contraste, veja o que o modelo gerou quando troquei o ano 1000 por 1980:
Bem interessante, na minha opinião. Confira o arquivo text_to_video.py para ver o script completo.
Passo 2: implementando recursos de imagem para vídeo
Para animar uma imagem estática ou usá-la como referência para orientar a geração, precisamos enviar tanto a imagem quanto um prompt de texto ao modelo.
Como a Interactions API espera imagens em base64, primeiro definimos uma função auxiliar para converter objetos PIL Image em strings base64:
import io
from PIL import Image
import base64
def _image_to_base64(img: Image.Image) -> str:
"""
Converts a PIL Image object to a base64-encoded string.
"""
buffered = io.BytesIO()
img.save(buffered, format="PNG")
return base64.b64encode(buffered.getvalue()).decode()Agora, podemos criar uma função mais geral, generate_video(), que trata imagens opcionais e o prompt de texto.
from google.genai import types
def generate_video(client, valid_images: list[Image.Image], animation_prompt: str, aspect_ratio: str):
"""
Generates a commercial-quality AI video using Google's Gemini Omni Flash model.
Supports image-to-video and text-to-video multimodal inputs using the Gemini API.
"""
omni_inputs = []
# 1. Base64 encode and append any input images
for img in valid_images:
img_b64 = _image_to_base64(img)
omni_inputs.append({
"type": "image",
"data": img_b64,
"mime_type": "image/png",
})
# 2. Append the text animation prompt
omni_inputs.append({"type": "text", "text": animation_prompt})
# 3. Request video generation from the interactions endpoint
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=omni_inputs,
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
},
)
return interactionPor fim, veja como usar essas funções para gerar um vídeo que anima este besouro que gerei com o Gemini:
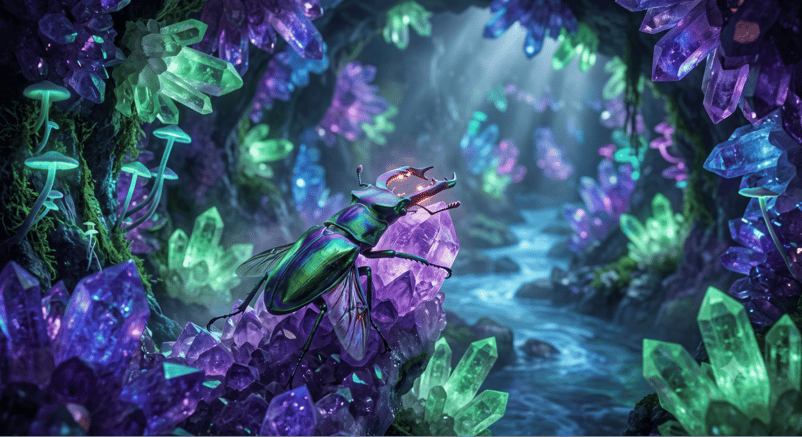
if __name__ == "__main__":
# Load our reference image
reference_image = Image.open("images/beetle.png").convert("RGB")
# Describe how we want the image to be animated
animation_prompt = """
A detailed, close-up photograph of an iridescent biomechanical stag beetle,
shimmering with metallic green, blue, and violet hues, as it traverses a
rugged amethyst crystal formation in a subterranean grotto.
The cavern walls are lined with a dense matrix of glowing crystals emitting
deep purple, blue, and green light. The air is misty, with bioluminescent
flora clinging to the rock. As the camera maintains focus, the beetle
subtly activates a soft internal orange glow from its mandibles, begins
vibrating its wings, and slowly crawls upward across the crystalline
surface, reflecting the surrounding light.
"""
# Call the generator with the reference image
interaction = generate_video(
client=client,
valid_images=[reference_image],
animation_prompt=animation_prompt,
aspect_ratio="16:9"
)
# Extract and save the animated video
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
video_bytes = base64.b64decode(interaction.output_video.data)
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)Este foi o vídeo gerado:
O script completo está disponível aqui.
Passo 3: implementando edição de vídeo com vídeo para vídeo
Editar um vídeo de forma conversacional com a API do Gemini Omni Flash fica muito simples graças ao uso de interações. Ao gerar um vídeo, recebemos um identificador de interação acessível como interaction.id.
Para editar um vídeo, fornecemos um prompt e o identificador da interação anterior. Se for a primeira edição, passamos o ID da interação usada para gerar o vídeo. Para edições subsequentes, usamos o ID da edição anterior.
client.interactions.create(
model="gemini-omni-flash-preview",
input=edit_prompt,
previous_interaction_id=previous_interaction_id,
)Criando um estúdio de vídeo com IA interativo: arquitetura e sinergia entre modelos
Nas seções anteriores, aprendemos a gerar imagens com o Nano Banana 2 Lite e vídeos com o Gemini Omni Flash de forma programática. Agora, vamos unir essas capacidades em um app web interativo e coeso: um Estúdio de Vídeo com IA.
A arquitetura do Estúdio de Vídeo com IA
Criar vídeos de alta qualidade com IA geralmente exige muita tentativa e erro. O Estúdio de Vídeo com IA resolve isso com um pipeline multimodelo em duas etapas que aproveita pontos fortes distintos de cada modelo:
- Criação de assets: com o Nano Banana 2 Lite, o usuário gera rapidamente recursos e imagens de referência para o vídeo, podendo combinar com imagens que já possui.
- Geração de vídeo: usamos o Gemini Omni Flash para gerar um vídeo a partir desses assets.
- Edição de vídeo: depois de gerado, o vídeo pode ser editado de forma conversacional.
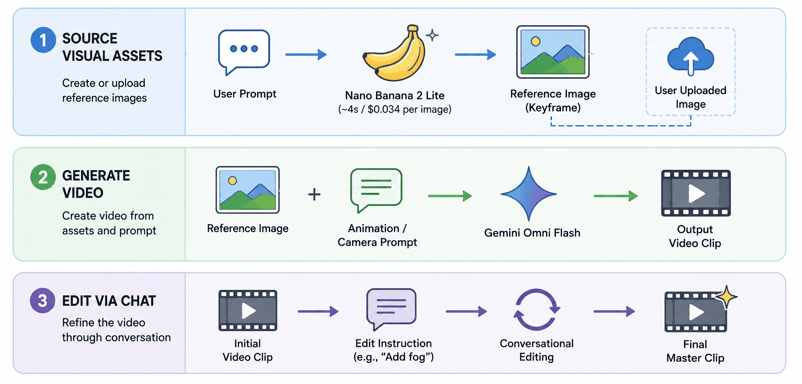
Etapa 1: prototipagem rápida com o Nano Banana 2 Lite
Na primeira etapa, o app permite obter imagens de referência (quadros-chave). Dá para enviar uma imagem local ou gerar uma na hora.
É aqui que o Nano Banana 2 Lite brilha.
Com latência abaixo de 4 segundos e custando uma fração de centavo por imagem, ele funciona como um sandbox ultrarrápido. Dá para prototipar rapidamente dezenas de estilos visuais, composições e temas até chegar ao quadro perfeito.
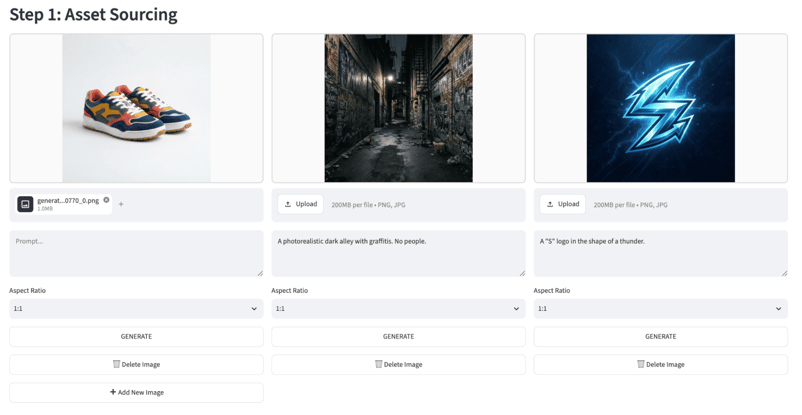
Etapa 2: geração multimodal com o Gemini Omni Flash
Com a imagem de referência perfeita em mãos, seguimos para a produção do vídeo.
A imagem de referência e o nosso prompt de animação (por exemplo, descrevendo movimento de câmera, mudanças de iluminação ou ação) são codificados em base64 e enviados ao Gemini Omni Flash usando a Interactions API do SDK.
O Gemini Omni Flash processa esses inputs e retorna um clipe de vídeo de alta fidelidade no formato widescreen (16:9) ou vertical (9:16).
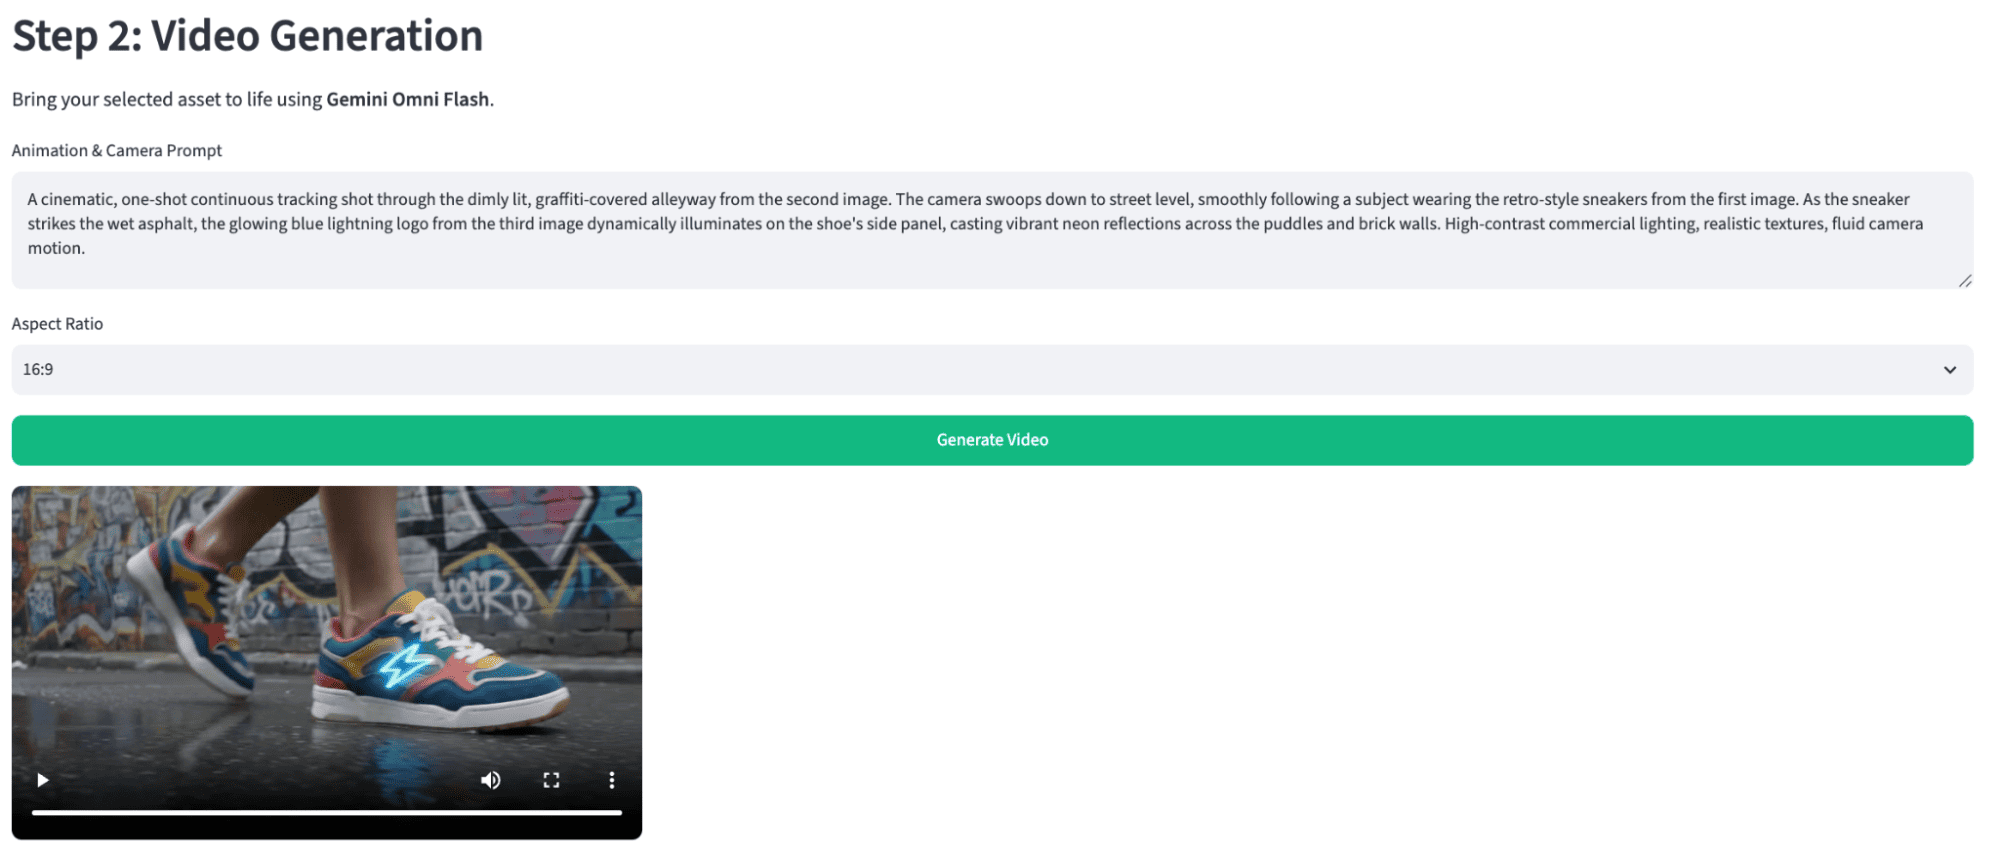
Aqui está o vídeo que obtivemos:
Implementação do app de geração de vídeo com Streamlit
Para construir a interface do usuário, usamos o Streamlit, um framework open source de Python que facilita muito criar apps web compartilháveis para machine learning e ciência de dados.
Se você é novo em Streamlit ou quer um reforço de como ele funciona, recomendamos este tutorial de Python com Streamlit.
Não vamos focar no código da UI em Streamlit, e sim na arquitetura do pipeline de geração de vídeo e nas possibilidades criativas de combinar esses dois modelos poderosos.
O script gemini_api.py contém as funções que implementamos acima para gerar imagens e vídeos. A interface foi feita em Streamlit no script app.py.
Se quiser rodar localmente e experimentar, faça o seguinte:
git clone [email protected]:fran-aubry/nano-banana-2-flash-tutorial.git
pip install -r requirement.txt
streamlit run app.pyAqui vai um exemplo completo de workflow que combina a imagem existente de uma marca de chá imaginária com uma imagem gerada de uma plantação de chá para criar um take comercial da lata de chá.
Depois, editamos o vídeo com um prompt.
O vídeo foi acelerado na demonstração porque a geração pode levar alguns minutos.
Conclusão
As promessas de velocidade feitas pelo Google sobre o novo Nano Banana 2 Lite se confirmam.
O modelo é incrivelmente rápido e está chegando perto de algo capaz de gerar imagens praticamente em tempo real. Embora as imagens sejam boas, não são exatamente revolucionárias. A principal inovação do modelo é, sem dúvida, sua velocidade impressionante — mais do que uma qualidade de imagem inédita.
Em conjunto, os modelos Gemini Omni Flash e Nano Banana 2 Lite formam um pipeline poderoso. O Omni se destaca especialmente em manter a fidelidade ao material de referência.
Para saber mais sobre o Nano Banana 2, confira este artigo: Nano Banana 2: um guia completo com Python.
Para se aprofundar na família Gemini Omni, recomendo ler Gemini Omni: um modelo para texto, imagem, áudio e vídeo.
FAQs
Qual é a diferença de propósito entre o Nano Banana 2 Lite e o Gemini Omni Flash?
O Nano Banana 2 Lite é otimizado para geração de imagens rápida e econômica (ideal para prototipagem ágil), enquanto o Gemini Omni Flash foi projetado para geração multimodal de vídeos e edição de vídeo conversacional.
Posso editar um vídeo sem precisar regenerar tudo do zero?
Sim. O Gemini Omni Flash permite edição de vídeo conversacional. Ao fornecer um prompt junto com o ID da interação anterior, você pode refinar sequências existentes usando linguagem natural.
O Nano Banana 2 Lite é adequado para aplicações em tempo real?
Com latência ultrabaixa de aproximadamente 4 segundos por imagem, ele foi feito especificamente para apps interativos em que velocidade e orçamento são prioridade.
Quais são as principais considerações de custo desses modelos?
Ambos priorizam custo-benefício. O Nano Banana 2 Lite custa US$ 0,034 por imagem em resolução 1K, e o Gemini Omni Flash sai por US$ 0,10 por segundo de vídeo gerado — valores viáveis para pipelines de alto volume.








O Google lançou recentemente o Nano Banana 2 Lite e o Gemini Omni Flash, dois modelos pensados para redefinir velocidade e recursos multimodais no desenvolvimento de IA.
Esses modelos oferecem uma combinação poderosa de geração de imagens com latência ultrabaixa e edição de vídeo conversacional versátil.
Neste artigo, eu exploro as principais capacidades desses modelos e construo um pipeline completo de editor de vídeo com IA que permite ao usuário selecionar e gerar imagens com o Nano Banana 2 Lite e depois combiná-las em um vídeo.
Aqui está um vídeo de demonstração do app que vamos construir: