

Wat is Nano Banana 2 Lite?
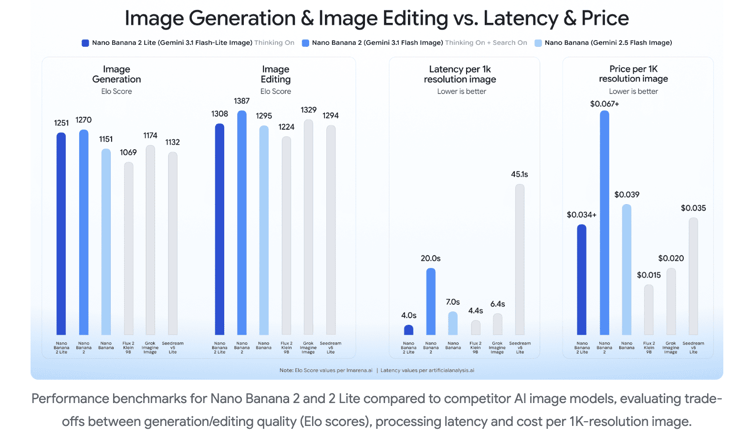
Nano Banana 2 Lite (gemini-3.1-flash-lite-image) is tot nu toe Google's snelste en meest kostenefficiënte model voor beeldgeneratie.
Het is specifiek gebouwd voor ontwikkelaars-pijplijnen met hoge doorvoer en toepassingen met veel verkeer, en geoptimaliseerd voor scenario's waar lage latentie en krappe operationele budgetten de primaire randvoorwaarden zijn.
Voor platforms die momenteel Google's legacy-model (gemini-2.5-flash-image) gebruiken, fungeert Nano Banana 2 Lite als directe vervanger, met onmiddellijke verbeteringen in snelheid, kosten en visuele kwaliteit.
Belangrijkste prestatie-indicatoren
- Ultra-lage latentie: Levert text-to-image-uitvoer in circa 4 seconden, ideaal voor interactieve prototyping en realtime gebruikersapplicaties.
- Kostenefficiëntie: Geprijsd op $0,034 per afbeelding met 1K-resolutie, waardoor de drempel voor generatie op grote schaal aanzienlijk lager ligt.
- Behouden van kwaliteit: Ondanks de focus op snelheid behoudt het model sterke prompt-naleving, consistente karakterrenders en betrouwbare tekstgeneratie in beelden.
Wat is Gemini Omni Flash?
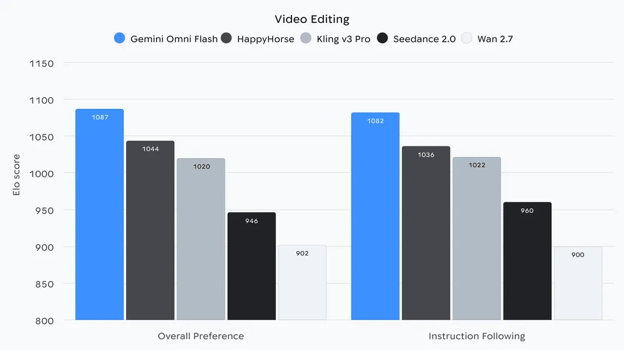
Gemini Omni Flash (gemini-omni-flash-preview) is Google's kostenefficiënte model voor videogeneratie en conversatiegestuurde video-editing.
In tegenstelling tot standalone videogeneratoren die strikt vertrouwen op statische tekstprompts, brengt Omni Flash Gemini’s kern van multimodaal redeneren direct in het videocreatieproces.
Het accepteert van nature combinaties van tekst-, beeld- en video-inputs, waardoor je programmatische controle krijgt over videogeneratie met ongekende precisie.
Kernmogelijkheden en prijsstelling van Omni Flash
- Concurrerende prijsstelling: $0,10 per seconde video-uitvoer, gelijk aan het tarief van Veo 3.1 Fast.
- Conversatiegestuurde video-editing: In plaats van video’s bij kleine aanpassingen helemaal opnieuw te genereren, kunnen applicaties natuurlijke taal gebruiken om bestaande sequenties te verfijnen.
- Multimodale referenties: Tekstprompts kunnen worden gecombineerd met referentieafbeeldingen of -clips om visuele consistentie en gedetailleerde controle over scene-elementen te waarborgen.
- Verankering in de echte wereld: Door gebruik te maken van Gemini’s basiskennis construeert het model realistische animaties op basis van logica en fysica.
- Synchronisatie van tekst en acties: Tekst op het scherm en grafische overlays kunnen via simpele prompts direct worden gekoppeld aan video-acties.
Hoe genereer en stel je een Gemini API-sleutel in
Voordat we de Gemini API kunnen gebruiken, moeten we een API-sleutel aanmaken en instellen zodat onze code met de API kan communiceren.
De eenvoudigste manier om dit te doen is:
- Bezoek de API-sleutelpagina van Google’s AI Studio en log in.
- Klik op de knop “Create API key” rechtsboven.
- Kopieer de API-sleutel naar een bestand met de naam
.envin dezelfde map als waar de Python-code staat, met het volgende formaat:
GEMINI_API_KEY=replace_with_api_keyLet op: Het gebruik van de API brengt kosten met zich mee. Om deze te gebruiken, moeten we een betaalmethode configureren op de factureringspagina van Google’s AI Studio.
Hoe genereer je afbeeldingen met Nano Banana 2 Lite in Python
Vereisten voor AI-beeldgeneratie in Python
Voordat we beginnen met het coderen van onze Python AI-beeldgenerator, zorg dat het volgende klaarstaat:
- Python 3.9+ is op het systeem geïnstalleerd.
- Google Gemini API-sleutel: Een geldige Google Gemini API-sleutel om aanvragen te authenticeren. Zie de stappen hierboven om de sleutel te maken en te configureren.
- Vereiste Python-bibliotheken: We gebruiken de officiële
google-genaiSDK voor API-integratie en Pillow voor het verwerken van de beelduitvoer.
De benodigde Python-pakketten kunnen met pip worden geïnstalleerd:
pip install google-genai pillow python-dotenvStap 1: Modules importeren en omgevingsvariabelen laden
Maak een nieuw bestand (bijv. generate_image.py) en voeg de volgende imports en laadsequentie toe om de omgeving in te stellen:
import io
from dotenv import load_dotenv
from google.genai import types
from PIL import Image
from google.genai import Client
# Load environment variables from the .env file
load_dotenv()Stap 2: De Google GenAI-client initialiseren
Om met het Nano Banana 2 Lite-model te communiceren, moeten we eerst de Google GenAI-client initialiseren.
Omdat de SDK automatisch de systeomgevingsvariabelen controleert op GEMINI_API_KEY (die in de vorige stap uit het .env-bestand is geladen), kunnen we de client initialiseren zonder de API-sleutel expliciet in de code door te geven.
# Initialize the Gemini API client
client = Client()Stap 3: De functie voor AI-beeldgeneratie schrijven
Nu komt de kernlogica van ons Python-script. We schrijven een aparte Python-functie, generate_image(), die de geïnitialiseerde client en een tekstprompt als input neemt.
Nano Banana 2 Lite wordt aangeroepen door model="gemini-3.1-flash-lite-image" op te geven. We configureren het API-verzoek om een beeldmodaliteit te verwachten en specificeren de gewenste beeldverhouding voor de AI-beeldgeneratie.
def generate_image(client, prompt: str, ratio: str = "1:1") -> Image.Image | None:
"""
Generates an AI image using the Nano Banana 2 Lite model via the Gemini API.
"""
print(f"Generating AI image for prompt: '{prompt}'...")
# 1. Call the Nano Banana 2 Lite model
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=prompt,
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=ratio),
),
)
# 2. Extract and convert the generated image data
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
# Load the bytes into a PIL Image and convert to RGB
image = Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return image
return NoneHet Python-verzoek voor beeldgeneratie uitgelegd:
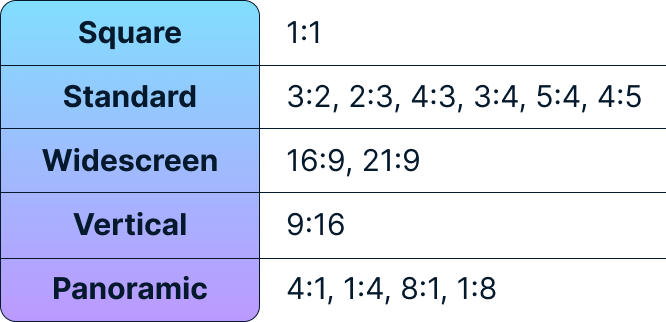
response_modalities: Dit dwingt het Google Gemini-model om een beeld te retourneren in plaats van tekst.inline_data: De Gemini API retourneert het gegenereerde beeld als ruwe bytes. We gebruikenio.BytesIOin Python om deze bytes te wrappen zodat Pillow (Image.open) ze als een standaard afbeeldingsbestand kan lezen.image_config: We zetten deaspect_ratioop "1:1" (vierkant), maar dit is eenvoudig aan te passen afhankelijk van de usecase van je AI-toepassing.
Ondersteunde beeldverhoudingen:
Stap 4: Het Python-script voor beeldgeneratie uitvoeren
Laten we alles samenbrengen en Nano Banana 2 Lite vragen om een afbeelding te genereren!
We geven een creatieve prompt, roepen de functie show() aan op het resulterende beeld om het AI-kunstwerk te bekijken, en sluiten de client om resources vrij te geven.
if __name__ == "__main__":
# Define our creative prompt for the AI model
my_prompt = "A futuristic city skyline at sunset, cyberpunk style, highly detailed"
# Generate the AI image
result_image = generate_image(client, my_prompt)
# Display the resulting image
if result_image:
print("AI Image generated successfully!")
result_image.show()
else:
print("Failed to generate AI image.")
# Close the client to prevent shutdown exceptions
client.close()Hier is de afbeelding die door Nano Banana 2 Flash werd gegenereerd:
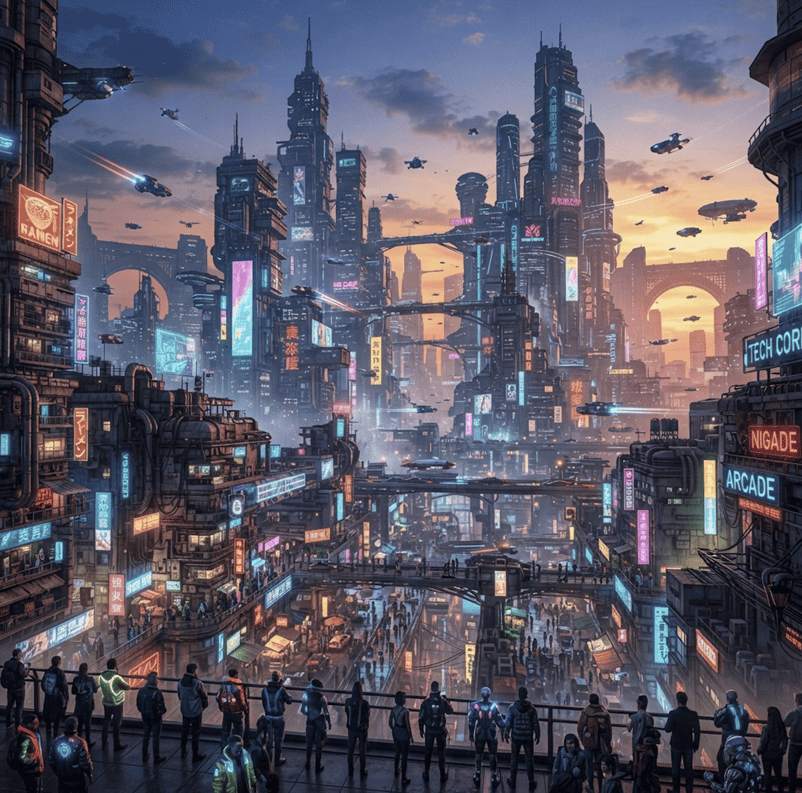
Zoals Google in hun aankondiging beloofde, had het model slechts een paar seconden nodig om de afbeelding te genereren. Op het eerste gezicht voelt het veel sneller aan dan elk ander model dat ik tot nu toe heb geprobeerd.
Het volledige script vind je in het generate_image.py-script uit de repository van deze tutorial.
Het script uitbreiden naar beeldbewerking
Laten we een functie edit_image() schrijven die een afbeelding bewerkt. Het enige wat we in het verzoek hoeven te wijzigen, is de afbeelding samen met de prompt aanleveren in de parameter contents als een lijst [image, prompt].
def edit_image(client, image: Image.Image, prompt: str, aspect_ratio: str = "1:1") -> Image.Image | None:
"""
Edits an AI image using the Gemini 3.1 Flash Lite model via the Gemini API.
"""
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=[image, prompt],
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=aspect_ratio),
),
)
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
return Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return NoneNano Banana 2 Flash testen
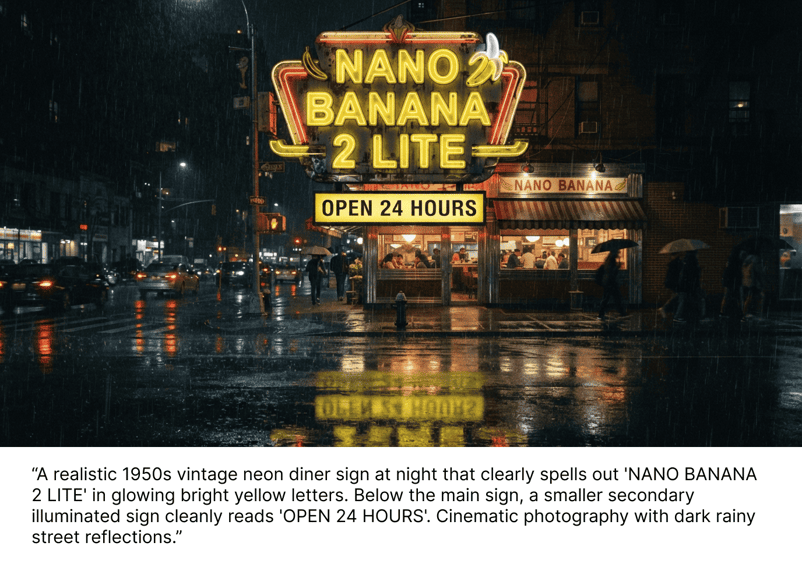
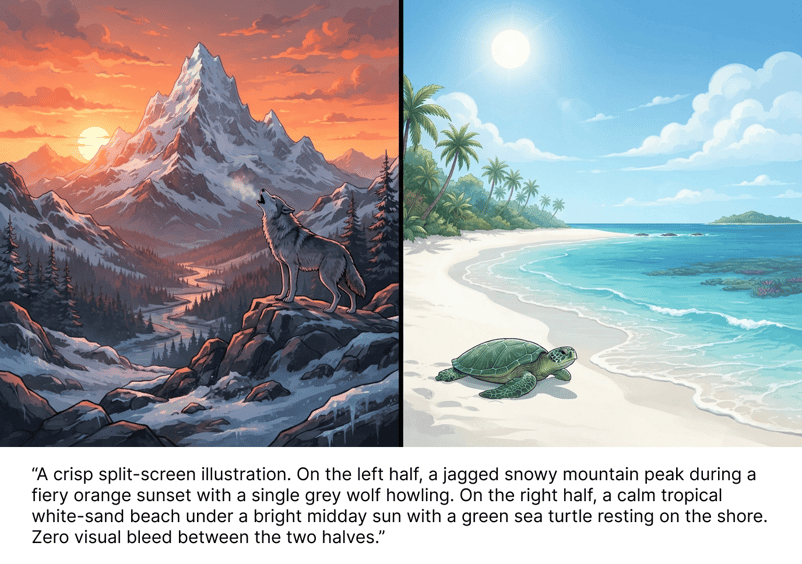
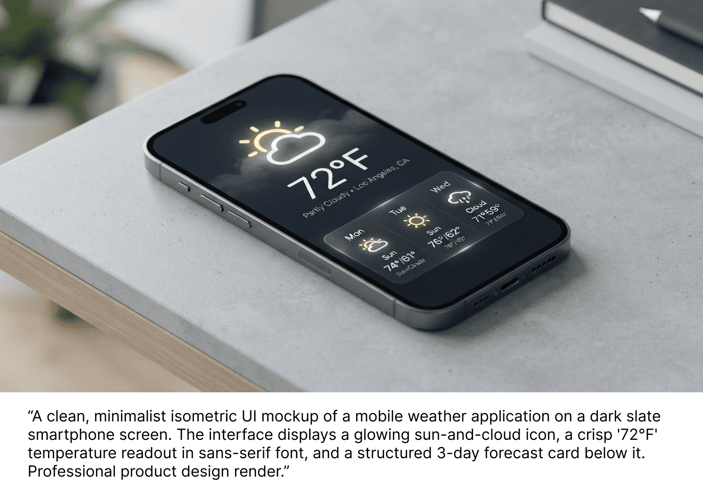
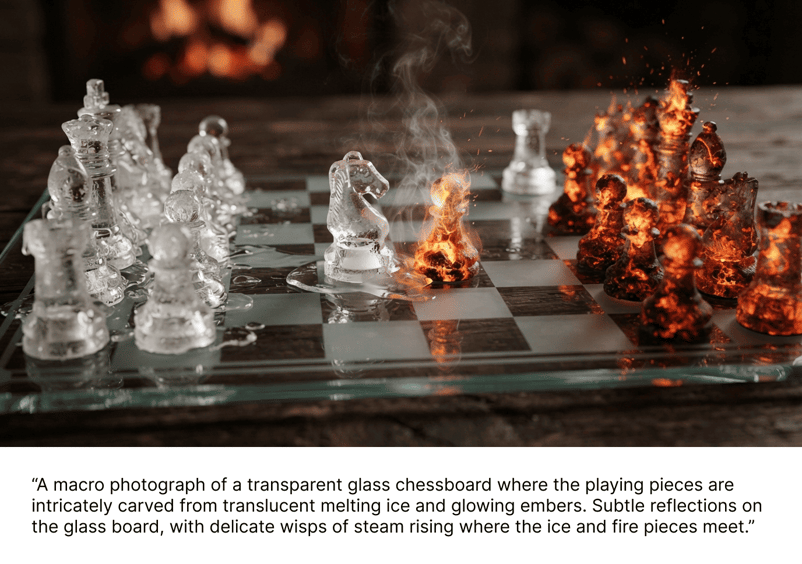
We hebben de prestaties in de praktijk geëvalueerd door een reeks gerichte stresstests uit te voeren.
Deze evaluaties richten zich op het vermogen van het model om complexe visuele taken aan te kunnen, zoals leesbare tekst renderen, strakke ruimtelijke lay-outs behouden en consistentie waarborgen over meerdere beurten, om te bepalen of het zijn belofte van hoogwaardige generatie op hoge snelheid waarmaakt.
Leesbare tekstrendering ín de afbeelding testen
Strikte ruimtelijke controle en naleving met twee onderwerpen testen
Snelle UI-prototyping en lay-outprecisie testen
Complexe materiaalcontrasten en belichting testen
Consistentie van personages over meerdere beurten testen
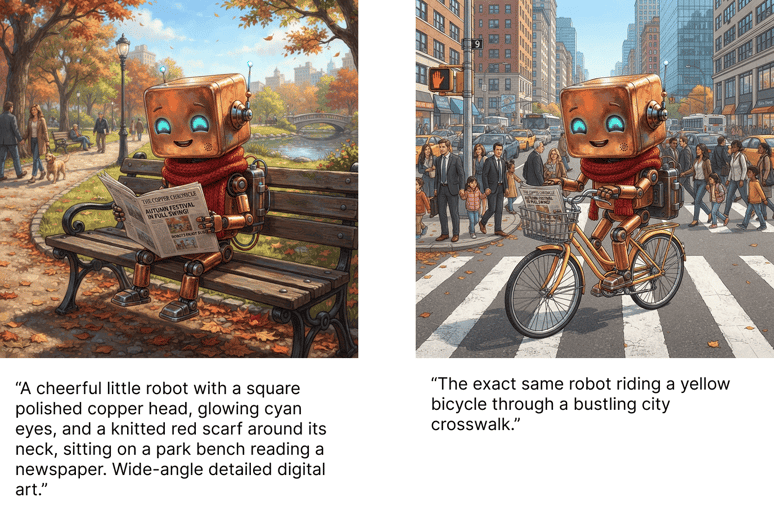
Eerlijk gezegd ben ik behoorlijk onder de indruk van de resultaten voor zo’n snel model. In het laatste voorbeeld wist het model zelfs de tekst in de krant enigszins consistent te houden.
Uit mijn ervaring is consistentie een van de belangrijkste aspecten waar een beeldgeneratiemodel in moet uitblinken om echt nuttig te zijn.
Hoe genereer je video’s met Gemini Omni Flash in Python
In deze sectie laten we zien hoe je een Python-script bouwt om video’s te genereren, te beginnen met een simpele tekst-naar-video-prompt en dit vervolgens uit te breiden met referentieafbeeldingen.
In tegenstelling tot standaard beeldgeneratie gebeurt het genereren van video’s met Gemini Omni Flash via de Interactions API van de SDK (client.interactions.create). Deze endpoint is specifiek ontworpen voor rijke, meerstaps- en multimodale interacties.
Omdat de vereiste SDK-imports, het instellen van omgevingsvariabelen en het initialiseren van de Google GenAI-client identiek zijn aan het proces voor beeldgeneratie in de vorige sectie, kunnen we ons direct richten op het schrijven van onze functies voor videogeneratie.
Stap 1: Tekst-naar-video (Eenvoudige prompt-naar-video)
Om een video te genereren op basis van alleen een tekstprompt, geven we één tekstinvoerblok door aan de Interactions API. We kunnen hiervoor een eenvoudige Python-functie schrijven:
def text_to_video(client, prompt: str, aspect_ratio: str = "16:9", duration: str = "5s"):
"""
Generates a video from a text prompt using Gemini Omni Flash.
"""
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=[{"type": "text", "text": prompt}],
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
"duration": duration,
},
)
return interactionWe kunnen deze functie aanroepen en de geretourneerde videobytes als volgt opslaan in een bestand:
if __name__ == "__main__":
import base64
# Define a creative video prompt
text_prompt = """
Generate a first person view of what daily life would look like in the year
1000 at this location: 41.89030621184054, 12.492266126772481
"""
# Call the video generator
interaction = text_to_video(
client=client,
prompt=text_prompt,
aspect_ratio="16:9",
duration="5s"
)
# Extract and save the generated video file
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
# Decode the base64-encoded video data returned by the API
video_bytes = base64.b64decode(interaction.output_video.data)
# Save the bytes locally as an MP4 file
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)
else:
print("Failed to generate video.")De prompt die we gebruikten was:
Generate a first-person view of what daily life would look like in the year 1000 at this location: 41.89030621184054, 12.492266126772481Die specifieke locatie is het Romeinse Colosseum. Ik gebruikte coördinaten om de wereldkennis van het model te testen. Dit is de video die werd gegenereerd:
Ter vergelijking: dit is wat het model genereerde toen ik het jaar 1000 verving door 1980:
Best interessant, vind ik. Bekijk het text_to_video.py-bestand om het volledige script te zien.
Stap 2: Image-to-Video-mogelijkheden implementeren
Om een statische afbeelding te animeren of deze alleen als referentie te gebruiken om de videogeneratie aan te sturen, moeten we zowel de afbeelding als een tekstprompt aan het model doorgeven.
Omdat de Interactions API verwacht dat afbeeldingsinputs base64-gecodeerd zijn, definiëren we eerst een hulpfunctie om PIL Image-objecten naar base64-strings te converteren:
import io
from PIL import Image
import base64
def _image_to_base64(img: Image.Image) -> str:
"""
Converts a PIL Image object to a base64-encoded string.
"""
buffered = io.BytesIO()
img.save(buffered, format="PNG")
return base64.b64encode(buffered.getvalue()).decode()Nu kunnen we een algemenere functie bouwen, generate_video(), die zowel optionele afbeeldingen als de tekstprompt verwerkt.
from google.genai import types
def generate_video(client, valid_images: list[Image.Image], animation_prompt: str, aspect_ratio: str):
"""
Generates a commercial-quality AI video using Google's Gemini Omni Flash model.
Supports image-to-video and text-to-video multimodal inputs using the Gemini API.
"""
omni_inputs = []
# 1. Base64 encode and append any input images
for img in valid_images:
img_b64 = _image_to_base64(img)
omni_inputs.append({
"type": "image",
"data": img_b64,
"mime_type": "image/png",
})
# 2. Append the text animation prompt
omni_inputs.append({"type": "text", "text": animation_prompt})
# 3. Request video generation from the interactions endpoint
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=omni_inputs,
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
},
)
return interactionTot slot: zo gebruiken we deze functies om een video te genereren die deze keverafbeelding animeert, die ik met Gemini heb gegenereerd:
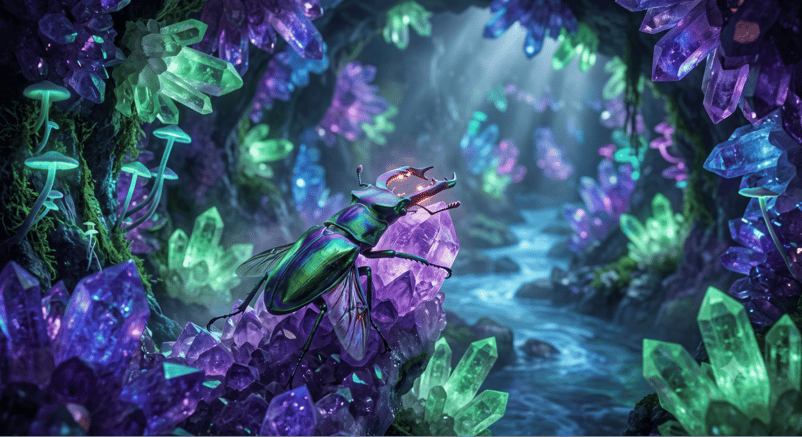
if __name__ == "__main__":
# Load our reference image
reference_image = Image.open("images/beetle.png").convert("RGB")
# Describe how we want the image to be animated
animation_prompt = """
A detailed, close-up photograph of an iridescent biomechanical stag beetle,
shimmering with metallic green, blue, and violet hues, as it traverses a
rugged amethyst crystal formation in a subterranean grotto.
The cavern walls are lined with a dense matrix of glowing crystals emitting
deep purple, blue, and green light. The air is misty, with bioluminescent
flora clinging to the rock. As the camera maintains focus, the beetle
subtly activates a soft internal orange glow from its mandibles, begins
vibrating its wings, and slowly crawls upward across the crystalline
surface, reflecting the surrounding light.
"""
# Call the generator with the reference image
interaction = generate_video(
client=client,
valid_images=[reference_image],
animation_prompt=animation_prompt,
aspect_ratio="16:9"
)
# Extract and save the animated video
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
video_bytes = base64.b64decode(interaction.output_video.data)
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)Dit was de video die werd gegenereerd:
Het volledige script is hier beschikbaar.
Stap 3: Video bewerken met Video-to-Video
Een video conversatiegestuurd bewerken met de Gemini Omni Flash API is ontzettend eenvoudig dankzij het gebruik van interacties. Wanneer we een video genereren, krijgen we een interactie-ID die toegankelijk is als interaction.id.
Om een video te bewerken, geven we vervolgens een prompt en de ID van de vorige interactie op. Is het de eerste bewerking, dan geven we de ID op van de interactie die is gebruikt om de video te genereren. Voor volgende bewerkingen geven we de ID van de vorige bewerking op.
client.interactions.create(
model="gemini-omni-flash-preview",
input=edit_prompt,
previous_interaction_id=previous_interaction_id,
)Een interactieve AI Video Studio bouwen: architectuur en synergie tussen modellen
In de vorige secties leerden we hoe je programmatisch afbeeldingen genereert met Nano Banana 2 Lite en video’s met Gemini Omni Flash. Nu laten we zien hoe je deze mogelijkheden samenbrengt in één samenhangende, interactieve webapplicatie: een AI Video Studio.
De architectuur van de AI Video Studio
Het maken van hoogwaardige AI-video’s vereist meestal veel trial-and-error. De AI Video Studio lost dit op met een tweefasige pipeline met meerdere modellen die de unieke sterke punten van twee verschillende modellen benut:
- Assets verzamelen: Aangedreven door Nano Banana 2 Lite kunnen gebruikers snel resources en referentieafbeeldingen voor de video genereren en combineren met bestaande beelden die ze hebben.
- Videogeneratie: We gebruiken Gemini Omni Flash om een video te genereren op basis van die assets.
- Videobewerking: Nadat een video is gegenereerd, kunnen we deze conversatiegestuurd bewerken.
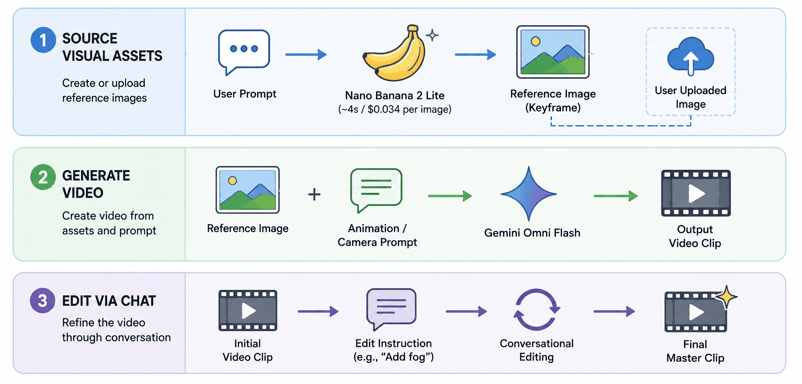
Fase 1: Snel prototypen met Nano Banana 2 Lite
In de eerste fase laat de applicatie ons referentiebeelden (keyframes) verzamelen. We kunnen ofwel een lokale afbeelding uploaden of er on the fly één genereren.
Hier blinkt Nano Banana 2 Lite in uit.
Met een latentie van onder de 4 seconden en voor slechts een fractie van een cent per afbeelding, dient het als een ultrasnelle sandbox. We kunnen razendsnel tientallen verschillende visuele stijlen, composities en onderwerpen prototypen tot we het perfecte keyframe hebben.
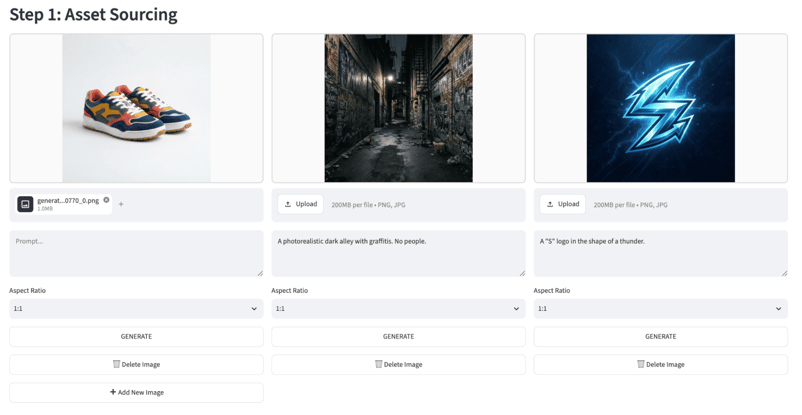
Fase 2: Multimodale generatie met Gemini Omni Flash
Zodra we het perfecte referentiebeeld hebben, gaan we door naar de videoproductiefase.
Het referentiebeeld en onze animatieprompt (bijv. beschrijving van camerabeweging, lichtveranderingen of actie) worden base64-gecodeerd en via de Interactions API van de SDK naar Gemini Omni Flash gestuurd.
Gemini Omni Flash verwerkt deze inputs en retourneert een video met hoge getrouwheid in breedbeeld (16:9) of verticaal (9:16) formaat.
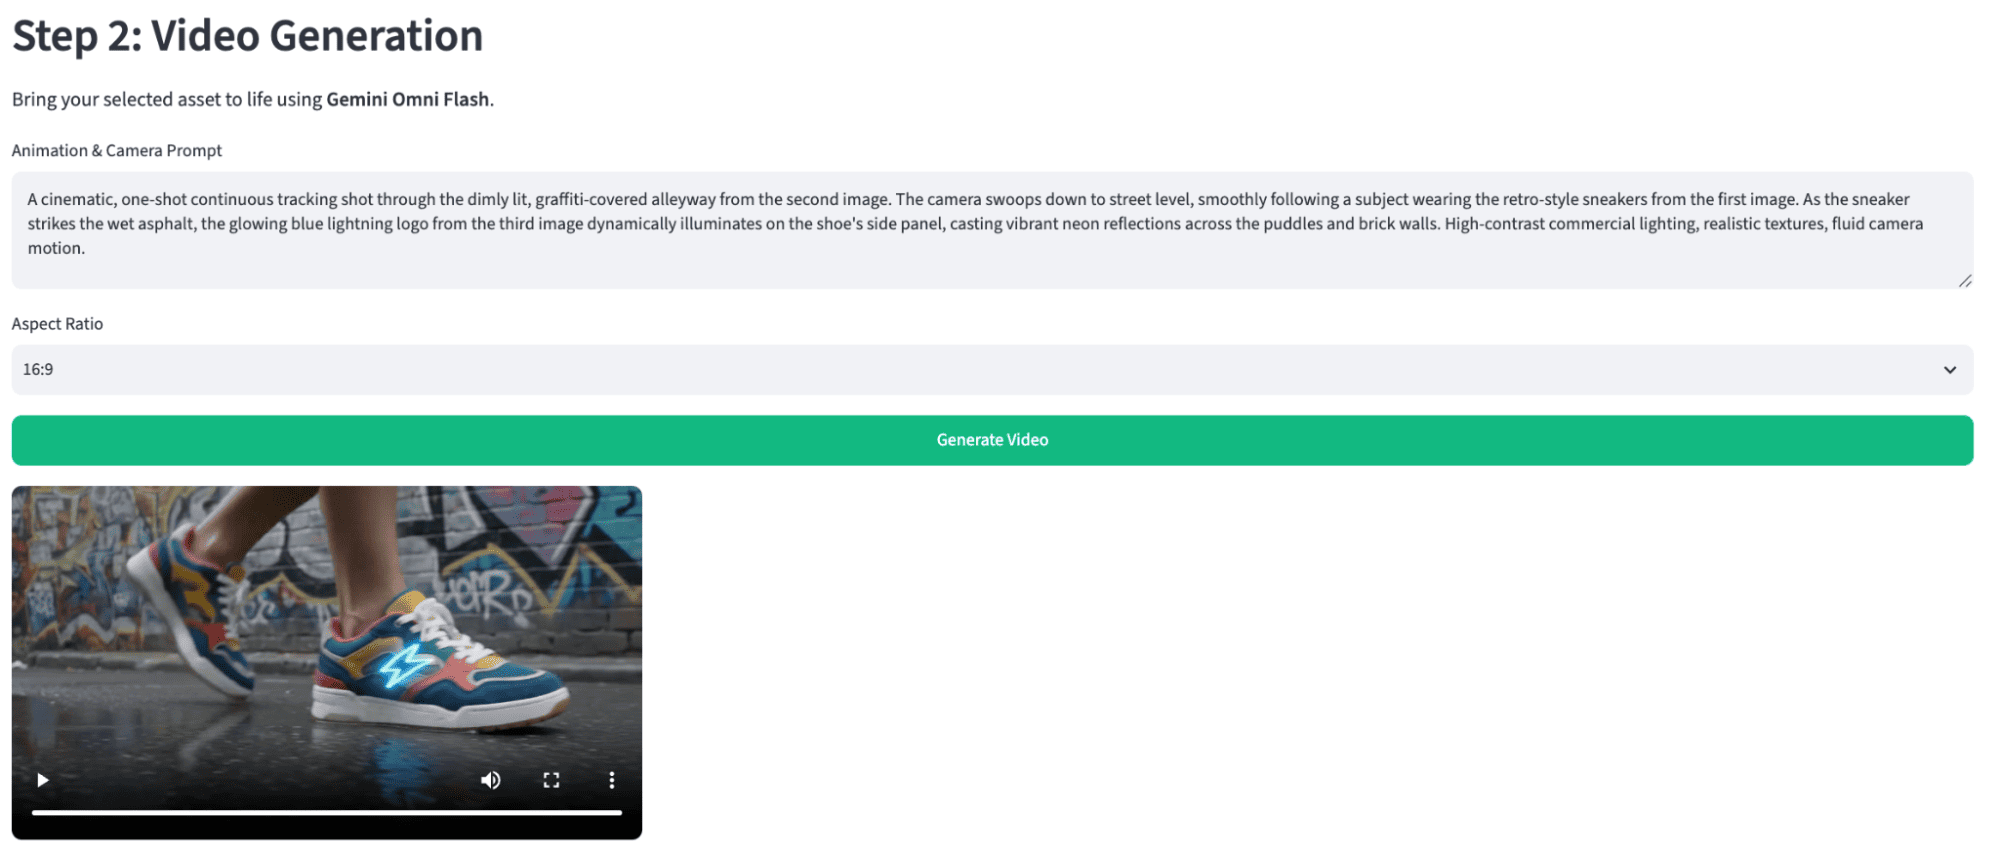
Hier is de video die we kregen:
Streamlit-implementatie van de videogeneratie-app
Voor de gebruikersinterface gebruiken we Streamlit, een populair open-source Python-framework waarmee je heel eenvoudig deelbare webapps voor machine learning en data science bouwt.
Ben je nieuw met Streamlit of wil je een opfrisser over hoe het werkt, lees dan zeker deze Python Streamlit-tutorial.
We focussen niet op de Streamlit-UI-code zelf, maar kijken naar de architectuur van de videogeneratiepipeline en verkennen de creatieve mogelijkheden van het combineren van deze twee krachtige modellen.
Het gemini_api.py-script bevat de functies die we hierboven hebben geïmplementeerd om afbeeldingen en video’s te genereren. De gebruikersinterface is met Streamlit geïmplementeerd in het app.py-script.
Wil je het lokaal draaien en ermee experimenteren, doe dan het volgende:
git clone [email protected]:fran-aubry/nano-banana-2-flash-tutorial.git
pip install -r requirement.txt
streamlit run app.pyHier is een volledig workflowvoorbeeld dat een bestaande afbeelding van een denkbeeldig theemerk combineert met een gegenereerde afbeelding van een theeplantage om een commercial shot voor dat theeblik te maken.
Daarna bewerken we de video met een prompt.
De video is versneld weergegeven tijdens de videogeneratie, omdat dit enkele minuten kan duren.
Conclusie
De snelheidsclaims die Google doet over hun nieuwe Nano Banana 2 Lite-model kloppen.
Het model is ongelooflijk snel en komt dichter in de buurt van iets dat beelden in realtime kan genereren. Hoewel de afbeeldingen die het genereert goed zijn, zijn ze niet bepaald revolutionair. De primaire innovatie van het model is ongetwijfeld de indrukwekkende snelheid, niet baanbrekende beeldkwaliteit.
Samen vormen de Gemini Omni Flash- en Nano Banana 2 Lite-modellen een krachtige pipeline. Het Omni-model is bijzonder effectief in het behouden van de getrouwheid aan het referentiemateriaal.
Wil je meer weten over Nano Banana 2, bekijk dan dit artikel: Nano Banana 2: Een volledige gids met Python.
Voor meer diepgang in de Gemini Omni-serie raad ik aan om Gemini Omni: één model voor tekst, beeld, audio en video te lezen.
FAQs
Waarin verschillen Nano Banana 2 Lite en Gemini Omni Flash qua doel?
Nano Banana 2 Lite is geoptimaliseerd voor snelle, kostenefficiënte beeldgeneratie (ideaal voor snel prototypen), terwijl Gemini Omni Flash is ontworpen voor multimodale videogeneratie en conversatiegestuurde videobewerking.
Kan ik een video bewerken zonder deze vanaf nul opnieuw te genereren?
Ja. Met Gemini Omni Flash kun je video’s conversatiegestuurd bewerken. Door een prompt te geven samen met de ID van de vorige interactie kun je bestaande videosequenties met natuurlijke taal verfijnen.
Is Nano Banana 2 Lite geschikt voor realtime gebruikersapplicaties?
Met een ultra-lage latentie van ongeveer 4 seconden per afbeelding is het specifiek gebouwd voor interactieve apps waar snelheid en budget de belangrijkste factoren zijn.
Wat zijn de belangrijkste kostenoverwegingen voor deze modellen?
Beide modellen geven prioriteit aan kostenefficiëntie. Nano Banana 2 Lite kost $0,034 per afbeelding met 1K-resolutie en Gemini Omni Flash kost $0,10 per seconde video-uitvoer, waardoor ze geschikt zijn voor pipelines op grote schaal.



Google heeft onlangs Nano Banana 2 Lite en Gemini Omni Flash uitgebracht, twee modellen die snelheid en multimodale mogelijkheden in AI-ontwikkeling opnieuw definiëren.
Deze modellen bieden een krachtige combinatie van extreem lage latentie voor beeldgeneratie en veelzijdige, conversatiegestuurde video-editing.
In dit artikel verken ik de kerncapaciteiten van deze modellen en bouw ik een volledige AI-videobewerkingspipeline waarmee gebruikers beelden kunnen selecteren en genereren met Nano Banana 2 Lite, om ze vervolgens samen te voegen tot een video.
Hier is een demovideo van de app die we bouwen: