

Nano Banana 2 Lite क्या है?
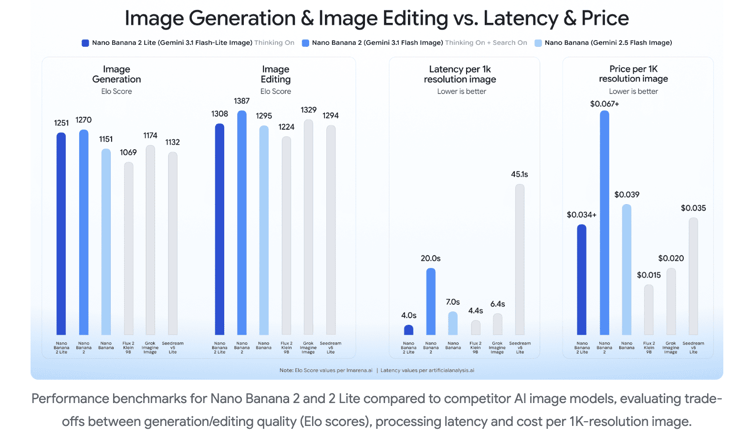
Nano Banana 2 Lite (gemini-3.1-flash-lite-image) अब तक का Google का सबसे तेज़ और सबसे किफायती इमेज जेनरेशन मॉडल है.
विशेष रूप से उच्च-वेग डेवलपर पाइपलाइंस और उच्च-थ्रूपुट अनुप्रयोगों के लिए बनाया गया, यह उन परिदृश्यों के लिए अनुकूलित है जहाँ कम लेटेंसी और सीमित परिचालन बजट प्राथमिक बाधाएँ हैं।
जो प्लेटफ़ॉर्म वर्तमान में Google के लिगेसी मॉडल (gemini-2.5-flash-image) का उपयोग कर रहे हैं, उनके लिए Nano Banana 2 Lite एक प्रत्यक्ष ड्रॉप-इन रिप्लेसमेंट का काम करता है, जो गति, लागत, और विज़ुअल गुणवत्ता में तुरंत सुधार देता है।
मुख्य परफॉर्मेंस मीट्रिक्स
- अल्ट्रा-लो लेटेंसी: लगभग 4 सेकंड में टेक्स्ट-टू-इमेज आउटपुट देता है, जो इंटरैक्टिव प्रोटोटाइपिंग और रीयल-टाइम उपयोगकर्ता अनुप्रयोगों के लिए आदर्श है।
- किफायती: 1K-रेज़ोल्यूशन इमेज पर $0.034 की कीमत, उच्च-वॉल्यूम जेनरेशन के लिए बाधाएँ काफी घटाती है।
- क्वालिटी रिटेंशन: गति पर फोकस के बावजूद, मॉडल मज़बूत प्रॉम्प्ट अनुपालन, सुसंगत कैरेक्टर रेंडरिंग, और विश्वसनीय इन-इमेज टेक्स्ट जेनरेशन बनाए रखता है।
Gemini Omni Flash क्या है?
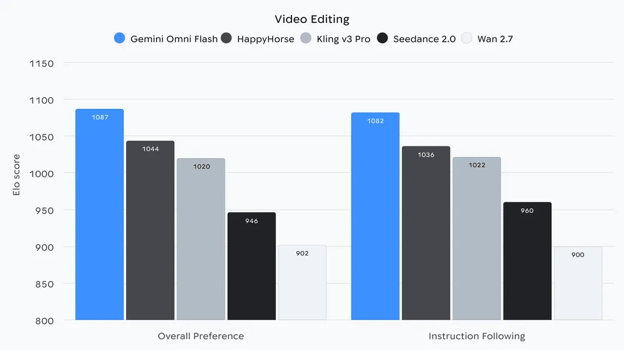
Gemini Omni Flash (gemini-omni-flash-preview) वीडियो जेनरेशन और संवादात्मक वीडियो एडिटिंग के लिए Google का किफायती मॉडल है।
स्टैंडअलोन वीडियो जेनरेटर, जो केवल स्थिर टेक्स्ट प्रॉम्प्ट्स पर निर्भर रहते हैं, के विपरीत, Omni Flash Gemini की कोर मल्टीमोडल रीजनिंग को सीधे वीडियो निर्माण प्रक्रिया में लाता है.
यह स्वाभाविक रूप से टेक्स्ट, इमेज और वीडियो इनपुट्स के संयोजन स्वीकार करता है, जिससे प्रोग्रामेटिक कंट्रोल के साथ अद्वितीय सटीकता में वीडियो जेनरेशन संभव होता है।
Omni Flash की मुख्य क्षमताएँ और कीमत
- प्रतिस्पर्धी मूल्य: प्रति सेकंड वीडियो आउटपुट पर $0.10, जो Veo 3.1 Fast की दर से मेल खाता है।
- संवादात्मक वीडियो एडिटिंग: छोटे समायोजनों के लिए वीडियो को शुरू से फिर से बनाने के बजाय, एप्लिकेशन प्राकृतिक भाषा निर्देशों से मौजूदा सीक्वेंस को परिष्कृत कर सकते हैं।
- मल्टीमोडल रेफरेंसिंग: विज़ुअल स्थिरता और सीन एलिमेंट्स पर सूक्ष्म नियंत्रण सुनिश्चित करने के लिए टेक्स्ट प्रॉम्प्ट्स को रेफरेंस इमेज या क्लिप्स के साथ जोड़ा जा सकता है।
- वास्तविक दुनिया से ग्राउंडिंग: Gemini के बुनियादी ज्ञान का उपयोग करके, मॉडल तर्क और भौतिकी पर आधारित यथार्थपरक एनीमेशन बनाता है।
- टेक्स्ट और एक्शन सिंक्रोनाइज़ेशन: साधारण प्रॉम्प्टिंग के माध्यम से ऑन-स्क्रीन टेक्स्ट और ग्राफिक ओवरलेज़ को सीधे वीडियो एक्शंस से जोड़ा जा सकता है।
Gemini API Key कैसे जनरेट और सेटअप करें
Gemini API का उपयोग करने से पहले, हमें एक API key बनानी और सेटअप करनी होगी ताकि हमारा कोड API से संवाद कर सके।
इसे करने का सबसे सरल तरीका यह है:
- यह पेज खोलें: Google का AI Studio API key पेज और लॉग इन करें।
- ऊपरी-दाएँ कोने में “Create API key” बटन पर क्लिक करें।
- API key को उसी फ़ोल्डर में जहाँ Python कोड होगा,
.envनामक फ़ाइल में निम्न स्वरूप में कॉपी करें:
GEMINI_API_KEY=replace_with_api_keyध्यान दें: API का उपयोग करने पर लागत आती है। इसका उपयोग करने के लिए, हमें Google के AI Studio बिलिंग पेज पर भुगतान विधि कॉन्फ़िगर करनी होगी।
Python में Nano Banana 2 Lite से इमेज कैसे जेनरेट करें
Python में AI इमेज जेनरेशन के लिए आवश्यकताएँ
हमारा Python AI इमेज जेनरेटर कोड करने से पहले, सुनिश्चित करें कि निम्नलिखित टूल तैयार हैं:
- Python 3.9+ सिस्टम पर इंस्टॉल हो।
- Google Gemini API Key: अनुरोधों को प्रमाणित करने के लिए एक वैध Google Gemini API key। key बनाने और कॉन्फ़िगर करने के लिए ऊपर दिए चरण देखें।
- आवश्यक Python लाइब्रेरीज़: API एकीकरण के लिए आधिकारिक
google-genaiSDK और इमेज आउटपुट हैंडल करने के लिए Pillow का उपयोग करेंगे।
आवश्यक Python पैकेज pip का उपयोग करके इंस्टॉल किए जा सकते हैं:
pip install google-genai pillow python-dotenvचरण 1: मॉड्यूल इम्पोर्ट करना और वातावरण वेरिएबल लोड करना
एक नई फ़ाइल बनाएँ (उदा., generate_image.py) और पर्यावरण सेटअप करने के लिए निम्न इम्पोर्ट्स और लोड सीक्वेंस जोड़ें:
import io
from dotenv import load_dotenv
from google.genai import types
from PIL import Image
from google.genai import Client
# Load environment variables from the .env file
load_dotenv()चरण 2: Google GenAI क्लाइंट इनिशियलाइज़ करना
Nano Banana 2 Lite मॉडल के साथ इंटरैक्ट करने के लिए, हमें पहले Google GenAI क्लाइंट इनिशियलाइज़ करना होगा.
क्योंकि SDK स्वचालित रूप से सिस्टम वातावरण वेरिएबल्स में GEMINI_API_KEY (जो पिछले चरण में .env फ़ाइल से लोड हुआ) को जाँचता है, हम क्लाइंट को बिना API key कोड में पास किए इनिशियलाइज़ कर सकते हैं।
# Initialize the Gemini API client
client = Client()चरण 3: AI इमेज जेनरेशन फ़ंक्शन लिखना
अब हमारे Python स्क्रिप्ट का कोर लॉजिक। हम एक समर्पित Python फ़ंक्शन generate_image() लिखेंगे, जो इनिशियलाइज़ किए गए क्लाइंट और एक टेक्स्ट प्रॉम्प्ट को इनपुट के रूप में लेता है।
Nano Banana 2 Lite को model="gemini-3.1-flash-lite-image" बताकर इनवोक किया जाता है। हम API अनुरोध को इमेज मॉडेलिटी की अपेक्षा करने के लिए कॉन्फ़िगर करते हैं और वांछित आस्पेक्ट रेशियो निर्दिष्ट करते हैं।
def generate_image(client, prompt: str, ratio: str = "1:1") -> Image.Image | None:
"""
Generates an AI image using the Nano Banana 2 Lite model via the Gemini API.
"""
print(f"Generating AI image for prompt: '{prompt}'...")
# 1. Call the Nano Banana 2 Lite model
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=prompt,
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=ratio),
),
)
# 2. Extract and convert the generated image data
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
# Load the bytes into a PIL Image and convert to RGB
image = Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return image
return NonePython इमेज जेनरेशन अनुरोध को समझना:
response_modalities: यह Google Gemini मॉडल को टेक्स्ट के बजाय इमेज लौटाने के लिए बाध्य करता है।inline_data: Gemini API जेनरेट की गई इमेज को रॉ बाइट्स के रूप में लौटाता है। हम Python केio.BytesIOका उपयोग करके इन बाइट्स को रैप करते हैं ताकि Pillow (Image.open) उन्हें मानक इमेज फ़ाइल की तरह पढ़ सके।image_config: हमaspect_ratioको "1:1" (स्क्वायर) सेट करते हैं, लेकिन इसे विशेष AI उपयोग मामले के अनुसार आसानी से समायोजित किया जा सकता है।
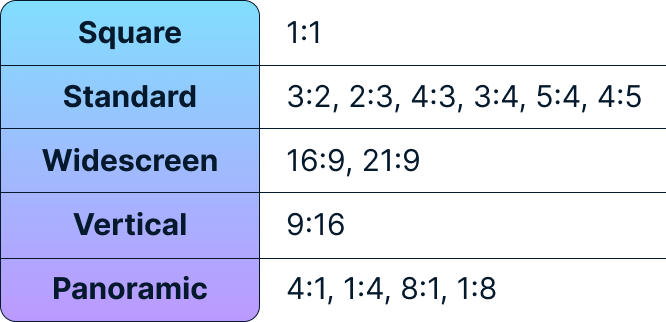
समर्थित आस्पेक्ट रेशियो:
चरण 4: Python इमेज जेनरेशन स्क्रिप्ट चलाना
अब सब कुछ एक साथ जोड़ते हैं और Nano Banana 2 Lite से एक इमेज जेनरेट करने के लिए कहते हैं!
हम इसे कुछ रचनात्मक के लिए प्रॉम्प्ट करेंगे, प्राप्त इमेज पर show() फ़ंक्शन कॉल करके AI-जनित आर्टवर्क देखेंगे, और संसाधन मुक्त करने के लिए क्लाइंट बंद करेंगे।
if __name__ == "__main__":
# Define our creative prompt for the AI model
my_prompt = "A futuristic city skyline at sunset, cyberpunk style, highly detailed"
# Generate the AI image
result_image = generate_image(client, my_prompt)
# Display the resulting image
if result_image:
print("AI Image generated successfully!")
result_image.show()
else:
print("Failed to generate AI image.")
# Close the client to prevent shutdown exceptions
client.close()यहाँ Nano Banana 2 Flash द्वारा जेनरेट की गई इमेज है:
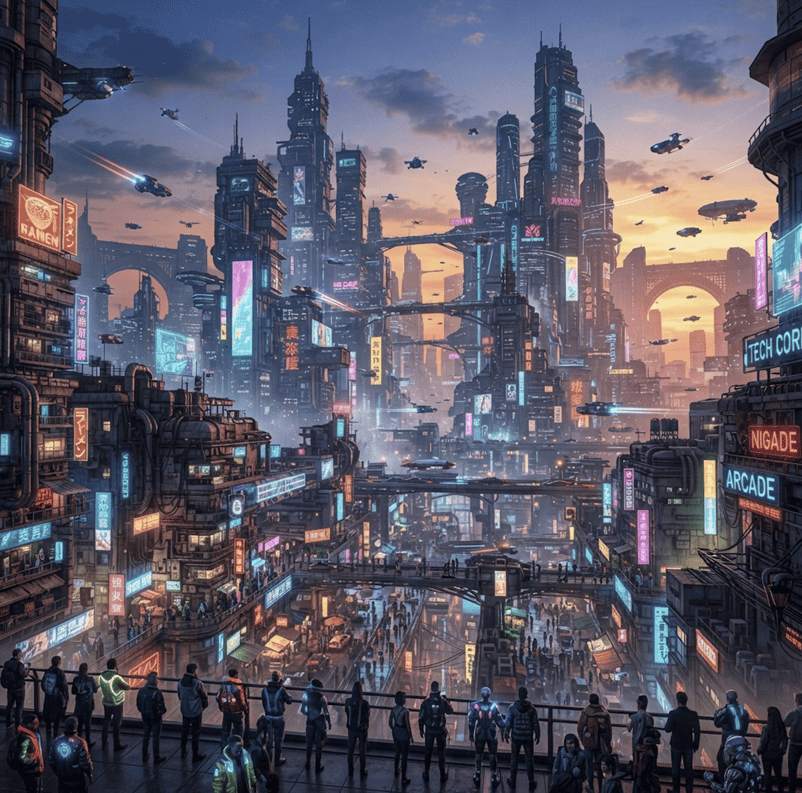
Google द्वारा अपनी घोषणा में किए गए वादे के मुताबिक, मॉडल ने इमेज जेनरेट करने में केवल कुछ सेकंड लिए। पहली नज़र में, यह अब तक आज़माए गए अन्य किसी भी मॉडल से काफी तेज़ महसूस होता है।
पूरा स्क्रिप्ट generate_image.py इस ट्यूटोरियल की रिपोजिटरी में मिल सकता है।
स्क्रिप्ट को इमेज एडिटिंग तक बढ़ाना
आइए एक फ़ंक्शन edit_image() लिखते हैं जो इमेज एडिट करता है। अनुरोध में केवल यही बदलाव करना है कि contents पैरामीटर में इमेज को प्रॉम्प्ट के साथ एक सूची [image, prompt] के रूप में दें।
def edit_image(client, image: Image.Image, prompt: str, aspect_ratio: str = "1:1") -> Image.Image | None:
"""
Edits an AI image using the Gemini 3.1 Flash Lite model via the Gemini API.
"""
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=[image, prompt],
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=aspect_ratio),
),
)
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
return Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return NoneNano Banana 2 Flash का परीक्षण
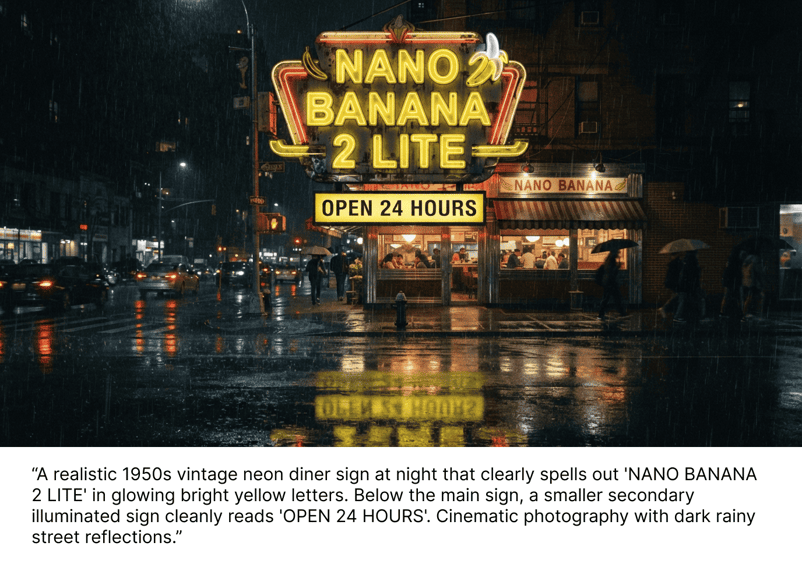
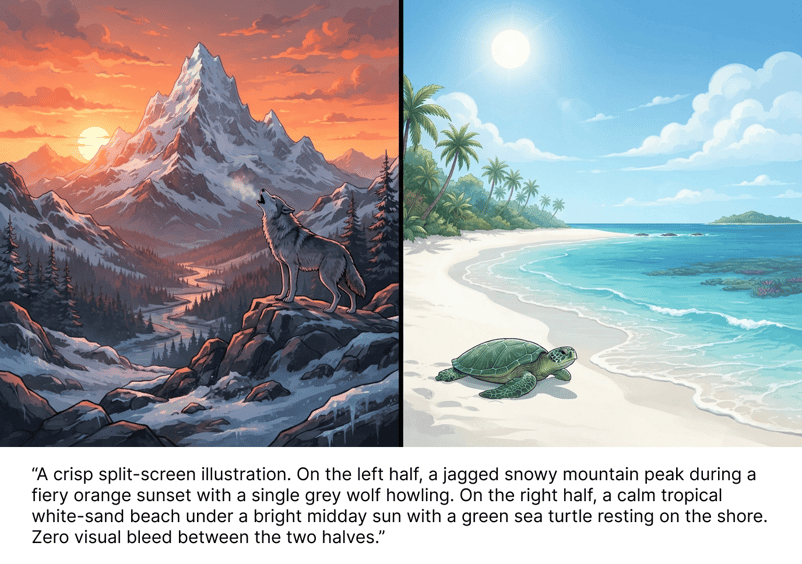
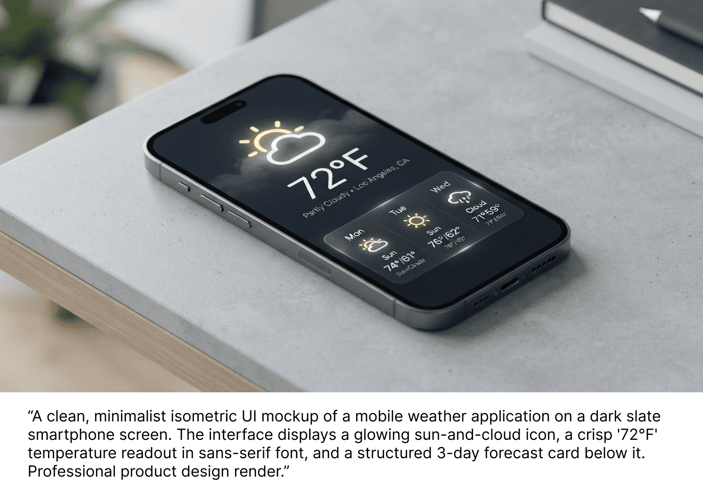
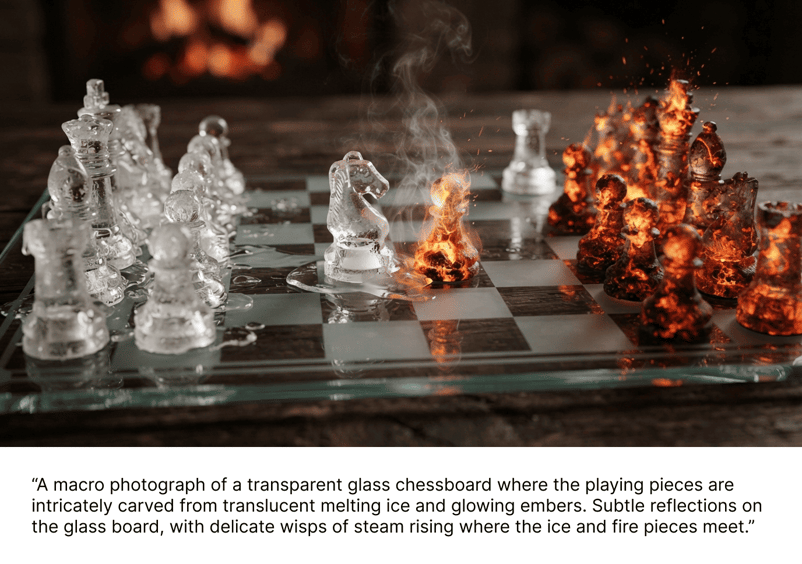
हमने लक्षित स्ट्रेस टेस्ट की एक श्रृंखला आयोजित करके वास्तविक दुनिया में मॉडल के प्रदर्शन का मूल्यांकन किया।
ये मूल्यांकन मॉडल की जटिल विज़ुअल कार्यों—जैसे पठनीय टेक्स्ट रेंडरिंग, सख्त स्थानिक लेआउट बनाए रखना, और मल्टी-टर्न इंटरैक्शंस में सुसंगतता सुनिश्चित करना—को संभालने की क्षमता पर केंद्रित हैं, ताकि यह तय किया जा सके कि क्या यह वास्तव में उच्च गति पर उच्च-फिडेलिटी जेनरेशन के अपने वादे पर खरा उतरता है।
इमेज के भीतर पठनीय टेक्स्ट रेंडरिंग का परीक्षण
कड़े स्थानिक नियंत्रण और द्वि-विषय अनुपालन का परीक्षण
तेज़ UI प्रोटोटाइपिंग और लेआउट परिशुद्धता का परीक्षण
जटिल सामग्री कंट्रास्ट और लाइटिंग का परीक्षण
मल्टी-टर्न कैरेक्टर सुसंगतता का परीक्षण
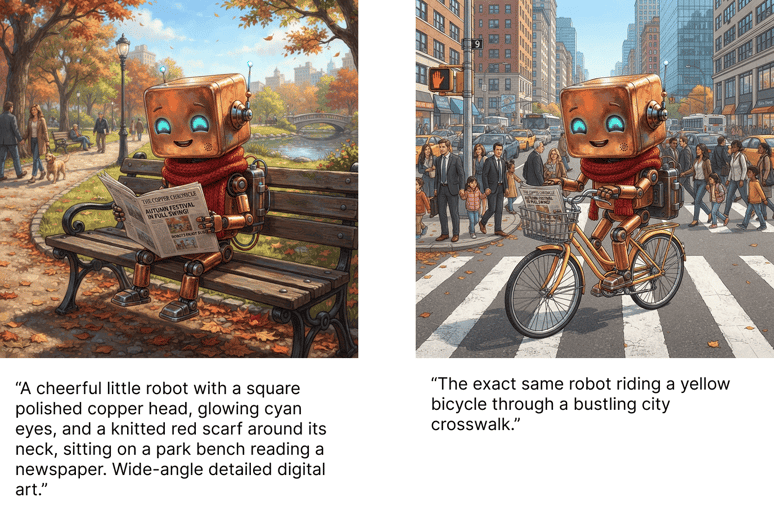
सच कहूँ तो, इतने तेज़ मॉडल के लिए परिणामों से मैं काफ़ी प्रभावित हूँ। अंतिम उदाहरण में, मॉडल अख़बार के टेक्स्ट की सुसंगतता को भी कुछ हद तक बनाए रखने में सफल रहा।
मेरे अनुभव में, सुसंगतता बनाए रखना उन सबसे महत्वपूर्ण पहलुओं में से एक है, जिन्हें एक इमेज जेनरेशन मॉडल को वाकई उपयोगी होने के लिए बखूबी निभाना चाहिए।
Python में Gemini Omni Flash से वीडियो कैसे जेनरेट करें
इस अनुभाग में, हम एक Python स्क्रिप्ट बनाना सीखेंगे जो वीडियो जेनरेट करे—एक साधारण टेक्स्ट-टू-वीडियो प्रॉम्प्ट से शुरू करते हुए और फिर रेफरेंस इमेज को शामिल करने तक विस्तार करते हुए।
मानक इमेज जेनरेशन के विपरीत, Gemini Omni Flash के साथ वीडियो जेनरेट करना SDK के Interactions API (client.interactions.create) के माध्यम से किया जाता है। यह एंडपॉइंट विशेष रूप से समृद्ध, मल्टी-टर्न और मल्टीमोडल इंटरैक्शंस के लिए डिज़ाइन किया गया है।
चूँकि आवश्यक SDK इम्पोर्ट्स, वातावरण वेरिएबल सेटअप, और Google GenAI क्लाइंट इनिशियलाइज़ेशन, पिछले सेक्शन में बताए इमेज जेनरेशन प्रोसेस के समान हैं, हम सीधे अपने वीडियो जेनरेशन फ़ंक्शंस लिखने पर ध्यान केंद्रित कर सकते हैं।
चरण 1: टेक्स्ट-टू-वीडियो (सरल प्रॉम्प्ट-टू-वीडियो)
सिर्फ टेक्स्ट प्रॉम्प्ट से वीडियो जेनरेट करने के लिए, हम Interactions API को एक सिंगल टेक्स्ट इनपुट ब्लॉक पास करते हैं। इसे संभालने के लिए हम एक साधारण Python फ़ंक्शन लिख सकते हैं:
def text_to_video(client, prompt: str, aspect_ratio: str = "16:9", duration: str = "5s"):
"""
Generates a video from a text prompt using Gemini Omni Flash.
"""
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=[{"type": "text", "text": prompt}],
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
"duration": duration,
},
)
return interactionहम इस फ़ंक्शन को कॉल कर सकते हैं और लौटे वीडियो बाइट्स को फ़ाइल में सेव कर सकते हैं, इस प्रकार:
if __name__ == "__main__":
import base64
# Define a creative video prompt
text_prompt = """
Generate a first person view of what daily life would look like in the year
1000 at this location: 41.89030621184054, 12.492266126772481
"""
# Call the video generator
interaction = text_to_video(
client=client,
prompt=text_prompt,
aspect_ratio="16:9",
duration="5s"
)
# Extract and save the generated video file
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
# Decode the base64-encoded video data returned by the API
video_bytes = base64.b64decode(interaction.output_video.data)
# Save the bytes locally as an MP4 file
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)
else:
print("Failed to generate video.")हमने जो प्रॉम्प्ट इस्तेमाल किया था, वह यह है:
Generate a first-person view of what daily life would look like in the year 1000 at this location: 41.89030621184054, 12.492266126772481वह विशिष्ट स्थान रोमन कोलोसियम है। मैंने मॉडल के विश्व-ज्ञान का परीक्षण करने के लिए निर्देशांक का उपयोग किया। यह वह वीडियो है जो जेनरेट हुआ:
इसके विपरीत, जब मैंने वर्ष 1000 को वर्ष 1980 से बदल दिया, तो मॉडल ने यह जनरेट किया:
मेरी राय में यह काफ़ी दिलचस्प है। पूरा स्क्रिप्ट देखने के लिए text_to_video.py फ़ाइल देखें।
चरण 2: इमेज-टू-वीडियो क्षमता लागू करना
किसी स्थिर छवि को एनिमेट करने या उसे वीडियो जेनरेशन को निर्देशित करने के लिए रेफरेंस के रूप में उपयोग करने हेतु, हमें मॉडल को छवि और एक टेक्स्ट प्रॉम्प्ट दोनों पास करने होते हैं।
क्योंकि Interactions API को इमेज इनपुट base64-एन्कोडेड चाहिए होता है, हम पहले एक हेल्पर फ़ंक्शन परिभाषित करते हैं जो PIL Image ऑब्जेक्ट्स को base64 स्ट्रिंग्स में बदलता है:
import io
from PIL import Image
import base64
def _image_to_base64(img: Image.Image) -> str:
"""
Converts a PIL Image object to a base64-encoded string.
"""
buffered = io.BytesIO()
img.save(buffered, format="PNG")
return base64.b64encode(buffered.getvalue()).decode()अब हम एक अधिक सामान्य फ़ंक्शन generate_video() बना सकते हैं, जो वैकल्पिक इमेज और टेक्स्ट प्रॉम्प्ट—दोनों को हैंडल करता है।
from google.genai import types
def generate_video(client, valid_images: list[Image.Image], animation_prompt: str, aspect_ratio: str):
"""
Generates a commercial-quality AI video using Google's Gemini Omni Flash model.
Supports image-to-video and text-to-video multimodal inputs using the Gemini API.
"""
omni_inputs = []
# 1. Base64 encode and append any input images
for img in valid_images:
img_b64 = _image_to_base64(img)
omni_inputs.append({
"type": "image",
"data": img_b64,
"mime_type": "image/png",
})
# 2. Append the text animation prompt
omni_inputs.append({"type": "text", "text": animation_prompt})
# 3. Request video generation from the interactions endpoint
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=omni_inputs,
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
},
)
return interactionअंत में, यहाँ बताया गया है कि मैंने Gemini से जनरेट की गई इस भृंग (beetle) छवि को एनिमेट करने वाला वीडियो बनाने के लिए इन फ़ंक्शनों का उपयोग कैसे किया:
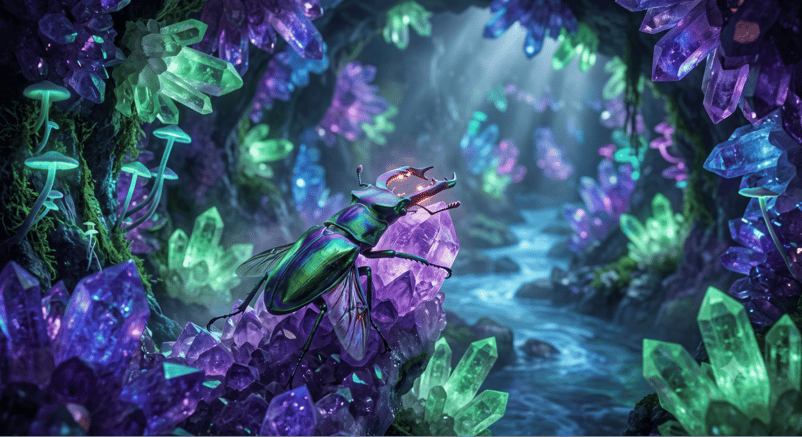
if __name__ == "__main__":
# Load our reference image
reference_image = Image.open("images/beetle.png").convert("RGB")
# Describe how we want the image to be animated
animation_prompt = """
A detailed, close-up photograph of an iridescent biomechanical stag beetle,
shimmering with metallic green, blue, and violet hues, as it traverses a
rugged amethyst crystal formation in a subterranean grotto.
The cavern walls are lined with a dense matrix of glowing crystals emitting
deep purple, blue, and green light. The air is misty, with bioluminescent
flora clinging to the rock. As the camera maintains focus, the beetle
subtly activates a soft internal orange glow from its mandibles, begins
vibrating its wings, and slowly crawls upward across the crystalline
surface, reflecting the surrounding light.
"""
# Call the generator with the reference image
interaction = generate_video(
client=client,
valid_images=[reference_image],
animation_prompt=animation_prompt,
aspect_ratio="16:9"
)
# Extract and save the animated video
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
video_bytes = base64.b64decode(interaction.output_video.data)
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)यह रहा वह वीडियो जो इसने जनरेट किया:
पूरा स्क्रिप्ट यहाँ उपलब्ध है।
चरण 3: वीडियो-टू-वीडियो के साथ वीडियो एडिटिंग लागू करना
Gemini Omni Flash API के साथ बातचीत के ज़रिए वीडियो एडिट करना, इंटरैक्शंस के उपयोग की वजह से, अत्यंत आसान हो जाता है। जब हम कोई वीडियो जनरेट करते हैं, तो हमें एक इंटरैक्शन आइडेंटिफ़ायर मिलता है, जिसे interaction.id के रूप में एक्सेस किया जा सकता है।
वीडियो एडिट करने के लिए, हम एक प्रॉम्प्ट और पिछले इंटरैक्शन का आइडेंटिफ़ायर प्रदान कर सकते हैं। यदि यह पहली एडिट है, तो हम उस इंटरैक्शन का आइडेंटिफ़ायर देते हैं जिसका उपयोग वीडियो जनरेट करने के लिए किया गया था। आगे की एडिट्स के लिए, हम पिछली एडिट के आइडेंटिफ़ायर का उपयोग करते हैं।
client.interactions.create(
model="gemini-omni-flash-preview",
input=edit_prompt,
previous_interaction_id=previous_interaction_id,
)एक इंटरैक्टिव AI वीडियो स्टूडियो बनाना: आर्किटेक्चर और मल्टी-मॉडल समन्वय
पिछले सेक्शनों में, हमने Nano Banana 2 Lite से प्रोग्रामेटिक रूप से इमेजेज जनरेट करना और Gemini Omni Flash से वीडियो बनाना सीखा। अब, हम देखेंगे कि इन क्षमताओं को एक ही, सुसंगत, इंटरैक्टिव वेब एप्लिकेशन—AI वीडियो स्टूडियो—में कैसे जोड़ा जाए।
AI वीडियो स्टूडियो का आर्किटेक्चर
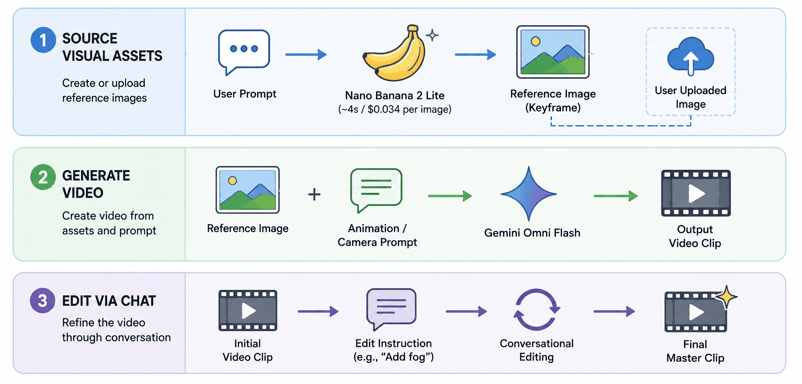
उच्च-गुणवत्ता वाले AI वीडियो बनाना आमतौर पर काफ़ी ट्रायल-एंड-एरर मांगता है। AI वीडियो स्टूडियो इसे दो-चरणीय, मल्टी-मॉडल पाइपलाइन लागू करके हल करता है, जो दो अलग-अलग मॉडलों की विशिष्ट ताकतों का लाभ उठाता है:
- एसेट सोर्सिंग: Nano Banana 2 Lite द्वारा संचालित, उपयोगकर्ता तेज़ी से संसाधन और रेफरेंस इमेजेज जनरेट कर सकते हैं और उन्हें अपनी मौजूदा छवियों के साथ संयोजित कर सकते हैं।
- वीडियो जेनरेशन: हम उन्हीं एसेट्स के आधार पर वीडियो जनरेट करने के लिए Gemini Omni Flash का उपयोग करते हैं।
- वीडियो एडिशन: वीडियो जनरेट होने के बाद, हम उसे बातचीत के ज़रिए एडिट कर सकते हैं।
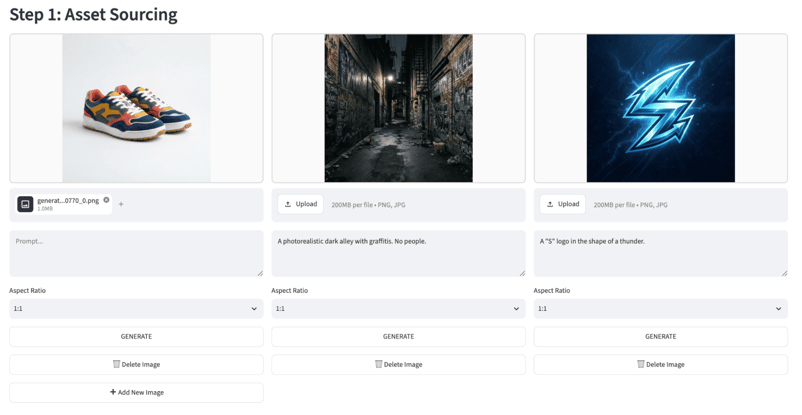
चरण 1: Nano Banana 2 Lite के साथ तेज़ प्रोटोटाइपिंग
पहले चरण में, एप्लिकेशन हमें रेफरेंस इमेजेज (कीफ़्रेम्स) सोर्स करने देता है। हम या तो कोई लोकल इमेज अपलोड कर सकते हैं या तुरंत एक जनरेट कर सकते हैं।
यहीं Nano Banana 2 Lite की ताकत नज़र आती है।
लगभग 4 सेकंड से कम लेटेंसी और प्रति इमेज बेहद कम लागत के साथ, यह एक अल्ट्रा-फास्ट सैंडबॉक्स का काम करता है। हम दर्जनों अलग-अलग विज़ुअल स्टाइल, कंपोज़िशन और सब्जेक्ट्स का तेजी से प्रोटोटाइप बना सकते हैं, जब तक कि हमें परफ़ेक्ट कीफ़्रेम न मिल जाए।
चरण 2: Gemini Omni Flash के साथ मल्टीमॉडल जेनरेशन
जब हमारे पास परफ़ेक्ट रेफरेंस इमेज हो जाती है, तो हम वीडियो प्रोडक्शन चरण में जाते हैं।
रेफरेंस इमेज और हमारा एनीमेशन प्रॉम्प्ट (जैसे, कैमरा मूवमेंट, लाइटिंग में बदलाव, या एक्शन का वर्णन) base64-एन्कोड करके SDK के Interactions API के ज़रिए Gemini Omni Flash को भेजे जाते हैं।
Gemini Omni Flash इन इनपुट्स को प्रोसेस करता है और वाइडस्क्रीन (16:9) या वर्टिकल (9:16) फ़ॉर्मैट में एक उच्च-गुणवत्ता वाला वीडियो क्लिप लौटाता है।
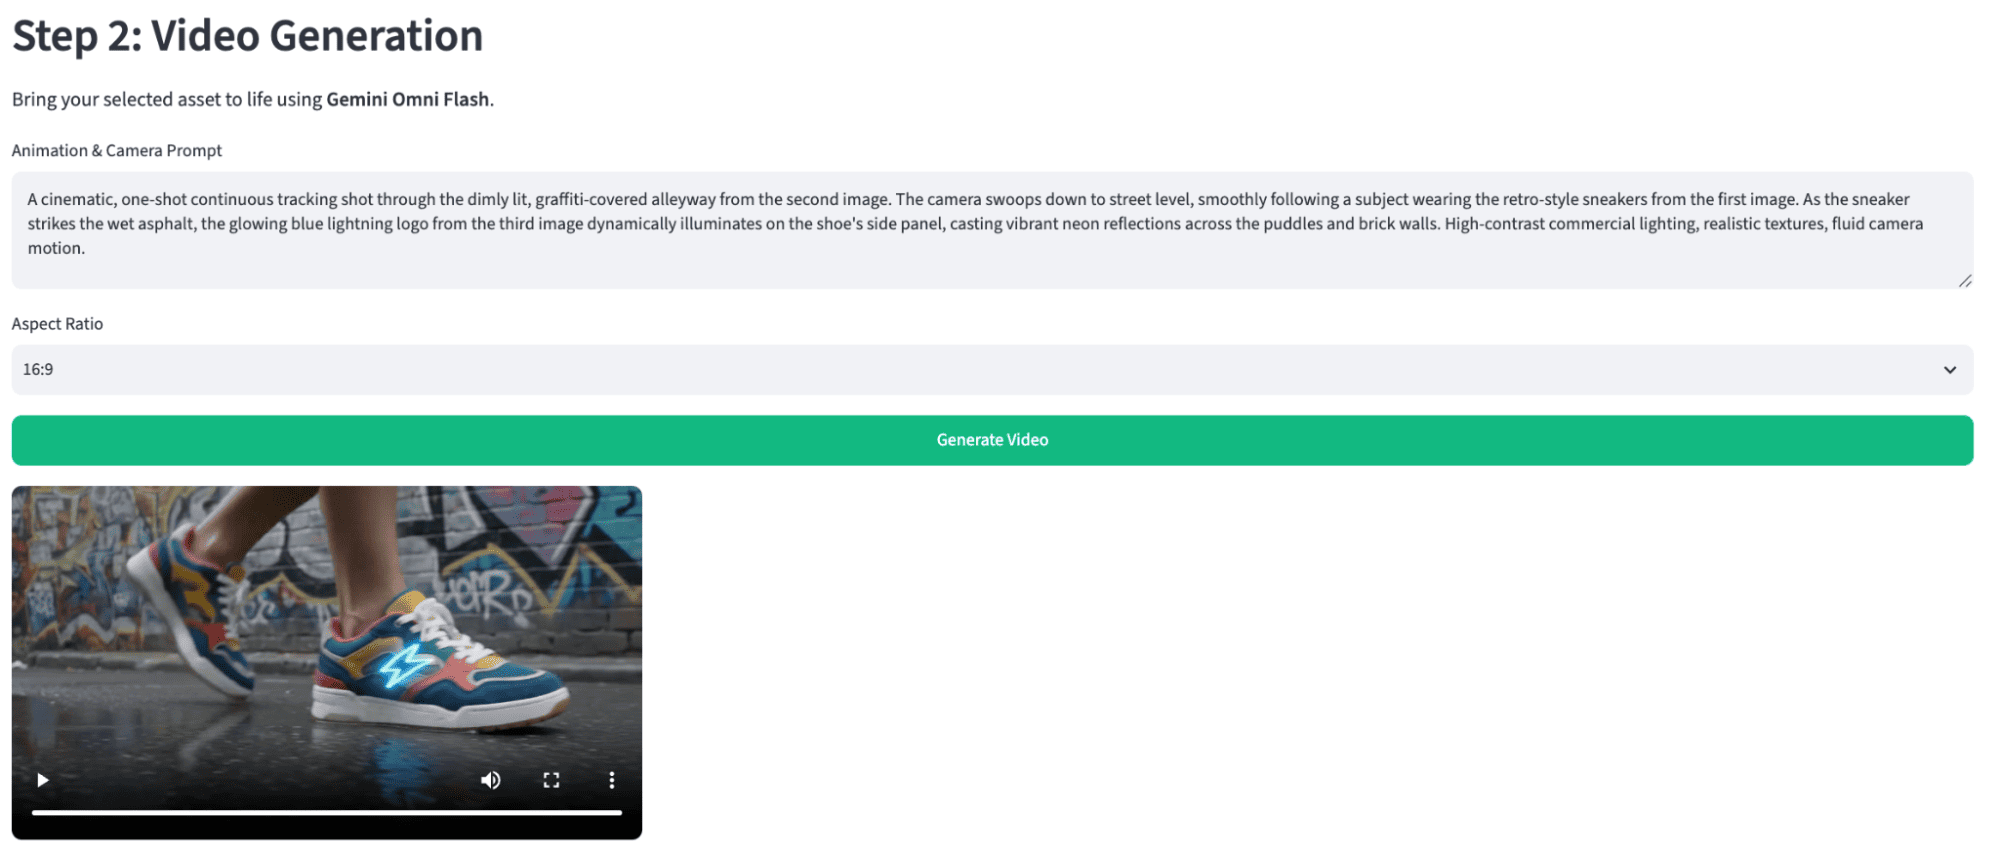
यह रहा हमें मिला वीडियो:
Streamlit वीडियो जेनरेशन ऐप का इम्प्लीमेंटेशन
यूज़र इंटरफ़ेस बनाने के लिए, हम Streamlit का उपयोग करते हैं—यह एक लोकप्रिय ओपन-सोर्स Python फ़्रेमवर्क है, जो मशीन लर्निंग और डेटा साइंस के लिए शेयर करने योग्य वेब ऐप्स बनाना बेहद आसान बनाता है।
यदि आप Streamlit में नए हैं या यह कैसे काम करता है इसका रिफ़्रेशर चाहते हैं, तो हम यह Python Streamlit Tutorial पढ़ने की अत्यधिक अनुशंसा करते हैं।
हम Streamlit UI कोड पर नहीं, बल्कि वीडियो जेनरेशन पाइपलाइन की आर्किटेक्चर पर ध्यान देंगे और देखेंगे कि इन दो शक्तिशाली मॉडलों को मिलाकर कौन-सी रचनात्मक संभावनाएँ खुलती हैं।
जो फ़ंक्शंस हमने ऊपर इमेज और वीडियो जनरेट करने के लिए इम्प्लीमेंट किए हैं, वे gemini_api.py स्क्रिप्ट में हैं। यूज़र इंटरफ़ेस Streamlit के साथ app.py स्क्रिप्ट में इम्प्लीमेंट किया गया है।
यदि आप इसे लोकल रूप से चलाकर प्रयोग करना चाहते हैं, तो निम्न करें:
git clone [email protected]:fran-aubry/nano-banana-2-flash-tutorial.git
pip install -r requirement.txt
streamlit run app.pyयहाँ एक पूरा वर्कफ़्लो उदाहरण है जो एक काल्पनिक चाय ब्रांड की मौजूदा इमेज को जनरेट की गई चाय बागान की छवि के साथ मिलाकर उसी चाय कैन के लिए एक कमर्शियल शॉट बनाता है।
फिर हम प्रॉम्प्ट का उपयोग करके वीडियो को एडिट करते हैं।
वीडियो जेनरेशन के दौरान वीडियो को तेज़ कर दिया गया था क्योंकि इन्हें पूरा होने में कुछ मिनट लग सकते हैं।
निष्कर्ष
Google द्वारा अपने नए Nano Banana 2 Lite मॉडल के बारे में किए गए स्पीड संबंधी दावे सही हैं।
यह मॉडल अविश्वसनीय रूप से तेज़ है और रीयल-टाइम में इमेज जनरेट करने के क़रीब पहुँच रहा है। जबकि यह जिन इमेजेज को जनरेट करता है वे अच्छी हैं, वे बिल्कुल क्रांतिकारी नहीं हैं। मॉडल का प्रमुख नवाचार निस्संदेह इसकी प्रभावशाली गति है, न कि इमेज क्वालिटी में कोई भूचाल लाने वाली छलांग।
एक साथ उपयोग करने पर, Gemini Omni Flash और Nano Banana 2 Lite मिलकर एक शक्तिशाली पाइपलाइन बनाते हैं। Omni मॉडल रेफरेंस सामग्री के प्रति निष्ठा बनाए रखने में विशेष रूप से प्रभावी है।
Nano Banana 2 के बारे में अधिक जानने के लिए, यह लेख देखें: Nano Banana 2: A Full Guide With Python.
Gemini Omni श्रृंखला में गहराई से जाने के लिए, मैं यह पढ़ने की सलाह देता/देती हूँ: Gemini Omni: One Model for Text, Image, Audio, and Video.
FAQs
Nano Banana 2 Lite और Gemini Omni Flash उद्देश्य में कैसे अलग हैं?
Nano Banana 2 Lite उच्च-गति, किफ़ायती इमेज जेनरेशन (त्वरित प्रोटोटाइपिंग के लिए आदर्श) के लिए अनुकूलित है, जबकि Gemini Omni Flash मल्टीमॉडल वीडियो जेनरेशन और बातचीत-आधारित वीडियो एडिटिंग के लिए बनाया गया है।
क्या मैं बिना शुरू से जनरेट किए वीडियो को एडिट कर सकता/सकती हूँ?
हाँ। Gemini Omni Flash बातचीत-आधारित वीडियो एडिटिंग की अनुमति देता है। आप एक प्रॉम्प्ट के साथ पिछले इंटरैक्शन ID प्रदान करके, नैचुरल लैंग्वेज के माध्यम से मौजूदा वीडियो सीक्वेंस को परिष्कृत कर सकते हैं।
क्या Nano Banana 2 Lite वास्तविक-समय यूज़र एप्लिकेशंस के लिए उपयुक्त है?
लगभग 4 सेकंड प्रति इमेज की अल्ट्रा-लो लेटेंसी के साथ, यह विशेष रूप से उन इंटरैक्टिव एप्लिकेशंस के लिए बना है जहाँ स्पीड और बजट प्राथमिक चिंताएँ हैं।
इन मॉडलों के लिए प्राथमिक लागत विचार क्या हैं?
दोनों मॉडल लागत-दक्षता को प्राथमिकता देते हैं। Nano Banana 2 Lite की लागत 1K-रिज़ॉल्यूशन इमेज पर $0.034 है, और Gemini Omni Flash की कीमत वीडियो आउटपुट के प्रति सेकंड $0.10 है, जो उन्हें उच्च-वॉल्यूम पाइपलाइनों के लिए उपयुक्त बनाता है।

Google ने हाल ही में Nano Banana 2 Lite और Gemini Omni Flash जारी किए हैं—दो मॉडल जो AI डेवलपमेंट में गति और मल्टीमोडल क्षमताओं को नई परिभाषा देने के लिए बनाए गए हैं।
ये मॉडल अल्ट्रा-लो लेटेंसी इमेज जेनरेशन और बहुमुखी संवादात्मक वीडियो एडिटिंग का शक्तिशाली संयोजन प्रस्तुत करते हैं।
इस लेख में, मैं इन मॉडलों की मुख्य क्षमताओं का अन्वेषण करता/करती हूँ और एक पूर्ण AI वीडियो एडिटर पाइपलाइन बनाता/बनाती हूँ जो उपयोगकर्ताओं को Nano Banana 2 Lite के साथ इमेज चुनने और जेनरेट करने, फिर उन्हें एक वीडियो में जोड़ने देती है।
यहाँ उस ऐप का डेमो वीडियो है जिसे हम बनाएँगे: