

Apa itu Nano Banana 2 Lite?
Nano Banana 2 Lite (gemini-3.1-flash-lite-image) adalah model pembuatan gambar Google yang paling cepat dan paling hemat biaya hingga saat ini.
Dibangun khusus untuk pipeline pengembang berkecepatan tinggi dan aplikasi ber-throughput tinggi, model ini dioptimalkan untuk skenario dengan latensi rendah dan anggaran operasional ketat sebagai kendala utama.
Untuk platform yang saat ini menggunakan model lama Google (gemini-2.5-flash-image), Nano Banana 2 Lite dapat menjadi pengganti langsung, menghadirkan peningkatan instan pada kecepatan, biaya, dan fidelitas visual.
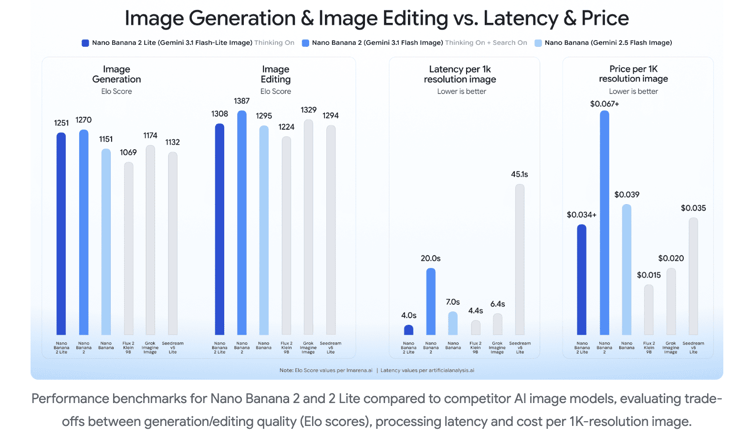
Metrik kinerja utama
- Latensi sangat rendah: Menghasilkan keluaran teks-ke-gambar dalam sekitar 4 detik, ideal untuk prototyping interaktif dan aplikasi pengguna waktu nyata.
- Efisiensi biaya: Dibanderol $0,034 per gambar resolusi 1K, secara signifikan menurunkan hambatan untuk produksi dalam volume tinggi.
- Retensi kualitas: Meski berfokus pada kecepatan, model ini menjaga kepatuhan terhadap prompt, perenderan karakter yang konsisten, dan pembuatan teks di dalam gambar yang andal.
Apa itu Gemini Omni Flash?
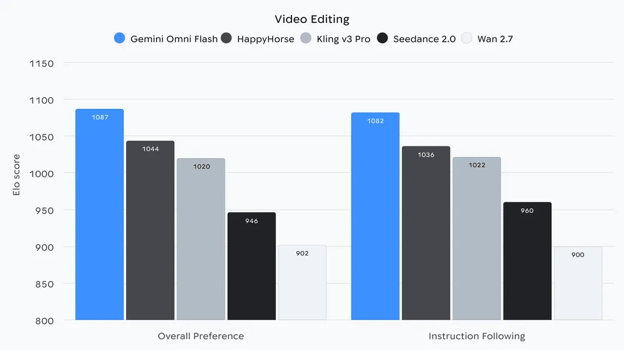
Gemini Omni Flash (gemini-omni-flash-preview) adalah model hemat biaya Google untuk pembuatan video dan pengeditan video percakapan.
Berbeda dari pembuat video mandiri yang ketat bergantung pada prompt teks statis, Omni Flash menghadirkan penalaran multimodal inti Gemini langsung ke proses pembuatan video.
Model ini secara native menerima kombinasi masukan teks, gambar, dan video, memungkinkan kontrol programatik atas pembuatan video dengan presisi yang belum pernah ada sebelumnya.
Kapabilitas inti dan harga Omni Flash
- Harga kompetitif: Dibanderol $0,10 per detik output video, menyamai tarif Veo 3.1 Fast.
- Pengeditan video percakapan: Alih-alih membuat ulang video dari awal untuk penyesuaian kecil, aplikasi dapat menggunakan instruksi bahasa alami untuk menyempurnakan urutan yang ada.
- Referensi multimodal: Prompt teks dapat dipadukan dengan gambar atau klip referensi untuk memastikan konsistensi visual dan kontrol granular atas elemen adegan.
- Landasan dunia nyata: Memanfaatkan pengetahuan dasar Gemini, model ini membangun animasi realistis berdasarkan logika dan fisika.
- Sinkronisasi teks & aksi: Teks di layar dan overlay grafis dapat ditautkan langsung ke aksi video melalui prompt sederhana.
Cara Membuat dan Menyiapkan Kunci API Gemini
Sebelum kita dapat menggunakan API Gemini, kita perlu membuat dan menyiapkan kunci API agar kode kita dapat berkomunikasi dengan API tersebut.
Cara termudah untuk melakukannya adalah:
- Kunjungi halaman kunci API Google’s AI Studio dan masuk.
- Klik tombol “Create API key” di pojok kanan atas.
- Salin kunci API ke dalam file bernama
.envdi folder yang sama dengan kode Python dengan format berikut:
GEMINI_API_KEY=replace_with_api_keyCatatan: Menggunakan API menimbulkan biaya. Untuk menggunakannya, kita perlu memastikan metode pembayaran telah dikonfigurasi di halaman penagihan Google’s AI Studio.
Cara Membuat Gambar dengan Nano Banana 2 Lite di Python
Prasyarat untuk Pembuatan Gambar AI di Python
Sebelum mulai menulis kode generator gambar AI Python, pastikan alat berikut siap:
- Python 3.9+ terpasang di sistem.
- Kunci API Google Gemini: Kunci API Google Gemini yang valid untuk mengautentikasi permintaan. Lihat langkah di atas untuk membuat dan mengonfigurasikan kunci.
- Pustaka Python yang Diperlukan: Kita akan menggunakan SDK resmi
google-genaiuntuk integrasi API dan Pillow untuk menangani keluaran gambar.
Paket Python yang diperlukan dapat dipasang menggunakan pip:
pip install google-genai pillow python-dotenvLangkah 1: Mengimpor modul dan memuat variabel lingkungan
Buat file baru (misalnya, generate_image.py) dan tambahkan impor serta urutan pemuatan berikut untuk menyiapkan lingkungan:
import io
from dotenv import load_dotenv
from google.genai import types
from PIL import Image
from google.genai import Client
# Load environment variables from the .env file
load_dotenv()Langkah 2: Menginisialisasi klien Google GenAI
Untuk berinteraksi dengan model Nano Banana 2 Lite, pertama-tama kita harus menginisialisasi klien Google GenAI.
Karena SDK secara otomatis memeriksa variabel lingkungan sistem untuk GEMINI_API_KEY (yang dimuat dari file .env pada langkah sebelumnya), kita dapat menginisialisasi klien tanpa menyertakan kunci API secara eksplisit di kode.
# Initialize the Gemini API client
client = Client()Langkah 3: Menulis fungsi pembuatan gambar AI
Sekarang ke logika inti skrip Python kita. Kita akan menulis fungsi Python khusus, generate_image(), yang menerima klien yang sudah diinisialisasi dan prompt teks sebagai masukan.
Nano Banana 2 Lite dipanggil dengan menentukan model="gemini-3.1-flash-lite-image". Kita mengonfigurasi permintaan API untuk mengharapkan modality gambar dan menentukan rasio aspek yang diinginkan untuk pembuatan gambar AI.
def generate_image(client, prompt: str, ratio: str = "1:1") -> Image.Image | None:
"""
Generates an AI image using the Nano Banana 2 Lite model via the Gemini API.
"""
print(f"Generating AI image for prompt: '{prompt}'...")
# 1. Call the Nano Banana 2 Lite model
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=prompt,
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=ratio),
),
)
# 2. Extract and convert the generated image data
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
# Load the bytes into a PIL Image and convert to RGB
image = Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return image
return NoneMemahami permintaan pembuatan gambar Python:
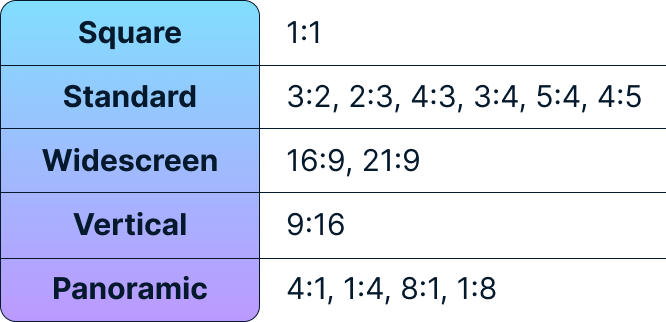
response_modalities: Ini memaksa model Google Gemini untuk mengembalikan gambar alih-alih teks.inline_data: API Gemini mengembalikan gambar yang dihasilkan sebagai byte mentah. Kita menggunakanio.BytesIOPython untuk membungkus byte ini agar Pillow (Image.open) dapat membacanya sebagai file gambar standar.image_config: Kita menetapkanaspect_ratioke "1:1" (persegi), namun ini dapat dengan mudah disesuaikan tergantung pada kasus penggunaan aplikasi AI spesifik.
Rasio aspek yang didukung:
Langkah 4: Menjalankan skrip pembuatan gambar Python
Mari kita gabungkan semuanya dan meminta Nano Banana 2 Lite untuk membuat gambar!
Kita akan memberinya prompt yang kreatif, memanggil fungsi show() pada gambar hasilnya untuk melihat karya seni yang dihasilkan AI, dan menutup klien untuk membebaskan sumber daya.
if __name__ == "__main__":
# Define our creative prompt for the AI model
my_prompt = "A futuristic city skyline at sunset, cyberpunk style, highly detailed"
# Generate the AI image
result_image = generate_image(client, my_prompt)
# Display the resulting image
if result_image:
print("AI Image generated successfully!")
result_image.show()
else:
print("Failed to generate AI image.")
# Close the client to prevent shutdown exceptions
client.close()Berikut gambar yang dibuat oleh Nano Banana 2 Flash:
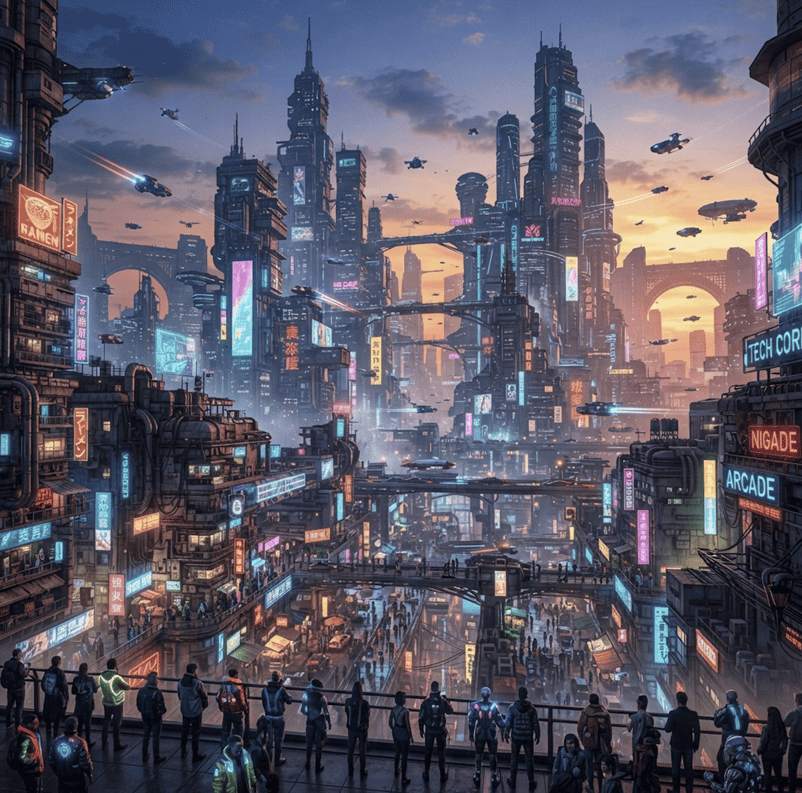
Seperti yang dijanjikan Google dalam pengumumannya, model ini hanya memerlukan beberapa detik untuk membuat gambar. Sekilas, rasanya jauh lebih cepat dibanding model lain yang pernah saya coba sejauh ini.
Skrip lengkap dapat ditemukan di skrip generate_image.py dari repositori tutorial ini.
Memperluas skrip ke pengeditan gambar
Mari kita tulis fungsi edit_image() yang mengedit gambar. Satu-satunya hal yang perlu kita ubah dalam permintaan adalah memberikan gambar bersama prompt pada parameter contents sebagai daftar [image, prompt].
def edit_image(client, image: Image.Image, prompt: str, aspect_ratio: str = "1:1") -> Image.Image | None:
"""
Edits an AI image using the Gemini 3.1 Flash Lite model via the Gemini API.
"""
response = client.models.generate_content(
model="gemini-3.1-flash-lite-image",
contents=[image, prompt],
config=types.GenerateContentConfig(
response_modalities=[types.Modality.IMAGE],
image_config=types.ImageConfig(aspect_ratio=aspect_ratio),
),
)
if response and response.candidates:
for part in response.candidates[0].content.parts:
if part.inline_data:
return Image.open(io.BytesIO(part.inline_data.data)).convert("RGB")
return NoneMenguji Nano Banana 2 Flash
Kami mengevaluasi kinerja dunia nyata model ini dengan melakukan serangkaian uji stres terarah.
Evaluasi ini berfokus pada kemampuan model untuk menangani tugas visual yang kompleks, seperti merender teks yang terbaca, mempertahankan tata letak spasial yang ketat, dan memastikan konsistensi di berbagai interaksi multi-giliran, untuk menentukan apakah model benar-benar memenuhi janjinya akan pembuatan berkualitas tinggi dengan kecepatan tinggi.
Menguji perenderan teks terbaca di dalam gambar
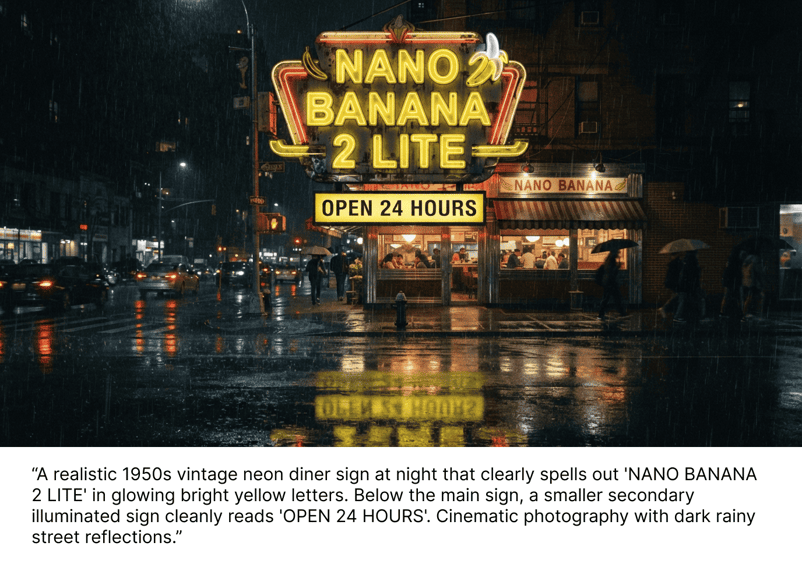
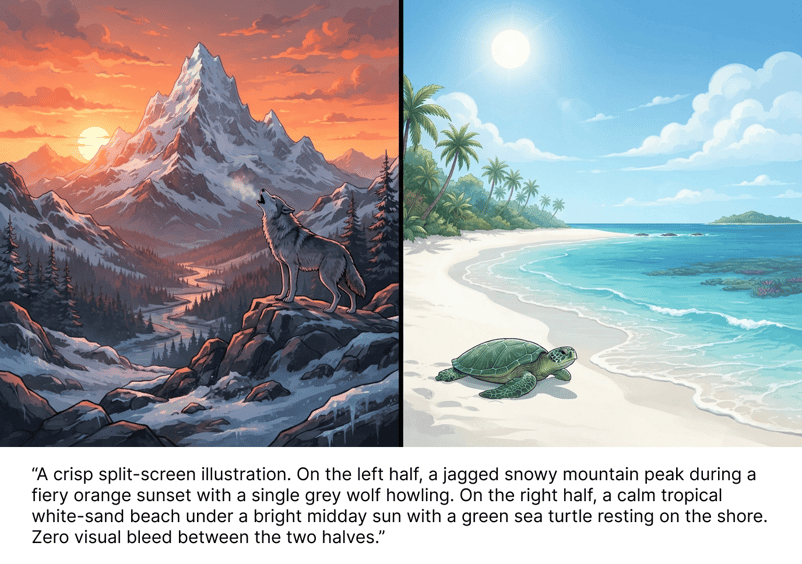
Menguji kontrol spasial ketat dan kepatuhan dua subjek
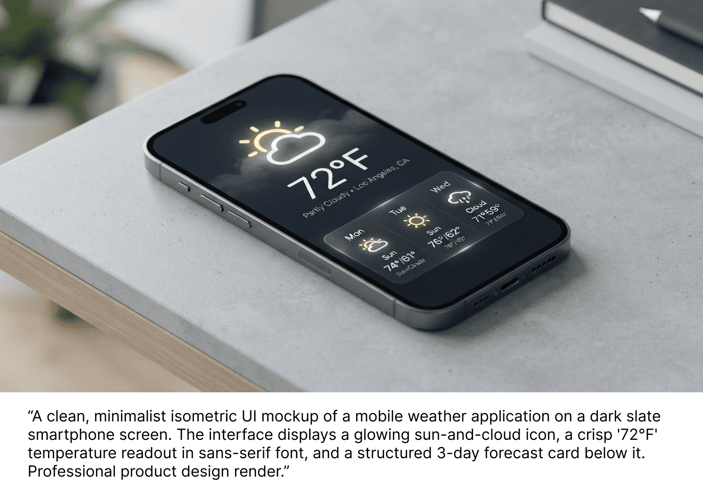
Menguji prototyping UI cepat dan presisi tata letak
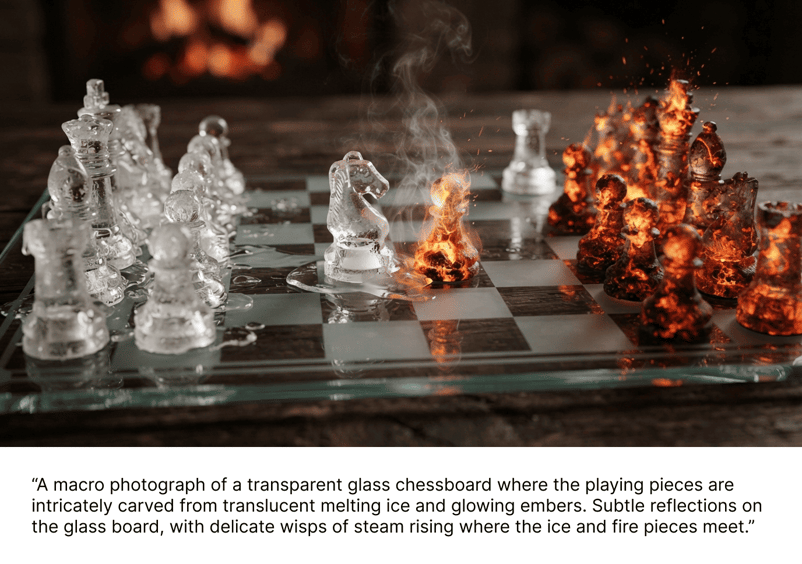
Menguji kontras material kompleks dan pencahayaan
Menguji konsistensi karakter multi-giliran
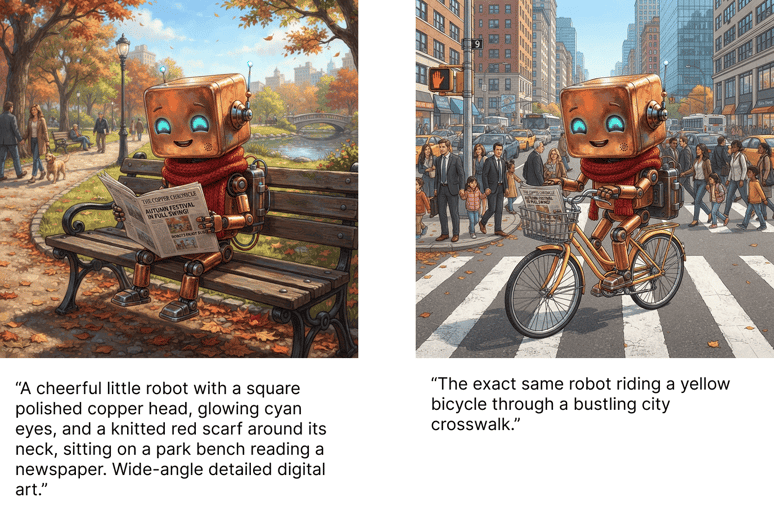
Sejujurnya, saya cukup terkesan dengan hasilnya untuk model secepat ini. Pada contoh terakhir, model bahkan berhasil somewhat mempertahankan konsistensi teks di koran.
Menurut pengalaman saya, menjaga konsistensi adalah salah satu aspek terpenting yang perlu dikuasai model pembuatan gambar agar benar-benar berguna.
Cara Membuat Video dengan Gemini Omni Flash di Python
Pada bagian ini, kita akan memandu cara membangun skrip Python untuk membuat video, dimulai dengan prompt teks-ke-video sederhana lalu mengembangkannya dengan menyertakan gambar referensi.
Tidak seperti pembuatan gambar standar, pembuatan video dengan Gemini Omni Flash dilakukan melalui Interactions API SDK (client.interactions.create). Endpoint ini dirancang khusus untuk menangani interaksi yang kaya, multi-giliran, dan multimodal.
Karena impor SDK yang diperlukan, penyiapan variabel lingkungan, dan inisialisasi klien Google GenAI identik dengan proses pembuatan gambar yang dijelaskan pada bagian sebelumnya, kita dapat langsung fokus menulis fungsi pembuatan video.
Langkah 1: Teks-ke-Video (Prompt-ke-Video Sederhana)
Untuk membuat video dari prompt teks saja, kita meneruskan satu blok masukan teks ke Interactions API. Kita dapat menulis fungsi Python sederhana untuk menanganinya:
def text_to_video(client, prompt: str, aspect_ratio: str = "16:9", duration: str = "5s"):
"""
Generates a video from a text prompt using Gemini Omni Flash.
"""
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=[{"type": "text", "text": prompt}],
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
"duration": duration,
},
)
return interactionKita dapat memanggil fungsi ini dan menyimpan byte video yang dikembalikan ke file, seperti ini:
if __name__ == "__main__":
import base64
# Define a creative video prompt
text_prompt = """
Generate a first person view of what daily life would look like in the year
1000 at this location: 41.89030621184054, 12.492266126772481
"""
# Call the video generator
interaction = text_to_video(
client=client,
prompt=text_prompt,
aspect_ratio="16:9",
duration="5s"
)
# Extract and save the generated video file
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
# Decode the base64-encoded video data returned by the API
video_bytes = base64.b64decode(interaction.output_video.data)
# Save the bytes locally as an MP4 file
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)
else:
print("Failed to generate video.")Prompt yang kita gunakan adalah:
Generate a first-person view of what daily life would look like in the year 1000 at this location: 41.89030621184054, 12.492266126772481Lokasi spesifik itu adalah Koloseum Romawi. Saya menggunakan koordinat untuk menguji pengetahuan dunia model. Ini adalah video yang dihasilkan:
Sebaliknya, berikut yang dihasilkan model saat saya mengganti tahun 1000 menjadi tahun 1980:
Cukup menarik menurut saya. Lihat file text_to_video.py untuk melihat skrip lengkapnya.
Langkah 2: Menerapkan kapabilitas Image-to-Video
Untuk menganimasikan gambar statis atau sekadar menggunakannya sebagai referensi untuk mengarahkan pembuatan video, kita harus memberikan baik gambar maupun prompt teks ke model.
Karena Interactions API mengharapkan masukan gambar dalam bentuk base64, pertama-tama kita mendefinisikan fungsi pembantu untuk mengonversi objek PIL Image menjadi string base64:
import io
from PIL import Image
import base64
def _image_to_base64(img: Image.Image) -> str:
"""
Converts a PIL Image object to a base64-encoded string.
"""
buffered = io.BytesIO()
img.save(buffered, format="PNG")
return base64.b64encode(buffered.getvalue()).decode()Sekarang, kita dapat membangun fungsi yang lebih umum, generate_video(), yang menangani gambar opsional dan prompt teks sekaligus.
from google.genai import types
def generate_video(client, valid_images: list[Image.Image], animation_prompt: str, aspect_ratio: str):
"""
Generates a commercial-quality AI video using Google's Gemini Omni Flash model.
Supports image-to-video and text-to-video multimodal inputs using the Gemini API.
"""
omni_inputs = []
# 1. Base64 encode and append any input images
for img in valid_images:
img_b64 = _image_to_base64(img)
omni_inputs.append({
"type": "image",
"data": img_b64,
"mime_type": "image/png",
})
# 2. Append the text animation prompt
omni_inputs.append({"type": "text", "text": animation_prompt})
# 3. Request video generation from the interactions endpoint
interaction = client.interactions.create(
model="gemini-omni-flash-preview",
input=omni_inputs,
response_format={
"type": "video",
"aspect_ratio": aspect_ratio,
},
)
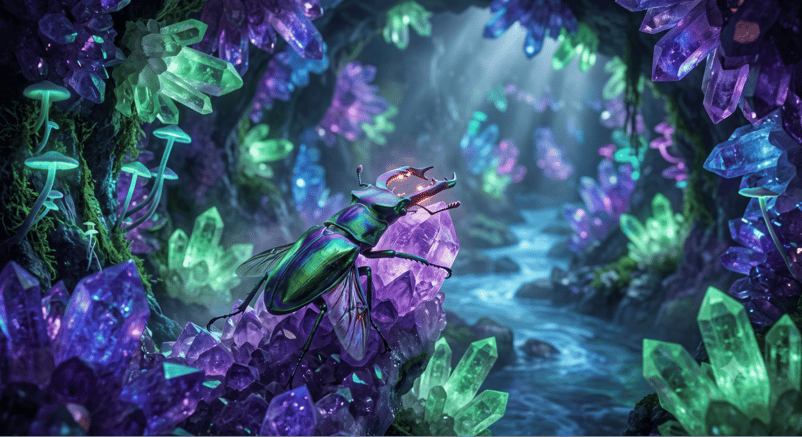
return interactionAkhirnya, berikut cara kita menggunakan fungsi-fungsi ini untuk membuat video yang menganimasikan gambar kumbang yang saya buat dengan Gemini:
if __name__ == "__main__":
# Load our reference image
reference_image = Image.open("images/beetle.png").convert("RGB")
# Describe how we want the image to be animated
animation_prompt = """
A detailed, close-up photograph of an iridescent biomechanical stag beetle,
shimmering with metallic green, blue, and violet hues, as it traverses a
rugged amethyst crystal formation in a subterranean grotto.
The cavern walls are lined with a dense matrix of glowing crystals emitting
deep purple, blue, and green light. The air is misty, with bioluminescent
flora clinging to the rock. As the camera maintains focus, the beetle
subtly activates a soft internal orange glow from its mandibles, begins
vibrating its wings, and slowly crawls upward across the crystalline
surface, reflecting the surrounding light.
"""
# Call the generator with the reference image
interaction = generate_video(
client=client,
valid_images=[reference_image],
animation_prompt=animation_prompt,
aspect_ratio="16:9"
)
# Extract and save the animated video
if interaction and hasattr(interaction, "output_video") and interaction.output_video:
video_bytes = base64.b64decode(interaction.output_video.data)
with open("videos/video.mp4", "wb") as f:
f.write(video_bytes)Ini adalah video yang dihasilkan:
Skrip lengkap tersedia di sini.
Langkah 3: Menerapkan pengeditan video dengan Video-to-Video
Mengedit video secara percakapan dengan Gemini Omni Flash API menjadi sangat mudah berkat penggunaan interactions. Saat kita membuat video, kita mendapatkan pengenal interaction yang dapat diakses sebagai interaction.id.
Untuk mengedit video, kita kemudian dapat memberikan prompt dan pengenal interaction sebelumnya. Jika ini adalah edit pertama, kita memberikan pengenal interaction yang digunakan untuk membuat video. Untuk edit berikutnya, kita memberikan pengenal dari edit sebelumnya.
client.interactions.create(
model="gemini-omni-flash-preview",
input=edit_prompt,
previous_interaction_id=previous_interaction_id,
)Membangun AI Video Studio Interaktif: Arsitektur dan Sinergi Multi-Model
Pada bagian sebelumnya, kita telah mempelajari cara membuat gambar secara programatik menggunakan Nano Banana 2 Lite dan video menggunakan Gemini Omni Flash. Sekarang, kita akan melihat cara menyatukan kapabilitas tersebut dalam satu aplikasi web interaktif yang kohesif: sebuah AI Video Studio.
Arsitektur AI Video Studio
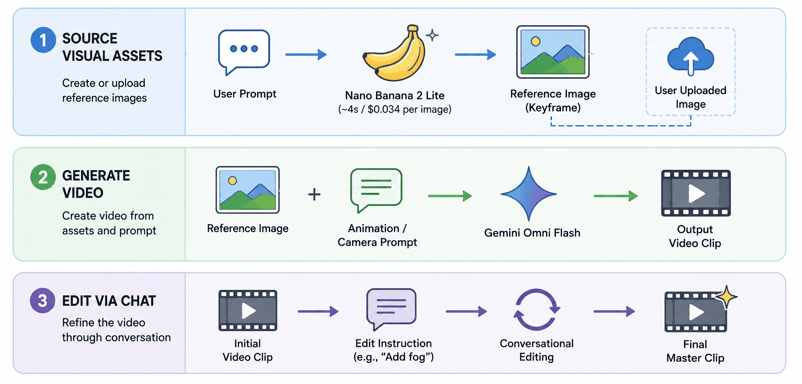
Membuat video AI berkualitas tinggi biasanya melibatkan tingkat coba-coba yang tinggi. AI Video Studio mengatasinya dengan menerapkan pipeline multi-model dua tahap yang memanfaatkan kekuatan unik dari dua model berbeda:
- Pengumpulan Aset: Didukung oleh Nano Banana 2 Lite, pengguna dapat dengan cepat membuat sumber daya dan gambar referensi untuk video guna menggabungkannya dengan gambar yang sudah mereka miliki.
- Pembuatan Video: Kita menggunakan Gemini Omni Flash untuk membuat video berdasarkan aset tersebut.
- Pengeditan Video: Setelah video dibuat, kita dapat mengeditnya secara percakapan.
Tahap 1: Prototyping cepat dengan Nano Banana 2 Lite
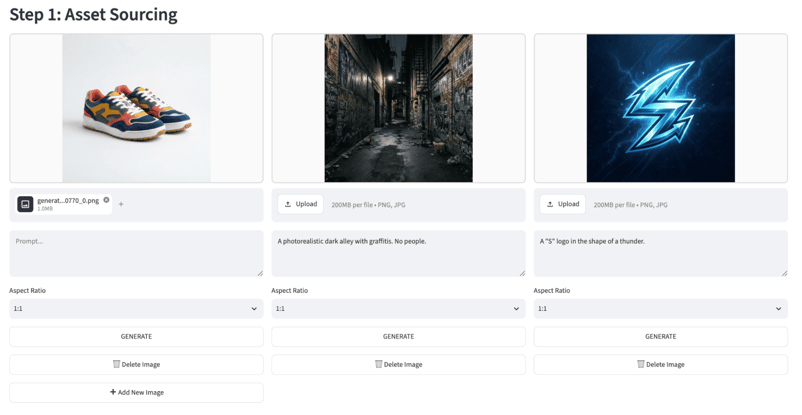
Pada tahap pertama, aplikasi memungkinkan kita mendapatkan gambar referensi (keyframe). Kita dapat mengunggah gambar lokal atau membuatnya secara langsung.
Di sinilah Nano Banana 2 Lite bersinar.
Dengan latensi di bawah 4 detik dan biaya hanya sebagian kecil sen per gambar, model ini berfungsi sebagai sandbox super cepat. Kita dapat dengan cepat membuat prototipe puluhan gaya visual, komposisi, dan subjek berbeda hingga mendapatkan keyframe yang sempurna.
Tahap 2: Pembuatan multimodal dengan Gemini Omni Flash
Setelah kita memiliki gambar referensi yang sempurna, kita beralih ke tahap produksi video.
Gambar referensi dan prompt animasi kita (misalnya, mendeskripsikan gerakan kamera, perubahan pencahayaan, atau aksi) dikodekan base64 dan dikirim ke Gemini Omni Flash menggunakan Interactions API SDK.
Gemini Omni Flash memproses masukan ini dan mengembalikan klip video berkualitas tinggi dalam format layar lebar (16:9) atau vertikal (9:16).
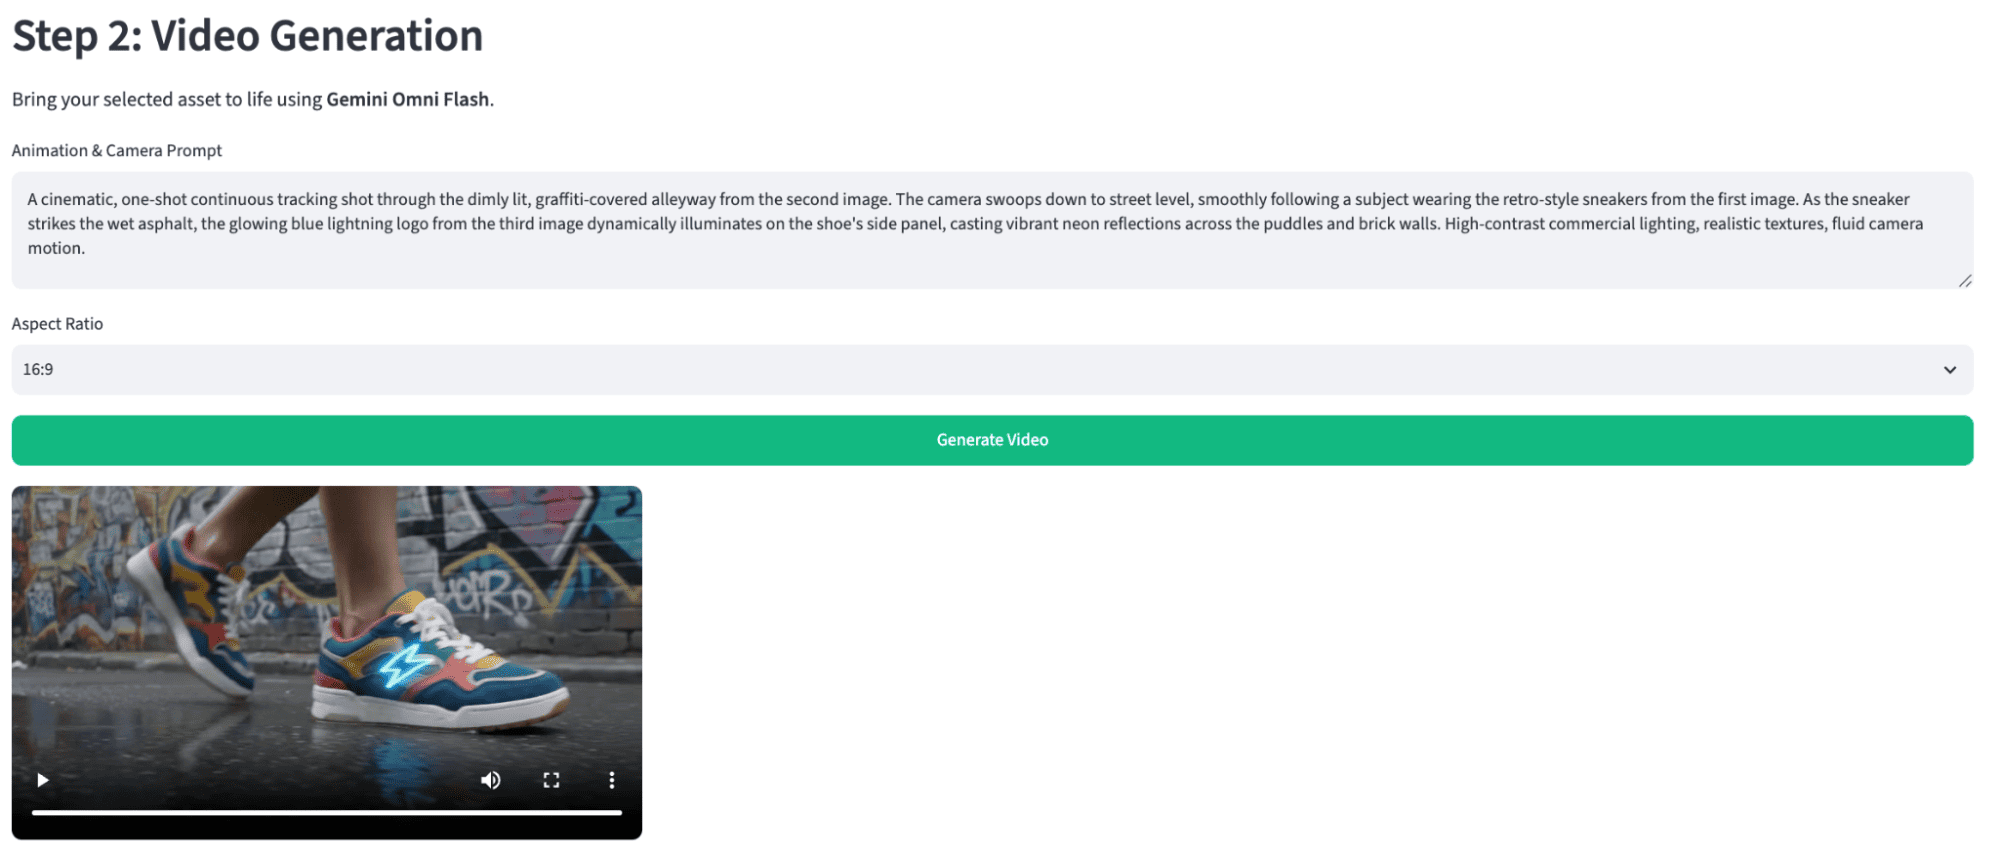
Berikut video yang kami dapatkan:
Implementasi aplikasi pembuatan video Streamlit
Untuk membangun antarmuka pengguna, kami menggunakan Streamlit, kerangka kerja Python open-source populer yang memudahkan pembuatan aplikasi web yang dapat dibagikan untuk pembelajaran mesin dan ilmu data.
Jika Anda baru mengenal Streamlit atau ingin penyegaran cara kerjanya, kami sangat merekomendasikan membaca Tutorial Python Streamlit ini.
Kami tidak akan berfokus pada kode UI Streamlit itu sendiri, melainkan melihat arsitektur pipeline pembuatan video dan mengeksplorasi kemungkinan kreatif dari penggabungan dua model tangguh ini.
Skrip gemini_api.py memuat fungsi-fungsi yang kita implementasikan di atas untuk membuat gambar dan video. Antarmuka pengguna diimplementasikan dengan Streamlit dalam skrip app.py.
Jika Anda ingin menjalankannya secara lokal dan bereksperimen, lakukan hal berikut:
git clone [email protected]:fran-aubry/nano-banana-2-flash-tutorial.git
pip install -r requirement.txt
streamlit run app.pyBerikut contoh alur kerja lengkap yang menggabungkan gambar merek teh imajiner yang sudah ada dengan gambar perkebunan teh yang dibuat untuk membuat bidikan komersial kaleng teh tersebut.
Lalu kita mengedit videonya menggunakan prompt.
Video dipercepat selama pembuatan video karena proses ini dapat memakan waktu beberapa menit hingga selesai.
Kesimpulan
Klaim kecepatan yang dibuat Google tentang model Nano Banana 2 Lite terbaru mereka terbukti benar.
3Model ini sangat cepat dan semakin mendekati sesuatu yang dapat membuat gambar secara real time. Meski gambar yang dihasilkannya bagus, belum benar-benar revolusioner. Inovasi utama model ini jelas kecepatannya yang mengesankan, bukan kualitas gambarnya yang terobosan.
Saat dipasangkan, model Gemini Omni Flash dan Nano Banana 2 Lite menciptakan pipeline yang kuat. Model Omni sangat efektif dalam mempertahankan kesetiaan terhadap materi referensi.
Untuk mempelajari lebih lanjut tentang Nano Banana 2, baca artikel ini: Nano Banana 2: Panduan Lengkap dengan Python.
Untuk pembahasan lebih mendalam tentang seri Gemini Omni, saya merekomendasikan membaca Gemini Omni: Satu Model untuk Teks, Gambar, Audio, dan Video.
FAQs
Apa perbedaan tujuan Nano Banana 2 Lite dan Gemini Omni Flash?
Nano Banana 2 Lite dioptimalkan untuk pembuatan gambar yang cepat dan hemat biaya (ideal untuk prototyping cepat), sedangkan Gemini Omni Flash dirancang untuk pembuatan video multimodal dan pengeditan video percakapan.
Bisakah saya mengedit video tanpa membuat ulang dari awal?
Ya. Gemini Omni Flash memungkinkan pengeditan video secara percakapan. Dengan memberikan prompt beserta ID interaction sebelumnya, Anda dapat menyempurnakan urutan video yang ada menggunakan bahasa alami.
Apakah Nano Banana 2 Lite cocok untuk aplikasi pengguna waktu nyata?
Dengan latensi sangat rendah sekitar 4 detik per gambar, model ini dibuat khusus untuk aplikasi interaktif di mana kecepatan dan kendala anggaran menjadi yang utama.
Apa pertimbangan biaya utama untuk model-model ini?
Kedua model memprioritaskan efisiensi biaya. Nano Banana 2 Lite berharga $0,034 per gambar resolusi 1K, dan Gemini Omni Flash berharga $0,10 per detik output video, menjadikannya layak untuk pipeline ber-volume tinggi.




Google baru saja merilis Nano Banana 2 Lite dan Gemini Omni Flash, dua model yang dirancang untuk mendefinisikan ulang kecepatan dan kapabilitas multimodal dalam pengembangan AI.
Model-model ini menawarkan kombinasi kuat antara pembuatan gambar berlatensi sangat rendah dan pengeditan video percakapan yang serbaguna.
Dalam artikel ini, saya mengeksplorasi kapabilitas inti kedua model tersebut dan membangun pipeline editor video AI lengkap yang memungkinkan pengguna memilih dan membuat gambar dengan Nano Banana 2 Lite, lalu menggabungkannya menjadi video.
Berikut video demo aplikasi yang akan kita bangun: