

什么是 Qwen 3.7 Max?
Qwen 3.7 Max 是阿里巴巴于 2026 年 5 月 20 日发布的全新旗舰模型,面向代理型工作流打造。这意味着它并非只为单轮对话设计,而是针对需要规划、工具使用、编码、办公自动化、长上下文推理与多步执行的任务进行了优化。
Qwen 团队将其描述为“代理时代”的模型,擅长编码代理、生产力助手、基于 MCP 的工作流以及长时程自主任务。
该模型的亮点不仅在于基准测试的原始分数,更在于其在多轮任务中保持一致性的能力,每一轮都有不同目的,包括:
- 规划
- 证据综合
- 长篇写作
- 自我批评
- 修订
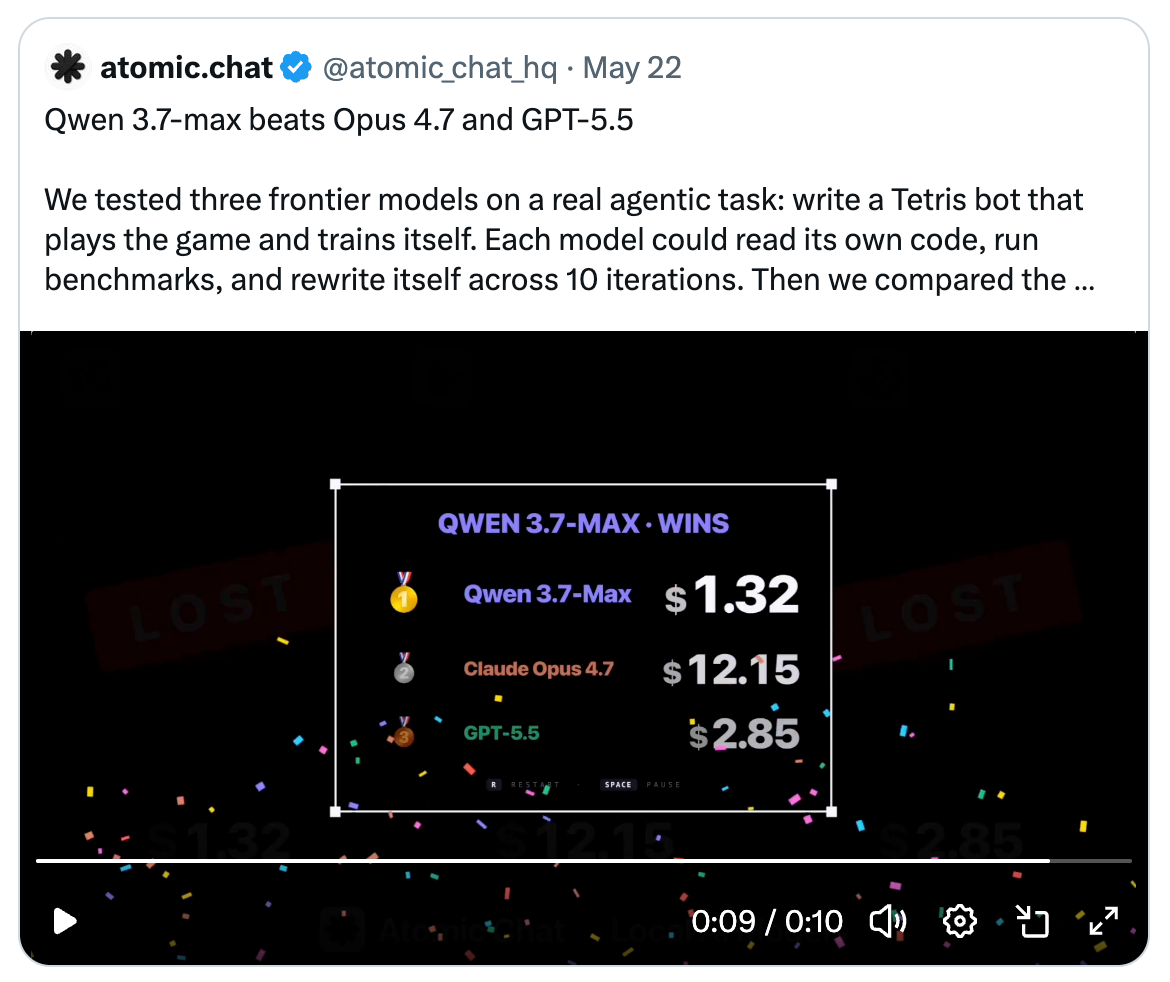
在 X 上,用户发现 该模型在长时程编码任务上可与 Opus 4.7 和 GPT 5.5 比肩。
Qwen 3.7 Max 的强项与基准表现
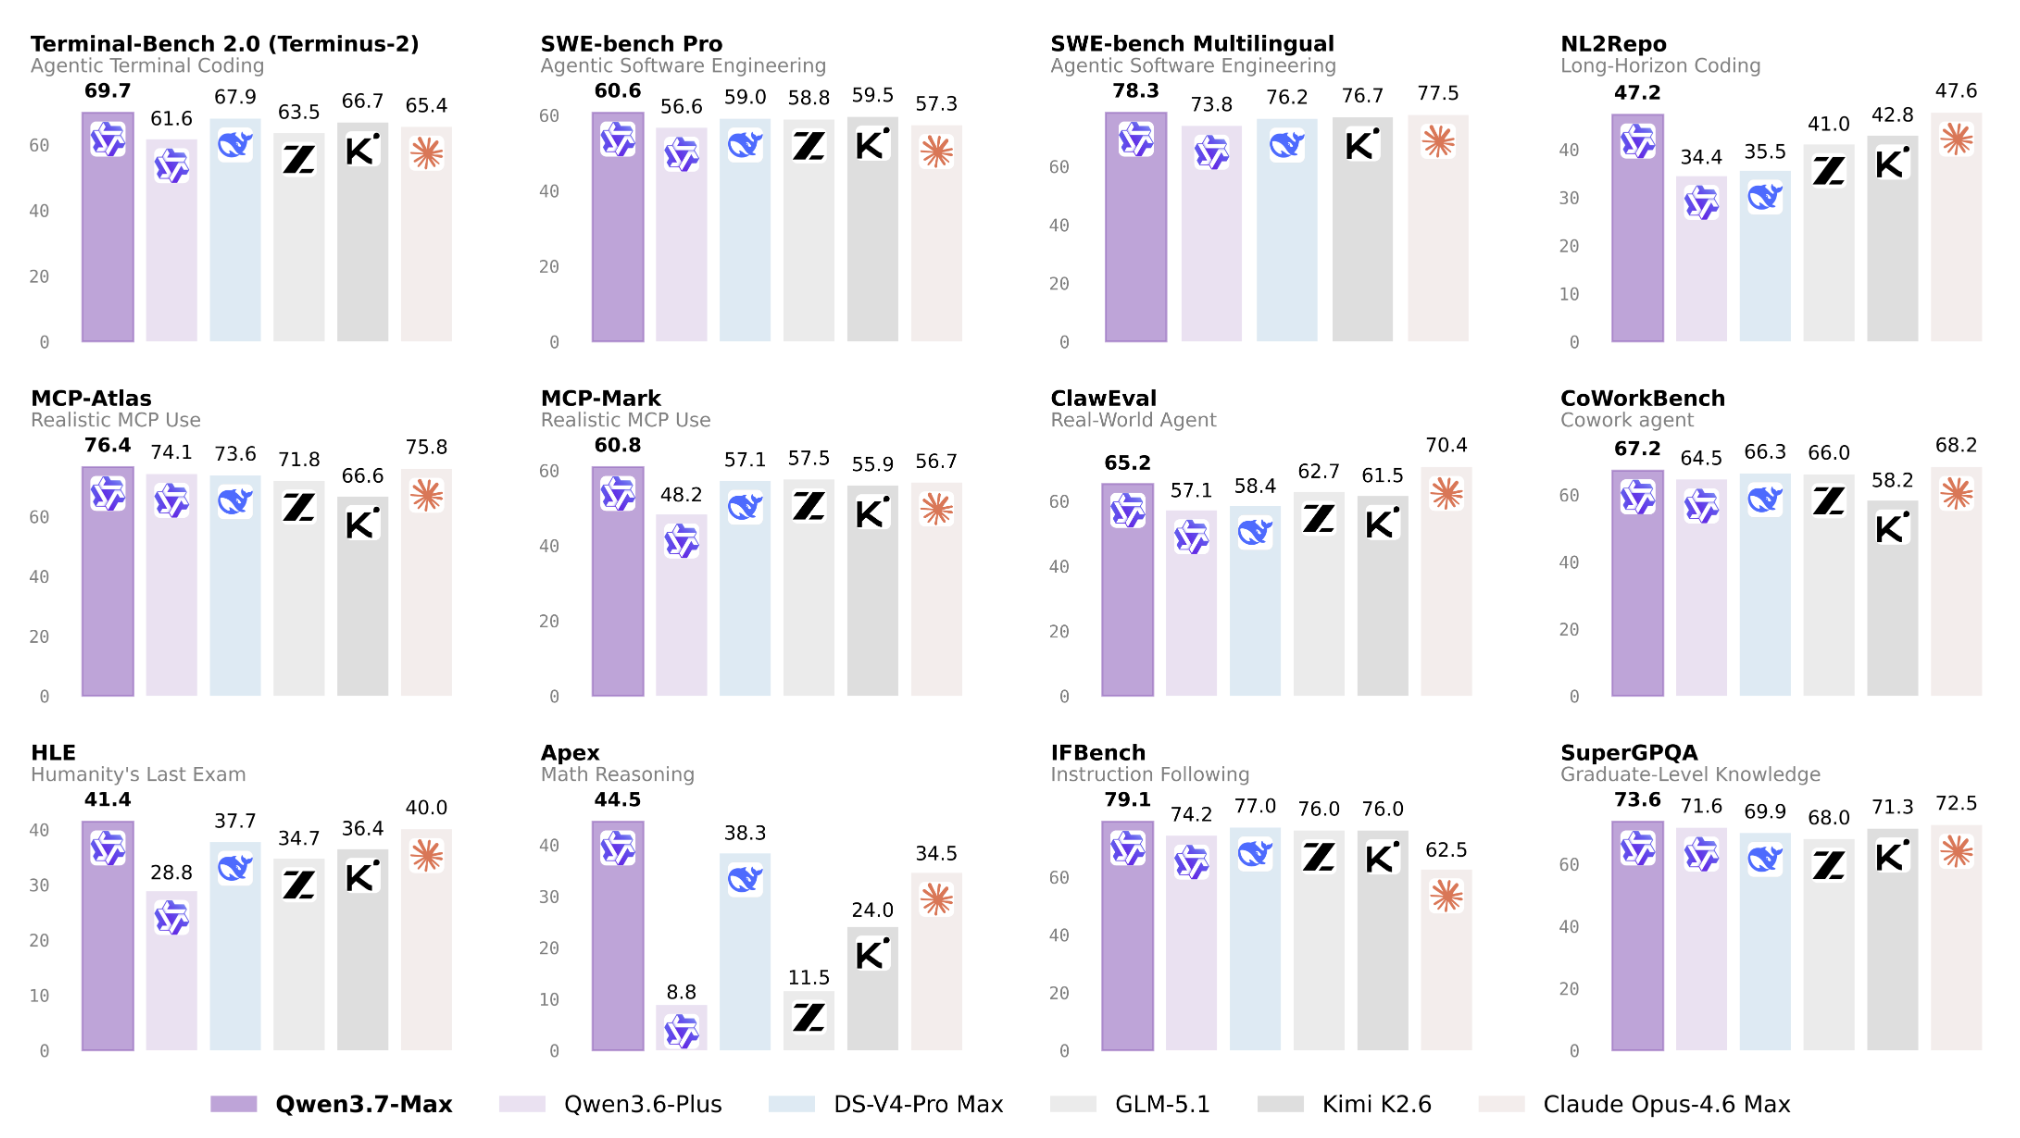
Qwen 3.7 Max 在代理与推理类基准上表现出色。在编码代理评测中,其得分为:
- Terminal-Bench 2.0-Terminus:69.7
- SWE-bench Pro:60.6
- SWE-bench Multilingual:78.3
- NL2Repo:47.2
- SciCode:53.5
在通用代理类基准上,其成绩为:
- MCP-Mark:60.8
- MCP-Atlas:76.4
- CoWorkBench:67.2
- SpreadSheetBench-v1:87.0
来源:Qwen 开发者博客
直观理解:这些结果整体领先于DeepSeek V4 Pro;大多是小幅领先,但在长时程编码方面,两者差距更明显(NL2Repo 中 47.2 vs 35.5)。
这也引出本次发布的一个亮点示例:Qwen 3.7 Max 的长时程内核优化跑通。官方称其运行约 35 小时,进行了 1,158 次工具调用、完成 432 次内核评估,并相较 Triton 参考实现获得 10.0x 的几何平均加速。
这很重要,因为它体现了模型在迭代式、基于工具的改进流程中的表现评估,而不是只做静态基准题。
简而言之,Qwen 3.7 Max 非常契合本次演示:它专为需要推理、用工具、保留上下文,并在多轮中改进成果的工作流而建。
用 Qwen 3.7 Max 构建可保留思考的生产力代理
本项目将演示三点实用思路:
项目概览
我们将构建一个只有一个输入框和一个按钮的简易应用,用户输入类似这样的模糊请求:
I need to prepare a competitive analysis of the top 3 vector databases
for a team presentation next week. I have no idea where to start.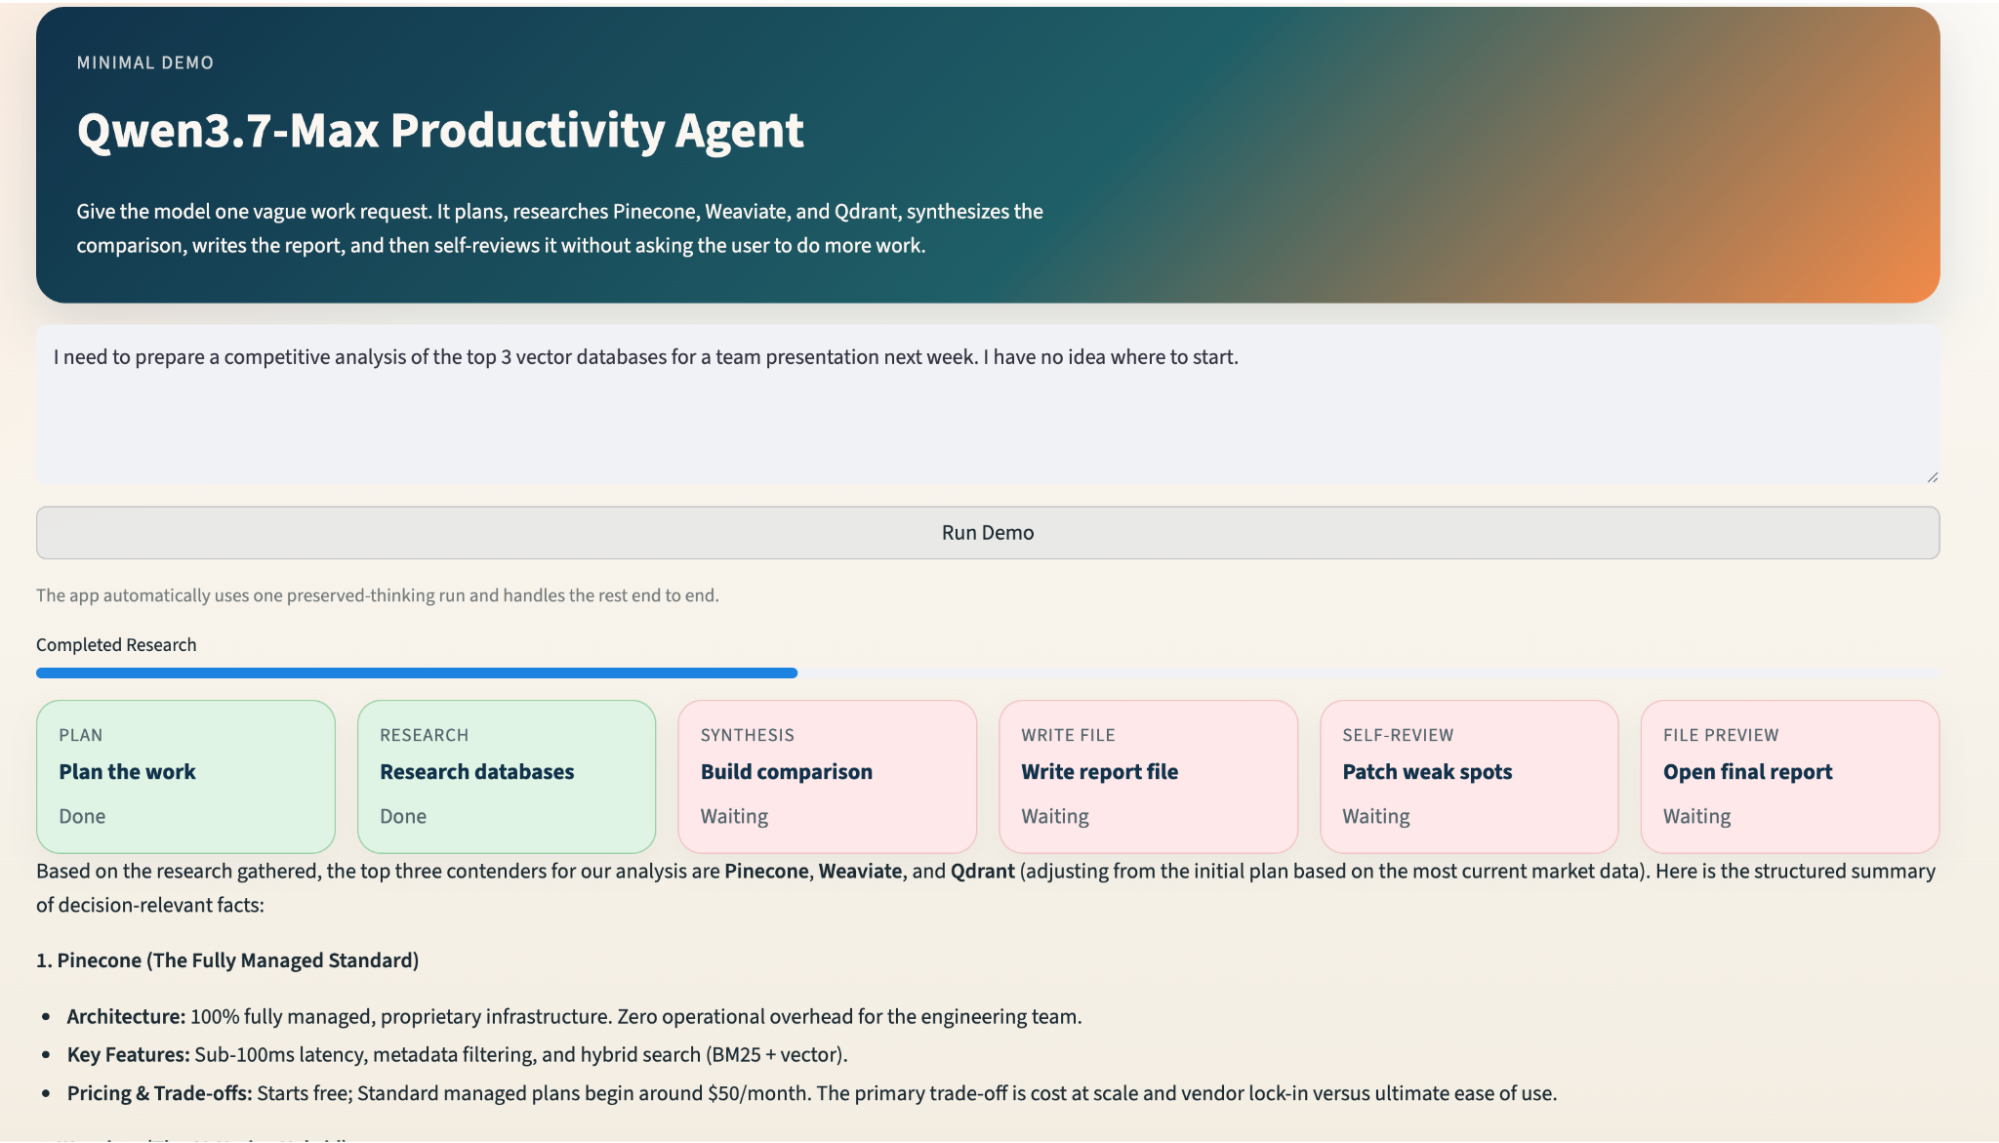
随后,代理按固定的五轮工作流运行:
User prompt
Turn 1: Plan the work
Parallel research for Pinecone, Weaviate, and Qdrant
Turn 2: Summarize research
Turn 3: Build comparison matrix
Turn 4: Write competitive_analysis.md
Turn 5: Self-review and patch the markdown file
Streamlit file previewUI 将每一步显示为进度卡片。随着工作流推进,卡片从等待变为完成。最后,用户可以查看各阶段:规划、研究、综合、草稿、自我审阅,以及最终文件预览。
这样使代理的工作流可见,而不是把一切都藏在单条聊天回复后面。
仓库特意保持小而清晰。核心部分包括:
-
thinking_agent.py:包含后端代理逻辑,如模型调用、提示、思考保留、研究、重试、文件写入和自我审阅。 -
agent.py:包含 Streamlit 界面,包括页面布局、提示输入、进度条、步骤卡片、结果选择器、Markdown 预览和下载按钮。 -
requirements.txt:包含演示所需的运行时依赖
后端围绕一个 ThinkingAgent 类展开,执行固定的五轮序列并返回结构化的轮次记录。UI 无需了解模型调用、重试或研究发散如何工作,只需按到达顺序渲染每一轮。
本教程的完整代码见 GitHub。
注:我通过 OpenRouter 访问 Qwen 3.7 Max,您也可以使用官方的 Qwen API Platform。
步骤 1:环境准备
在构建 Qwen 3.7 Max 生产力代理之前,我们需要搭建一个包含 Streamlit、与 OpenAI 兼容的客户端,以及用于轻量网页搜索的 httpx 的小型 Python 环境。
本教程使用 OpenRouter 作为模型网关,但后端按 OpenAI 兼容 API 格式编写。这意味着后续可以将同样的结构适配为阿里云 Model Studio 或其他兼容提供方。
本步骤我们将:
-
创建虚拟环境
-
安装所需依赖
-
设置
OPENROUTER_API_KEY或QWEN_API_KEY -
确认可通过 Streamlit 启动应用
创建并激活虚拟环境:
python3 -m venv .venv
source .venv/bin/activate安装项目依赖:
pip install -r requirements.txtrequirements.txt 文件特意保持精简:
httpx>=0.23.0
openai>=1.30.0
streamlit>=1.45.0我们使用 streamlit 构建交互式网页界面,使用 openai 通过 OpenAI 兼容 API 调用 Qwen 3.7 Max,使用 httpx 在研究步骤抓取轻量的实时搜索结果。
步骤 2:配置 Qwen 3.7 Max 客户端
后端使用 OpenAI Python SDK,因为 OpenRouter 暴露的是 OpenAI 兼容端点。thinking_agent.py 中定义了若干默认值:
from openai import OpenAI
DEFAULT_MODEL = "qwen/qwen3.7-max"
DEFAULT_BASE_URL = "https://openrouter.ai/api/v1"
DEFAULT_REFERER = "https://qwen.ai"
DEFAULT_TITLE = "Qwen3.7-Max Productivity Agent"然后创建客户端:
def build_client(
api_key: str | None = None,
base_url: str | None = None,
referer: str = DEFAULT_REFERER,
title: str = DEFAULT_TITLE,
) -> OpenAI:
return OpenAI(
base_url=base_url or DEFAULT_BASE_URL,
api_key=api_key,
default_headers={
"HTTP-Referer": referer,
"X-Title": title,
},
)build_client() 集中管理所有与提供方相关的配置。应用的其余部分无需关心请求是走 OpenRouter、阿里云 Model Studio,还是其他兼容端点。
客户端配置完成后,后端即可用标准的聊天补全格式调用 Qwen 3.7 Max。
现在我们来构建核心的 ThinkingAgent 工作流。
步骤 3:五轮代理工作流
在模型客户端配置好后,我们定义核心后端工作流。我们不让 Qwen 3.7 Max 一步生成完整报告,而是将任务拆分为五个可控阶段。
-
规划:将模糊提示转化为结构化任务计划。
-
研究:从外部片段收集并总结证据。
-
综合:基于研究构建对比矩阵。
-
草稿:写出第一版
competitive_analysis.md报告。 -
自我审阅:在返回最终文件前审阅并修补报告。
class ThinkingAgent:
def run(
self,
goal: str,
preserve_thinking: bool = True,
data_mode: str = "live",
on_turn: Callable[[TurnRecord], None] | None = None,
) -> ThinkingRunResult:
history = [{"role": "system", "content": SYSTEM_PROMPT}]
turns = []
backend = self._build_search_backend(data_mode)
turn1 = self._run_turn(
history=history,
turn_index=1,
phase="planning",
user_prompt=_planning_prompt(goal),
preserve_thinking=preserve_thinking,
)
search_results = self._run_research(backend)
turn2 = self._run_turn(
history=history,
turn_index=2,
phase="research",
user_prompt=_research_prompt(goal, search_results),
preserve_thinking=preserve_thinking,
)
turn3 = self._run_turn(
history=history,
turn_index=3,
phase="synthesis",
user_prompt=_synthesis_prompt(),
preserve_thinking=preserve_thinking,
)
turn4 = self._run_turn(
history=history,
turn_index=4,
phase="draft",
user_prompt=_draft_prompt(goal),
preserve_thinking=preserve_thinking,
)
turn5 = self._run_turn(
history=history,
turn_index=5,
phase="self_review",
user_prompt=_self_review_prompt(draft_markdown),
preserve_thinking=preserve_thinking,
)run() 方法是主编排循环。它从系统提示开始,创建会话历史,构建研究后端,然后依次执行五轮。
每次调用 _run_turn() 都有明确的阶段,使工作流更易调试:规划轮负责规划;研究轮解读外部片段;综合轮建结构;草稿轮写作;自我审阅轮改进输出。
研究步骤放在第 1 与第 2 轮之间,因为模型需要先理解任务,再将外部信息引入工作流。
下一步,我们将加入 Qwen 特有的“思考保留”逻辑,帮助模型在这些轮次间保持连贯。
步骤 4:跨轮保留思考
本演示之所以采用 Qwen 3.7 Max,主要因为它支持可保留思考的工作流。代理不会把每次模型调用视为孤立提示,而是可以保留前几轮的推理并把该上下文传递到后续轮次。
本步骤我们将:
- 启用模型思考。
- 在多轮间保留推理。
- 将助手输出追加回共享历史。
response = self.client.chat.completions.create(
model=self.config.model,
messages=request_messages,
extra_body={
"enable_thinking": True,
"preserve_thinking": preserve_thinking,
},
)enable_thinking=True 允许 Qwen 3.7 Max 在响应中生成推理内容,而 preserve_thinking 则控制这些推理是否在后续轮次中继续保留。
模型响应后,后端会同时提取可见答案与推理内容:
message = response.choices[0].message
assistant_content = _normalize_text(getattr(message, "content", ""))
reasoning_content = _extract_reasoning_content(message)
The visible answer is what the app can show to the user. The reasoning content is used internally to help the next turn stay aligned with the earlier plan.
Then the backend appends the assistant message back into the conversation history:
```python
assistant_message = {
"role": "assistant",
"content": assistant_content,
}
if preserve_thinking and reasoning_content:
assistant_message["reasoning_content"] = reasoning_content
history.append(assistant_message)如果规划轮决定最终报告需从部署模式、可扩展性、开发者体验、混合检索和企业就绪度等维度比较向量数据库,后续各轮即可沿用这些标准。否则,每一轮都可能发生漂移:综合步骤或许会改换维度,自我审阅也可能依据不同目标评判报告。
接下来我们加入研究层,在写报告前为代理提供外部上下文。
步骤 5:添加带回退数据的并行研究
在生成竞品分析之前,模型需要外部上下文。本演示固定研究范围,对比三种向量数据库:Pinecone、Weaviate 和 Qdrant。
本步骤我们将:
- 定义目标数据库。
- 并行发起研究调用。
- 若实时搜索失败,则回退到确定性的预置数据。
DATABASES = ("Pinecone", "Weaviate", "Qdrant")目标列表特意固定,以保持演示稳定、便于讲解。后续您可以扩展为由模型动态选择对比对象。
接着,后端并行发起研究调用:
from concurrent.futures import ThreadPoolExecutor, as_completed
with ThreadPoolExecutor(max_workers=3) as executor:
future_map = {
executor.submit(backend.search, database, query): database
for database, query in queries.items()
}
for future in as_completed(future_map):
database = future_map[future]
results[database] = future.result()ThreadPoolExecutor 为每个数据库启动一次搜索。相比串行搜索更快,因为针对 Pinecone、Weaviate、Qdrant 的研究可以并行进行。
try:
results[database] = future.result()
except Exception as exc:
fallback = FixtureSearchBackend().search(database, queries[database])
fallback.warning = (
f"Live search failed for {database} ({exc}). "
"Fallback demo research was used."
)
results[database] = fallback若实时搜索可用,代理将使用新鲜片段;若失败,应用仍可用内置的确定性研究片段完成工作流。重要的设计理念是优雅降级:不应因一个外部依赖失败而崩溃。
下一步,我们把这些研究结果传给 Qwen 3.7 Max,以便综合出对比矩阵。
步骤 6:生成综合与对比矩阵
当代理拿到研究片段后,接下来就是综合。这一步将零散信息转化为可支撑最终报告的结构化对比。
本步骤我们将:
- 把研究上下文回传给 Qwen 3.7 Max。
- 请求模型创建结构化对比。
- 稍后在 Streamlit 界面渲染该输出。
turn3 = self._run_turn(
history=history,
turn_index=3,
phase="synthesis",
user_prompt=_synthesis_prompt(),
preserve_thinking=preserve_thinking,
)运行到这里,会话历史已包含原始用户请求、规划输出、研究总结,以及可选的前几轮保留思考。
这意味着综合提示无需重述整个任务,只需专注于将研究转化为可决策的对比矩阵。
良好的综合应从以下维度比较各选项:
- 部署模式
- 可扩展性
- 开发者体验
- 混合检索支持
- 企业就绪度
- 最适用场景
随后,我们将用该综合结构来撰写第一版 Markdown 报告。
步骤 7:撰写 Markdown 报告
在完成规划、研究与综合后,代理已有足够上下文写出首个可交付物。这里的交付物是名为 competitive_analysis.md 的 Markdown 文件。
本步骤我们将:
- 让 Qwen 3.7 Max 写出第一版报告草稿。
- 去除不必要的 Markdown 代码围栏。
- 将草稿保存到磁盘。
- 把写文件动作记录为工具事件。
turn4 = self._run_turn(
history=history,
turn_index=4,
phase="draft",
user_prompt=_draft_prompt(goal),
preserve_thinking=preserve_thinking,
)草稿轮会利用此前全部上下文:用户原始目标、计划、研究及综合矩阵。
随后清洗模型响应并写入磁盘:
draft_markdown = _strip_markdown_fences(turn4.assistant_content)
report_path = run_output_dir / "competitive_analysis.md"
report_path.write_text(draft_markdown)_strip_markdown_fences() 很实用,因为模型常会将 Markdown 输出包在三反引号内。这在聊天回复中尚可,但直接写入 .md 文件时并不理想。
后端还会记录该写入动作:
turn4.tool_events.append(
ToolEvent(
name="write_file",
status="completed",
input_payload={"path": str(report_path)},
output_payload={
"description": "Initial draft written to disk.",
},
)
)该工具事件有助于 UI 呈现后端确实创建了真实文件,而不仅是另一段文本回复。至此应用已具备可用报告,但我们再增加一轮模型调用,以在展示最终成果前提升质量。
下一步我们让 Qwen 3.7 Max 审阅并修补自己的草稿。
步骤 8:自我审阅并修补报告
最后一轮是自我审阅。代理不会立即把首稿交给用户,而是重读报告、对照原始目标进行检查,并写出改进版。
本步骤我们将:
- 把草稿 Markdown 回传给模型。
- 请模型识别薄弱之处。
- 生成修订版本。
- 用改进后的最终版本覆盖报告。
turn5 = self._run_turn(
history=history,
turn_index=5,
phase="self_review",
user_prompt=_self_review_prompt(draft_markdown),
preserve_thinking=preserve_thinking,
)自我审阅提示会让模型检查实用性问题,例如建议是否明确、比较标准是否一致、报告是否适用于团队汇报。
修订后的输出被写回同一文件:
final_markdown = _strip_markdown_fences(turn5.assistant_content)
report_path.write_text(final_markdown)代理还可记录最终写入事件:
turn5.tool_events.append(
ToolEvent(
name="write_file",
status="completed",
input_payload={"path": str(report_path)},
output_payload={
"description": "Self-reviewed final report written to disk.",
},
)
)这一环节让应用从“简单生成器”升级为“小型编辑流程”。用户看到的不是初稿,而是审阅并修补过的版本。
接下来,我们把该后端工作流接入 Streamlit 应用。
步骤 9:构建 Streamlit 进度界面
现在从后端逻辑转到用户界面。Streamlit 应用应支持用户输入提示、运行工作流,并观察各阶段完成。
注意:以下代码属于 agent.py,因为它控制用户所见与可点击之处。
本步骤我们将:
-
配置 Streamlit 页面。
-
创建提示输入框。
-
添加运行按钮。
-
调用
ThinkingAgent.run()函数。 -
在轮次完成时更新 UI。
def render_streamlit_app() -> None:
st.set_page_config(
page_title="Qwen3.7-Max Demo Agent",
page_icon=":material/psychology:",
layout="wide",
initial_sidebar_state="collapsed",
)应用使用宽屏布局,因为 UI 包含步骤卡片、进度指示与结果面板。
输入区域非常简洁:
goal = st.text_area(
"Prompt",
value=DEFAULT_GOAL,
height=120,
label_visibility="collapsed",
)
run_clicked = st.button("Run Demo", use_container_width=True)用户只需提供任务,不必配置温度、搜索模式、模型 ID 或推理设置。这些细节由后端处理。
当用户点击按钮时,agent.py 会创建后端代理并运行:
agent = ThinkingAgent(config=config)
result = agent.run(
goal=goal,
preserve_thinking=True,
data_mode="live",
on_turn=on_turn,
)这里完成两份文件的对接:agent.py 触发工作流,但 thinking_agent.py 拥有真正的代理行为。UI 回调会在每轮后更新页面:
def on_turn(turn: TurnRecord) -> None:
partial_turns.append(turn)
progress_placeholder.progress(
len(partial_turns) / len(phase_order),
text=f"Completed {_phase_label(turn.phase)}",
)
with steps_placeholder.container():
_render_step_cards(partial_turns, result_ready=False)回调接收一个已完成的 TurnRecord,并刷新进度条与步骤卡。在执行中,卡片充当状态指示;完成后,它们变为可点击的结果视图。
现在,我们来渲染最终的 Markdown 报告,并提供下载。
步骤 10:预览并下载最终报告
后端完成后,UI 需要显示最终报告。后端已创建了 Markdown 文件,因此 agent.py 只需读取、渲染并提供下载按钮。
本步骤我们将:
- 检查报告文件是否存在。
- 读取最终的 Markdown 内容。
- 显示下载按钮。
- 在 Streamlit 应用中渲染 Markdown
def _render_file_preview(report_path: str) -> None:
path = Path(report_path)
if not path.exists():
st.info("No file was written yet.")
return
content = path.read_text()
st.caption(f"Created file: {path.name}")
st.download_button(
"Download competitive_analysis.md",
data=content,
file_name=path.name,
use_container_width=True,
)
st.markdown(content)函数首先检查文件是否存在,避免后端在写文件前失败导致应用崩溃。随后读取 Markdown 内容并创建下载按钮,最后在 Streamlit 页面直接渲染该 Markdown。
这实现了清晰的职责分离:
-
thinking_agent.py负责写报告 -
agent.py负责预览与下载报告
下一步,我们加入基础错误处理,使当提供方路由失败或限流出现时,演示表现更稳健。
步骤 11:错误与限流处理
模型提供方可能超时、暂时失败或对请求限流。如果将这些原始错误直接暴露给用户,应用会显得不够成熟。
该步骤在两份文件中分工实现。重试逻辑属于 thinking_agent.py,因为它是后端模型调用的一部分;而错误信息属于 agent.py,因为它决定用户所见。
本步骤我们将:
- 在后端重试临时失败的提供方错误。
- 检测类似限流的错误。
- 在 Streamlit UI 显示更友好的消息
delays = (1.0, 2.0)
for attempt_index in range(len(delays) + 1):
try:
return self.client.chat.completions.create(...)
except Exception as exc:
if not _is_retryable_provider_error(exc):
raise
if attempt_index >= len(delays):
raise
time.sleep(delays[attempt_index])后端尝试发起模型调用,捕获可重试失败,短暂等待后再试。短延迟足以平滑临时性不稳定,同时不让用户等待过久。
def _friendly_rate_limit_message(exc: Any) -> str:
return (
"Qwen 3.7 Max is temporarily rate-limited upstream. "
"Please wait 30 to 60 seconds and try again."
)这样可避免在 UI 中出现原始的提供方 JSON 或堆栈跟踪。用户获得清晰解释与可行的下一步。
至此最后一步完成,我们可以运行完整应用并测试端到端工作流。
步骤 12:运行演示
当后端工作流与 Streamlit 界面连接完成后,即可运行完整应用。
本步骤我们将:
- 启动 Streamlit 应用。
- 输入默认的生产力提示。
- 运行五阶段工作流。
- 预览并下载最终的 Markdown 报告
启动应用:
streamlit run agent.py使用默认提示:
I need to prepare a competitive analysis of the top 3 vector databases
for a team presentation next week. I have no idea where to start.点击 Run Demo 后,应用将依次完成整个工作流:
-
规划:创建结构化计划。
-
研究:收集 Pinecone、Weaviate 与 Qdrant 的片段。
-
综合:构建对比矩阵。
-
草稿:写出第一版 Markdown 报告。
-
自我审阅:修补报告。
-
预览:展示最终的
competitive_analysis.md文件。
最终报告保存在:
output/showcase_runs/<timestamp>/with_preserve/competitive_analysis.md
最后,您应能在 Streamlit 界面看到报告预览与下载按钮。
结语
在本教程中,我们用 Qwen 3.7 Max 构建了一个紧凑的生产力代理,按固定且可解释的工作流从规划、研究、综合、写作到自我审阅一路推进。同时展示了在长流程代理任务中,跨轮保留推理为何有用。
当前版本仅使用 Streamlit、OpenAI 兼容的模型调用、轻量搜索层与 Markdown 输出,便于学习、修改与在您自己的实验中复用。
从这里出发有许多自然扩展:
-
让模型自行选择对比对象,而非固定列表
-
加入“启用
preserve_thinking”与“未启用preserve_thinking”的对比运行 -
在 UI 中展示 token 用量与成本估算
-
在 Markdown 报告旁生成幻灯大纲或图表
-
用更稳健的搜索 API 替换 DuckDuckGo 抓取
如果您想超越固定工作流,系统学习从提示工程、RAG 到代理系统的生产级 AI 应用构建,我们的 AI Engineering with LangChain 技能路径 是不错的下一步选择。
Qwen 3.7 Max API 教程常见问题
何时应在 Qwen 3.7 Max 中使用 preserve_thinking=True?
preserve_thinking=True 有助于在多轮工作流中让后续轮次与先前决策保持一致。在我们的示例中,如果规划轮选定了具体的比较标准,综合与自我审阅轮就能沿用相同的推理,而不至于漂移。
Qwen 3.7 Max 只适用于编码代理吗?
不是。编码是其重要强项之一,但该模型同样面向生产力代理、办公自动化、基于 MCP 的工作流、多语种任务、长上下文推理与长时程工具使用。
演示应用是否使用真实的网页搜索?
是的,当前默认路径会尝试实时 DuckDuckGo 抓取。如果失败,则回退到内置的预置研究数据。
我们的演示应用中,模型会创建子代理吗?
不是。应用只使用一个模型会话。“并行”发生在研究层,后端同时发起三次网页搜索,并把结果回灌到同一模型会话。
为什么要将 agent.py 与 thinking_agent.py 分离?
agent.py 保持 Streamlit UI 清晰易读;thinking_agent.py 承载后端工作流、提示构造、重试与研究逻辑,从而能在不依赖界面的情况下独立测试代理行为。

我是一名 Google Developers 机器学习(生成式 AI)领域的专家、Kaggle 三项专家,以及 Women Techmakers 大使,拥有 3 年以上的技术从业经验。2020 年我共同创办了一家健康科技初创公司,目前在佐治亚理工学院攻读计算机科学硕士,专攻机器学习。
多数 AI 演示仍然像聊天机器人:您提问,模型回答,交互随即结束。但真正的效率工作通常不是一步完成的。一个有用的助手需要把模糊的请求拆解、收集上下文、比较选项、产出可用成果,并在交付前自查。
Qwen 3.7 Max 是通义千问团队面向代理型任务打造的模型,适用于编码、办公生产力任务与长链路执行。它以代理为先,不仅追求单轮提示的优答,更强调在涉及规划、工具调用、写作与自我纠错的长流程中保持连贯性。
在本教程中,我们将使用 Qwen 3.7 Max 和 Streamlit 构建一个紧凑的生产力代理。该应用接收一个模糊的业务请求,比如准备一份关于向量数据库的竞品分析,并将其转化为一份打磨完成的
competitive_analysis.md文件。完成本教程后,您将了解如何:
构建固定的五轮代理工作流
使用
enable_thinking=True和preserve_thinking=True添加轻量级并行研究
编写并修补 Markdown 成果
围绕该工作流创建一个简易的 Streamlit 界面
完整代码可在 GitHub 仓库中获取。
本项目特意保持精简,核心逻辑分为两部分:
agent.py负责 Streamlit 应用,thinking_agent.py负责后端工作流。如果您是代理型 AI 新手,建议先从我们的 AI Agent Fundamentals 技能路径开始。