
要点速览
- 向量数据库使用相似度而非精确匹配来存储与检索高维数据(嵌入),因此成为 RAG、推荐引擎与异常检测等 AI 应用的关键基础
- 2026 年排名前七的向量数据库为 Chroma、Pinecone、Weaviate、Faiss、Qdrant、Milvus 和 pgvector
- 关键选择因素包括规模需求、是否偏好托管或自建、现有技术栈与预算
- RAG(检索增强生成)已成为 2026 年推动向量数据库普及的主要用例
- Chroma 与 Faiss 等开源选项适合原型开发,而 Pinecone 与 Milvus 面向大规模生产工作负载
什么是向量数据库?
向量数据库是一类专门的数据库,以表示特定特征或属性的多维向量形式来保存信息。
每个向量的维度数量差异很大,可从个位数到数千维,取决于数据的复杂度与细节。文本、图像、音频与视频等数据会通过机器学习模型、词嵌入或特征提取等过程被转换成向量。
向量数据库的主要优势在于能够根据向量之间的接近程度或相似性,快速而精准地定位并检索数据。这样就可以基于语义或上下文相关性进行搜索,而不仅仅依赖传统数据库中的精确匹配或固定条件。
例如,借助向量数据库,您可以:
- 基于旋律与节奏,搜索与某段曲调“相投”的歌曲。
- 发现与某篇文章在主题与观点上相近的其他文章。
- 识别在特性与评价上与某款设备相仿的电子产品。
向量数据库如何工作?
传统数据库以表格形式存储诸如词语与数字等简单数据。而向量数据库处理的是称为向量的复杂数据,并采用独特的检索方法。
常规数据库寻找的是精确匹配,而向量数据库会使用特定的相似度度量来寻找“最接近”的匹配。
向量数据库使用称为近似最近邻(ANN)的特殊搜索技术,包括哈希与基于图的搜索等方法。
若要真正理解向量数据库如何工作以及它与如 SQL 等传统关系型数据库的差异,我们首先需要理解“嵌入”的概念。
非结构化数据(如文本、图像与音频)没有预定义格式,这对传统数据库是挑战。要在 AI 与机器学习应用中利用这些数据,需要通过嵌入将其转换为数值表示。
嵌入好比为每个项目(无论是词语、图像还是其他)分配一个能捕捉其意义或本质的独特“编码”。这个编码帮助计算机更高效、更有意义地理解与比较这些项目。可以把它类比为把一本复杂的书转化为一段仍能抓住要点的精炼摘要。
这一嵌入过程通常由为此任务设计的特定神经网络来完成。例如,词嵌入会将词语转换为向量,使得语义相近的词在向量空间中彼此更接近。
这种转换使算法能够理解项目之间的关系与相似性。
本质上,嵌入充当了一座桥梁,将非数值数据转化为机器学习模型可处理的形式,从而使其更有效地识别数据中的模式与关系。
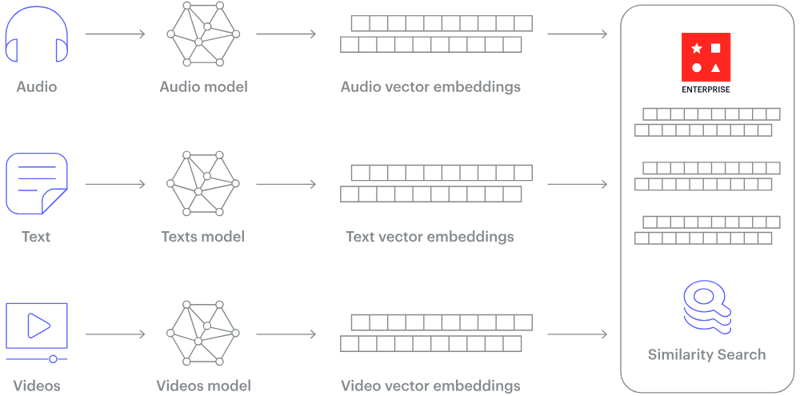
向量数据库如何工作?(图片来源)
向量数据库的应用
得益于高效实现“相似性搜索”的能力,向量数据库正凭借其独特优势在众多行业中占据一席之地。以下是更多样化应用场景的解析:
1. 提升零售体验
在繁忙的零售业中,向量数据库正在重塑消费者的购物方式。它们能够打造先进的推荐系统,提供个性化的购物体验。例如,网购用户收到的商品推荐不仅依据过往购买记录,还会分析商品属性、用户行为与偏好之间的相似性。
2. 金融数据分析
金融领域蕴含复杂的模式与趋势。向量数据库擅长分析这些密集数据,帮助金融分析师识别对投资策略至关重要的模式。通过识别微妙的相似性或偏差,它们可以辅助预测市场走势,制定更有依据的投资方案。
3. 医疗健康
在医疗领域,个性化至关重要。通过分析基因组序列,向量数据库有助于制定更贴合个体遗传特征的治疗方案。
4. 强化自然语言处理(NLP)应用
数字世界中的聊天机器人与虚拟助手日益增长。这些由 AI 驱动的系统高度依赖对人类语言的理解。通过将海量文本数据转换为向量,这些系统可以更准确地理解并回应用户问题。例如,Talkmap 等公司利用实时自然语言理解技术,促进更顺畅的客服交流。
5. 媒体分析
从医学影像到监控视频,精准比较与理解图像的能力至关重要。向量数据库通过聚焦图像的关键特征、过滤噪声与失真来简化这一过程。例如,在交通管理中,可快速分析视频流中的图像,以优化交通流并提升公共安全。
6. 异常检测
识别离群点与识别相似性同样重要。尤其在金融与安全等行业,发现异常可能意味着预防欺诈或阻止潜在的安全漏洞。向量数据库在此领域提供更强能力,使检测过程更快、更精准。
7. 支撑 RAG 流水线
2026 年向量数据库最具影响力的应用之一是检索增强生成(RAG)。在 RAG 系统中,向量数据库存储文档嵌入,LLM 在推理时查询它们以生成更准确、依据更充分的回答。这一方法已成为 AI 应用的标准基础设施,从客服聊天机器人到企业知识管理系统,都是向量数据库市场快速增长的核心原因。
优秀向量数据库的特性
向量数据库已成为在不严重依赖人工标签的情况下,驾驭图像、视频、文本等海量非结构化数据的强大工具。其与先进机器学习模型结合的能力,潜力足以重塑从电商到制药等众多领域。以下是令向量数据库脱颖而出的关键特性:
1. 可扩展性与适配性
强健的向量数据库可随数据增长(达数百万乃至数十亿条目)在多节点间自如扩展。顶级向量数据库具备良好适配性,允许用户根据写入速度、查询频率与底层硬件差异进行调优。
2. 多用户支持与数据隐私
支持多用户是数据库的基本要求。然而为每个用户都新建一个向量数据库并不高效。向量数据库优先保障数据隔离,确保某一数据集合的改动不会被他人看到,除非所有者主动共享。这不仅支持多租户,也确保了数据的隐私与安全。
3. 完备的 API 套件
真正有效的数据库会提供完整的 API 与 SDK,确保系统能与多样化应用交互并得到有效管理。领先的向量数据库(如 Pinecone)提供多种编程语言的 SDK,如 Python、Node、Go 与 Java,便于灵活开发与运维。
4. 友好的用户界面
为降低新技术带来的学习曲线,向量数据库中的友好界面至关重要。它们提供可视化概览、便捷导航,以及对可能被忽视功能的易达性。
2026 年 7 大最佳向量数据库
以下排名不分先后——它们各自都具备上述诸多优点。
1. Chroma
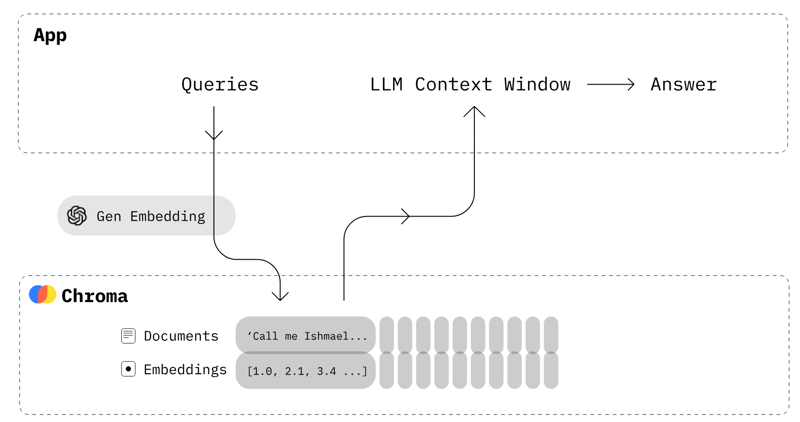
使用 ChromaDB 构建 LLM 应用(图片来源)
Chroma 是一款开源嵌入数据库。它通过让 LLM 的知识、事实与技能可插拔,简化 LLM 应用的构建。正如我们在Chroma DB 教程中所示,您可以轻松管理文本文档、将文本转换为嵌入并执行相似性搜索。
ChromaDB 功能:
- 支持 LangChain(Python 与 JavaScript)与 LlamaIndex
- 在 Python 笔记本中运行的同一 API 可扩展至生产集群
- 开箱即用支持向量、全文、正则与元数据搜索
- 基于对象存储,具备自动分层以优化成本
2. Pinecone
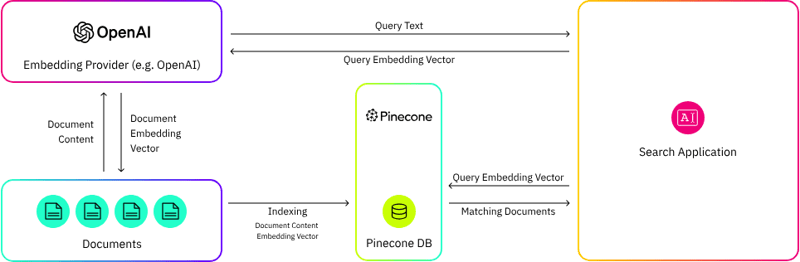
Pinecone 向量数据库
Pinecone 是一款托管的向量数据库平台,专为应对高维数据的独特挑战而打造。借助前沿的索引与检索能力,Pinecone 使数据工程师与数据科学家能够构建并部署大规模机器学习应用,高效处理与分析高维数据。
Pinecone 的关键特性包括:
- 全托管、无服务器架构,无需自管基础设施
- 可扩展至数十亿向量,并具备可预测的性能
- 实时数据摄取与在线索引
- 面向生产工作负载优化的低延迟相似度搜索
- 密集与稀疏向量结合的混合搜索,并支持元数据过滤
- 与 LangChain、LlamaIndex 和 Hugging Face 集成
Pinecone 还支持企业客户的自带云(BYOC)部署,以满足数据属地要求,并通过 Pinecone Inference 提供内置的嵌入与重排序模型。
想进一步了解 Pinecone,请参阅Pinecone 向量数据库精通教程。
3. Weaviate
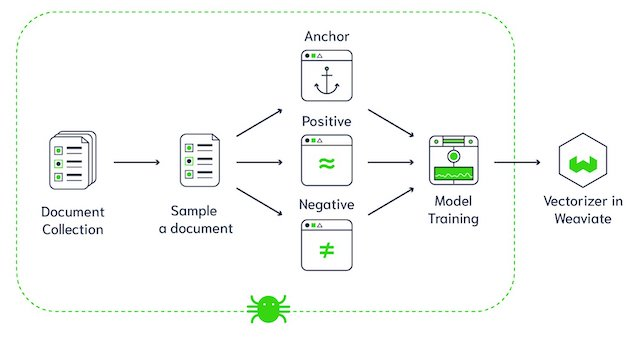
Weaviate 向量数据库架构(图片来源)
Weaviate 是一款开源、AI 原生的向量数据库。正如我们在Weaviate 教程中所示,它允许您存储来自常用 ML 模型的数据对象与向量嵌入,并无缝扩展至数十亿个数据对象。其关键特性包括:
- Weaviate 能在几毫秒内从数百万对象中快速搜索最近邻。
- 可在导入时自动向量化数据,或上传您自己的向量,支持与 OpenAI、Cohere、HuggingFace 等平台集成的模块。
- 从原型到大规模生产,Weaviate 注重可扩展性、复制与安全性。
- 除快速向量搜索外,还提供推荐、摘要与神经搜索框架集成。
4. Faiss
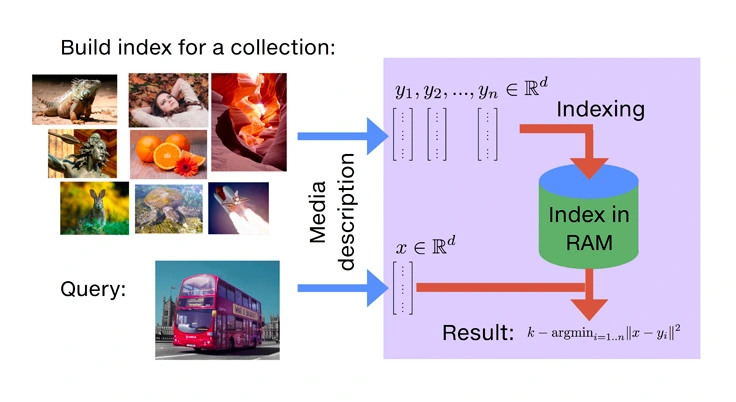
Faiss 是由 Meta 创建的开源向量搜索库(图片来源)
Faiss 是一个用于快速相似度搜索与稠密向量聚类的开源库。它包含可在不同规模向量集内进行搜索的算法,甚至支持超出内存容量的数据集。此外,Faiss 还提供用于评估与参数调优的辅助代码。
尽管主要以 C++ 编写,但它完全支持 Python/NumPy 集成。其部分核心算法也可在 GPU 上执行。Faiss 的主要开发由 Meta 的基础 AI 研究团队负责。
5. Qdrant
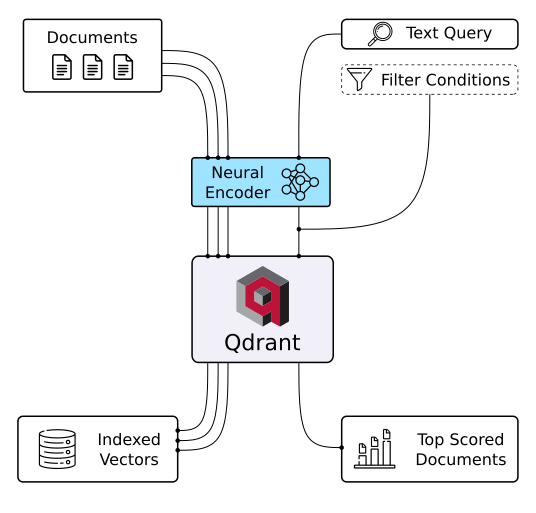
Qdrant 向量数据库(图片来源)
Qdrant 是一款向量数据库与向量相似度搜索工具。它作为 API 服务运行,可用于搜索最接近的高维向量。借助 Qdrant,您可以将嵌入或神经网络编码器转化为用于匹配、搜索、推荐等任务的完整应用。其关键特性包括:
- 提供 OpenAPI v3 规范与多语言的现成客户端。
- 采用自定义 HNSW 算法,实现快速而准确的搜索。
- 允许基于向量伴随的载荷进行结果过滤。
- 支持字符串匹配、数值区间、地理位置等。
- 云原生设计,具备水平扩展能力。
- 以 Rust 构建,通过动态查询规划优化资源使用。
6. Milvus
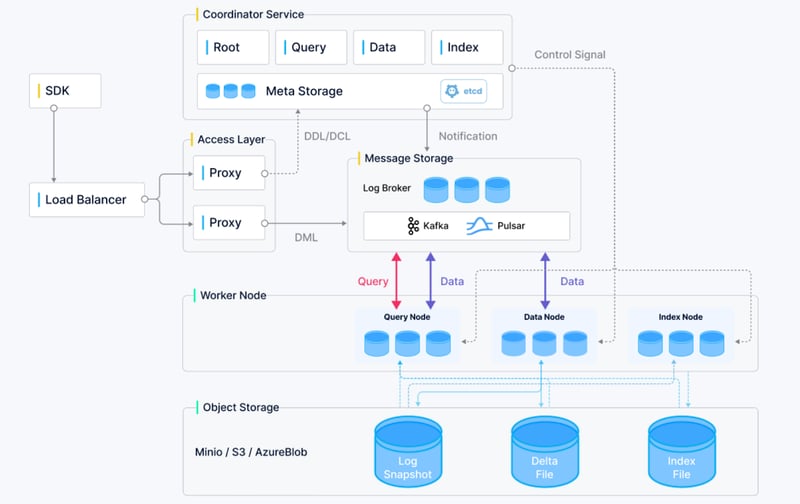
Milvus 架构概览。(图片来源)
Milvus 是一款开源向量数据库,凭借其可扩展性、可靠性与性能迅速受到关注。其专为相似度搜索与 AI 驱动应用而设计,支持存储与查询由深度神经网络生成的大规模嵌入向量。Milvus 提供以下特性:
- 通过分布式架构处理数十亿向量。
- 针对低延迟的高速相似度搜索进行了优化。
- 支持 TensorFlow、PyTorch 与 Hugging Face 等主流深度学习框架。
- 提供多种部署方式,包括 Kubernetes、Docker 与云环境。
- 拥有不断壮大的开源社区与完善文档支持。
Milvus 非常适合用于推荐系统、视频分析与个性化搜索等应用。
7. pgvector
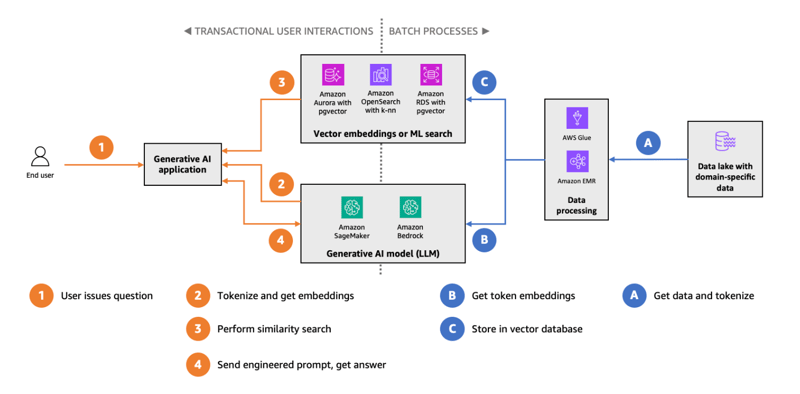
在 Amazon Aurora 上使用 pgvector 进行 HNSW 索引与搜索的架构图。(图片来源)
pgvector 是 PostgreSQL 的一个扩展,为这一广泛使用的关系型数据库引入向量数据类型与相似度搜索能力。通过将向量搜索集成进 PostgreSQL,pgvector 为已使用传统数据库、但希望加入向量搜索能力的团队提供了无缝方案。其关键特性包括:
- 在熟悉的数据库系统中增加基于向量的功能,无需单独的向量数据库。
- 兼容已依赖 PostgreSQL 的工具与生态。
- 支持近似最近邻(ANN)搜索,高效查询高维向量。
- 对熟悉 SQL 的用户友好,便于开发者与数据工程师采用。
pgvector 尤其适合较小规模的向量搜索用例,或倾向使用单一数据库同时承担关系型与向量化工作负载的环境。要开始使用,请查看我们的pgvector 详细教程。
顶尖向量数据库对比
下表对上述顶尖向量数据库的功能进行了对比:
| Feature | Chroma | Pinecone | Weaviate | Faiss | Qdrant | Milvus | PGVector |
|---|---|---|---|---|---|---|---|
| 开源 | ✅ | ❎ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 主要用例 | LLM 应用开发 | 面向机器学习的托管向量数据库 | 可扩展的向量存储与搜索 | 高速相似度搜索与聚类 | 向量相似度搜索 | 高性能 AI 搜索 | 为 PostgreSQL 增加向量搜索 |
| 集成 | LangChain、LlamaIndex | LangChain | OpenAI、Cohere、HuggingFace | Python/NumPy、GPU 执行 | OpenAPI v3、多语言客户端 | TensorFlow、PyTorch、HuggingFace | 内嵌于 PostgreSQL 生态 |
| 可扩展性 | 可从 Python 笔记本扩展到集群 | 高度可扩展 | 无缝扩展至数十亿对象 | 可处理大于内存容量的数据集 | 云原生,支持水平扩展 | 可扩展至数十亿向量 | 取决于 PostgreSQL 部署 |
| 搜索速度 | 快速相似度搜索 | 低延迟搜索 | 对数百万对象可达毫秒级 | 快速,支持 GPU | 自定义 HNSW,搜索迅速 | 针对低延迟搜索优化 | 近似最近邻(ANN) |
| 数据隐私 | 支持多用户并数据隔离 | 全托管服务 | 强调安全与副本 | 主要用于研究与开发 | 对向量载荷提供高级过滤 | 安全的多租户架构 | 继承 PostgreSQL 的安全性 |
| 编程语言 | Python、JavaScript | Python | Python、Java、Go 等 | C++、Python | Rust | C++、Python、Go | PostgreSQL 扩展(基于 SQL) |
AI 崛起与向量数据库的影响
向量数据库专注于存储高维向量,从而实现快速而准确的相似度搜索。随着 AI 模型(尤其是自然语言处理与计算机视觉领域的模型)生成并处理这类向量,高效的存储与检索系统变得至关重要。向量数据库正是在此发挥作用,为这些 AI 驱动的应用提供高度优化的运行环境。
这种关系的典型例子是检索增强生成(RAG)的兴起,其中大型语言模型(LLM)如GPT会在生成回答前使用向量数据库检索相关上下文。RAG 已在 2026 年成为 AI 应用的标准基础设施。
这些模型通过处理海量数据来理解并生成类人文本,并将数据转换为高维向量。基于 LLM 的应用高度依赖向量数据库来高效管理与查询这些向量。随着模型能力增强与智能体式 AI 工作流走向主流,向量化数据的规模显著增长,使专用向量数据库成为生产级 AI 系统的必需组件。
如何选择合适的向量数据库
选择合适的向量数据库取决于您的具体需求。以下基于常见用例给出建议:
| 用例 | 推荐 |
|---|---|
| 快速原型 | Chroma(轻量、配置最少、免费开源) |
| 大规模生产 | Pinecone(托管、无服务器)或 Milvus(自建、数十亿向量) |
| 现有 PostgreSQL 技术栈 | pgvector(无需新增基础设施) |
| 混合搜索需求 | Weaviate(向量 + BM25 关键词)或 Qdrant(高级过滤) |
| 研究与基准 | Faiss(优化的 C++ 库,支持 GPU) |
| RAG 流水线 | Pinecone、Weaviate 或 Qdrant(与 LangChain 和 LlamaIndex 有强集成) |
结论
不断演进的人工智能与机器学习版图凸显了向量数据库在当今数据驱动世界中的不可或缺性。凭借对多维数据向量的存储、检索与分析能力,这些数据库正为从推荐系统到基因组分析等 AI 应用提供关键支撑。
近年来,Chroma、Pinecone、Weaviate、Faiss、Qdrant、Milvus 与 pgvector 等向量数据库表现亮眼,各自带来不同的能力与创新。随着 AI 不断精进,向量数据库在塑造数据检索、处理与分析的未来方面必将承担更重要的角色,为各行业带来更高效、更智能与更个性化的解决方案。
通过我们的Pinecone 教程系统学习向量数据库,参加Vector Databases for Embeddings with Pinecone课程,或探索Introduction to Embeddings with the OpenAI API课程,深入理解向量搜索与 AI 应用。
常见问题
向量数据库与 MySQL 或 PostgreSQL 等传统关系型数据库有何不同?
向量数据库旨在处理高维数据,例如由 AI 模型生成的嵌入。与依赖结构化表与精确匹配的关系型数据库不同,向量数据库聚焦相似度搜索,从而检索在语义或上下文上相关的数据点。
向量数据库能否取代传统数据库?
不会,向量数据库是对传统数据库的补充,而非替代。传统数据库擅长管理结构化数据与支持事务操作,而向量数据库专注于处理与搜索文本嵌入、图像或音频等非结构化的高维数据。
什么是近似最近邻(ANN)算法?为什么它们对向量数据库至关重要?
ANN 算法是一类专门方法,用于在高维空间中快速找到最接近给定查询向量的向量。它们在速度与准确性之间取得平衡,适用于对精确最近邻搜索计算代价过高的大型数据集。
向量数据库适合小型项目,还是仅适用于大型企业?
向量数据库用途广泛,既能用于小型项目,也可支撑大型项目。对于小规模项目,Chroma、Faiss 与 Weaviate 等开源方案功能强大;对于企业级项目,Pinecone 等托管平台在可扩展性与性能优化方面更具优势。
随着数据规模增长,向量数据库的性能如何扩展?
性能扩展性取决于底层架构与索引技术(如 HNSW 或 IVF)。包括 Milvus 与 Qdrant 在内的大多数现代向量数据库均针对分布式架构优化,能够无缝扩展至数十亿向量。
不具备深厚机器学习知识,也能使用向量数据库吗?
可以。许多向量数据库(如 Pinecone 与 Chroma)提供友好的 API、SDK,并与常用框架(如 LangChain、Hugging Face)集成,使非专家也能以较低学习成本加以利用。
向量数据库的存储需求如何?
向量数据库存储嵌入,尤其在高维情况下会占用较多内存。存储需求取决于向量维度、数据集规模与索引结构等因素。Faiss 与 Milvus 等方案提供优化手段,可高效处理超出可用内存的大型数据集。
向量数据库是否兼容云原生应用?
可以。包括 Milvus 与 Qdrant 在内的许多现代向量数据库都采用云原生架构,且可与 Kubernetes、Docker 及 AWS、GCP 等云平台无缝集成。

在人工智能(AI)领域,海量数据需要高效的处理与运算。随着我们深入到更先进的 AI 应用,例如图像识别、语音搜索或推荐引擎,数据的性质也变得更为复杂。这正是向量数据库发挥作用的地方。与存储标量值的传统数据库不同,向量数据库专为处理多维数据点(通常称为向量)而设计。这些向量以众多维度表示数据,可以将其理解为空间中具有特定方向与大小的“箭头”。
在数字时代推动我们迈向由 AI 与机器学习主导的时代之际,向量数据库已成为存储、检索和分析高维数据向量的必备工具。本文旨在全面介绍什么是向量数据库、它们在 AI 中日益重要的地位,并深入评测 2026 年可用的最佳向量数据库。