

Qwen 3.7 Max क्या है?
Qwen 3.7 Max अलीबाबा का नया फ्लैगशिप मॉडल है, जो 20 मई, 2026 को जारी किया गया। इसे एजेंटिक वर्कफ़्लो के लिए बनाया गया है। इसका मतलब है कि एक-बार की चैट तक सीमित रहने की बजाय, इसे ऐसे कार्यों के लिए अनुकूलित किया गया है जिनमें योजना बनाना, टूल का उपयोग, कोडिंग, ऑफिस ऑटोमेशन, लंबी संदर्भ-आधारित तर्क क्षमता, और बहु-चरणीय निष्पादन शामिल हैं।
Qwen टीम इसे “एजेंट युग” के लिए बना मॉडल बताती है, जिसकी ताकतें कोडिंग एजेंट्स, उत्पादकता सहायक, MCP-आधारित वर्कफ़्लो, और लंबी-अवधि के स्वायत्त कार्यों में दिखती हैं।
इस मॉडल की दिलचस्पी केवल कच्चे बेंचमार्क प्रदर्शन में नहीं है, बल्कि एक बहु-टर्न कार्य के दौरान इसकी निरंतरता बनाए रखने की क्षमता में है, जहाँ हर टर्न का अलग उद्देश्य होता है, जैसे:
- योजना बनाना
- साक्ष्य संश्लेषण
- दीर्घ-रूप लेखन
- स्वयं-समीक्षा
- संशोधन
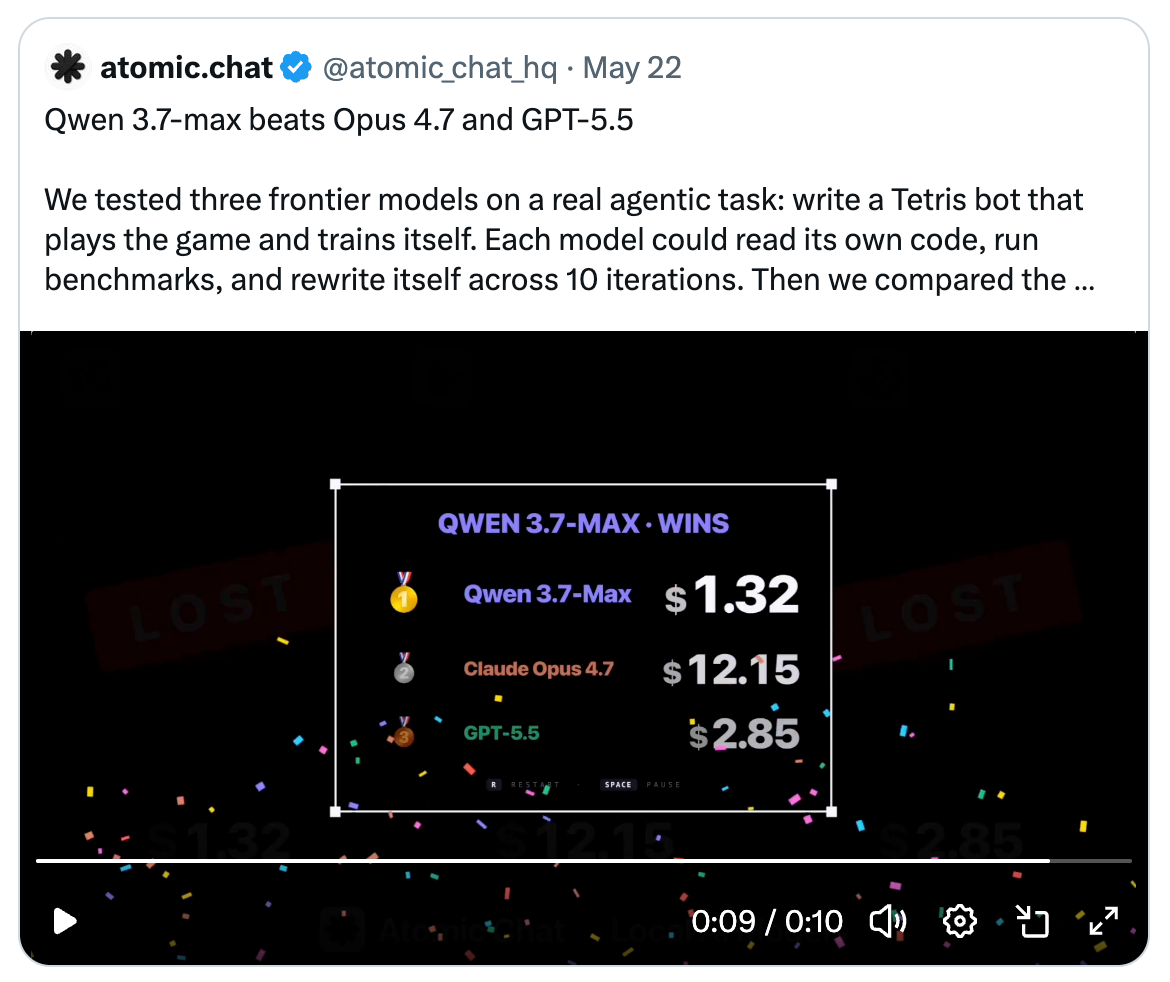
X पर, उपयोगकर्ताओं ने पाया कि यह मॉडल लंबी-अवधि की कोडिंग टास्क के लिए Opus 4.7 और GPT 5.5 के समकक्ष है।
Qwen 3.7 Max की खूबियाँ और बेंचमार्क प्रदर्शन
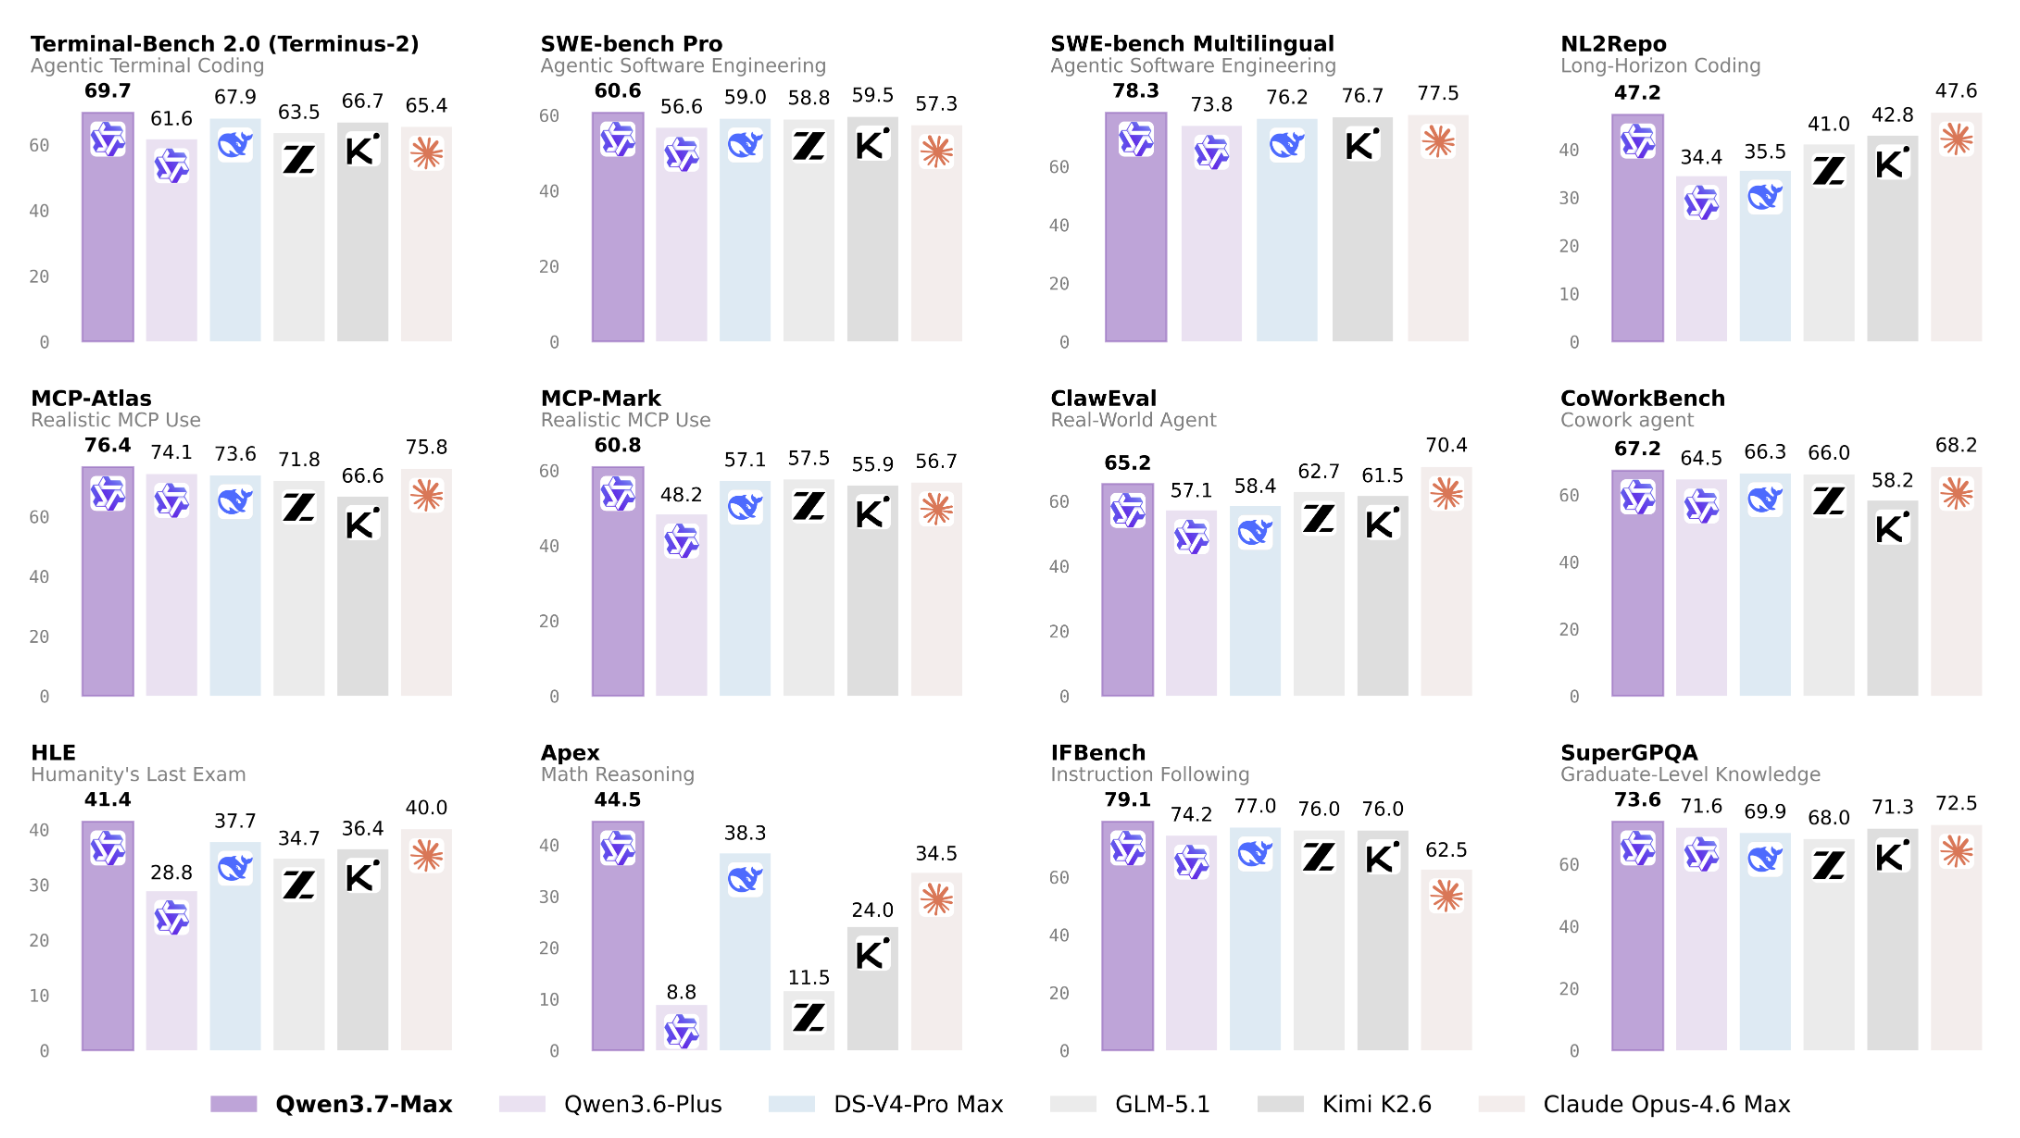
Qwen 3.7 Max एजेंट और तर्क संबंधी बेंचमार्क में सशक्त प्रदर्शन करता है। कोडिंग-एजेंट मूल्यांकनों में, इसके स्कोर हैं
- Terminal-Bench 2.0-Terminus पर 69.7
- SWE-bench Pro पर 60.6
- SWE-bench Multilingual पर 78.3
- NL2Repo पर 47.2
- SciCode पर 53.5
सामान्य-एजेंट बेंचमार्क में, यह पहुँचता है
- MCP-Mark पर 60.8
- MCP-Atlas पर 76.4
- CoWorkBench पर 67.2
- SpreadSheetBench-v1 पर 87.0
स्रोत: Qwen डेवलपर ब्लॉग
समझने के लिए: ये सभी नतीजे DeepSeek V4 Pro के स्कोर से आगे हैं; अधिकतर मामूली अंतर से, लेकिन लंबी-अवधि की कोडिंग में दोनों के बीच काफ़ी अंतर दिखता है (NL2Repo में 47.2 बनाम 35.5)।
यही हमें रिलीज़ के एक खास उदाहरण तक लाता है: Qwen 3.7 Max की लंबी-अवधि कर्नेल ऑप्टिमाइज़ेशन रन। बताया गया है कि Qwen 3.7 Max ने लगभग 35 घंटे तक रन किया, 1,158 टूल कॉल किए, 432 कर्नेल मूल्यांकन पूरे किए, और एक Triton संदर्भ इम्प्लीमेंटेशन की तुलना में 10.0x ज्यामितीय औसत स्पीडअप हासिल किया।
यह इसलिए महत्वपूर्ण है क्योंकि यह मॉडल को केवल स्थिर बेंचमार्क प्रश्नों पर नहीं, बल्कि इटरेटिव टूल-आधारित सुधार पर परखा जाना दिखाता है।
संक्षेप में, Qwen 3.7 Max इस डेमो के लिए एक मजबूत विकल्प है क्योंकि इसे ऐसे वर्कफ़्लो के लिए बनाया गया है जहाँ मॉडल को तर्क करना, टूल्स का उपयोग करना, संदर्भ बनाए रखना, और एक आर्टिफैक्ट को कई टर्न में बेहतर बनाना पड़ता है।
Qwen 3.7 Max के साथ Thinking-Preserving उत्पादकता एजेंट बनाना
इस प्रोजेक्ट में, हम तीन व्यावहारिक विचार दिखाएँगे:
- एक अस्पष्ट उपयोगकर्ता अनुरोध को संरचित बहु-चरणीय वर्कफ़्लो में बदला जा सकता है।
- टूल आउटपुट को एक लंबे प्रॉम्प्ट में डंप करने के बजाय तर्क प्रक्रिया में वापस समाहित किया जा सकता है।
- अंतिम आर्टिफैक्ट सौंपने से पहले, एक मॉडल चेन-ऑफ-थॉट प्रॉम्प्टिंग के माध्यम से अपने आउटपुट को फिर से पढ़ और सुधार सकता है।
प्रोजेक्ट का अवलोकन
हम एक साधारण एप बनाएँगे जिसमें एक इनपुट बॉक्स और एक बटन होगा, और उपयोगकर्ता इस तरह का अस्पष्ट अनुरोध दर्ज करेगा:
I need to prepare a competitive analysis of the top 3 vector databases
for a team presentation next week. I have no idea where to start.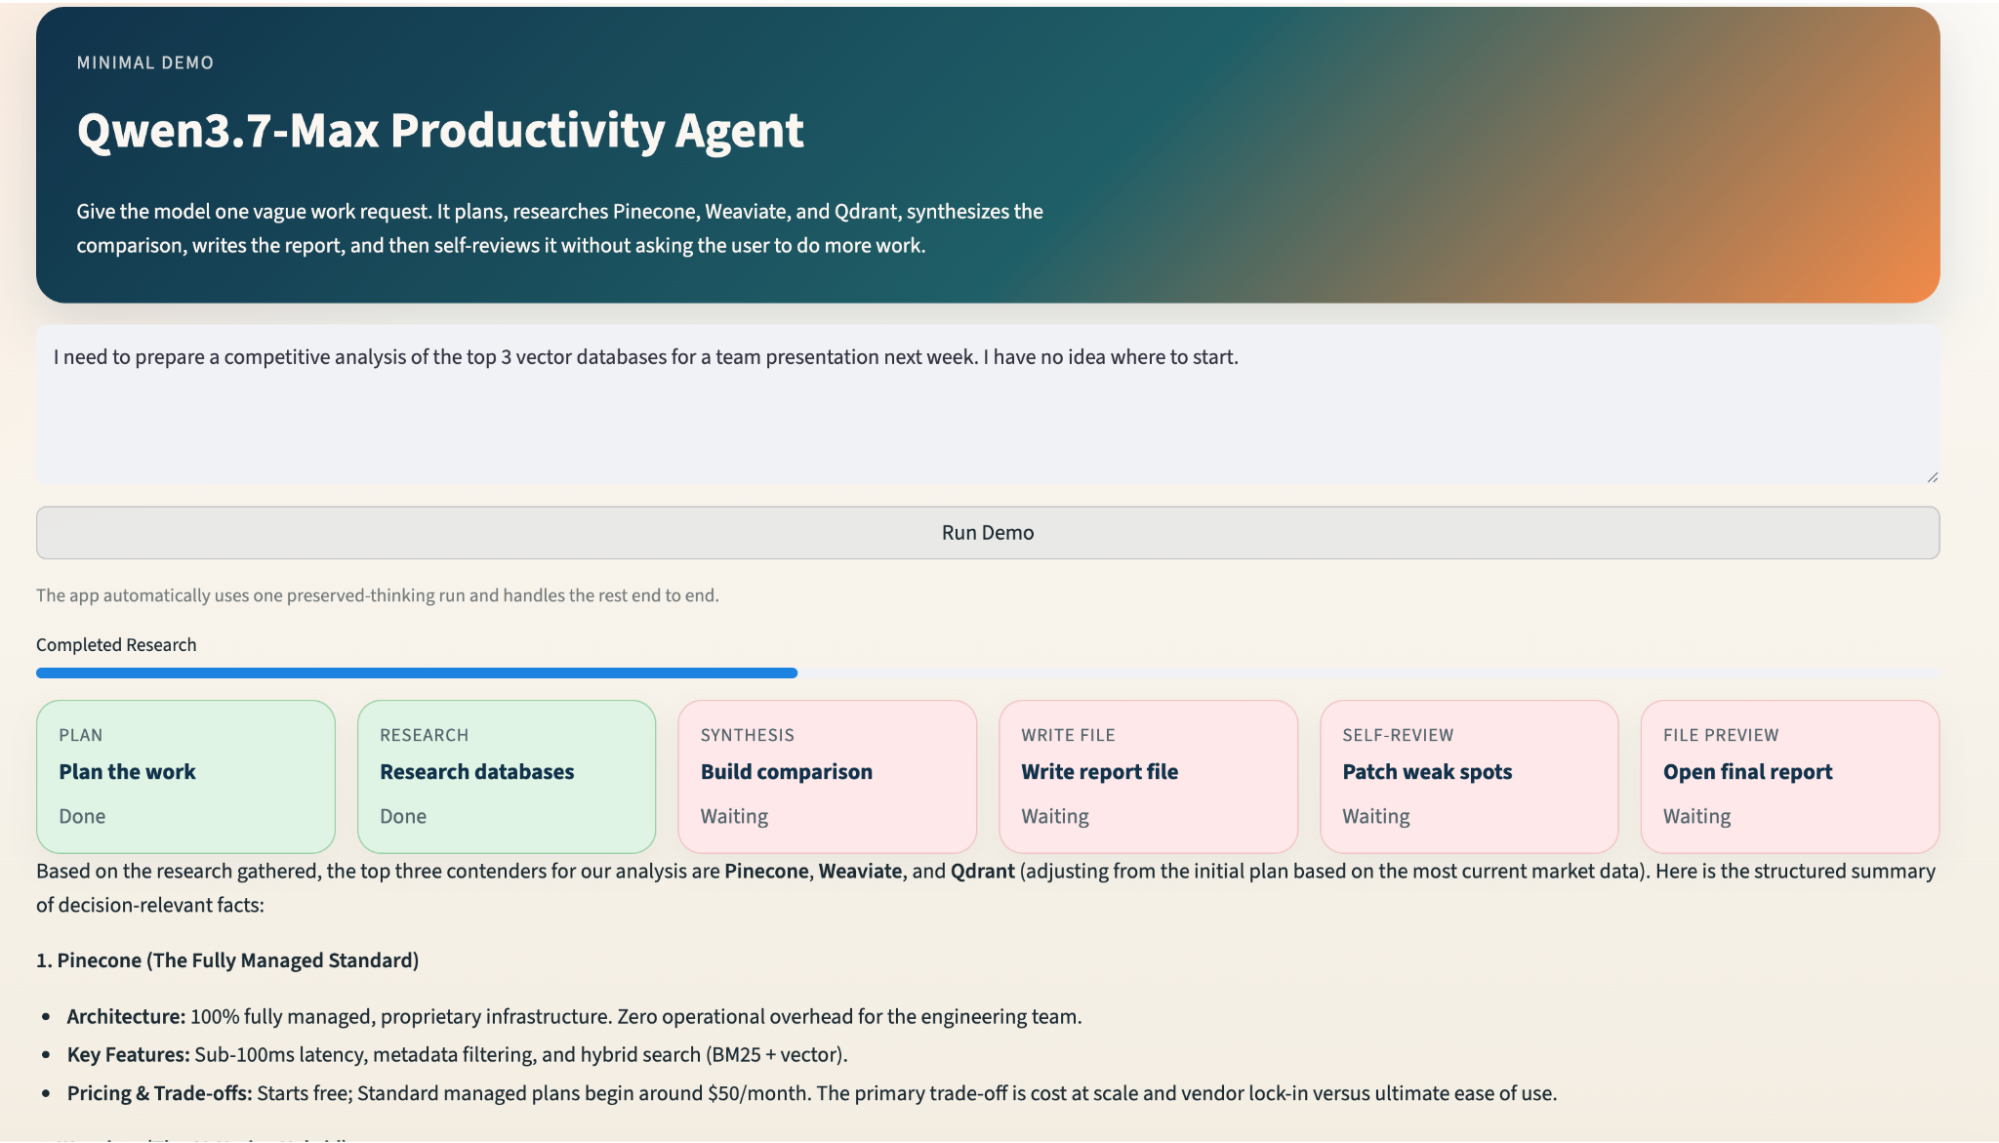
इसके बाद, एजेंट एक तय पाँच-टर्न वर्कफ़्लो चलाता है:
User prompt
Turn 1: Plan the work
Parallel research for Pinecone, Weaviate, and Qdrant
Turn 2: Summarize research
Turn 3: Build comparison matrix
Turn 4: Write competitive_analysis.md
Turn 5: Self-review and patch the markdown file
Streamlit file previewUI हर चरण को एक प्रोग्रेस कार्ड के रूप में दिखाती है। जैसे-जैसे वर्कफ़्लो पूरा होता है, कार्ड्स वेटिंग से डन में बदलते जाते हैं। अंत में, उपयोगकर्ता हर स्टेज देख सकता है: प्लानिंग, रिसर्च, सिंथेसिस, ड्राफ्ट, स्वयं-समीक्षा, और अंतिम फ़ाइल पूर्वावलोकन।
इससे एजेंट का वर्कफ़्लो एकल चैट प्रतिक्रिया के पीछे सब कुछ छिपाने के बजाय दिखाई देता है।
रिपो जानबूझकर छोटा रखा गया है। मुख्य हिस्से हैं:
-
thinking_agent.py: इसमें बैकएंड एजेंट लॉजिक है, जैसे मॉडल कॉल, प्रॉम्प्ट्स, थिंकिंग प्रिज़र्वेशन, रिसर्च, रिट्राइज़, फ़ाइल लिखना, और स्वयं-समीक्षा। -
agent.py: इसमें Streamlit इंटरफ़ेस है, जिसमें पेज लेआउट, प्रॉम्प्ट बॉक्स, प्रोग्रेस बार, स्टेप कार्ड्स, रिज़ल्ट सेलेक्टर, मार्कडाउन प्रीव्यू, और डाउनलोड बटन शामिल हैं। -
requirements.txt: इसमें डेमो के लिए आवश्यक रनटाइम डिपेंडेंसीज़ हैं
बैकएंड एक ThinkingAgent क्लास पर केंद्रित है जो एक तय पाँच-टर्न सीक्वेंस चलाता है और संरचित टर्न रिकॉर्ड्स लौटाता है। UI को यह जानने की ज़रूरत नहीं कि मॉडल कॉल, रिट्राइज़, या रिसर्च फैनआउट कैसे काम करता है। उसे केवल हर टर्न को आते ही रेंडर करना है।
इस ट्यूटोरियल का पूरा कोड GitHub पर उपलब्ध है।
नोट: मैंने Qwen 3.7 Max तक पहुँचने के लिए OpenRouter का उपयोग किया है, लेकिन आप इसे आधिकारिक Qwen API Platform के ज़रिए भी इस्तेमाल कर सकते हैं।
चरण 1: एनवायरनमेंट सेटअप
Qwen 3.7 Max उत्पादकता एजेंट बनाने से पहले, हमें Streamlit, OpenAI-कम्पैटिबल क्लाइंट, और हल्के वेब सर्च के लिए httpx के साथ एक छोटा Python एनवायरनमेंट सेट करना होगा।
इस ट्यूटोरियल में, हम मॉडल गेटवे के रूप में OpenRouter का उपयोग करेंगे, लेकिन बैकएंड OpenAI-कम्पैटिबल API फ़ॉर्मैट में लिखा गया है। यानी यही संरचना बाद में Alibaba Cloud Model Studio या किसी भी अन्य कम्पैटिबल प्रोवाइडर के लिए अपनाई जा सकती है।
इस चरण में, हम:
-
एक वर्चुअल एनवायरनमेंट बनाएँगे
-
आवश्यक डिपेंडेंसीज़ इंस्टॉल करेंगे
-
OPENROUTER_API_KEYयाQWEN_API_KEYसेट करेंगे -
पुष्टि करेंगे कि ऐप Streamlit से लॉन्च हो सकता है
वर्चुअल एनवायरनमेंट बनाएँ और सक्रिय करें:
python3 -m venv .venv
source .venv/bin/activateप्रोजेक्ट डिपेंडेंसीज़ इंस्टॉल करें:
pip install -r requirements.txtrequirements.txt फ़ाइल जानबूझकर छोटी रखी गई है:
httpx>=0.23.0
openai>=1.30.0
streamlit>=1.45.0हम streamlit का उपयोग इंटरैक्टिव वेब इंटरफ़ेस बनाने के लिए करते हैं, openai का उपयोग OpenAI-कम्पैटिबल API के ज़रिए Qwen 3.7 Max को कॉल करने के लिए, और httpx का उपयोग रिसर्च चरण के लिए हल्के लाइव सर्च नतीजे लाने के लिए।
चरण 2: Qwen 3.7 Max क्लाइंट कॉन्फ़िगर करें
बैकएंड OpenAI Python SDK का उपयोग करता है क्योंकि OpenRouter OpenAI-कम्पैटिबल एंडपॉइंट एक्सपोज़ करता है। thinking_agent.py फ़ाइल कुछ डिफॉल्ट्स परिभाषित करती है:
from openai import OpenAI
DEFAULT_MODEL = "qwen/qwen3.7-max"
DEFAULT_BASE_URL = "https://openrouter.ai/api/v1"
DEFAULT_REFERER = "https://qwen.ai"
DEFAULT_TITLE = "Qwen3.7-Max Productivity Agent"फिर हम एक क्लाइंट बनाते हैं:
def build_client(
api_key: str | None = None,
base_url: str | None = None,
referer: str = DEFAULT_REFERER,
title: str = DEFAULT_TITLE,
) -> OpenAI:
return OpenAI(
base_url=base_url or DEFAULT_BASE_URL,
api_key=api_key,
default_headers={
"HTTP-Referer": referer,
"X-Title": title,
},
)build_client() फ़ंक्शन सभी प्रोवाइडर-विशिष्ट कॉन्फ़िगरेशन को केंद्रीकृत करता है। ऐप के बाकी हिस्सों को यह जानने की ज़रूरत नहीं कि अनुरोध OpenRouter, Alibaba Cloud Model Studio, या किसी अन्य कम्पैटिबल एंडपॉइंट से जा रहा है।
क्लाइंट कॉन्फ़िगर होने के बाद, बैकएंड मानक चैट कम्प्लीशन फ़ॉर्मैट का उपयोग कर Qwen 3.7 Max को कॉल कर सकता है।
अब, हम कोर ThinkingAgent वर्कफ़्लो बनाएँगे।
चरण 3: पाँच-टर्न एजेंट वर्कफ़्लो
अब जबकि मॉडल क्लाइंट कॉन्फ़िगर हो चुका है, हम कोर बैकएंड वर्कफ़्लो परिभाषित कर सकते हैं। Qwen 3.7 Max से एक ही बार में पूरा रिपोर्ट जनरेट करने को कहने के बजाय, हम कार्य को पाँच नियंत्रित चरणों में बाँटते हैं।
-
Planning: अस्पष्ट प्रॉम्प्ट को एक संरचित टास्क प्लान में बदलता है।
-
Research: बाहरी स्निपेट्स से साक्ष्य एकत्र करता है और उनका सार बनाता है।
-
Synthesis: रिसर्च से एक तुलना मैट्रिक्स बनाता है।
-
Draft: पहला
competitive_analysis.mdरिपोर्ट लिखता है। -
Self-review: अंतिम फ़ाइल लौटाने से पहले रिपोर्ट की समीक्षा और पैच करता है।
class ThinkingAgent:
def run(
self,
goal: str,
preserve_thinking: bool = True,
data_mode: str = "live",
on_turn: Callable[[TurnRecord], None] | None = None,
) -> ThinkingRunResult:
history = [{"role": "system", "content": SYSTEM_PROMPT}]
turns = []
backend = self._build_search_backend(data_mode)
turn1 = self._run_turn(
history=history,
turn_index=1,
phase="planning",
user_prompt=_planning_prompt(goal),
preserve_thinking=preserve_thinking,
)
search_results = self._run_research(backend)
turn2 = self._run_turn(
history=history,
turn_index=2,
phase="research",
user_prompt=_research_prompt(goal, search_results),
preserve_thinking=preserve_thinking,
)
turn3 = self._run_turn(
history=history,
turn_index=3,
phase="synthesis",
user_prompt=_synthesis_prompt(),
preserve_thinking=preserve_thinking,
)
turn4 = self._run_turn(
history=history,
turn_index=4,
phase="draft",
user_prompt=_draft_prompt(goal),
preserve_thinking=preserve_thinking,
)
turn5 = self._run_turn(
history=history,
turn_index=5,
phase="self_review",
user_prompt=_self_review_prompt(draft_markdown),
preserve_thinking=preserve_thinking,
)run() मेथड मुख्य ऑर्केस्ट्रेशन लूप है। यह एक सिस्टम प्रॉम्प्ट से शुरू होता है, वार्तालाप इतिहास बनाता है, एक रिसर्च बैकएंड तैयार करता है, और फिर पाँचों टर्न क्रम से चलाता है।
हर _run_turn() कॉल का एक विशिष्ट फेज़ होता है। इससे वर्कफ़्लो डिबग करना आसान हो जाता है क्योंकि हर मॉडल कॉल की एक स्पष्ट ज़िम्मेदारी होती है। प्लानिंग टर्न योजना बनाता है। रिसर्च टर्न बाहरी स्निपेट्स की व्याख्या करता है। सिंथेसिस टर्न संरचना बनाता है। ड्राफ्ट टर्न लिखता है। स्वयं-समीक्षा टर्न आउटपुट को बेहतर बनाता है।
रिसर्च चरण को टर्न 1 और टर्न 2 के बीच रखा गया है क्योंकि मॉडल को पहले कार्य समझने की ज़रूरत है, उसके बाद बाहरी जानकारी को वर्कफ़्लो में शामिल किया जाता है।
अगले चरण में, हम Qwen-विशिष्ट थिंकिंग प्रिज़र्वेशन लॉजिक जोड़ेंगे जो मॉडल को इन टर्न्स में निरंतरता बनाए रखने में मदद करता है।
चरण 4: टर्न्स के बीच सोच को संरक्षित करें
हम इस डेमो में Qwen 3.7 Max का उपयोग मुख्यतः इसलिए कर रहे हैं क्योंकि यह थिंकिंग-प्रिज़र्विंग वर्कफ़्लो को सपोर्ट करता है। एजेंट हर मॉडल कॉल को अलग-थलग प्रॉम्प्ट की तरह नहीं मानता। इसके बजाय, यह पहले के टर्न्स से तर्क को संरक्षित रख सकता है और उस संदर्भ को बाद के टर्न्स में पहुँचा सकता है।
इस चरण में, हम:
- मॉडल थिंकिंग सक्षम करेंगे।
- टर्न्स के बीच तर्क को संरक्षित रखेंगे।
- असिस्टेंट आउटपुट को साझा इतिहास में वापस जोड़ेंगे।
response = self.client.chat.completions.create(
model=self.config.model,
messages=request_messages,
extra_body={
"enable_thinking": True,
"preserve_thinking": preserve_thinking,
},
)enable_thinking=True फ़्लैग Qwen 3.7 Max को प्रतिक्रिया के दौरान तर्क-संबंधी सामग्री बनाने देता है। जबकि preserve_thinking फ़्लैग नियंत्रित करता है कि वह तर्क-सामग्री बाद के टर्न्स में बनी रहनी चाहिए या नहीं।
मॉडल के उत्तर देने के बाद, बैकएंड दृश्य उत्तर और तर्क-सामग्री—दोनों निकालता है:
message = response.choices[0].message
assistant_content = _normalize_text(getattr(message, "content", ""))
reasoning_content = _extract_reasoning_content(message)
The visible answer is what the app can show to the user. The reasoning content is used internally to help the next turn stay aligned with the earlier plan.
Then the backend appends the assistant message back into the conversation history:
```python
assistant_message = {
"role": "assistant",
"content": assistant_content,
}
if preserve_thinking and reasoning_content:
assistant_message["reasoning_content"] = reasoning_content
history.append(assistant_message)यदि प्लानिंग टर्न तय करता है कि अंतिम रिपोर्ट को डिप्लॉयमेंट मॉडल, स्केलेबिलिटी, डेवलपर अनुभव, हाइब्रिड सर्च, और एंटरप्राइज़ रेडीनेस के आधार पर वेक्टर डेटाबेस की तुलना करनी चाहिए, तो बाद के टर्न उन्हीं मानदंडों का उपयोग जारी रख सकते हैं। इसके बिना, हर टर्न भटक सकता है। सिंथेसिस चरण प्लानिंग चरण से अलग मानदंड चुन सकता है, या स्वयं-समीक्षा चरण रिपोर्ट का आकलन किसी अलग लक्ष्य के अनुसार कर सकता है।
अब हम रिसर्च लेयर जोड़ेंगे जो रिपोर्ट लिखने से पहले एजेंट को बाहरी संदर्भ देती है।
चरण 5: फ़ॉलबैक डेटा के साथ समानांतर रिसर्च जोड़ें
मॉडल के लिए प्रतिस्पर्धी विश्लेषण लिखने से पहले, कुछ बाहरी संदर्भ ज़रूरी है। इस डेमो में, हम रिसर्च दायरा तय रखते हैं और तीन वेक्टर डेटाबेस की तुलना करते हैं: Pinecone, Weaviate, और Qdrant।
इस चरण में, हम:
- लक्ष्य डेटाबेस परिभाषित करेंगे।
- रिसर्च कॉल्स समानांतर में चलाएँगे।
- लाइव सर्च विफल होने पर निर्धारक फ़िक्स्चर डेटा पर फ़ॉलबैक करेंगे।
DATABASES = ("Pinecone", "Weaviate", "Qdrant")लक्ष्य सूची जानबूझकर तय है। इससे डेमो स्थिर और समझाने में आसान रहता है। बाद में, आप प्रोजेक्ट बढ़ाकर मॉडल को तुलना लक्ष्य गतिशील रूप से चुनने दे सकते हैं।
इसके बाद, बैकएंड समानांतर में रिसर्च कॉल्स लॉन्च करता है:
from concurrent.futures import ThreadPoolExecutor, as_completed
with ThreadPoolExecutor(max_workers=3) as executor:
future_map = {
executor.submit(backend.search, database, query): database
for database, query in queries.items()
}
for future in as_completed(future_map):
database = future_map[future]
results[database] = future.result()ThreadPoolExecutor हर डेटाबेस पर एक सर्च शुरू करता है। यह सिलसिलेवार सर्च से तेज़ है क्योंकि Pinecone, Weaviate, और Qdrant पर रिसर्च समानांतर में चल सकती है।
try:
results[database] = future.result()
except Exception as exc:
fallback = FixtureSearchBackend().search(database, queries[database])
fallback.warning = (
f"Live search failed for {database} ({exc}). "
"Fallback demo research was used."
)
results[database] = fallbackयदि लाइव सर्च काम करती है, तो एजेंट ताज़ा स्निपेट्स का उपयोग करता है। यदि विफल होती है, तब भी ऐप अंतर्निहित निर्धारक रिसर्च स्निपेट्स का उपयोग कर वर्कफ़्लो पूरा करता है। महत्वपूर्ण डिज़ाइन सिद्धांत है ग्रेसफुल डिग्रेडेशन। किसी एक बाहरी निर्भरता के फेल होने से एजेंट क्रैश नहीं होना चाहिए।
अगले चरण में, हम इन रिसर्च नतीजों को Qwen 3.7 Max को देंगे ताकि वह एक तुलना मैट्रिक्स संश्लेषित कर सके।
चरण 6: सिंथेसिस और तुलना मैट्रिक्स तैयार करें
जब एजेंट के पास रिसर्च स्निपेट्स आ जाते हैं, तो अगला काम सिंथेसिस है। यह चरण बिखरी हुई जानकारी को एक संरचित तुलना में बदलता है जो अंतिम रिपोर्ट का आधार बन सके।
इस चरण में, हम:
- रिसर्च संदर्भ वापस Qwen 3.7 Max को भेजेंगे।
- मॉडल से संरचित तुलना बनाने को कहेंगे।
- बाद में उस आउटपुट को Streamlit इंटरफ़ेस में रेंडर करेंगे।
turn3 = self._run_turn(
history=history,
turn_index=3,
phase="synthesis",
user_prompt=_synthesis_prompt(),
preserve_thinking=preserve_thinking,
)जब तक यह कोड चलता है, वार्तालाप इतिहास में पहले से मूल उपयोगकर्ता अनुरोध, प्लानिंग आउटपुट, रिसर्च सारांश, और वैकल्पिक रूप से पहले के टर्न्स की संरक्षित सोच शामिल होती है।
इसका मतलब है कि सिंथेसिस प्रॉम्प्ट को पूरा कार्य फिर से बताने की ज़रूरत नहीं। यह एक ही काम पर केंद्रित रह सकता है, यानी रिसर्च को निर्णय-तैयार तुलना मैट्रिक्स में बदलना।
एक अच्छा सिंथेसिस इन आयामों पर विकल्पों की तुलना करता है:
- डिप्लॉयमेंट मॉडल
- स्केलेबिलिटी
- डेवलपर अनुभव
- हाइब्रिड सर्च सपोर्ट
- एंटरप्राइज़ रेडीनेस
- सर्वोत्तम-फिट उपयोग मामला
आगे, हम इसी संश्लेषित संरचना का उपयोग करके पहला Markdown रिपोर्ट लिखेंगे।
चरण 7: मार्कडाउन रिपोर्ट लिखें
प्लानिंग, रिसर्च, और सिंथेसिस के बाद, एजेंट के पास पहला संपूर्ण डिलिवरेबल लिखने के लिए पर्याप्त संदर्भ होता है। इस डेमो में, डिलिवरेबल एक मार्कडाउन फ़ाइल है जिसका नाम competitive_analysis.md है।
इस चरण में, हम:
- Qwen 3.7 Max से पहला रिपोर्ट ड्राफ्ट लिखवाएँगे।
- अनावश्यक मार्कडाउन कोड फेंस हटाएँगे।
- ड्राफ्ट को डिस्क पर सेव करेंगे।
- फ़ाइल-लिखने की क्रिया को एक टूल इवेंट के रूप में दर्ज करेंगे।
turn4 = self._run_turn(
history=history,
turn_index=4,
phase="draft",
user_prompt=_draft_prompt(goal),
preserve_thinking=preserve_thinking,
)ड्राफ्ट टर्न पिछले सभी संदर्भ का उपयोग करता है, जिसमें उपयोगकर्ता का मूल लक्ष्य, योजना, रिसर्च, और सिंथेसिस मैट्रिक्स शामिल हैं।
इसके बाद मॉडल प्रतिक्रिया को साफ़ किया जाता है और डिस्क पर लिखा जाता है:
draft_markdown = _strip_markdown_fences(turn4.assistant_content)
report_path = run_output_dir / "competitive_analysis.md"
report_path.write_text(draft_markdown)हेल्पर _strip_markdown_fences() उपयोगी है क्योंकि मॉडल अक्सर मार्कडाउन आउटपुट को ट्रिपल बैकटिक्स में लपेट देता है। यह चैट प्रतिक्रिया में ठीक है, लेकिन सीधे .md फ़ाइल में लिखते समय आदर्श नहीं।
बैकएंड लिखने की क्रिया भी रिकॉर्ड करता है:
turn4.tool_events.append(
ToolEvent(
name="write_file",
status="completed",
input_payload={"path": str(report_path)},
output_payload={
"description": "Initial draft written to disk.",
},
)
)यह टूल इवेंट UI को यह दिखाने में मदद करता है कि बैकएंड ने एक वास्तविक फ़ाइल बनाई है, केवल एक और टेक्स्ट प्रतिक्रिया नहीं। इस चरण पर, ऐप के पास पहले से एक उपयोगी रिपोर्ट है। लेकिन हम अंतिम आर्टिफैक्ट दिखाने से पहले गुणवत्ता सुधार के लिए एक और मॉडल टर्न जोड़ते हैं।
अगले चरण में, हम Qwen 3.7 Max से अपने ही ड्राफ्ट की समीक्षा और पैच करने के लिए कहेंगे।
चरण 8: स्वयं-समीक्षा और रिपोर्ट पैच करें
अंतिम मॉडल टर्न स्वयं-समीक्षा चरण है। पहले ड्राफ्ट को तुरंत उपयोगकर्ता को सौंपने के बजाय, एजेंट रिपोर्ट को फिर से पढ़ता है, उसे मूल लक्ष्य के साथ परखता है, और एक बेहतर संस्करण लिखता है।
इस चरण में, हम:
- ड्राफ्ट मार्कडाउन को वापस मॉडल को भेजेंगे।
- मॉडल से कमज़ोरियों की पहचान करने को कहेंगे।
- संशोधित संस्करण बनाएँगे।
- बेहतर अंतिम संस्करण से रिपोर्ट को ओवरराइट करेंगे।
turn5 = self._run_turn(
history=history,
turn_index=5,
phase="self_review",
user_prompt=_self_review_prompt(draft_markdown),
preserve_thinking=preserve_thinking,
)स्वयं-समीक्षा प्रॉम्प्ट मॉडल से व्यावहारिक मुद्दों की जाँच करने को कहता है, जैसे सिफारिश स्पष्ट है या नहीं, तुलना मानदंड सुसंगत हैं या नहीं, और रिपोर्ट टीम प्रस्तुति के लिए उपयोगी है या नहीं।
संशोधित आउटपुट को उसी फ़ाइल में वापस लिखा जाता है:
final_markdown = _strip_markdown_fences(turn5.assistant_content)
report_path.write_text(final_markdown)एजेंट अंतिम लिखने की घटना भी रिकॉर्ड कर सकता है:
turn5.tool_events.append(
ToolEvent(
name="write_file",
status="completed",
input_payload={"path": str(report_path)},
output_payload={
"description": "Self-reviewed final report written to disk.",
},
)
)यह चरण ऐप को एक साधारण जनरेटर से एक छोटे संपादकीय वर्कफ़्लो में बदल देता है। उपयोगकर्ता जो आउटपुट देखता है, वह पहला ड्राफ्ट नहीं, बल्कि समीक्षा किया हुआ और पैच किया हुआ संस्करण है।
अब हम इस बैकएंड वर्कफ़्लो को Streamlit ऐप से जोड़ेंगे।
चरण 9: Streamlit प्रोग्रेस इंटरफ़ेस बनाएँ
अब हम बैकएंड लॉजिक से यूज़र इंटरफ़ेस पर आते हैं। Streamlit ऐप को उपयोगकर्ता को प्रॉम्प्ट दर्ज करने, वर्कफ़्लो चलाने, और हर चरण को पूरा होते देखने देना चाहिए।
नोट: यह कोड agent.py फ़ाइल में होना चाहिए क्योंकि यह नियंत्रित करता है कि उपयोगकर्ता क्या देखता और क्लिक करता है।
इस चरण में, हम:
-
Streamlit पेज कॉन्फ़िगर करेंगे।
-
प्रॉम्प्ट इनपुट बनाएँगे।
-
रन बटन जोड़ेंगे।
-
ThinkingAgent.run()फ़ंक्शन कॉल करेंगे। -
टर्न पूरे होते ही UI अपडेट करेंगे।
def render_streamlit_app() -> None:
st.set_page_config(
page_title="Qwen3.7-Max Demo Agent",
page_icon=":material/psychology:",
layout="wide",
initial_sidebar_state="collapsed",
)ऐप वाइड लेआउट का उपयोग करता है क्योंकि UI में स्टेप कार्ड्स, प्रोग्रेस इंडिकेटर्स, और रिज़ल्ट पैनल शामिल हैं।
इनपुट क्षेत्र सरल है:
goal = st.text_area(
"Prompt",
value=DEFAULT_GOAL,
height=120,
label_visibility="collapsed",
)
run_clicked = st.button("Run Demo", use_container_width=True)उपयोगकर्ता को केवल कार्य बताना होता है। ऐप उनसे टेम्परेचर, सर्च मोड, मॉडल ID, या तर्क संबंधी सेटिंग्स कॉन्फ़िगर करने को नहीं कहता। ये विवरण बैकएंड संभालता है।
जब उपयोगकर्ता बटन क्लिक करता है, तो agent.py बैकएंड एजेंट बनाता है और चलाता है:
agent = ThinkingAgent(config=config)
result = agent.run(
goal=goal,
preserve_thinking=True,
data_mode="live",
on_turn=on_turn,
)यहीं दोनों फ़ाइलें मिलती हैं। agent.py वर्कफ़्लो ट्रिगर करता है, लेकिन वास्तविक एजेंट व्यवहार thinking_agent.py का है। UI कॉलबैक हर टर्न के बाद पेज अपडेट करता है:
def on_turn(turn: TurnRecord) -> None:
partial_turns.append(turn)
progress_placeholder.progress(
len(partial_turns) / len(phase_order),
text=f"Completed {_phase_label(turn.phase)}",
)
with steps_placeholder.container():
_render_step_cards(partial_turns, result_ready=False)कॉलबैक एक पूर्ण TurnRecord प्राप्त करता है और प्रोग्रेस बार व स्टेप कार्ड्स को रिफ़्रेश करता है। निष्पादन के दौरान, कार्ड्स स्टेटस इंडिकेटर की तरह काम करते हैं। पूर्ण होने के बाद, वे क्लिक करने योग्य परिणाम दृश्य बन जाते हैं।
अब हम अंतिम मार्कडाउन रिपोर्ट रेंडर करेंगे और उसे डाउनलोड योग्य फ़ाइल के रूप में उपलब्ध कराएँगे।
चरण 10: अंतिम रिपोर्ट का प्रीव्यू और डाउनलोड
बैकएंड के खत्म होने के बाद, UI को अंतिम रिपोर्ट दिखानी होती है। बैकएंड पहले ही मार्कडाउन फ़ाइल बना चुका है, इसलिए agent.py को केवल उसे पढ़ना, रेंडर करना, और डाउनलोड बटन दिखाना है।
इस चरण में, हम:
- जाँचेंगे कि रिपोर्ट फ़ाइल मौजूद है या नहीं।
- अंतिम मार्कडाउन सामग्री पढ़ेंगे।
- डाउनलोड बटन दिखाएँगे।
- Streamlit ऐप में मार्कडाउन रेंडर करेंगे
def _render_file_preview(report_path: str) -> None:
path = Path(report_path)
if not path.exists():
st.info("No file was written yet.")
return
content = path.read_text()
st.caption(f"Created file: {path.name}")
st.download_button(
"Download competitive_analysis.md",
data=content,
file_name=path.name,
use_container_width=True,
)
st.markdown(content)फ़ंक्शन सबसे पहले जाँचता है कि फ़ाइल मौजूद है या नहीं। इससे बैकएंड के रिपोर्ट लिखने से पहले फेल होने पर ऐप के क्रैश होने से बचाव होता है। फिर यह मार्कडाउन सामग्री पढ़ता है और एक डाउनलोड बटन बनाता है। अंत में, यह मार्कडाउन को सीधे Streamlit पेज में रेंडर करता है।
यह ज़िम्मेदारियों का साफ़ बँटवारा है, जहाँ:
-
thinking_agent.pyरिपोर्ट लिखता है -
agent.pyरिपोर्ट का पूर्वावलोकन दिखाता है और उसे डाउनलोड कराता है
अगले चरण में, हम बुनियादी त्रुटि हैंडलिंग जोड़ेंगे ताकि प्रोवाइडर रूट्स के फेल होने या रेट लिमिट आने पर डेमो बेहतर व्यवहार करे।
चरण 11: त्रुटि और रेट लिमिट हैंडलिंग
मॉडल प्रोवाइडर्स टाइमआउट हो सकते हैं, अस्थायी विफलताएँ लौटा सकते हैं, या अनुरोधों को रेट-लिमिट कर सकते हैं। यदि हम उन कच्ची त्रुटियों को सीधे उपयोगकर्ताओं के सामने रखें, तो ऐप अधूरा लगता है।
यह चरण दोनों फ़ाइलों में बँटा है। रिट्राइ लॉजिक thinking_agent.py में होना चाहिए क्योंकि यह बैकएंड मॉडल कॉल का हिस्सा है। त्रुटि संदेश agent.py में होना चाहिए क्योंकि यह नियंत्रित करता है कि उपयोगकर्ता क्या देखता है।
इस चरण में, हम:
- बैकएंड में अस्थायी प्रोवाइडर विफलताओं पर पुन:प्रयास करेंगे।
- रेट-लिमिट जैसी त्रुटियों का पता लगाएंगे।
- Streamlit UI में एक अधिक साफ़ संदेश दिखाएँगे
delays = (1.0, 2.0)
for attempt_index in range(len(delays) + 1):
try:
return self.client.chat.completions.create(...)
except Exception as exc:
if not _is_retryable_provider_error(exc):
raise
if attempt_index >= len(delays):
raise
time.sleep(delays[attempt_index])बैकएंड मॉडल कॉल का प्रयास करता है, रिट्राइ योग्य विफलताओं को पकड़ता है, थोड़ी देर रुकता है, और फिर से कोशिश करता है। छोटे विलंब अस्थायी प्रोवाइडर अस्थिरता को स्मूद कर देते हैं, बिना उपयोगकर्ता को ज़्यादा प्रतीक्षा कराए।
def _friendly_rate_limit_message(exc: Any) -> str:
return (
"Qwen 3.7 Max is temporarily rate-limited upstream. "
"Please wait 30 to 60 seconds and try again."
)इससे कच्चा प्रोवाइडर JSON या स्टैक ट्रेसेज़ UI से बाहर रहते हैं। उपयोगकर्ता को स्पष्ट स्पष्टीकरण और व्यावहारिक अगला कदम मिलता है।
इस अंतिम चरण के साथ, अब हम पूरी ऐप चला सकते हैं और एंड-टू-एंड वर्कफ़्लो का परीक्षण कर सकते हैं।
चरण 12: डेमो चलाएँ
अब जबकि बैकएंड वर्कफ़्लो और Streamlit इंटरफ़ेस जुड़ चुके हैं, हम पूरी ऐप चला सकते हैं।
इस चरण में, हम:
- Streamlit ऐप शुरू करेंगे।
- डिफ़ॉल्ट उत्पादकता प्रॉम्प्ट दर्ज करेंगे।
- पाँच-चरणीय वर्कफ़्लो चलाएँगे।
- अंतिम मार्कडाउन रिपोर्ट का प्रीव्यू और डाउनलोड करेंगे
ऐप शुरू करें:
streamlit run agent.pyडिफ़ॉल्ट प्रॉम्प्ट का उपयोग करें:
I need to prepare a competitive analysis of the top 3 vector databases
for a team presentation next week. I have no idea where to start.जब आप Run Demo पर क्लिक करेंगे, ऐप पूरा वर्कफ़्लो चलाएगा:
-
Planning: एक संरचित योजना बनाता है।
-
Research: Pinecone, Weaviate, और Qdrant के लिए स्निपेट्स एकत्र करता है।
-
Synthesis: एक तुलना मैट्रिक्स तैयार करता है।
-
Draft: पहली मार्कडाउन रिपोर्ट लिखता है।
-
Self-review: रिपोर्ट में सुधार करता है।
-
Preview: अंतिम
competitive_analysis.mdफ़ाइल दिखाता है।
अंतिम रिपोर्ट यहाँ सहेजी जाती है:
output/showcase_runs/<timestamp>/with_preserve/competitive_analysis.md
अंत में, आपको Streamlit इंटरफ़ेस में रिपोर्ट का पूर्वावलोकन और एक डाउनलोड बटन दिखना चाहिए।
निष्कर्ष
इस ट्यूटोरियल में, हमने Qwen 3.7 Max के साथ एक कॉम्पैक्ट प्रोडक्टिविटी एजेंट बनाया जो प्लानिंग, रिसर्च, सिंथेसिस, लेखन और सेल्फ-रीव्यू तक फैला एक तयशुदा, समझने योग्य वर्कफ़्लो चलाता है। इसी दौरान, यह दिखाता है कि लंबी-फ़ॉर्म एजेंट कार्यों में विभिन्न चरणों के बीच तर्क को संरक्षित रखना क्यों उपयोगी हो सकता है।
वर्तमान संस्करण केवल Streamlit, OpenAI-संगत मॉडल कॉल्स, एक हल्की-फुल्की सर्च लेयर, और Markdown आउटपुट का उपयोग करता है। इससे इसे अपने प्रयोगों में पढ़ना, संशोधित करना और दोबारा उपयोग करना आसान हो जाता है।
यहाँ से कई स्वाभाविक विस्तार संभव हैं:
-
एक तय सूची के बजाय तुलना के लक्ष्य मॉडल को चुनने दें
-
साइड-बाय-साइड “with
preserve_thinking” बनाम “withoutpreserve_thinking” रन जोड़ें -
UI में टोकन उपयोग और लागत के अनुमान दिखाएँ
-
मार्कडाउन रिपोर्ट के साथ-साथ एक स्लाइड रूपरेखा या चार्ट जनरेट करें
-
DuckDuckGo स्क्रैपिंग को एक अधिक मज़बूत सर्च API से बदलें
यदि आप एक तयशुदा वर्कफ़्लो से आगे बढ़ना चाहते हैं और प्रॉम्प्ट इंजीनियरिंग से लेकर RAG तक और एजेंटिक सिस्टम्स तक प्रोडक्शन-ग्रेड AI एप्लिकेशन बनाना सीखना चाहते हैं, तो हमारा AI Engineering with LangChain स्किल ट्रैक अगला अच्छा कदम है।
Qwen 3.7 Max API ट्यूटोरियल FAQs
मुझे Qwen 3.7 Max के साथ preserve_thinking=True कब उपयोग करना चाहिए?
preserve_thinking=True मल्टी-टर्न वर्कफ़्लोज़ में बाद के चरणों को पहले के निर्णयों के अनुरूप बनाए रखने में मदद करता है। हमारे उदाहरण में, यदि प्लानिंग चरण विशेष तुलना मानदंड चुनता है, तो सिंथेसिस और सेल्फ-रीव्यू चरण उसी तर्क का उपयोग जारी रख सकते हैं, भटकने के बजाय।
क्या Qwen 3.7 Max सिर्फ़ कोडिंग एजेंट्स के लिए है?
नहीं। कोडिंग इसकी प्रमुख ताकतों में से एक है, लेकिन मॉडल को प्रोडक्टिविटी एजेंट्स, ऑफिस ऑटोमेशन, MCP-आधारित वर्कफ़्लोज़, बहुभाषी कार्य, लॉन्ग-कॉन्टेक्स्ट रीजनिंग, और लंबी-अवधि वाले टूल उपयोग के लिए भी तैयार किया गया है।
क्या डेमो ऐप वास्तविक वेब सर्च का उपयोग करता है?
हाँ, वर्तमान डिफ़ॉल्ट पथ लाइव DuckDuckGo स्क्रैपिंग का प्रयास करता है। यदि वह विफल हो जाए, तो यह बिल्ट-इन फ़िक्स्चर रिसर्च पर लौट आता है।
क्या हमारा डेमो ऐप मॉडल के अंदर सब-एजेंट्स बनाता है?
नहीं। ऐप एक ही मॉडल सत्र का उपयोग करता है। “समानांतर” हिस्सा रिसर्च लेयर में होता है, जहाँ बैकएंड एक साथ तीन वेब सर्च शुरू करता है और परिणामों को उसी मॉडल सत्र में वापस फ़ीड करता है।
हम agent.py और thinking_agent.py को अलग क्यों रखते हैं?
agent.py Streamlit UI को पठनीय रखता है। thinking_agent.py बैकएंड वर्कफ़्लो, प्रॉम्प्ट निर्माण, रिट्राइज़, और रिसर्च लॉजिक रखता है ताकि एजेंट का व्यवहार इंटरफ़ेस से स्वतंत्र रूप से टेस्ट किया जा सके।

मैं एमएल (Gen AI) में Google Developers Expert, Kaggle 3x Expert, और Women Techmakers एंबेसडर हूँ, तथा तकनीक क्षेत्र में 3+ वर्षों का अनुभव रखती हूँ। मैंने 2020 में एक हेल्थ-टेक स्टार्टअप की सह-स्थापना की और वर्तमान में Georgia Tech से कंप्यूटर विज्ञान में मास्टर कर रही हूँ, जिसमें मेरा विशेषज्ञता क्षेत्र मशीन लर्निंग है।
अधिकांश AI डेमो अब भी चैटबॉट जैसे दिखते हैं: आप कोई सवाल पूछते हैं, मॉडल जवाब देता है, और बातचीत यहीं खत्म हो जाती है। लेकिन वास्तविक उत्पादकता का काम आम तौर पर एक ही चरण में नहीं होता। एक उपयोगी सहायक को एक अस्पष्ट अनुरोध को तोड़ना, संदर्भ जुटाना, विकल्पों की तुलना करना, एक उपयोग योग्य आर्टिफैक्ट बनाना, और फिर वापस सौंपने से पहले अपने काम की खुद जाँच करना आना चाहिए।
Qwen 3.7 Max Qwen टीम का एक एजेंटिक मॉडल है, जिसे एजेंट-केंद्रित वर्कलोड के लिए बनाया गया है, जिनमें कोडिंग, ऑफिस प्रोडक्टिविटी टास्क, और लंबे क्षितिज वाले एक्जीक्यूशन शामिल हैं। यह एक एजेंट-फर्स्ट मॉडल है, जिसे सिर्फ एक प्रॉम्प्ट का अच्छा जवाब देने के लिए नहीं, बल्कि योजना, टूल उपयोग, लेखन और स्व-सुधार से जुड़ी लंबी वर्कफ़्लो के दौरान सुसंगत बने रहने के लिए डिज़ाइन किया गया है।
इस ट्यूटोरियल में, हम Qwen 3.7 Max और Streamlit का उपयोग करके एक कॉम्पैक्ट प्रोडक्टिविटी एजेंट बनाएंगे। यह ऐप किसी धुंधले बिज़नेस अनुरोध—जैसे वेक्टर डेटाबेस का एक प्रतिस्पर्धी विश्लेषण तैयार करना—को लेता है, और उसे एक परिष्कृत
competitive_analysis.mdफ़ाइल में बदल देता है।इस ट्यूटोरियल के अंत तक, आप यह समझ जाएंगे कि कैसे:
एक फिक्स्ड पाँच-टर्न एजेंट वर्कफ़्लो बनाएं
enable_thinking=Trueऔरpreserve_thinking=Trueका उपयोग करेंहल्का-फुल्का समानांतर शोध जोड़ें
एक मार्कडाउन आर्टिफैक्ट लिखें और उसमें पैच लगाएँ
वर्कफ़्लो के चारों ओर एक सरल Streamlit UI बनाएं
पूरा कोड GitHub रिपोज़िटरी में उपलब्ध है।
यह प्रोजेक्ट जानबूझकर छोटा रखा गया है, जिसकी मुख्य लॉजिक दो हिस्सों में बँटी है: Streamlit ऐप के लिए
agent.pyऔर बैकएंड वर्कफ़्लो के लिएthinking_agent.py।यदि आप एजेंटिक AI में नए हैं, तो हमारी AI Agent Fundamentals स्किल ट्रैक से शुरुआत करने की सलाह देता/देती हूँ।