

Apa itu Qwen 3.7 Max?
Qwen 3.7 Max adalah model andalan baru dari Alibaba, dirilis pada 20 Mei 2026. Model ini dibangun untuk alur kerja agentic. Artinya, alih-alih hanya dirancang untuk chat satu kali, model ini dioptimalkan untuk tugas yang memerlukan perencanaan, penggunaan alat, pengodean, automasi perkantoran, penalaran konteks panjang, dan eksekusi multi-langkah.
Tim Qwen menggambarkannya sebagai model untuk “era agen,” dengan kekuatan di seluruh agen pengodean, asisten produktivitas, alur kerja berbasis MCP, dan tugas otonom jangka panjang.
Yang menarik dari model ini bukan hanya performa benchmark mentah, tetapi kemampuannya untuk tetap konsisten di seluruh tugas multi-giliran di mana setiap giliran memiliki tujuan berbeda, termasuk:
- perencanaan
- sintesis bukti
- penulisan bentuk panjang
- kritik diri
- Revisi
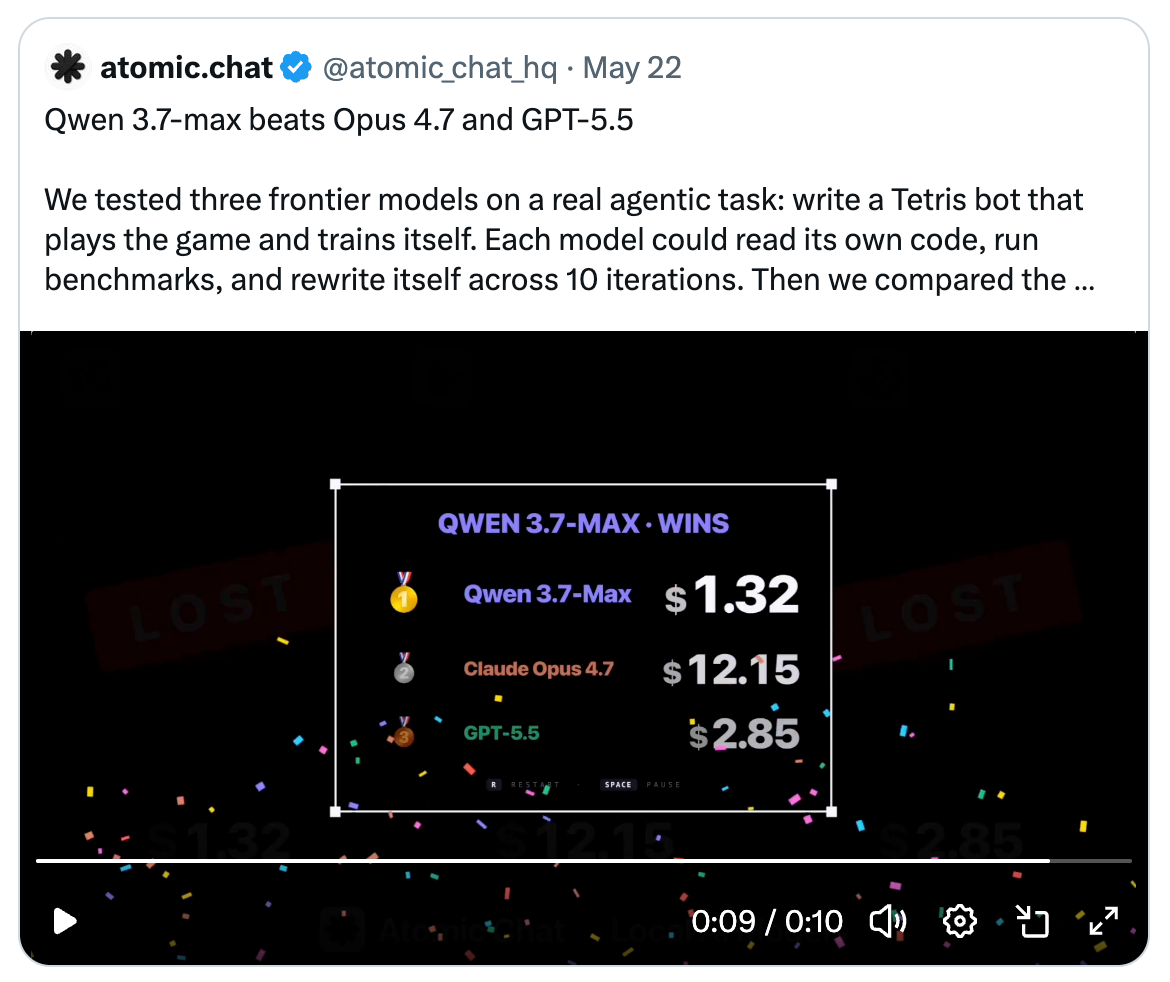
Di X, pengguna menemukan bahwa model ini sebanding dengan Opus 4.7 dan GPT 5.5 untuk tugas pengodean jangka panjang.
Kekuatan dan performa benchmark Qwen 3.7 Max
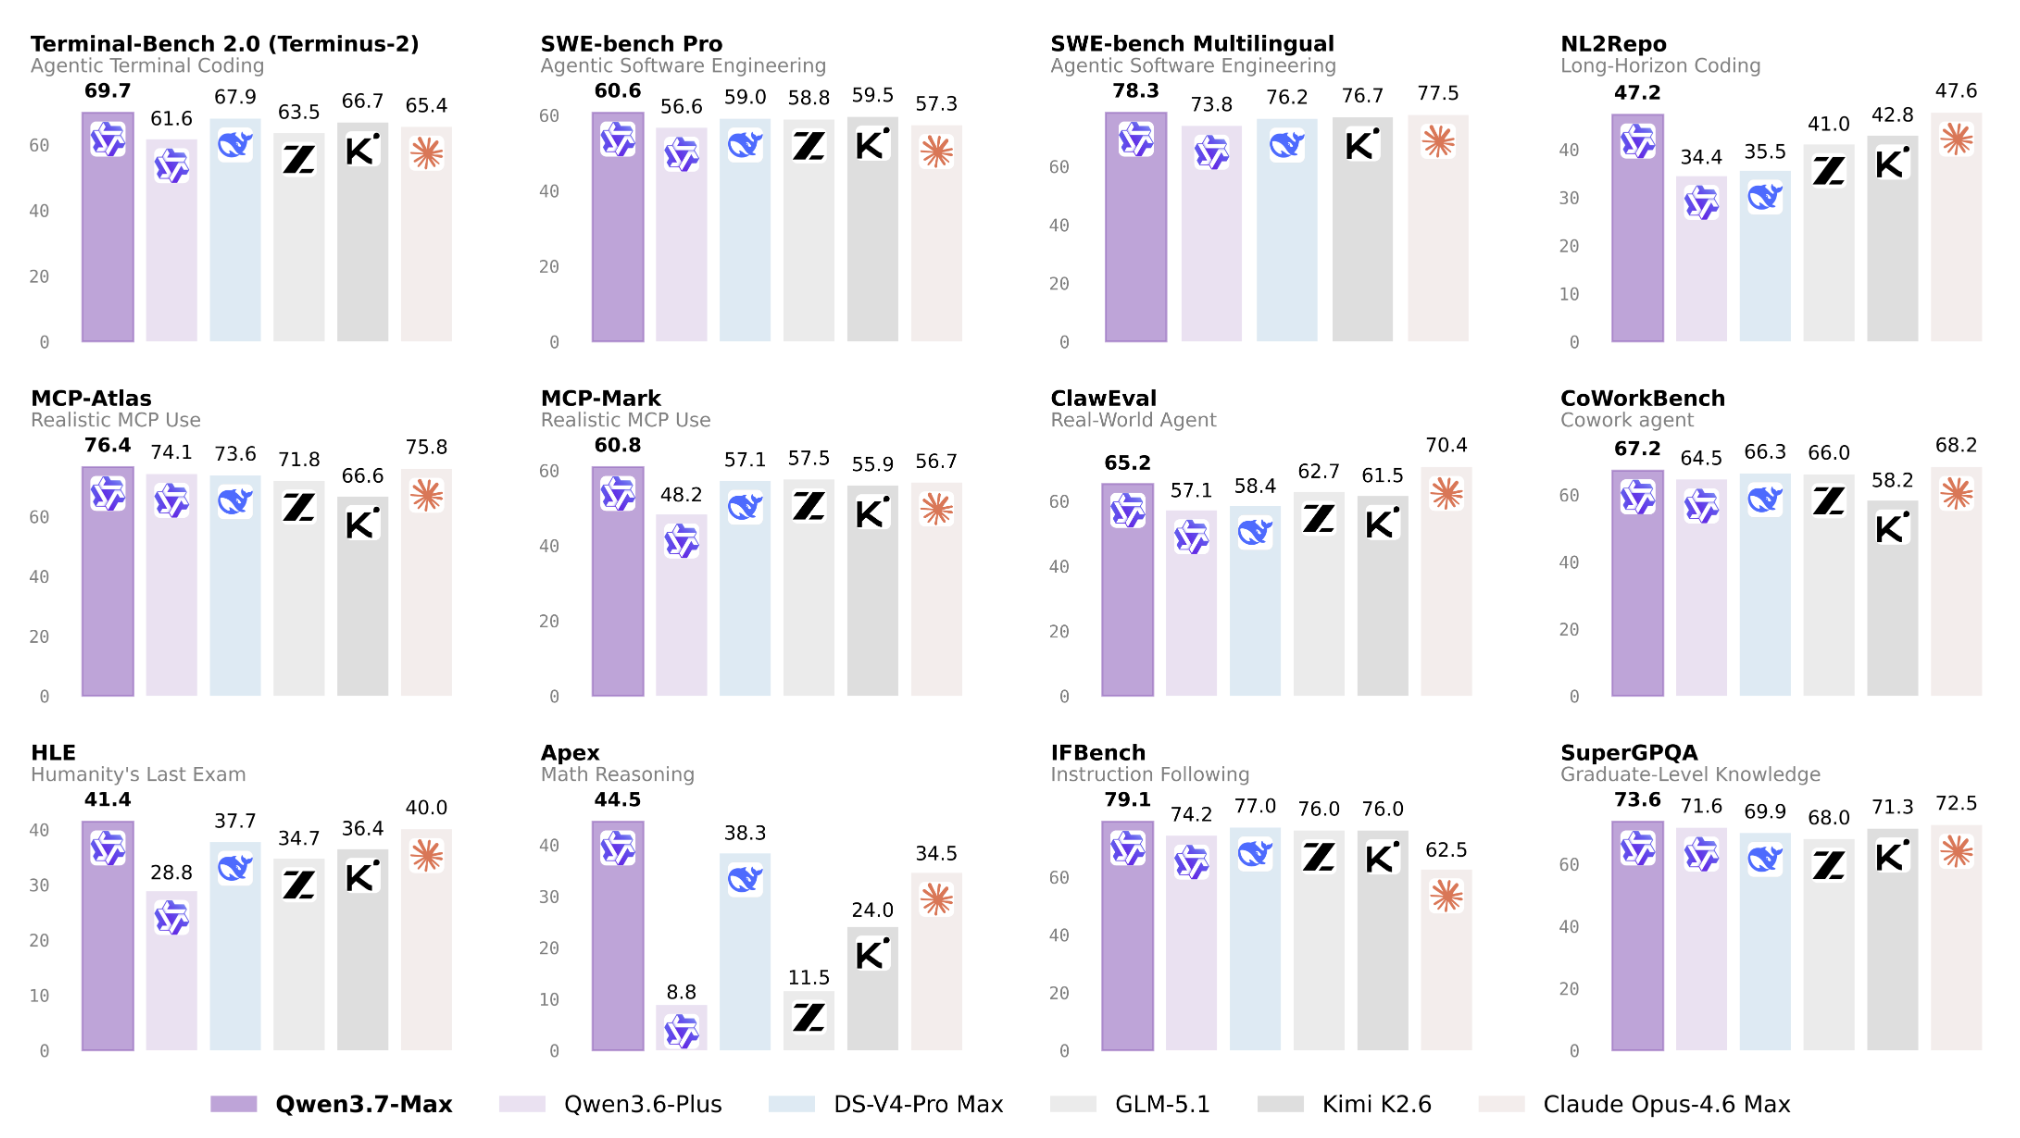
Qwen 3.7 Max tampil kuat di berbagai benchmark agen dan penalaran. Dalam evaluasi agen pengodean, model ini meraih
- 69,7 pada Terminal-Bench 2.0-Terminus
- 60,6 pada SWE-bench Pro
- 78,3 pada SWE-bench Multilingual
- 47,2 pada NL2Repo
- 53,5 pada SciCode
Dalam benchmark agen umum, model ini mencapai
- 60,8 pada MCP-Mark
- 76,4 pada MCP-Atlas
- 67,2 pada CoWorkBench
- 87,0 pada SpreadSheetBench-v1
Sumber: Blog pengembang Qwen
Agar Anda mendapat gambaran: semua hasil tersebut berada di atas skor DeepSeek V4 Pro; sebagian besar selisihnya tipis, tetapi untuk pengodean jangka panjang, ada celah cukup signifikan antara keduanya (47,2 vs 35,5 di NL2Repo).
Ini membawa kita ke salah satu contoh menonjol dari rilis tersebut: run optimasi kernel jangka panjang Qwen 3.7 Max. Qwen 3.7 Max dilaporkan berjalan sekitar 35 jam, melakukan 1.158 panggilan alat, menyelesaikan 432 evaluasi kernel, dan menghasilkan percepatan rata-rata geometri 10,0x dibanding implementasi referensi Triton.
Ini penting karena menunjukkan model dievaluasi pada perbaikan berbasis alat yang iteratif, bukan hanya pertanyaan benchmark statis.
Singkatnya, Qwen 3.7 Max sangat cocok untuk demo ini karena dibangun untuk alur kerja di mana model perlu bernalar, menggunakan alat, menjaga konteks, dan meningkatkan artefak dalam beberapa giliran.
Membangun Agen Produktivitas yang Menjaga Proses Berpikir dengan Qwen 3.7 Max
Dalam proyek ini, kami akan mendemonstrasikan tiga gagasan praktis:
- Permintaan pengguna yang samar dapat diubah menjadi alur kerja multi-langkah terstruktur.
- Keluaran alat dapat dimasukkan kembali ke proses penalaran alih-alih ditumpuk dalam satu prompt panjang.
- Model dapat membaca ulang dan meningkatkan outputnya sendiri melalui chain-of-thought prompting sebelum menyerahkan artefak akhir ke pengguna.
Gambaran proyek
Kita akan membangun aplikasi sederhana dengan satu kotak input dan satu tombol, dan pengguna memasukkan permintaan samar seperti:
I need to prepare a competitive analysis of the top 3 vector databases
for a team presentation next week. I have no idea where to start.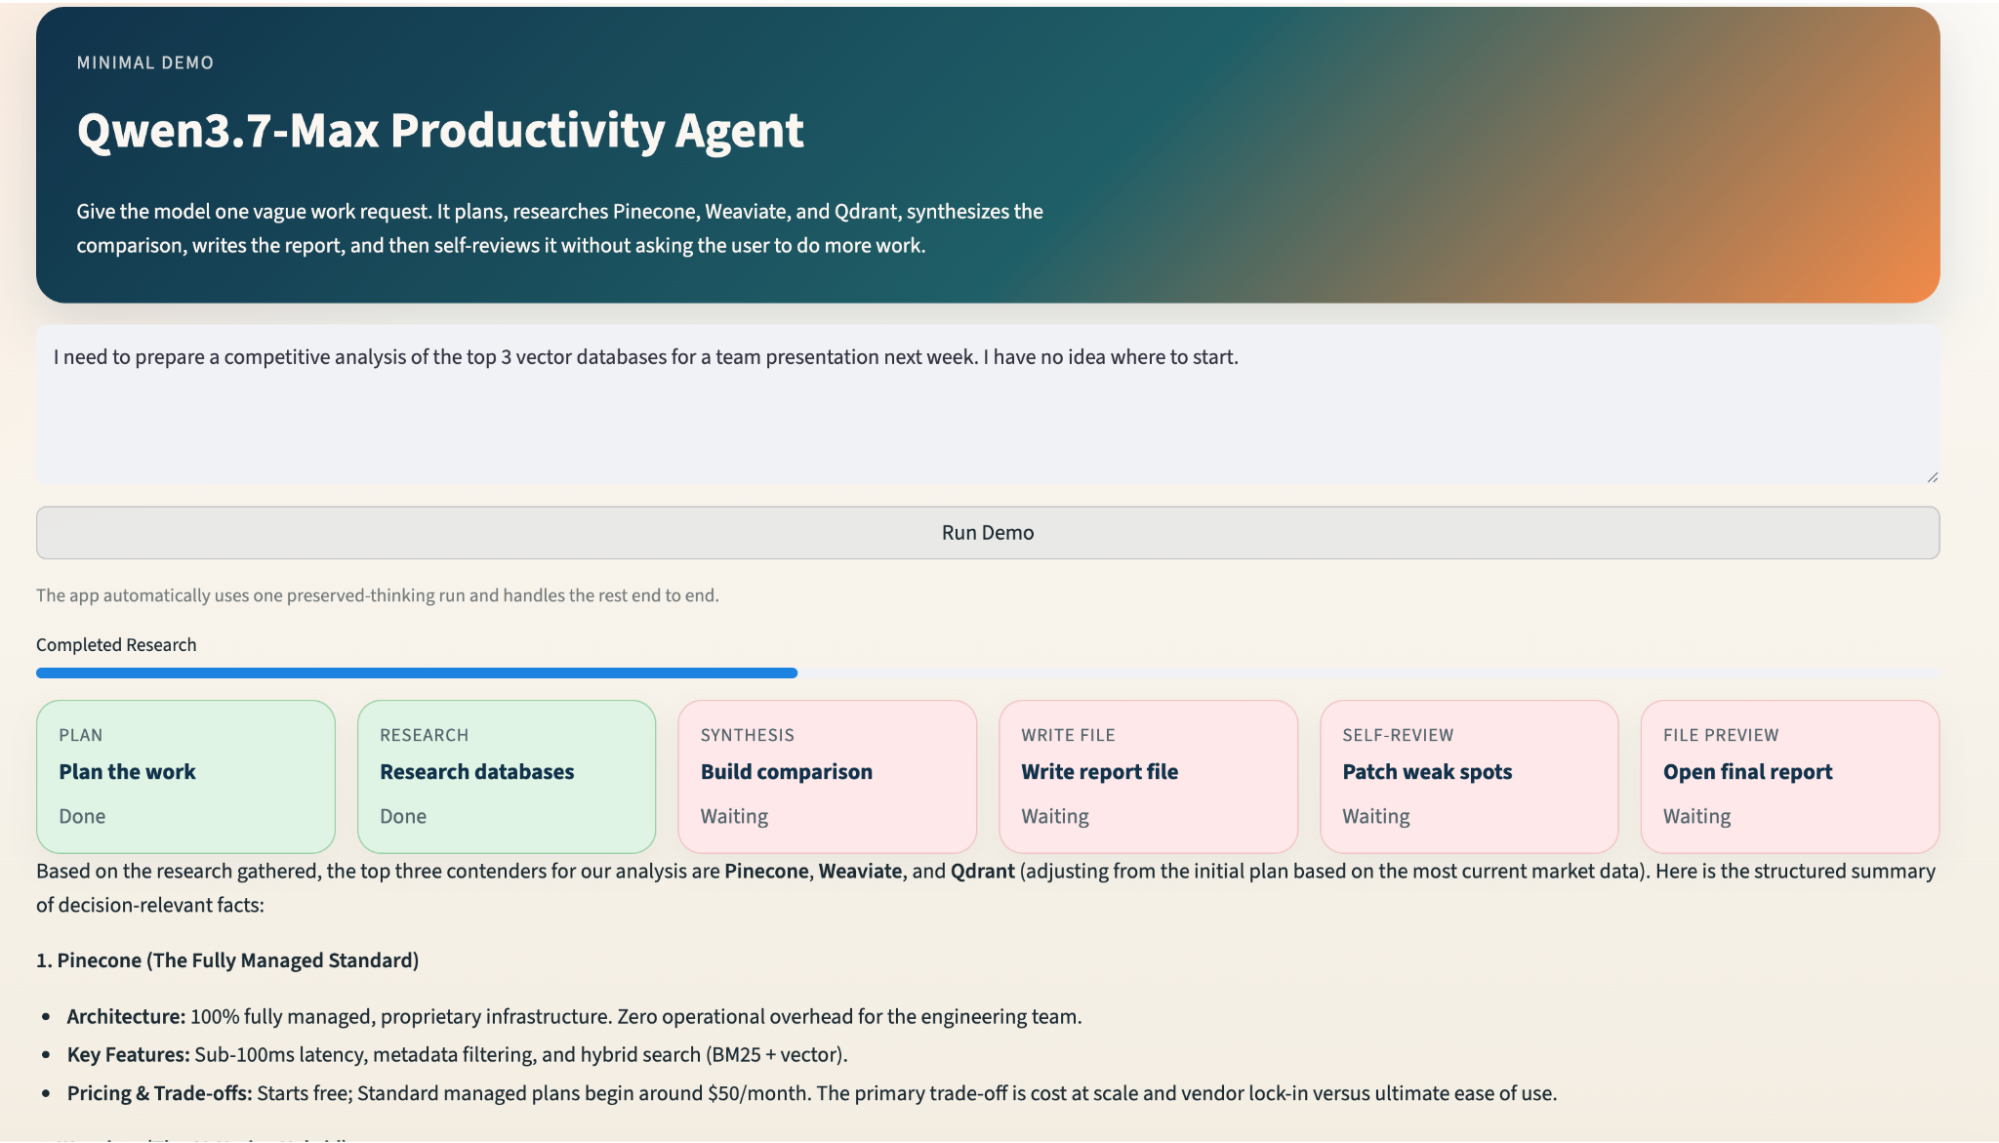
Lalu, agen menjalankan alur kerja lima giliran yang tetap:
User prompt
Turn 1: Plan the work
Parallel research for Pinecone, Weaviate, and Qdrant
Turn 2: Summarize research
Turn 3: Build comparison matrix
Turn 4: Write competitive_analysis.md
Turn 5: Self-review and patch the markdown file
Streamlit file previewUI menampilkan setiap langkah sebagai kartu progres. Saat alur kerja selesai, kartu berpindah dari menunggu menjadi selesai. Di akhir, pengguna dapat meninjau setiap tahap: perencanaan, riset, sintesis, draf, tinjauan diri, dan pratinjau berkas akhir.
Ini membuat alur kerja agen terlihat alih-alih menyembunyikan semuanya di balik satu respons chat.
Repo sengaja dibuat kecil. Komponen utamanya adalah:
-
thinking_agent.py: Berisi logika agen backend, seperti panggilan model, prompt, pelestarian proses berpikir, riset, percobaan ulang, penulisan berkas, dan tinjauan diri. -
agent.py: Berisi antarmuka Streamlit, termasuk tata letak halaman, kotak prompt, bilah progres, kartu langkah, pemilih hasil, pratinjau markdown, dan tombol unduh. -
requirements.txt: Berisi dependensi runtime yang diperlukan untuk demo
Backend berpusat pada kelas ThinkingAgent yang menjalankan urutan lima giliran tetap dan mengembalikan catatan giliran terstruktur. UI tidak perlu tahu bagaimana panggilan model, percobaan ulang, atau fanout riset bekerja. UI hanya perlu merender setiap giliran saat tiba.
Kode lengkap untuk tutorial ini tersedia di GitHub.
Catatan: Saya menggunakan OpenRouter untuk mengakses Qwen 3.7 Max, tetapi Anda juga dapat menggunakan model ini melalui Qwen API Platform resmi.
Langkah 1: Menyiapkan environment
Sebelum membangun agen produktivitas Qwen 3.7 Max, kita perlu menyiapkan environment Python kecil dengan Streamlit, klien yang kompatibel dengan OpenAI, dan httpx untuk penelusuran web ringan.
Dalam tutorial ini, kita akan menggunakan OpenRouter sebagai gerbang model, tetapi backend ditulis menggunakan format API yang kompatibel dengan OpenAI. Artinya, struktur yang sama dapat diadaptasi nanti untuk Alibaba Cloud Model Studio atau penyedia kompatibel lainnya.
Di langkah ini, kita akan:
-
Membuat virtual environment
-
Menginstal dependensi yang diperlukan
-
Menyetel
OPENROUTER_API_KEYatauQWEN_API_KEY -
Memastikan aplikasi dapat dijalankan dengan Streamlit
Buat dan aktifkan virtual environment:
python3 -m venv .venv
source .venv/bin/activateInstal dependensi proyek:
pip install -r requirements.txtBerkas requirements.txt sengaja dibuat ringkas:
httpx>=0.23.0
openai>=1.30.0
streamlit>=1.45.0Kami menggunakan streamlit untuk membangun antarmuka web interaktif, openai untuk memanggil Qwen 3.7 Max melalui API yang kompatibel dengan OpenAI, dan httpx untuk mengambil hasil penelusuran live yang ringan untuk langkah riset.
Langkah 2: Konfigurasikan klien Qwen 3.7 Max
Backend menggunakan OpenAI Python SDK karena OpenRouter mengekspos endpoint yang kompatibel dengan OpenAI. Berkas thinking_agent.py mendefinisikan beberapa nilai bawaan:
from openai import OpenAI
DEFAULT_MODEL = "qwen/qwen3.7-max"
DEFAULT_BASE_URL = "https://openrouter.ai/api/v1"
DEFAULT_REFERER = "https://qwen.ai"
DEFAULT_TITLE = "Qwen3.7-Max Productivity Agent"Lalu kita membuat klien:
def build_client(
api_key: str | None = None,
base_url: str | None = None,
referer: str = DEFAULT_REFERER,
title: str = DEFAULT_TITLE,
) -> OpenAI:
return OpenAI(
base_url=base_url or DEFAULT_BASE_URL,
api_key=api_key,
default_headers={
"HTTP-Referer": referer,
"X-Title": title,
},
)Fungsi build_client() memusatkan semua konfigurasi spesifik penyedia. Sisa aplikasi tidak perlu tahu apakah permintaan melalui OpenRouter, Alibaba Cloud Model Studio, atau endpoint kompatibel lainnya.
Setelah klien dikonfigurasi, backend dapat memanggil Qwen 3.7 Max menggunakan format chat completions standar.
Sekarang, kita akan membangun alur kerja inti ThinkingAgent.
Langkah 3: Alur kerja agen lima giliran
Setelah klien model dikonfigurasi, kita dapat mendefinisikan alur kerja backend inti. Alih-alih meminta Qwen 3.7 Max menghasilkan laporan lengkap sekaligus, kita membagi tugas menjadi lima tahap terkontrol.
-
Perencanaan: Mengubah prompt yang samar menjadi rencana tugas terstruktur.
-
Riset: Mengumpulkan dan meringkas bukti dari cuplikan eksternal.
-
Sintesis: Membangun matriks perbandingan dari hasil riset.
-
Draf: Menulis laporan
competitive_analysis.mdpertama. -
Tinjauan diri: Meninjau dan menambal laporan sebelum mengembalikan berkas final.
class ThinkingAgent:
def run(
self,
goal: str,
preserve_thinking: bool = True,
data_mode: str = "live",
on_turn: Callable[[TurnRecord], None] | None = None,
) -> ThinkingRunResult:
history = [{"role": "system", "content": SYSTEM_PROMPT}]
turns = []
backend = self._build_search_backend(data_mode)
turn1 = self._run_turn(
history=history,
turn_index=1,
phase="planning",
user_prompt=_planning_prompt(goal),
preserve_thinking=preserve_thinking,
)
search_results = self._run_research(backend)
turn2 = self._run_turn(
history=history,
turn_index=2,
phase="research",
user_prompt=_research_prompt(goal, search_results),
preserve_thinking=preserve_thinking,
)
turn3 = self._run_turn(
history=history,
turn_index=3,
phase="synthesis",
user_prompt=_synthesis_prompt(),
preserve_thinking=preserve_thinking,
)
turn4 = self._run_turn(
history=history,
turn_index=4,
phase="draft",
user_prompt=_draft_prompt(goal),
preserve_thinking=preserve_thinking,
)
turn5 = self._run_turn(
history=history,
turn_index=5,
phase="self_review",
user_prompt=_self_review_prompt(draft_markdown),
preserve_thinking=preserve_thinking,
)Metode run() adalah loop orkestrasi utama. Metode ini dimulai dengan system prompt, membuat riwayat percakapan, membangun backend riset, lalu mengeksekusi lima giliran satu per satu.
Setiap pemanggilan _run_turn() memiliki fase spesifik. Ini membuat alur kerja lebih mudah di-debug karena setiap panggilan model memiliki satu tanggung jawab jelas. Giliran perencanaan menyusun rencana. Giliran riset menafsirkan cuplikan eksternal. Giliran sintesis membangun struktur. Giliran draf menulis. Giliran tinjauan diri meningkatkan output.
Langkah riset ditempatkan antara Giliran 1 dan Giliran 2 karena model perlu memahami tugas terlebih dahulu sebelum informasi eksternal dimasukkan ke alur kerja.
Di langkah berikutnya, kita akan menambahkan logika pelestarian proses berpikir spesifik Qwen yang membantu model menjaga kontinuitas di seluruh giliran ini.
Langkah 4: Melestarikan proses berpikir antar giliran
Alasan utama kami menggunakan Qwen 3.7 Max dalam demo ini adalah dukungannya untuk alur kerja yang melestarikan proses berpikir. Agen tidak memperlakukan setiap panggilan model sebagai prompt terisolasi. Sebaliknya, agen dapat melestarikan penalaran dari giliran sebelumnya dan meneruskan konteks tersebut ke giliran berikutnya.
Di langkah ini, kita akan:
- Mengaktifkan proses berpikir model.
- Melestarikan penalaran antar giliran.
- Menambahkan kembali keluaran asisten ke riwayat bersama.
response = self.client.chat.completions.create(
model=self.config.model,
messages=request_messages,
extra_body={
"enable_thinking": True,
"preserve_thinking": preserve_thinking,
},
)Flag enable_thinking=True memungkinkan Qwen 3.7 Max menghasilkan konten penalaran selama respons. Sementara flag preserve_thinking mengontrol apakah konten penalaran tersebut harus dipertahankan di giliran selanjutnya.
Setelah model merespons, backend mengekstrak jawaban yang terlihat dan konten penalaran:
message = response.choices[0].message
assistant_content = _normalize_text(getattr(message, "content", ""))
reasoning_content = _extract_reasoning_content(message)
The visible answer is what the app can show to the user. The reasoning content is used internally to help the next turn stay aligned with the earlier plan.
Then the backend appends the assistant message back into the conversation history:
```python
assistant_message = {
"role": "assistant",
"content": assistant_content,
}
if preserve_thinking and reasoning_content:
assistant_message["reasoning_content"] = reasoning_content
history.append(assistant_message)Jika giliran perencanaan memutuskan bahwa laporan akhir harus membandingkan database vektor berdasarkan model deployment, skalabilitas, pengalaman pengembang, hybrid search, dan kesiapan enterprise, giliran berikutnya dapat terus menggunakan kriteria tersebut. Tanpa ini, setiap giliran bisa melenceng. Langkah sintesis mungkin memilih kriteria berbeda dari langkah perencanaan, atau langkah tinjauan diri mungkin mengevaluasi laporan berdasarkan tujuan yang berbeda.
Selanjutnya, kita akan menambahkan lapisan riset yang memberi agen konteks eksternal sebelum menulis laporan.
Langkah 5: Tambahkan riset paralel dengan data fallback
Sebelum model menulis analisis kompetitif, model memerlukan konteks eksternal. Dalam demo ini, kami membatasi cakupan riset dengan membandingkan tiga database vektor: Pinecone, Weaviate, dan Qdrant.
Di langkah ini, kita akan:
- Menetapkan target database.
- Menjalankan panggilan riset secara paralel.
- Jatuh kembali ke data fixture deterministik jika penelusuran live gagal.
DATABASES = ("Pinecone", "Weaviate", "Qdrant")Daftar target sengaja dibuat tetap. Ini menjaga demo stabil dan mudah dijelaskan. Nanti, Anda bisa memperluas proyek agar model memilih target perbandingan secara dinamis.
Berikutnya, backend meluncurkan panggilan riset secara paralel:
from concurrent.futures import ThreadPoolExecutor, as_completed
with ThreadPoolExecutor(max_workers=3) as executor:
future_map = {
executor.submit(backend.search, database, query): database
for database, query in queries.items()
}
for future in as_completed(future_map):
database = future_map[future]
results[database] = future.result()ThreadPoolExecutor memulai satu penelusuran per database. Ini lebih cepat dibanding menjalankan penelusuran secara berurutan karena riset untuk Pinecone, Weaviate, dan Qdrant dapat berjalan paralel.
try:
results[database] = future.result()
except Exception as exc:
fallback = FixtureSearchBackend().search(database, queries[database])
fallback.warning = (
f"Live search failed for {database} ({exc}). "
"Fallback demo research was used."
)
results[database] = fallbackJika penelusuran live berhasil, agen menggunakan cuplikan terbaru. Jika gagal, aplikasi tetap menyelesaikan alur kerja menggunakan cuplikan riset deterministik bawaan. Prinsip desain pentingnya adalah penurunan yang mulus. Agen tidak boleh crash hanya karena satu dependensi eksternal gagal.
Di langkah berikutnya, kita akan memasukkan hasil riset ini ke Qwen 3.7 Max agar dapat menyintesis matriks perbandingan.
Langkah 6: Hasilkan sintesis dan matriks perbandingan
Setelah agen memiliki cuplikan riset, tugas berikutnya adalah sintesis. Langkah ini mengubah informasi yang tersebar menjadi perbandingan terstruktur yang dapat mendukung laporan akhir.
Di langkah ini, kita akan:
- Mengirim konteks riset kembali ke Qwen 3.7 Max.
- Meminta model membuat perbandingan terstruktur.
- Merender output tersebut di antarmuka Streamlit nanti.
turn3 = self._run_turn(
history=history,
turn_index=3,
phase="synthesis",
user_prompt=_synthesis_prompt(),
preserve_thinking=preserve_thinking,
)Saat kode ini berjalan, riwayat percakapan sudah berisi permintaan awal pengguna, keluaran perencanaan, ringkasan riset, dan opsional proses berpikir yang dilestarikan dari giliran sebelumnya.
Ini berarti prompt sintesis tidak perlu mengulang seluruh tugas. Prompt dapat fokus pada satu pekerjaan, yaitu mengonversi riset menjadi matriks perbandingan yang siap untuk pengambilan keputusan.
Sintesis yang baik harus membandingkan opsi di berbagai dimensi seperti:
- Model deployment
- Skalabilitas
- Pengalaman pengembang
- Dukungan hybrid search
- Kesiapan enterprise
- Use case paling cocok
Selanjutnya, kita akan menggunakan struktur tersintesis ini untuk menulis laporan Markdown pertama.
Langkah 7: Tulis laporan markdown
Setelah perencanaan, riset, dan sintesis, agen memiliki cukup konteks untuk menulis deliverable lengkap pertama. Dalam demo ini, deliverable-nya adalah berkas markdown bernama competitive_analysis.md.
Di langkah ini, kita akan:
- Meminta Qwen 3.7 Max menulis draf laporan pertama.
- Menghapus pagar kode markdown yang tidak perlu.
- Menyimpan draf ke disk.
- Mencatat aksi penulisan berkas sebagai event alat.
turn4 = self._run_turn(
history=history,
turn_index=4,
phase="draft",
user_prompt=_draft_prompt(goal),
preserve_thinking=preserve_thinking,
)Giliran draf menggunakan semua konteks sebelumnya, termasuk tujuan awal pengguna, rencana, riset, dan matriks sintesis.
Respons model kemudian dibersihkan dan ditulis ke disk:
draft_markdown = _strip_markdown_fences(turn4.assistant_content)
report_path = run_output_dir / "competitive_analysis.md"
report_path.write_text(draft_markdown)Helper _strip_markdown_fences() berguna karena model sering membungkus output markdown di dalam tiga backtick. Itu baik untuk respons chat, tetapi tidak ideal saat menulis langsung ke berkas .md.
Backend juga mencatat aksi penulisan:
turn4.tool_events.append(
ToolEvent(
name="write_file",
status="completed",
input_payload={"path": str(report_path)},
output_payload={
"description": "Initial draft written to disk.",
},
)
)Event alat ini membantu UI menunjukkan bahwa backend membuat berkas nyata, bukan sekadar respons teks lain. Pada tahap ini, aplikasi sudah memiliki laporan yang dapat digunakan. Namun kita menambahkan satu giliran model lagi untuk meningkatkan kualitas sebelum menampilkan artefak final.
Di langkah berikutnya, kita akan meminta Qwen 3.7 Max untuk meninjau dan menambal drafnya sendiri.
Langkah 8: Tinjau diri dan tambal laporan
Giliran model terakhir adalah langkah tinjauan diri. Alih-alih langsung menyerahkan draf pertama ke pengguna, agen membaca ulang laporan, memeriksanya terhadap tujuan awal, dan menulis versi yang ditingkatkan.
Di langkah ini, kita akan:
- Mengirim draf markdown kembali ke model.
- Meminta model mengidentifikasi kelemahan.
- Menghasilkan versi revisi.
- Menimpa laporan dengan versi final yang ditingkatkan.
turn5 = self._run_turn(
history=history,
turn_index=5,
phase="self_review",
user_prompt=_self_review_prompt(draft_markdown),
preserve_thinking=preserve_thinking,
)Prompt tinjauan diri meminta model memeriksa isu praktis, seperti apakah rekomendasi jelas, apakah kriteria perbandingan konsisten, dan apakah laporan berguna untuk presentasi tim.
Output yang direvisi ditulis kembali ke berkas yang sama:
final_markdown = _strip_markdown_fences(turn5.assistant_content)
report_path.write_text(final_markdown)Agen juga dapat mencatat event penulisan final:
turn5.tool_events.append(
ToolEvent(
name="write_file",
status="completed",
input_payload={"path": str(report_path)},
output_payload={
"description": "Self-reviewed final report written to disk.",
},
)
)Langkah ini mengubah aplikasi dari generator sederhana menjadi alur editorial kecil. Output yang dilihat pengguna bukanlah draf pertama; melainkan versi yang telah ditinjau dan ditambal.
Selanjutnya, kita akan menghubungkan alur kerja backend ini ke aplikasi Streamlit.
Langkah 9: Bangun antarmuka progres Streamlit
Sekarang kita beralih dari logika backend ke antarmuka pengguna. Aplikasi Streamlit harus memungkinkan pengguna memasukkan prompt, menjalankan alur kerja, dan menyaksikan setiap tahap selesai.
Catatan: Kode ini berada di berkas agent.py karena mengontrol apa yang dilihat dan diklik pengguna.
Di langkah ini, kita akan:
-
Konfigurasi halaman Streamlit.
-
Membuat input prompt.
-
Menambahkan tombol jalankan.
-
Memanggil fungsi
ThinkingAgent.run(). -
Memperbarui UI saat giliran selesai.
def render_streamlit_app() -> None:
st.set_page_config(
page_title="Qwen3.7-Max Demo Agent",
page_icon=":material/psychology:",
layout="wide",
initial_sidebar_state="collapsed",
)Aplikasi menggunakan tata letak lebar karena UI mencakup kartu langkah, indikator progres, dan panel hasil.
Area inputnya sederhana:
goal = st.text_area(
"Prompt",
value=DEFAULT_GOAL,
height=120,
label_visibility="collapsed",
)
run_clicked = st.button("Run Demo", use_container_width=True)Pengguna hanya perlu memberikan tugas. Aplikasi tidak meminta mereka mengonfigurasi temperature, mode penelusuran, ID model, atau pengaturan penalaran. Detail tersebut ditangani oleh backend.
Saat pengguna mengklik tombol, agent.py membuat agen backend dan menjalankannya:
agent = ThinkingAgent(config=config)
result = agent.run(
goal=goal,
preserve_thinking=True,
data_mode="live",
on_turn=on_turn,
)Di sinilah kedua berkas bertemu. agent.py memicu alur kerja, tetapi thinking_agent.py memiliki perilaku agen sebenarnya. Callback UI memperbarui halaman setelah setiap giliran:
def on_turn(turn: TurnRecord) -> None:
partial_turns.append(turn)
progress_placeholder.progress(
len(partial_turns) / len(phase_order),
text=f"Completed {_phase_label(turn.phase)}",
)
with steps_placeholder.container():
_render_step_cards(partial_turns, result_ready=False)Callback menerima satu TurnRecord yang telah selesai dan menyegarkan bilah progres serta kartu langkah. Selama eksekusi, kartu berfungsi sebagai indikator status. Setelah selesai, kartu menjadi tampilan hasil yang dapat diklik.
Sekarang, kita akan merender laporan markdown final dan menyediakannya sebagai berkas yang dapat diunduh.
Langkah 10: Pratinjau dan unduh laporan final
Setelah backend selesai, UI perlu menampilkan laporan final. Backend sudah membuat berkas markdown, jadi agent.py hanya perlu membacanya, merendernya, dan menyediakan tombol unduh.
Di langkah ini, kita akan:
- Memeriksa apakah berkas laporan ada.
- Membaca konten markdown final.
- Menampilkan tombol unduh.
- Merender markdown di aplikasi Streamlit
def _render_file_preview(report_path: str) -> None:
path = Path(report_path)
if not path.exists():
st.info("No file was written yet.")
return
content = path.read_text()
st.caption(f"Created file: {path.name}")
st.download_button(
"Download competitive_analysis.md",
data=content,
file_name=path.name,
use_container_width=True,
)
st.markdown(content)Fungsi dimulai dengan memeriksa apakah berkas ada. Ini mencegah aplikasi crash jika backend gagal sebelum menulis laporan. Lalu fungsi membaca konten markdown dan membuat tombol unduh. Terakhir, fungsi merender markdown langsung di halaman Streamlit.
Ini adalah pemisahan tanggung jawab yang jelas di mana:
-
thinking_agent.pymenulis laporan -
agent.pymelakukan pratinjau dan mengunduh laporan
Di langkah berikutnya, kita akan menambahkan penanganan error dasar agar demo berperilaku lebih baik saat rute penyedia gagal atau terjadi pembatasan laju.
Langkah 11: Penanganan error dan rate limit
Penyedia model dapat timeout, mengembalikan kegagalan sementara, atau membatasi laju permintaan. Jika kita menampilkan error mentah tersebut langsung ke pengguna, aplikasi terasa belum selesai.
Langkah ini dibagi di kedua berkas. Logika retry berada di thinking_agent.py karena merupakan bagian dari panggilan model backend. Pesan error berada di agent.py karena mengontrol apa yang dilihat pengguna.
Di langkah ini, kita akan:
- Mengulang percobaan untuk kegagalan penyedia sementara di backend.
- Mendeteksi error mirip rate limit.
- Menampilkan pesan yang lebih bersih di UI Streamlit
delays = (1.0, 2.0)
for attempt_index in range(len(delays) + 1):
try:
return self.client.chat.completions.create(...)
except Exception as exc:
if not _is_retryable_provider_error(exc):
raise
if attempt_index >= len(delays):
raise
time.sleep(delays[attempt_index])Backend mencoba melakukan panggilan model, menangkap kegagalan yang dapat diulang, menunggu sebentar, dan mencoba lagi. Penundaan singkat sudah cukup untuk meredam ketidakstabilan sementara penyedia tanpa membuat pengguna menunggu terlalu lama.
def _friendly_rate_limit_message(exc: Any) -> str:
return (
"Qwen 3.7 Max is temporarily rate-limited upstream. "
"Please wait 30 to 60 seconds and try again."
)Ini menjaga JSON penyedia mentah atau stack trace tetap keluar dari UI. Pengguna mendapatkan penjelasan yang jelas dan langkah praktis berikutnya.
Dengan langkah terakhir ini, kini kita dapat menjalankan aplikasi lengkap dan menguji alur kerja end-to-end.
Langkah 12: Jalankan demo
Sekarang alur kerja backend dan antarmuka Streamlit sudah terhubung, kita dapat menjalankan aplikasi lengkap.
Di langkah ini, kita akan:
- Menjalankan aplikasi Streamlit.
- Memasukkan prompt produktivitas bawaan.
- Menjalankan alur kerja lima tahap.
- Pratinjau dan unduh laporan markdown final
Jalankan aplikasi:
streamlit run agent.pyGunakan prompt bawaan:
I need to prepare a competitive analysis of the top 3 vector databases
for a team presentation next week. I have no idea where to start.Saat Anda mengklik Run Demo, aplikasi akan bergerak melalui alur kerja lengkap:
-
Perencanaan: Membuat rencana terstruktur.
-
Riset: Mengumpulkan cuplikan untuk Pinecone, Weaviate, dan Qdrant.
-
Sintesis: Membangun matriks perbandingan.
-
Draf: Menulis laporan markdown pertama.
-
Tinjauan diri: Menambal laporan.
-
Pratinjau: Menampilkan berkas
competitive_analysis.mdfinal.
Laporan akhir disimpan di:
output/showcase_runs/<timestamp>/with_preserve/competitive_analysis.md
Pada akhirnya, Anda akan melihat pratinjau laporan dan tombol unduh di antarmuka Streamlit.
Kesimpulan
Dalam tutorial ini, kami membangun agen produktivitas ringkas dengan Qwen 3.7 Max yang menjalankan alur kerja tetap dan dapat ditafsirkan dari perencanaan, riset, sintesis, penulisan, hingga tinjauan diri. Sepanjang proses, ini menunjukkan mengapa melestarikan penalaran antar giliran dapat berguna untuk tugas agen bentuk panjang.
Versi saat ini hanya menggunakan Streamlit, panggilan model yang kompatibel dengan OpenAI, lapisan penelusuran ringan, dan output Markdown. Itu membuatnya mudah dipelajari, dimodifikasi, dan digunakan kembali dalam eksperimen Anda sendiri.
Ada banyak pengembangan alami dari sini:
-
Biarkan model memilih target perbandingan alih-alih menggunakan daftar tetap
-
tambahkan run berdampingan “dengan
preserve_thinking” vs “tanpapreserve_thinking” -
Tampilkan penggunaan token dan estimasi biaya di UI
-
menghasilkan kerangka slide atau bagan bersamaan dengan laporan markdown
-
Ganti scraping DuckDuckGo dengan API penelusuran yang lebih andal
Jika Anda ingin melampaui alur kerja tetap dan belajar cara membangun aplikasi AI siap produksi dari prompt engineering hingga RAG sampai sistem agentic, jalur keterampilan AI Engineering with LangChain kami adalah langkah berikut yang baik.
FAQ Tutorial API Qwen 3.7 Max
Kapan saya harus menggunakan preserve_thinking=True dengan Qwen 3.7 Max?
preserve_thinking=True membantu giliran-giliran berikutnya tetap selaras dengan keputusan sebelumnya dalam alur kerja multi-giliran. Dalam contoh kami, jika giliran perencanaan memilih kriteria perbandingan tertentu, giliran sintesis dan tinjauan diri dapat terus menggunakan penalaran yang sama alih-alih melenceng.
Apakah Qwen 3.7 Max hanya untuk agen pengodean?
Tidak. Pengodean adalah salah satu kekuatan utamanya, tetapi model ini juga diposisikan untuk agen produktivitas, automasi perkantoran, alur kerja berbasis MCP, tugas multibahasa, penalaran konteks panjang, dan penggunaan alat jangka panjang.
Apakah aplikasi demo menggunakan penelusuran web nyata?
Ya, jalur bawaan saat ini mencoba scraping DuckDuckGo secara live. Jika itu gagal, aplikasi kembali menggunakan riset fixture bawaan.
Apakah model membuat subagen dalam aplikasi demo kita?
Tidak. Aplikasi menggunakan satu sesi model. Bagian “paralel” terjadi di lapisan riset, di mana backend meluncurkan tiga penelusuran web secara bersamaan dan memasukkan hasilnya kembali ke sesi model yang sama.
Mengapa kami memisahkan agent.py dan thinking_agent.py?
agent.py menjaga UI Streamlit tetap mudah dibaca. thinking_agent.py menyimpan alur kerja backend, penyusunan prompt, percobaan ulang, dan logika riset agar perilaku agen dapat diuji secara independen dari antarmuka.

Saya adalah Google Developers Expert di ML (Gen AI), Kaggle 3x Expert, dan Women Techmakers Ambassador dengan pengalaman lebih dari 3 tahun di bidang teknologi. Saya ikut mendirikan startup health-tech pada 2020 dan sedang menempuh studi magister ilmu komputer di Georgia Tech dengan spesialisasi machine learning.



Sebagian besar demo AI masih terlihat seperti chatbot: Anda mengajukan pertanyaan, model menjawab, dan interaksi berakhir. Namun, pekerjaan produktivitas nyata biasanya tidak terjadi dalam satu langkah. Asisten yang berguna perlu menguraikan permintaan yang samar, mengumpulkan konteks, membandingkan opsi, menghasilkan artefak yang dapat digunakan, lalu memeriksa pekerjaannya sendiri sebelum mengembalikannya.
Qwen 3.7 Max adalah model agentic dari tim Qwen, dirancang untuk beban kerja berfokus agen, termasuk pengodean, tugas produktivitas perkantoran, dan eksekusi jangka panjang. Ini adalah model berorientasi agen yang dirancang bukan hanya untuk menjawab satu prompt dengan baik, tetapi untuk tetap koheren di seluruh alur kerja yang lebih panjang yang melibatkan perencanaan, penggunaan alat, penulisan, dan koreksi diri.
Dalam tutorial ini, kita akan membangun agen produktivitas ringkas menggunakan Qwen 3.7 Max dan Streamlit. Aplikasi ini menerima permintaan bisnis yang samar, seperti menyiapkan analisis kompetitif tentang database vektor, dan mengubahnya menjadi berkas
competitive_analysis.mdyang rapi.Di akhir tutorial ini, Anda akan memahami cara:
Membangun alur kerja agen lima giliran yang tetap
Menggunakan
enable_thinking=Truedanpreserve_thinking=TrueMenambahkan riset paralel yang ringan
Menulis dan menambal artefak markdown
Membuat UI Streamlit sederhana di sekitar alur kerja
Kode lengkap tersedia di repositori GitHub.
Proyek ini sengaja dibuat kecil, dengan logika utama dibagi ke
agent.pyuntuk aplikasi Streamlit danthinking_agent.pyuntuk alur kerja backend.Jika Anda baru dalam AI agentic, saya sarankan mulai dengan jalur keterampilan AI Agent Fundamentals kami.