

Wat is Qwen 3.7 Max?
Qwen 3.7 Max is Alibaba’s nieuwe vlaggenschipmodel, uitgebracht op 20 mei 2026. Het is gebouwd voor agentische workflows. Dat betekent dat het niet alleen is ontworpen voor one-shot chat, maar geoptimaliseerd is voor taken die planning, toolgebruik, coderen, kantoorautomatisering, redeneren met lange context en meerstapsuitvoering vereisen.
Het Qwen-team beschrijft het als een model voor het “agententijdperk”, met sterke punten bij codeeragents, productiviteitsassistenten, MCP-gebaseerde workflows en autonome taken over een lange horizon.
Het interessante aan dit model is niet alleen de ruwe benchmarkprestatie, maar het vermogen om consistent te blijven tijdens een taak met meerdere beurten, waarbij elke beurt een ander doel heeft, waaronder:
- planning
- evidentiesynthese
- schrijven van lange teksten
- zelfkritiek
- revisie
Op X merkten gebruikers op dat het model op één lijn ligt met Opus 4.7 en GPT 5.5 voor long-horizon coderingstaken.
Sterke punten en benchmarkprestaties van Qwen 3.7 Max
Qwen 3.7 Max presteert sterk op agent- en redeneerbenchmarks. In evaluaties van codeeragents scoort het
- 69,7 op Terminal-Bench 2.0-Terminus
- 60,6 op SWE-bench Pro
- 78,3 op SWE-bench Multilingual
- 47,2 op NL2Repo
- 53,5 op SciCode
Op algemene agent-benchmarks haalt het
- 60,8 op MCP-Mark
- 76,4 op MCP-Atlas
- 67,2 op CoWorkBench
- 87,0 op SpreadSheetBench-v1
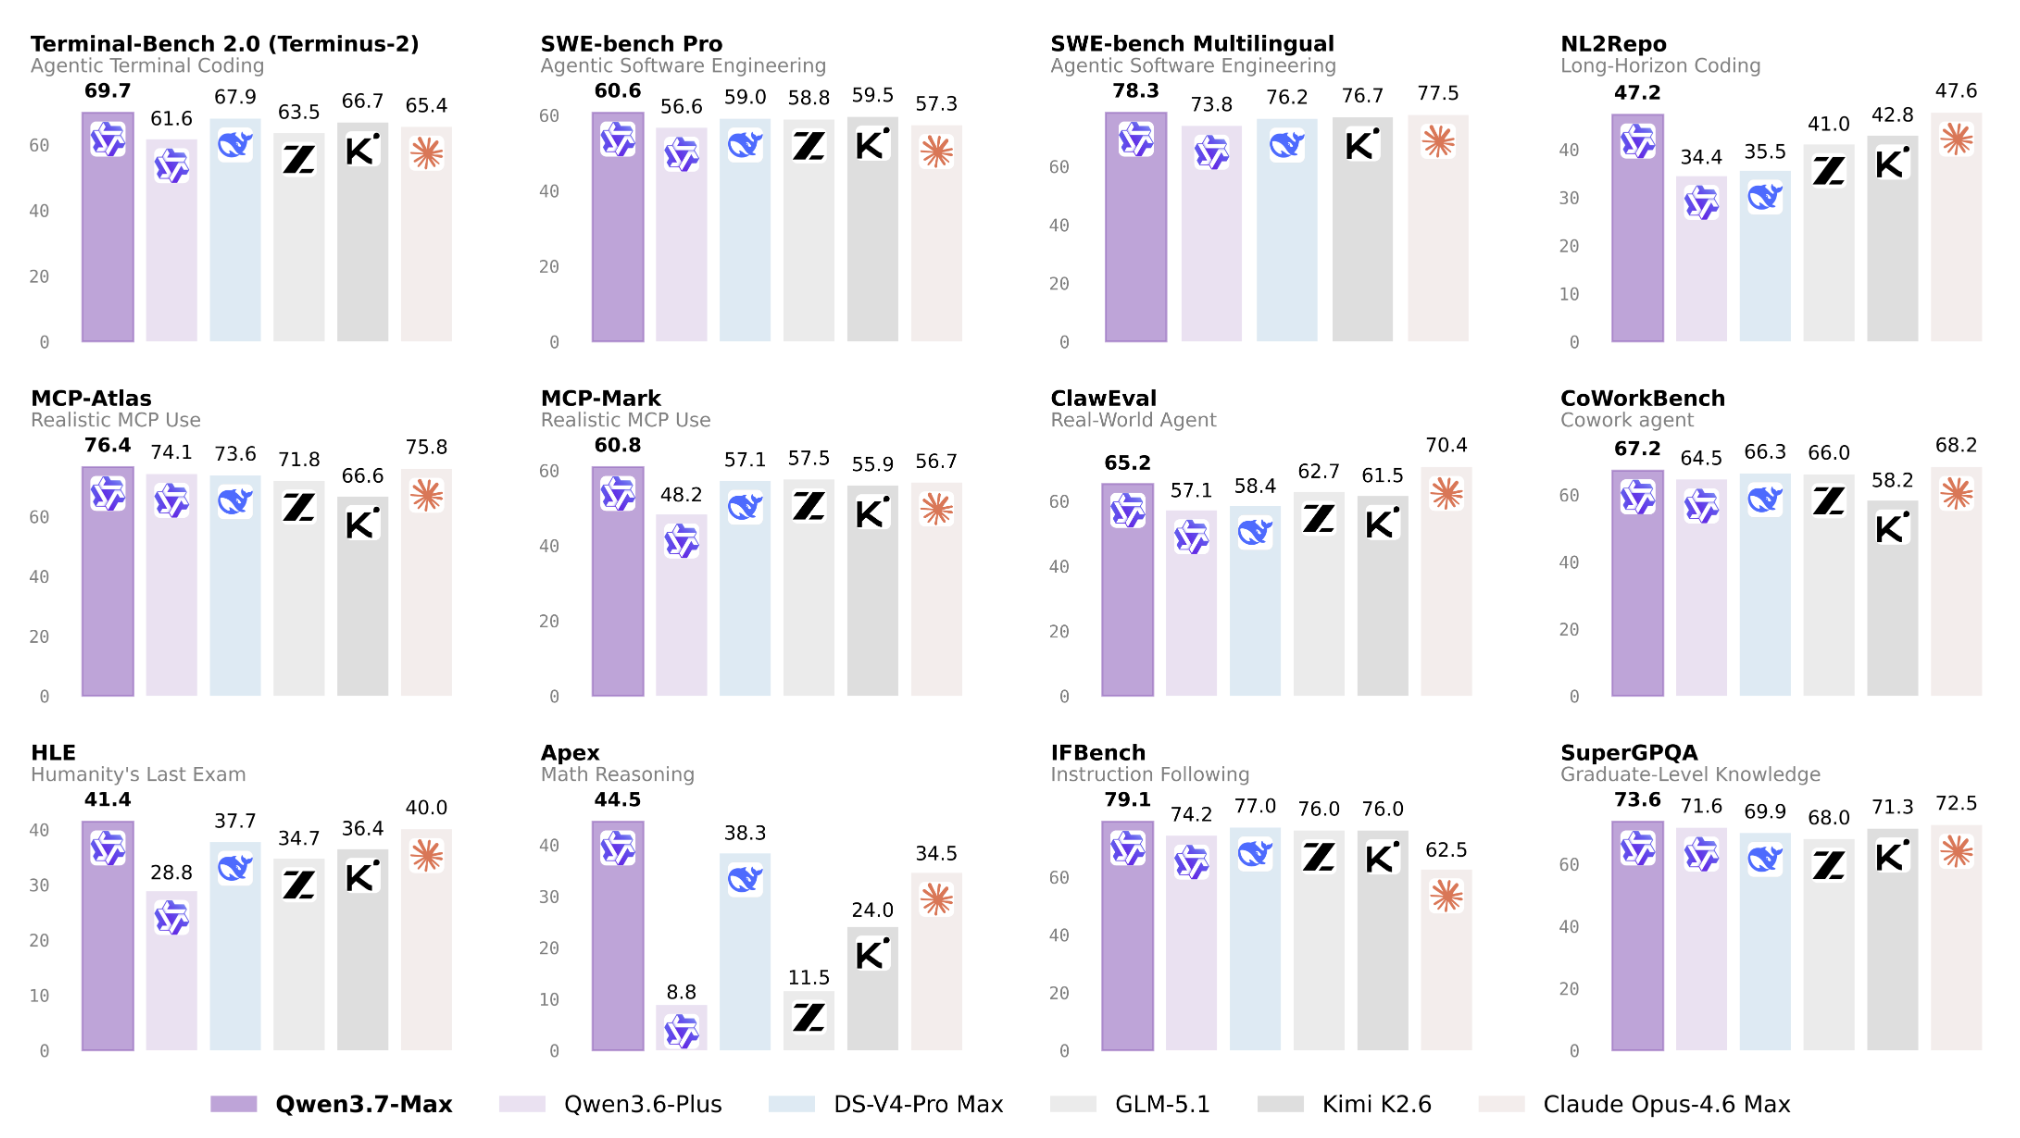
Bron: Qwen developer blog
Ter illustratie: al die resultaten liggen boven de scores van DeepSeek V4 Pro; de meeste licht, maar voor long-horizon coderen is er een aanzienlijk verschil tussen de twee (47,2 vs 35,5 in NL2Repo).
Dat brengt ons bij één opvallend voorbeeld uit de release: Qwen 3.7 Max’ run voor kerneloptimalisatie over een lange horizon. Qwen 3.7 Max draaide naar verluidt ongeveer 35 uur, deed 1.158 tool-calls, voltooide 432 kernelevaluaties en leverde een 10,0x geometrisch gemiddelde snelheidswinst ten opzichte van een Triton-referentie-implementatie.
Dit is belangrijk omdat het laat zien dat het model wordt geëvalueerd op iteratieve, tool-gebaseerde verbetering, niet alleen op statische benchmarkvragen.
Kortom, Qwen 3.7 Max past goed bij deze demo omdat het is gebouwd voor workflows waarin het model moet redeneren, tools gebruiken, context bewaren en een artefact over meerdere beurten verbeteren.
Een productiviteitsagent bouwen met behoud van “thinking” met Qwen 3.7 Max
In dit project demonstreren we drie praktische ideeën:
- Een vage gebruikersvraag kan worden omgezet in een gestructureerde workflow met meerdere stappen.
- Tooluitvoer kan worden teruggevouwen in het redeneerproces in plaats van in één lange prompt te worden gegooid.
- Een model kan zijn eigen output herlezen en verbeteren via chain-of-thought prompting voordat het het eindartefact aan de gebruiker geeft.
Projectoverzicht
We bouwen een simpele applicatie met één invoerveld en één knop, waarin de gebruiker een vage vraag invoert zoals:
I need to prepare a competitive analysis of the top 3 vector databases
for a team presentation next week. I have no idea where to start.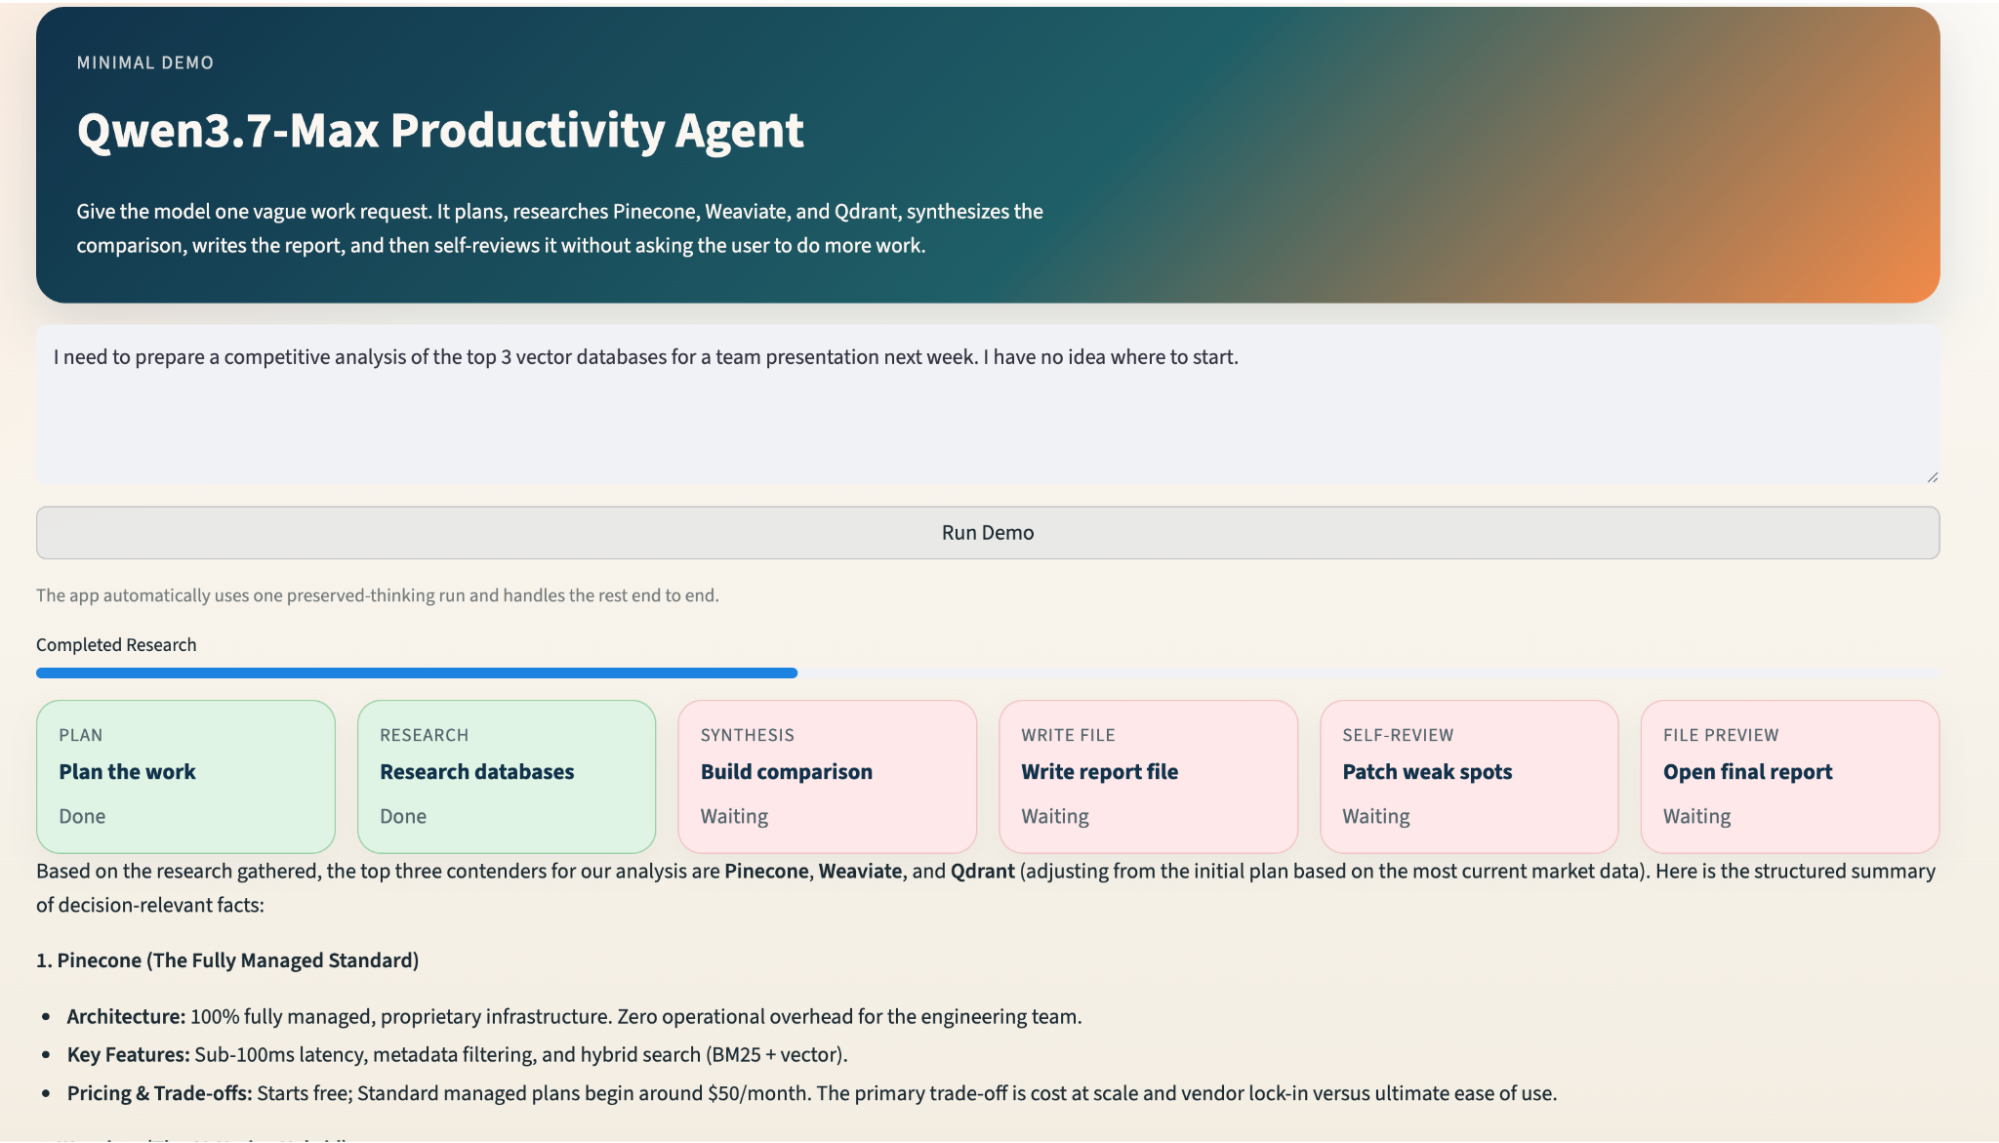
Daarna draait de agent een vaste workflow met vijf beurten:
User prompt
Turn 1: Plan the work
Parallel research for Pinecone, Weaviate, and Qdrant
Turn 2: Summarize research
Turn 3: Build comparison matrix
Turn 4: Write competitive_analysis.md
Turn 5: Self-review and patch the markdown file
Streamlit file previewDe UI toont elke stap als een voortgangskaart. Terwijl de workflow voltooit, gaan de kaarten van wachten naar klaar. Aan het einde kan de gebruiker elke fase bekijken: planning, onderzoek, synthese, concept, zelfreview en eindbestandsvoorbeeld.
Dit maakt de workflow van de agent zichtbaar in plaats van alles te verbergen achter één enkel chatantwoord.
De repo is bewust klein. De hoofdonderdelen zijn:
-
thinking_agent.py: bevat de backend agentlogica, zoals modelcalls, prompts, behoud van thinking, research, retries, bestandsschrijven en zelfreview. -
agent.py: dit bestand bevat de Streamlit-interface, inclusief paginalay-out, promptvak, voortgangsbalk, stapkaarten, resultaatskeuze, markdown-preview en downloadknop. -
requirements.txt: bevat runtime-afhankelijkheden die voor de demo nodig zijn
De backend draait om een ThinkingAgent-klasse die een vaste reeks van vijf beurten uitvoert en gestructureerde turn-records retourneert. De UI hoeft niet te weten hoe modelcalls, retries of research-fanout werken. Die hoeft alleen elke beurt te renderen zodra die binnenkomt.
De complete code voor deze tutorial is beschikbaar op GitHub.
Let op: ik gebruikte OpenRouter om Qwen 3.7 Max te benaderen, maar je kunt het model ook via het officiële Qwen API Platform gebruiken.
Stap 1: Omgeving instellen
Voordat we de Qwen 3.7 Max-productiviteitsagent bouwen, zetten we een kleine Python-omgeving op met Streamlit, de OpenAI-compatibele client en httpx voor lichtgewicht websearch.
In deze tutorial gebruiken we OpenRouter als modelgateway, maar de backend is geschreven met het OpenAI-compatibele API-formaat. Dat betekent dat dezelfde structuur later kan worden aangepast voor Alibaba Cloud Model Studio of een andere compatibele provider.
In deze stap gaan we:
-
Een virtuele omgeving maken
-
De vereiste afhankelijkheden installeren
-
De
OPENROUTER_API_KEYofQWEN_API_KEYinstellen -
Bevestigen dat de app met Streamlit gestart kan worden
Maak en activeer een virtuele omgeving:
python3 -m venv .venv
source .venv/bin/activateInstalleer de projectafhankelijkheden:
pip install -r requirements.txtHet requirements.txt-bestand is bewust klein:
httpx>=0.23.0
openai>=1.30.0
streamlit>=1.45.0We gebruiken streamlit om de interactieve webinterface te bouwen, openai om Qwen 3.7 Max aan te roepen via een OpenAI-compatibele API, en httpx om lichtgewicht live zoekresultaten op te halen voor de researchstap.
Stap 2: De Qwen 3.7 Max-client configureren
De backend gebruikt de OpenAI Python SDK omdat OpenRouter een OpenAI-compatibel endpoint aanbiedt. Het bestand thinking_agent.py definieert een paar defaults:
from openai import OpenAI
DEFAULT_MODEL = "qwen/qwen3.7-max"
DEFAULT_BASE_URL = "https://openrouter.ai/api/v1"
DEFAULT_REFERER = "https://qwen.ai"
DEFAULT_TITLE = "Qwen3.7-Max Productivity Agent"Daarna maken we een client:
def build_client(
api_key: str | None = None,
base_url: str | None = None,
referer: str = DEFAULT_REFERER,
title: str = DEFAULT_TITLE,
) -> OpenAI:
return OpenAI(
base_url=base_url or DEFAULT_BASE_URL,
api_key=api_key,
default_headers={
"HTTP-Referer": referer,
"X-Title": title,
},
)De functie build_client() centraliseert alle providerspecifieke configuratie. De rest van de app hoeft niet te weten of het verzoek via OpenRouter, Alibaba Cloud Model Studio of een ander compatibel endpoint gaat.
Zodra de client is geconfigureerd, kan de backend Qwen 3.7 Max aanroepen met het standaard chat-completionsformaat.
Nu bouwen we de kernworkflow van de ThinkingAgent.
Stap 3: Agent-workflow met vijf beurten
Nu de modelclient is geconfigureerd, kunnen we de kernbackend-workflow definiëren. In plaats van Qwen 3.7 Max te vragen om in één keer een volledig rapport te genereren, splitsen we de taak op in vijf gecontroleerde fasen.
-
Planning: zet de vage prompt om in een gestructureerd takenplan.
-
Onderzoek: verzamelt en vat bewijs samen uit externe fragmenten.
-
Synthese: bouwt een vergelijkingsmatrix op basis van het onderzoek.
-
Concept: schrijft het eerste
competitive_analysis.md-rapport. -
Zelfreview: beoordeelt en patcht het rapport voordat het eindbestand wordt teruggegeven.
class ThinkingAgent:
def run(
self,
goal: str,
preserve_thinking: bool = True,
data_mode: str = "live",
on_turn: Callable[[TurnRecord], None] | None = None,
) -> ThinkingRunResult:
history = [{"role": "system", "content": SYSTEM_PROMPT}]
turns = []
backend = self._build_search_backend(data_mode)
turn1 = self._run_turn(
history=history,
turn_index=1,
phase="planning",
user_prompt=_planning_prompt(goal),
preserve_thinking=preserve_thinking,
)
search_results = self._run_research(backend)
turn2 = self._run_turn(
history=history,
turn_index=2,
phase="research",
user_prompt=_research_prompt(goal, search_results),
preserve_thinking=preserve_thinking,
)
turn3 = self._run_turn(
history=history,
turn_index=3,
phase="synthesis",
user_prompt=_synthesis_prompt(),
preserve_thinking=preserve_thinking,
)
turn4 = self._run_turn(
history=history,
turn_index=4,
phase="draft",
user_prompt=_draft_prompt(goal),
preserve_thinking=preserve_thinking,
)
turn5 = self._run_turn(
history=history,
turn_index=5,
phase="self_review",
user_prompt=_self_review_prompt(draft_markdown),
preserve_thinking=preserve_thinking,
)De run()-methode is de hoofdorkestratielus. Die start met een systeemprompt, maakt een gesprekshistorie, bouwt een researchbackend, en voert vervolgens de vijf beurten één voor één uit.
Elke aanroep van _run_turn() heeft een specifieke fase. Dit maakt de workflow makkelijker te debuggen omdat elke modelcall één duidelijke verantwoordelijkheid heeft. De planningsturn plant. De researchturn interpreteert externe fragmenten. De synthese-turn bouwt structuur. De draft-turn schrijft. De zelfreview-turn verbetert de output.
De researchstap is geplaatst tussen beurt 1 en 2 omdat het model eerst de taak moet begrijpen voordat externe informatie in de workflow wordt gevouwen.
In de volgende stap voegen we de Qwen-specifieke logica voor het behouden van thinking toe, die het model helpt de continuïteit over deze beurten te bewaren.
Stap 4: Thinking behouden over beurten heen
De belangrijkste reden om Qwen 3.7 Max in deze demo te gebruiken is de ondersteuning voor workflows met behoud van thinking. De agent beschouwt elke modelcall niet als een geïsoleerde prompt. In plaats daarvan kan hij redeneringen uit eerdere beurten bewaren en die context doorgeven aan latere beurten.
In deze stap gaan we:
- Thinking van het model inschakelen.
- Redeneringen over beurten heen bewaren.
- Assistentuitvoer terug in de gedeelde historie toevoegen.
response = self.client.chat.completions.create(
model=self.config.model,
messages=request_messages,
extra_body={
"enable_thinking": True,
"preserve_thinking": preserve_thinking,
},
)De vlag enable_thinking=True laat Qwen 3.7 Max redeneerinhoud produceren tijdens de respons. Terwijl de vlag preserve_thinking bepaalt of die redeneerinhoud moet worden behouden voor latere beurten.
Nadat het model heeft geantwoord, haalt de backend zowel het zichtbare antwoord als de redeneerinhoud op:
message = response.choices[0].message
assistant_content = _normalize_text(getattr(message, "content", ""))
reasoning_content = _extract_reasoning_content(message)
The visible answer is what the app can show to the user. The reasoning content is used internally to help the next turn stay aligned with the earlier plan.
Then the backend appends the assistant message back into the conversation history:
```python
assistant_message = {
"role": "assistant",
"content": assistant_content,
}
if preserve_thinking and reasoning_content:
assistant_message["reasoning_content"] = reasoning_content
history.append(assistant_message)Als de planningsturn beslist dat het eindrapport vectordatabases moet vergelijken op implementatiemodel, schaalbaarheid, ontwikkelaarservaring, hybride zoekmogelijkheden en enterprise-gereedheid, kunnen latere beurten die criteria blijven gebruiken. Zonder dit kan elke beurt afdrijven. De synthese-stap kan andere criteria kiezen dan de planningsstap, of de zelfreview-stap kan het rapport tegen een ander doel evalueren.
Vervolgens voegen we de researchlaag toe die de agent externe context geeft voordat hij het rapport schrijft.
Stap 5: Parallel onderzoek met fallbackdata toevoegen
Voordat het model een concurrentieanalyse schrijft, is externe context nodig. In deze demo houden we de researchscope vast door drie vectordatabases te vergelijken: Pinecone, Weaviate en Qdrant.
In deze stap gaan we:
- De doeldatabases definiëren.
- Researchcalls parallel uitvoeren.
- Terugvallen op deterministische fixturedata als live search faalt.
DATABASES = ("Pinecone", "Weaviate", "Qdrant")De doelijst is bewust vast. Dit houdt de demo stabiel en makkelijker uit te leggen. Later kun je het project uitbreiden zodat het model de vergelijkingsdoelen dynamisch kiest.
Vervolgens start de backend researchcalls parallel:
from concurrent.futures import ThreadPoolExecutor, as_completed
with ThreadPoolExecutor(max_workers=3) as executor:
future_map = {
executor.submit(backend.search, database, query): database
for database, query in queries.items()
}
for future in as_completed(future_map):
database = future_map[future]
results[database] = future.result()De ThreadPoolExecutor start één zoekopdracht per database. Dit is sneller dan de zoekopdrachten sequentieel uitvoeren, omdat Pinecone-, Weaviate- en Qdrant-onderzoek parallel kan lopen.
try:
results[database] = future.result()
except Exception as exc:
fallback = FixtureSearchBackend().search(database, queries[database])
fallback.warning = (
f"Live search failed for {database} ({exc}). "
"Fallback demo research was used."
)
results[database] = fallbackAls live search werkt, gebruikt de agent verse fragmenten. Als het faalt, voltooit de app de workflow alsnog met ingebouwde deterministische researchfragmenten. Het belangrijkste ontwerpprincipe is gracieus degraderen. De agent mag niet crashen alleen omdat één externe afhankelijkheid faalt.
In de volgende stap geven we deze researchresultaten door aan Qwen 3.7 Max, zodat het een vergelijkingsmatrix kan synthetiseren.
Stap 6: De synthese en vergelijkingsmatrix genereren
Zodra de agent researchfragmenten heeft, is de volgende taak synthese. Deze stap zet losse informatie om in een gestructureerde vergelijking die het eindrapport kan ondersteunen.
In deze stap gaan we:
- De researchcontext terugsturen naar Qwen 3.7 Max.
- Het model vragen een gestructureerde vergelijking te maken.
- Die output later renderen in de Streamlit-interface.
turn3 = self._run_turn(
history=history,
turn_index=3,
phase="synthesis",
user_prompt=_synthesis_prompt(),
preserve_thinking=preserve_thinking,
)Tegen de tijd dat deze code draait, bevat de gesprekshistorie al de oorspronkelijke gebruikersvraag, de output van planning, de researchsamenvattingen en optioneel de behouden thinking uit eerdere beurten.
Dit betekent dat de synthese-prompt niet de hele taak hoeft te herhalen. Die kan zich richten op één klus, namelijk het omzetten van het onderzoek in een beslisrijpe vergelijkingsmatrix.
Een goede synthese vergelijkt de opties langs dimensies zoals:
- Implementatiemodel
- Schaalbaarheid
- Ontwikkelaarservaring
- Ondersteuning voor hybride search
- Enterprise-gereedheid
- Best passende usecase
Vervolgens gebruiken we deze gesynthetiseerde structuur om het eerste Markdown-rapport te schrijven.
Stap 7: Het markdown-rapport schrijven
Na planning, onderzoek en synthese heeft de agent genoeg context om het eerste complete deliverable te schrijven. In deze demo is het deliverable een markdown-bestand met de naam competitive_analysis.md.
In deze stap gaan we:
- Qwen 3.7 Max vragen om de eerste rapportversie te schrijven.
- Onnodige markdown-codeblokken verwijderen.
- Het concept op schijf opslaan.
- De bestands-schrijfactie registreren als toolevent.
turn4 = self._run_turn(
history=history,
turn_index=4,
phase="draft",
user_prompt=_draft_prompt(goal),
preserve_thinking=preserve_thinking,
)De draft-turn gebruikt alle eerdere context, waaronder het oorspronkelijke doel van de gebruiker, het plan, het onderzoek en de synthese-matrix.
De modelrespons wordt daarna opgeschoond en op schijf geschreven:
draft_markdown = _strip_markdown_fences(turn4.assistant_content)
report_path = run_output_dir / "competitive_analysis.md"
report_path.write_text(draft_markdown)De helper _strip_markdown_fences() is handig omdat modellen markdown-uitvoer vaak omhullen met triple backticks. Dat is prima in een chat, maar minder ideaal als je direct naar een .md-bestand schrijft.
De backend registreert ook de schrijfactie:
turn4.tool_events.append(
ToolEvent(
name="write_file",
status="completed",
input_payload={"path": str(report_path)},
output_payload={
"description": "Initial draft written to disk.",
},
)
)Dit toolevent helpt de UI laten zien dat de backend een echt bestand heeft gemaakt, niet slechts een tekstantwoord. Op dit punt heeft de app al een bruikbaar rapport. Maar we voegen nog één modelbeurt toe om de kwaliteit te verbeteren voordat we het eindartefact tonen.
In de volgende stap vragen we Qwen 3.7 Max om het eigen concept te reviewen en te patchen.
Stap 8: Zelfreview en patch van het rapport
De laatste modelbeurt is een zelfreview-stap. In plaats van het eerste concept meteen aan de gebruiker te geven, herleest de agent het rapport, checkt het tegen het oorspronkelijke doel en schrijft een verbeterde versie.
In deze stap gaan we:
- Het concept-markdown terug naar het model sturen.
- Het model vragen zwaktes te identificeren.
- Een herziening genereren.
- Het rapport overschrijven met de verbeterde eindversie.
turn5 = self._run_turn(
history=history,
turn_index=5,
phase="self_review",
user_prompt=_self_review_prompt(draft_markdown),
preserve_thinking=preserve_thinking,
)De zelfreview-prompt vraagt het model te letten op praktische punten, zoals of de aanbeveling duidelijk is, of de vergelijkingscriteria consistent zijn en of het rapport nuttig is voor een teampresentatie.
De herziene output wordt teruggeschreven naar hetzelfde bestand:
final_markdown = _strip_markdown_fences(turn5.assistant_content)
report_path.write_text(final_markdown)De agent kan ook het definitieve schrijf-event registreren:
turn5.tool_events.append(
ToolEvent(
name="write_file",
status="completed",
input_payload={"path": str(report_path)},
output_payload={
"description": "Self-reviewed final report written to disk.",
},
)
)Deze stap tilt de app van een simpele generator naar een kleine redactionele workflow. De output die de gebruiker ziet is niet de eerste versie; het is de gereviewde en gepatchte variant.
Vervolgens koppelen we deze backend-workflow aan de Streamlit-app.
Stap 9: De Streamlit-voortgangsinterface bouwen
We gaan nu van backendlogica naar de gebruikersinterface. De Streamlit-app moet de gebruiker een prompt laten invoeren, de workflow draaien en elke fase zien voltooien.
Opmerking: deze code hoort in het bestand agent.py omdat het bepaalt wat de gebruiker ziet en klikt.
In deze stap gaan we:
-
De Streamlit-pagina configureren.
-
De promptinvoer maken.
-
Een run-knop toevoegen.
-
De functie
ThinkingAgent.run()aanroepen. -
De UI updaten zodra beurten klaar zijn.
def render_streamlit_app() -> None:
st.set_page_config(
page_title="Qwen3.7-Max Demo Agent",
page_icon=":material/psychology:",
layout="wide",
initial_sidebar_state="collapsed",
)De app gebruikt een brede lay-out omdat de UI stapkaarten, voortgangsindicatoren en resultaatpanelen bevat.
Het invoergedeelte is simpel:
goal = st.text_area(
"Prompt",
value=DEFAULT_GOAL,
height=120,
label_visibility="collapsed",
)
run_clicked = st.button("Run Demo", use_container_width=True)De gebruiker hoeft alleen de taak te geven. De app vraagt niet om temperatuur, zoekmodus, model-ID of redeneerinstellingen te configureren. Die details worden door de backend afgehandeld.
Wanneer de gebruiker op de knop klikt, maakt agent.py de backendagent en voert die uit:
agent = ThinkingAgent(config=config)
result = agent.run(
goal=goal,
preserve_thinking=True,
data_mode="live",
on_turn=on_turn,
)Hier komen de twee bestanden samen. De agent.py triggert de workflow, maar thinking_agent.py beheert het eigenlijke agentgedrag. De UI-callback werkt de pagina bij na elke beurt:
def on_turn(turn: TurnRecord) -> None:
partial_turns.append(turn)
progress_placeholder.progress(
len(partial_turns) / len(phase_order),
text=f"Completed {_phase_label(turn.phase)}",
)
with steps_placeholder.container():
_render_step_cards(partial_turns, result_ready=False)De callback ontvangt een voltooide TurnRecord en ververst de voortgangsbalk en stapkaarten. Tijdens de uitvoering fungeren de kaarten als statusindicatoren. Na voltooiing worden het klikbare resultaatweergaven.
Nu renderen we het definitieve markdown-rapport en bieden we het aan als downloadbaar bestand.
Stap 10: Voorbeeldweergave en download van het eindrapport
Nadat de backend klaar is, moet de UI het eindrapport tonen. De backend heeft het markdown-bestand al gemaakt, dus agent.py hoeft het alleen te lezen, te renderen en een downloadknop aan te bieden.
In deze stap gaan we:
- Controleren of het rapportbestand bestaat.
- De definitieve markdown-inhoud lezen.
- Een downloadknop tonen.
- De markdown renderen in de Streamlit-app
def _render_file_preview(report_path: str) -> None:
path = Path(report_path)
if not path.exists():
st.info("No file was written yet.")
return
content = path.read_text()
st.caption(f"Created file: {path.name}")
st.download_button(
"Download competitive_analysis.md",
data=content,
file_name=path.name,
use_container_width=True,
)
st.markdown(content)De functie begint met controleren of het bestand bestaat. Dit voorkomt dat de app crasht als de backend faalde voordat het rapport werd geschreven. Vervolgens leest hij de markdown-inhoud en maakt een downloadknop. Ten slotte rendert hij de markdown direct op de Streamlit-pagina.
Dit is een nette scheiding van verantwoordelijkheden waarbij:
-
thinking_agent.pyhet rapport schrijft -
agent.pyhet rapport previewt en downloadt
In de volgende stap voegen we basisfoutafhandeling toe zodat de demo zich beter gedraagt wanneer provider-routes falen of rate limits optreden.
Stap 11: Afhandeling van fouten en rate limits
Modelproviders kunnen time-outs geven, tijdelijke failures retourneren of verzoeken rate-limiten. Als we die ruwe fouten direct aan gebruikers tonen, voelt de app onaf.
Deze stap is verdeeld over beide bestanden. De retrylogica hoort in thinking_agent.py omdat die onderdeel is van de backend-modelcall. De foutmelding hoort in agent.py omdat die bepaalt wat de gebruiker ziet.
In deze stap gaan we:
- Tijdelijke providerfouten in de backend opnieuw proberen.
- Rate-limit-achtige fouten detecteren.
- Een nettere melding tonen in de Streamlit-UI
delays = (1.0, 2.0)
for attempt_index in range(len(delays) + 1):
try:
return self.client.chat.completions.create(...)
except Exception as exc:
if not _is_retryable_provider_error(exc):
raise
if attempt_index >= len(delays):
raise
time.sleep(delays[attempt_index])De backend probeert de modelcall, vangt retrybare fouten af, wacht kort en probeert opnieuw. De korte vertragingen zijn genoeg om tijdelijke providerinstabiliteit op te vangen zonder de gebruiker te lang te laten wachten.
def _friendly_rate_limit_message(exc: Any) -> str:
return (
"Qwen 3.7 Max is temporarily rate-limited upstream. "
"Please wait 30 to 60 seconds and try again."
)Dit houdt ruwe provider-JSON of stacktraces uit de UI. De gebruiker krijgt een duidelijke uitleg en een praktische vervolgstap.
Met deze laatste stap kunnen we nu de volledige app draaien en de end-to-end workflow testen.
Stap 12: De demo draaien
Nu de backend-workflow en Streamlit-interface gekoppeld zijn, kunnen we de complete app draaien.
In deze stap gaan we:
- De Streamlit-app starten.
- De standaard productiviteitsprompt invoeren.
- De workflow met vijf fasen draaien.
- Het definitieve markdown-rapport previewen en downloaden
Start de app:
streamlit run agent.pyGebruik de standaardprompt:
I need to prepare a competitive analysis of the top 3 vector databases
for a team presentation next week. I have no idea where to start.Als je op Run Demo klikt, doorloopt de app de volledige workflow:
-
Planning: maakt een gestructureerd plan.
-
Onderzoek: verzamelt fragmenten voor Pinecone, Weaviate en Qdrant.
-
Synthese: bouwt een vergelijkingsmatrix.
-
Concept: schrijft het eerste markdown-rapport.
-
Zelfreview: patcht het rapport.
-
Voorbeeld: toont het definitieve
competitive_analysis.md-bestand.
Het eindrapport wordt opgeslagen onder:
output/showcase_runs/<timestamp>/with_preserve/competitive_analysis.md
Aan het eind zou je de rapportpreview en een downloadknop in de Streamlit-interface moeten zien.
Conclusie
In deze tutorial bouwden we een compacte productiviteitsagent met Qwen 3.7 Max die een vaste, interpreteerbare workflow draait van planning, onderzoek, synthese en schrijven tot zelfreview. Onderweg laat het zien waarom het behouden van redeneringen over beurten heen nuttig kan zijn voor langlopende agenttaken.
De huidige versie gebruikt alleen Streamlit, OpenAI-compatibele modelcalls, een lichtgewicht zoeklaag en Markdown-output. Dat maakt het makkelijk om te bestuderen, aan te passen en te hergebruiken in je eigen experimenten.
Er zijn vanaf hier veel logische uitbreidingen:
-
Laat het model de vergelijkingsdoelen kiezen in plaats van een vaste lijst te gebruiken
-
voeg side-by-side runs toe “met
preserve_thinking” vs “zonderpreserve_thinking” -
Toon tokenverbruik en kostenramingen in de UI
-
genereer een slide-omlijsting of grafiek naast het markdown-rapport
-
Vervang DuckDuckGo-scraping door een robuustere zoek-API
Als je verder wilt gaan dan een vaste workflow en wilt leren hoe je productieklare AI-toepassingen bouwt, van prompt engineering via RAG tot agentische systemen, dan is onze skill track AI Engineering with LangChain een goede volgende stap.
Qwen 3.7 Max API-tutorial: veelgestelde vragen
Wanneer moet ik preserve_thinking=True gebruiken met Qwen 3.7 Max?
preserve_thinking=True helpt latere beurten afgestemd te blijven op eerdere beslissingen in workflows met meerdere beurten. In ons voorbeeld: als de planningsturn specifieke vergelijkingscriteria kiest, kunnen de synthese- en zelfreview-beurten dezelfde redenering blijven gebruiken in plaats van af te drijven.
Is Qwen 3.7 Max alleen voor codeeragents?
Nee. Coderen is een van zijn grote sterke punten, maar het model is ook gepositioneerd voor productiviteitsagents, kantoorautomatisering, MCP-gebaseerde workflows, meertalige taken, redeneren met lange context en toolgebruik over een lange horizon.
Gebruikt de demo-app echte websearch?
Ja, het huidige standaardpad probeert live DuckDuckGo-scraping. Als dat faalt, valt het terug op ingebouwde fixtureresearch.
Maakt het model subagents in onze demo-app?
Nee. De app gebruikt één modelsessie. Het “parallelle” deel gebeurt in de researchlaag, waar de backend drie webzoekopdrachten tegelijk start en de resultaten terugvoert in dezelfde modelsessie.
Waarom scheiden we agent.py en thinking_agent.py?
agent.py houdt de Streamlit-UI overzichtelijk. thinking_agent.py bevat de backend-workflow, promptconstructie, retries en researchlogica zodat het agentgedrag los van de interface kan worden getest.

Ik ben een Google Developers Expert in ML (Gen AI), een Kaggle 3x Expert en een Women Techmakers Ambassador met meer dan 3 jaar ervaring in tech. In 2020 heb ik een healthtech-startup mee opgericht en ik volg een master computer science aan Georgia Tech, met als specialisatie machine learning.


De meeste AI-demo’s lijken nog steeds op chatbots: je stelt een vraag, het model antwoordt, en de interactie stopt. Maar echt productief werk gebeurt meestal niet in één stap. Een nuttige assistent moet een vage vraag kunnen opdelen, context verzamelen, opties vergelijken, een bruikbaar artefact opleveren en vervolgens het eigen werk checken voordat het wordt teruggegeven.
Qwen 3.7 Max is een agentisch model van het Qwen-team, ontworpen voor agent-gerichte workloads, waaronder coderen, productiviteitstaken voor kantoor en uitvoer over een lange horizon. Het is een agent-first model dat niet alleen één prompt goed wil beantwoorden, maar ook consistent wil blijven over een langere workflow met planning, toolgebruik, schrijven en zelfcorrectie.
In deze tutorial bouwen we een compacte productiviteitsagent met Qwen 3.7 Max en Streamlit. De app neemt een vage zakelijke vraag, zoals het voorbereiden van een concurrentieanalyse van vectordatabases, en zet die om in een gepolijst
competitive_analysis.md-bestand.Aan het einde van deze tutorial snap je hoe je:
Een vaste agent-workflow met vijf beurten bouwt
enable_thinking=Trueenpreserve_thinking=TruegebruiktLichtgewicht parallel onderzoek toevoegt
Een markdown-artefact schrijft en bijwerkt
Een simpele Streamlit-UI rond de workflow maakt
De complete code is beschikbaar in de GitHub-repository.
Het project is bewust klein, met de hoofdlogica verdeeld over
agent.pyvoor de Streamlit-app enthinking_agent.pyvoor de backend-workflow.Als je nieuw bent met agentische AI, begin dan met onze skill track AI Agent Fundamentals.