Qwen3-Coder-Next 是 Qwen 团队推出的开源权重编码模型,面向智能体式编程与本地开发者工作流。它采用稀疏专家混合(MoE)设计,在支持长上下文和复杂多步任务的同时保持高效,并在现代编码与工具使用基准上表现强劲。
Qwen3-Coder-Next 特别令人兴奋之处在于,其性能与顶级闭源模型相当有竞争力。早期评估显示,它可接近Claude Sonnet 4.5等系统的水准,同时仍可在本地运行,完全掌控您的环境、隐私与速度,而无需依赖昂贵的托管 API。
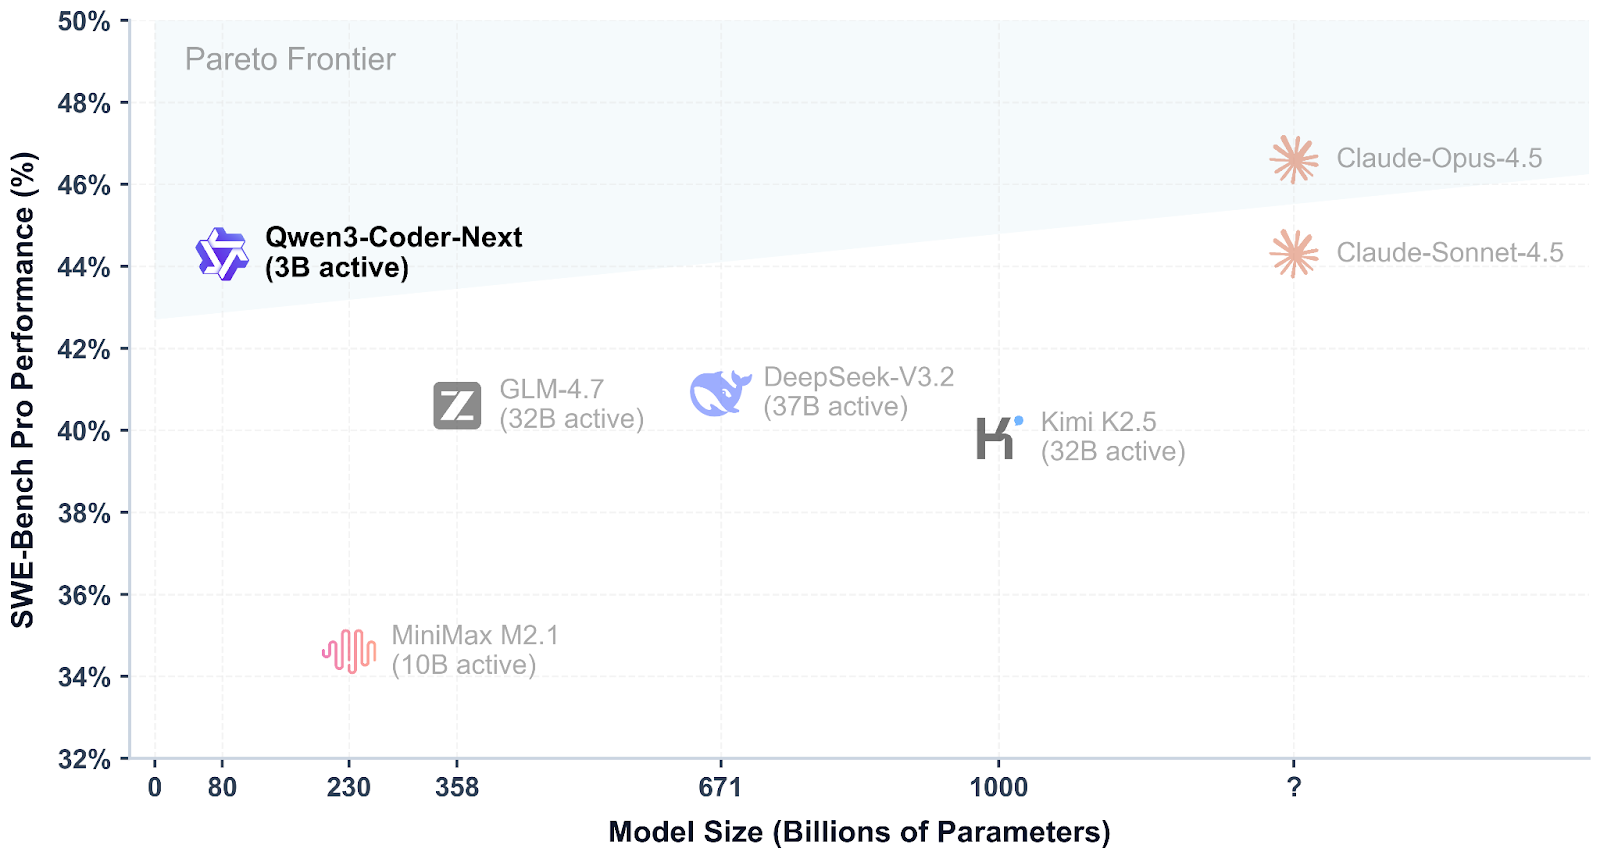
来源:Qwen/Qwen3-Coder-Next
在本教程中,我们将从源码构建llama.cpp,使用 llama.cpp 推理服务器在本地运行 Qwen3-Coder-Next,然后将其连接到 Qwen Code CLI。最后,我们将进行 vibe coding,构建一个简单的数据分析仪表板。
Qwen3-Coder-Next 硬件与软件先决条件
在本地构建并运行Qwen3-Coder-Next之前,您需要一个可用的 Linux 开发环境,具备编译llama.cpp并运行 GGUF 模型所需的标准构建工具。
除了系统软件包,请确保您还具备:
- Python(>= 3.11),用于支持脚本与本地工作流
- Node.js + npm(Node 20+),用于安装 Qwen Code CLI
- 正确的NVIDIA GPU 驱动
- 已配置完备 GPU 加速的CUDA Toolkit
首先更新系统并安装核心依赖:
sudo apt-get update
sudo apt-get install -y build-essential cmake curl git libcurl4-openssl-dev技术支持
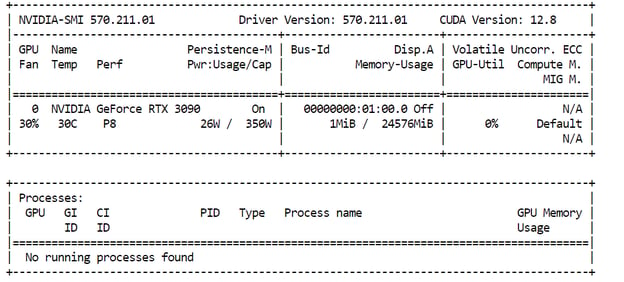
如果您计划使用CUDA 加速,请确认您的 NVIDIA GPU 被正确识别:
nvidia-smi技术支持
我们的环境使用NVIDIA RTX 3090,配备24GB VRAM。由于 Qwen3-Coder-Next 在更大量化下所需内存超过该容量,剩余权重将自动脱载至系统内存,从而仍可在本地以良好性能运行模型。
为顺畅运行 Qwen3-Coder-Next,建议您的硬件满足以下大致内存目标:
- 46GB RAM / VRAM / 统一内存,用于4-bit GGUF推理。
- 约 85GB 内存,用于8-bit变体。
如果可用内存不足 46GB,您仍可运行更小的量化版本(例如3-bit)。
一个简单的经验法则是:
磁盘 + 内存 + 显存 ≥ 量化大小
如果整个量化文件都能放入内存,您可以期待快速的本地性能;否则模型仍可通过脱载运行,但推理会更慢。
安装支持 CUDA 的 llama.cpp
在本地运行 Qwen3-Coder-Next 之前,我们需要一个快速的推理引擎。当前最受欢迎的选择是llama.cpp,它提供轻量级 GGUF 推理以及易于运行的本地服务器。
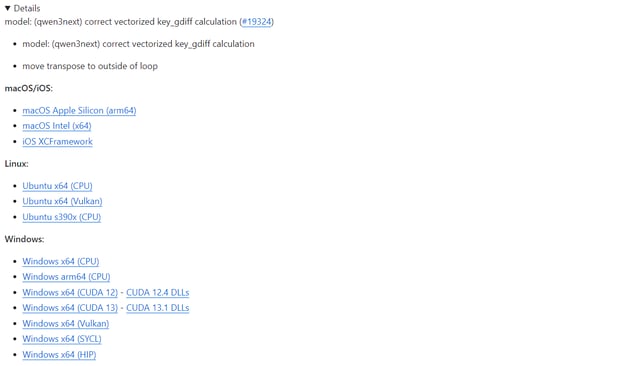
如果您想快速搭建,llama.cpp 为 macOS、Linux 和 Windows(包括启用 CUDA 的构建)提供预编译二进制文件。您可以直接从官方 GitHub 发布页下载:Release b7936 · ggml-org/llama.cpp。
通过预编译安装,您可以立即运行 llama.cpp 的 CLI 工具或启动推理服务器,而无需自行编译。
在本教程中,我们将手动构建 llama.cpp,而不是依赖预编译二进制文件,原因包括:
- 获取最新更新与修复(来自 GitHub 仓库)
- 完整的CUDA 支持,针对 Linux 优化
- 更佳性能,贴合您的特定 GPU 与环境
- 支持更新的量化格式与近期输出质量改进
首先直接从 GitHub 下载官方 llama.cpp 源码,确保使用最新版本,包含最新 CUDA 改进与修复:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp技术支持
此时,您应位于 llama.cpp 目录中,其中包含从头构建项目所需的一切。
接下来我们使用CMake 配置构建系统。该步骤将生成必要的构建文件并通过 CUDA 启用 GPU 加速:
cmake /workspace/llama.cpp -B /workspace/llama.cpp/build -DGGML_CUDA=ON -DBUILD_SHARED_LIBS=OFF技术支持
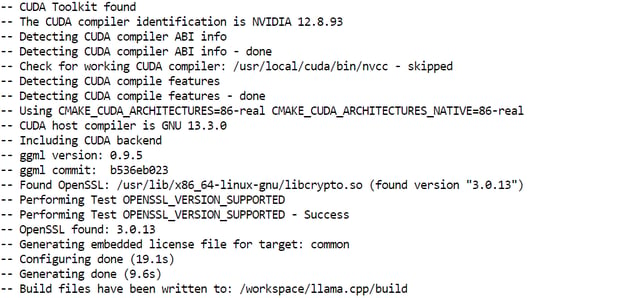
现在编译实际的推理服务器二进制文件。该组件将在本地承载 Qwen3-Coder-Next,并为编码工具与 CLI 集成提供 API 端点:
cmake --build /workspace/llama.cpp/build -j --clean-first --target llama-server技术支持
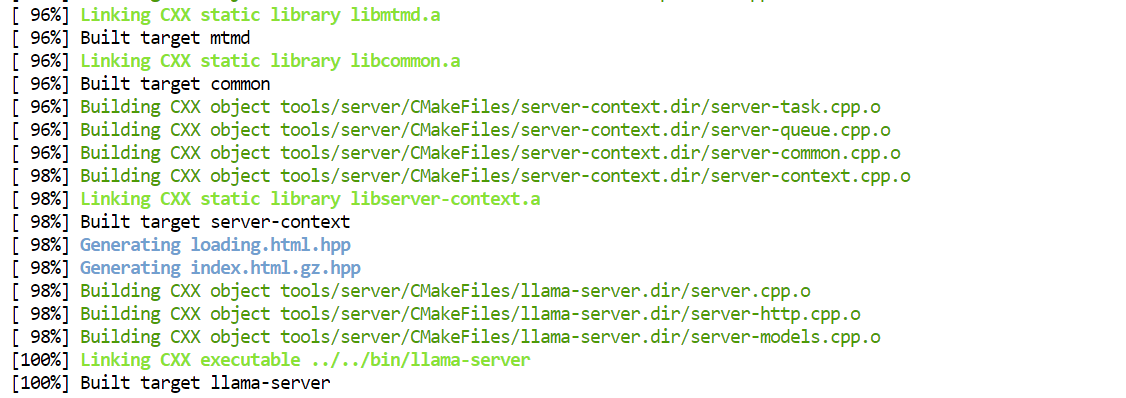
构建完成后,可执行文件位于 build/bin/ 目录。为便于在项目根目录直接运行,您可以这样复制:
cp /workspace/llama.cpp/build/bin/llama-server /workspace/llama.cpp/llama-server技术支持
下载 Qwen3-Coder-Next 模型
安装好 llama.cpp 后,下一步从 Hugging Face 下载Qwen3-Coder-Next GGUF 模型。
开始前,请确保您已安装较新的Python(>= 3.11),因为 Hugging Face 工具与传输实用程序依赖它。
为高效下载大型 GGUF 文件,我们将使用 Hugging Face Hub 客户端及高速的 Xet 与传输后端:
pip install -U "huggingface_hub[hf_xet]" hf-xet hf_transfer技术支持
接着,启用 Hugging Face 的优化传输后端:
export HF_HUB_ENABLE_HF_TRANSFER=1技术支持
现在我们可以下载 Qwen3-Coder-Next 的Unsloth 动态 GGUF 版本。本教程中我们将获取UD-Q4_K_XL 量化。
这是一个很好的默认选择,因为它在以下方面达成出色平衡:
- 模型质量(极强的编码表现)
- 推理速度(足够快,适合本地 vibe coding 工作流)
- 内存效率(在高端消费级 GPU 上配合内存脱载即可容纳)
其中Q4 格式表示模型被压缩至4-bit 精度,相比完整 FP16 权重更轻,同时仍保持令人印象深刻的输出质量。
hf download unsloth/Qwen3-Coder-Next-GGUF \
  --local-dir /workspace/models/qwen3-coder-next \
  --include "*UD-Q4_K_XL*"技术支持
命令执行后,模型文件将开始下载至您的本地目录。

在高速网络下通常只需几分钟。下载完成后,您即可将 GGUF 模型加载到llama-server 进行本地推理。
运行 Qwen3-Coder-Next 推理服务器
GGUF 模型下载完成后,我们即可使用 llama-server 推理后端在本地启动Qwen3-Coder-Next。这将启动一个与 OpenAI 兼容的 API 服务器,供编码工具与 CLI 连接。
运行以下命令:
./llama-server \
  --model "/workspace/models/qwen3-coder-next/Qwen3-Coder-Next-UD-Q4_K_XL.gguf" \
  --alias "Qwen3-Coder-Next" \
  --host 0.0.0.0 \
  --port 8080 \
  --threads 32 \
  --threads-batch 32 \
  --ctx-size 20000\
  --batch-size  1024\
  --ubatch-size 256 \
  --jinja \
  --flash-attn on \
  --temp 0.7 \
  --top-p 0.9 \
  --min-p 0.05 \
  --fit on \
  --swa off技术支持
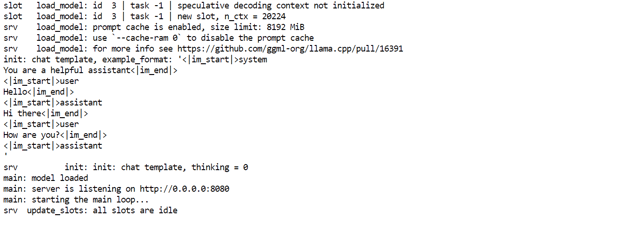
关键参数说明:
--model:指向已下载的Qwen3-Coder-Next GGUF 检查点--alias:在 API 客户端中显示的友好模型名称--host 0.0.0.0:在所有网络接口上暴露服务器(便于远程访问)--port 8080:在8080 端口运行推理 API--threads 32:使用 32 个 CPU 线程以获得最大吞吐--threads-batch 32:并行化批处理以更快生成 token--ctx-size 20000:设置较大的上下文窗口(约 20K token),适合长时间编码会话--batch-size 1024:提升推理期间的 GPU 利用率--ubatch-size 256:控制微批以获得更平滑的性能--jinja:启用指令式模型所需的聊天模板格式--flash-attn on:启用 Flash Attention,加速长上下文推理--temp 0.7:保持输出专注同时具备一定创造性,利于 vibe coding--top-p 0.9:核采样,平衡多样性--min-p 0.05:过滤极低概率 token,获得更干净的补全--fit on:自动将层装入显存并将其余部分脱载至内存--swa off:关闭滑动窗口注意力(更适合全上下文任务)
服务器启动后,请让其在该终端保持运行。然后打开一个新的终端标签页或会话,在不停止服务器的情况下测试 API。
在新终端中,您可以通过查询可用模型来确认一切正常:
curl http://127.0.0.1:8080/v1/models技术支持
如果服务器运行正常,您应在响应中看到Qwen3-Coder-Next,这意味着您的本地推理端点已就绪。
通过 Web UI 访问本地 Qwen3-Coder-Next API 端点
推理服务器运行后,您也可以通过内置的llama.cpp Web UI 直接与 Qwen3-Coder-Next 交互。
打开浏览器访问:http://127.0.0.1:8080。
这会启动一个类似 ChatGPT 的简单界面,您可以快速测试提示并验证模型响应是否正确。
例如,可让模型生成一些实用内容,比如一个基础的 Python 交易机器人。
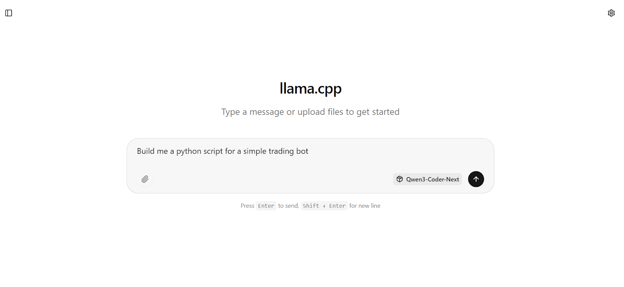 数秒内,您将获得包含可运行代码与清晰实现步骤的完整响应。
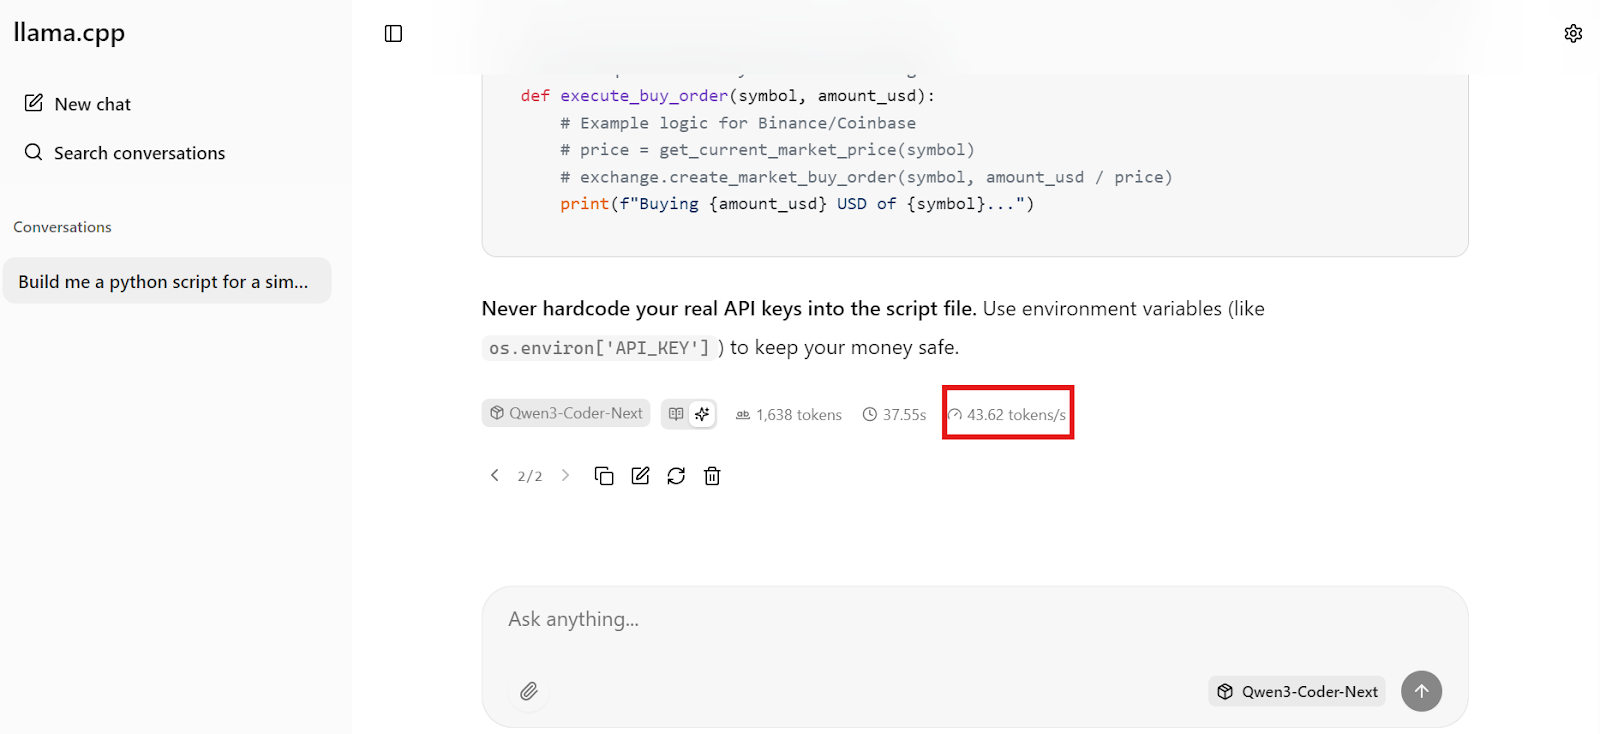
令人印象深刻的是速度。在我们的环境中,Qwen3-Coder-Next 的生成速度约为每秒 44 个 token,让本地编码体验极为流畅,能够满足实时 vibe coding 的需求。
安装并设置 Qwen Code CLI
现在本地推理服务器已运行在 http://127.0.0.1:8080/v1,我们可以将其连接到Qwen Code CLI。这将为您提供一个轻量级的终端编码助手,通过与 OpenAI 兼容的 API 与本地 Qwen3-Coder-Next 通信。
Qwen Code CLI 基于 Node,因此您需要:
- Node.js 20+
- npm(在 Ubuntu/Debian 上随 Node.js 自动安装)
通过 NodeSource 安装 Node.js(推荐以获取正确版本):
sudo apt update
sudo apt install -y curl ca-certificates
curl -fsSL https://deb.nodesource.com/setup_20.x | sudo -E bash -
sudo apt install -y nodejs技术支持
全局安装 Qwen Code CLI:
npm install -g @qwen-code/qwen-code@latest技术支持
验证是否安装成功:
qwen --version 技术支持
0.9.0技术支持
Qwen CLI 期望使用 OpenAI 风格的环境变量。我们将创建一个简单的配置文件,告知它:
- 使用一个占位 API Key(因为我们在本地运行)
- 将请求发送到llama-server 的 8080 端口
- 使用我们通过
--alias 设置的精确模型名称
创建配置目录与 .env 文件:
mkdir -p ~/.qwen
cat > ~/.qwen/.env <<'EOF'
OPENAI_API_KEY="dummy"
OPENAI_BASE_URL="http://127.0.0.1:8080/v1"
OPENAI_MODEL="Qwen3-Coder-Next"
EOF技术支持
现在启动 Qwen Code:
qwen 技术支持
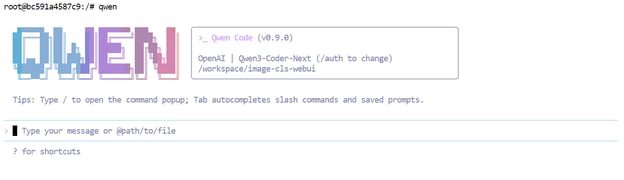 此时,您的 CLI 已连接至本地 Qwen3-Coder-Next 服务器,每条提示均在本地运行,而非调用托管 API。
使用 Qwen3-Coder-Next 进行 Vibe Coding 打造分析仪表板
现在一切已在本地运行,我们可以开始使用vibe coding,通过Qwen Code CLI 构建一个简单的分析仪表板。
首先,新建项目文件夹并进入:
mkdir dashboardcd dashboard技术支持
然后在该目录内启动 Qwen CLI:
qwen技术支持
现在给出一个清晰、简单的指令,例如:
“使用虚拟数据(销售、用户、营收、流失)构建一个 HTML 分析仪表板,包含 KPI 卡片、一个交互式表格、至少一个图表,并添加日期范围与类别筛选。”
数秒内,Qwen3-Coder-Next 即可理解需求,并在写代码前将任务拆解为结构化计划。
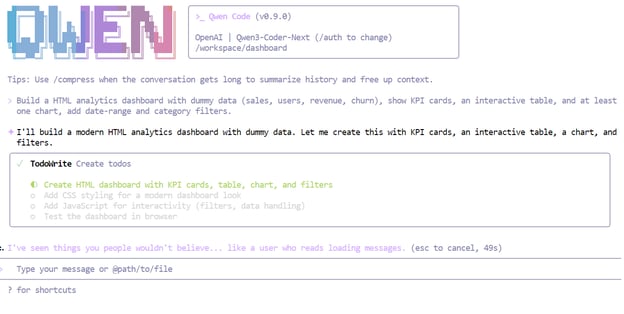
勾选清单后,模型一次性生成了完整、可运行的仪表板,包括:
index.htmlstyle.cssscript.js
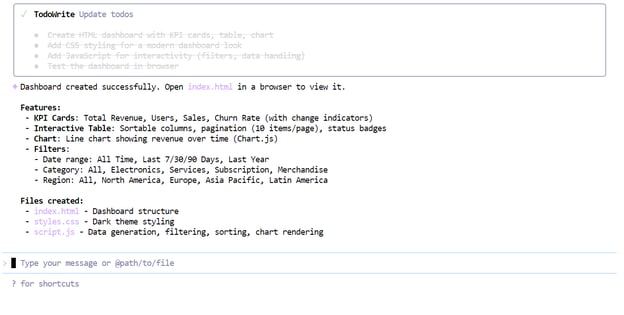
在浏览器中打开 index.html,您将立即看到一个现代、结构清晰的仪表板,具备干净的样式、KPI 卡片与逼真的占位指标。
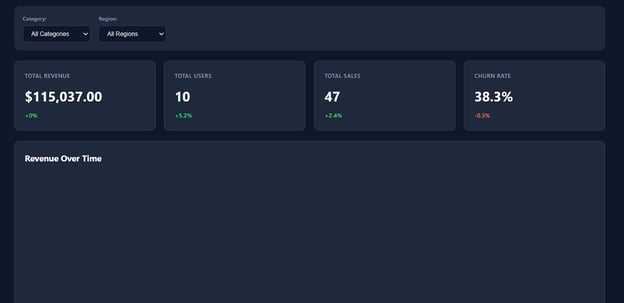
筛选器、表格交互与下载选项均可即开即用,运行顺畅。
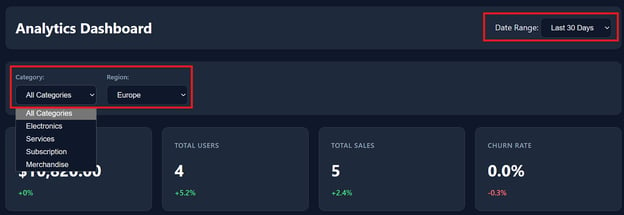
继续向下滚动,仪表板还包含约150 条虚拟记录的详细交易数据,让其更贴近真实分析产品。
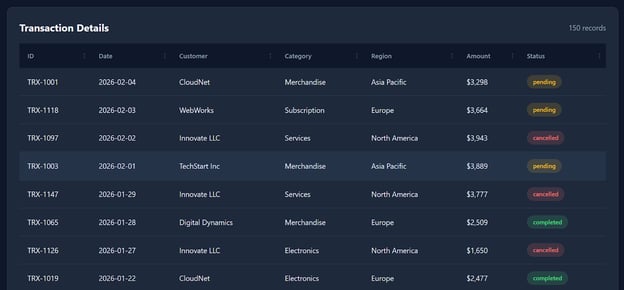
尽管并未生成所有可能的可视化(例如增加一张营收随时间变化的折线图会更好),但就一个在本地运行的量化模型而言,几乎一次成型地产出可用仪表板,仍然相当出色。
总体而言,从提示到可用产出,全流程仅耗时数分钟。
总结
坦率地说,我对Qwen3-Coder-Next 的体验有些复杂。
从纸面上看,评估显示它应当接近如Claude Sonnet 4.5 这类前沿模型的水平,而能在本地运行一款 80B MoE 编码模型确实令人兴奋。
在本教程中,我们成功以 CUDA 支持构建了 llama.cpp,下载了 Unsloth GGUF 量化,启动了本地推理服务器,并在数分钟内 vibe coding 出一个可用的分析仪表板。本地速度与响应性令人满意,尤其对于开源权重方案而言。
但在实践中,我并未稳定获得某些基准所暗示的“接近 Sonnet 水平”的可靠性。我花了几个小时尝试在更复杂的智能体环境(如opencode)中使用该模型,期间频繁遇到工具报错、生成不稳定、偶发循环输出等问题。
有趣的是,当我切换到使用更简单的Qwen Code CLI 工作流后,模型的可靠性明显提升。在这种场景中,它在直接编码任务、快速原型与 vibe coding 会话中表现良好,顺滑、快速,用起来确实有趣。
我的结论:Qwen3-Coder-Next 非常值得一试,尤其当您希望拥有无需云端 API 的强大本地编码助手时。但若要完全替代面向生产的编码智能体,我暂不推荐,除非您准备投入时间调试、微调 llama.cpp 设置,并针对您的硬件优化性能。
如果您希望进一步学习如何在工作流中使用 AI,建议查看 AI-Assisted Coding for Developers 课程。


Qwen3-Coder-Next 是 Qwen 团队推出的开源权重编码模型,面向智能体式编程与本地开发者工作流。它采用稀疏专家混合(MoE)设计,在支持长上下文和复杂多步任务的同时保持高效,并在现代编码与工具使用基准上表现强劲。
Qwen3-Coder-Next 特别令人兴奋之处在于,其性能与顶级闭源模型相当有竞争力。早期评估显示,它可接近Claude Sonnet 4.5等系统的水准,同时仍可在本地运行,完全掌控您的环境、隐私与速度,而无需依赖昂贵的托管 API。
来源:Qwen/Qwen3-Coder-Next
在本教程中,我们将从源码构建llama.cpp,使用 llama.cpp 推理服务器在本地运行 Qwen3-Coder-Next,然后将其连接到 Qwen Code CLI。最后,我们将进行 vibe coding,构建一个简单的数据分析仪表板。
Qwen3-Coder-Next 硬件与软件先决条件
在本地构建并运行Qwen3-Coder-Next之前,您需要一个可用的 Linux 开发环境,具备编译llama.cpp并运行 GGUF 模型所需的标准构建工具。
除了系统软件包,请确保您还具备:
首先更新系统并安装核心依赖:
如果您计划使用CUDA 加速,请确认您的 NVIDIA GPU 被正确识别:
我们的环境使用NVIDIA RTX 3090,配备24GB VRAM。由于 Qwen3-Coder-Next 在更大量化下所需内存超过该容量,剩余权重将自动脱载至系统内存,从而仍可在本地以良好性能运行模型。
为顺畅运行 Qwen3-Coder-Next,建议您的硬件满足以下大致内存目标:
如果可用内存不足 46GB,您仍可运行更小的量化版本(例如3-bit)。
一个简单的经验法则是:
磁盘 + 内存 + 显存 ≥ 量化大小
如果整个量化文件都能放入内存,您可以期待快速的本地性能;否则模型仍可通过脱载运行,但推理会更慢。
安装支持 CUDA 的 llama.cpp
在本地运行 Qwen3-Coder-Next 之前,我们需要一个快速的推理引擎。当前最受欢迎的选择是llama.cpp,它提供轻量级 GGUF 推理以及易于运行的本地服务器。
如果您想快速搭建,llama.cpp 为 macOS、Linux 和 Windows(包括启用 CUDA 的构建)提供预编译二进制文件。您可以直接从官方 GitHub 发布页下载:Release b7936 · ggml-org/llama.cpp。
通过预编译安装,您可以立即运行
llama.cpp的 CLI 工具或启动推理服务器,而无需自行编译。在本教程中,我们将手动构建 llama.cpp,而不是依赖预编译二进制文件,原因包括:
首先直接从 GitHub 下载官方 llama.cpp 源码,确保使用最新版本,包含最新 CUDA 改进与修复:
此时,您应位于
llama.cpp目录中,其中包含从头构建项目所需的一切。接下来我们使用CMake 配置构建系统。该步骤将生成必要的构建文件并通过 CUDA 启用 GPU 加速:
现在编译实际的推理服务器二进制文件。该组件将在本地承载 Qwen3-Coder-Next,并为编码工具与 CLI 集成提供 API 端点:
构建完成后,可执行文件位于
build/bin/目录。为便于在项目根目录直接运行,您可以这样复制:下载 Qwen3-Coder-Next 模型
安装好 llama.cpp 后,下一步从 Hugging Face 下载Qwen3-Coder-Next GGUF 模型。
开始前,请确保您已安装较新的Python(>= 3.11),因为 Hugging Face 工具与传输实用程序依赖它。
为高效下载大型 GGUF 文件,我们将使用 Hugging Face Hub 客户端及高速的 Xet 与传输后端:
接着,启用 Hugging Face 的优化传输后端:
现在我们可以下载 Qwen3-Coder-Next 的Unsloth 动态 GGUF 版本。本教程中我们将获取UD-Q4_K_XL 量化。
这是一个很好的默认选择,因为它在以下方面达成出色平衡:
其中Q4 格式表示模型被压缩至4-bit 精度,相比完整 FP16 权重更轻,同时仍保持令人印象深刻的输出质量。
命令执行后,模型文件将开始下载至您的本地目录。
在高速网络下通常只需几分钟。下载完成后,您即可将 GGUF 模型加载到llama-server 进行本地推理。
运行 Qwen3-Coder-Next 推理服务器
GGUF 模型下载完成后,我们即可使用
llama-server推理后端在本地启动Qwen3-Coder-Next。这将启动一个与 OpenAI 兼容的 API 服务器,供编码工具与 CLI 连接。运行以下命令:
关键参数说明:
--model:指向已下载的Qwen3-Coder-Next GGUF 检查点--alias:在 API 客户端中显示的友好模型名称--host 0.0.0.0:在所有网络接口上暴露服务器(便于远程访问)--port 8080:在8080 端口运行推理 API--threads 32:使用 32 个 CPU 线程以获得最大吞吐--threads-batch 32:并行化批处理以更快生成 token--ctx-size 20000:设置较大的上下文窗口(约 20K token),适合长时间编码会话--batch-size 1024:提升推理期间的 GPU 利用率--ubatch-size 256:控制微批以获得更平滑的性能--jinja:启用指令式模型所需的聊天模板格式--flash-attn on:启用 Flash Attention,加速长上下文推理--temp 0.7:保持输出专注同时具备一定创造性,利于 vibe coding--top-p 0.9:核采样,平衡多样性--min-p 0.05:过滤极低概率 token,获得更干净的补全--fit on:自动将层装入显存并将其余部分脱载至内存--swa off:关闭滑动窗口注意力(更适合全上下文任务)服务器启动后,请让其在该终端保持运行。然后打开一个新的终端标签页或会话,在不停止服务器的情况下测试 API。
在新终端中,您可以通过查询可用模型来确认一切正常:
如果服务器运行正常,您应在响应中看到Qwen3-Coder-Next,这意味着您的本地推理端点已就绪。
通过 Web UI 访问本地 Qwen3-Coder-Next API 端点
推理服务器运行后,您也可以通过内置的llama.cpp Web UI 直接与 Qwen3-Coder-Next 交互。
打开浏览器访问:http://127.0.0.1:8080。
这会启动一个类似 ChatGPT 的简单界面,您可以快速测试提示并验证模型响应是否正确。
例如,可让模型生成一些实用内容,比如一个基础的 Python 交易机器人。
令人印象深刻的是速度。在我们的环境中,Qwen3-Coder-Next 的生成速度约为每秒 44 个 token,让本地编码体验极为流畅,能够满足实时 vibe coding 的需求。
安装并设置 Qwen Code CLI
现在本地推理服务器已运行在 http://127.0.0.1:8080/v1,我们可以将其连接到Qwen Code CLI。这将为您提供一个轻量级的终端编码助手,通过与 OpenAI 兼容的 API 与本地 Qwen3-Coder-Next 通信。
Qwen Code CLI 基于 Node,因此您需要:
通过 NodeSource 安装 Node.js(推荐以获取正确版本):
全局安装 Qwen Code CLI:
验证是否安装成功:
Qwen CLI 期望使用 OpenAI 风格的环境变量。我们将创建一个简单的配置文件,告知它:
--alias设置的精确模型名称创建配置目录与
.env文件:现在启动 Qwen Code:
使用 Qwen3-Coder-Next 进行 Vibe Coding 打造分析仪表板
现在一切已在本地运行,我们可以开始使用vibe coding,通过Qwen Code CLI 构建一个简单的分析仪表板。
首先,新建项目文件夹并进入:
然后在该目录内启动 Qwen CLI:
现在给出一个清晰、简单的指令,例如:
“使用虚拟数据(销售、用户、营收、流失)构建一个 HTML 分析仪表板,包含 KPI 卡片、一个交互式表格、至少一个图表,并添加日期范围与类别筛选。”
数秒内,Qwen3-Coder-Next 即可理解需求,并在写代码前将任务拆解为结构化计划。
勾选清单后,模型一次性生成了完整、可运行的仪表板,包括:
index.htmlstyle.cssscript.js在浏览器中打开
index.html,您将立即看到一个现代、结构清晰的仪表板,具备干净的样式、KPI 卡片与逼真的占位指标。筛选器、表格交互与下载选项均可即开即用,运行顺畅。
继续向下滚动,仪表板还包含约150 条虚拟记录的详细交易数据,让其更贴近真实分析产品。
尽管并未生成所有可能的可视化(例如增加一张营收随时间变化的折线图会更好),但就一个在本地运行的量化模型而言,几乎一次成型地产出可用仪表板,仍然相当出色。
总体而言,从提示到可用产出,全流程仅耗时数分钟。
总结
坦率地说,我对Qwen3-Coder-Next 的体验有些复杂。
从纸面上看,评估显示它应当接近如Claude Sonnet 4.5 这类前沿模型的水平,而能在本地运行一款 80B MoE 编码模型确实令人兴奋。
在本教程中,我们成功以 CUDA 支持构建了 llama.cpp,下载了 Unsloth GGUF 量化,启动了本地推理服务器,并在数分钟内 vibe coding 出一个可用的分析仪表板。本地速度与响应性令人满意,尤其对于开源权重方案而言。
但在实践中,我并未稳定获得某些基准所暗示的“接近 Sonnet 水平”的可靠性。我花了几个小时尝试在更复杂的智能体环境(如opencode)中使用该模型,期间频繁遇到工具报错、生成不稳定、偶发循环输出等问题。
有趣的是,当我切换到使用更简单的Qwen Code CLI 工作流后,模型的可靠性明显提升。在这种场景中,它在直接编码任务、快速原型与 vibe coding 会话中表现良好,顺滑、快速,用起来确实有趣。
我的结论:Qwen3-Coder-Next 非常值得一试,尤其当您希望拥有无需云端 API 的强大本地编码助手时。但若要完全替代面向生产的编码智能体,我暂不推荐,除非您准备投入时间调试、微调 llama.cpp 设置,并针对您的硬件优化性能。
如果您希望进一步学习如何在工作流中使用 AI,建议查看 AI-Assisted Coding for Developers 课程。