
课程
使用 pandas 连接数据
4 小时
229.4K
SettingWithCopyWarning 是 Pandas 在我们对 DataFrame 执行赋值操作时可能抛出的警告。这在我们进行链式赋值或使用由切片创建的 DataFrame 时会发生。它是 Pandas 代码中常见的错误来源,很多人都遇到过。之所以难以调试,是因为这条警告可能出现在看起来应当能正常工作的代码中。
理解 SettingWithCopyWarning 很重要,因为它标示了数据操作可能存在的问题。该警告提示您的代码可能没有按预期修改数据,从而导致意料之外的结果以及难以排查的隐蔽性错误。
在本文中,我们将探讨 pandas 中的 SettingWithCopyWarning 以及如何避免它。我们还将讨论 Pandas 的未来,以及 copy_on_write 选项将如何改变我们处理 DataFrame 的方式。
当我们选择 DataFrame 的一个切片并将其赋给变量时,可能会得到一个视图,也可能会得到一个全新的 DataFrame 副本。
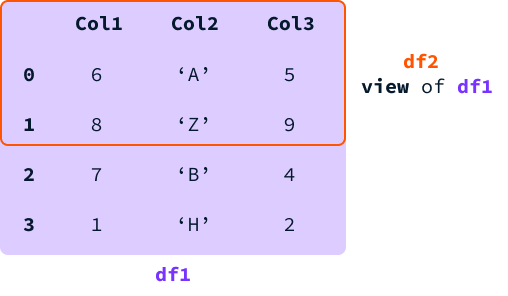
对于视图,两个 DataFrame 之间共享内存。这意味着修改两个 DataFrame 中都存在的某个单元格,会同时修改二者。
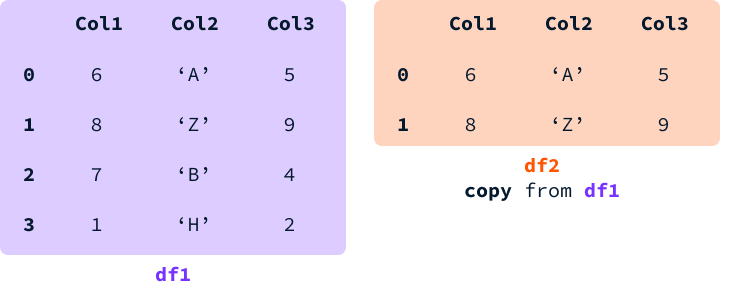
对于副本,会分配新的内存,并创建一个与原始 DataFrame 具有相同值的独立副本。在这种情况下,两个 DataFrame 是相互独立的,修改其中一个的值不会影响另一个。
为了优化性能,Pandas 会尽量避免在可以不创建副本时创建副本。然而,事先无法预测我们会得到视图还是副本。每当我们对一个不清楚是副本还是源自另一个 DataFrame 的视图的 DataFrame 进行赋值时,就会触发 SettingWithCopyWarning。
SettingWithCopyWarning我们将使用 Kaggle 的 Real Estate Data London 2024 数据集来了解 SettingWithCopyWarning 是如何出现的以及如何修复它。
该数据集包含伦敦近期的房地产数据。以下是数据集中各列的概览:
addedOn:房源被添加的日期。title:房源标题。descriptionHtml:房源的 HTML 描述。propertyType:房产类型。如果未指定类型,值为 "Not Specified"。sizeSqFeetMax:最大面积(平方英尺)。bedrooms:卧室数量。listingUpdatedReason:更新房源的原因(例如,新房源、降价)。price:房源价格(英镑)。假设我们被告知,未指定房产类型的房源都是独立屋。因此我们想将所有 propertyType 等于 "Not Specified" 的行更新为 "House"。一种做法是先将未指定房产类型的行筛选到一个临时 DataFrame 变量中,然后像这样更新 propertyType 列的值:
import pandas as pd
dataset_name = "realestate_data_london_2024_nov.csv"
df = pd.read_csv(dataset_name)

# Obtain all rows with unspecified property type
no_property_type = df[df["propertyType"] == "Not Specified"]

# Update the property type to “House” on those rows
no_property_type["propertyType"] = "House"
执行这段代码会让 pandas 抛出 SettingWithCopyWarning:
SettingWithCopyWarning:
A value is trying to be set on a copy of a slice from a DataFrame.
Try using .loc[row_indexer,col_indexer] = value instead
See the caveats in the documentation: https://pandas.pydata.org/pandas-docs/stable/user_guide/indexing.html#returning-a-view-versus-a-copy
  no_property_type["propertyType"] = "House"
原因是 pandas 无法知道 no_property_type 这个 DataFrame 是 df 的视图还是副本。
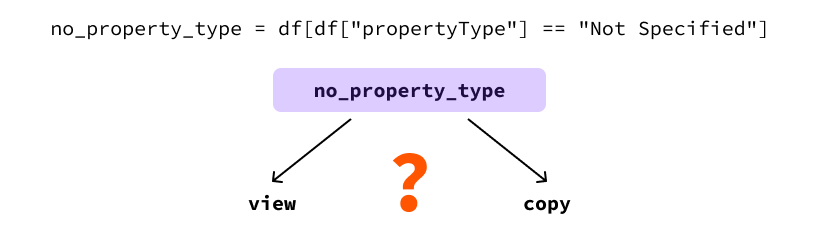
这是个问题,因为下面代码的行为会因其是视图还是副本而截然不同。
在这个例子中,我们的目标是修改原始 DataFrame。只有当 no_property_type 是视图时,这才会发生。如果我们的后续代码假设 df 已被修改,那这种假设可能是错误的,因为无法保证确实如此。由于这种不确定性,Pandas 才会抛出警告来告知我们这一点。
即使因为我们恰好得到了一个视图而使代码这次运行正常,将来再次运行时也可能得到一个副本,从而导致代码无法按预期工作。因此,请不要忽略这个警告,务必确保我们的代码始终能实现我们想要的行为。
在前一个示例中,临时变量的使用是显而易见的,因为我们明确地将 DataFrame 的一部分赋给了名为 no_property_type 的变量。
然而,有些情况下并不那么明显。SettingWithCopyWarning 最常见的出现场景是链式索引。假设我们把最后两行合并成一行:
df[df["propertyType"] == "Not Specified"]["propertyType"] = "House"乍一看,似乎并没有创建临时变量。但执行后同样会出现 SettingWithCopyWarning。
这段代码的执行过程如下:
df[df["propertyType"] == "Not Specified"] 被计算并暂存在内存中。 ["propertyType"]。 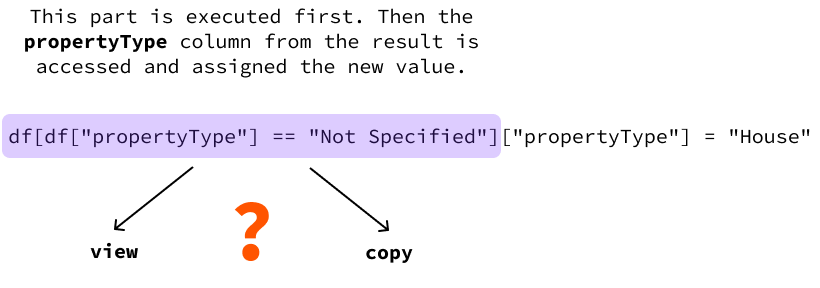
索引访问是逐步计算的,因此链式索引会产生相同的警告,因为我们不知道中间结果是视图还是副本。上述代码本质上等同于:
tmp = df[df["propertyType"] == "Not Specified"]
tmp["propertyType"] = "House"
这个例子通常被称为链式索引,因为我们用 [] 将索引访问“链”在一起。首先访问 [df["propertyType"] == "Not Specified"],然后访问 ["propertyType"]。
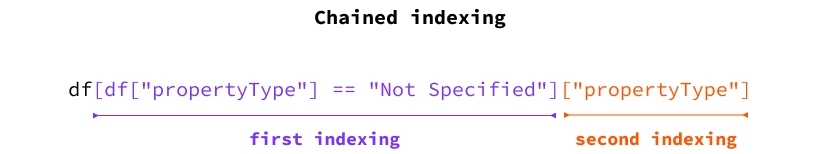
SettingWithCopyWarning让我们学习如何编写没有歧义、不会触发 SettingWithCopyWarning 的代码。我们已经知道,这个警告源于某个 DataFrame 是另一个 DataFrame 的视图还是副本这一点存在歧义。
解决方法是:确保我们创建的每个 DataFrame,要么明确是副本(如果我们想要副本),要么明确是视图(如果我们想要视图)。
loc 安全地修改原始 DataFrame 让我们修复上面的示例代码,我们的目标是修改原始 DataFrame。为避免使用临时变量,请使用 loc 索引器属性。
df.loc[df["propertyType"] == "Not Specified", "propertyType"] = "House"通过这段代码,我们是通过 loc 索引器直接作用于原始的 df DataFrame,因此不需要中间变量。当我们想直接修改原始 DataFrame 时,就应当这样做。
这段代码乍看像链式索引,因为仍然有参数,但其实不是。每次索引的界定是由方括号 [] 来决定的。
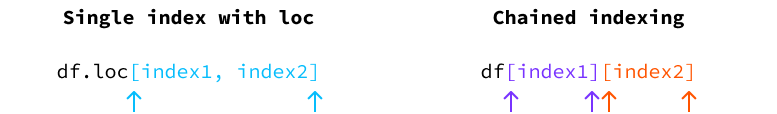
请注意,只有在我们直接进行赋值时,使用 loc 才是安全的,就像上面那样。如果我们改为使用临时变量,问题仍会重现。下面是两个不能修复问题的示例代码:
loc 与临时变量一起使用:# Using loc plus temporary variable doesn’t fix the issue
no_property_type = df.loc[df["propertyType"] == "Not Specified"]
no_property_type["propertyType"] = "House"loc 和再次索引结合(与链式索引相同):# Using loc plus indexing is the same as chained indexing
df.loc[df["propertyType"] == "Not Specified"]["propertyType"] = "House"这两个例子之所以容易让人困惑,是因为一个常见的误解是:只要用了 loc,我们就在修改原始数据。这是不正确的。确保将值赋给原始 DataFrame 的唯一方法,是使用单个 loc 直接赋值,而不要再进行单独的索引。
copy() 安全地处理原始 DataFrame 的副本当我们想确保在 DataFrame 的副本上进行操作时,应当使用 .copy() 方法。
假设我们被要求分析各房产的每平方英尺价格。我们不想修改原始数据。目标是创建一个包含分析结果的新 DataFrame,以便发送给其他团队。
第一步是过滤部分行并清洗数据。具体而言,我们需要:
sizeSqFeetMax 未定义的行。price 为 "POA"(按需报价)的行。"£25,000,000")上述步骤可以用以下代码实现:
# 1. Filter out all properties without a size or a price
properties_with_size_and_price = df[df["sizeSqFeetMax"].notna() & (df["price"] != "POA")]

# 2. Remove the £ and , characters from the price columns
properties_with_size_and_price["price"] = properties_with_size_and_price["price"].str.replace("£", "", regex=False).str.replace(",", "", regex=False)

# 3. Convert the price column to numeric values
properties_with_size_and_price["price"] = pd.to_numeric(properties_with_size_and_price["price"])
为计算每平方英尺价格,我们创建一个新列,其值为 price 列除以 sizeSqFeetMax 列的结果:
properties_with_size_and_price["pricePerSqFt"] = properties_with_size_and_price["price"] / properties_with_size_and_price["sizeSqFeetMax"]如果我们执行这段代码,又会得到 SettingWithCopyWarning。这并不意外,因为我们明确创建并修改了一个临时 DataFrame 变量 properties_with_size_and_price。
既然我们希望在数据的副本而非原始 DataFrame 上工作,就可以通过确保 properties_with_size_and_price 是一个全新的副本而非视图来修复问题——在第一行使用 .copy() 方法:
properties_with_size_and_price = df[df["sizeSqFeetMax"].notna() & (df["price"] != "POA")].copy()安全地添加新列
创建新列与赋值操作的行为相同。只要存在我们是在副本还是视图上操作的歧义,pandas 就会抛出 SettingWithCopyWarning。
如果我们要在副本上工作,应显式使用 .copy() 进行复制。之后,无论以何种方式赋值新列都可以。我们在前一个示例中创建 pricePerSqFt 列时就是这样做的。
另一方面,如果我们要修改原始 DataFrame,需要考虑两种情况。
note 列: df["notes"] = df["propertyType"].apply(lambda house_type: "Missing house type" if house_type == "Not Specified" else "")loc 索引器属性。例如:df.loc[df["propertyType"] == "Not Specified", "notes"] = "Missing house type"请注意,在这种情况下,未被选中的行在该列上的值将是未定义的,因此第一种方法更为可取,因为它允许我们为每一行指定一个值。
SettingWithCopyWarning 在 Pandas 3.0 中将变为错误目前,SettingWithCopyWarning 只是一个警告,而非错误。我们的代码仍会执行,Pandas 只是提示我们要小心。
根据 Pandas 官方文档,从 3.0 版本开始将不再使用 SettingWithCopyWarning,而是默认以实际错误替代,从而实施更严格的代码标准。
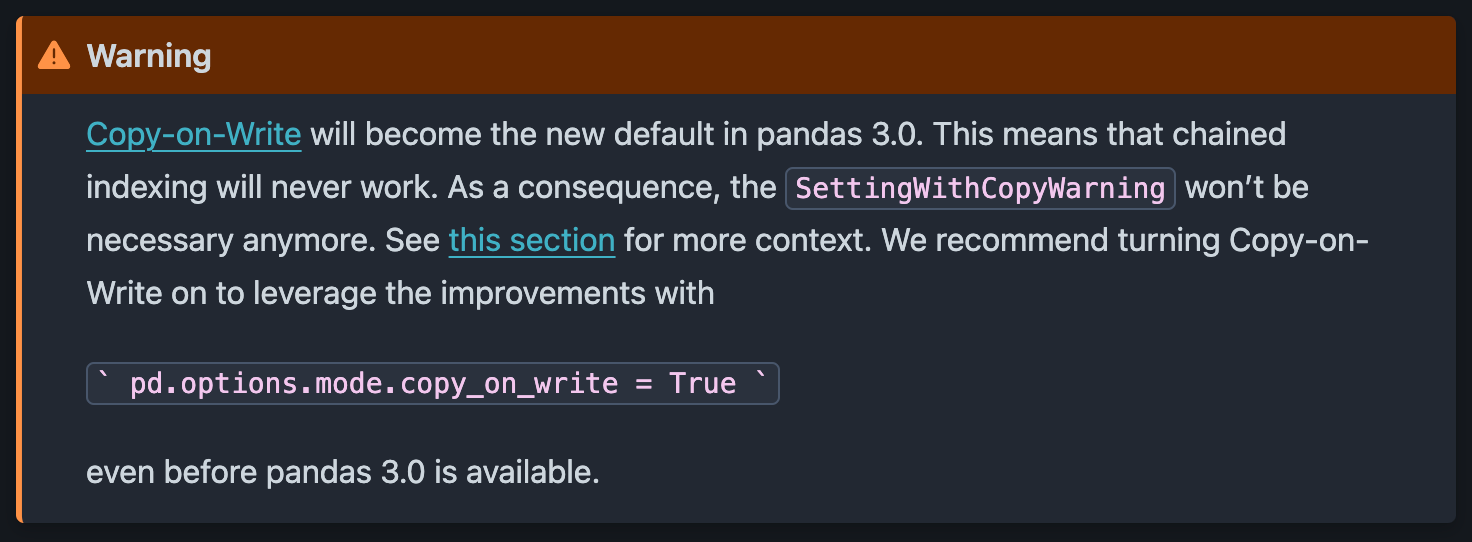
为确保我们的代码在未来版本的 pandas 中仍然兼容,建议现在就将其更新为抛出错误而非警告。
这可以在导入 pandas 之后设置如下选项来实现:
import pandas as pd
pd.options.mode.copy_on_write = True
将此添加到现有代码中,可以确保我们处理代码中的每个含糊赋值,并确保升级到 pandas 3.0 时代码仍能正常工作。
SettingWithCopyWarning 会在我们的代码使某个被修改的值究竟属于视图还是副本变得模糊不清时出现。我们可以通过始终明确表达意图来修复它:
copy() 方法显式复制。loc 索引器属性,并在访问数据时直接赋值,避免使用中间变量。尽管这不是错误,但不应忽视该警告,因为它可能导致意外结果。而且从 Pandas 3.0 开始,它将默认变为错误,因此我们应当通过在现有代码中开启 Copy-on-Write(pd.options.mode.copy_on_write = True)来为代码的未来做好准备。这将确保代码在 Pandas 的未来版本中仍然可用。
如需进一步学习 Pandas,可参考以下资源:
通过这些课程学习 Pandas!
课程
课程
课程