
कोर्स
pandas के साथ Data Joining
4 घंटा
229.5K
SettingWithCopyWarning एक चेतावनी है जो Pandas तब दिखा सकता है जब हम किसी DataFrame पर असाइनमेंट करते हैं। यह तब हो सकता है जब हम चेन किए गए असाइनमेंट का उपयोग करते हैं या जब हम किसी स्लाइस से बनाए गए DataFrame का उपयोग करते हैं। यह Pandas कोड में बग्स का एक सामान्य स्रोत है, जिसका सामना हम सभी ने किया है। इसे डिबग करना कठिन हो सकता है क्योंकि चेतावनी ऐसे कोड में भी दिखाई दे सकती है जो दिखने में ठीक काम करना चाहिए।
SettingWithCopyWarning को समझना इसलिए महत्वपूर्ण है क्योंकि यह डेटा मैनिपुलेशन में संभावित समस्याओं का संकेत देता है। यह चेतावनी बताती है कि आपका कोड संभवतः इरादे के मुताबिक डेटा को बदल नहीं रहा है, जिससे अनचाहे नतीजे और ऐसे बग आ सकते हैं जिनका पता लगाना मुश्किल है।
इस लेख में, हम pandas में SettingWithCopyWarning और इसे कैसे टाला जाए, इसका पता लगाएंगे। हम Pandas के भविष्य और copy_on_write विकल्प के बारे में भी चर्चा करेंगे कि यह DataFrames के साथ हमारे काम करने के तरीके को कैसे बदलेगा।
जब हम किसी DataFrame का स्लाइस चुनकर उसे किसी वेरिएबल को असाइन करते हैं, तो हमें या तो एक व्यू मिलता है या एक नया DataFrame कॉपी।
एक व्यू में, दोनों DataFrames के बीच मेमोरी साझा होती है। इसका मतलब है कि दोनों DataFrames में मौजूद किसी सेल का मान बदलने पर दोनों पर असर पड़ेगा।
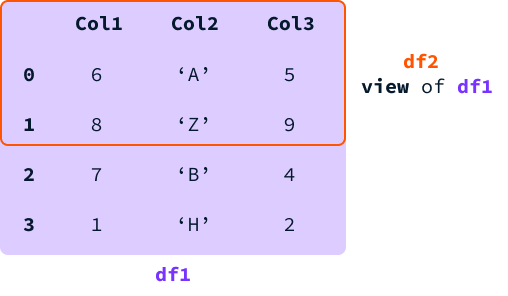
एक कॉपी में, नई मेमोरी अलॉट होती है और मूल DataFrame के समान मानों के साथ एक स्वतंत्र DataFrame बनता है। इस स्थिति में दोनों DataFrames अलग-अलग इकाइयाँ होती हैं, इसलिए एक में मान बदलने से दूसरे पर असर नहीं पड़ता।
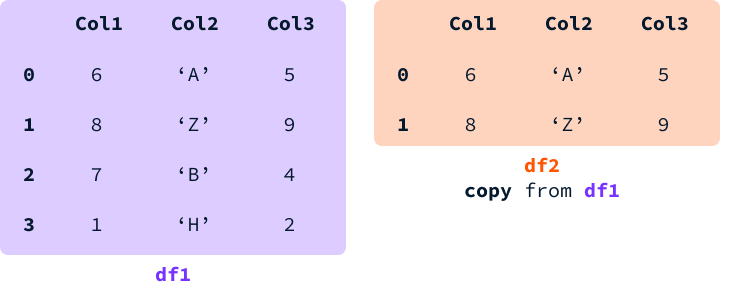
Pandas प्रदर्शन बेहतर करने के लिए जहाँ संभव हो कॉपी बनाने से बचने की कोशिश करता है। हालाँकि, यह पहले से बताना असंभव है कि हमें व्यू मिलेगा या कॉपी। SettingWithCopyWarning तब उठती है जब हम ऐसे DataFrame को मान असाइन करते हैं जिसके बारे में यह स्पष्ट नहीं है कि वह किसी अन्य DataFrame का व्यू है या कॉपी।
SettingWithCopyWarning को समझनाहम Real Estate Data London 2024 Kaggle डेटासेट का उपयोग करेंगे ताकि समझ सकें कि SettingWithCopyWarning कैसे होती है और इसे कैसे ठीक किया जाए।
यह डेटासेट लंदन के हालिया रियल एस्टेट डेटा को समाहित करता है। यहाँ डेटासेट में मौजूद कॉलम्स का एक अवलोकन है:
addedOn: वह तारीख जिस पर लिस्टिंग जोड़ी गई थी।title: लिस्टिंग का शीर्षक।descriptionHtml: लिस्टिंग का HTML विवरण।propertyType: प्रॉपर्टी का प्रकार। यदि प्रकार निर्दिष्ट नहीं है तो मान "Not Specified" होगा।sizeSqFeetMax: अधिकतम आकार (स्क्वायर फीट में)।bedrooms: बेडरूम की संख्या।listingUpdatedReason: लिस्टिंग अपडेट करने का कारण (जैसे नई लिस्टिंग, मूल्य में कमी)।price: लिस्टिंग का मूल्य (पाउंड में)।मान लीजिए हमें बताया गया है कि जिन प्रॉपर्टीज़ का प्रकार अनिर्दिष्ट है वे घर हैं। हम इसलिए उन सभी पंक्तियों को अपडेट करना चाहते हैं जिनमें propertyType "Not Specified" है, उन्हें "House" बना दें। इसे करने का एक तरीका है कि अनिर्दिष्ट प्रकार वाली पंक्तियों को एक अस्थायी DataFrame वेरिएबल में फ़िल्टर करें और फिर propertyType कॉलम के मान इस तरह अपडेट करें:
import pandas as pd
dataset_name = "realestate_data_london_2024_nov.csv"
df = pd.read_csv(dataset_name)

# Obtain all rows with unspecified property type
no_property_type = df[df["propertyType"] == "Not Specified"]

# Update the property type to “House” on those rows
no_property_type["propertyType"] = "House"
इस कोड को चलाने पर pandas SettingWithCopyWarning दिखाएगा:
SettingWithCopyWarning:
A value is trying to be set on a copy of a slice from a DataFrame.
Try using .loc[row_indexer,col_indexer] = value instead
See the caveats in the documentation: https://pandas.pydata.org/pandas-docs/stable/user_guide/indexing.html#returning-a-view-versus-a-copy
  no_property_type["propertyType"] = "House"
इसका कारण यह है कि pandas यह नहीं जान सकता कि no_property_type DataFrame, df का व्यू है या कॉपी।
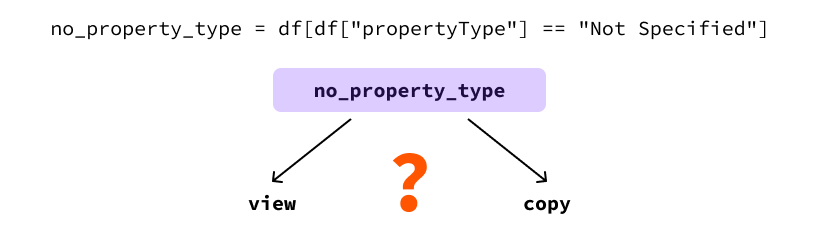
यह समस्या इसलिए है क्योंकि नीचे दिए गए कोड का व्यवहार व्यू या कॉपी होने पर काफी अलग हो सकता है।
इस उदाहरण में हमारा लक्ष्य मूल DataFrame को संशोधित करना है। यह केवल तब होगा जब no_property_type एक व्यू हो। यदि हमारे बाकी कोड में यह मान लिया गया है कि df संशोधित हो चुका है, तो यह गलत हो सकता है क्योंकि इस बात की कोई गारंटी नहीं है। इसी अनिश्चित व्यवहार के कारण Pandas यह चेतावनी देता है ताकि हमें इसकी जानकारी रहे।
भले ही हमारा कोड इसलिए सही चल जाए क्योंकि हमें व्यू मिला, आगे के रन में कॉपी मिल सकती है और कोड इच्छानुसार काम नहीं करेगा। इसलिए, इस चेतावनी को नज़रअंदाज़ न करना और यह सुनिश्चित करना महत्वपूर्ण है कि हमारा कोड हमेशा वही करेगा जो हम चाहते हैं।
पिछले उदाहरण में यह स्पष्ट था कि एक अस्थायी वेरिएबल उपयोग हो रहा है क्योंकि हम DataFrame के एक हिस्से को स्पष्ट रूप से no_property_type नाम के वेरिएबल में असाइन कर रहे हैं।
हालाँकि, कुछ मामलों में यह इतना स्पष्ट नहीं होता। SettingWithCopyWarning का सबसे सामान्य उदाहरण चेन किए गए इंडेक्सिंग के साथ आता है। मान लीजिए हम आख़िरी दो पंक्तियों को एक ही पंक्ति से बदल दें:
df[df["propertyType"] == "Not Specified"]["propertyType"] = "House"पहली नज़र में, ऐसा नहीं लगता कि कोई अस्थायी वेरिएबल बन रहा है। लेकिन इसे चलाने पर SettingWithCopyWarning फिर भी आती है।
यह कोड इस तरह निष्पादित होता है:
df[df["propertyType"] == "Not Specified"] का मूल्यांकन करके उसे अस्थायी रूप से मेमोरी में रखा जाता है। ["propertyType"] एक्सेस किया जाता है। 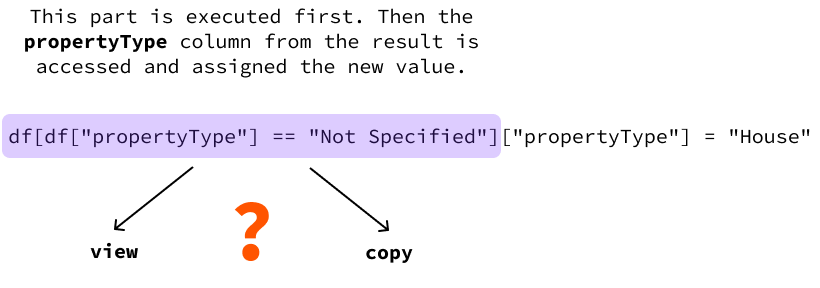
इंडेक्स एक्सेस एक-एक करके मूल्यांकित होते हैं, इसलिए चेन इंडेक्सिंग में वही चेतावनी आती है क्योंकि हमें नहीं पता कि मध्यवर्ती परिणाम व्यू हैं या कॉपी। ऊपर का कोड मूलतः ऐसा ही है जैसे कि:
tmp = df[df["propertyType"] == "Not Specified"]
tmp["propertyType"] = "House"
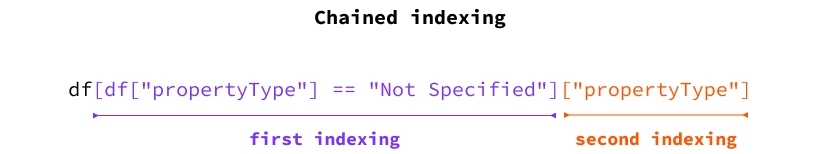
इस उदाहरण को अक्सर चेन इंडेक्सिंग कहा जाता है क्योंकि हम [] का उपयोग करते हुए इंडेक्स एक्सेस को चेन करते हैं। पहले हम [df["propertyType"] == "Not Specified"] एक्सेस करते हैं, फिर ["propertyType"]।
SettingWithCopyWarning को कैसे सुलझाएँआइए सीखें कि कोड कैसे लिखें ताकि कोई अस्पष्टता न रहे और SettingWithCopyWarning ट्रिगर न हो। हमने देखा कि चेतावनी इसलिए आती है क्योंकि यह अस्पष्ट है कि कोई DataFrame किसी दूसरे DataFrame का व्यू है या कॉपी।
इसे ठीक करने का तरीका यह है कि हम सुनिश्चित करें कि प्रत्येक बनाया गया DataFrame, हमारी ज़रूरत के अनुसार, या तो कॉपी हो या व्यू।
loc के साथ मूल DataFrame को सुरक्षित रूप से संशोधित करना ऊपर के उदाहरण का कोड ठीक करें जहाँ हम मूल DataFrame को संशोधित करना चाहते हैं। अस्थायी वेरिएबल से बचने के लिए loc इंडेक्सर प्रॉपर्टी का उपयोग करें।
df.loc[df["propertyType"] == "Not Specified", "propertyType"] = "House"इस कोड में, हम loc इंडेक्सर प्रॉपर्टी के माध्यम से सीधे मूल df DataFrame पर कार्य कर रहे हैं, इसलिए किसी मध्यवर्ती वेरिएबल की आवश्यकता नहीं है। जब हमें सीधे मूल DataFrame को संशोधित करना हो, यही तरीका अपनाना चाहिए।
पहली नज़र में यह चेन इंडेक्सिंग जैसा लग सकता है क्योंकि अभी भी पैरामीटर्स हैं, लेकिन ऐसा नहीं है। प्रत्येक इंडेक्सिंग को परिभाषित करने वाली चीज़ स्क्वायर ब्रैकेट्स [] हैं।
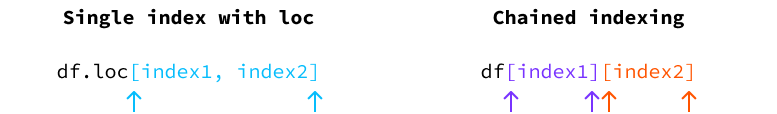
ध्यान दें कि loc का उपयोग तभी सुरक्षित है जब हम सीधे मान असाइन करें, जैसा कि ऊपर किया। यदि हम इसके बजाय अस्थायी वेरिएबल का उपयोग करते हैं, तो हम फिर से उसी समस्या में फँस जाते हैं। यहाँ दो उदाहरण हैं जो समस्या का समाधान नहीं करते:
loc का उपयोग:# Using loc plus temporary variable doesn’t fix the issue
no_property_type = df.loc[df["propertyType"] == "Not Specified"]
no_property_type["propertyType"] = "House"loc का उपयोग (चेन इंडेक्सिंग जैसा ही):# Using loc plus indexing is the same as chained indexing
df.loc[df["propertyType"] == "Not Specified"]["propertyType"] = "House"ये दोनों उदाहरण अक्सर लोगों को भ्रमित करते हैं क्योंकि एक आम गलतफ़हमी है कि जहाँ loc है, वहाँ हम मूल डेटा संशोधित कर रहे हैं। यह सही नहीं है। मूल DataFrame में मान असाइन होने की एकमात्र गारंटी यही है कि एकल loc के साथ सीधे असाइनमेंट करें, अलग इंडेक्सिंग के बिना।
copy() के साथ मूल DataFrame की कॉपी पर सुरक्षित रूप से काम करनाजब हमें यह सुनिश्चित करना हो कि हम DataFrame की कॉपी पर काम कर रहे हैं, तो हमें .copy() मेथड का उपयोग करना चाहिए।
मान लीजिए हमसे प्रॉपर्टीज़ के प्रति स्क्वायर फीट मूल्य का विश्लेषण करने को कहा गया है। हम मूल डेटा को संशोधित नहीं करना चाहते। लक्ष्य है विश्लेषण परिणामों के साथ एक नया DataFrame बनाना और उसे दूसरी टीम को भेजना।
पहला कदम है कुछ पंक्तियों को फ़िल्टर करना और डेटा को साफ़ करना। विशेष रूप से, हमें:
sizeSqFeetMax परिभाषित नहीं है।price "POA" (price on application) है।"£25,000,000")ऊपर दिए गए चरण निम्नलिखित कोड से किए जा सकते हैं:
# 1. Filter out all properties without a size or a price
properties_with_size_and_price = df[df["sizeSqFeetMax"].notna() & (df["price"] != "POA")]

# 2. Remove the £ and , characters from the price columns
properties_with_size_and_price["price"] = properties_with_size_and_price["price"].str.replace("£", "", regex=False).str.replace(",", "", regex=False)

# 3. Convert the price column to numeric values
properties_with_size_and_price["price"] = pd.to_numeric(properties_with_size_and_price["price"])
प्रति स्क्वायर फीट मूल्य निकालने के लिए, हम एक नया कॉलम बनाते हैं जिसके मान price कॉलम को sizeSqFeetMax कॉलम से भाग देने का परिणाम होते हैं:
properties_with_size_and_price["pricePerSqFt"] = properties_with_size_and_price["price"] / properties_with_size_and_price["sizeSqFeetMax"]यदि हम यह कोड चलाते हैं, तो हमें फिर से SettingWithCopyWarning मिलती है। यह आश्चर्य की बात नहीं होनी चाहिए क्योंकि हमने स्पष्ट रूप से एक अस्थायी DataFrame वेरिएबल properties_with_size_and_price बनाया और उसे संशोधित किया।
चूँकि हम मूल DataFrame के बजाय डेटा की कॉपी पर काम करना चाहते हैं, हम पहले लाइन पर .copy() मेथड का उपयोग करके सुनिश्चित कर सकते हैं कि properties_with_size_and_price एक नया DataFrame कॉपी है, व्यू नहीं:
properties_with_size_and_price = df[df["sizeSqFeetMax"].notna() & (df["price"] != "POA")].copy()नए कॉलम सुरक्षित रूप से जोड़ना
नए कॉलम बनाना भी असाइनमेंट जैसा ही व्यवहार करता है। जब भी यह अस्पष्ट होता है कि हम कॉपी पर काम कर रहे हैं या व्यू पर, pandas SettingWithCopyWarning उठाएगा।
यदि हम डेटा की कॉपी पर काम करना चाहते हैं, तो .copy() मेथड का उपयोग करके उसे स्पष्ट रूप से कॉपी कर लेना चाहिए। उसके बाद, हम नए कॉलम को किसी भी तरीके से असाइन कर सकते हैं। हमने यह पिछले उदाहरण में pricePerSqFt कॉलम बनाते समय किया था।
दूसरी ओर, यदि हम मूल DataFrame को संशोधित करना चाहते हैं, तो दो स्थितियाँ विचार करने लायक हैं।
note कॉलम जोड़ सकते हैं जहाँ हाउस टाइप गायब है: df["notes"] = df["propertyType"].apply(lambda house_type: "Missing house type" if house_type == "Not Specified" else "")loc इंडेक्सर प्रॉपर्टी का उपयोग कर सकते हैं। उदाहरण के लिए:df.loc[df["propertyType"] == "Not Specified", "notes"] = "Missing house type"ध्यान दें कि इस स्थिति में, जिन कॉलमों की पंक्तियाँ चयनित नहीं हुईं, उनमें मान अपरिभाषित रहेगा, इसलिए पहला तरीका बेहतर है क्योंकि इससे हम हर पंक्ति के लिए मान निर्दिष्ट कर सकते हैं।
SettingWithCopyWarning एररअभी, SettingWithCopyWarning सिर्फ एक चेतावनी है, एरर नहीं। हमारा कोड फिर भी चलता है और Pandas हमें सिर्फ सावधान रहने को कहता है।
आधिकारिक Pandas प्रलेखन के अनुसार, संस्करण 3.0 से SettingWithCopyWarning का उपयोग नहीं किया जाएगा और इसे डिफ़ॉल्ट रूप से वास्तविक एरर से बदला जाएगा, जिससे सख्त कोड मानक लागू होंगे।
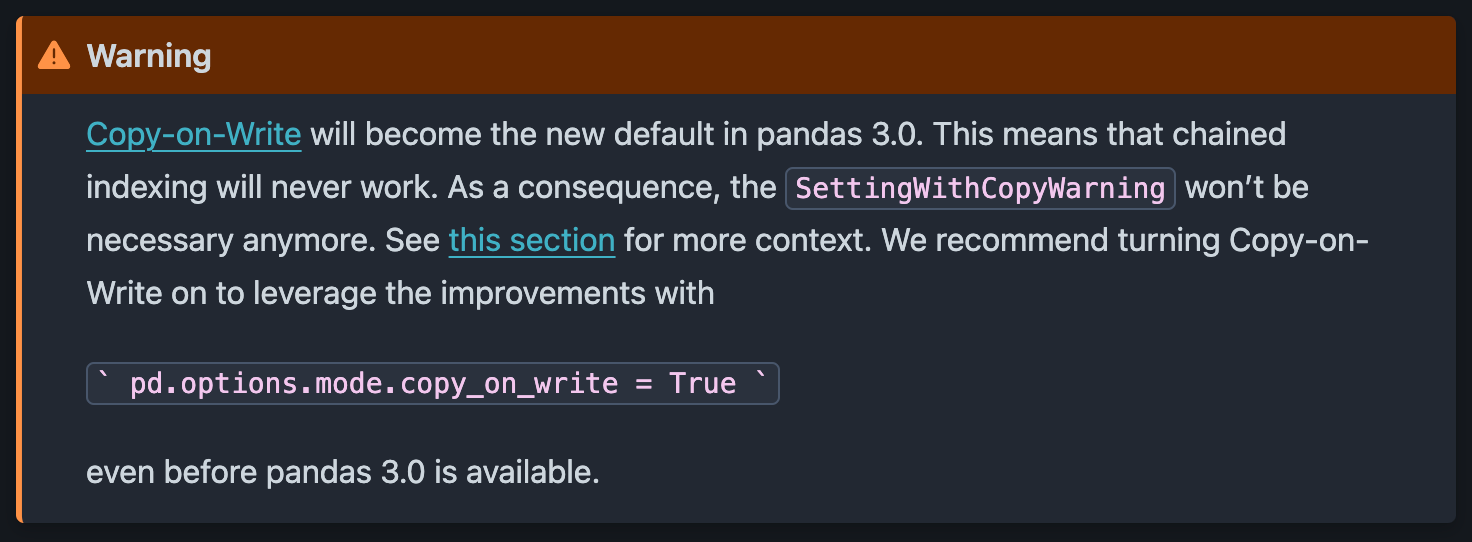
यह सुनिश्चित करने के लिए कि हमारा कोड pandas के भविष्य के संस्करणों के साथ संगत बना रहे, सलाह दी जाती है कि अभी से इसे चेतावनी के बजाय एरर उठाने के लिए अपडेट कर लें।
यह pandas आयात करने के बाद निम्न विकल्प सेट करके किया जाता है:
import pandas as pd
pd.options.mode.copy_on_write = True
इसे मौजूदा कोड में जोड़ने से हम अपने कोड में प्रत्येक अस्पष्ट असाइनमेंट को संभाल पाएँगे और pandas 3.0 में अपडेट करने पर भी कोड काम करता रहेगा।
SettingWithCopyWarning तब आती है जब हमारे कोड में यह अस्पष्ट होता है कि हम जिस मान में संशोधन कर रहे हैं वह व्यू है या कॉपी। इसे हम हमेशा अपने इरादे को स्पष्ट रखकर ठीक कर सकते हैं:
copy() मेथड का उपयोग करके उसे स्पष्ट रूप से कॉपी कर लें।loc इंडेक्सर प्रॉपर्टी का उपयोग करें और किसी मध्यवर्ती वेरिएबल के बिना डेटा एक्सेस करते हुए सीधे मान असाइन करें।भले ही यह एरर नहीं है, हमें इस चेतावनी को नज़रअंदाज़ नहीं करना चाहिए क्योंकि यह अप्रत्याशित परिणाम दे सकती है। साथ ही, Pandas 3.0 से यह डिफ़ॉल्ट रूप से एरर बन जाएगी, इसलिए हमें अपने मौजूदा कोड में pd.options.mode.copy_on_write = True का उपयोग करके Copy-on-Write चालू कर देना चाहिए। इससे भविष्य के Pandas संस्करणों के लिए कोड कार्यक्षम बना रहेगा।
Pandas के बारे में और जानने के लिए, ये संसाधन देखें:
इन कोर्सेज़ के साथ Pandas सीखें!
कोर्स
कोर्स
कोर्स