
Corso
Unire i dati con pandas
4 ore
228.3K
SettingWithCopyWarning è un avviso che Pandas può generare quando eseguiamo un'assegnazione su un DataFrame. Questo può accadere quando usiamo assegnazioni concatenate o quando usiamo un DataFrame creato da uno slice. È una fonte comune di bug nel codice Pandas: ci siamo passati tutti. Può essere difficile da debuggare perché l'avviso può apparire in codice che a prima vista sembra corretto.
Capire il SettingWithCopyWarning è importante perché segnala potenziali problemi nella manipolazione dei dati. Questo avviso suggerisce che il tuo codice potrebbe non stare modificando i dati come previsto, con conseguenze indesiderate e bug subdoli difficili da individuare.
In questo articolo esploreremo il SettingWithCopyWarning in pandas e come evitarlo. Parleremo anche del futuro di Pandas e di come l'opzione copy_on_write cambierà il modo in cui lavoriamo con i DataFrame.
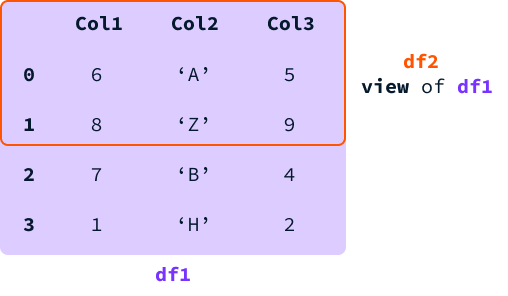
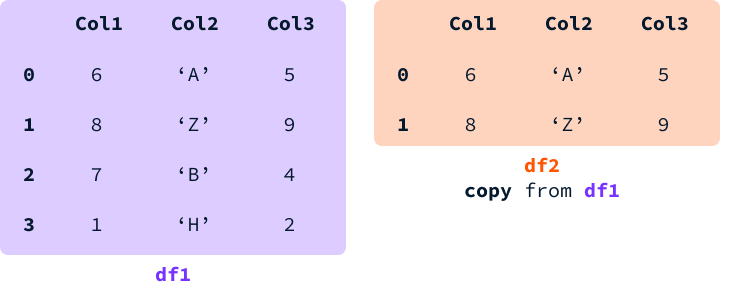
Quando selezioniamo uno slice di un DataFrame e lo assegniamo a una variabile, possiamo ottenere o una view o una nuova copia del DataFrame.
Con una view, la memoria tra i due DataFrame è condivisa. Questo significa che modificare un valore di una cella presente in entrambi i DataFrame li modificherà entrambi.
Con una copia, viene allocata nuova memoria e viene creato un DataFrame indipendente con gli stessi valori dell'originale. In questo caso i due DataFrame sono entità distinte, quindi modificare un valore in uno non influisce sull'altro.
Pandas cerca di evitare di creare copie quando può, per ottimizzare le prestazioni. Tuttavia, è impossibile prevedere in anticipo se otterremo una view o una copia. Il SettingWithCopyWarning viene generato ogni volta che assegniamo un valore a un DataFrame per il quale non è chiaro se sia una copia o una view di un altro DataFrame.
SettingWithCopyWarning con dati realiUseremo il dataset Kaggle Real Estate Data London 2024 per capire come si verifica il SettingWithCopyWarning e come risolverlo.
Questo dataset contiene dati immobiliari recenti di Londra. Ecco una panoramica delle colonne presenti nel dataset:
addedOn: La data in cui l'annuncio è stato aggiunto.title: Il titolo dell'annuncio.descriptionHtml: Una descrizione HTML dell'annuncio.propertyType: Il tipo di immobile. Il valore sarà "Not Specified" se il tipo non è stato specificato.sizeSqFeetMax: La metratura massima in piedi quadrati.bedrooms: Il numero di camere da letto.listingUpdatedReason: Motivo dell'aggiornamento dell'annuncio (ad esempio, nuovo annuncio, riduzione di prezzo).price: Il prezzo dell'annuncio in sterline.Supponiamo ci venga detto che gli immobili con tipo non specificato sono case. Vogliamo quindi aggiornare tutte le righe con propertyType uguale a "Not Specified" in "House". Un modo per farlo è filtrare le righe con tipo non specificato in una variabile DataFrame temporanea e aggiornare i valori della colonna propertyType così:
import pandas as pd
dataset_name = "realestate_data_london_2024_nov.csv"
df = pd.read_csv(dataset_name)

# Obtain all rows with unspecified property type
no_property_type = df[df["propertyType"] == "Not Specified"]

# Update the property type to “House” on those rows
no_property_type["propertyType"] = "House"
Eseguire questo codice farà sì che pandas mostri il SettingWithCopyWarning:
SettingWithCopyWarning:
A value is trying to be set on a copy of a slice from a DataFrame.
Try using .loc[row_indexer,col_indexer] = value instead
See the caveats in the documentation: https://pandas.pydata.org/pandas-docs/stable/user_guide/indexing.html#returning-a-view-versus-a-copy
  no_property_type["propertyType"] = "House"
Il motivo è che pandas non può sapere se il DataFrame no_property_type sia una view o una copia di df.
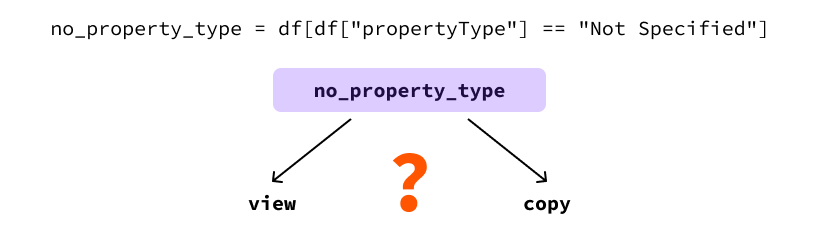
Questo è un problema perché il comportamento del codice seguente può essere molto diverso a seconda che sia una view o una copia.
In questo esempio, il nostro obiettivo è modificare il DataFrame originale. Questo avverrà solo se no_property_type è una view. Se il resto del nostro codice presume che df sia stato modificato, potrebbe essere sbagliato perché non c'è modo di garantire che sia così. A causa di questo comportamento incerto, Pandas genera l'avviso per segnalarcelo.
Anche se il nostro codice dovesse funzionare perché abbiamo ottenuto una view, in esecuzioni successive potremmo ottenere una copia e il codice non funzionerebbe come previsto. Perciò è importante non ignorare questo avviso e assicurarsi che il nostro codice faccia sempre ciò che vogliamo.
Nell'esempio precedente è chiaro che si sta usando una variabile temporanea perché stiamo esplicitamente assegnando una parte del DataFrame a una variabile chiamata no_property_type.
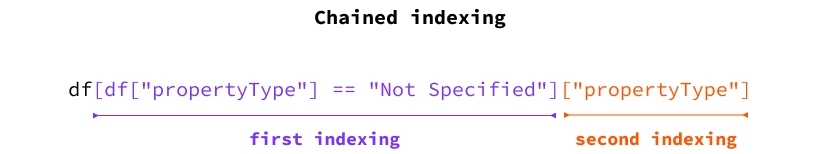
Tuttavia, in alcuni casi non è così esplicito. L'esempio più comune in cui si verifica il SettingWithCopyWarning è con l'indicizzazione concatenata. Supponiamo di sostituire le ultime due righe con una sola riga:
df[df["propertyType"] == "Not Specified"]["propertyType"] = "House"A prima vista, non sembra venga creata una variabile temporanea. Tuttavia, eseguendolo si ottiene comunque un SettingWithCopyWarning.
Il modo in cui viene eseguito questo codice è:
df[df["propertyType"] == "Not Specified"] viene valutato e memorizzato temporaneamente in memoria. ["propertyType"] di quella posizione di memoria temporanea. 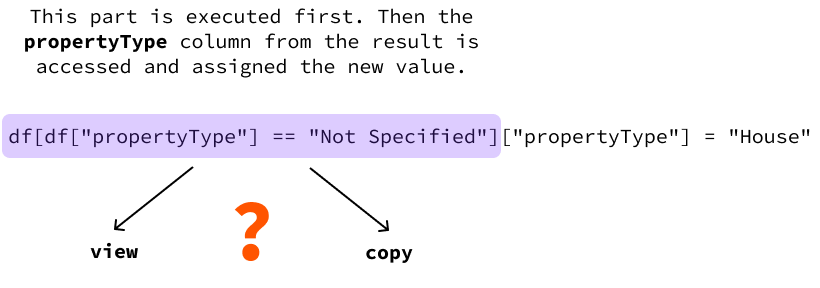
Gli accessi per indice vengono valutati uno alla volta e, quindi, l'indicizzazione concatenata produce lo stesso avviso perché non sappiamo se i risultati intermedi sono view o copie. Il codice sopra è essenzialmente equivalente a:
tmp = df[df["propertyType"] == "Not Specified"]
tmp["propertyType"] = "House"
Questo esempio è spesso chiamato indicizzazione concatenata perché concateniamo accessi indicizzati usando []. Prima accediamo a [df["propertyType"] == "Not Specified"] poi a ["propertyType"].
SettingWithCopyWarningVediamo come scrivere il nostro codice in modo che non ci sia ambiguità e il SettingWithCopyWarning non venga attivato. Abbiamo visto che l'avviso nasce dall'ambiguità sul fatto che un DataFrame sia una view o una copia di un altro DataFrame.
Il modo per risolverlo è garantire che ogni DataFrame che creiamo sia una copia se vogliamo una copia, o una view se vogliamo una view.
loc Correggiamo il codice dell'esempio sopra in cui vogliamo modificare il DataFrame originale. Per evitare di usare una variabile temporanea, usa la proprietà di indicizzazione loc.
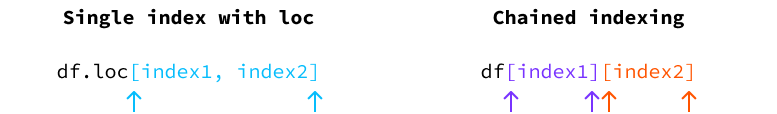
df.loc[df["propertyType"] == "Not Specified", "propertyType"] = "House"Con questo codice agiamo direttamente sul DataFrame originale df tramite la proprietà di indicizzazione loc, quindi non servono variabili intermedie. È ciò che dobbiamo fare quando vogliamo modificare direttamente il DataFrame originale.
A prima vista potrebbe sembrare indicizzazione concatenata perché ci sono ancora parametri, ma non lo è. Ciò che definisce ciascuna indicizzazione sono le parentesi quadre [].
Nota che usare loc è sicuro solo se assegniamo direttamente un valore, come sopra. Se invece usiamo una variabile temporanea, ricadiamo nello stesso problema. Ecco due esempi di codice che non risolvono il problema:
loc con una variabile temporanea:# Using loc plus temporary variable doesn’t fix the issue
no_property_type = df.loc[df["propertyType"] == "Not Specified"]
no_property_type["propertyType"] = "House"loc insieme a un indice (equivalente all'indicizzazione concatenata):# Using loc plus indexing is the same as chained indexing
df.loc[df["propertyType"] == "Not Specified"]["propertyType"] = "House"Questi esempi tendono a confondere perché è diffusa la convinzione che, finché c'è loc, stiamo modificando i dati originali. Non è così. L'unico modo per essere certi che il valore venga assegnato al DataFrame originale è assegnarlo direttamente usando un solo loc senza indicizzazioni separate.
copy()Quando vogliamo essere sicuri di operare su una copia del DataFrame, dovremmo usare il metodo .copy().
Poniamo di dover analizzare il prezzo per piede quadrato degli immobili. Non vogliamo modificare i dati originali. L'obiettivo è creare un nuovo DataFrame con i risultati dell'analisi da inviare a un altro team.
Il primo passo è filtrare alcune righe e ripulire i dati. In particolare, dobbiamo:
sizeSqFeetMax non è definito.price è "POA" (price on application)."£25,000,000")Possiamo eseguire i passaggi sopra con il seguente codice:
# 1. Filter out all properties without a size or a price
properties_with_size_and_price = df[df["sizeSqFeetMax"].notna() & (df["price"] != "POA")]

# 2. Remove the £ and , characters from the price columns
properties_with_size_and_price["price"] = properties_with_size_and_price["price"].str.replace("£", "", regex=False).str.replace(",", "", regex=False)

# 3. Convert the price column to numeric values
properties_with_size_and_price["price"] = pd.to_numeric(properties_with_size_and_price["price"])
Per calcolare il prezzo per piede quadrato, creiamo una nuova colonna i cui valori sono il risultato della divisione della colonna price per la colonna sizeSqFeetMax:
properties_with_size_and_price["pricePerSqFt"] = properties_with_size_and_price["price"] / properties_with_size_and_price["sizeSqFeetMax"]Se eseguiamo questo codice, otteniamo di nuovo il SettingWithCopyWarning. Non dovrebbe sorprenderci, perché abbiamo esplicitamente creato e modificato una variabile DataFrame temporanea properties_with_size_and_price.
Dato che vogliamo lavorare su una copia dei dati e non sul DataFrame originale, possiamo risolvere il problema assicurandoci che properties_with_size_and_price sia una nuova copia del DataFrame e non una view usando il metodo .copy() sulla prima riga:
properties_with_size_and_price = df[df["sizeSqFeetMax"].notna() & (df["price"] != "POA")].copy()Aggiungere nuove colonne in sicurezza
La creazione di nuove colonne si comporta allo stesso modo dell'assegnazione di valori. Ogni volta che è ambiguo se stiamo lavorando con una copia o una view, pandas genererà un SettingWithCopyWarning.
Se vogliamo lavorare con una copia dei dati, dovremmo copiarla esplicitamente con il metodo .copy(). Poi siamo liberi di assegnare una nuova colonna come preferiamo. L'abbiamo fatto quando abbiamo creato la colonna pricePerSqFt nell'esempio precedente.
D'altra parte, se vogliamo modificare il DataFrame originale, ci sono due casi da considerare.
note per ogni riga in cui manca il tipo di casa: df["notes"] = df["propertyType"].apply(lambda house_type: "Missing house type" if house_type == "Not Specified" else "")loc. Per esempio:df.loc[df["propertyType"] == "Not Specified", "notes"] = "Missing house type"Nota che in questo caso il valore nelle colonne non selezionate sarà indefinito, quindi il primo approccio è preferibile perché ci permette di specificare un valore per ogni riga.
SettingWithCopyWarning in Pandas 3.0Al momento, SettingWithCopyWarning è solo un avviso, non un errore. Il nostro codice viene comunque eseguito e Pandas si limita ad avvisarci di fare attenzione.
Secondo la documentazione ufficiale di Pandas, a partire dalla versione 3.0 il SettingWithCopyWarning non verrà più usato e sarà sostituito di default da un vero e proprio errore, imponendo standard di codice più rigorosi.
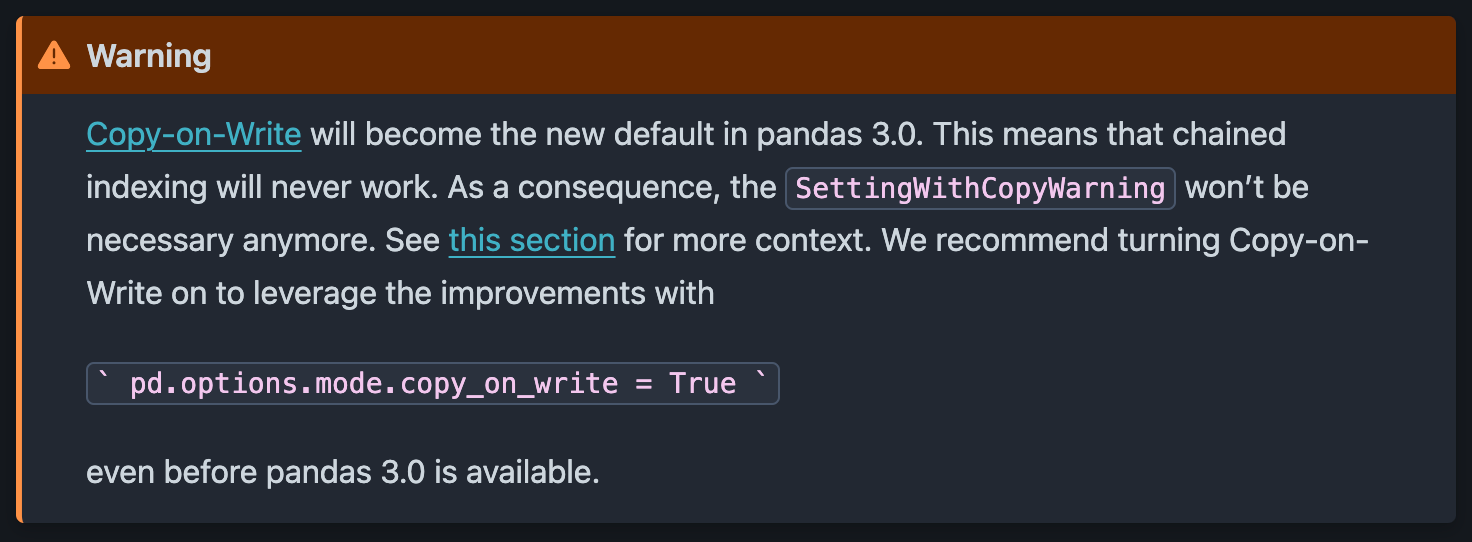
Per garantire che il nostro codice rimanga compatibile con le versioni future di pandas, è consigliabile aggiornarlo già ora in modo da generare un errore invece di un avviso.
Questo si fa impostando la seguente opzione dopo aver importato pandas:
import pandas as pd
pd.options.mode.copy_on_write = True
Aggiungerlo al codice esistente ci assicurerà di gestire ogni assegnazione ambigua e che il codice continui a funzionare quando aggiorneremo a pandas 3.0.
Il SettingWithCopyWarning si verifica quando nel nostro codice è ambiguo se il valore che stiamo modificando appartenga a una view o a una copia. Possiamo risolverlo essendo sempre espliciti su ciò che vogliamo:
copy().loc e assegnare il valore direttamente durante l'accesso ai dati, senza variabili intermedie.Pur non essendo un errore, non dovremmo ignorare questo avviso perché può portare a risultati inattesi. Inoltre, a partire da Pandas 3.0 diventerà un errore di default, quindi dovremmo rendere il nostro codice a prova di futuro attivando il Copy-on-Write nel codice attuale usando pd.options.mode.copy_on_write = True. Questo garantirà che il codice resti funzionante nelle versioni future di Pandas.
Per approfondire Pandas, dai un'occhiata a queste risorse:
Impara Pandas con questi corsi!
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



