

Torchchat 的功能
Torchchat 提供四项主要功能:
- 使用 Python 与 PyTorch 运行 LLM。
- 在无需 Python 的桌面应用或服务器上运行自包含模型。
- 在移动设备上执行模型。
- 评估模型性能。
使用 Python 与 PyTorch 运行 LLM
该模式允许在已安装 Python 与 PyTorch 的机器上运行 LLM。我们可以直接在终端与模型交互,或通过设置带有REST API的服务器进行交互。本文将重点讲解这种设置方式。
运行自包含模型
Torchchat 使用 AOT Inductor(Ahead-of-Time Inductor,提前编译)为 PyTorch 推理程序创建自包含、可分发的可执行文件,具体以动态库形式存在,对 Python 和 PyTorch 无依赖。
这种方法适用于需要在生产环境中部署模型的场景,可在服务环境更新与变化时确保模型运行时的稳定性,使模型无需重新编译即可持续工作。
AOT Inductor 专注于通过高效的二进制分发格式来优化模型部署,加载更快、即装即用,解决了如 TorchScript 等文本格式的限制与开销。其通过代码生成与优化技术同时提升 CPU 与 GPU 的性能,旨在降低开销并加快执行速度。
在移动设备上执行
在移动端执行方面,Torchchat 利用ExecuTorch。与 AOT Inductor 类似,ExecuTorch 会对模型进行优化,以便在移动或嵌入式设备上执行,并生成可用于后续执行模型的 PTE 工件。
评估模型
Torchchat 的评估模式可用于在 lm_eval 提供的各类任务上评估 LLM 的表现。对于希望在常用基准上评估其新模型的研究人员来说,这是一个重要功能。
为何使用 Torchchat
在本地运行 LLM,而非依赖第三方云端 API(如OpenAI 的 API),可覆盖多种使用场景并带来诸多益处,满足不同需求与情境。
- 重视隐私的应用:对于处理敏感数据的行业(如医疗、金融、法律),本地运行 LLM 可确保机密信息不离开组织基础设施,符合数据保护法规。
- 实时应用:对于需要低延迟响应的应用(如交互式聊天机器人、实时内容生成与在线监测系统),本地运行 LLM 可消除往返云 API 带来的网络延迟。
- 离线或低连接场景:在网络较差或无网络的环境(如野外调研、远程教育、机上娱乐系统)中,本地部署可确保 LLM 应用可用。
- 成本控制与优化:对于高频或持续使用场景,本地部署可能更具成本效益,可避免云 API 的按请求计费,并有机会利用现有算力资源。
如果您有兴趣进一步了解如何在设备本地而非云端运行 AI 模型,推荐阅读这篇关于边缘 AI(Edge AI)的博文。
使用 Python 的本地搭建
让我们一步步在本地设置 Torchchat。我们先从克隆 Torcchat 存储库开始。
克隆或下载代码
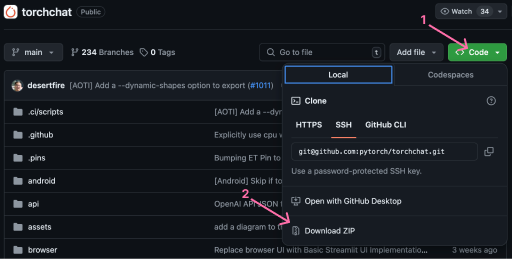
本地设置 Torchchat 的第一步是克隆Torchchat 存储库。安装Git 后,我们可以打开终端运行以下命令来克隆仓库:
git clone [email protected]:pytorch/torchchat.git或者,也可以通过 GitHub 界面下载该仓库。
安装
我们假定已安装 Python 3.10。关于如何安装 Python 的指南,请参阅这篇文章。
要安装 Torchchat,请在 Torchchat 文件夹中打开终端。首先创建一个虚拟环境:
python -m venv .venv简而言之,虚拟环境是项目的自包含目录,包含其所需 Python 库、包的安装目录,有时还包含特定版本的 Python。本机制可确保每个项目准确使用其所需的软件版本,不受其他项目及其依赖的干扰。
创建虚拟环境后,需要将其激活。可使用以下命令:
source .venv/bin/activate最后,我们需要通过安装 Torchchat 运行所需的全部依赖来完成环境设置。Torchchat 提供了安装脚本 install_requirements.sh,可以通过以下命令运行:
./install_requirements.sh至此,Torchchat 应已安装完成并可使用。我们可以通过列出可用的 Torchchat 命令来验证安装,如下:
python torchchat.py --help在本地使用 Torchchat(Python)
安装完成后,我们即可在本地机器上运行 LLM。
列出所有支持的模型
TorchChat 支持多种 LLM。可以使用 list 命令列出支持的模型:
python torchchat.py list模型的完整列表可在其 GitHub 仓库中查看。
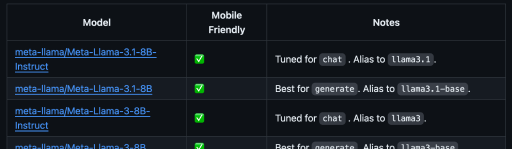
“Notes” 部分提供了关于模型的有用信息,例如最佳使用场景以及在使用 Torchchat 命令时指定模型所用的别名。
下载模型
Torchchat 通过 Hugging Face 分发模型。Hugging Face 是一个协作平台,提供工具,帮助任何人使用开源代码创建、训练与部署 NLP 与 ML 模型。想进一步了解,请参阅这篇博文:What Is Hugging Face。
在下载模型之前,我们需要:
- 安装 Hugging Face 命令行界面
- 在 Hugging Face 创建账户
- 创建访问令牌
- 使用 Hugging Face 命令行界面登录
安装 Hugging Face 命令行界面可使用 pip:
pip install huggingface_hub接着,前往Hugging Face 官网创建账户。创建完成后,可在个人资料设置中生成访问令牌:
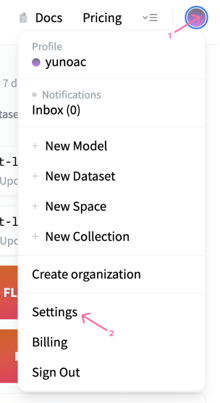
在个人资料中,打开 “Access Tokens” 菜单以创建新令牌:
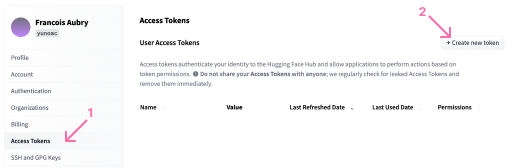
关于令牌权限,本文仅需读取权限。请注意,令牌创建后需要立即复制保存,后续将无法再次查看。
使用令牌,我们可以通过以下命令登录:
huggingface-cli login登录后,即可使用 download 命令下载模型。请注意,某些模型体积较大,请确保磁盘空间充足。演示中我们使用 stories15M 模型,这是一个小型的故事生成模型,下载较快且无需特殊权限,适合作为入门示例。
下载命令如下:
python torchchat.py download stories15M运行模型
下载完成后,可以使用 chat 或 generate 命令。要生成文本,需要通过 --prompt 参数提供提示词。示例如下:
python torchchat.py generate stories15M --prompt "Once upon a time"上述命令会指示 Torchchat 使用 stories15M 模型,以提示词 "Once upon a time" 生成文本。
要以聊天模式执行模型,可在不提供提示词的情况下使用 chat 命令。
python torchchat.py chat stories15M chat 命令会在终端启动交互式对话,您可以与 LLM 来回交流。请注意,有些模型更适合配合 generate 模式使用,而另一些则更适合 chat 模式。相关信息可在模型文档的 “Notes” 部分找到。
申请模型访问权限
某些模型(如 llama3)下载需要特殊访问权限。如果尝试下载此类模型,会收到错误信息:
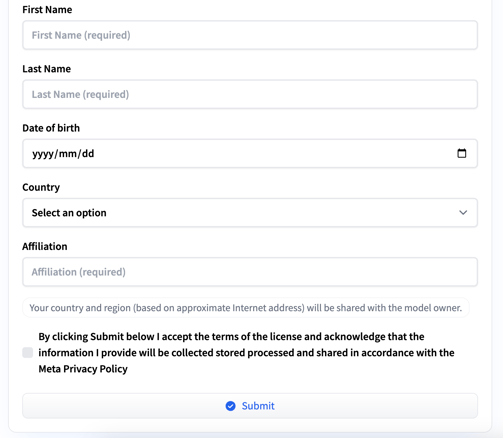
Access to model meta-llama/Meta-Llama-3-8B-Instruct is restricted and you are not in the authorized list. Visit https://huggingface.co/meta-llama/Meta-Llama-3-8B-Instruct to ask for access.可以按照错误信息中提供的 URL 提交访问申请。需要填写一份包含个人信息的简短表单并同意服务条款。获批后您会收到一封电子邮件。
高级用法
Torchchat 在本地运行 LLM 时提供了一些附加选项,可根据我们的需求与硬件进行适配。下面介绍其中几项。
控制精度
LLM 大量依赖矩阵乘法,即对众多浮点数进行运算。计算机中存在多种数据类型来以不同精度表示浮点数。
更高精度有助于在推理时更忠实地呈现训练中捕捉的细微差异,尤其适用于复杂任务或细腻的语言理解。但高精度也会显著降低推理速度。应根据速度与准确性的权衡选择合适的数据类型。
运行 LLM 时可通过 --dtype 参数设置数据类型,例如:
python torchchat.py chat --dtype fast stories15M即时编译(JIT)
--compile 标志用于启用模型的即时编译(JIT)。JIT 是一种在运行时将模型的部分动态编译为机器码以优化推理性能的技术,而不是每次都进行解释执行。该方法可在多种硬件平台上显著提升效率与速度。
使用 JIT 会因额外的编译步骤导致启动时间更长,但推理速度更快。以下示例展示了结合 JIT 使用 chat 的方式:
python torchchat.py chat --compile stories15M请注意,该选项可能并非在所有硬件上都受支持。在这种情况下,Torchchat 会忽略编译步骤并直接运行 LLM。
量化
量化是一种在不显著降低性能或准确性的前提下,缩小模型体积并提升推理速度的技术。这对在边缘设备上部署 LLM或资源(算力、内存、带宽)受限的环境尤为重要。
简言之,量化是将神经网络的权重与激活由浮点表示(通常为 32 位浮点)转换为更低位宽的表示,如 16 位整数、8 位整数,甚至在某些情况下为二值表示。
这与使用 --dtype 设置精度不同。量化直接作用于模型权重,生成更小的模型;而数据类型控制的是推理计算中所使用的数据类型。
在 Torchchat 中使用量化需要一个 JSON 配置文件,用法如下:
python torchchat.py chat --quantize config.json stories15M关于 config.json 配置文件的格式及 Torchchat 中量化的工作原理,请参阅其量化文档页面。
设备指定
我们可以通过 --device 选项指定执行 LLM 的设备。例如,要在 CUDA 上运行,可使用:
python torchchat.py chat --device cuda stories15M结语
Torchchat 是推动 LLM 推理普及的重要一步。它让任何人都能在各类设备上高效运行 LLM。
Torchchat 的功能远不止本文介绍的内容。我们已提供在电脑上使用 Python 与 PyTorch 本地运行 LLM 的入门说明。强烈建议您继续深入探索 Torchchat。

大型语言模型(LLM)现已成为众多技术领域不可或缺的一部分,大多数产品都融入了一定程度的 LLM 功能。然而,由于硬件限制,将这些模型部署到笔记本、台式机或智能手机等个人设备上长期面临重大障碍。
为此,PyTorch 团队推出了 Torchchat,这是一个可适配的框架,旨在提升 LLM 在多种硬件平台上的效率。这一突破性方法便于在各类设备上本地高效处理,有望让先进的 AI 模型更为易用。
PyTorch 是由 Facebook 的 AI 研究院(FAIR)开发的领先开源机器学习框架,支持包括计算机视觉与自然语言处理等多种应用。
本文将概述 Torchchat 的功能,并学习如何在本地完成设置。