Torchchat की क्षमताएँ
Torchchat चार प्रमुख कार्यक्षमताएँ प्रदान करता है:
- Python और PyTorch के साथ LLMs चलाना।
- Python के बिना डेस्कटॉप एप्लिकेशन या सर्वर पर स्व-निहित (self-contained) मॉडल चलाना।
- मोबाइल डिवाइस पर मॉडल निष्पादित करना।
- किसी मॉडल के प्रदर्शन का आकलन करना।
PyTorch के साथ Python का उपयोग करके LLMs चलाएँ
यह मोड ऐसे मशीन पर LLM चलाने में सक्षम बनाता है जिस पर Python और PyTorch इंस्टॉल हों। हम टर्मिनल में सीधे मॉडल के साथ इंटरैक्ट कर सकते हैं या REST API के साथ सर्वर सेटअप करके भी। इस लेख में हम इसी सेटअप पर ध्यान देंगे।
स्व-निहित मॉडल चलाना
Torchchat, AOT Inductor (Ahead-of-Time Inductor) का उपयोग करता है ताकि PyTorch इनफ़रेंस प्रोग्रामों के लिए स्व-निहित, वितरित करने योग्य executable बनाया जा सके, विशेष रूप से एक डायनेमिक लाइब्रेरी के रूप में जिसकी Python और PyTorch पर कोई निर्भरता नहीं होती।
यह तरीका ऐसे प्रोडक्शन वातावरण में मॉडल डिप्लॉय करने की आवश्यकता को पूरा करता है जहाँ सर्विंग एन्वायरमेंट में अपडेट और बदलावों के बीच मॉडल रनटाइम स्थिरता आवश्यक होती है, जिससे बिना दोबारा कंपाइल किए मॉडल चालू रहें।
AOT Inductor मॉडल डिप्लॉयमेंट को अनुकूलित करने पर केंद्रित है, ताकि प्रभावी, बाइनरी वितरण स्वरूप सक्षम हों जो तेज़ी से लोड हों और तुरंत निष्पादन के लिए तैयार हों, और TorchScript जैसे टेक्स्ट फ़ॉर्मैट से जुड़े सीमाओं और ओवरहेड को संबोधित किया जा सके। यह CPU और GPU दोनों प्रदर्शन के लिए कोड जेनरेशन और अनुकूलन तकनीकों का लाभ उठाता है, जिसका उद्देश्य ओवरहेड कम करना और निष्पादन गति में सुधार करना है।
मोबाइल डिवाइस पर निष्पादन
मोबाइल डिवाइस निष्पादन के लिए, Torchchat ExecuTorch का उपयोग करता है। AOT Inductor की तरह, ExecuTorch मॉडल को मोबाइल या एम्बेडेड डिवाइस पर निष्पादन के लिए अनुकूलित करता है। यह एक PTE आर्टिफैक्ट तैयार करता है जिसे बाद में मॉडल निष्पादन के लिए उपयोग किया जा सकता है।
किसी मॉडल का मूल्यांकन
Torchchat का मूल्यांकन मोड lm_eval में उपलब्ध विभिन्न कार्यों पर किसी LLM के प्रदर्शन का आकलन करने के लिए उपयोग किया जा सकता है। यह उन शोधकर्ताओं के लिए एक महत्वपूर्ण सुविधा है जो अपने नए मॉडलों का आम तौर पर उपयोग होने वाले बेंचमार्क पर मूल्यांकन करना चाहते हैं।
Torchchat क्यों उपयोग करें
LLM को स्थानीय रूप से चलाना, किसी तृतीय-पक्ष क्लाउड API जैसे Open AI के API पर निर्भर होने के बजाय, विभिन्न उपयोग मामलों और लाभों को प्रस्तुत करता है, जो अलग-अलग ज़रूरतों और परिदृश्यों के अनुरूप हैं।
- गोपनीयता-संवेदनशील अनुप्रयोग: स्वास्थ्य सेवा, वित्त और विधि जैसे संवेदनशील डेटा से जुड़े उद्योगों के लिए, LLMs को स्थानीय रूप से चलाने से गोपनीय जानकारी संगठन के बुनियादी ढांचे से बाहर नहीं जाती, और डेटा संरक्षण विनियमों का पालन होता है।
- रियल-टाइम अनुप्रयोग: कम-विलंबता प्रतिक्रियाओं की आवश्यकता वाले अनुप्रयोग, जैसे इंटरैक्टिव चैटबॉट, रियल-टाइम सामग्री निर्माण और लाइव मॉनिटरिंग सिस्टम, LLMs को स्थानीय रूप से चलाने से लाभान्वित हो सकते हैं, क्योंकि यह क्लाउड API से आने-जाने वाले नेटवर्क ट्रांसमिशन की देरी को समाप्त करता है।
- ऑफलाइन या कम कनेक्टिविटी वाले परिदृश्य: जहाँ इंटरनेट कनेक्टिविटी कमजोर या उपलब्ध नहीं है, वहाँ स्थानीय डिप्लॉयमेंट से फील्ड रिसर्च, दूरस्थ शिक्षा और इन-फ़्लाइट एंटरटेनमेंट सिस्टम जैसे LLM अनुप्रयोगों का उपयोग संभव होता है।
- लागत नियंत्रण और अनुकूलन: उच्च-वॉल्यूम या निरंतर-उपयोग वाले मामलों में, स्थानीय डिप्लॉयमेंट अधिक किफायती हो सकता है, क्लाउड APIs के प्रति-रिक्वेस्ट प्राइसिंग मॉडल से बचते हुए और मौजूदा संगणनात्मक संसाधनों का लाभ उठाते हुए।
यदि आप क्लाउड के बजाय किसी डिवाइस पर AI मॉडल को स्थानीय रूप से चलाने के बारे में अधिक जानना चाहते हैं, तो Edge AI पर यह ब्लॉग पोस्ट देखें।
Python के साथ स्थानीय सेटअप
आइए Torchchat को स्थानीय रूप से चरण-दर-चरण सेटअप करें। हम Torcchat रिपॉज़िटरी को क्लोन करने से शुरू करेंगे।
कोड क्लोन या डाउनलोड करें
Torchchat को स्थानीय रूप से सेटअप करने का पहला कदम है Torchchat रिपॉज़िटरी को क्लोन करना। Git इंस्टॉल होने पर, हम टर्मिनल खोलकर यह कमांड चलाकर रिपॉज़िटरी क्लोन कर सकते हैं:
git clone git@github.com:pytorch/torchchat.gitवैकल्पिक रूप से, हम Github इंटरफ़ेस का उपयोग करके रिपॉज़िटरी डाउनलोड कर सकते हैं।
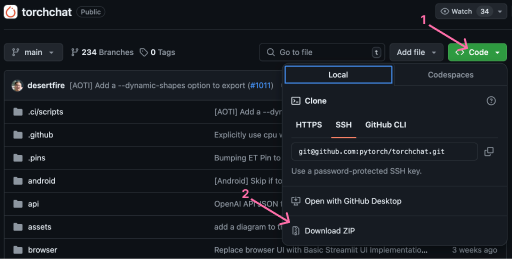
इंस्टॉलेशन
हम मान लेते हैं कि Python 3.10 पहले से इंस्टॉल है। Python कैसे इंस्टॉल करें, इस पर मार्गदर्शिका के लिए यह लेख देखें।
Torchchat इंस्टॉल करने के लिए, Torchchat फ़ोल्डर में एक टर्मिनल खोलें। हम वर्चुअल एन्वायरमेंट बनाकर शुरू करते हैं:
python -m venv .venvसंक्षेप में, एक वर्चुअल एन्वायरमेंट किसी प्रोजेक्ट के लिए स्व-निहित डायरेक्टरी होती है, जिसमें Python लाइब्रेरियों, पैकेजों और कभी-कभी स्वयं Python के किसी विशिष्ट संस्करण की इंस्टॉलेशन डायरेक्टरियाँ शामिल होती हैं। यह सुनिश्चित करता है कि प्रत्येक प्रोजेक्ट के पास वही सॉफ़्टवेयर संस्करण हों जिनकी उसे चलने के लिए आवश्यकता है, अन्य प्रोजेक्ट्स और उनकी आवश्यकताओं के हस्तक्षेप के बिना।
वर्चुअल एन्वायरमेंट बनने के बाद, हमें उसे सक्रिय करना होगा। हम यह कमांड चलाकर कर सकते हैं:
source .venv/bin/activateअंत में, हमें सभी निर्भरताएँ इंस्टॉल करके वातावरण सेटअप करना होगा जो Torchchat चलाने के लिए आवश्यक हैं। Torchchat एक इंस्टॉलेशन स्क्रिप्ट install_requirements.sh प्रदान करता है, जिसे हम इस कमांड के साथ चला सकते हैं:
./install_requirements.shअब Torchchat इंस्टॉल हो जाना चाहिए और उपयोग के लिए तैयार होना चाहिए। हम इस तरह उपलब्ध Torchchat कमांड्स लिस्ट करके इंस्टॉलेशन सत्यापित कर सकते हैं:
python torchchat.py --helpPython के साथ स्थानीय रूप से Torchchat का उपयोग
Torchchat इंस्टॉल होने के बाद, हम अपने लोकल मशीन पर LLMs चलाना शुरू कर सकते हैं।
सभी समर्थित मॉडलों की सूची बनाना
TorchChat कई प्रकार के LLMs को सपोर्ट करता है। हम list कमांड का उपयोग करके समर्थित मॉडलों की सूची प्राप्त कर सकते हैं:
python torchchat.py listमॉडलों की पूरी सूची उनके GitHub रिपॉज़िटरी में मिल सकती है।
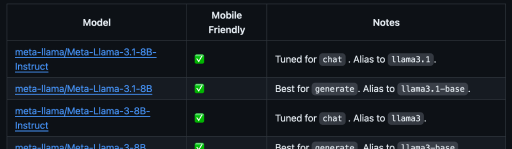
“Notes” अनुभाग मॉडल के बारे में उपयोगी जानकारी देता है, जैसे सर्वोत्तम उपयोग का मामला और Torchchat कमांड्स का उपयोग करते समय मॉडल निर्दिष्ट करने के लिए प्रयुक्त मॉडल उपनाम।
किसी मॉडल को डाउनलोड करना
Torchchat, मॉडलों के लिए वितरण चैनल के रूप में Hugging Face का उपयोग करता है। Hugging Face एक सहयोगी प्लेटफ़ॉर्म है जिसमें ऐसे टूल हैं जो किसी को भी ओपन-सोर्स कोड का उपयोग करके NLP और ML मॉडल बनाने, प्रशिक्षित करने और डिप्लॉय करने में सक्षम बनाते हैं। इसके बारे में अधिक जानने के लिए, What Is Hugging Face पर यह ब्लॉग पोस्ट देखें।
किसी मॉडल को डाउनलोड करने से पहले, हमें यह करना होगा:
- Hugging Face कमांड लाइन इंटरफ़ेस इंस्टॉल करें
- Hugging Face पर एक खाता बनाएँ
- एक एक्सेस टोकन बनाएँ
- Hugging Face कमांड लाइन इंटरफ़ेस का उपयोग करके लॉगिन करें
Hugging Face कमांड लाइन इंटरफ़ेस इंस्टॉल करने के लिए, हम pip का उपयोग करते हैं:
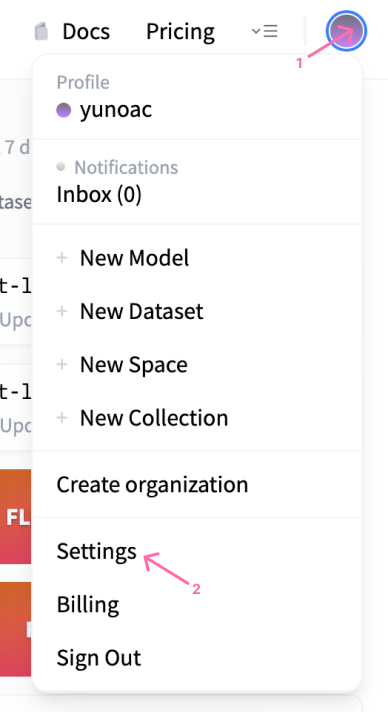
pip install huggingface_hubफिर, हम खाता बनाने के लिए Hugging Face वेबसाइट पर जा सकते हैं। खाता बनाने के बाद, हम प्रोफ़ाइल सेटिंग्स पर जाकर एक एक्सेस टोकन बना सकते हैं:
प्रोफ़ाइल में, हम “Access Tokens” मेनू खोलकर नया टोकन बना सकते हैं:
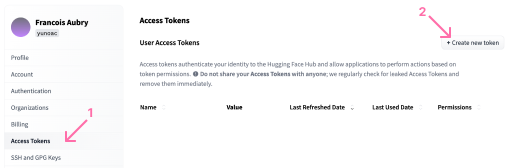
टोकन अनुमतियों के संदर्भ में, इस लेख के लिए read अनुमतियाँ पर्याप्त हैं। ध्यान दें कि टोकन बनने पर हमें उसे क्लिपबोर्ड पर कॉपी करना होगा क्योंकि बाद में हम उसे फिर से नहीं देख पाएँगे।
टोकन का उपयोग करके, हम इस कमांड से लॉगिन कर सकते हैं:
huggingface-cli loginलॉगिन होने के बाद, हम download कमांड का उपयोग करके कोई मॉडल डाउनलोड कर सकते हैं। ध्यान दें कि इन मॉडलों में से कुछ काफ़ी बड़े हो सकते हैं, इसलिए सुनिश्चित करें कि आपके पास पर्याप्त डिस्क स्पेस हो। उदाहरण के लिए, हम stories15M मॉडल का उपयोग करेंगे, जो एक छोटा स्टोरी जनरेशन मॉडल है। यह शुरू करने के लिए अच्छा मॉडल है क्योंकि इसे तेज़ी से डाउनलोड किया जा सकता है और इसे विशेष अनुमतियों की आवश्यकता नहीं होती।
इसे डाउनलोड करने के लिए, हम यह करते हैं:
python torchchat.py download stories15Mकिसी मॉडल को चलाना
मॉडल डाउनलोड करने के बाद, हम chat या generate कमांड का उपयोग कर सकते हैं। टेक्स्ट जनरेट करने के लिए, हमें --prompt आर्ग्युमेंट का उपयोग करके एक प्रॉम्प्ट देना होगा। यहाँ एक उदाहरण है:
python torchchat.py generate stories15M --prompt “Once upon a time”उपरोक्त कमांड Torchchat को stories15M मॉडल का उपयोग करते हुए प्रॉम्प्ट ”Once upon a time” के साथ टेक्स्ट जनरेट करने का निर्देश देगा।
मॉडल को चैट मोड में चलाने के लिए, हम बिना प्रॉम्प्ट के chat कमांड का उपयोग करते हैं।
python torchchat.py chat stories15M chat कमांड टर्मिनल में एक इंटरऐक्टिव चैट शुरू करेगा, जहाँ हम LLM के साथ आगे-पीछे चैट कर सकते हैं। ध्यान दें कि कुछ मॉडल generate मोड के साथ उपयोग के लिए अधिक उपयुक्त हैं, जबकि अन्य chat मोड के लिए बेहतर हैं। यह जानकारी मॉडल प्रलेखन के “Notes” अनुभाग में उपलब्ध है।
किसी मॉडल के लिए एक्सेस का अनुरोध
कुछ मॉडल, जैसे llama3, को डाउनलोड करने के लिए विशेष एक्सेस की आवश्यकता होती है। यदि हम ऐसे किसी मॉडल को डाउनलोड करने का प्रयास करते हैं, तो हमें एक त्रुटि संदेश मिलेगा:
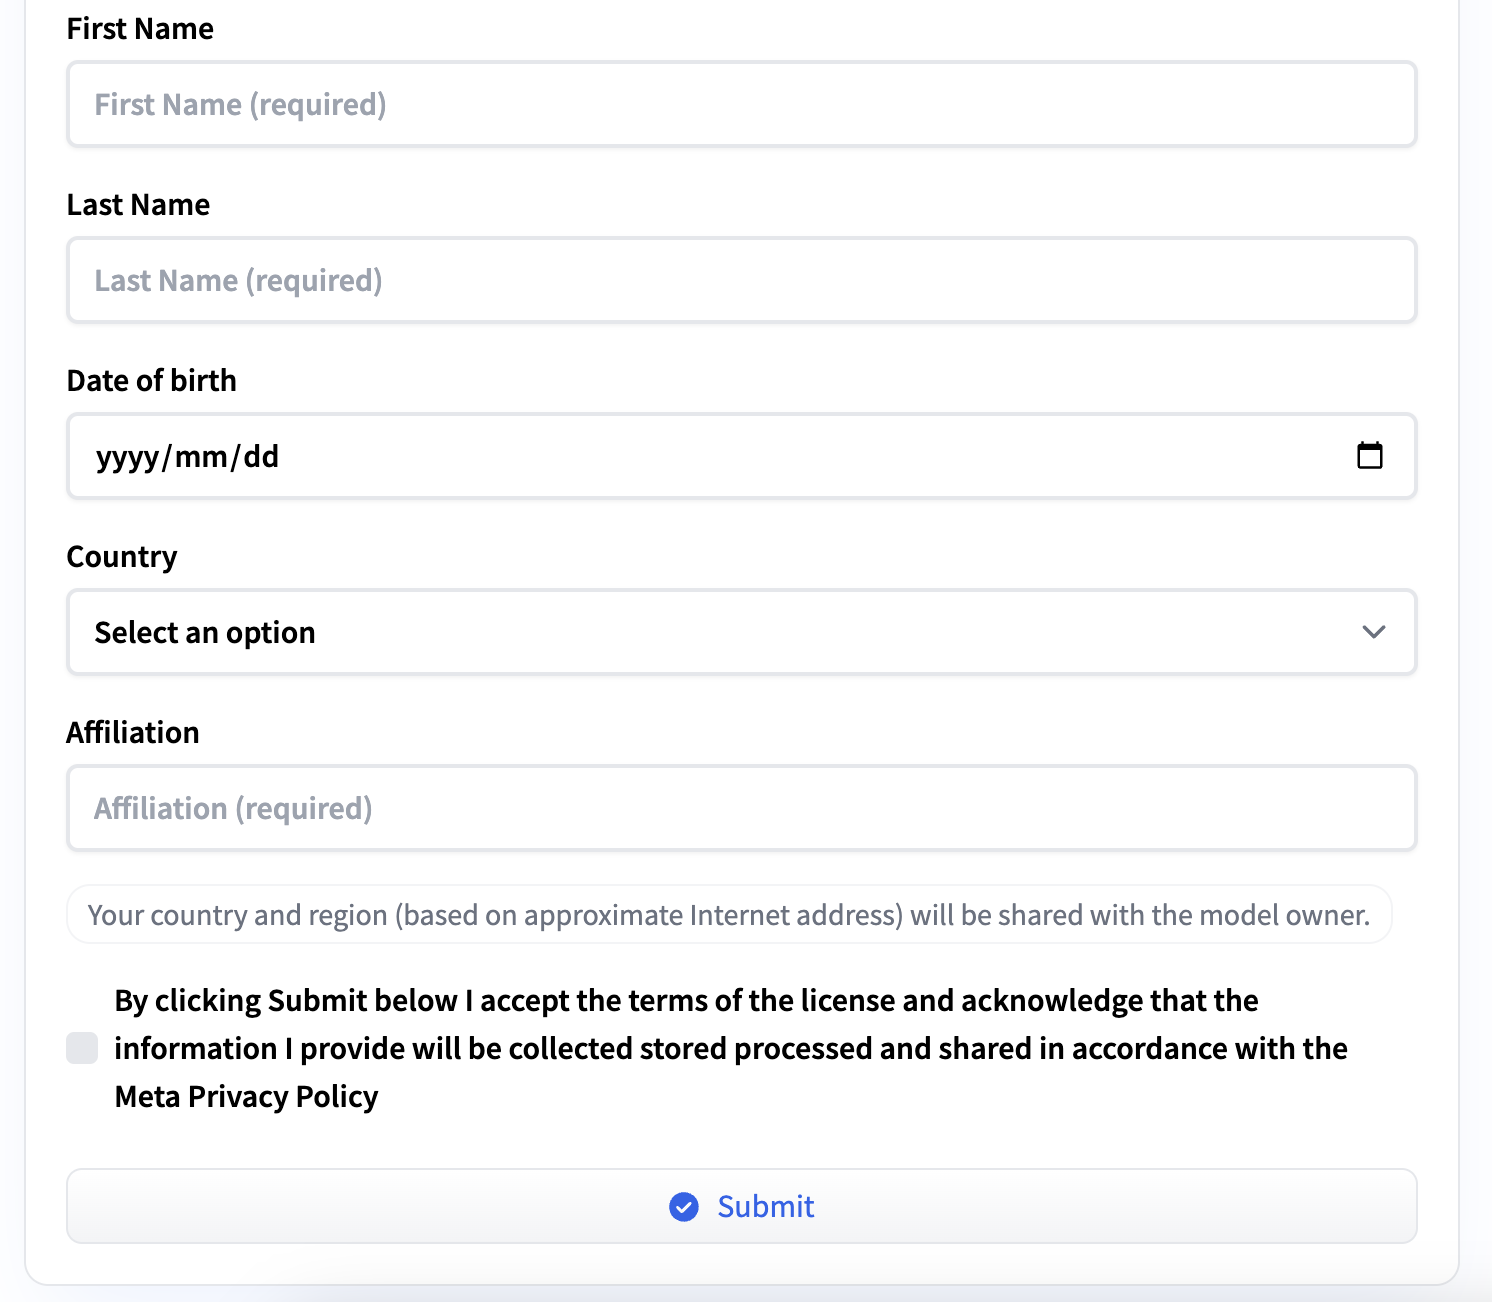
Access to model meta-llama/Meta-Llama-3-8B-Instruct is restricted and you are not in the authorized list. Visit https://huggingface.co/meta-llama/Meta-Llama-3-8B-Instruct to ask for access.हम त्रुटि संदेश में दिए गए URL का अनुसरण करके एक्सेस का अनुरोध कर सकते हैं। हमें व्यक्तिगत जानकारी के साथ एक छोटा फॉर्म भरना होगा और सेवा की शर्तों से सहमत होना होगा। एक्सेस स्वीकृत होने पर आपको ईमेल प्राप्त होगा।
उन्नत उपयोग
Torchchat स्थानीय रूप से LLM चलाते समय कुछ अतिरिक्त विकल्प प्रदान करता है, जिससे हम उन्हें अपनी आवश्यकताओं और हार्डवेयर के अनुसार अनुकूलित कर सकते हैं। आइए इन विकल्पों में से कुछ का अन्वेषण करें।
प्रिसिशन को नियंत्रित करना
LLM काफी हद तक मैट्रिक्स गुणन पर निर्भर करते हैं, जिसमें कई फ्लोटिंग-पॉइंट संख्याओं का गुणन शामिल होता है। कंप्यूटर में फ्लोटिंग-पॉइंट संख्याओं को विभिन्न प्रिसिशन के साथ निरूपित करने के लिए कई डेटा प्रकार मौजूद होते हैं।
उच्च प्रिसिशन यह सुनिश्चित कर सकता है कि प्रशिक्षण के दौरान कैप्चर की गई बारीकियाँ इन्फरेंस के समय भी सटीक रूप से परिलक्षित हों, खासकर जटिल कार्यों या सूक्ष्म भाषा-समझ के लिए। हालाँकि, उच्च-प्रिसिशन संख्याओं का उपयोग इन्फरेंस को काफी धीमा कर सकता है। सही डेटा प्रकार गति और सटीकता के बीच संतुलन पर निर्भर करता है।
LLM चलाते समय डेटा प्रकार सेट करने के लिए, हम --dtype पैरामीटर का उपयोग कर सकते हैं, उदाहरण के लिए:
python torchchat.py chat --dtype fast stories15Mजस्ट-इन-टाइम कंपाइलेशन
--compile फ्लैग मॉडल के जस्ट-इन-टाइम (JIT) कंपाइलेशन को सक्षम करता है। JIT एक ऐसी तकनीक है जिसका उपयोग इन्फरेंस प्रदर्शन को बेहतर बनाने के लिए किया जाता है, जिसमें रनटाइम पर मॉडल के कुछ हिस्सों को मशीन-लेवल कोड में डायनेमिक रूप से कंपाइल किया जाता है, बजाय इसके कि हर बार निष्पादित होने पर उन्हें इंटरप्रेट किया जाए। यह तरीका विभिन्न हार्डवेयर प्लेटफ़ॉर्म पर चलने वाले मॉडलों के लिए दक्षता और गति में उल्लेखनीय सुधार कर सकता है।
JIT का उपयोग करने से अतिरिक्त कंपाइलेशन चरण के कारण स्टार्टअप समय अधिक होगा, लेकिन इन्फरेंस तेज़ चलेगा। यहाँ बताया गया है कि हम JIT के साथ chat का उपयोग कैसे करेंगे:
python torchchat.py chat --compile stories15Mध्यान दें कि यह विकल्प सभी प्रकार के हार्डवेयर पर समर्थित न भी हो। इस स्थिति में, Torchchat कंपाइलेशन चरण को अनदेखा करेगा और उसके बिना LLM चलाएगा।
क्वांटाइज़ेशन
क्वांटाइज़ेशन एक तकनीक है जिसका उपयोग मॉडल का आकार घटाने और उसकी इन्फरेंस गति बढ़ाने के लिए किया जाता है, बिना प्रदर्शन या सटीकता पर उल्लेखनीय समझौता किए। यह विशेष रूप से एज डिवाइसों पर LLM को परिनियोजित करने या ऐसे परिवेशों में महत्वपूर्ण है जहाँ कम्प्यूटेशनल संसाधन, मेमोरी और बैंडविड्थ सीमित हों।
संक्षेप में, क्वांटाइज़ेशन में किसी न्यूरल नेटवर्क के वज़न और एक्टिवेशंस को फ्लोटिंग-पॉइंट प्रतिनिधित्व (आमतौर पर 32-बिट फ्लोट्स) से कम-बिट प्रतिनिधित्वों में बदलना शामिल है, जैसे 16-बिट इंटीजर, 8-बिट इंटीजर, या कुछ मामलों में बाइनरी प्रतिनिधित्व।
यह --dtype से प्रिसिशन सेट करने से अलग है। क्वांटाइज़ेशन सीधे मॉडल वज़नों पर कार्य करता है और एक छोटा मॉडल बनाता है, जबकि डेटा प्रकार इन्फरेंस गणनाओं में उपयोग किए गए डेटा के प्रकार को निर्दिष्ट करता है।
Torchchat में क्वांटाइज़ेशन का उपयोग करने के लिए एक JSON कॉन्फ़िगरेशन फ़ाइल की आवश्यकता होती है और इसे इस तरह उपयोग किया जा सकता है:
python torchchat.py chat --quantize config.json stories15Mconfig.json कॉन्फ़िगरेशन फ़ाइल के फ़ॉर्मेट या Torchchat में क्वांटाइज़ेशन कैसे काम करता है, इस पर अधिक विवरण के लिए, उनके क्वांटाइज़ेशन प्रलेखन पृष्ठ को देखें।
डिवाइस विनिर्देशन
हम --device विकल्प का उपयोग करके वह डिवाइस निर्दिष्ट कर सकते हैं जिस पर LLM चलाया जाएगा। उदाहरण के लिए, इसे CUDA पर चलाने के लिए हम यह उपयोग करेंगे:
python torchchat.py chat --device cuda stories15Mनिष्कर्ष
Torchchat, LLM इन्फरेंस के जनतंत्रीकरण में एक बड़ा कदम है। यह किसी भी व्यक्ति के लिए विभिन्न प्रकार के डिवाइसों पर LLM को कुशलतापूर्वक चलाना आसान बनाता है।
Torchchat उन क्षमताओं से कहीं अधिक प्रदान करता है जिनका हमने इस लेख में परिचय कराया है। हमने किसी भी व्यक्ति के लिए अपने कंप्यूटर पर Python और PyTorch का उपयोग करके स्थानीय रूप से LLM चलाना शुरू करने हेतु आवश्यक स्पष्टीकरण प्रदान किए हैं। मैं आपको Torchchat को और गहराई से अन्वेषित करने के लिए प्रोत्साहित करता हूँ।
