

Creating a Database
本部分我们将学习如何将在 CC BY-NC-SA 4.0 许可下发布的 COVID-19 对机场客流量的影响 数据集加载到我们的 SQLite 数据库中。我们也将学习如何从零开始创建表。
该机场客流数据集包含 2020 年 2 月 1 日至 2020 年 3 月 15 日基线期间的客流量百分比。我们将使用 Pandas 的 read_csv 函数加载 CSV 文件,然后用 to_sql 函数将数据框传入我们的 SQLite 表。to_sql 需要提供表名(字符串)以及与 SQLite 引擎的连接。
data = pd.read_csv("data/covid_impact_on_airport_traffic.csv")
data.to_sql(
'airport', # Name of the sql table
conn, # sqlite.Connection or sqlalchemy.engine.Engine
if_exists='replace'
)
现在我们将通过运行一个简短的 SQL 查询来测试是否成功。在运行查询之前,需要创建一个用于执行查询的 cursor(游标),如下方代码块所示。单个连接内,您可以在同一数据库上拥有多个游标。
在我们的例子中,SQL 查询从 airport 表中返回了三列和五行。要显示第一行,我们将使用 cursor.fetchone()。
cursor = conn.cursor()
cursor.execute("""SELECT Date, AirportName, PercentOfBaseline
FROM airport
LIMIT 5""")
cursor.fetchone()
>>> ('2020-04-03', 'Kingsford Smith', 64)
要显示其余记录,我们将使用 cursor.fetchall()。仅用几行代码,机场数据集就已成功加载到数据库中。
cursor.fetchall()
>>> [('2020-04-13', 'Kingsford Smith', 29),
('2020-07-10', 'Kingsford Smith', 54),
('2020-09-02', 'Kingsford Smith', 18),
('2020-10-31', 'Kingsford Smith', 22)]
现在,我们来学习如何从零创建一个表,并通过添加示例值来填充它。我们将创建一个 studentinfo 表,包含 id(整数,主键,自增)、name(文本)和 subject(文本)。
注意:SQLite 的语法略有不同。建议查看 SQLite 速查表,以理解本教程中提到的 SQL 查询。
cursor.execute("""
CREATE TABLE studentinfo
(
id INTEGER PRIMARY KEY AUTOINCREMENT,
name TEXT,
subject TEXT
)
""")
让我们通过运行一个简单的 SQLite 查询来检查数据库中已经添加了多少个表。
cursor.execute("""
SELECT name
FROM sqlite_master
WHERE type='table'
""")
cursor.fetchall()
>>> [('airport',), ('studentinfo',)]
Running Queries
本节我们将向 studentinfo 表添加值,并运行简单的 SQL 查询。使用 INSERT INTO,我们可以向 studentinfo 表添加一行。
插入值时,需要向 execute 函数提供 query 和 value 参数。该函数会用我们提供的值填充 “?” 占位符。
query = """
INSERT INTO studentinfo
(name, subject)
VALUES (?, ?)
"""
value = ("Marry", "Math")
cursor.execute(query,value)
重复上述查询,添加多条记录。
query = """
INSERT INTO studentinfo
(name, subject)
VALUES (?, ?)
"""
values = [("Abid", "Stat"),
("Carry", "Math"),
("Ali","Data Science"),
("Nisha","Data Science"),
("Matthew","Math"),
("Henry","Data Science")]
cursor.executemany(query,values)
现在该验证记录了。为此,我们将运行一个简单的 SQL 查询,返回 subject 为 Data Science 的行。
cursor.execute("""
SELECT *
FROM studentinfo
WHERE subject LIKE 'Data Science'
""")
cursor.fetchall()
>>> [(4, 'Ali', 'Data Science'),
(5, 'Nisha', 'Data Science'),
(7, 'Henry', 'Data Science')]
DISTINCT subject 用于显示 subject 列中存在的唯一值。在我们的例子中是 Math、Stat 和 Data Science。
cursor.execute("SELECT DISTINCT subject from studentinfo")
cursor.fetchall()
>>> [('Math',), ('Stat',), ('Data Science',)]
要保存所有更改,我们将使用 commit() 函数。如果不提交,机器重启后数据将会丢失。
conn.commit()
SQL with Pandas
本部分我们将学习如何从 SQLite 数据库中提取数据,并用一行代码将其转换为 Pandas 数据框。read_sql 不仅能运行 SQL 查询;我们还可以用它设置索引列、解析日期和时间、添加值以及按列名过滤。通过学习一门简短的 DataCamp 课程,了解更多在 Python 中导入数据的方法。
read_sql 需要两个参数:一个 SQL 查询 和与 SQLite 引擎的 连接。输出包含 airport 表中 PercentOfBaseline 大于 20 的前五行。
data_sql_1 = pd.read_sql("""
SELECT Date,City,PercentOfBaseline
FROM airport
WHERE PercentOfBaseline > 20
ORDER BY Date DESC
""",
conn)
print(data_sql_1.head())
Date City PercentOfBaseline
0 2020-12-02 Sydney 27
1 2020-12-02 Santiago 48
2 2020-12-02 Calgary 99
3 2020-12-02 Leduc County 100
4 2020-12-02 Richmond 86
借助与 Pandas 的集成,在关系型数据库上进行数据分析变得更容易。我们还可以使用这些数据进行预测并开展复杂的统计分析。
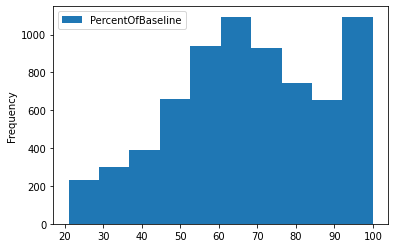
plot 函数用于可视化 PercentOfBaseline 列的直方图。
data_sql_1.plot(y="PercentOfBaseline",kind="hist");
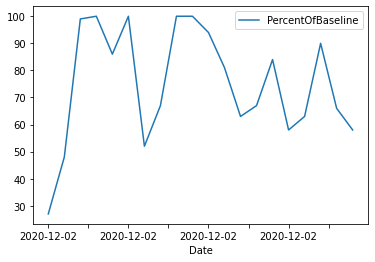
同样,我们可以将记录限制为前 20 条,并显示时间序列折线图。
data_sql_2 = pd.read_sql("""
SELECT Date,City,PercentOfBaseline
FROM airport
WHERE PercentOfBaseline > 20
ORDER BY Date DESC
LIMIT 20
""",
conn)
data_sql_2.plot(x="Date",y="PercentOfBaseline",kind="line");
最后,我们将关闭连接以释放资源。大多数包会自动处理,但在完成更改后主动关闭连接是更好的做法。
conn.close()
R Tutorial
我们将使用 R 复现 Python 教程中的所有任务。内容包括创建连接、写入表、追加行、运行查询,以及使用 dplyr 进行数据分析。
Setting Up
DBI 包用于连接最流行的数据库,如 MariaDB、Postgres、Duckdb 和 SQLite。例如,安装 RMySQL 包,并通过提供用户名、密码、数据库名和主机地址来创建数据库。
install.packages("RMySQL")
library(RMySQL)
conn = dbConnect(
MySQL(),
user = 'abid',
password = '1234',
dbname = 'datacamp_R',
host = 'localhost'
)
在本教程中,我们将通过提供名称和 SQLite 函数来创建一个 SQLite 数据库。
library(RSQLite)
library(DBI)
library(tidyverse)
conn = dbConnect(SQLite(), dbname = 'datacamp_R.db')
Creating Database
导入 tidyverse 库后,我们将能使用 dplyr、ggplot 和 defaults 数据集。
dbWriteTable 函数接收 data.frame 并将其写入 SQL 表。它需要三个参数:与 SQLite 的连接、表名和数据框。使用 dbReadTable 可以查看整个表。要查看前 6 行,我们使用了 head。
dbWriteTable(conn, "cars", mtcars)
head(dbReadTable(conn, "cars"))
mpg cyl disp hp drat wt qsec vs am gear carb
1 21.0 6 160 110 3.90 2.620 16.46 0 1 4 4
2 21.0 6 160 110 3.90 2.875 17.02 0 1 4 4
3 22.8 4 108 93 3.85 2.320 18.61 1 1 4 1
4 21.4 6 258 110 3.08 3.215 19.44 1 0 3 1
5 18.7 8 360 175 3.15 3.440 17.02 0 0 3 2
6 18.1 6 225 105 2.76 3.460 20.22 1 0 3 1
dbExecute 允许我们执行任意 SQLite 查询,因此我们将使用它创建名为 idcard 的表。
要显示数据库中的表名,我们将使用 dbListTables。
dbExecute(conn, 'CREATE TABLE idcard (id int, name text)')
dbListTables(conn)
>>> 'cars''idcard'
让我们向 idcard 表添加一行,并使用 dbGetQuery 显示结果。
注意:dbGetQuery 会运行查询并返回记录,而 dbExecute 会运行 SQL 查询但不返回任何记录。
dbExecute(conn, "INSERT INTO idcard (id,name)\
VALUES(1,'love')")
dbGetQuery(conn,"SELECT * FROM idcard")
id name
1 love
现在我们将再添加两行,并使用 dbReadTable 显示结果。
dbExecute(conn,"INSERT INTO idcard (id,name)\
VALUES(2,'Kill'),(3,'Game')
")
dbReadTable(conn,'idcard')
id name
1 love
2 Kill
3 Game
dbCreateTable 可让我们无障碍地创建表。它需要三个参数:连接、表名,以及一个字符向量或 data.frame。字符向量由名称(列名)和取值(类型)组成。在我们的例子中,我们将提供一个默认的 population data.frame 来创建初始结构。
dbCreateTable(conn,'population',population)
dbReadTable(conn,'population')
country year population
然后,我们将使用 dbAppendTable 向 population 表添加值。
dbAppendTable(conn,'population',head(population))
dbReadTable(conn,'population')
country year population
Afghanistan 1995 17586073
Afghanistan 1996 18415307
Afghanistan 1997 19021226
Afghanistan 1998 19496836
Afghanistan 1999 19987071
Afghanistan 2000 20595360
Running Queries
我们将使用 dbGetQuery 来执行所有数据分析任务。先尝试运行一个简单查询,然后再了解更多函数。
dbGetQuery(conn,"SELECT * FROM idcard")
id name
1 love
2 Kill
3 Game
您也可以运行复杂的 SQL 查询来筛选马力并限制返回的行与列。
dbGetQuery(conn, "SELECT mpg,hp,gear\
FROM cars\
WHERE hp > 50\
LIMIT 5")
mpg hp gear
21.0 110 4
21.0 110 4
22.8 93 4
21.4 110 3
18.7 175 3
要删除表,请使用 dbRemoveTable。如我们所见,idcard 表已成功删除。
dbRemoveTable(conn,'idcard')
dbListTables(conn)
>>> 'cars''population'
为更了解表结构,我们将使用 dbListFields 显示特定表中的列名。
dbListFields(conn, "cars")
>>> 'mpg''cyl''disp''hp''drat''wt''qsec''vs''am''gear''carb'
SQL with dplyr
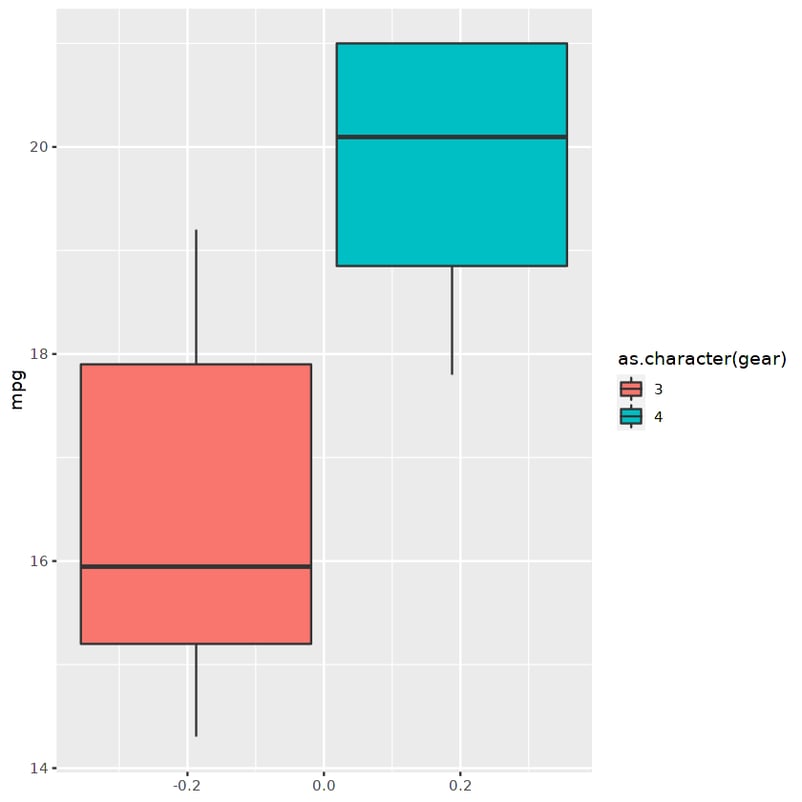
本节我们将使用 dplyr 读取表,然后用 filter、select 和 collect 运行查询。如果您不想学习 SQL 语法,而是希望用纯 R 完成所有任务,那么这种方法适合您。我们提取了 cars 表,按 gears 和 mpg 进行了筛选,然后选择了三个列,如下所示。
cars_results <-
tbl(conn, "cars") %>%
filter(gear %in% c(4, 3),
mpg >= 14,
mpg <= 21) %>%
select(mpg, hp, gear) %>%
collect()
cars_results
mpg hp gear
21.0 110 4
21.0 110 4
18.7 175 3
18.1 105 3
14.3 245 3
... ... ...
我们可以使用筛选后的数据框,通过 ggplot 显示箱线图。
ggplot(cars_results,aes(fill=as.character(gear), y=mpg)) +
geom_boxplot()
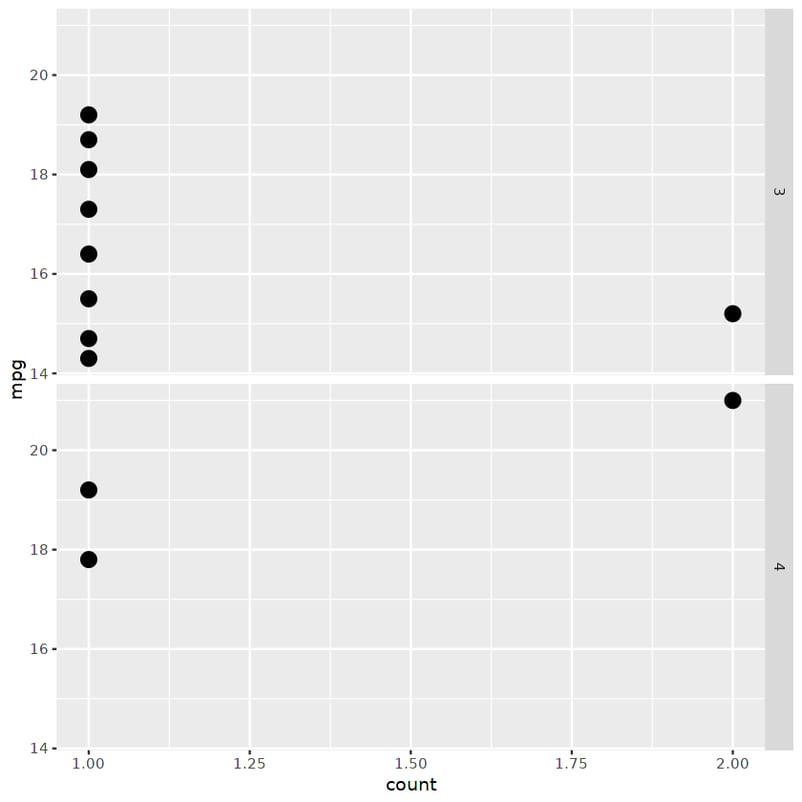
或者,我们可以按 gears 的数量分面显示点图。
ggplot(cars_results,
aes(mpg, ..count.. ) ) +
geom_point(stat = "count", size = 4) +
coord_flip()+
facet_grid( as.character(gear) ~ . )
Conclusion
在本教程中,我们学习了在 Python 和 R 中运行 SQL 查询的重要性、创建数据库、添加表以及使用 SQL 查询进行数据分析。我们还学习了 Pandas 和 dplyr 如何帮助我们用一行代码运行查询。
对于所有与技术相关的岗位,SQL 都是一项必学技能。如果您正以数据分析师为起点,建议在两个月内完成 Data Analyst with SQL Server 职业路径。该路径将教您有关 SQL 查询、服务器和资源管理的一切。
您可以免费运行本教程中使用的所有脚本:
- SQL with Python 项目可在 此 DataLab 工作簿中获取。
- SQL with R 项目可在 此 DataLab 工作簿中获取。
What is SQL
结构化查询语言(SQL)是执行各类数据分析任务时最常用的语言。它也用于维护关系型数据库,例如:添加表、删除值以及优化数据库。一个简单的关系型数据库由多个相互关联的表组成,每个表由行和列构成。
平均而言,一家科技公司每天会产生数以百万计的数据点。需要一种稳健且高效的存储方案,才能利用这些数据改进现有系统或推出新产品。MySQL、PostgreSQL 和 SQLite 等关系型数据库通过提供稳健的数据库管理、安全性和高性能来解决这些问题。
SQL 的核心功能
SQL 是一项需求旺盛的技能,可助您在科技行业求职。Meta、Google 和 Netflix 等公司一直在寻找能够从 SQL 数据库中提取信息并提出创新解决方案的数据专业人士。您可以在 DataCamp 上学习 Introduction to SQL 教程,掌握 SQL 的基础知识。
Why use SQL with Python and R?
SQL 可以帮助我们洞察公司的业绩、理解客户行为并监测营销活动的成功指标。大多数数据分析师可以通过运行 SQL 查询完成大部分商业智能任务,那么为何还需要 PowerBI、Python 和 R 等工具?使用 SQL 查询,您可以描述过去发生的事情,但无法预测未来趋势。这些工具有助于我们更深入地理解当前表现与潜在增长。
Python 和 R 是多用途语言,允许专业人士进行高级统计分析、构建机器学习模型、创建数据 API,并最终帮助公司将目光投向 KPI 之外。在本教程中,我们将学习如何连接 SQL 数据库、填充数据库,并使用 Python 和 R 运行 SQL 查询。
注意:如果您是 SQL 新手,建议先学习 SQL skill track,以理解编写 SQL 查询的基础。
Python Tutorial
本节 Python 教程将涵盖连接多种数据库(MySQL 和 SQLite)、创建表、添加记录、运行查询,以及了解 Pandas 函数
read_sql的基础。Setting Up
我们可以使用 SQLAlchemy 连接数据库,但在本教程中,我们将使用内置的 Python 包 SQLite3 在数据库上运行查询。SQLAlchemy 提供统一的 API,支持各种数据库。如果您想进一步了解 SQLAlchemy 以及它如何与其他数据库配合使用,请查看 Introduction to Databases in Python 课程。
MySQL 是全球最流行的数据库引擎,被 Youtube、Paypal、LinkedIn 和 GitHub 等公司广泛使用。这里我们将学习如何连接数据库。后续使用 MySQL 的步骤与 SQLite3 包类似。
首先使用“!pip install mysql”安装 mysql 包,然后通过提供用户名、密码和数据库名创建本地数据库引擎。
同样地,我们可以使用
sqlite3.connect函数创建或加载一个 SQLite 数据库。SQLite 是一个实现了自包含、零配置、无服务器数据库引擎的库。它对 DataLab 友好,因此我们将在项目中使用它以避免本地主机错误。