

Veritabanı Oluşturma
Bu bölümde, COVID-19'un havaalanı trafiğine etkisi veri setini, CC BY-NC-SA 4.0 lisansı kapsamında, SQLite veritabanımıza nasıl yükleyeceğimizi öğreneceğiz. Ayrıca, sıfırdan tablo oluşturmayı da göreceğiz.
Havaalanı trafiği veri seti, 1 Şubat 2020 ile 15 Mart 2020 arasındaki temel dönem süresince trafik hacminin yüzdesinden oluşur. Pandas'ın read_csv fonksiyonunu kullanarak bir CSV dosyası yükleyecek ve ardından to_sql fonksiyonunu kullanarak veri çerçevesini SQLite tablomuzun içine aktaracağız. to_sql fonksiyonu bir tablo adı (String) ve SQLite motoruna bağlantı gerektirir.
data = pd.read_csv("data/covid_impact_on_airport_traffic.csv")
data.to_sql(
'airport', # Name of the sql table
conn, # sqlite.Connection or sqlalchemy.engine.Engine
if_exists='replace'
)
Şimdi, hızlı bir SQL sorgusu çalıştırarak başarılı olup olmadığımızı test edeceğiz. Bir sorgu çalıştırmadan önce, aşağıdaki kod bloğunda gösterildiği gibi sorguları yürütmemize yardımcı olacak bir imleç (cursor) oluşturmamız gerekir. Tek bir bağlantı içinde aynı veritabanında birden fazla imlece sahip olabilirsiniz.
Bizim durumumuzda, SQL sorgusu airport tablosundan üç sütun ve beş satır döndürdü. İlk satırı görüntülemek için cursor.fetchone() kullanacağız.
cursor = conn.cursor()
cursor.execute("""SELECT Date, AirportName, PercentOfBaseline
FROM airport
LIMIT 5""")
cursor.fetchone()
>>> ('2020-04-03', 'Kingsford Smith', 64)
Kalan kayıtları görüntülemek için cursor.fetchall() kullanacağız. Havaalanı veri seti, birkaç satır kodla veritabanına başarıyla yüklendi.
cursor.fetchall()
>>> [('2020-04-13', 'Kingsford Smith', 29),
('2020-07-10', 'Kingsford Smith', 54),
('2020-09-02', 'Kingsford Smith', 18),
('2020-10-31', 'Kingsford Smith', 22)]
Şimdi sıfırdan bir tablo oluşturmayı ve örnek değerler ekleyerek doldurmayı öğrenelim. id (tamsayı, birincil anahtar, otomatik artan), name (metin) ve subject (metin) sütunlarına sahip bir studentinfo tablosu oluşturacağız.
Not: SQLite söz dizimi biraz farklıdır. Bu eğitimde geçen SQL sorgularını anlamak için SQLite kısa kılavuzuna göz atmanız önerilir.
cursor.execute("""
CREATE TABLE studentinfo
(
id INTEGER PRIMARY KEY AUTOINCREMENT,
name TEXT,
subject TEXT
)
""")
Basit bir SQLite sorgusu çalıştırarak veritabanına kaç tablo eklediğimizi kontrol edelim.
cursor.execute("""
SELECT name
FROM sqlite_master
WHERE type='table'
""")
cursor.fetchall()
>>> [('airport',), ('studentinfo',)]
Sorguları Çalıştırma
Bu bölümde, studentinfo tablosuna değerler ekleyecek ve basit SQL sorguları çalıştıracağız. INSERT INTO kullanarak studentinfo tablosuna tek bir satır ekleyebiliriz.
Değer eklemek için, execute fonksiyonuna bir sorgu ve değer argümanı sağlamamız gerekir. Fonksiyon, verdiğimiz değerlerle "?" girişlerini doldurur.
query = """
INSERT INTO studentinfo
(name, subject)
VALUES (?, ?)
"""
value = ("Marry", "Math")
cursor.execute(query,value)
Yukarıdaki sorguyu birden fazla kayıt ekleyerek tekrarlayın.
query = """
INSERT INTO studentinfo
(name, subject)
VALUES (?, ?)
"""
values = [("Abid", "Stat"),
("Carry", "Math"),
("Ali","Data Science"),
("Nisha","Data Science"),
("Matthew","Math"),
("Henry","Data Science")]
cursor.executemany(query,values)
Kaydı doğrulama zamanı. Bunu yapmak için, subject değeri Data Science olan satırları döndürecek basit bir SQL sorgusu çalıştıracağız.
cursor.execute("""
SELECT *
FROM studentinfo
WHERE subject LIKE 'Data Science'
""")
cursor.fetchall()
>>> [(4, 'Ali', 'Data Science'),
(5, 'Nisha', 'Data Science'),
(7, 'Henry', 'Data Science')]
DISTINCT subject komutu, subject sütunlarında bulunan benzersiz değerleri görüntülemek için kullanılır. Bizim örneğimizde Math, Stat ve Data Science.
cursor.execute("SELECT DISTINCT subject from studentinfo")
cursor.fetchall()
>>> [('Math',), ('Stat',), ('Data Science',)]
Tüm değişiklikleri kaydetmek için commit() fonksiyonunu kullanacağız. Commit olmadan, makine yeniden başlatıldıktan sonra veriler kaybolur.
conn.commit()
Pandas ile SQL
Bu bölümde, SQLite veritabanından verileri nasıl çıkarıp tek satır kodla bir Pandas veri çerçevesine dönüştüreceğimizi öğreneceğiz. read_sql, yalnızca SQL sorguları çalıştırmaktan fazlasını sunar. Bunu, indeks sütunları ayarlamak, tarih ve saati ayrıştırmak, değer eklemek ve sütun adlarını filtrelemek için kullanabiliriz. Python'da veri içe aktarma hakkında daha fazla bilgi edinmek için kısa bir DataCamp kursu alın.
read_sql iki argüman gerektirir: bir SQL sorgusu ve SQLite motoruna bağlantı. Çıktı, airport tablosunda PercentOfBaseline değeri 20'den büyük olan ilk beş satırı içerir.
data_sql_1 = pd.read_sql("""
SELECT Date,City,PercentOfBaseline
FROM airport
WHERE PercentOfBaseline > 20
ORDER BY Date DESC
""",
conn)
print(data_sql_1.head())
Date City PercentOfBaseline
0 2020-12-02 Sydney 27
1 2020-12-02 Santiago 48
2 2020-12-02 Calgary 99
3 2020-12-02 Leduc County 100
4 2020-12-02 Richmond 86
Pandas entegrasyonu ile ilişkisel veritabanlarında veri analizi yapmak daha kolay hale geldi. Bu verileri ayrıca değerleri tahmin etmek ve karmaşık istatistiksel analizler yürütmek için de kullanabiliriz.
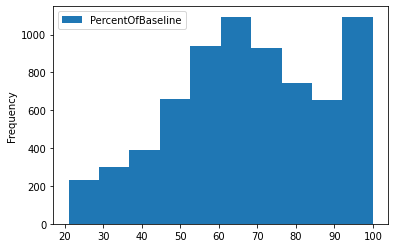
plot fonksiyonu, PercentOfBaseline sütununun histogramını görselleştirmek için kullanılır.
data_sql_1.plot(y="PercentOfBaseline",kind="hist");
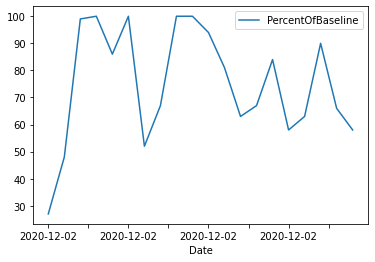
Benzer şekilde, değerleri en üst 20 ile sınırlayıp bir zaman serisi çizgi grafiği görüntüleyebiliriz.
data_sql_2 = pd.read_sql("""
SELECT Date,City,PercentOfBaseline
FROM airport
WHERE PercentOfBaseline > 20
ORDER BY Date DESC
LIMIT 20
""",
conn)
data_sql_2.plot(x="Date",y="PercentOfBaseline",kind="line");
Son olarak, kaynakları serbest bırakmak için bağlantıyı kapatacağız. Çoğu paket bunu otomatik olarak yapar, ancak değişiklikleri tamamladıktan sonra bağlantıları kapatmak tercih edilir.
conn.close()
R Eğitimi
Python eğitimindeki tüm görevleri R kullanarak yineleyeceğiz. Eğitim; bağlantılar oluşturmayı, tablolar yazmayı, satır eklemeyi, sorgular çalıştırmayı ve dplyr ile veri analizini içerir.
Kurulum
DBI paketi, MariaDB, Postgres, Duckdb ve SQLite gibi en popüler veritabanlarına bağlanmak için kullanılır. Örneğin, RMySQL paketini kurun ve kullanıcı adı, parola, veritabanı adı ve ana makine adresi sağlayarak bir veritabanı oluşturun.
install.packages("RMySQL")
library(RMySQL)
conn = dbConnect(
MySQL(),
user = 'abid',
password = '1234',
dbname = 'datacamp_R',
host = 'localhost'
)
Bu eğitimde, bir ad ve SQLite fonksiyonu sağlayarak bir SQLite veritabanı oluşturacağız.
library(RSQLite)
library(DBI)
library(tidyverse)
conn = dbConnect(SQLite(), dbname = 'datacamp_R.db')
Veritabanı Oluşturma
tidyverse kütüphanesini içe aktararak dplyr, ggplot ve varsayılan veri setlerine erişeceğiz.
dbWriteTable fonksiyonu bir data.frame alır ve onu SQL tablosuna ekler. Üç argüman alır: SQLite bağlantısı, tablonun adı ve veri çerçevesi. dbReadTable ile tablonun tamamını görüntüleyebiliriz. İlk 6 satırı görmek için head kullandık.
dbWriteTable(conn, "cars", mtcars)
head(dbReadTable(conn, "cars"))
mpg cyl disp hp drat wt qsec vs am gear carb
1 21.0 6 160 110 3.90 2.620 16.46 0 1 4 4
2 21.0 6 160 110 3.90 2.875 17.02 0 1 4 4
3 22.8 4 108 93 3.85 2.320 18.61 1 1 4 1
4 21.4 6 258 110 3.08 3.215 19.44 1 0 3 1
5 18.7 8 360 175 3.15 3.440 17.02 0 0 3 2
6 18.1 6 225 105 2.76 3.460 20.22 1 0 3 1
dbExecute, herhangi bir SQLite sorgusunu yürütmemize olanak tanır; bu nedenle idcard adlı bir tablo oluşturmak için bunu kullanacağız.
Veritabanındaki tablo adlarını görüntülemek için dbListTables kullanacağız.
dbExecute(conn, 'CREATE TABLE idcard (id int, name text)')
dbListTables(conn)
>>> 'cars''idcard'
idcard tablosuna tek bir satır ekleyelim ve sonuçları görüntülemek için dbGetQuery kullanalım.
Not: dbGetQuery bir sorgu çalıştırır ve kayıtları döndürür; dbExecute ise SQL sorgusu çalıştırır ancak herhangi bir kayıt döndürmez.
dbExecute(conn, "INSERT INTO idcard (id,name)\
VALUES(1,'love')")
dbGetQuery(conn,"SELECT * FROM idcard")
id name
1 love
Şimdi iki satır daha ekleyip dbReadTable kullanarak sonuçları görüntüleyeceğiz.
dbExecute(conn,"INSERT INTO idcard (id,name)\
VALUES(2,'Kill'),(3,'Game')
")
dbReadTable(conn,'idcard')
id name
1 love
2 Kill
3 Game
dbCreateTable, zahmetsizce tablo oluşturmamıza olanak tanır. Üç argüman gerektirir; bağlantı, tablonun adı ve bir karakter vektörü veya bir data.frame. Karakter vektörü adlardan (sütun adları) ve değerlerden (tipler) oluşur. Bizim durumumuzda, başlangıç yapısını oluşturmak için varsayılan bir nüfus data.frame'i sağlayacağız.
dbCreateTable(conn,'population',population)
dbReadTable(conn,'population')
country year population
Ardından, population tablosuna değerler eklemek için dbAppendTable kullanacağız.
dbAppendTable(conn,'population',head(population))
dbReadTable(conn,'population')
country year population
Afghanistan 1995 17586073
Afghanistan 1996 18415307
Afghanistan 1997 19021226
Afghanistan 1998 19496836
Afghanistan 1999 19987071
Afghanistan 2000 20595360
Sorguları Çalıştırma
Tüm veri analitiği görevlerimiz için dbGetQuery kullanacağız. Basit bir sorgu çalıştırmayı deneyelim ve sonra diğer fonksiyonlar hakkında daha fazla şey öğrenelim.
dbGetQuery(conn,"SELECT * FROM idcard")
id name
1 love
2 Kill
3 Game
Ayrıca beygir gücünü filtrelemek ve sınırlı sayı ve sütun göstermek için karmaşık bir SQL sorgusu da çalıştırabilirsiniz.
dbGetQuery(conn, "SELECT mpg,hp,gear\
FROM cars\
WHERE hp > 50\
LIMIT 5")
mpg hp gear
21.0 110 4
21.0 110 4
22.8 93 4
21.4 110 3
18.7 175 3
Tabloları kaldırmak için dbRemoveTable kullanın. Artık idcard tablosunu başarıyla kaldırdığımızı görebiliyoruz.
dbRemoveTable(conn,'idcard')
dbListTables(conn)
>>> 'cars''population'
Tabloları daha iyi anlamak için, belirli bir tablodaki sütun adlarını görüntüleyecek olan dbListFields'ı kullanacağız.
dbListFields(conn, "cars")
>>> 'mpg''cyl''disp''hp''drat''wt''qsec''vs''am''gear''carb'
dplyr ile SQL
Bu bölümde, dplyr kullanarak tabloları okuyacak ve ardından filter, select ve collect kullanarak sorgular çalıştıracağız. Eğer SQL söz dizimini öğrenmek istemiyor ve tüm görevleri saf R ile gerçekleştirmek istiyorsanız, bu yöntem sizin için uygundur. Aşağıda gösterildiği gibi cars tablosunu çektik, gear ve mpg ile filtreledik ve ardından üç sütun seçtik.
cars_results <-
tbl(conn, "cars") %>%
filter(gear %in% c(4, 3),
mpg >= 14,
mpg <= 21) %>%
select(mpg, hp, gear) %>%
collect()
cars_results
mpg hp gear
21.0 110 4
21.0 110 4
18.7 175 3
18.1 105 3
14.3 245 3
... ... ...
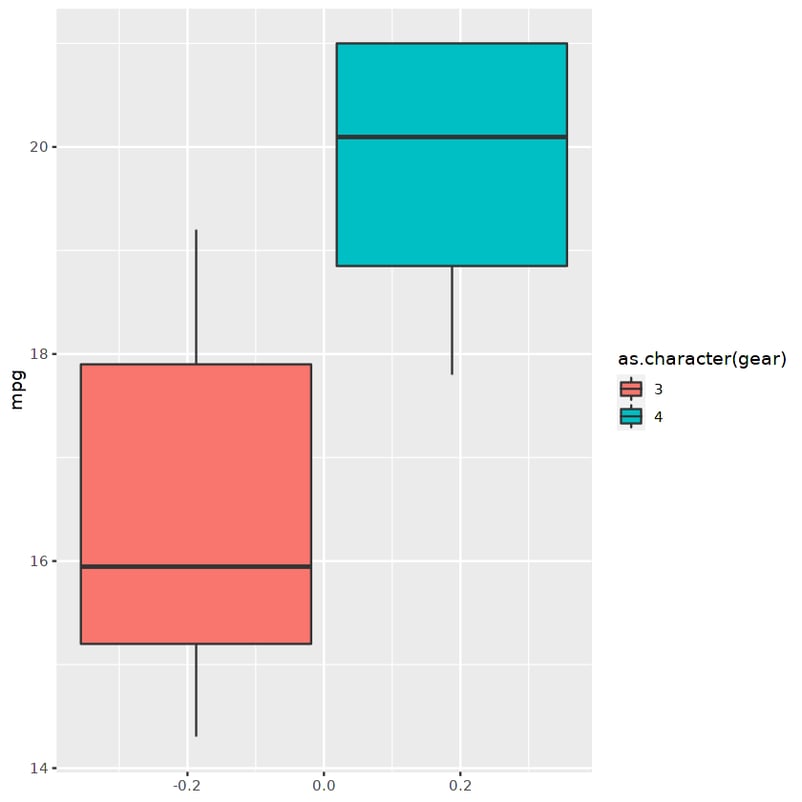
Filtrelenmiş veri çerçevesini kullanarak ggplot ile bir kutu grafiği (boxplot) gösterebiliriz.
ggplot(cars_results,aes(fill=as.character(gear), y=mpg)) +
geom_boxplot()
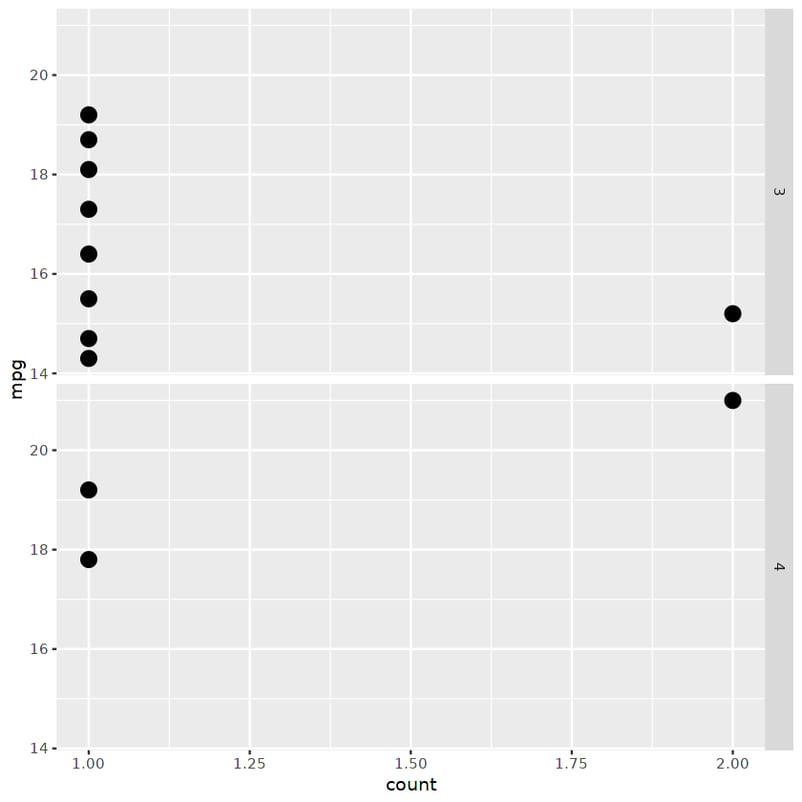
Ya da gear sayısına göre bölünmüş bir facet nokta grafiği görüntüleyebiliriz.
ggplot(cars_results,
aes(mpg, ..count.. ) ) +
geom_point(stat = "count", size = 4) +
coord_flip()+
facet_grid( as.character(gear) ~ . )
Sonuç
Bu eğitimde, Python ve R ile SQL sorguları çalıştırmanın, veritabanları oluşturmanın, tablolar eklemenin ve SQL sorgularıyla veri analizi yapmanın önemini öğrendik. Ayrıca, Pandas ve dplyr'ın tek satır kodla sorgu çalıştırmamıza nasıl yardımcı olduğunu gördük.
SQL, teknolojiyle ilgili tüm işler için öğrenilmesi gereken bir beceridir. Kariyerinize veri analisti olarak başlıyorsanız, iki ay içinde Data Analyst with SQL Server kariyer yolunu tamamlamanızı öneririz. Bu kariyer yolu, SQL sorguları, sunucular ve kaynak yönetimi hakkında bilmeniz gereken her şeyi öğretecektir.
Bu eğitimde kullanılan tüm betikleri ücretsiz olarak çalıştırabilirsiniz:
- Python ile SQL projesi bu DataLab çalışma kitabında mevcuttur.
- R ile SQL projesi bu DataLab çalışma kitabında mevcuttur.





SQL Nedir
Yapılandırılmış Sorgu Dili (SQL), çeşitli veri analizi görevlerini yürütmek için kullanılan en yaygın dildir. Ayrıca ilişkisel bir veritabanını yönetmek için de kullanılır; örneğin: tablolar eklemek, değerleri kaldırmak ve veritabanını optimize etmek. Basit bir ilişkisel veritabanı birbiriyle bağlantılı birden fazla tablodan oluşur ve her tablo satırlar ve sütunlardan meydana gelir.
Ortalama bir teknoloji şirketi her gün milyonlarca veri noktası üretir. Mevcut sistemi iyileştirmek veya yeni bir ürün geliştirmek için veriyi kullanabilmeleri adına sağlam ve etkili bir depolama çözümü gerekir. MySQL, PostgreSQL ve SQLite gibi bir ilişkisel veritabanı; sağlam veritabanı yönetimi, güvenlik ve yüksek performans sağlayarak bu sorunları çözer.
SQL'in temel işlevleri
SQL, teknoloji sektöründe iş bulmanıza yardımcı olacak, talebi yüksek bir beceridir. Meta, Google ve Netflix gibi şirketler, SQL veritabanlarından bilgi çıkarıp yenilikçi çözümler üretebilen veri profesyonellerini sürekli arıyor. SQL'in temellerini DataCamp'teki Introduction to SQL eğitimini alarak öğrenebilirsiniz.
Neden SQL'i Python ve R ile kullanmalısınız?
SQL, şirketin performansını keşfetmemize, müşteri davranışlarını anlamamıza ve pazarlama kampanyalarının başarı metriklerini izlememize yardımcı olabilir. Çoğu veri analisti, iş zekâsı görevlerinin büyük kısmını SQL sorguları çalıştırarak gerçekleştirebilir; peki neden PoweBI, Python ve R gibi araçlara ihtiyaç duyarız? SQL sorgularını kullanarak geçmişte neler olduğunu söyleyebilirsiniz, ancak geleceğe yönelik projeksiyonları tahmin edemezsiniz. Bu araçlar, mevcut performans ve potansiyel büyüme hakkında daha fazlasını anlamamıza yardımcı olur.
Python ve R; ileri düzey istatistiksel analizler çalıştırmaya, makine öğrenmesi modelleri kurmaya, veri API'leri oluşturmaya ve nihayetinde şirketlerin KPI'ların ötesinde düşünmesine yardımcı olan çok amaçlı dillerdir. Bu eğitimde, SQL veritabanlarına bağlanmayı, veritabanlarını doldurmayı ve SQL sorgularını Python ve R kullanarak çalıştırmayı öğreneceğiz.
Not: SQL'e yeni başlıyorsanız, SQL sorguları yazmanın temellerini anlamak için SQL beceri yolunu tamamlayın.
Python Eğitimi
Python eğitimi; çeşitli veritabanlarına (MySQL ve SQLite) bağlanmanın temellerini, tablolar oluşturmayı, kayıt eklemeyi, sorgular çalıştırmayı ve Pandas'ın
read_sqlfonksiyonunu öğrenmeyi kapsayacaktır.Kurulum
Veritabanına SQLAlchemy kullanarak bağlanabiliriz; ancak bu eğitimde, veritabanında sorgular çalıştırmak için yerleşik Python paketi SQLite3'ü kullanacağız. SQLAlchemy, birleşik bir API sunarak her türlü veritabanını destekler. SQLAlchemy hakkında daha fazla bilgi edinmek ve diğer veritabanlarıyla nasıl çalıştığını öğrenmek istiyorsanız, Introduction to Databases in Python kursuna göz atın.
MySQL, dünyanın en popüler veritabanı motorudur ve Youtube, Paypal, LinkedIn ve GitHub gibi şirketler tarafından yaygın şekilde kullanılır. Burada veritabanına nasıl bağlanacağımızı öğreneceğiz. MySQL'i kullanmanın geri kalan adımları, SQLite3 paketiyle benzerlik gösterir.
Önce '!pip install mysql' komutuyla mysql paketini kurun ve ardından kullanıcı adınızı, şifrenizi ve veritabanı adınızı vererek yerel bir veritabanı motoru oluşturun.
Benzer şekilde,
sqlite3.connectfonksiyonunu kullanarak bir SQLite veritabanı oluşturabilir veya yükleyebiliriz. SQLite, kendi kendine yeten, sıfır yapılandırma gerektiren ve sunucusuz bir veritabanı motorunu uygulayan bir kütüphanedir. DataLab ile uyumludur; bu nedenle yerel ana makine hatalarından kaçınmak için projede bunu kullanacağız.