

डेटाबेस बनाना
इस भाग में, हम हवाई अड्डों के यातायात पर COVID-19 का प्रभाव डेटासेट, जो CC BY-NC-SA 4.0 लाइसेंस के तहत है, को अपने SQLite डेटाबेस में लोड करना सीखेंगे। हम शून्य से टेबल बनाना भी सीखेंगे।
एयरपोर्ट ट्रैफिक डेटासेट में 1 फरवरी, 2020 से 15 मार्च, 2020 के बेसलाइन अवधि के दौरान ट्रैफिक वॉल्यूम का प्रतिशत शामिल है। हम Pandas की read_csv फ़ंक्शन का उपयोग करके एक CSV फ़ाइल लोड करेंगे और फिर to_sql फ़ंक्शन का उपयोग करके डेटाफ़्रेम को अपनी SQLite टेबल में ट्रांसफर करेंगे। to_sql फ़ंक्शन को एक टेबल नाम (String) और SQLite इंजन से कनेक्शन की आवश्यकता होती है।
data = pd.read_csv("data/covid_impact_on_airport_traffic.csv")
data.to_sql(
'airport', # Name of the sql table
conn, # sqlite.Connection or sqlalchemy.engine.Engine
if_exists='replace'
)
अब हम एक त्वरित SQL क्वेरी चलाकर जाँचेंगे कि हम सफल हुए हैं या नहीं। क्वेरी चलाने से पहले, हमें एक कर्सर बनाना होगा, जो हमें क्वेरियों को निष्पादित करने में मदद करेगा, जैसा कि नीचे दिए गए कोड ब्लॉक में दिखाया गया है। आप एक ही कनेक्शन के भीतर उसी डेटाबेस पर कई कर्सर रख सकते हैं।
हमारे मामले में, SQL क्वेरी ने airport टेबल से तीन कॉलम और पाँच पंक्तियाँ लौटाईं। पहली पंक्ति प्रदर्शित करने के लिए, हम cursor.fetchone() का उपयोग करेंगे।
cursor = conn.cursor()
cursor.execute("""SELECT Date, AirportName, PercentOfBaseline
FROM airport
LIMIT 5""")
cursor.fetchone()
>>> ('2020-04-03', 'Kingsford Smith', 64)
बाकी रिकॉर्ड प्रदर्शित करने के लिए, हम cursor.fetchall() का उपयोग करेंगे। कुछ पंक्तियों के कोड से एयरपोर्ट डेटासेट सफलतापूर्वक डेटाबेस में लोड हो जाता है।
cursor.fetchall()
>>> [('2020-04-13', 'Kingsford Smith', 29),
('2020-07-10', 'Kingsford Smith', 54),
('2020-09-02', 'Kingsford Smith', 18),
('2020-10-31', 'Kingsford Smith', 22)]
अब, शून्य से एक टेबल बनाना सीखते हैं और उसमें नमूना मान जोड़कर उसे भरते हैं। हम studentinfo नाम की एक टेबल बनाएंगे, जिसमें id (integer, primary key, auto-increment), name (text), और subject (text) होंगे।
ध्यान दें: SQLite का सिंटैक्स थोड़ा भिन्न है। इस ट्यूटोरियल में बताई गई SQL क्वेरियों को समझने के लिए SQLite चीट शीट देखना अनुशंसित है।
cursor.execute("""
CREATE TABLE studentinfo
(
id INTEGER PRIMARY KEY AUTOINCREMENT,
name TEXT,
subject TEXT
)
""")
एक साधारण SQLite क्वेरी चलाकर देखते हैं कि हमने डेटाबेस में कितनी टेबल जोड़ी हैं।
cursor.execute("""
SELECT name
FROM sqlite_master
WHERE type='table'
""")
cursor.fetchall()
>>> [('airport',), ('studentinfo',)]
क्वेरियाँ चलाना
इस खंड में, हम studentinfo टेबल में मान जोड़ेंगे और सरल SQL क्वेरियाँ चलाएँगे। INSERT INTO का उपयोग करके, हम studentinfo टेबल में एक पंक्ति जोड़ सकते हैं।
मान जोड़ने के लिए, हमें execute फ़ंक्शन को query और value आर्ग्युमेंट देने होते हैं। यह फ़ंक्शन हमारे द्वारा दिए गए मानों से “?” इनपुट भरता है।
query = """
INSERT INTO studentinfo
(name, subject)
VALUES (?, ?)
"""
value = ("Marry", "Math")
cursor.execute(query,value)
उपरोक्त क्वेरी को कई रिकॉर्ड जोड़कर दोहराएँ।
query = """
INSERT INTO studentinfo
(name, subject)
VALUES (?, ?)
"""
values = [("Abid", "Stat"),
("Carry", "Math"),
("Ali","Data Science"),
("Nisha","Data Science"),
("Matthew","Math"),
("Henry","Data Science")]
cursor.executemany(query,values)
अब रिकॉर्ड सत्यापित करने का समय है। इसके लिए हम एक सरल SQL क्वेरी चलाएँगे जो उन पंक्तियों को वापस करेगी जिनमें subject Data Science है।
cursor.execute("""
SELECT *
FROM studentinfo
WHERE subject LIKE 'Data Science'
""")
cursor.fetchall()
>>> [(4, 'Ali', 'Data Science'),
(5, 'Nisha', 'Data Science'),
(7, 'Henry', 'Data Science')]
DISTINCT subject कमांड का उपयोग subject कॉलम में मौजूद अद्वितीय मानों को प्रदर्शित करने के लिए किया जाता है। हमारे मामले में, ये Math, Stat, और Data Science हैं।
cursor.execute("SELECT DISTINCT subject from studentinfo")
cursor.fetchall()
>>> [('Math',), ('Stat',), ('Data Science',)]
सभी परिवर्तनों को सहेजने के लिए, हम commit() फ़ंक्शन का उपयोग करेंगे। कमिट किए बिना, मशीन के रीस्टार्ट होने के बाद डेटा खो जाएगा।
conn.commit()
Pandas के साथ SQL
इस भाग में हम सीखेंगे कि SQLite डेटाबेस से डेटा निकालकर एक पंक्ति के कोड में उसे Pandas डेटाफ़्रेम में कैसे बदलें। read_sql केवल SQL क्वेरियाँ चलाने से अधिक प्रदान करता है। हम इसका उपयोग इंडेक्स कॉलम सेट करने, दिनांक और समय पार्स करने, मान जोड़ने, और कॉलम नामों को फ़िल्टर करने के लिए कर सकते हैं। Python में डेटा इम्पोर्ट करने के बारे में अधिक जानने के लिए एक छोटा DataCamp कोर्स लें।
read_sql को दो आर्ग्युमेंट चाहिए: एक SQL क्वेरी और SQLite इंजन से कनेक्शन। आउटपुट में airport टेबल की वे शीर्ष पाँच पंक्तियाँ होती हैं जहाँ PercentOfBaseline 20 से अधिक है।
data_sql_1 = pd.read_sql("""
SELECT Date,City,PercentOfBaseline
FROM airport
WHERE PercentOfBaseline > 20
ORDER BY Date DESC
""",
conn)
print(data_sql_1.head())
Date City PercentOfBaseline
0 2020-12-02 Sydney 27
1 2020-12-02 Santiago 48
2 2020-12-02 Calgary 99
3 2020-12-02 Leduc County 100
4 2020-12-02 Richmond 86
Pandas इंटीग्रेशन के साथ रिलेशनल डेटाबेस पर डेटा विश्लेषण चलाना आसान हो गया है। हम इस डेटा का उपयोग मानों का पूर्वानुमान लगाने और जटिल सांख्यिकीय विश्लेषण चलाने के लिए भी कर सकते हैं।
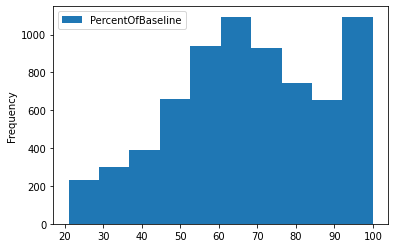
plot फ़ंक्शन का उपयोग PercentOfBaseline कॉलम का हिस्टोग्राम विज़ुअलाइज़ करने के लिए किया जाता है।
data_sql_1.plot(y="PercentOfBaseline",kind="hist");
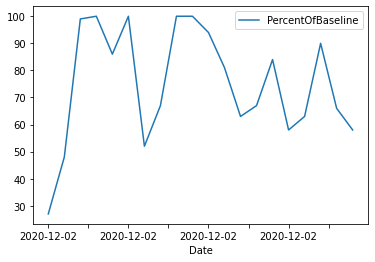
इसी तरह, हम मानों को शीर्ष 20 तक सीमित कर सकते हैं और एक टाइम सीरीज़ लाइन चार्ट प्रदर्शित कर सकते हैं।
data_sql_2 = pd.read_sql("""
SELECT Date,City,PercentOfBaseline
FROM airport
WHERE PercentOfBaseline > 20
ORDER BY Date DESC
LIMIT 20
""",
conn)
data_sql_2.plot(x="Date",y="PercentOfBaseline",kind="line");
अंत में, हम कनेक्शन बंद करेंगे ताकि संसाधन मुक्त हो सकें। अधिकांश पैकेज यह स्वतः करते हैं, लेकिन परिवर्तनों को अंतिम रूप देने के बाद कनेक्शन बंद करना बेहतर माना जाता है।
conn.close()
R ट्यूटोरियल
हम R का उपयोग करके Python ट्यूटोरियल के सभी कार्यों को दोहराने वाले हैं। इस ट्यूटोरियल में कनेक्शन बनाना, टेबल लिखना, पंक्तियाँ जोड़ना, क्वेरियाँ चलाना, और dplyr के साथ डेटा विश्लेषण शामिल है।
सेटअप
DBI पैकेज का उपयोग सबसे लोकप्रिय डेटाबेस जैसे MariaDB, Postgres, Duckdb, और SQLite से कनेक्ट होने के लिए किया जाता है। उदाहरण के लिए, RMySQL पैकेज इंस्टॉल करें और यूज़रनेम, पासवर्ड, डेटाबेस नाम, और होस्ट पता देकर एक डेटाबेस बनाएँ।
install.packages("RMySQL")
library(RMySQL)
conn = dbConnect(
MySQL(),
user = 'abid',
password = '1234',
dbname = 'datacamp_R',
host = 'localhost'
)
इस ट्यूटोरियल में, हम एक नाम और SQLite फ़ंक्शन प्रदान करके एक SQLite डेटाबेस बनाने जा रहे हैं।
library(RSQLite)
library(DBI)
library(tidyverse)
conn = dbConnect(SQLite(), dbname = 'datacamp_R.db')
डेटाबेस बनाना
tidyverse लाइब्रेरी इम्पोर्ट करने से हमें dplyr, ggplot, और डिफ़ॉल्ट डेटासेट्स तक पहुँच मिल जाएगी।
dbWriteTable फ़ंक्शन data.frame लेता है और उसे SQL टेबल में जोड़ता है। इसे तीन आर्ग्युमेंट चाहिए: SQLite से कनेक्शन, टेबल का नाम, और डेटा फ्रेम। dbReadTable से हम पूरी टेबल देख सकते हैं। शीर्ष 6 पंक्तियाँ देखने के लिए, हमने head का उपयोग किया है।
dbWriteTable(conn, "cars", mtcars)
head(dbReadTable(conn, "cars"))
mpg cyl disp hp drat wt qsec vs am gear carb
1 21.0 6 160 110 3.90 2.620 16.46 0 1 4 4
2 21.0 6 160 110 3.90 2.875 17.02 0 1 4 4
3 22.8 4 108 93 3.85 2.320 18.61 1 1 4 1
4 21.4 6 258 110 3.08 3.215 19.44 1 0 3 1
5 18.7 8 360 175 3.15 3.440 17.02 0 0 3 2
6 18.1 6 225 105 2.76 3.460 20.22 1 0 3 1
dbExecute हमें कोई भी SQLite क्वेरी चलाने देता है, इसलिए हम इसका उपयोग idcard नाम की एक तालिका बनाने के लिए करेंगे।
डेटाबेस में तालिकाओं के नाम दिखाने के लिए, हम dbListTables का उपयोग करेंगे।
dbExecute(conn, 'CREATE TABLE idcard (id int, name text)')
dbListTables(conn)
>>> 'cars''idcard'
आइए idcard तालिका में एक पंक्ति जोड़ें और परिणाम दिखाने के लिए dbGetQuery का उपयोग करें।
ध्यान दें: dbGetQuery एक क्वेरी चलाता है और रिकॉर्ड लौटाता है, जबकि dbExecute SQL क्वेरी चलाता है पर कोई रिकॉर्ड वापस नहीं करता।
dbExecute(conn, "INSERT INTO idcard (id,name)\
VALUES(1,'love')")
dbGetQuery(conn,"SELECT * FROM idcard")
id name
1 love
अब हम दो और पंक्तियाँ जोड़ेंगे और dbReadTable का उपयोग करके परिणाम दिखाएँगे।
dbExecute(conn,"INSERT INTO idcard (id,name)\
VALUES(2,'Kill'),(3,'Game')
")
dbReadTable(conn,'idcard')
id name
1 love
2 Kill
3 Game
dbCreateTable हमें बिना झंझट के तालिका बनाने देता है। इसे तीन आर्ग्युमेंट्स चाहिए: कनेक्शन, तालिका का नाम, और एक तो या तो कैरेक्टर वेक्टर या data.frame। कैरेक्टर वेक्टर में नाम (कॉलम नाम) और मान (प्रकार) होते हैं। हमारे मामले में, हम शुरुआती संरचना बनाने के लिए एक डिफ़ॉल्ट data.frame population प्रदान करने जा रहे हैं।
dbCreateTable(conn,'population',population)
dbReadTable(conn,'population')
country year population
फिर, हम dbAppendTable का उपयोग करके population तालिका में मान जोड़ेंगे।
dbAppendTable(conn,'population',head(population))
dbReadTable(conn,'population')
country year population
Afghanistan 1995 17586073
Afghanistan 1996 18415307
Afghanistan 1997 19021226
Afghanistan 1998 19496836
Afghanistan 1999 19987071
Afghanistan 2000 20595360
क्वेरियाँ चलाना
हम अपने सभी डेटा एनालिटिक्स कार्यों के लिए dbGetQuery का उपयोग करेंगे। आइए एक साधारण क्वेरी चलाकर देखें और फिर अन्य फ़ंक्शंस के बारे में और जानें।
dbGetQuery(conn,"SELECT * FROM idcard")
id name
1 love
2 Kill
3 Game
आप एक जटिल SQL क्वेरी भी चला सकते हैं ताकि horsepower को फ़िल्टर किया जा सके और सीमित पंक्तियाँ व कॉलम दिखें।
dbGetQuery(conn, "SELECT mpg,hp,gear\
FROM cars\
WHERE hp > 50\
LIMIT 5")
mpg hp gear
21.0 110 4
21.0 110 4
22.8 93 4
21.4 110 3
18.7 175 3
तालिकाएँ हटाने के लिए dbRemoveTable का उपयोग करें। जैसा कि अब हम देख सकते हैं, हमने सफलतापूर्वक idcard तालिका हटा दी है।
dbRemoveTable(conn,'idcard')
dbListTables(conn)
>>> 'cars''population'
तालिकाओं के बारे में और जानने के लिए हम dbListFields का उपयोग करेंगे, जो किसी विशेष तालिका में कॉलम नाम दिखाएगा।
dbListFields(conn, "cars")
>>> 'mpg''cyl''disp''hp''drat''wt''qsec''vs''am''gear''carb'
dplyr के साथ SQL
इस खंड में, हम dplyr का उपयोग करके तालिकाएँ पढ़ेंगे और फिर filter, select, और collect के जरिए क्वेरियाँ चलाएँगे। यदि आप SQL सिंटैक्स सीखना नहीं चाहते और सारे कार्य शुद्ध R से करना चाहते हैं, तो यह विधि आपके लिए है। हमने cars तालिका को खींचा, उसे gears और mpg के आधार पर फ़िल्टर किया, और फिर नीचे दिखाए अनुसार तीन कॉलम चुने।
cars_results <-
tbl(conn, "cars") %>%
filter(gear %in% c(4, 3),
mpg >= 14,
mpg <= 21) %>%
select(mpg, hp, gear) %>%
collect()
cars_results
mpg hp gear
21.0 110 4
21.0 110 4
18.7 175 3
18.1 105 3
14.3 245 3
... ... ...
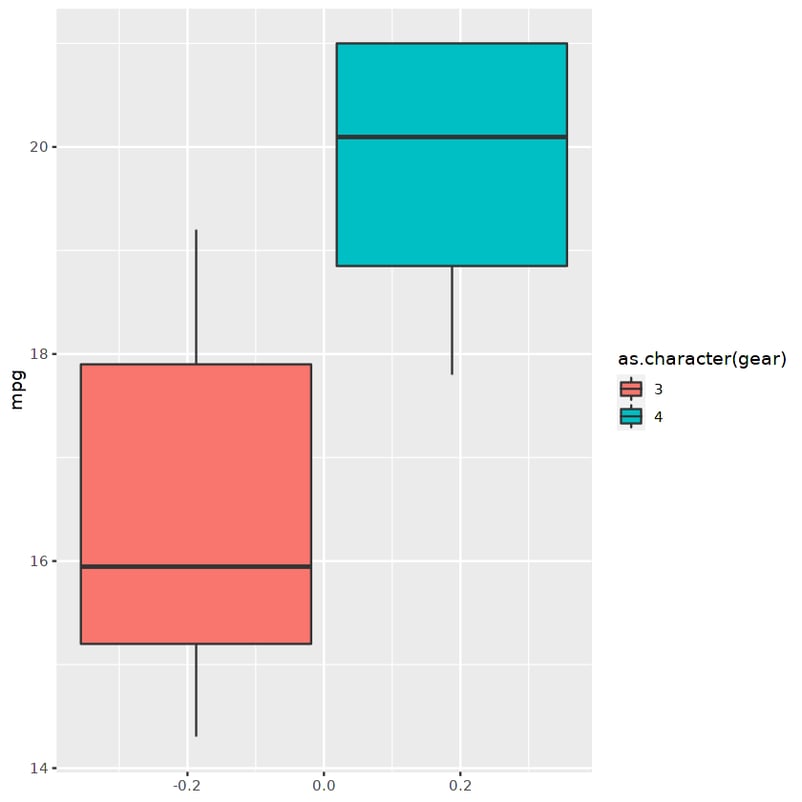
हम इस फ़िल्टर किए गए डेटा फ्रेम का उपयोग ggplot के जरिए एक बॉक्सप्लॉट ग्राफ़ दिखाने के लिए कर सकते हैं।
ggplot(cars_results,aes(fill=as.character(gear), y=mpg)) +
geom_boxplot()
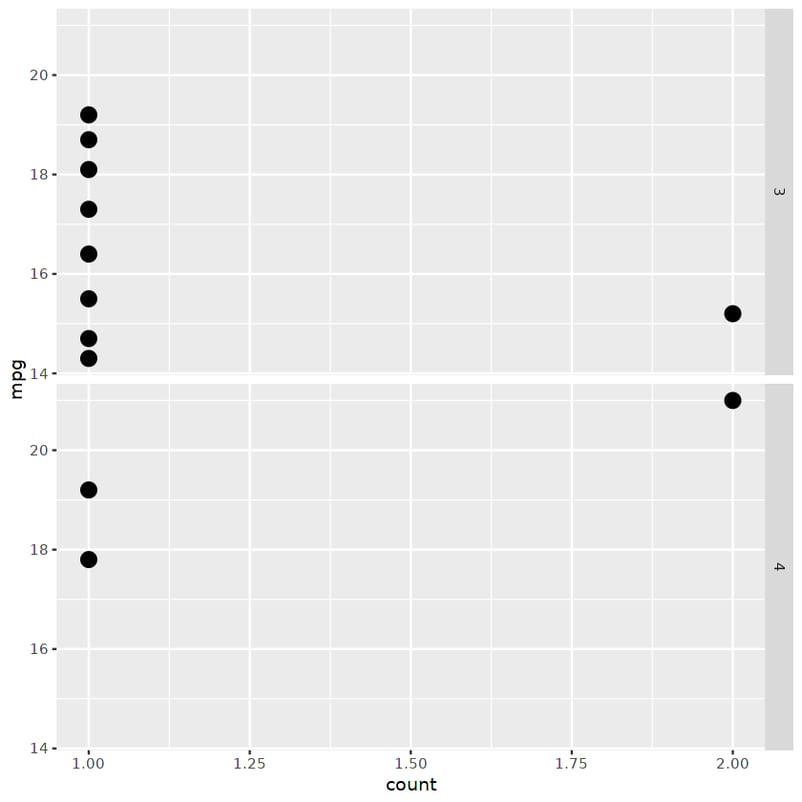
या हम gears की संख्या के आधार पर विभाजित एक फैसेट पॉइंट प्लॉट दिखा सकते हैं।
ggplot(cars_results,
aes(mpg, ..count.. ) ) +
geom_point(stat = "count", size = 4) +
coord_flip()+
facet_grid( as.character(gear) ~ . )
निष्कर्ष
इस ट्यूटोरियल में, हमने Python और R के साथ SQL क्वेरियाँ चलाने, डेटाबेस बनाने, तालिकाएँ जोड़ने, और SQL क्वेरियों का उपयोग करके डेटा विश्लेषण करने का महत्त्व सीखा। हमने यह भी देखा कि Pandas और dplyr हमें एक ही पंक्ति के कोड से क्वेरियाँ चलाने में कैसे मदद करते हैं।
SQL सभी तकनीकी भूमिकाओं के लिए सीखना आवश्यक कौशल है। यदि आप डेटा विश्लेषक के रूप में अपना करियर शुरू कर रहे हैं, तो हम सलाह देंगे कि आप दो महीनों के भीतर Data Analyst with SQL Server कैरियर ट्रैक पूरा करें। यह कैरियर ट्रैक आपको SQL क्वेरियों, सर्वरों और संसाधनों के प्रबंधन के बारे में सब कुछ सिखाएगा।
आप इस ट्यूटोरियल में उपयोग की गई सभी स्क्रिप्ट्स निःशुल्क चला सकते हैं:
- SQL with Python प्रोजेक्ट इस DataLab वर्कबुक में उपलब्ध है।
- SQL with R प्रोजेक्ट इस DataLab वर्कबुक पर उपलब्ध है।
SQL क्या है
Structured Query Language (SQL) डेटा विश्लेषण के विभिन्न कार्यों को चलाने के लिए सबसे आम भाषा है। इसे रिलेशनल डेटाबेस के रखरखाव के लिए भी इस्तेमाल किया जाता है, जैसे: टेबल जोड़ना, मान हटाना, और डेटाबेस का अनुकूलन करना। एक साधारण रिलेशनल डेटाबेस कई परस्पर जुड़े टेबलों से बना होता है, और प्रत्येक टेबल पंक्तियों और स्तंभों से मिलकर बना होता है।
औसतन, एक टेक्नोलॉजी कंपनी हर दिन लाखों डेटा पॉइंट्स जनरेट करती है। एक ऐसा स्टोरेज समाधान आवश्यक है जो मजबूत और प्रभावी हो, ताकि वे डेटा का उपयोग करके मौजूदा सिस्टम में सुधार कर सकें या कोई नया प्रोडक्ट बना सकें। MySQL, PostgreSQL, और SQLite जैसे रिलेशनल डेटाबेस ये समस्याएँ डेटाबेस प्रबंधन, सुरक्षा और उच्च प्रदर्शन प्रदान करके हल करते हैं।
SQL की मुख्य क्षमताएँ
SQL एक उच्च मांग वाली कौशल है जो आपको टेक उद्योग में नौकरी पाने में मदद करेगी। Meta, Google, और Netflix जैसी कंपनियाँ हमेशा ऐसे डेटा प्रोफेशनल्स की तलाश में रहती हैं जो SQL डेटाबेस से जानकारी निकाल सकें और नवीन समाधान पेश कर सकें। आप DataCamp पर Introduction to SQL ट्यूटोरियल लेकर SQL की बुनियादी बातें सीख सकते हैं।
Python और R के साथ SQL का उपयोग क्यों करें?
SQL हमें कंपनी के प्रदर्शन का पता लगाने, ग्राहक व्यवहार समझने, और मार्केटिंग अभियानों के सफलता मीट्रिक्स की निगरानी करने में मदद करता है। अधिकांश डेटा विश्लेषक SQL क्वेरियों को चलाकर बिज़नेस इंटेलिजेंस के अधिकांश कार्य कर सकते हैं, तो फिर हमें PowerBI, Python, और R जैसे टूल्स की आवश्यकता क्यों है? SQL क्वेरियों के माध्यम से आप बता सकते हैं कि अतीत में क्या हुआ, लेकिन भविष्य का अनुमान नहीं लगा सकते। ये टूल हमें मौजूदा प्रदर्शन और संभावित वृद्धि के बारे में अधिक समझने में मदद करते हैं।
Python और R बहुउद्देशीय भाषाएँ हैं जो प्रोफेशनल्स को उन्नत सांख्यिकीय विश्लेषण चलाने, मशीन लर्निंग मॉडल बनाने, डेटा API तैयार करने, और अंततः कंपनियों को KPIs से आगे सोचने में मदद करती हैं। इस ट्यूटोरियल में, हम SQL डेटाबेस से कनेक्ट करना, डेटाबेस को भरना, और Python तथा R का उपयोग करके SQL क्वेरियाँ चलाना सीखेंगे।
नोट: यदि आप SQL में नए हैं, तो SQL क्वेरी लिखने की मूल बातें समझने के लिए SQL skill track लें।
Python ट्यूटोरियल
यह Python ट्यूटोरियल विभिन्न डेटाबेस (MySQL और SQLite) से कनेक्ट करने, टेबल बनाने, रिकॉर्ड जोड़ने, क्वेरियाँ चलाने, और Pandas के
read_sqlफ़ंक्शन के बारे में बुनियादी बातें कवर करेगा।सेटअप
हम SQLAlchemy का उपयोग करके डेटाबेस से कनेक्ट कर सकते हैं, लेकिन इस ट्यूटोरियल में हम इनबिल्ट Python पैकेज SQLite3 का उपयोग करके डेटाबेस पर क्वेरियाँ चलाएँगे। SQLAlchemy एकीकृत API प्रदान करके सभी प्रकार के डेटाबेस का समर्थन करता है। यदि आप SQLAlchemy और यह अन्य डेटाबेस के साथ कैसे काम करता है, इसके बारे में अधिक सीखने में रुचि रखते हैं, तो Introduction to Databases in Python कोर्स देखें।
MySQL दुनिया का सबसे लोकप्रिय डेटाबेस इंजन है, और Youtube, Paypal, LinkedIn, और GitHub जैसी कंपनियाँ इसका व्यापक उपयोग करती हैं। यहाँ हम सीखेंगे कि डेटाबेस से कनेक्ट कैसे करें। MySQL का उपयोग करने के शेष चरण SQLite3 पैकेज के समान हैं।
सबसे पहले, '!pip install mysql' का उपयोग करके mysql पैकेज इंस्टॉल करें और फिर अपना यूज़रनेम, पासवर्ड, और डेटाबेस नाम देकर एक लोकल डेटाबेस इंजन बनाएँ।
इसी तरह, हम
sqlite3.connectफ़ंक्शन का उपयोग करके कोई SQLite डेटाबेस बना या लोड कर सकते हैं। SQLite एक लाइब्रेरी है जो स्व-निहित, शून्य-कॉन्फ़िगरेशन, और सर्वरलेस डेटाबेस इंजन को लागू करती है। यह DataLab-फ्रेंडली है, इसलिए लोकल होस्ट एरर से बचने के लिए हम इसे अपने प्रोजेक्ट में उपयोग करेंगे।