
Last chance! 50% off DataCamp Premium
Sale ends in
在您的会话开始之前,Claude Code 的系统提示已经占用了约 50 条指令。关于前沿大语言模型的研究显示,当总指令数大约达到 150 至 200 条时,遵循指令的能力会开始下降。也就是说,您只有大约 100 至 150 个“名额”,用于放入您希望 Claude 了解的项目信息。
CLAUDE.md 就是填充这些“名额”的文件。它是一份 markdown 文件,Claude Code 会在每次会话开始时读取它,从而在不需要您重复说明的情况下,持续获取关于代码库的上下文。但需要注意,Claude 会主动过滤它认为与当前任务无关的内容。文件臃肿不仅浪费空间,还会与您真正的规则“抢位置”。
本教程将介绍如何编写一份“行行都有价值”的 CLAUDE.md:哪些应当写入、哪些应当剔除、如何为团队结构化组织,以及如何在时间推移中保持其实用性。
也推荐您查看我们近期的其他 Claude Code 指南:
CLAUDE.md 是 Claude Code 在每次对话开始时自动加载的 markdown 文件。它位于项目根目录,为 Claude 提供一系列持续生效的指令,涵盖各类相关事实:
如果没有它,每次会话都要从零开始。您会一遍遍解释同样的上下文、纠正同样的假设,看着 Claude 重蹈昨天的覆辙。CLAUDE.md 通过一次性编码项目知识来解决这一问题。
它是 Claude Code 使用的多种上下文系统之一,每种系统各司其职:
|
系统 |
由谁编写 |
作用 |
加载时机 |
|
|
您 |
您定义的项目规则、约定与约束 |
每次会话(完整文件) |
|
记忆( |
Claude |
会话中自行发现的模式与事实 |
每次会话(前 200 行) |
|
您 |
按需加载的特定工作流领域知识 |
按需 |
|
|
您 |
在预提交或编辑后等触发点执行的 Shell 命令 |
在特定触发点 |
运行 /init 会通过分析代码库(检测构建系统、测试框架与代码模式)生成初始版 CLAUDE.md。如果文件已存在,它会给出改进建议而非直接覆盖。这是一个合理的起点,但这个文件的重要性不允许您“自动驾驶”。
另一个要点是,CLAUDE.md 的内容在执行 /compact 后仍会保留。当会话中途压缩上下文时,Claude 会从磁盘重新读取该文件并再次注入。
CLAUDE.md 文件可存在于四个位置,按范围从广到窄排列:
托管策略(组织级): 在 macOS 为 /Library/Application Support/ClaudeCode/CLAUDE.md。适用于这台机器上的所有用户,且任何设置都无法排除。在 Linux/WSL 为 /etc/claude-code/CLAUDE.md,在 Windows 为 C:\Program Files\ClaudeCode\CLAUDE.md。
用户级: ~/.claude/CLAUDE.md。适用于您本机上所有项目的个人指令。
项目级: 代码仓库根目录下的 ./CLAUDE.md 或 ./.claude/CLAUDE.md。这是您提交到 git 并与团队共享的那份。
子目录级: ./subdir/CLAUDE.md。作用域限定为该目录。Claude 在读取该目录下文件时按需加载,而非在会话开始时加载。
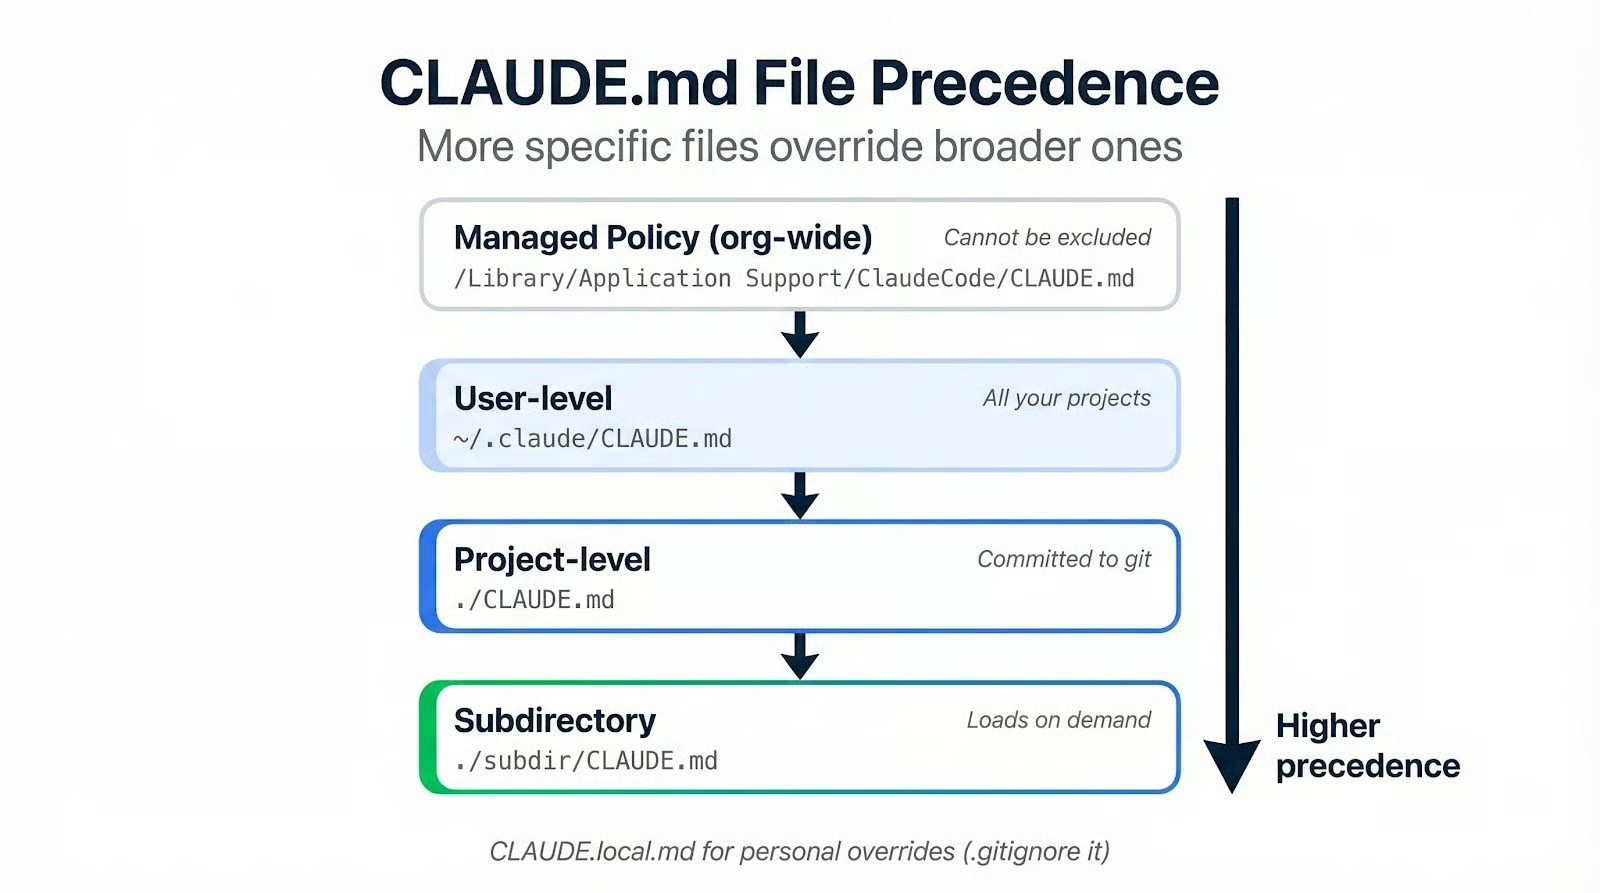
越具体的文件优先级越高。若项目级 CLAUDE.md 说“使用制表符”,而用户级文件说“使用空格”,则项目级文件生效。
对于不应加入版本控制的个人偏好,请创建 CLAUDE.local.md 并将其加入 .gitignore。编辑器癖好、首选提交风格或临时性的覆写,都应放在这里,避免污染共享文件。
弄清文件放在哪以及会与哪些文件“竞争”之后,下一个问题是:它到底该写些什么。
一份 CLAUDE.md 大体分为三层:
如果您读过Claude Code 最佳实践,会发现这是同一原则在更小范围上的应用。(如果还没读,强烈建议您在本文之后去看看!)
先用一到两句话描述项目,并给出您的技术栈及其版本号。Claude 能从代码中推断出很多信息,但它不会凭空猜到您用的是 Next.js 15 而非 14,或您选择了 Drizzle 而不是 Prisma。
加入目录结构示意图。不必列出每个文件,只写顶层布局并配以简短说明:
src/
  data/        # Data loading and preprocessing pipelines
  models/      # Model definitions and training loops
  evaluation/  # Metrics, validation, experiment tracking
  api/         # FastAPI endpoints for model serving
tests/ # Co-located with source, test_*.py将常用命令放在代码块中:构建、测试、lint、开发服务器启动等。写在代码围栏中的命令是 Claude 会原样执行的;写在句子里的命令更像一种建议,Claude 可能会发挥。
需要将架构决策写入文件,因为否则 Claude 会自行做出决定。若您选择 SQLite 而非 Postgres 有其理由,请说明。若 API 层遵循特定模式,请解释背后的考量。
阐明理由在这里真正有用。“不要强制推送(force push)”是条平铺直叙的指令,Claude 在压力下可能忽视它。“不要强制推送。这会改写共享历史,协作者将无法恢复。”这样的表述给了 Claude 足够的上下文以类推。它不仅会避免 git push --force,也会在共享分支上对 git reset --hard 三思而行。
这一部分涵盖 Claude 仅靠读代码无法学到的约定。如果您使用 Conventional Commits(feat:、fix:、docs:),请明确指出。若分支遵循如 initials/description 的命名模式,也请写下来。
这里也应包含“坑点”和“雷区”。每个代码库都有:构建前必须先跑的迁移脚本、测试通过前环境变量必须设置为某值、模块导入顺序错误就会崩的地方。Claude 在每次会话里都是“新同事”,而这些正是新同事第一天最容易踩的雷。
可以省略的内容:语言本身已经约定俗成的东西。您不需要告诉它在现代 JavaScript 中使用 async/await,或在 Python 3 中偏好 pathlib。若某条约定已是语言默认,将其写入只会制造噪音,挤占那些真正重要的指令空间。
把内容选对相对容易;更难的是写出 Claude 真会遵循的指令,并知道哪些该删。
具体性永远胜过意图。“正确格式化代码”什么都没说清。“使用 2 空格缩进、不加分号、使用单引号”才是可执行、可验证的指令。
对每一行应用这条检验:“删掉这行会导致 Claude 出错吗?”如果答案是否,这行就该删。官方建议每个文件不超过 200 行,一些经验丰富的团队甚至控制在 60 行以内。这并非为了极简而极简:更短的文件意味着更多内容能被真正读到。
标题层级最多使用三级。采用代理熟悉的 README 约定式分区名称:Commands、Structure、Conventions、Testing。用新奇的分区名称会增加摩擦,因为 Claude 见过数以百万计的 README,并对“什么内容放在哪”有强预期。
当某条规则明明写在文件里却总被忽略,不要在它周围加更多字。请在其前加前缀 IMPORTANT: 或 YOU MUST。但要谨慎使用,因为强调是“通胀”的:当每条都被标注为重要时,强调就形同虚设。
代码风格约束是最大的陷阱。格式、缩进、导入顺序等都是确定性问题,有确定性解法。Biome、ESLint 或 Ruff 之类的 linter 与 formatter 处理它们更快、更省钱且 100% 一致。把指令预算花在风格规则上是负担——同样的工作,pre-commit hook 免费完成。
标准的语言约定也应排除在外,因为 Claude 已经掌握 TypeScript 的模式与 Python 的惯用法。完整的 API 文档应以链接形式引用而非粘贴。只在特定工作流中适用的任务型指令应放入 skills 中,按需加载,而不是在每次会话里都占据空间。
有一种模式值得特别指出:仅否定式的约束。“绝不要使用 --legacy-peer-deps”会让 Claude 在遇到依赖冲突时无所适从。请为每条禁止配套给出指引:“绝不要使用 --legacy-peer-deps;请通过将包升级到兼容版本来解决冲突。”如果您用过 Cursor Rules 或类似的 AI 配置文件,您会发现这一原则是跨工具通用的。
下面展示了实际中的区别。左侧是典型的自动生成 CLAUDE.md 片段,充满了 Claude 已经知道的泛泛建议;右侧是在应用“具体性检验”后得到的同一片段:只保留项目特有的事实。
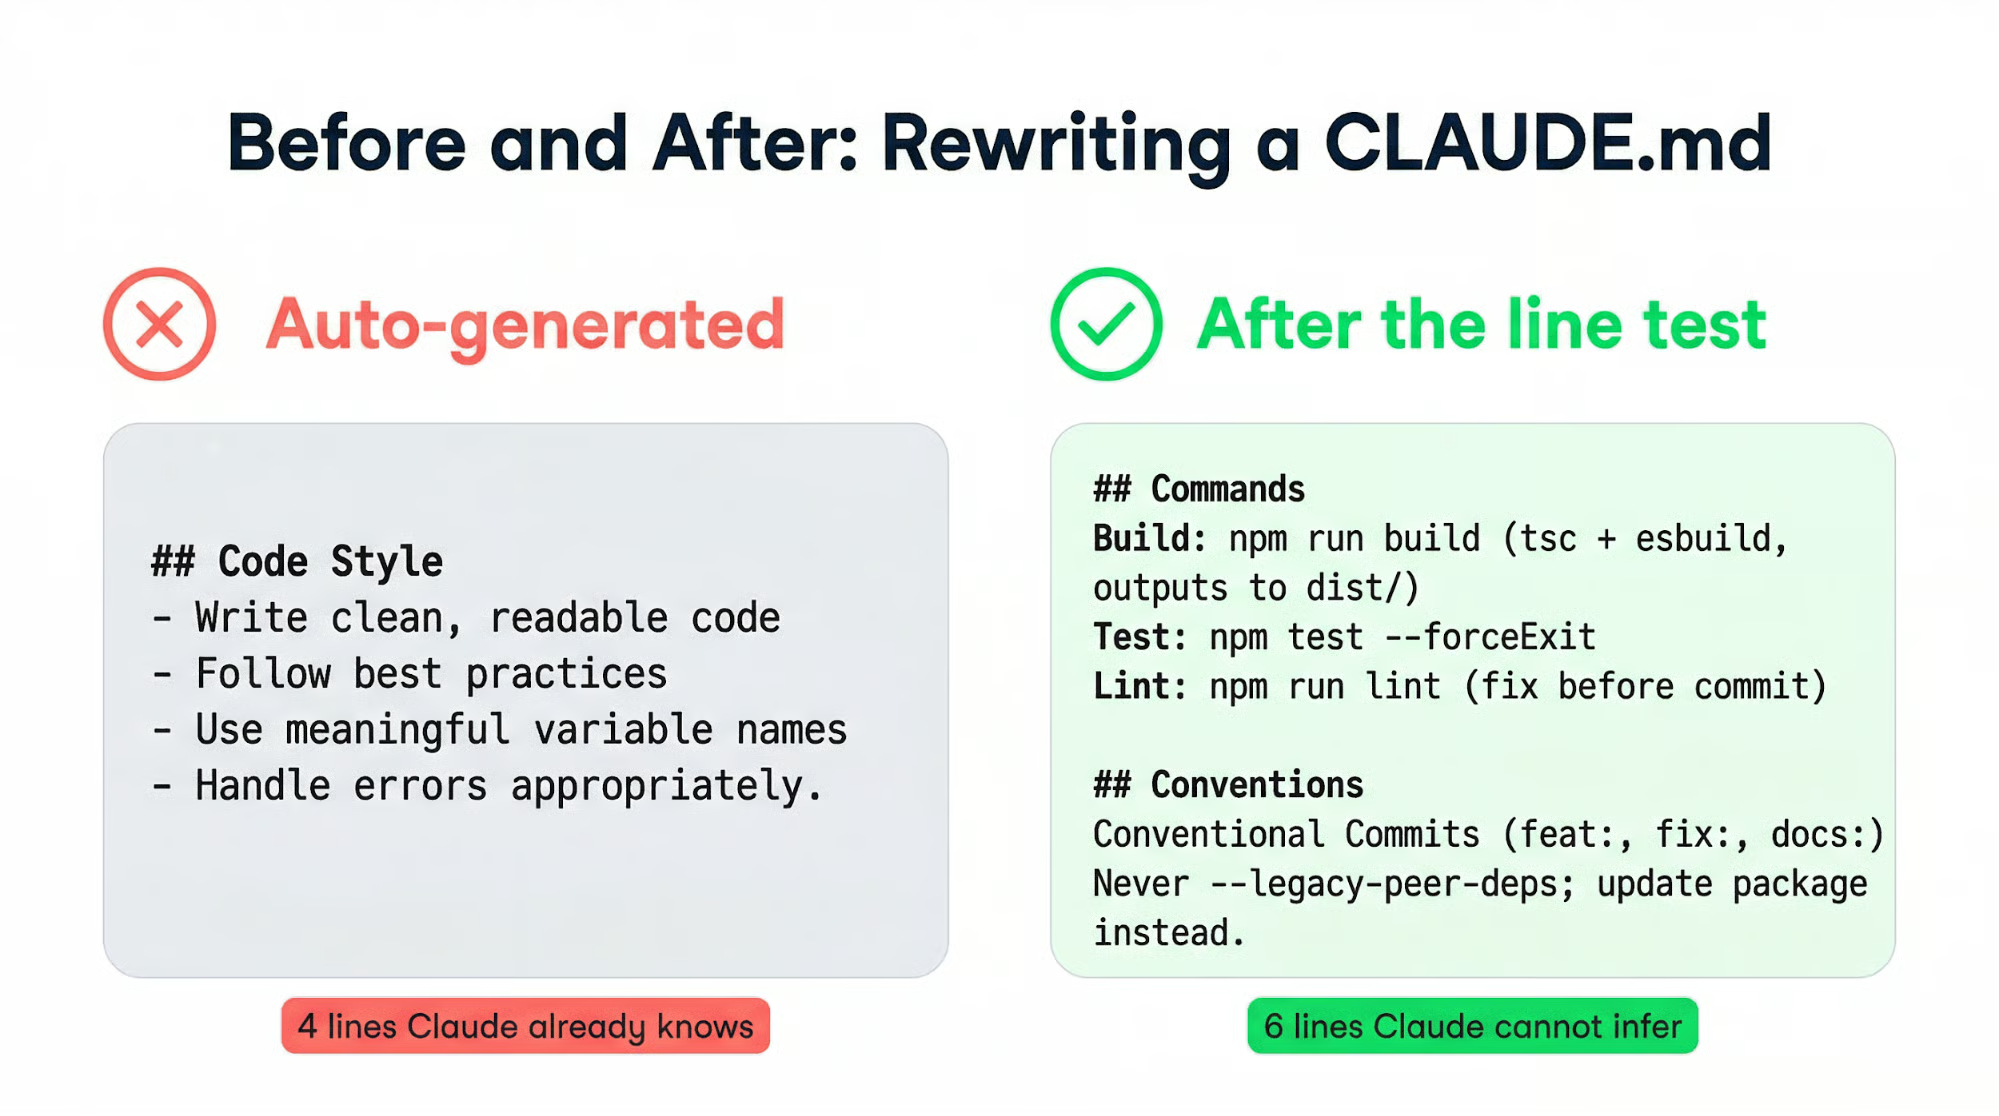
第二个版本更短,也能告诉 Claude 它无法从代码库中自行推断的内容。
在项目根目录运行 /init 以生成起点。逐行阅读,删除显而易见的内容,并补充团队实际工作中的缺失。基于 /init 输出进行调整比白手起家更快,但自动生成的内容绝不能不经审核就投入使用。
如果您更喜欢从零写,先从五个部分开始:
文件日后随时可以扩展;而从精简起步意味着每一行新增都源于真实错误,而非臆测。
有两个信号说明文件需要维护:
两者的应对都相同:更少的字,更清晰的结构。
单人项目的文件可以一直保持这么精简。一旦团队参与,文件就需要不同的组织结构。
项目级的 CLAUDE.md 应纳入 git。它是一份共享文档,团队成员可以根据自己的失误不断补充规则,让它变得更好。对它的修改应像代码 PR 一样对待:需要评审,并质疑每一行新增是否“配得上它的位置”。
当约定多到一份文件装不下时,将它们移到 .claude/rules/ 中。每个 Markdown 文件覆盖一个主题,并使用具描述性的文件名:testing.md、api-design.md、database-migrations.md。Claude 会递归发现这些文件,并以与主 CLAUDE.md 相同的优先级加载它们。
基于路径的规则能让定位更精准。加入 YAML frontmatter 后,仅当 Claude 操作匹配的文件时才会加载该规则:
---
paths:
  - "src/api/**/*.ts"
---
# API conventions go here
这样在做后端工作时,前端约定不会占用指令预算,反之亦然。
在团队约定相互冲突的 monorepo 中,claudeMdExcludes 可用于阻止特定文件被加载:
{
  "claudeMdExcludes": [
    "**/other-team/.claude/rules/**"
  ]
}
将此放入 .claude/settings.local.json,以避免纳入版本控制。
在扩展 CLAUDE.md 时,大家往往想要集中化:一个大文件装下所有内容。这是错误方向。将 monorepo 的 CLAUDE.md 拆分到服务级别的 文件 可以减少 80% 的总字数,同时提升 Claude 遵循规则的效果;每次会话需要阅读的内容更少,过滤负担也更小。
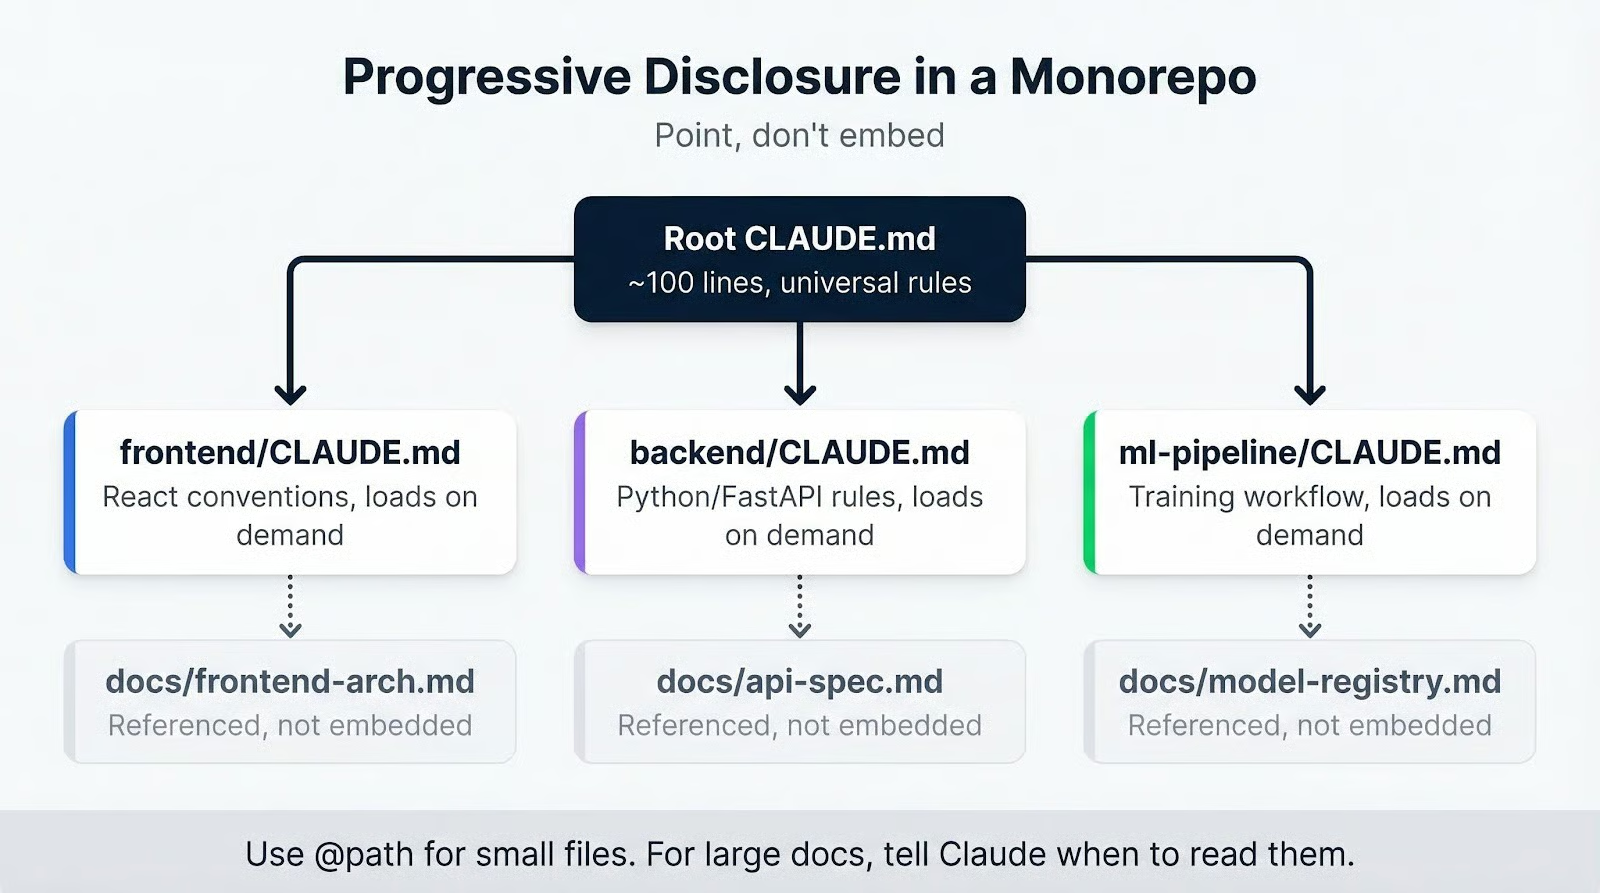 原则是:引用,不内嵌。与其使用
@path/to/big-doc.md(这会在每次会话中加载整份文件),不如写“关于迁移流程,请参见 docs/migrations.md。”Claude 需要时再去读取。 @ 导入语法适合小文件,体量较大的内容应当引用而非内嵌。
子目录级 CLAUDE.md 完善了这一模式。位于 frontend/CLAUDE.md 的 React 约定只会在 Claude 处理该目录下文件时加载。后端规则在前端工作时不会造成干扰。
只要掌握了这些基本单元,结构层面的扩展基本就解决了。但项目会变、约定会演进。六个月前合情合理的规则,今天可能已成噪音,挤占了当下真正重要的内容。持续的挑战在于,如何让这份文件随时间保持“诚实”。
新增规则时要比您想象的更克制。只有当 Claude 真正犯下一个本可由该行避免的错误时,这一行才值得加入。每条规则都应能追溯到一次真实事件,而非一条假想中的情况。
反向也同样重要:如果 Claude 在没有提示的情况下已能遵循某个约定,那么这条规则就是累赘。删掉它,释放指令预算给那些能改变行为的规则。
一种低成本的维护习惯是每隔几周对 Claude 说:“请审阅这份 CLAUDE.md 并提出改进建议”。它能发现规则之间的矛盾、标记重叠的指令、并指出可以更简练的表述。
您也可以在文件里加入一条常驻指令:“当你在会话中遇到错误假设,请建议对 CLAUDE.md 的修正。”这样就建立起一个在日常使用中自我改进的反馈回路。
最常见的失败模式是“越积越多”。每次糟糕的会话后都会新增规则,却无人清理那些已不再重要的内容;最终,文件长到 Claude 会过滤掉其中一半。当 Claude 总是忽略某条规则时,在臃肿文件上再加强调也无济于事。该做的是“修枝剪叶”。
如果您用 @ 导入大文件,那就是第二个需要检查的问题。用 @ 导入的 500 行架构文档会在每次会话中整份嵌入,在 Claude 看到第一条真正规则前就已经烧光了大半指令预算。请改用引用。
只用 /init 自动生成且从不打磨,是在各个方面走向不良行为的可靠方式。CLAUDE.md 中的一条错误指令并不只影响一次回复。它会影响 Claude 的调研、规划与实施,贯穿每一次会话,直到有人发现为止。
跨多份文件的相互矛盾规则会导致不可预测的行为。当两条规则冲突时,Claude 会自行择一而不告知您选择了哪条。在既有根级 CLAUDE.md 又有多个 .claude/rules/ 文件的项目中,这种情况更糟。定期对所有指令文件进行联动审查是唯一的预防手段。
不是每个错误都值得新增规则。有些失败是一次性的。为每个边界情况都加一条规则,会让文件充满条件化指令——在少数场景中有用,但在大多数会话里适得其反。我们始终追求的目标只有一个:一份短小精悍、每一行都能改变行为的文件。
CLAUDE.md 可能是 Claude Code 项目中“承重”最高的文件。它在您输入第一个提示词之前就已塑造每次会话,而一份维护得当的文件,其价值会在数周的工作中不断复利。
如果您还没有,先运行 /init,读一遍输出,并删掉所有“即便删了也不会避免真实错误”的行。若您已有一份,现在就把它打开并应用同样的检验。如果您的 CLAUDE.md 必须巨大才能解释清楚项目,那说明是项目工具链过于复杂,而不是您需要更大的文件。
正确的下一步:今天就审计您的仓库并起草一份基线版本。从五个部分开始,将其控制在 60 行以内,并让真实错误驱动其后的每一次增补。
如果您想基于Anthropic API 构建工具,我们的 Introduction to Claude Models 课程将覆盖完整的模型家族,并教您如何高效使用它们。
AI 课程
课程
学习路径
课程
