Curso
Introdução aos modelos Claude
3 h
14.4K
O prompt de sistema do Claude Code já ocupa cerca de 50 instruções antes da sua sessão começar. Pesquisas com LLMs de fronteira mostram que a obediência a instruções começa a degradar por volta de 150 a 200 instruções totais, o que deixa algo entre 100 e 150 "vagas" para tudo o que você quer que o Claude saiba sobre o seu projeto.
CLAUDE.md é o arquivo que preenche essas vagas. É um arquivo markdown que o Claude Code lê no início de toda sessão, dando a ele contexto persistente sobre seu código sem você precisar se repetir. Mas o Claude filtra ativamente o que considera irrelevante para a tarefa atual. Um arquivo inchado não só desperdiça espaço; ele compete com as regras que realmente importam.
Este tutorial mostra como construir um CLAUDE.md que faça cada linha valer: o que entra, o que fica de fora, como estruturar para times e como mantê-lo útil ao longo do tempo.
Também recomendo conferir nossos outros guias recentes do Claude Code:
CLAUDE.md é um arquivo markdown que o Claude Code carrega automaticamente no começo de toda conversa. Ele fica na raiz do projeto e dá ao Claude instruções permanentes sobre vários pontos relevantes:
Sem ele, toda sessão começa do zero. Você repete o mesmo contexto, corrige as mesmas suposições e vê o Claude cometer os mesmos erros de ontem. O CLAUDE.md resolve isso ao codificar o conhecimento do seu projeto uma única vez.
Ele é um entre vários sistemas de contexto que o Claude Code usa, e cada um cuida de um tipo de trabalho:
|
Sistema |
Quem escreve |
O que faz |
Quando carrega |
|
|
Você |
Regras, convenções e restrições do projeto que você define |
Toda sessão (arquivo completo) |
|
Memória ( |
Claude |
Padrões e fatos que ele descobre sozinho durante as sessões |
Toda sessão (primeiras 200 linhas) |
|
Você |
Conhecimento de domínio para fluxos específicos, carregado sob demanda |
Sob demanda |
|
|
Você |
Comandos de shell que rodam em gatilhos como pre-commit ou post-edit |
Em pontos de gatilho específicos |
Executar /init gera um CLAUDE.md inicial analisando seu código, detectando sistemas de build, frameworks de teste e padrões. Se já existir um arquivo, ele sugere melhorias em vez de sobrescrever. É um bom ponto de partida, mas o arquivo é importante demais para ficar no piloto automático.
Um ponto importante: o conteúdo do CLAUDE.md também sobrevive ao /compact. Quando o contexto é comprimido no meio da sessão, o Claude relê o arquivo do disco e o reinsere do zero.
Arquivos CLAUDE.md podem viver em quatro lugares, do mais amplo ao mais específico:
Política gerenciada (nível da organização): /Library/Application Support/ClaudeCode/CLAUDE.md no macOS. Se aplica a todos os usuários da máquina e não pode ser excluído por nenhuma configuração. No Linux/WSL fica em /etc/claude-code/CLAUDE.md, e no Windows em C:\Program Files\ClaudeCode\CLAUDE.md.
Nível do usuário: ~/.claude/CLAUDE.md. Instruções pessoais que se aplicam a todos os projetos na sua máquina.
Nível do projeto: ./CLAUDE.md ou ./.claude/CLAUDE.md na raiz do repositório. Este é o que você commita no git e compartilha com o time.
Subdiretório: ./subdir/CLAUDE.md. Com escopo para aquele diretório e carregado sob demanda quando o Claude lê arquivos ali, não no início da sessão.
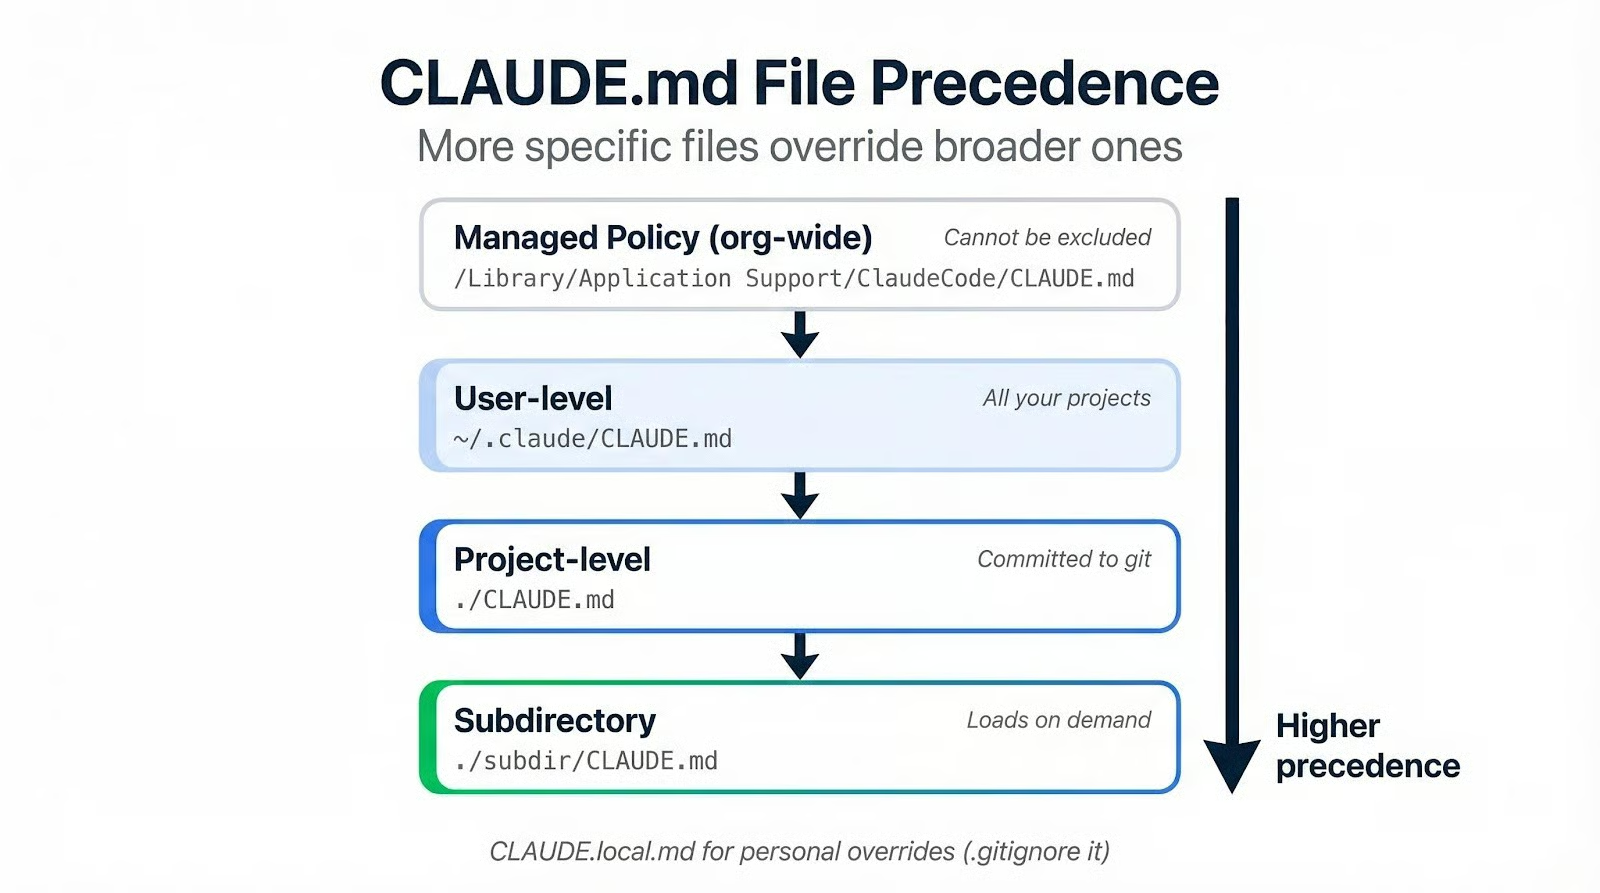
Arquivos mais específicos têm precedência sobre os mais gerais. Se o CLAUDE.md do projeto diz "use tabs" e o arquivo de usuário diz "use espaços", vence o do projeto.
Para preferências pessoais que não devem ir para o versionamento, crie um CLAUDE.local.md e adicione-o ao .gitignore. Manias de editor, estilos de commit preferidos ou overrides temporários vão aqui, sem poluir o arquivo compartilhado.
Sabendo onde o arquivo vive e com o que ele compete, a próxima pergunta é o que realmente deve entrar nele.
Um CLAUDE.md se divide em três camadas:
Se você leu as boas práticas do Claude Code, vai reconhecer o mesmo princípio aplicado a um escopo mais estreito. (Se não leu, vale muito a pena depois deste artigo!)
Comece com uma descrição do projeto em uma ou duas linhas e seu stack com versões. O Claude infere bastante lendo seu código, mas não vai adivinhar que você está no Next.js 15 em vez do 14, ou que escolheu Drizzle em vez de Prisma.
Inclua um mapa da estrutura de diretórios. Não precisa de cada arquivo, só o layout de topo com descrições curtas:
src/
  data/        # Data loading and preprocessing pipelines
  models/      # Model definitions and training loops
  evaluation/  # Metrics, validation, experiment tracking
  api/         # FastAPI endpoints for model serving
  tests/       # Co-located with source, test_*.py
Coloque os comandos comuns em blocos de código. Build, test, lint e inicialização do servidor de dev. Um comando dentro de um code fence é algo que o Claude executa literalmente. Um comando escrito em uma frase é uma sugestão — ele pode improvisar.
Suas decisões de arquitetura precisam estar no arquivo, porque, se não estiverem, o Claude vai tomar as dele. Se você escolheu SQLite em vez de Postgres por um motivo, diga. Se sua camada de API segue um padrão específico, explique o porquê.
A justificativa faz diferença real aqui. "Nunca dê force push" é uma instrução seca que o Claude pode ignorar sob pressão. "Nunca dê force push. Isso reescreve o histórico compartilhado e é irrecuperável para colaboradores" dá contexto para o Claude generalizar. Ele não vai só evitar git push --force. Vai hesitar antes de git reset --hard em uma branch compartilhada também.
Aqui entram convenções que o Claude não capta só lendo o código. Se você usa Conventional Commits (feat:, fix:, docs:), diga. Se as branches seguem um padrão como iniciais/descricao, registre.
Esquisitices e armadilhas também entram aqui. Todo codebase tem: o script de migração que deve rodar antes do build, a variável de ambiente que precisa de um valor específico para os testes passarem, o módulo que quebra se for importado fora de ordem. O Claude é um novo integrante a cada sessão — e são essas as coisas em que um novo contratado tropeça no primeiro dia.
O que você pode pular: qualquer coisa que o Claude já saiba pela linguagem. Não precisa dizer para usar async/await no JavaScript moderno ou preferir pathlib no Python 3. Se a convenção é o padrão da linguagem, anotar é ruído que ofusca o que realmente importa.
Acertar o conteúdo é a parte mais fácil. A mais difícil é escrever instruções que o Claude realmente seguirá — e saber o que cortar.
Especificidade vence intenção sempre. "Formate o código direito" não diz nada ao Claude. "Use indentação de 2 espaços, sem ponto e vírgula, aspas simples" diz exatamente o que fazer e dá algo verificável.
Aplique este teste a cada linha: "Tirar isso faria o Claude errar?" Se a resposta for não, corte. A recomendação oficial é ficar abaixo de 200 linhas por arquivo, e times experientes rodam com menos de 60. Não é minimalismo por si só: um arquivo mais curto significa mais leitura efetiva.
Limite os níveis de heading a, no máximo, três. Use nomes de seção que agentes reconhecem dos READMEs: Commands, Structure, Conventions, Testing. Tentar ser criativo com nomes adiciona atrito porque o Claude já viu milhões de READMEs e tem expectativas fortes sobre o que vai em cada lugar.
Se uma regra continua sendo ignorada apesar de estar no arquivo, não adicione mais palavras. Prefixe com IMPORTANT: ou YOU MUST. Use com parcimônia: ênfase demais perde efeito.
Impor estilo de código é a maior armadilha. Formatação, indentação, ordem de imports: são problemas determinísticos com soluções determinísticas. Linters e formatadores como Biome, ESLint ou Ruff resolvem mais rápido, barato e com 100% de consistência. Gastar orçamento de instrução com estilo é peso morto: o mesmo que um pre-commit faz de graça.
Convenções padrão da linguagem também ficam de fora — o Claude já conhece padrões de TypeScript e idioms de Python. Documentação completa de API deve ser linkada, não colada. Instruções específicas de tarefas que só se aplicam a certos fluxos vão em skills, carregadas sob demanda em vez de ocuparem espaço em toda sessão.
Um padrão que vale destacar: restrições só com negação. "Nunca use --legacy-peer-deps" deixa o Claude sem saída diante de conflito de dependência. Emparelhe toda proibição com uma direção: "Nunca use --legacy-peer-deps; resolva conflitos atualizando o pacote para uma versão compatível." Se você já trabalhou com Cursor Rules ou arquivos de configuração de IA semelhantes, vai ver que isso se aplica em diversas ferramentas.
Veja na prática. À esquerda, uma seção típica de CLAUDE.md gerada automaticamente e cheia de conselhos genéricos que o Claude já sabe. À direita, a mesma seção após aplicar o teste de especificidade: só sobrevivem fatos específicos do projeto.
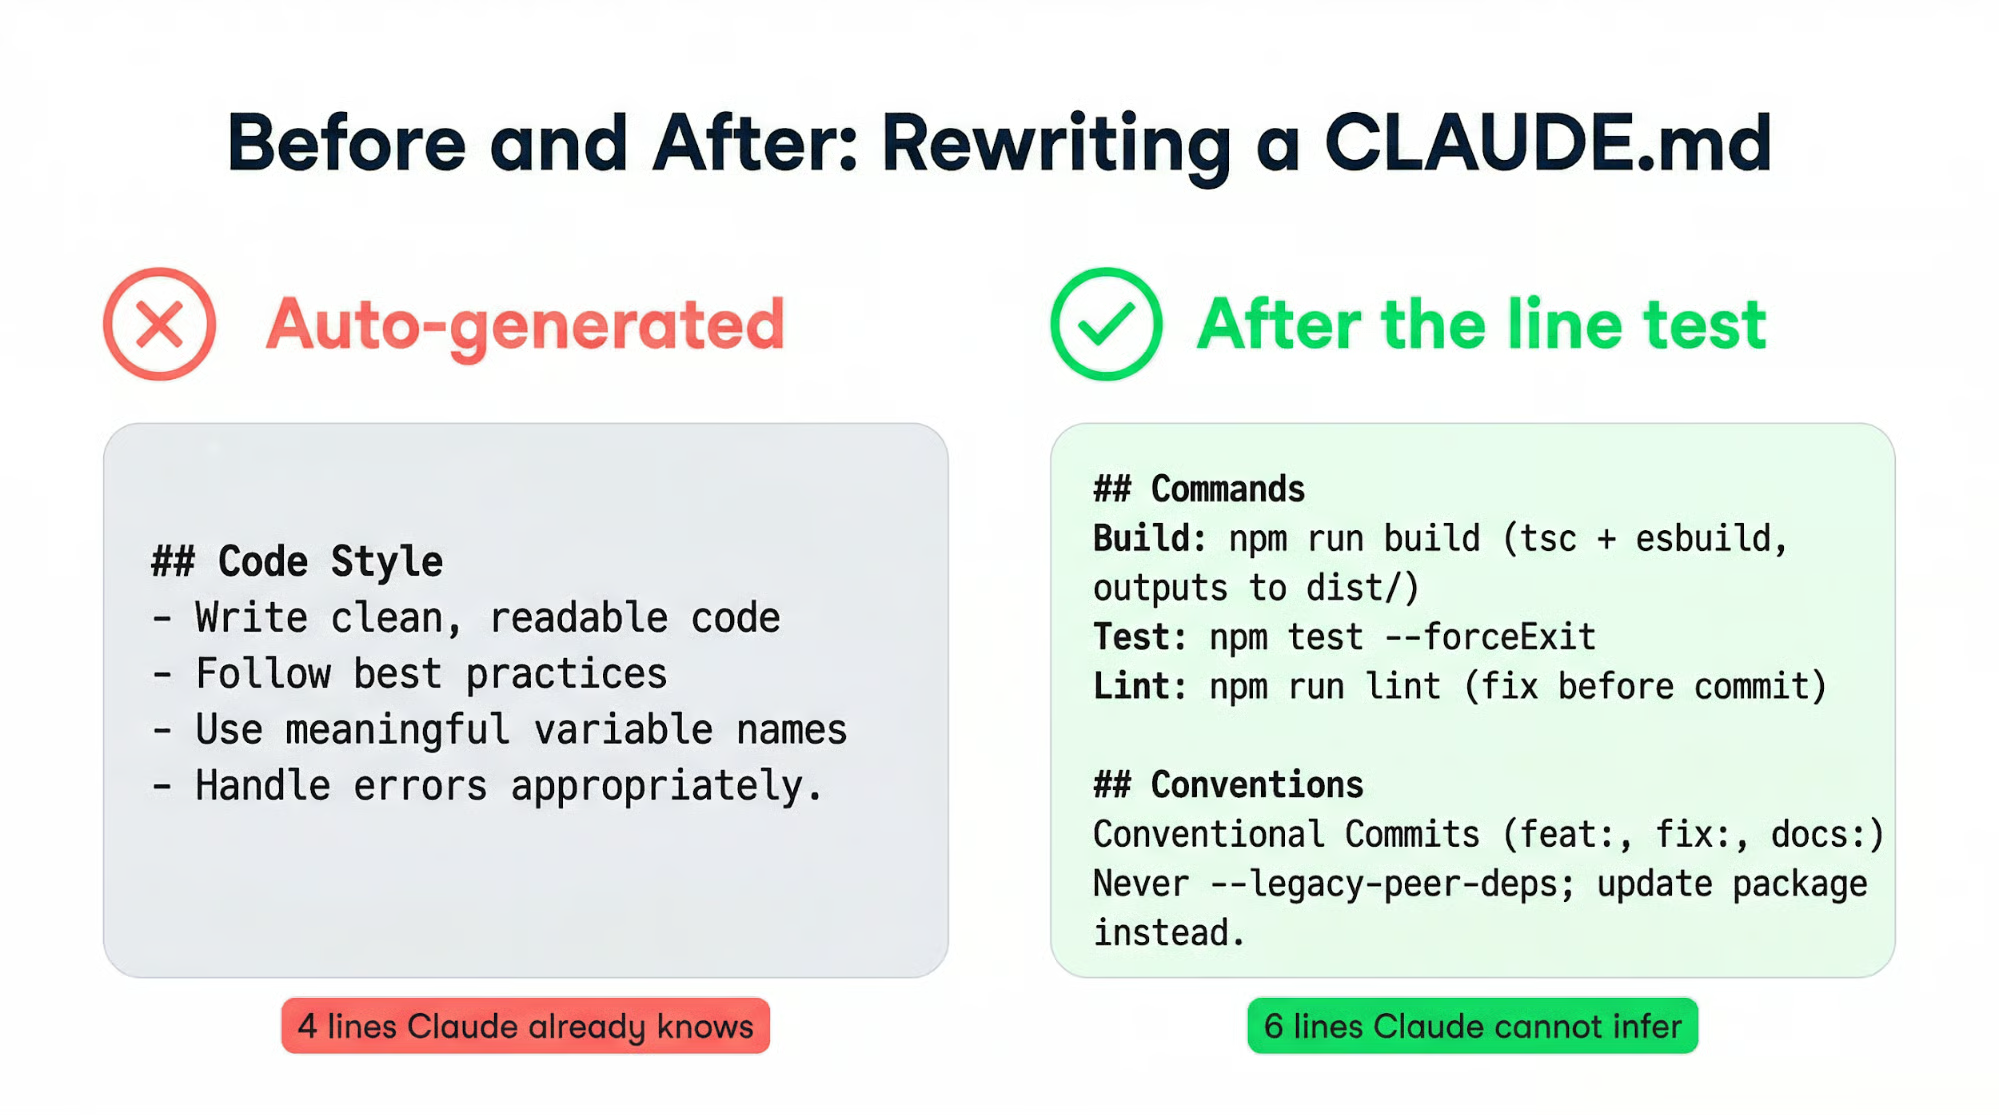
A segunda versão é mais curta e informa ao Claude o que ele não consegue inferir do codebase.
Rode /init na raiz do projeto para gerar um ponto de partida. Leia cada linha, corte o óbvio e adicione o que falta com base em como seu time realmente trabalha. Começar pela saída do /init é mais rápido do que uma página em branco, mas conteúdo gerado automaticamente não deve ser entregue sem revisão.
Se preferir escrever do zero, comece com cinco seções:
Você pode expandir depois. Começar mínimo significa que cada linha adicionada vem de um erro real, não de especulação.
Dois sinais mostram que o arquivo precisa de manutenção:
Ambos apontam para o mesmo remédio: menos palavras, estrutura mais clara.
Para um único desenvolvedor, dá para manter o arquivo enxuto indefinidamente. Quando o time cresce, a estrutura precisa mudar.
O CLAUDE.md do projeto deve ir para o git. É documentação compartilhada que melhora à medida que colegas adicionam regras a partir dos próprios tropeços. Trate mudanças nele como PRs de código: revise e questione se cada nova linha merece ficar.
Quando as convenções ultrapassarem o que cabe em um único arquivo, mova para .claude/rules/. Cada Markdown cobre um tema com nomes descritivos: testing.md, api-design.md, database-migrations.md. O Claude descobre esses arquivos recursivamente e os carrega com a mesma prioridade do CLAUDE.md principal.
Regras com escopo por caminho deixam tudo ainda mais direcionado. Adicione YAML frontmatter e a regra só carrega quando o Claude trabalha com arquivos correspondentes:
---
paths:
  - "src/api/**/*.ts"
---
# API conventions go here
Suas convenções de frontend não gastam orçamento de instrução durante o trabalho de backend — e vice-versa.
Em monorepos onde times têm convenções conflitantes, claudeMdExcludes bloqueia o carregamento de arquivos específicos:
{
  "claudeMdExcludes": [
    "**/other-team/.claude/rules/**"
  ]
}
Coloque isso em .claude/settings.local.json para manter fora do versionamento.
Escalar um CLAUDE.md costuma dar vontade de centralizar: um arquivo gigante com tudo. É o caminho errado. Dividir o CLAUDE.md de um monorepo por serviço pode reduzir o total de palavras em 80% ao mesmo tempo em que improva a obediência do Claude às regras; menos leitura por sessão significa menos filtragem.
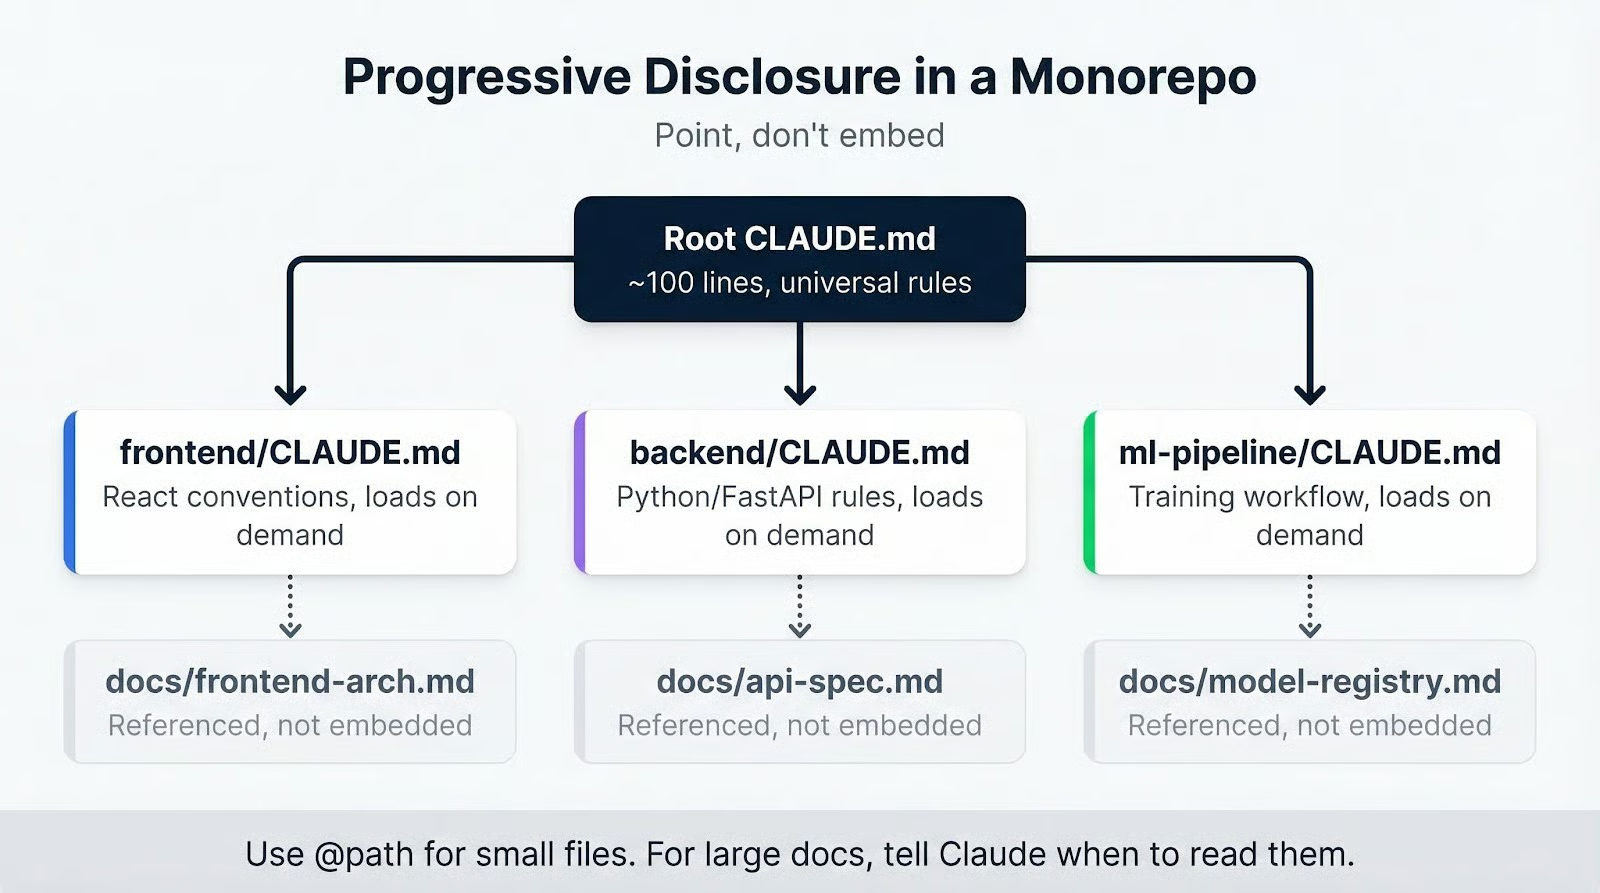 O princípio é: aponte, não incorpore. Em vez de
@path/to/big-doc.md (que carrega o arquivo inteiro em toda sessão), escreva "Para procedimentos de migração, veja docs/migrations.md." O Claude lê quando precisar. A sintaxe de importação com @ funciona para arquivos pequenos, mas qualquer coisa substancial é melhor referenciar do que embutir.
Arquivos CLAUDE.md em subdiretórios completam esse padrão. Um frontend/CLAUDE.md com convenções de React carrega só quando o Claude trabalha naquela pasta. Regras de backend não atrapalham o trabalho de frontend.
Escalar a estrutura fica fácil quando você conhece os blocos básicos. Mas projetos mudam e convenções evoluem. Regras que faziam sentido há seis meses viram ruído que atrapalha o que importa agora. O desafio contínuo é manter o arquivo honesto ao longo do tempo.
Adicione regras mais devagar do que você acha que deveria. Uma nova linha só pertence ao arquivo quando o Claude cometer um erro real que ela teria prevenido. Toda regra deve rastrear a um incidente real, não a um hipotético.
O inverso também importa: se o Claude já segue uma convenção sem ser instruído, essa regra é peso morto. Remova e libere orçamento para regras que mudem o comportamento.
Um hábito de baixa fricção é pedir ao Claude, "Revise este CLAUDE.md e sugira melhorias" a cada poucas semanas. Ele encontra contradições, aponta sobreposições e identifica trechos que podem ficar mais enxutos.
Você também pode adicionar uma instrução permanente no próprio arquivo: "Ao encontrar uma suposição errada durante a sessão, sugira uma correção no CLAUDE.md". Isso cria um ciclo de feedback em que o arquivo melhora com o uso normal.
O erro mais comum é acumular. Regras se empilham depois de cada sessão frustrante, ninguém remove o que deixou de importar e, no fim, o arquivo fica tão longo que o Claude filtra metade. Se o Claude continua ignorando uma regra, adicionar ênfase em cima de um arquivo inchado não resolve. Poda resolve.
Se você está usando imports com @ para arquivos grandes, esse é o segundo ponto a checar. Um doc de arquitetura com 500 linhas importado com @ embute o documento inteiro em toda sessão, queimando seu orçamento de instruções antes do Claude processar a primeira regra de fato. Prefira referenciar.
Gerar com /init e nunca lapidar o resultado é receita certa para comportamento ruim. Uma instrução errada no CLAUDE.md não afeta só uma resposta: ela molda a pesquisa, o planejamento e a implementação do Claude em toda sessão até alguém perceber.
Regras contraditórias espalhadas em vários arquivos geram comportamento imprevisível. Quando duas regras conflitam, o Claude escolhe uma sem avisar qual. Isso piora em projetos com um CLAUDE.md raiz e vários arquivos em .claude/rules/. A única prevenção é revisão periódica de todos os arquivos de instrução.
Nem todo erro merece uma nova regra. Alguns são casos isolados. Adicionar regra para cada exceção cria um arquivo cheio de condicionais que ajudam em situações raras e atrapalham na maioria. O objetivo sempre foi o mesmo: um arquivo curto em que cada linha muda o comportamento.
CLAUDE.md provavelmente é o arquivo mais crítico em um projeto com Claude Code. Ele molda toda sessão antes mesmo de você digitar o primeiro prompt, e um arquivo bem mantido gera ganhos compostos ao longo de semanas.
Se você ainda não tem, rode /init, leia a saída e corte toda linha que não impediria um erro real. Se já tem, abra agora e aplique o mesmo teste. Se o seu CLAUDE.md precisa ser enorme para explicar o projeto, isso indica que a sua ferramenta está complexa demais — não que você precisa de um arquivo maior.
Próximo passo: audite o repositório e rascunhe uma base hoje. Comece com cinco seções, mantenha abaixo de 60 linhas e deixe erros reais guiarem cada adição.
Se você quer criar ferramentas que usem a Anthropic API, nosso curso Introduction to Claude Models cobre toda a família de modelos e ensina a usá-los com eficiência.
Cursos de IA
Curso
Programa
Curso
blog
DataCamp Team
4 min
Tutorial
Abid Ali Awan
Tutorial
Moez Ali
12 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
Matt Crabtree
6 min