Kurs
Einführung in die Claude-Modelle
3 Std.
14.4K
Der System-Prompt von Claude Code belegt bereits rund 50 Anweisungen, bevor deine Session startet. Forschung zu fortgeschrittenen LLMs zeigt, dass die Befolgung von Anweisungen ab etwa 150 bis 200 Gesamtinstruktionen nachlässt. Das lässt dir ungefähr 100 bis 150 Plätze für alles, was Claude über dein Projekt wissen soll.
CLAUDE.md füllt diese Plätze. Es ist eine Markdown-Datei, die Claude Code zu Beginn jeder Session liest und die ihm dauerhaft Kontext zu deinem Code-Repository gibt – ohne dass du dich wiederholen musst. Claude filtert jedoch aktiv Inhalte heraus, die es für die aktuelle Aufgabe als irrelevant ansieht. Eine aufgeblähte Datei verschwendet nicht nur Platz; sie konkurriert mit deinen eigentlichen Regeln.
Dieses Tutorial zeigt, wie du eine CLAUDE.md erstellst, bei der jede Zeile zählt: Was hinein gehört, was draußen bleibt, wie du sie für Teams strukturierst und wie sie langfristig nützlich bleibt.
Schau dir außerdem unsere weiteren aktuellen Claude-Code-Guides an:
CLAUDE.md ist eine Markdown-Datei, die Claude Code zu Beginn jeder Unterhaltung automatisch lädt. Sie liegt im Projektroot und gibt Claude verbindliche Anweisungen zu allen relevanten Fakten:
Ohne sie startet jede Session bei null. Du erklärst denselben Kontext, korrigierst dieselben Annahmen und siehst, wie Claude dieselben Fehler macht wie gestern. CLAUDE.md löst das, indem es dein Projektwissen einmalig festhält.
Sie ist eines von mehreren Kontextsystemen, die Claude Code nutzt – jedes mit eigener Aufgabe:
|
System |
Wer schreibt es |
Wozu es dient |
Wann es geladen wird |
|
|
Du |
Projektrichtlinien, Konventionen und Rahmenbedingungen, die du festlegst |
Jede Session (gesamte Datei) |
|
Memory ( |
Claude |
Muster und Fakten, die es während Sessions eigenständig erkennt |
Jede Session (erste 200 Zeilen) |
|
Du |
Domänenwissen für spezifische Workflows, auf Abruf geladen |
Bei Bedarf |
|
|
Du |
Shell-Befehle an Triggerpunkten wie pre-commit oder post-edit |
An definierten Triggerpunkten |
Mit /init erzeugst du eine Startversion der CLAUDE.md. Claude analysiert dazu deine Codebasis, erkennt Buildsysteme, Testframeworks und Codepatterns. Existiert bereits eine Datei, schlägt es Verbesserungen vor, statt sie zu überschreiben. Das ist ein guter Einstieg – aber die Datei ist zu wichtig, um sie im Autopilot zu lassen.
Wichtig: Inhalte aus CLAUDE.md überstehen auch /compact. Wenn der Kontext in der Session komprimiert wird, liest Claude die Datei erneut von der Festplatte und injiziert sie frisch.
CLAUDE.md-Dateien können an vier Stellen liegen – von allgemein zu spezifisch:
Verwaltete Richtlinie (org-weit): /Library/Application Support/ClaudeCode/CLAUDE.md auf macOS. Gilt für alle Nutzer:innen der Maschine und kann nicht ausgeschlossen werden. Unter Linux/WSL unter /etc/claude-code/CLAUDE.md, unter Windows unter C:\Program Files\ClaudeCode\CLAUDE.md.
Auf Nutzerebene: ~/.claude/CLAUDE.md. Persönliche Anweisungen, die für alle Projekte auf deinem Rechner gelten.
Auf Projektebene: ./CLAUDE.md oder ./.claude/CLAUDE.md im Repo-Root. Diese Datei committest du in git und teilst sie mit dem Team.
Unterverzeichnis: ./subdir/CLAUDE.md. Gilt nur für dieses Verzeichnis und wird bei Bedarf geladen, wenn Claude dort Dateien liest – nicht beim Sessionstart.
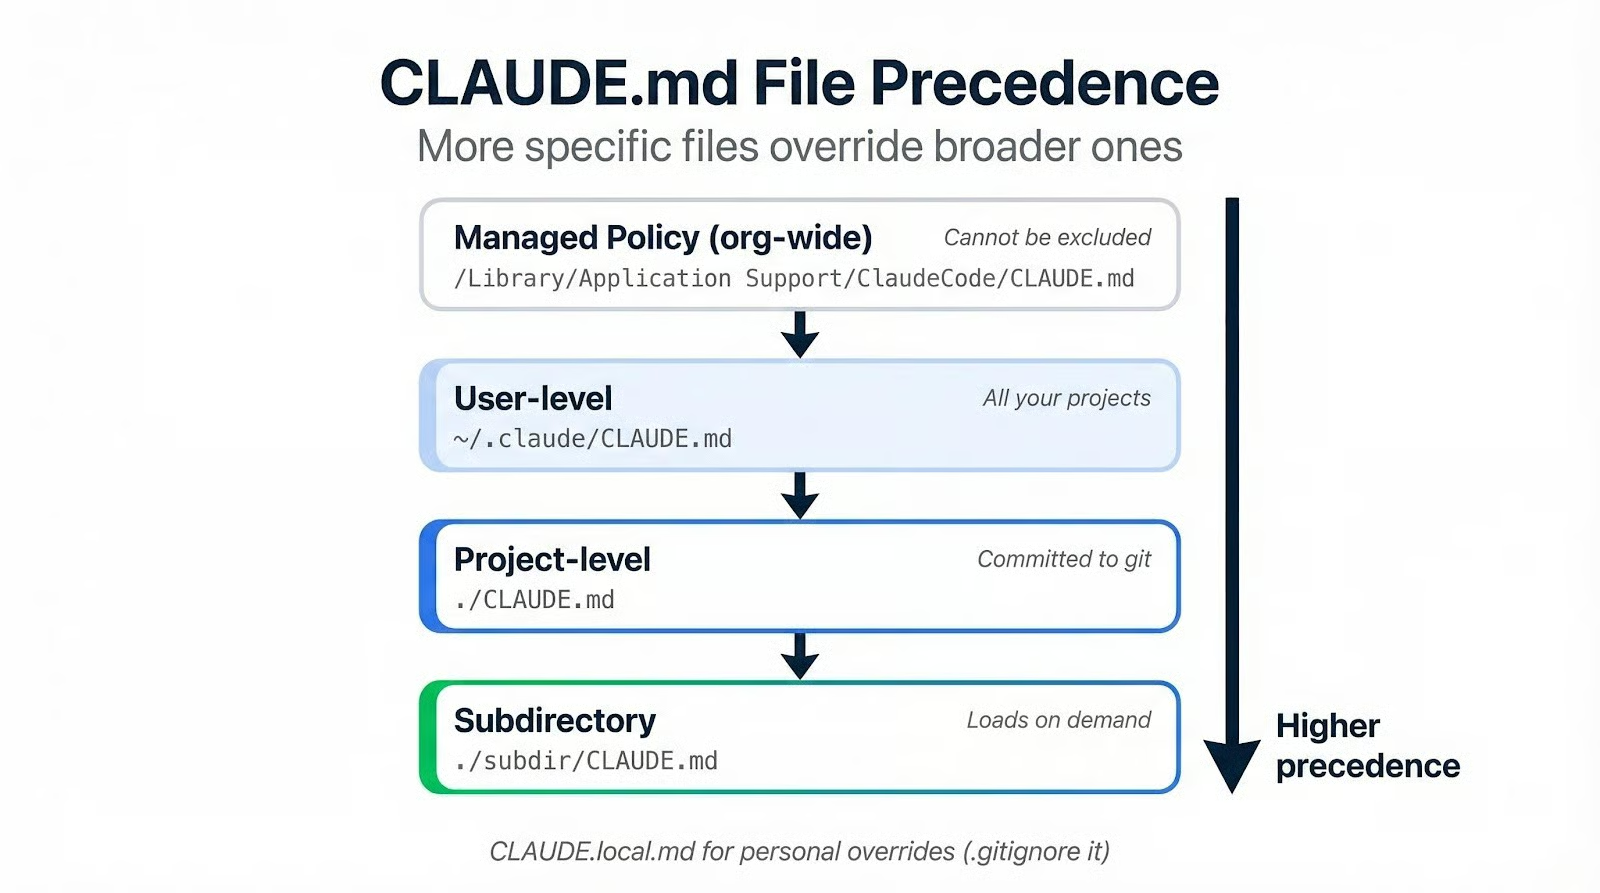
Spezifischere Dateien haben Vorrang vor allgemeineren. Wenn in deiner Projekt-CLAUDE.md „Tabs verwenden“ steht und in deiner Nutzerdatei „Spaces verwenden“, gewinnt die Projektdatei.
Für persönliche Vorlieben, die nicht in die Versionskontrolle gehören, erstelle eine CLAUDE.local.md und füge sie zu .gitignore hinzu. Editor-Eigenheiten, bevorzugte Commitstile oder temporäre Overrides gehören hierher – ohne die gemeinsame Datei zu verwässern.
Wenn klar ist, wo die Datei lebt und womit sie konkurriert, stellt sich als Nächstes die Frage: Was gehört wirklich hinein?
Eine CLAUDE.md besteht aus drei Ebenen:
Wenn du Claude Code Best Practices gelesen hast, erkennst du das Prinzip – hier nur auf eine engere Fläche angewendet. (Falls nicht, lies den Guide unbedingt im Anschluss!)
Starte mit einer ein- bis zweizeiligen Projektbeschreibung und deinem Tech-Stack mit Versionsnummern. Claude kann aus dem Code viel ableiten, aber nicht raten, dass ihr auf Next.js 15 statt 14 seid oder Drizzle statt Prisma nutzt.
Füge eine Verzeichnisübersicht hinzu. Nicht jede Datei, nur die Top-Ebene mit kurzen Beschreibungen:
src/
  data/        # Data loading and preprocessing pipelines
  models/      # Model definitions and training loops
  evaluation/  # Metrics, validation, experiment tracking
  api/         # FastAPI endpoints for model serving
  tests/       # Co-located with source, test_*.py
Häufige Befehle gehören in Codeblöcke: Build, Test, Lint und Dev-Server-Start. Ein Befehl in einem Code-Fence wird von Claude wortgetreu ausgeführt. Ein Befehl im Fließtext ist eher eine Anregung, an der es improvisieren könnte.
Architekturentscheidungen müssen in die Datei, sonst trifft Claude eigene. Wenn ihr SQLite statt Postgres aus gutem Grund gewählt habt, schreibe es. Wenn die API-Schicht einem bestimmten Muster folgt, erläutere die Begründung.
Begründungen leisten hier echte Arbeit. „Niemals force pushen“ ist eine platte Anweisung, die Claude unter Druck ignorieren könnte. „Niemals force pushen. Das überschreibt gemeinsame Historie und ist für andere nicht wiederherstellbar“ gibt genug Kontext zum Generalisieren. Es wird nicht nur git push --force meiden, sondern auch bei git reset --hard auf einem Shared-Branch zögern.
Hier landen Konventionen, die Claude nicht aus dem Code lesen kann. Wenn ihr Conventional Commits (feat:, fix:, docs:) verwendet, schreibe es. Wenn Branches einem Muster wie initials/description folgen, halte es fest.
Auch Eigenheiten und Fallen gehören hierher. Jede Codebasis hat sie: das Migrationsskript, das vor dem Build laufen muss, die Umgebungsvariable, die einen bestimmten Wert braucht, damit Tests grün werden, das Modul, das bricht, wenn es in falscher Reihenfolge importiert wird. Claude ist in jeder Session ein neues Teammitglied – genau darüber stolpert sonst jeder New Hire am ersten Tag.
Was du weglassen kannst: alles, was Claude bereits aus der Sprache kennt. Du musst nicht an async/await in modernem JavaScript erinnern oder an pathlib in Python 3. Wenn eine Konvention Standard der Sprache ist, ist sie Rauschen, das die wirklich wichtigen Anweisungen verdrängt.
Den richtigen Inhalt zu finden, ist der leichtere Teil. Schwieriger ist, Anweisungen so zu formulieren, dass Claude ihnen wirklich folgt – und zu wissen, was man streicht.
Spezifität schlägt Absicht – immer. „Code ordentlich formatieren“ sagt Claude nichts. „Einrückung mit 2 Leerzeichen, keine Semikolons, einfache Anführungszeichen“ sagt exakt, was zu tun ist, und macht es überprüfbar.
Lege jede Zeile an diesem Test an: „Würde das Entfernen dazu führen, dass Claude Fehler macht?“ Wenn nein, raus damit. Offiziell empfohlen werden unter 200 Zeilen pro Datei; erfahrene Teams kommen mit unter 60 aus. Das ist kein Selbstzweck-Minimalismus: Eine kürzere Datei wird zu größeren Teilen gelesen.
Begrenze Überschriftsebenen auf maximal drei. Verwende Abschnittsnamen, die Agenten aus READMEs kennen: Commands, Structure, Conventions, Testing. Kreative Bezeichnungen sorgen für Reibung, weil Claude Millionen READMEs gesehen hat und klare Erwartungen hat, was wo steht.
Wenn eine Regel ignoriert wird, obwohl sie in der Datei steht, schreibe nicht mehr Worte darum. Setze ein Präfix wie IMPORTANT: oder YOU MUST. Aber sparsam – zu viel Hervorhebung verliert Wirkung.
Code-Style-Erzwingung ist die größte Falle. Formatierung, Einrückung, Importreihenfolge – deterministische Probleme mit deterministischen Lösungen. Linter und Formatter wie Biome, ESLint oder Ruff erledigen das schneller, günstiger und mit 100% Konsistenz. Instruktionsbudget für Stilregeln zu verbraten, ist Ballast: Dasselbe erledigt ein Pre-Commit-Hook kostenlos.
Standardkonventionen der Sprache gehören ebenfalls auf die Ausschlussliste – Claude kennt TypeScript-Patterns und Python-Idiome bereits. Vollständige API-Dokumentation solltest du verlinken statt einbetten. Aufgabenspezifische Anweisungen, die nur für bestimmte Workflows gelten, gehören in Skills – sie werden bei Bedarf geladen, statt in jeder Session Platz zu belegen.
Ein Muster, das erwähnenswert ist: reine Negation. „Niemals --legacy-peer-deps verwenden“ lässt Claude hängen, wenn ein Abhängigkeitskonflikt auftaucht. Paare jedes Verbot mit einer Richtung: „Niemals --legacy-peer-deps verwenden; löse Konflikte durch Aktualisieren auf eine kompatible Paketversion.“ Wenn du mit Cursor Rules oder ähnlichen AI-Konfigurationsdateien gearbeitet hast, erkennst du: Dieses Prinzip gilt toolübergreifend.
So sieht der Unterschied in der Praxis aus. Links: eine typische, automatisch generierte CLAUDE.md-Sektion voll generischer Tipps, die Claude ohnehin kennt. Rechts: dieselbe Sektion nach dem Spezifitäts-Test – übrig bleiben nur projektspezifische Fakten.
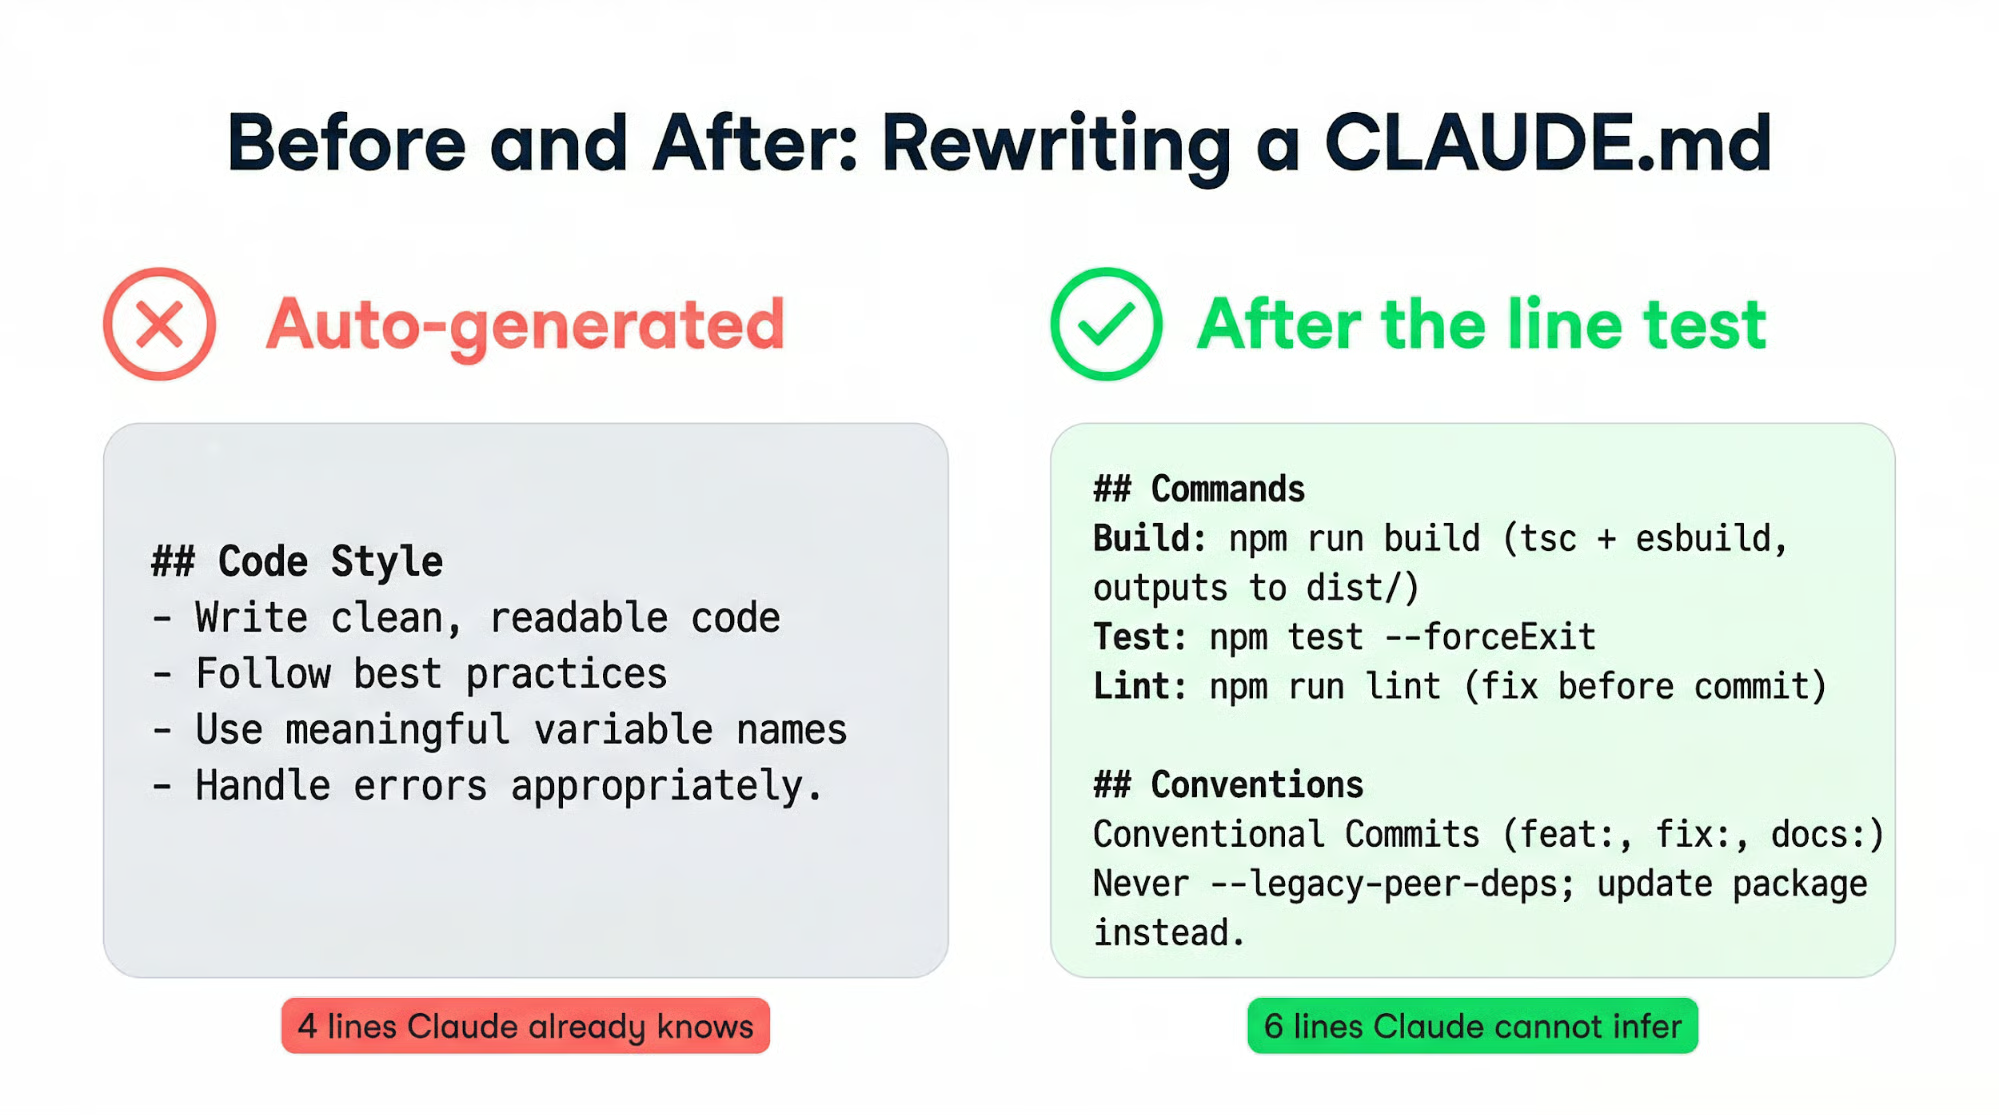
Die zweite Version ist kürzer und vermittelt Claude Dinge, die es nicht aus der Codebasis ableiten kann.
Führe /init im Projektroot aus, um einen generierten Ausgangspunkt zu erhalten. Lies jede Zeile, streiche das Offensichtliche und ergänze, was in eurem tatsächlichen Teamalltag fehlt. Vom /init-Output zu starten, ist schneller als von einer leeren Datei – aber Auto-Content sollte nie ungeprüft ins Repo wandern.
Wenn du lieber selbst schreibst, starte mit fünf Sektionen:
Du kannst die Datei später immer erweitern – ein schlanker Start stellt sicher, dass jede Zeile auf einem echten Fehler basiert, nicht auf Spekulation.
Zwei Signale zeigen dir, dass die Datei Pflege braucht:
Die Lösung ist in beiden Fällen dieselbe: weniger Worte, klarere Struktur.
Bei Solo-Projekten kann die Datei dauerhaft so schlank bleiben. In Teams braucht sie eine andere Art von Struktur.
Deine projektweite CLAUDE.md gehört in git. Es ist gemeinsame Dokumentation, die besser wird, wenn Teammitglieder Regeln aus ihren eigenen Fehlern beisteuern. Behandle Änderungen daran wie Code-PRs: reviewen, hinterfragen, ob jede neue Zeile ihren Platz verdient.
Wenn Konventionen den Rahmen einer einzelnen Datei sprengen, verschiebe sie nach .claude/rules/. Jede Markdown-Datei behandelt ein Thema mit sprechenden Dateinamen: testing.md, api-design.md, database-migrations.md. Claude findet diese Dateien rekursiv und lädt sie mit derselben Priorität wie die Haupt-CLAUDE.md.
Pfadbezogene Regeln machen es noch gezielter. Füge YAML-Frontmatter hinzu, und die Regel lädt nur, wenn Claude mit passenden Dateien arbeitet:
---
paths:
  - "src/api/**/*.ts"
---
# API conventions go here
So verbrauchst du beim Frontend nicht das Instruktionsbudget fürs Backend – und umgekehrt.
In Monorepos mit kollidierenden Teamkonventionen blockt claudeMdExcludes bestimmte Dateien vom Laden:
{
  "claudeMdExcludes": [
    "**/other-team/.claude/rules/**"
  ]
}
Füge das in .claude/settings.local.json ein, damit es nicht in die Versionskontrolle gerät.
Das Skalieren einer CLAUDE.md verleitet schnell zum Zentralisieren: eine große Datei mit allem. Das ist der falsche Weg. Eine Aufteilung der Monorepo-CLAUDE.md in Service-Level-Dateien kann den Gesamtumfang um 80% reduzieren und gleichzeitig die Regelbefolgung verbessern – weniger Lesestoff pro Session heißt weniger Filterung.
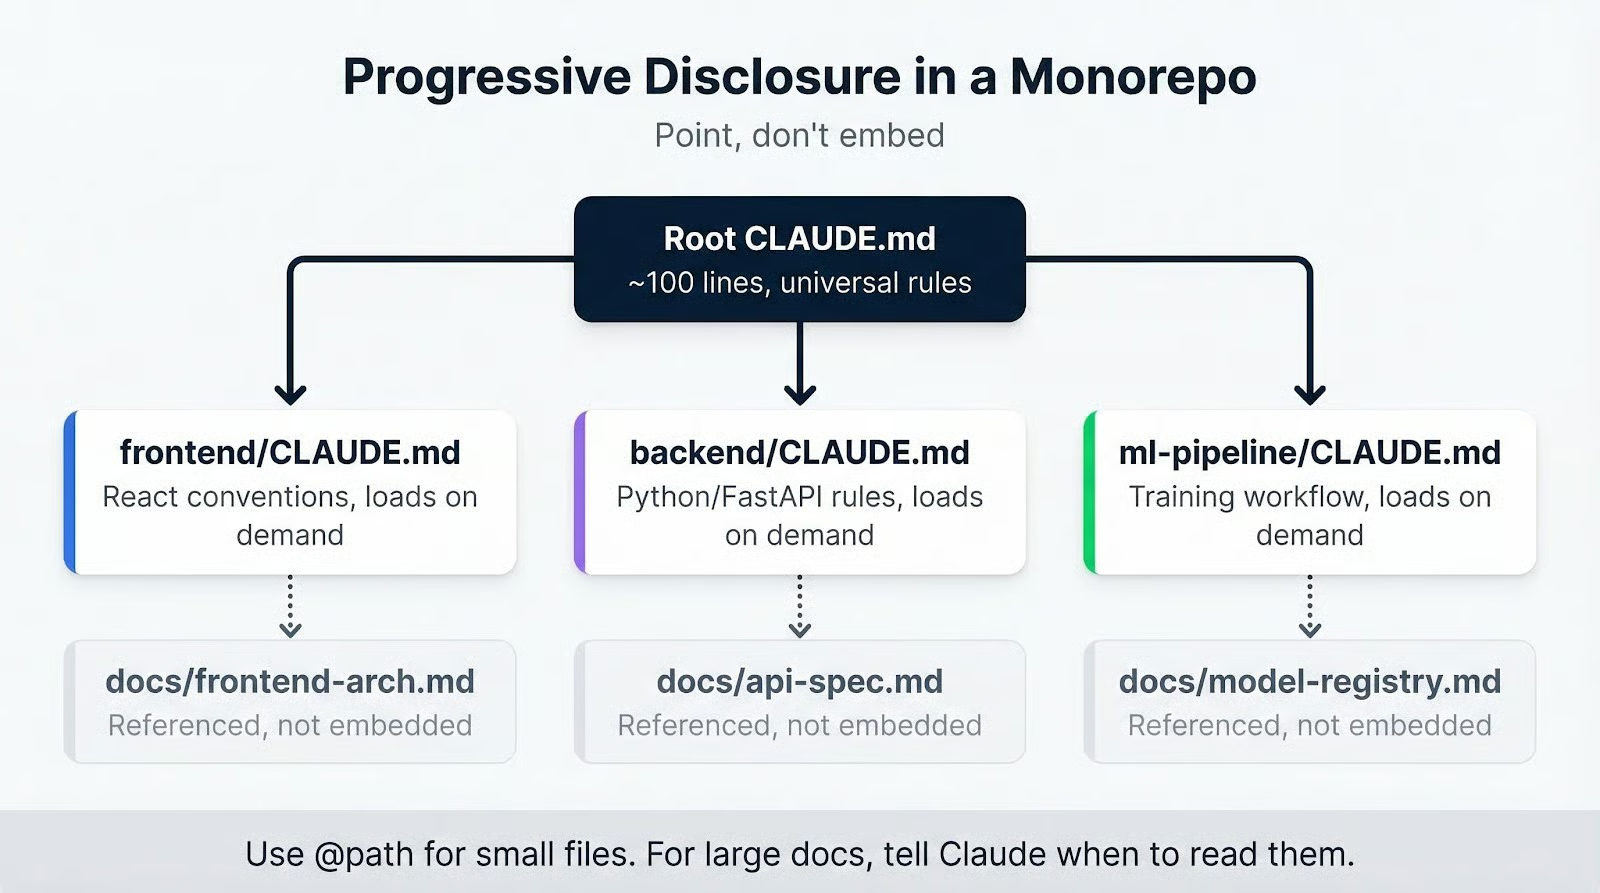 Das Prinzip: verweisen, nicht einbetten. Statt
@path/to/big-doc.md (lädt die gesamte Datei in jede Session) schreibe: „Für Migrationsvorgehen siehe docs/migrations.md.“ Claude liest sie, wenn die Information benötigt wird. Die @-Importsyntax ist für kleine Dateien okay, aber alles Größere sollte referenziert statt eingebettet werden.
Subdirectory-CLAUDE.md-Dateien runden das Muster ab. Eine frontend/CLAUDE.md mit React-Konventionen lädt nur, wenn Claude Dateien in diesem Pfad anfasst. Backend-Regeln bleiben beim Frontend außen vor.
Die strukturelle Skalierung ist gelöst, sobald du die Bausteine kennst. Aber Projekte ändern sich, Konventionen entwickeln sich. Regeln, die vor sechs Monaten sinnvoll waren, werden zu Rauschen und verdrängen heute Wichtiges. Die laufende Aufgabe ist, die Datei langfristig ehrlich zu halten.
Füge Regeln langsamer hinzu, als du denkst. Eine neue Zeile gehört nur dann in die Datei, wenn Claude einen echten Fehler gemacht hat, den diese Zeile verhindert hätte. Jede Regel sollte auf einen realen Vorfall zurückzuführen sein, nicht auf eine hypothetische Annahme.
Auch die Gegenrichtung zählt: Befolgt Claude eine Konvention bereits ohne Hinweis, ist die Regel Ballast. Entferne sie und schaffe Instruktionsbudget für Regeln, die Verhalten wirklich ändern.
Eine einfache Pflegepraxis: Bitte Claude alle paar Wochen, „diese CLAUDE.md zu reviewen und Verbesserungen vorzuschlagen“. Es findet Widersprüche, markiert Überschneidungen und macht Formulierungen knackiger.
Du kannst in der Datei auch eine dauerhafte Anweisung ergänzen: „Wenn dir während einer Session eine falsche Annahme auffällt, schlage eine CLAUDE.md-Korrektur vor.“ So entsteht eine Feedbackschleife, die die Datei im normalen Gebrauch verbessert.
Das häufigste Scheitern ist Akkumulation. Nach jeder frustrierenden Session kommen Regeln hinzu, niemand entfernt obsoletes, und irgendwann ist die Datei so lang, dass Claude die Hälfte herausfiltert. Wenn Claude eine Regel ständig ignoriert, hilft mehr Hervorhebung auf einer aufgeblähten Datei nicht. Nur Ausmisten hilft.
Wenn du große Dateien mit @ importierst, ist das der zweite Punkt. Ein 500-zeiliges Architektur-Dokument via @ zieht das komplette Dokument in jede Session und verbrennt dein Instruktionsbudget, bevor Claude die erste echte Regel verarbeitet. Verweise stattdessen nur darauf.
Mit /init auto-generieren und den Output nie kuratieren, führt verlässlich zu schlechtem Verhalten. Eine falsche Anweisung in CLAUDE.md betrifft nicht nur eine Antwort – sie prägt Recherche, Planung und Umsetzung in jeder Session, bis sie jemand findet.
Widersprüchliche Regeln über mehrere Dateien hinweg erzeugen unvorhersehbares Verhalten. Wenn zwei Regeln kollidieren, wählt Claude eine – ohne zu sagen, welche. Das wird in Projekten mit einer Root-CLAUDE.md plus mehreren .claude/rules/-Dateien noch schlimmer. Nur regelmäßige Reviews aller Anweisungsdateien beugen vor.
Nicht jeder Fehler verdient eine neue Regel. Manche Ausfälle sind Einzelfälle. Für jeden Edge Case eine Regel zu ergänzen, führt zu einer Datei voller bedingter Anweisungen, die selten helfen und meist stören. Das Ziel bleibt: eine kurze Datei, in der jede Zeile Verhalten ändert.
CLAUDE.md ist wahrscheinlich die tragfähigste Datei in einem Claude-Code-Projekt. Sie prägt jede Session, bevor du den ersten Prompt tippst – und eine gut gepflegte Datei zahlt sich über Wochen aus.
Wenn du noch keine hast, führe /init aus, lies das Ergebnis und streiche jede Zeile, die keinen realen Fehler verhindert hätte. Wenn du schon eine hast, öffne sie jetzt und wende denselben Test an. Muss deine CLAUDE.md riesig sein, um dein Projekt zu erklären, ist das ein Hinweis auf zu komplexes Tooling – nicht darauf, dass du eine größere Datei brauchst.
Der richtige nächste Schritt: Auditiere dein Repo und schreibe heute eine Basisversion. Starte mit fünf Sektionen, bleib unter 60 Zeilen und lass echte Fehler jede weitere Ergänzung steuern.
Wenn du Tools mit der Anthropic API bauen willst, deckt unser Kurs Introduction to Claude Models die komplette Modellfamilie ab und zeigt dir, wie du sie effektiv nutzt.
KI-Kurse
Kurs
Lernpfad
Kurs