学习路径
使用 LangChain 进行 AI 工程开发
21 小时
Claude Code 奖励的是一种大多数开发者工具并不要求的自律。如果您使用了一段时间,应该会注意到,有些会话能精准给出您要的结果,另一些则在原地打转、烧掉大量 token。Anthropic 自家团队发现无引导的尝试成功率约为 33%,而该工具的创建者会放弃 10-20% 的会话。
差异归根结底取决于您围绕工具建立的模式,而不是您输入的提示词。
本文介绍这些模式在实践中的样子,来源于 Abnormal AI、incident.io、Trail of Bits 等公司的生产工作流。
如果您需要回顾安装与核心功能,我们的 Claude Code 2.1 指南已为您准备好。这里的一切都假设您已了解基础,并希望从工具中榨取更多价值。
若想更宏观地了解智能体如何推理,以及本教程中的模式处在何处,强烈推荐报名我们的AI Agent Fundamentals 学习路径,里面涵盖了所有底层原理。
Claude 在没有引导时做出的每个决策也许都有较高的准确率,单看一次选择似乎无妨,但当一个功能包含许多决策点、误差不断复合时,把所有都做对的概率会迅速降低。若您假设 20 个决策各有 80% 的准确率,整体就是 0.8^20,完全正确实现的概率仅约 1%。
规划把那 20 个含糊的决策压缩进一份已评审的规格里,每个点都接近 100%,因为您已先行定夺。

在规模化场景中最有效的规划工作流是标注循环,正如 Boris Tane 所建议。您让 Claude 起草一份 plan.md,在编辑器中打开,并在 Claude 判断有误或留下歧义之处直接加注:"用 drizzle:generate,不要用原生 SQL",或 "这里应为 PATCH,而不是 PUT。"
然后将带标注的计划发回,并加上保护短语 "address all notes, don't implement yet"。这一短语非常关键,否则 Claude 会跳过计划、立刻开始写代码。这个循环会一直重复,直到计划不再含糊为止;此时 Claude 才开始实现,走弯路会少得多,因为每个决策都已事先定好。
# plan.md — annotation cycle

## Step 3: Database migration
Create a new migration for the users table.
> NOTE: use drizzle:generate, not raw SQL
> NOTE: add created_at with default NOW()

## Step 4: API endpoint
Add PUT /users/:id endpoint.
> NOTE: this should be PATCH, not PUT. Partial updates only.

# After annotating, send back with:
# "address all notes, don't implement yet"如果标注循环显得过于厚重,Claude Code 的内置计划模式是更轻量的选择:
计划会持久化到 ~/.claude/plans/,因此能在压缩和会话重启后保留,使内置计划模式成为大多数任务的稳妥默认。对于非常大的功能,事先写一份完整规格也很有效:有位开发者在 12 步规格上花了 2 小时,预计节省了 6-10 小时的实现时间。
无论采取何种方式,把优质的开源代码与计划请求一同贴给 Claude,会显著提升输出质量,因为相比抽象描述,Claude 更善于参考可运行的样例。
规划还可以通过 git worktree 水平扩展。incident.io 的工程师们会在不同分支上并行运行 4-5 个 Claude 会话,各自推进自己的计划。有位工程师花了 8 美元 Claude 额度,就产出了一套实现,把 API 生成时间提升了 18%,为整个团队日常使用的工具节省了 30 秒。
也有人更进一步,让多个 worktree 采用不同方案并行实现同一问题,再比较结果。
您的 CLAUDE.md 文件有一笔您可能还不清楚的「预算」。HumanLayer 对 Claude Code 内部机制的分析发现,系统会在您的指令上方注入提醒:"This context may or may not be relevant to your tasks."
Claude 并不会把所有内容都当作永久指令;它会主动筛选要遵循的内容。再加上,前沿思维类模型在大约 150-200 条指令后服从度会下降,而 Claude Code 自身的 system prompt 就占了约 50 条。这意味着留给您规则的有效容量大约在 100-150 条。HumanLayer 把他们的文件控制在 60 行以内。

您可以亲眼观察这个预算如何起作用。给 CLAUDE.md 加一句 "always address me as Mr. Tinkleberry",看看 Claude 多快就不再使用它,通常几千个 token 内就会消失。当这个称呼消失时,说明您的指令被注意力机制降权,CLAUDE.md 里的其它内容也会随之影响大减。
在这个预算内工作的方式是循序披露。项目根目录的 CLAUDE.md 保持简短,聚焦适用于各处的通用规则。任何领域特定内容都只做引用、不内联:"在处理支付系统时,请先阅读 docs/payment-architecture.md。"
Claude 只有在进入代码库的相关区域时才会读取被引用的文件,从而把指令预算留给高优先级规则。有家公司每月消耗数十亿 token,把他们的 monorepo CLAUDE.md 按这种方式组织,各团队对各自的部分还有独立的 token 预算:
# Monorepo CLAUDE.md — progressive disclosure

## Python
- Always use type hints for function signatures
- Test with: pytest -x --tb=short

## <Internal CLI Tool>
- <usage example>
- Always validate input before processing
- Never use raw SQL, prefer the ORM
For <complex usage> or <error> see path/to/<tool>_docs.md
子目录的 CLAUDE.md 可进一步扩展。在 src/persistence/ 放入数据库相关的指令,在 src/api/ 放入接口约定。
Claude 会自动从工作目录向上加载到项目根目录范围内的 CLAUDE.md,因此子目录文件只会在 Claude 在该区域工作时生效。这样既能让根文件保持通用性,又能在需要处向 Claude 提供精准指引。
一个常见错误:不要在 CLAUDE.md 中用 @ 内联整份文档。这会在每次运行时嵌入整份文件,在对话还没开始前就吃掉您的指令预算。
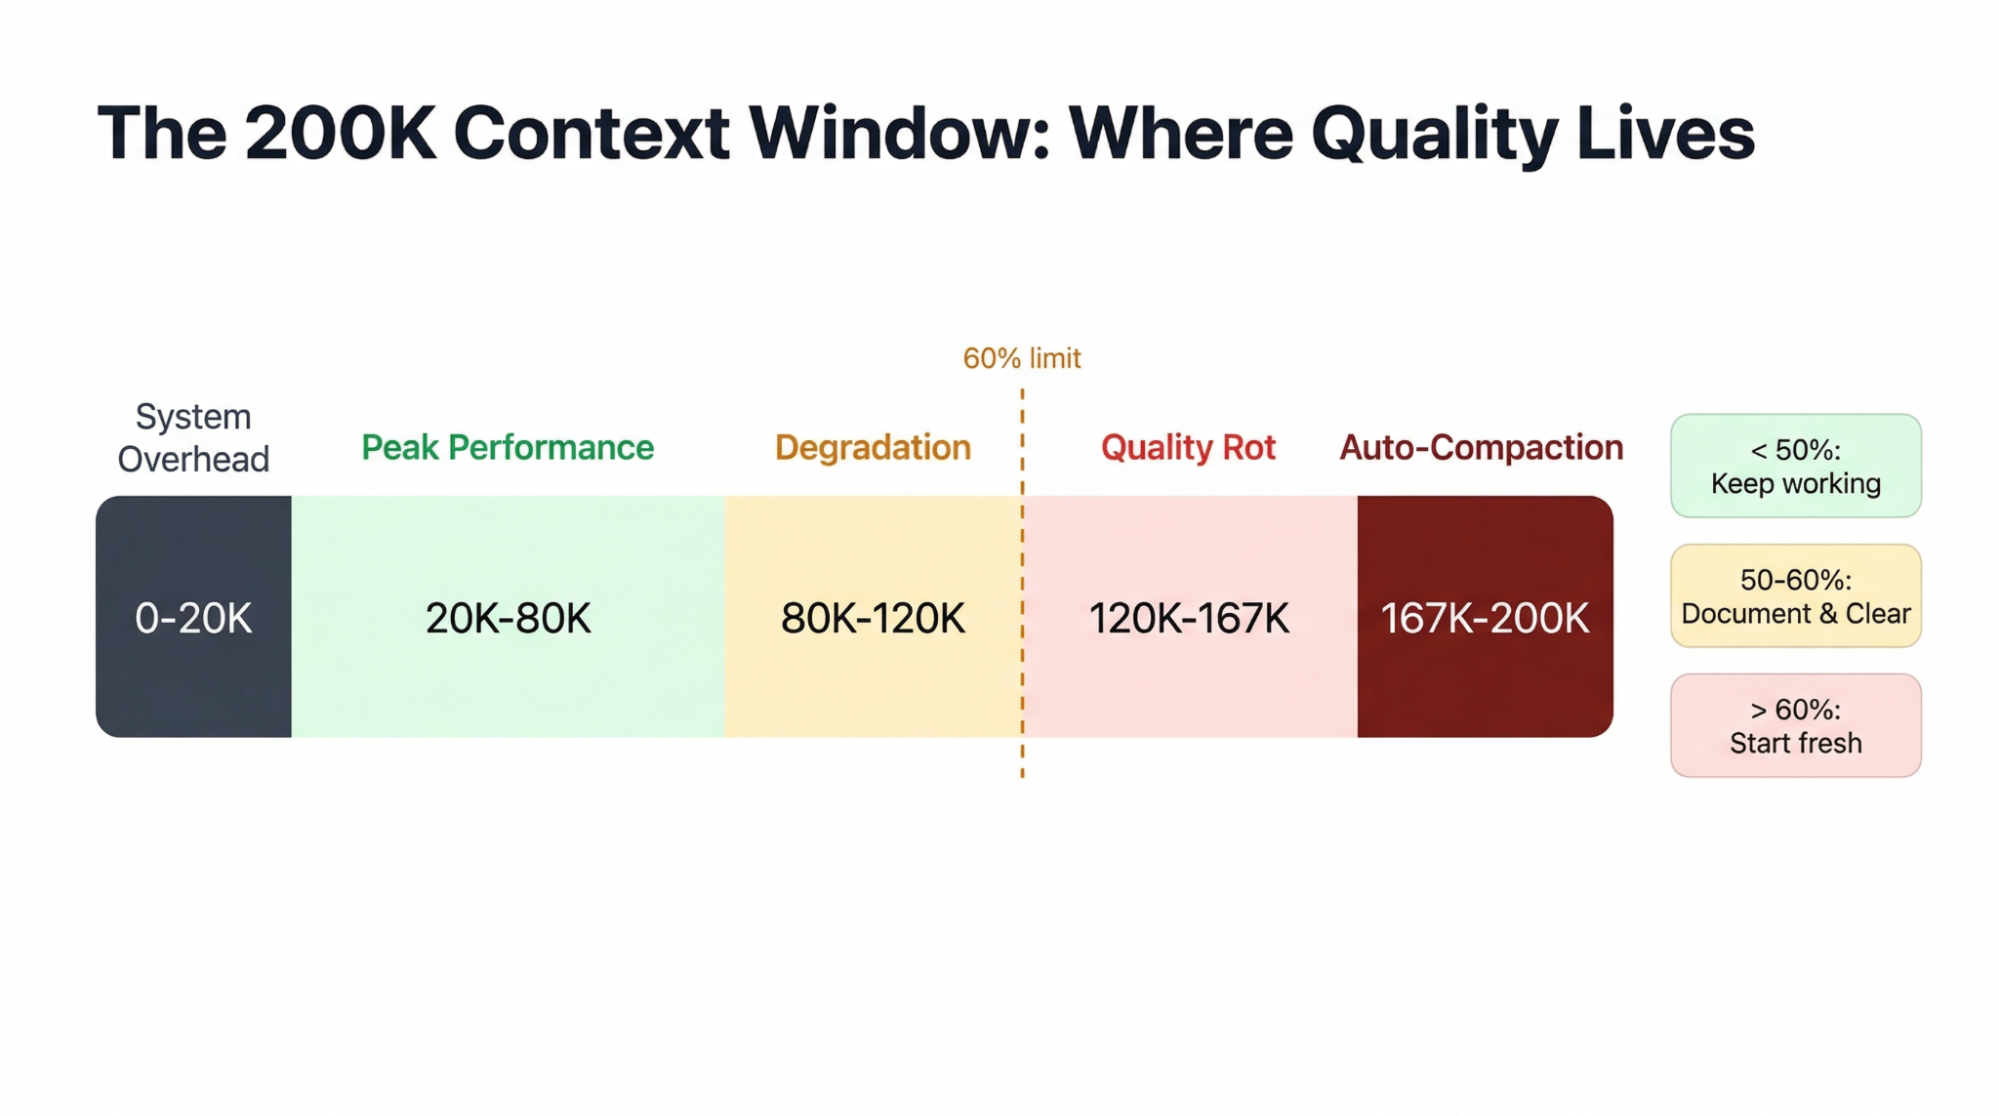
Claude Code 提供 200K token 的上下文,但可用窗口比看起来要小。
一个全新的monorepo 会话会先消耗约 20K token 来加载 system prompt、工具定义和 CLAUDE.md,在您打字之前就已经发生。每个 MCP 服务器都会添加会长期占用上下文的工具 schema,因此实际极限约为 5-8 个服务器,再多就会挤占真正的工作空间。
更糟的是,质量很早就开始下滑。多位实践者独立得出同一结论:不要让上下文超过 60% 的容量。
Claude 的输出会在窗口的 20-40% 就开始退化,远早于任何硬性上限,因为随着上下文填充,注意力机制会降低较早指令的权重。
自动压缩大约在 83.5% 触发,而且会丢失信息:有位开发者损失了 3 小时的重构工作,因为它在会话中途抹掉了所有迁移决策,只保留了 20-30% 的细节。
最好的防御是 Document & Clear 模式。当上下文变重时:
把当前计划和进展导出到一份 markdown 文件
运行 /clear 重置会话
让 Claude 从那份文件开始全新会话
这样您就能在完整 200K 窗口里,只保留您选择的内容,比 /compact更好,因为您能完全掌控保留的内容。
自定义 /catchup 命令能让过渡更顺畅:清空后,它会读取当前 git 分支上所有变更的文件,让 Claude 在没有旧对话历史的情况下,接续之前的进度。
<!-- .claude/commands/catchup.md -->
Rebuild context after a /clear. Read all files modified on the
current branch compared to main. For each file, understand the
changes made. Then summarize what's been implemented so far and
what work remains.

Changed files on this branch:
$ git diff --name-only main我会使用一个/transfer-context 技能把这件事做得更彻底。当会话开始退化时,该命令会导出一份结构化交接文件,其中包含已完成的工作、待定决策、需要避开的坑和相关文件路径。下一个会话读取这份文件后,就能接着上一个会话继续推进,只保留真正重要的信息,而没有对话历史的冗余。
您也可以通过延迟加载工具来主动节省上下文。有个项目通过使用 UserPromptSubmit 钩子,仅在用户提示触发相关关键词时才注入技能定义,而不是在启动时一次性加载全部,从而每个会话回收了约 15,000 个 token。
所有这些背后最简单的规则是:一场对话只做一个任务。重新开始会花费 20K token,但相比被污染会话导致的质量损失,这点消耗不值一提。
即使结构良好的 CLAUDE.md,被遵循的概率也只有约 70%。对于编码风格偏好,这还可以。对于诸如 "不要推送到 main" 或 "不要删除生产数据" 这样的安全规则,则不行。钩子(Hooks)通过在 Claude 工作流的特定节点运行 shell 脚本,把合规提升到 100%。
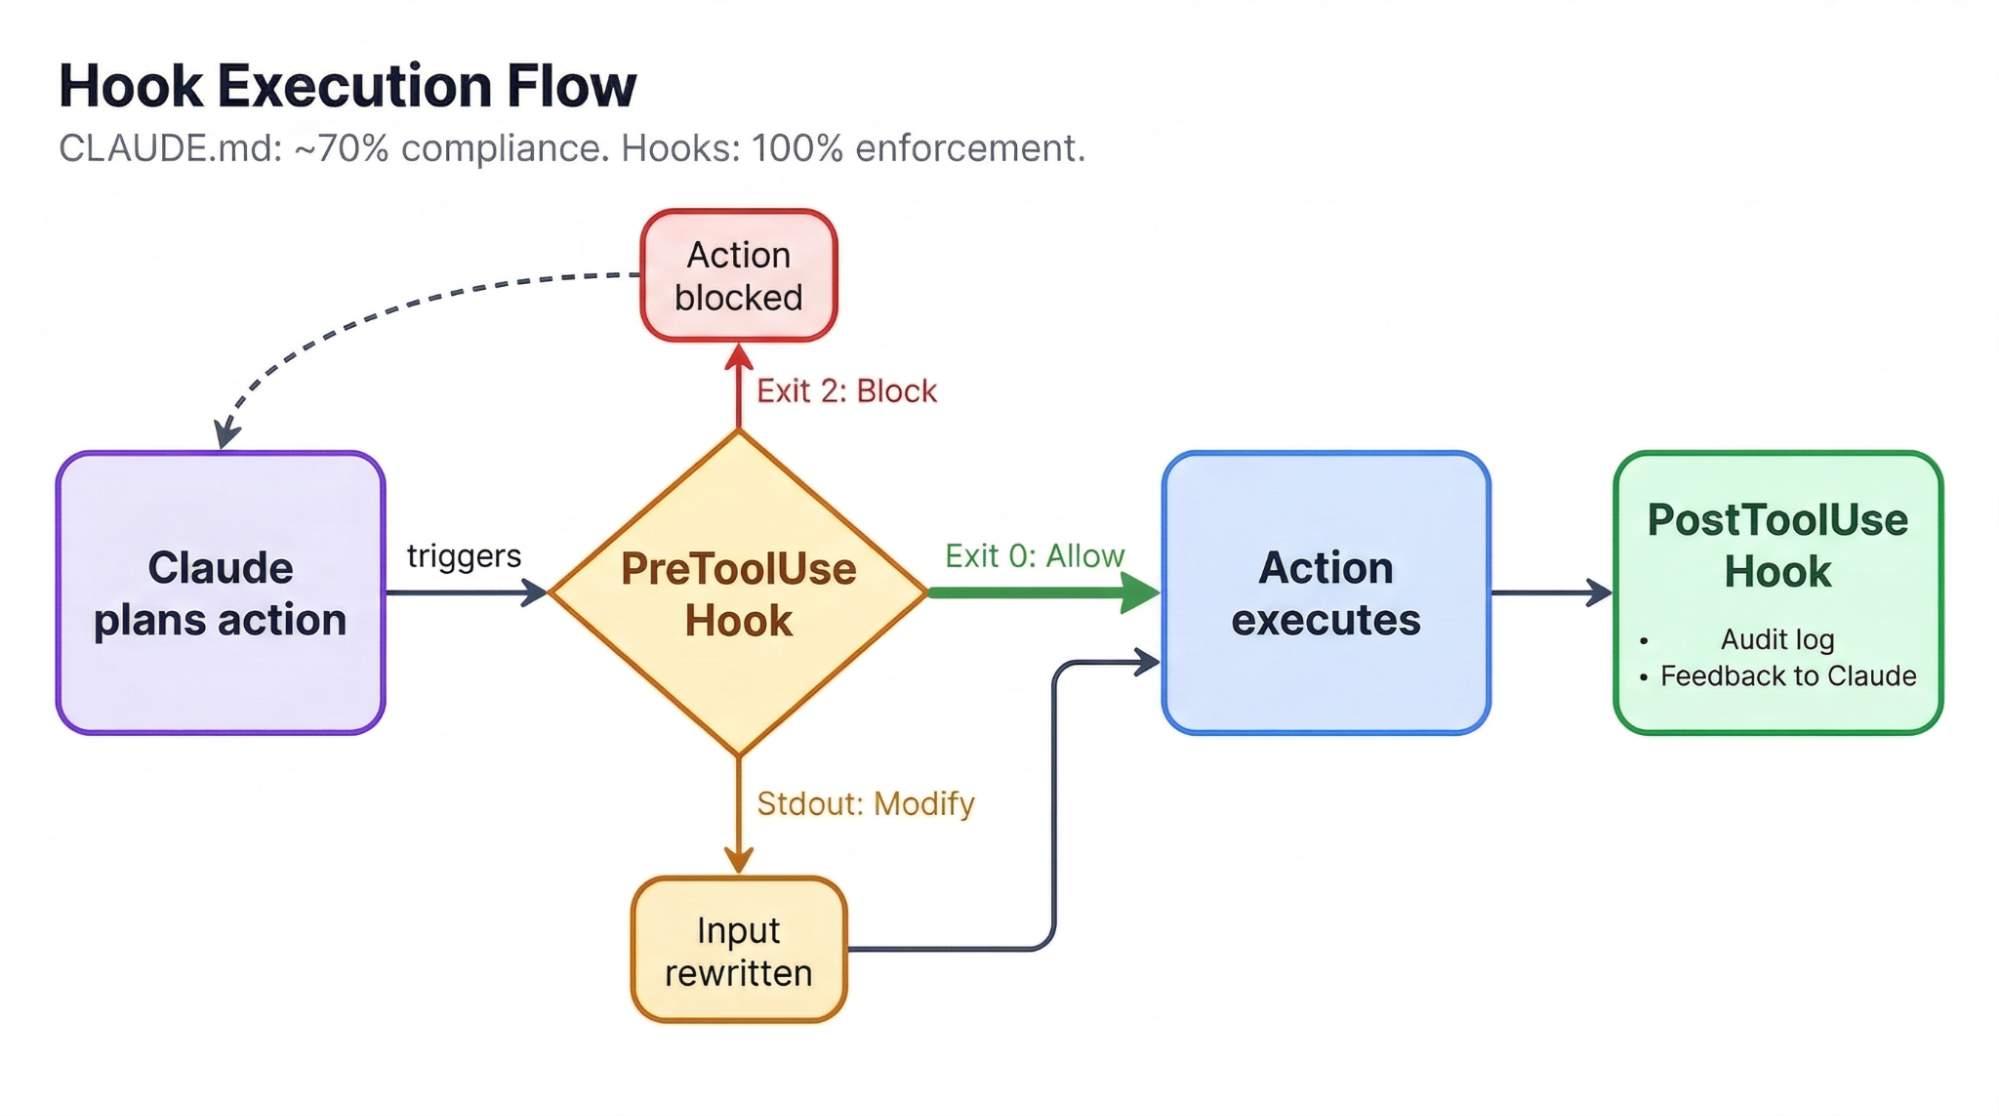
有两类值得了解。Submit 阶段拦截的钩子以 PreToolUse 事件运行、直接叫停动作:退出码 2 会阻止动作并强制 Claude 改用其他方法。提示型钩子则提供非阻塞反馈,例如在每次编辑后运行 linter,并把输出反馈回去,不打断 Claude 的流程。
最全面的公开钩子配置会做以下事情:
拦截 rm -rf 命令(改为建议使用 trash),
阻止直接推送到 main,
用时间戳记录所有变更,且
运行反合理化(anti-rationalization)门控。
该门控使用 Haiku 审查 Claude 的回复,捕捉诸如 "已有问题" 或 "超出范围" 之类的搪塞。一旦发现 Claude 过早宣告成功,它会用具体反馈拒绝该回复,并强制 Claude 继续工作。更轻量的设置则是在每次文件编辑后自动运行 Prettier 和 TypeScript 检查:
{
  "hooks": {
	"PostToolUse": [
  	{
    	"matcher": "Edit|Write",
    	"hooks": [
      	{
        	"type": "command",
        	"command": "prettier --write \"$CLAUDE_FILE_PATHS\""
      	}
    	]
  	}
	]
  }
}
需要避免的陷阱:切勿在计划中途阻止 Edit 或 Write 工具。写入阶段阻断会破坏多步推理,因为 Claude 会丢失上下文。让它先完成写入,再通过 PostToolUse 钩子或 pre-commit 检查来校验。我们的 Claude Code 钩子教程涵盖了更多模式,供您进一步构建。
没有测试时,Claude 唯一的自我校验是它自己的判断,而这会随着上下文变大而退化。测试提供了一个外部的「神谕」,无论会话运行多久都能保持准确。
每次从红到绿的循环都给 Claude明确无误的反馈,而且它可以在无人干预下反复运行整套测试,使测试驱动开发(TDD)成为与智能体式编码工具配合时最强的单一模式。
Anthropic 建议的工作流遵循以下顺序:
1. Write tests first
   > "Write tests for the auth module using pytest.
  	TDD approach, no mock implementations."

2. Confirm tests fail
   > "Run the tests. They should all fail."

3. Commit the failing tests as a checkpoint

4. Implement until green
   > "Write the implementation. Do not modify the tests.
  	Keep going until all tests pass."
最后那条指令比看起来更重要。Claude 有时会改测试来让它们通过,而不是修复实现。预先提交测试能为您兜底:如果 Claude 改动了测试,diff 会清楚显示变化,您也能还原。
对于前端工作,一个视觉化变体同样有效:如果您给 Claude 一份设计稿并配上 Puppeteer MCP 服务器,它会在实现后截图,与设计稿进行对比并迭代。当 Claude 能把自己的输出与视觉目标对照时,这个校验循环通常能把质量提升 2-3 倍。
Anthropic 的官方数据显示,以 API 计费,Claude Code 的平均成本是每位开发者每天 6 美元,90% 的开发者低于 12 美元/天。按月计算,在使用 Sonnet 4.6 时,每位开发者大致为 100-200 美元/月。
Max 订阅计划会彻底改变账本。有位开发者跟踪了 8 个月、约 100 亿 token 的用量,计算出的 API 等效成本超过 15,000 美元,而实际的 Max 订阅仅约 800 美元:节省 93%。
他 90% 以上的 token 属于缓存读取,这也是为什么按量计费的 API 比固定订阅贵得多。Max 方案的盈亏平衡点大约在每月 100-200 美元的 API 等效用量,任何日常用户都很快会达到这个门槛。
|
计费模式 |
月度成本 |
最适合 |
|
API(Sonnet 4.6) |
~$100-200 |
轻量使用,每天少于 30 分钟 |
|
API(Opus 4.6) |
~$300-800 |
复杂的多文件工作 |
|
Max($100/月) |
$100 固定 |
日常用户,约 ~$100 API 等效即达盈亏平衡 |
|
Max($200/月) |
$200 固定 |
重度用户,每天 5+ 小时 |
模型选择本身也是一种优化。Claude Code 的 "opusplan" 模式会在规划阶段路由到 Opus 4.6,并在代码生成时自动切换到 Sonnet 4.6,在最需要时获得 Opus 级别的推理质量,同时在实现阶段使用便宜 5 倍的 Sonnet token。
在 Anthropic 的内部测试中,59% 的 Claude Code 用户更偏好 Sonnet 4.6 而非 Opus 4.5,且它往往产出更干净、不过度工程化的代码。对于子代理密集的工作流,CLAUDE_CODE_SUBAGENT_MODEL="claude-sonnet-4-5-20250929" 会让子代理运行在 Sonnet 上,同时将 Opus 保留给编排器。
务必避免三大 token 浪费源:
在任务之间不清理上下文
由于 CLAUDE.md 结构不佳导致的重复读文件
含糊的提示词,让 Claude 陷入试错循环
只修正这三点,通常就能把 token 用量减半。
在收尾之前,让我们看看开发者在使用 Claude Code 时常见的问题以及应对方法。
杀伤力最大的失败模式是上下文丢失。上下文管理一节介绍的 Document & Clear 模式正是为此而生:永远不要让一次长会话成为您决策的唯一记录。频繁提交,把进展写入文件,并把每次会话都当作一次性品。
对于不熟悉的技术,Claude 也会生成自信且看似合理的代码。如果您使用的语言或框架无法亲自把关,那么每份输出都需要额外审查。正如一位开发者所言:"我用不熟悉的技术配合 LLM,把自己拖进了一大堆麻烦。但在熟悉的技术上,LLM 极大提升了我的速度。"
过度工程化是一个常见倾向。除非您明确要求,否则 Claude 会写出多余的抽象、主动添加辅助函数、过早重构。在 CLAUDE.md 里加上 "使用尽可能简单的方法" 会有所帮助,而按问题域而非技术分层来组织代码库,也能降低 Claude 与人类的认知负担。
最戏剧性的失败案例:在构建一款自然拼读应用时,Claude 删除了开发者亲自获得授权的所有音素音频文件,并用 AI 生成的声音替换。它还重命名文件,并且"深信自己之前标注错误,尽管它根本无法区分相关的音素"。
教训是:在让 Claude 访问之前,务必提交或备份不可替代的文件。
对于跑偏的会话,Anthropic 的建议相当坦诚:先保存状态再让 Claude 工作,跑完后要么接受结果,要么重新开始,不要在无休止的修正中纠缠。
是否信任 Claude 来提交,取决于您的测试覆盖率与风险承受度。有些开发者每天通过斜杠命令提交几十次,再用 PR 审查把关。对于有付费用户的生产代码库,逐个审查 diff 的摩擦是值得的。
更多细节可参考 Anthropic 的 Claude Code 概览,这是大多数社区内容的上游权威来源。若您想在本文基础上进一步实践并体验多个 Claude Code 功能,以下几篇教程值得一读:
还有若干开源项目把本文讨论的实践打包成即可用的配置:
obra/superpowers — 可组合的技能框架,内置 TDD 强制、苏格拉底式头脑风暴、精细化规划,以及任务间的自动代码评审。现已成为 Anthropic 市场的官方插件。
github/spec-kit — GitHub 官方的规格驱动开发工具包。把工作组织为 Constitution → Specify → Plan → Tasks,使规格成为任何编码代理的唯一可信来源。
bmad-code-org/BMAD-METHOD — 完整的敏捷框架,包含 12+ 个代理角色(架构师、QA、Scrum Master)和 34+ 个覆盖整个开发生命周期的工作流。
wshobson/commands — 57 个可直接放入 .claude/commands/ 的生产级斜杠命令,其中包含 15 个多代理工作流。
awesome-claude-code — 该生态的技能、钩子、命令、代理与插件目录首选。若想浏览现有资源,从这里开始。
本文所有模式都指向同一理念:在执行前对 Claude 做强约束,然后给予其自我校验的途径。规划消除歧义,CLAUDE.md 与钩子划定边界,测试提供验证,而良好的上下文卫生让一切在多个会话间持续有效。
如果只能选一项改变,从 Document & Clear 做起。跨会话的上下文腐烂带来的代价,远超重新开始所需的 20K token。之后:
添加 pre-commit 钩子,在测试失败时阻止提交
每个多文件任务在动手写代码前先制定计划
把 CLAUDE.md 控制在 100 条指令以内,并用子目录文件承载领域特定规则
我们最近新增了一个关于 AI Engineering with LangChain 的技能路径。其课程内容为 AI 原生,您可在个人导师代理的陪伴下学习。建议您查看,以成为构建 AI 工作流的真正高手。
AI 课程
学习路径
课程
学习路径