
{count, plural, one {Cursus} other {Cursussen}}
Introductie tot Claude-modellen
{hours} uur
14.9K
De systeemprompt van Claude Code neemt al zo'n 50 instructies in beslag voordat je sessie begint. Onderzoek naar frontier-LLM’s laat zien dat het opvolgen van instructies begint af te nemen rond grofweg 150 tot 200 totale instructies, wat je ergens 100 tot 150 plekken overlaat voor alles wat je Claude over je project wilt laten weten.
CLAUDE.md is het bestand dat die plekken vult. Het is een markdownbestand dat Claude Code aan het begin van elke sessie leest, zodat het blijvende context heeft over je codebase zonder dat jij jezelf hoeft te herhalen. Maar Claude filtert actief content die het irrelevant vindt voor de huidige taak. Een opgeblazen bestand verspilt niet alleen ruimte; het concurreert met je daadwerkelijke regels.
Deze tutorial behandelt hoe je een CLAUDE.md bouwt die elke regel waard is: wat erin gaat, wat je weglaat, hoe je het structureert voor teams en hoe je het in de tijd bruikbaar houdt.
Ik raad ook aan om onze andere recente Claude Code-gidsen te bekijken:
CLAUDE.md is een markdownbestand dat Claude Code automatisch laadt aan het begin van elk gesprek. Het staat in de projectroot en geeft Claude blijvende instructies over allerlei relevante feiten:
Zonder dit bestand start elke sessie vanaf nul. Je legt dezelfde context uit, corrigeert dezelfde aannames en ziet Claude dezelfde fouten maken als gisteren. CLAUDE.md lost dat op door je projectkennis één keer vast te leggen.
Het is één van meerdere contextsystemen die Claude Code gebruikt, en ze behandelen elk ander werk:
|
Systeem |
Wie schrijft het |
Wat het doet |
Wanneer het laadt |
|
|
Jij |
Projectregels, conventies en beperkingen die jij definieert |
Elke sessie (volledig bestand) |
|
Geheugen ( |
Claude |
Patronen en feiten die het zelf ontdekt tijdens sessies |
Elke sessie (eerste 200 regels) |
|
Jij |
Domeinkennis voor specifieke workflows, op verzoek geladen |
Op aanvraag |
|
|
Jij |
Shell-commando’s die draaien op triggers zoals pre-commit of post-edit |
Op specifieke triggerpunten |
Het draaien van /init genereert een startversie van CLAUDE.md door je codebase te analyseren en buildsystemen, testframeworks en codepatronen te detecteren. Als er al een bestand bestaat, stelt het verbeteringen voor in plaats van te overschrijven. Het is een redelijk startpunt, maar het bestand is te belangrijk om op de automatische piloot te laten staan.
Belangrijk om te weten: de inhoud van CLAUDE.md overleeft ook /compact. Wanneer context halverwege een sessie wordt gecomprimeerd, leest Claude het bestand opnieuw van schijf en injecteert het vers.
CLAUDE.md-bestanden kunnen op vier plekken staan, van breedst naar meest specifiek:
Beheerd beleid (org-breed): /Library/Application Support/ClaudeCode/CLAUDE.md op macOS. Geldt voor alle gebruikers op de machine en kan niet worden uitgesloten door een instelling. Op Linux/WSL te vinden op /etc/claude-code/CLAUDE.md, en op Windows op C:\Program Files\ClaudeCode\CLAUDE.md.
Gebruikersniveau: ~/.claude/CLAUDE.md. Persoonlijke instructies die gelden voor elk project op je machine.
Projectniveau: ./CLAUDE.md of ./.claude/CLAUDE.md in de root van de repo. Dit is degene die je commit naar git en met je team deelt.
Subdirectory: ./subdir/CLAUDE.md. Gescope op die map en on demand geladen wanneer Claude daar bestanden leest, niet bij sessiestart.
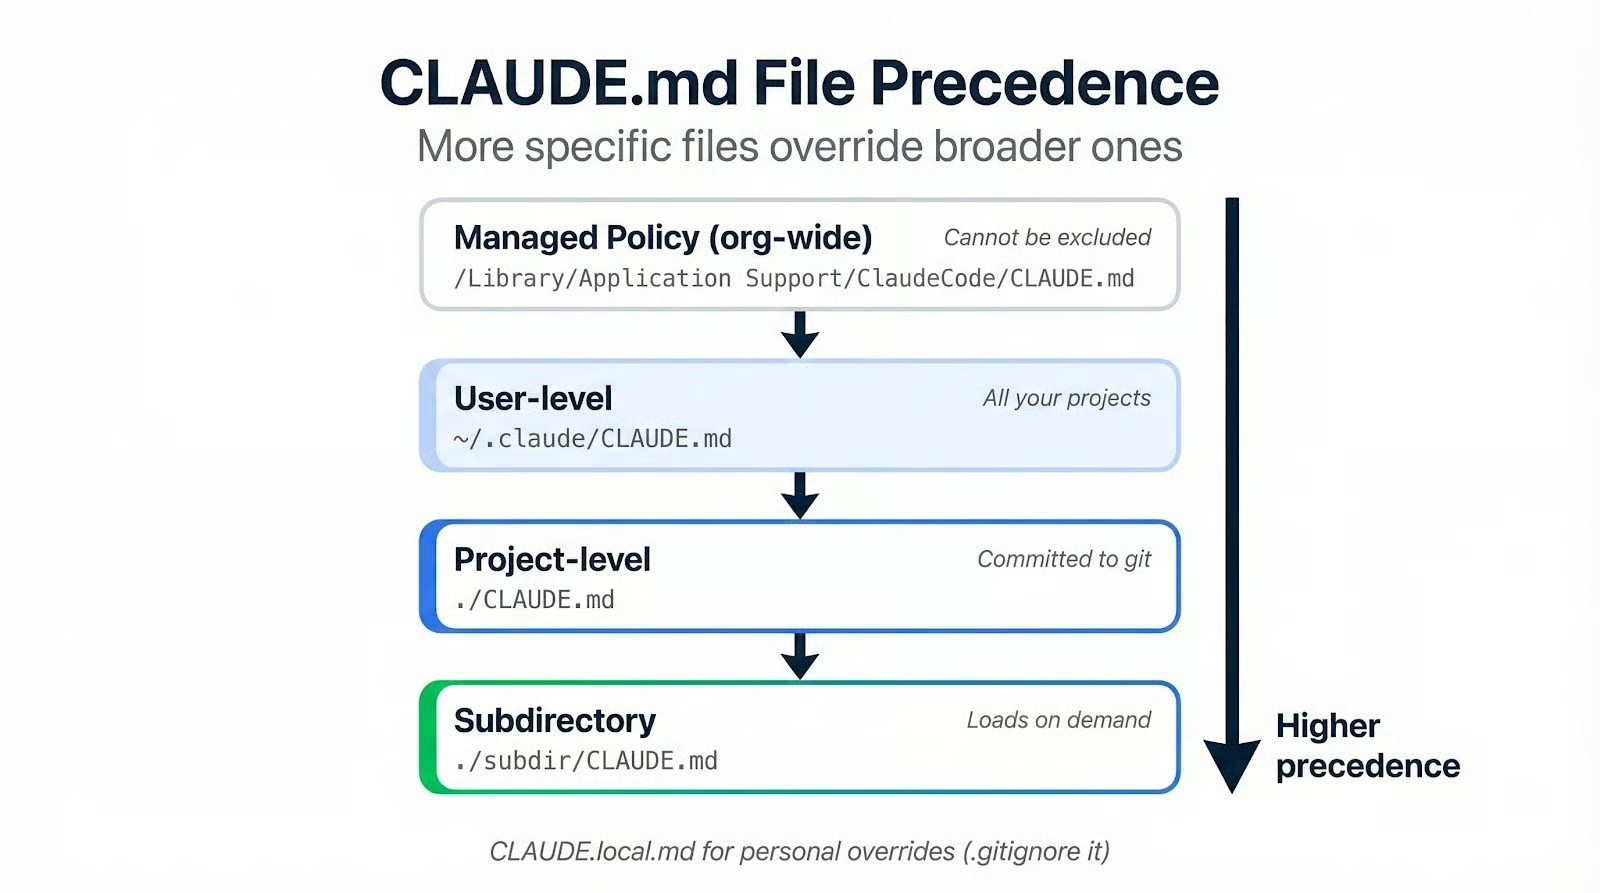
Specifiekere bestanden hebben voorrang op bredere. Als je project-CLAUDE.md zegt "gebruik tabs" en je gebruikersbestand zegt "gebruik spaties", dan wint het projectbestand.
Voor persoonlijke voorkeuren die niet in versiebeheer thuishoren, maak je een CLAUDE.local.md en voeg je die toe aan .gitignore. Editor-eigenaardigheden, geprefereerde commitstijlen of tijdelijke overrides zet je hier, zodat het gedeelde bestand schoon blijft.
Nu je weet waar het bestand staat en waarmee het concurreert, is de volgende vraag wat er daadwerkelijk in thuishoort.
Een CLAUDE.md valt uiteen in drie lagen:
Als je Claude Code Best Practices hebt gelezen, herken je dit als hetzelfde principe toegepast op een kleinere scope. (Zo niet, check het dan zeker nadat je dit artikel hebt gelezen!)
Begin met een projectbeschrijving van één à twee regels en je techstack met versienummers. Claude kan veel afleiden door je code te lezen, maar het raadt niet dat je op Next.js 15 zit in plaats van 14, of dat je voor Drizzle koos in plaats van Prisma.
Neem een overzicht van de mappenstructuur op. Niet elk bestand, maar de toplaag met korte beschrijvingen:
src/
  data/        # Data loading and preprocessing pipelines
  models/      # Model definitions and training loops
  evaluation/  # Metrics, validation, experiment tracking
  api/         # FastAPI endpoints for model serving
  tests/       # Co-located with source, test_*.py
Zet veelgebruikte commando’s in codeblokken. Build, test, lint en het starten van de devserver. Een commando binnen een codefence is iets dat Claude letterlijk zo uitvoert. Een commando in een zin is een suggestie waar het op kan improviseren.
Je architectuurkeuzes moeten in het bestand staan, want anders maakt Claude zelf keuzes. Als je om een reden voor SQLite koos in plaats van Postgres, zeg dat dan. Als je API-laag een specifiek patroon volgt, leg de reden uit.
Motivatie doet hier echt werk. "Nooit force pushen" is een platte instructie die Claude onder druk kan negeren. "Nooit force pushen. Dit herschrijft gedeelde geschiedenis en is onherstelbaar voor collega’s," geeft Claude genoeg context om te generaliseren. Het zal niet alleen git push --force vermijden. Het zal ook aarzelen voor git reset --hard op een gedeelde branch.
Dit dekt conventies die Claude niet kan oppikken door je code te lezen. Als je Conventional Commits gebruikt (feat:, fix:, docs:), zet dat erbij. Als branches een naamgevingspatroon volgen zoals initials/description, schrijf het op.
Ook eigenaardigheden en valkuilen horen hier. Elke codebase heeft ze: het migratiescript dat vóór builds moet draaien, de env-variabele die een specifieke waarde nodig heeft voordat tests slagen, de module die stukgaat als hij in de verkeerde volgorde geïmporteerd wordt. Claude is elke sessie een nieuw teamlid, en dit zijn de dingen waar een nieuwe collega op dag één over struikelt.
Wat je kunt overslaan: alles wat Claude al weet uit de taal zelf. Je hoeft niet te zeggen dat het async/await moet gebruiken in moderne JavaScript of pathlib in Python 3 moet prefereren. Als een conventie de standaard van de taal is, is het opschrijven ruis die de instructies verdringt die er wél toe doen.
De inhoud goed krijgen is het makkelijke deel. Het moeilijkere deel is instructies schrijven die Claude daadwerkelijk volgt, en weten wat je schrapt.
Specificiteit wint het altijd van intentie. "Formatteer code netjes" vertelt Claude niets. "Gebruik 2 spaties inspringing, geen puntkomma’s, enkele quotes" vertelt precies wat het moet doen en maakt het verifieerbaar.
Pas deze test op elke regel toe: "Zou het verwijderen hiervan ertoe leiden dat Claude fouten maakt?" Als het antwoord nee is, schrap de regel. De officiële aanbeveling is onder de 200 regels per bestand, en sommige ervaren teams werken met minder dan 60. Dat is geen minimalisme om het minimalisme: een korter bestand betekent dat er meer van wordt gelezen.
Beperk kopniveaus tot maximaal drie. Gebruik sectienamen die agents herkennen uit README-conventies: Commands, Structure, Conventions, Testing. Creatief worden met sectienamen zorgt voor frictie, omdat Claude miljoenen README’s heeft gezien en sterke verwachtingen heeft over wat waar thuishoort.
Als een regel steeds wordt genegeerd ondanks dat hij in het bestand staat, voeg dan geen extra tekst toe. Voorzie hem van een prefix zoals IMPORTANT: of YOU MUST. Gebruik dit echter spaarzaam, want nadruk schaalt slecht. Als elke regel belangrijk is, valt de nadruk niet meer op.
Code-stijlhandhaving is de grootste valkuil. Formatting, inspringing, importvolgorde: dit zijn deterministische problemen met deterministische oplossingen. Linters en formatters zoals Biome, ESLint of Ruff doen dit sneller, goedkoper en met 100% consistentie. Instructiebudget besteden aan stijlafspraken is ballast: hetzelfde werk dat een pre-commit hook gratis doet.
Standaardtaalconventies horen ook op de uitsluitingslijst, want Claude kent TypeScript-patronen en Python-idiomen al. Volledige API-documentatie moet je linken in plaats van plakken. Taakspecifieke instructies die alleen gelden voor bepaalde workflows horen in skills, waar ze on demand laden in plaats van ruimte in elke sessie in te nemen.
Een patroon dat het noemen waard is: uitsluitend negatieve beperkingen. "Gebruik nooit --legacy-peer-deps" laat Claude vastlopen bij een dependencyconflict. Koppel elke verboden stap aan een richting: "Gebruik nooit --legacy-peer-deps; los conflicten op door het pakket bij te werken naar een compatibele versie." Als je met Cursor Rules of vergelijkbare AI-configuratiebestanden hebt gewerkt, zul je merken dat dit principe tool-overstijgend geldt.
Zo ziet het verschil er in de praktijk uit. Links een typische automatisch gegenereerde CLAUDE.md-sectie vol generiek advies dat Claude al weet. Rechts dezelfde sectie na de specificiteitstest: alleen projectspecifieke feiten blijven over.
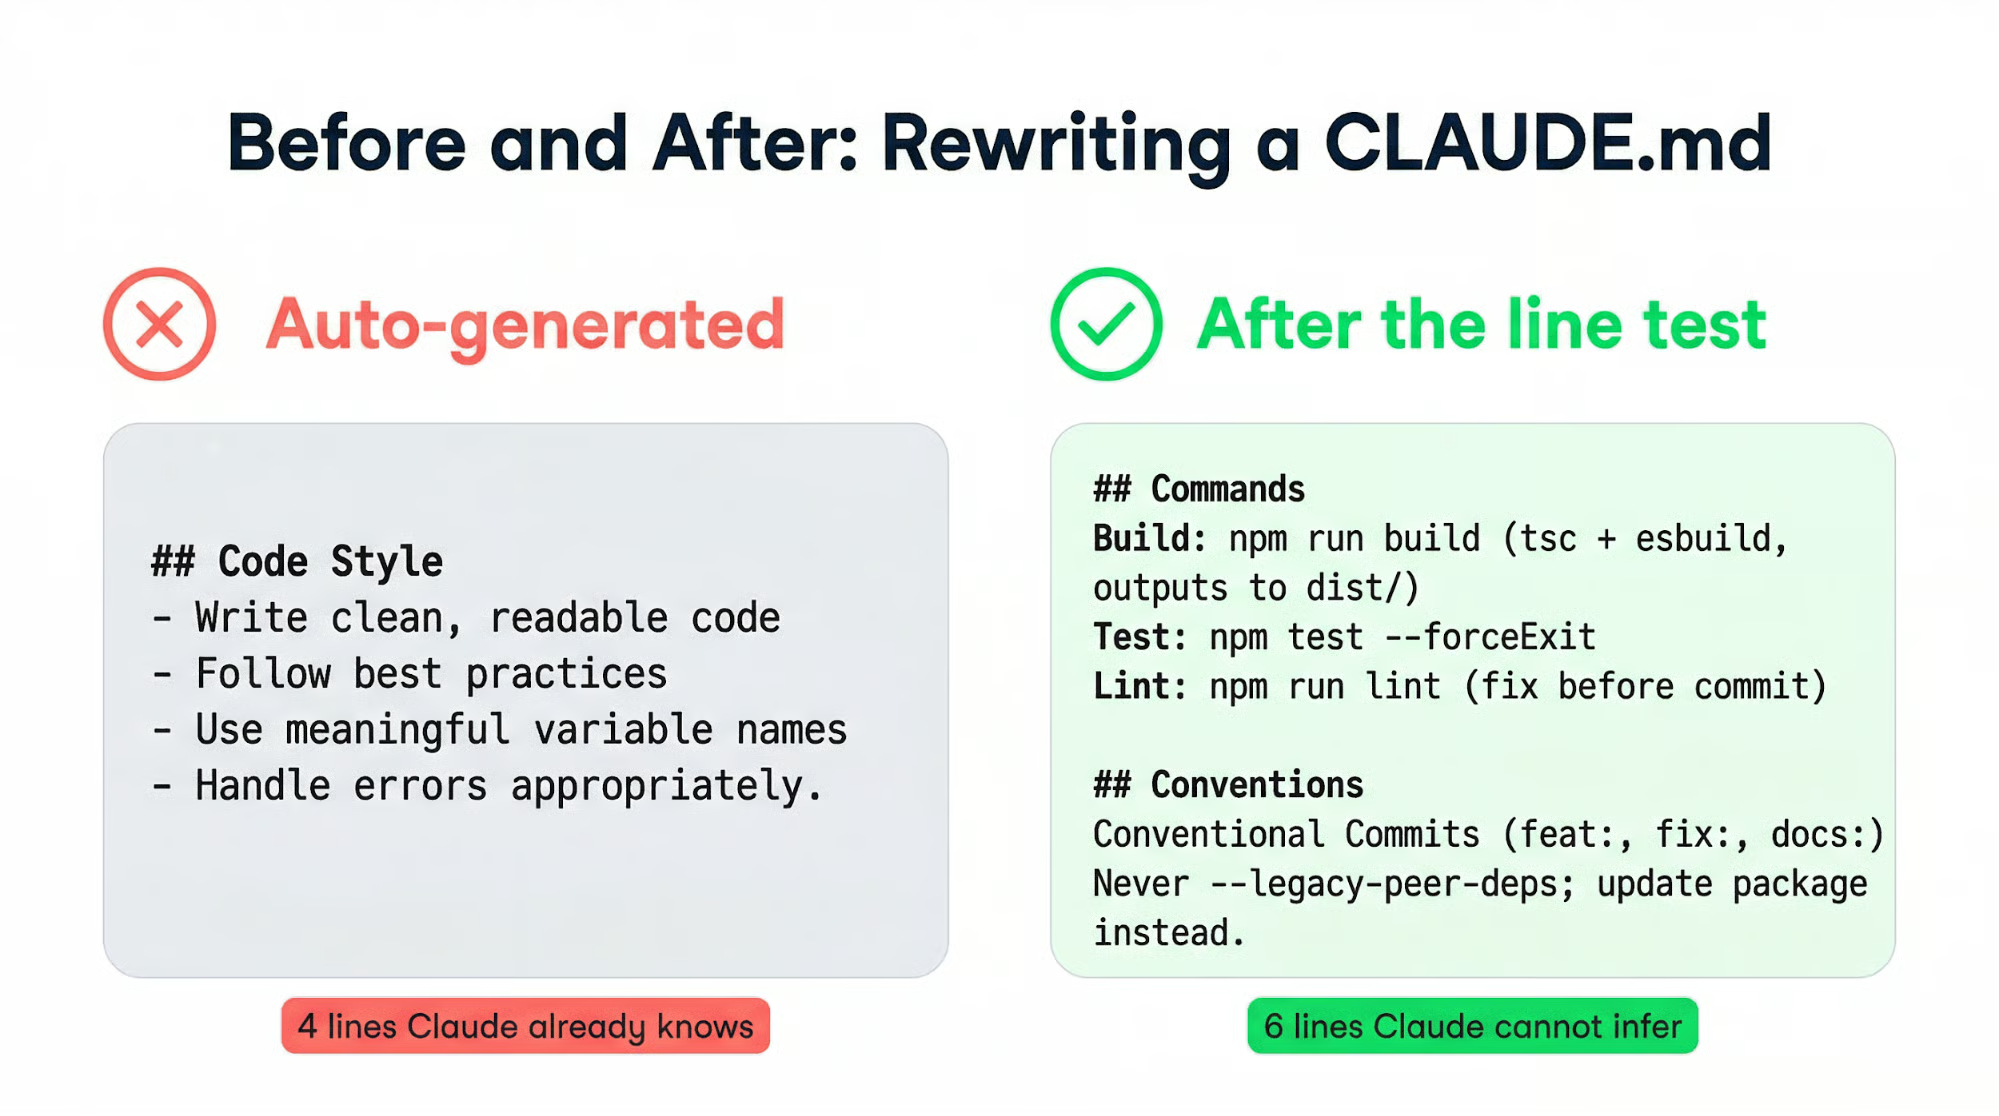
De tweede versie is korter en vertelt Claude dingen die het niet uit de codebase kan afleiden.
Draai /init in je projectroot voor een gegenereerd startpunt. Lees elke regel, schrap wat voor de hand ligt en voeg toe wat ontbreekt aan hoe je team daadwerkelijk werkt. Starten vanaf /init-output is sneller dan vanaf blanco, maar automatisch gegenereerde inhoud mag nooit zonder review blijven.
Schrijf je liever vanaf nul, begin dan met vijf secties:
Je kunt het bestand later altijd uitbreiden, en door minimaal te beginnen komt elke extra regel voort uit een echte fout in plaats van een aanname.
Twee signalen dat het bestand onderhoud nodig heeft:
Beide wijzen op dezelfde remedie: minder woorden, duidelijkere structuur.
Een bestand voor één ontwikkelaar kan onbeperkt slank blijven. Zodra een team meedoet, heeft het bestand een andere structuur nodig.
Je project-CLAUDE.md hoort in git. Het is gedeelde documentatie die beter wordt naarmate teamgenoten regels toevoegen vanuit hun eigen fouten. Behandel wijzigingen erin zoals je code-PR’s: review ze en vraag je af of elke nieuwe regel zijn plek verdient.
Als conventies zich opstapelen voorbij wat in één bestand past, verplaats ze dan naar .claude/rules/. Elk Markdownbestand dekt één onderwerp met beschrijvende bestandsnamen: testing.md, api-design.md, database-migrations.md. Claude ontdekt deze bestanden recursief en laadt ze met dezelfde prioriteit als de hoofd-CLAUDE.md.
Padgescope regels maken dit nog gerichter. Voeg YAML-frontmatter toe en de regel laadt alleen wanneer Claude met overeenkomende bestanden werkt:
---
paths:
  - "src/api/**/*.ts"
---
# API conventions go here
Je frontendconventies verbranden geen instructiebudget tijdens backendwerk, en andersom.
In monorepo’s waar teams conflicterende conventies hebben, blokkeert claudeMdExcludes specifieke bestanden van laden:
{
  "claudeMdExcludes": [
    "**/other-team/.claude/rules/**"
  ]
}
Zet dit in .claude/settings.local.json om het buiten versiebeheer te houden.
Het opschalen van een CLAUDE.md triggert vaak de neiging om te centraliseren: één groot bestand met alles erin. Dat is de verkeerde richting. Het opsplitsen van de CLAUDE.md van een monorepo in service-niveau bestanden kan het totale aantal woorden met 80% verminderen terwijl het volgen van regels door Claude verbetert; minder te lezen per sessie betekent minder om uit te filteren.
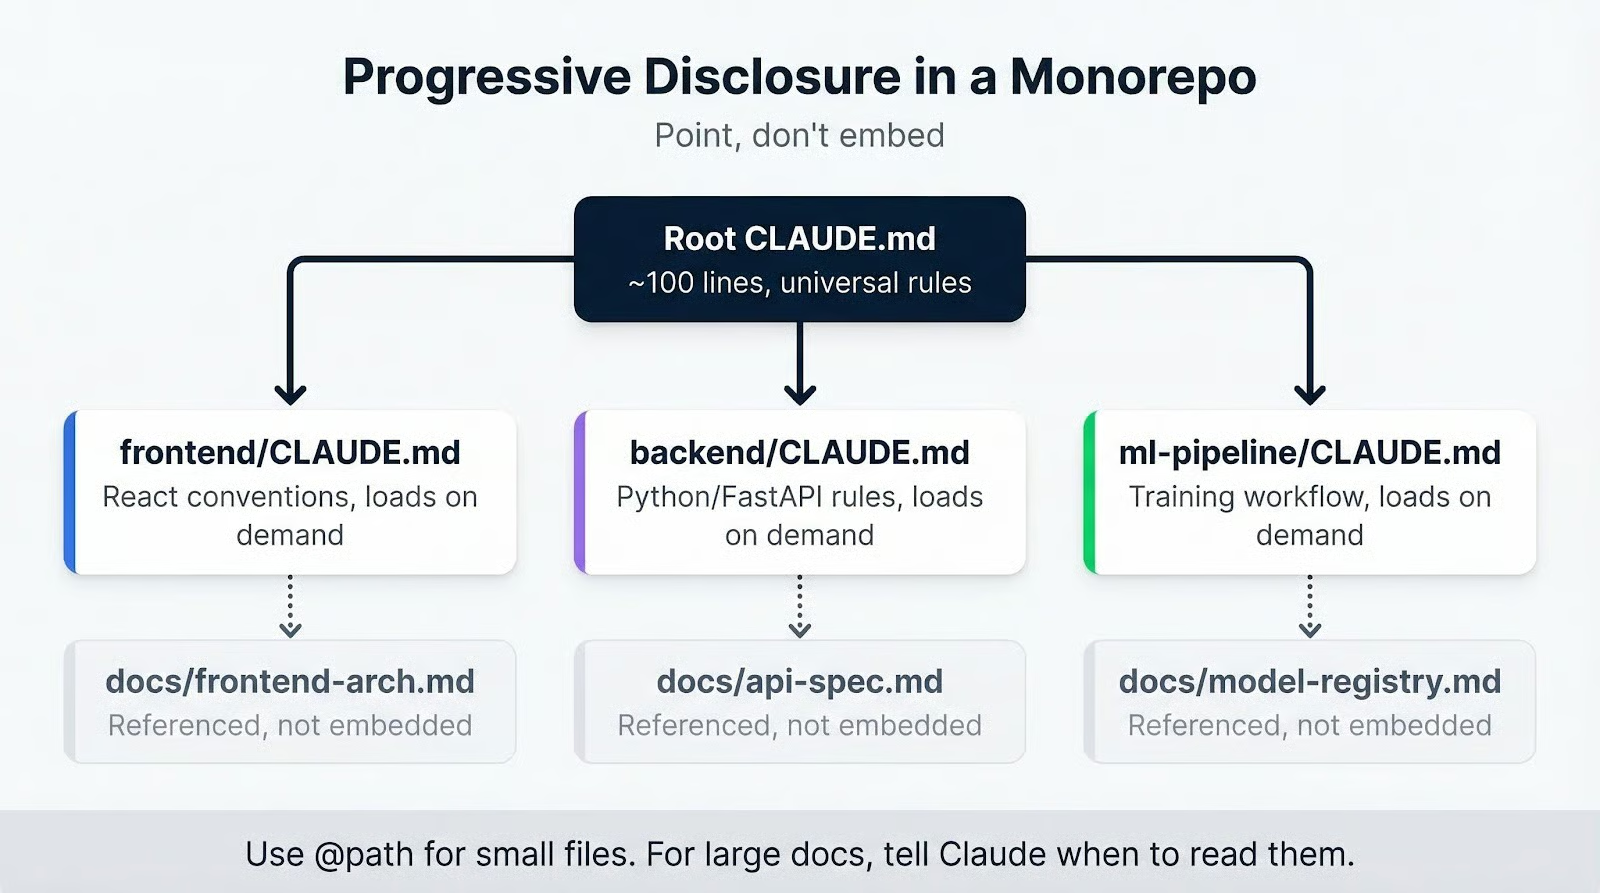 Het principe: verwijs, niet embedden. In plaats van
@path/to/big-doc.md (wat het hele bestand in elke sessie laadt), schrijf je: "Voor migratieprocedures, zie docs/migrations.md." Claude leest het wanneer het die informatie nodig heeft. De @-imports werken voor kleine bestanden, maar alles wat substantieel is kun je beter verwijzen dan embedden.
Subdirectory-CLAUDE.md-bestanden maken dit patroon compleet. Een frontend/CLAUDE.md met React-conventies laadt alleen wanneer Claude bestanden in die map aanraakt. Backendregels blijven uit beeld tijdens frontendwerk.
Structuur opschalen is grotendeels een opgelost probleem zodra je de bouwstenen kent. Maar projecten veranderen en conventies evolueren. Regels die zes maanden geleden logisch waren, worden ruis die de regels verdringt die nu tellen. De voortdurende uitdaging is het bestand in de tijd eerlijk houden.
Voeg regels trager toe dan je denkt. Een nieuwe regel hoort alleen in het bestand als Claude een echte fout heeft gemaakt die die regel had kunnen voorkomen. Elke regel moet terug te leiden zijn tot een echt incident, niet een hypothetisch.
De omgekeerde richting is net zo belangrijk: als Claude een conventie al volgt zonder dat je het zegt, is die regel ballast. Verwijder hem en maak instructiebudget vrij voor regels die gedrag veranderen.
Een onderhoudsgewoonte met lage drempel is Claude elke paar weken vragen: "Review deze CLAUDE.md en stel verbeteringen voor." Het spoort tegenstrijdigheden tussen regels op, markeert overlappende instructies en signaleert formuleringen die strakker kunnen.
Je kunt ook een blijvende instructie in het bestand zelf toevoegen: "Wanneer je tijdens een sessie een verkeerde aanname tegenkomt, stel een correctie voor in CLAUDE.md." Zo ontstaat een feedbacklus waarin het bestand verbetert door normaal gebruik.
De meest voorkomende faalstand is opstapeling. Regels hopen zich op na elke frustrerende sessie, niemand verwijdert wat niet meer relevant is, en uiteindelijk is het bestand zo lang dat Claude de helft eruit filtert. Als Claude een regel blijft negeren, lost extra nadruk bovenop een opgeblazen bestand niets op. Snoeien wel.
Als je @-imports gebruikt voor grote bestanden, is dat het tweede punt om te checken. Een architectuurbestand van 500 regels dat met @ wordt geïmporteerd embedt het hele document in elke sessie, waardoor je instructiebudget opraakt voordat Claude je eerste échte regel verwerkt. Verwijs ernaar in plaats daarvan.
Automatisch genereren met /init en de output nooit cureren is een zekere manier om overal slecht gedrag te krijgen. Een verkeerde instructie in CLAUDE.md raakt niet slechts één reactie. Het vormt Claude’s research, planning en implementatie in elke sessie totdat iemand het ontdekt.
Tegenstrijdige regels over meerdere bestanden zorgen voor onvoorspelbaar gedrag. Wanneer twee regels botsen, kiest Claude er één zonder te vertellen welke. Dit wordt erger in projecten die een root-CLAUDE.md combineren met meerdere .claude/rules/-bestanden. Periodieke review over alle instructiebestanden is de enige preventie.
Niet elke fout verdient een nieuwe regel. Sommige mislukkingen zijn eenmalig. Een regel voor elke edgecase leidt tot een bestand vol voorwaardelijke instructies die helpen in smalle situaties en schaden in de meerderheid van de sessies. Het doel is steeds hetzelfde gebleven: een kort bestand waarin elke regel gedrag verandert.
CLAUDE.md is waarschijnlijk het meest draagkrachtige bestand in een Claude Code-project. Het vormt elke sessie nog voordat er een prompt is getypt, en een goed onderhouden bestand levert wekenlang samengestelde winst op.
Heb je er nog geen, draai dan /init, lees wat eruit komt en schrap elke regel die geen echte fout zou voorkomen. Heb je er wel een, open hem nu en pas dezelfde test toe. Als je CLAUDE.md enorm moet zijn om je project uit te leggen, is dat een signaal dat de tooling van het project te complex is, niet dat je een groter bestand nodig hebt.
De juiste volgende stap: audit je repo en maak vandaag een basisversie. Begin met vijf secties, houd het onder 60 regels en laat echte fouten vanaf daar elke toevoeging sturen.
Als je tools wilt bouwen die de Anthropic API gebruiken, behandelt onze cursus Introduction to Claude Models de volledige modellenfamilie en leer je hoe je ze effectief inzet.
AI-cursussen
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

