Curso
IA práctica con Google Gemini y NotebookLM
2 h
10K
Google está lanzando modelos Flash a un ritmo difícil de seguir. Gemini 3.8 Flash es su tercer lanzamiento Flash en seis semanas y llega como su mejor modelo de razonamiento y código dentro de la gama Flash, manteniendo la misma velocidad y el bajo coste que 3.7 Flash de hace tres semanas.
Junto al modelo estándar, Google presentó Gemini 3.8 Flash Cyber, una variante ajustada para trabajo en ciberseguridad disponible solo para defensores de confianza a través del programa Fairwind, una iniciativa de acceso limitado lanzada al mismo tiempo que los nuevos modelos. Ambos comparten la misma inteligencia base.
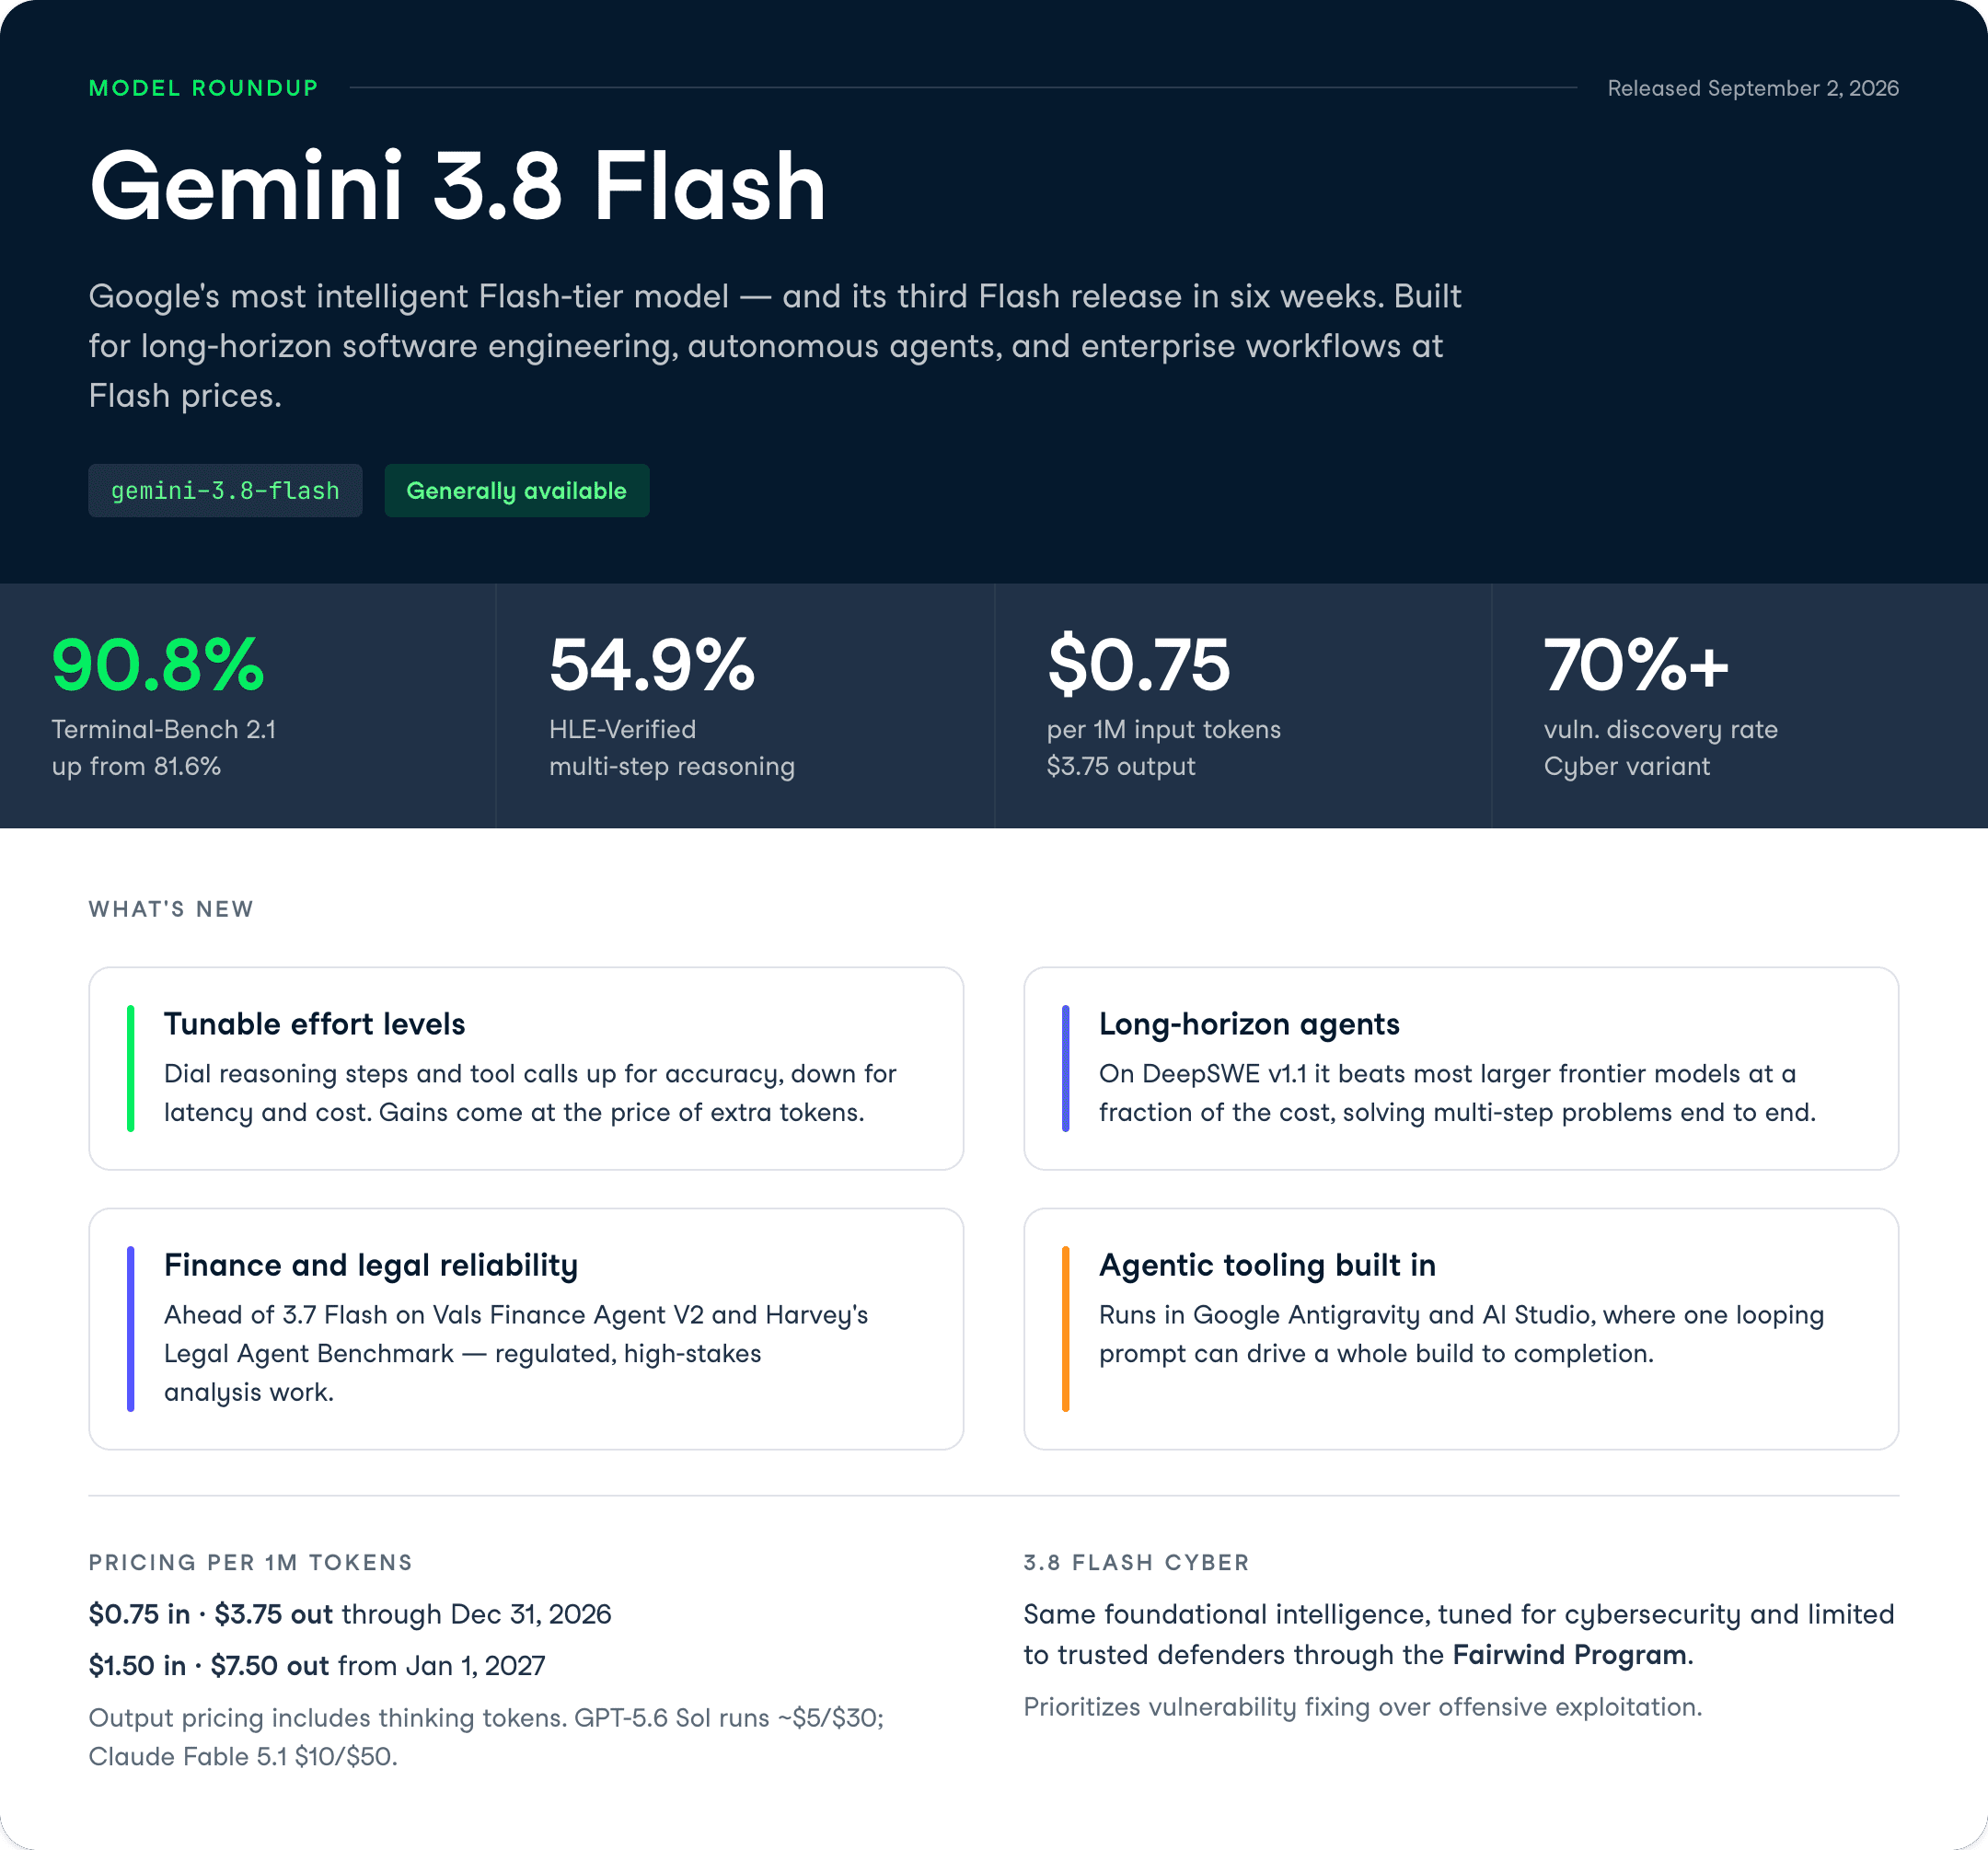
Los números de portada son sólidos: Gemini 3.8 Flash logra un 90,8% en Terminal-Bench 2.1 (frente al 81,6% de 3.7 Flash), un 54,9% en HLE-Verified y, para la variante Cyber, una tasa de descubrimiento de vulnerabilidades en escenarios reales superior al 70%.
En este artículo te cuento todas las novedades de Gemini 3.8 Flash y 3.8 Flash Cyber: nuevas funciones, benchmarks y pruebas prácticas con ejemplos. Mira el modelo en acción en nuestro tutorial de la API de Gemini 3.8 Flash y conoce el nuevo asistente de voz de Google en nuestra guía de Gemini 3.8 Live.
Para ponerte en contexto sobre los modelos rivales, consulta nuestras guías de DeepSeek v4.1 vs Gemini 3.8 Flash y Claude Opus 5 vs Sonnet 5.
Gemini 3.8 Flash es el modelo más inteligente de Google en la gama Flash, diseñado para ingeniería de software de largo recorrido, agentes autónomos y flujos de trabajo empresariales complejos.
Se sitúa por debajo de la gama Pro (como Gemini 3.1 Pro) pero cuesta una fracción, manteniendo la tarifa de lanzamiento de $0,75 por 1M de tokens de entrada y $3,75 por 1M de tokens de salida hasta el 31 de diciembre de 2026.
El principal cambio respecto a 3.7 Flash es que 3.8 Flash sencillamente se esfuerza más.
En tareas complejas, ejecuta pasos extra de razonamiento y llama a herramientas de forma iterativa, por lo que puede acercarse al rendimiento de modelos frontier más caros. La contrapartida es el consumo de tokens: a mayores niveles de esfuerzo, puede gastar más tokens para exprimir los últimos puntos de precisión.
El dato más llamativo está en Terminal-Bench 2.1, donde 3.8 Flash alcanzó un 90,8% frente al 81,6% de 3.7 Flash. Terminal-Bench mide la fiabilidad con la que un modelo completa tareas reales de terminal y programación de principio a fin, así que un salto de 9 puntos apunta directamente a un mejor comportamiento agente en programación.
 ¿Qué hay de nuevo en Gemini 3.8 Flash?
Las funciones de 3.8 Flash están pensadas para desarrolladores que ejecutan agentes y largas sesiones de programación, más que para usuarios de chat ocasionales.
Estas son las capacidades que debes conocer.
Puedes subir o bajar el esfuerzo del modelo según priorices más la precisión o el coste.
Esto importa porque las mejoras de 3.8 Flash tienen el precio de más tokens.
Si tu carga de trabajo prima la eficiencia, Google dice explícitamente que puedes seguir con 3.7 Flash, que sigue totalmente soportado.
Es una nota inusualmente honesta en un lanzamiento de Google, y deja claro que el dial de esfuerzo es un verdadero intercambio, no rendimiento gratis.
Gemini 3.8 Flash está hecho para ejecutar agentes que resuelven problemas de ingeniería en múltiples pasos sin necesidad de tutelaje.
En DeepSWE v1.1, un benchmark de ingeniería de software de largo recorrido, supera a la mayoría de modelos frontier más grandes por una fracción de su coste, resolviendo problemas complejos de extremo a extremo.
Para quienes construyen agentes de programación, este es el número que cuenta.
Usuarios de Reddit y X que filtraron impresiones previas lo describieron como "rendimiento nivel Fable 5 a precio Flash", y el Wall Street Journal señaló que, en las pruebas internas Jetski de Google, los ingenieros prefirieron 3.8 Flash al modelo Opus de Anthropic para programar.
Es una afirmación competitiva agresiva, y merece ser verificada cuando la API esté ampliamente disponible.
3.8 Flash apunta a sectores regulados y de alto riesgo, donde un error sale caro.
Supera a 3.7 Flash y a otros modelos frontier en Vals Finance Agent V2 y en el benchmark legal de Harvey, que evalúan análisis e informes en finanzas y derecho.
Piensa en un flujo de trabajo donde un agente lea varios informes trimestrales y redacte un resumen de cumplimiento, o revise cláusulas de un contrato frente a una política. La fiabilidad que se requiere aquí es distinta al chat genérico, y Google posiciona 3.8 Flash directamente para autonomía empresarial en estos dominios de conocimiento.
Gemini 3.8 Flash se ejecuta dentro de Google Antigravity y Google AI Studio, donde un solo prompt en bucle puede llevarlo a completar toda una construcción.
El ejemplo de Google es una versión jugable estilo DOS de Google Maps generada a partir de un único prompt en Antigravity, con ubicaciones, rutas y Street View.
Para tu trabajo, imagina darle una instrucción como "crea un panel interactivo que consuma este CSV, dibuje tres tipos de gráficos y me permita filtrar por región" y dejar que el bucle agente itere hasta que funcione.
Este patrón de instrucciones en bucle es donde los niveles extra de esfuerzo se notan, porque el modelo sigue refinando en lugar de quedarse en un primer borrador.
El panorama de benchmarks es desigual, lo cual es más útil que un pleno: te indica dónde han caído realmente las mejoras.
Programación y tareas de terminal mejoraron con fuerza, mientras que el razonamiento tipo examen apenas se movió.
Estos son los números de la documentación para desarrolladores y el anuncio de Google.
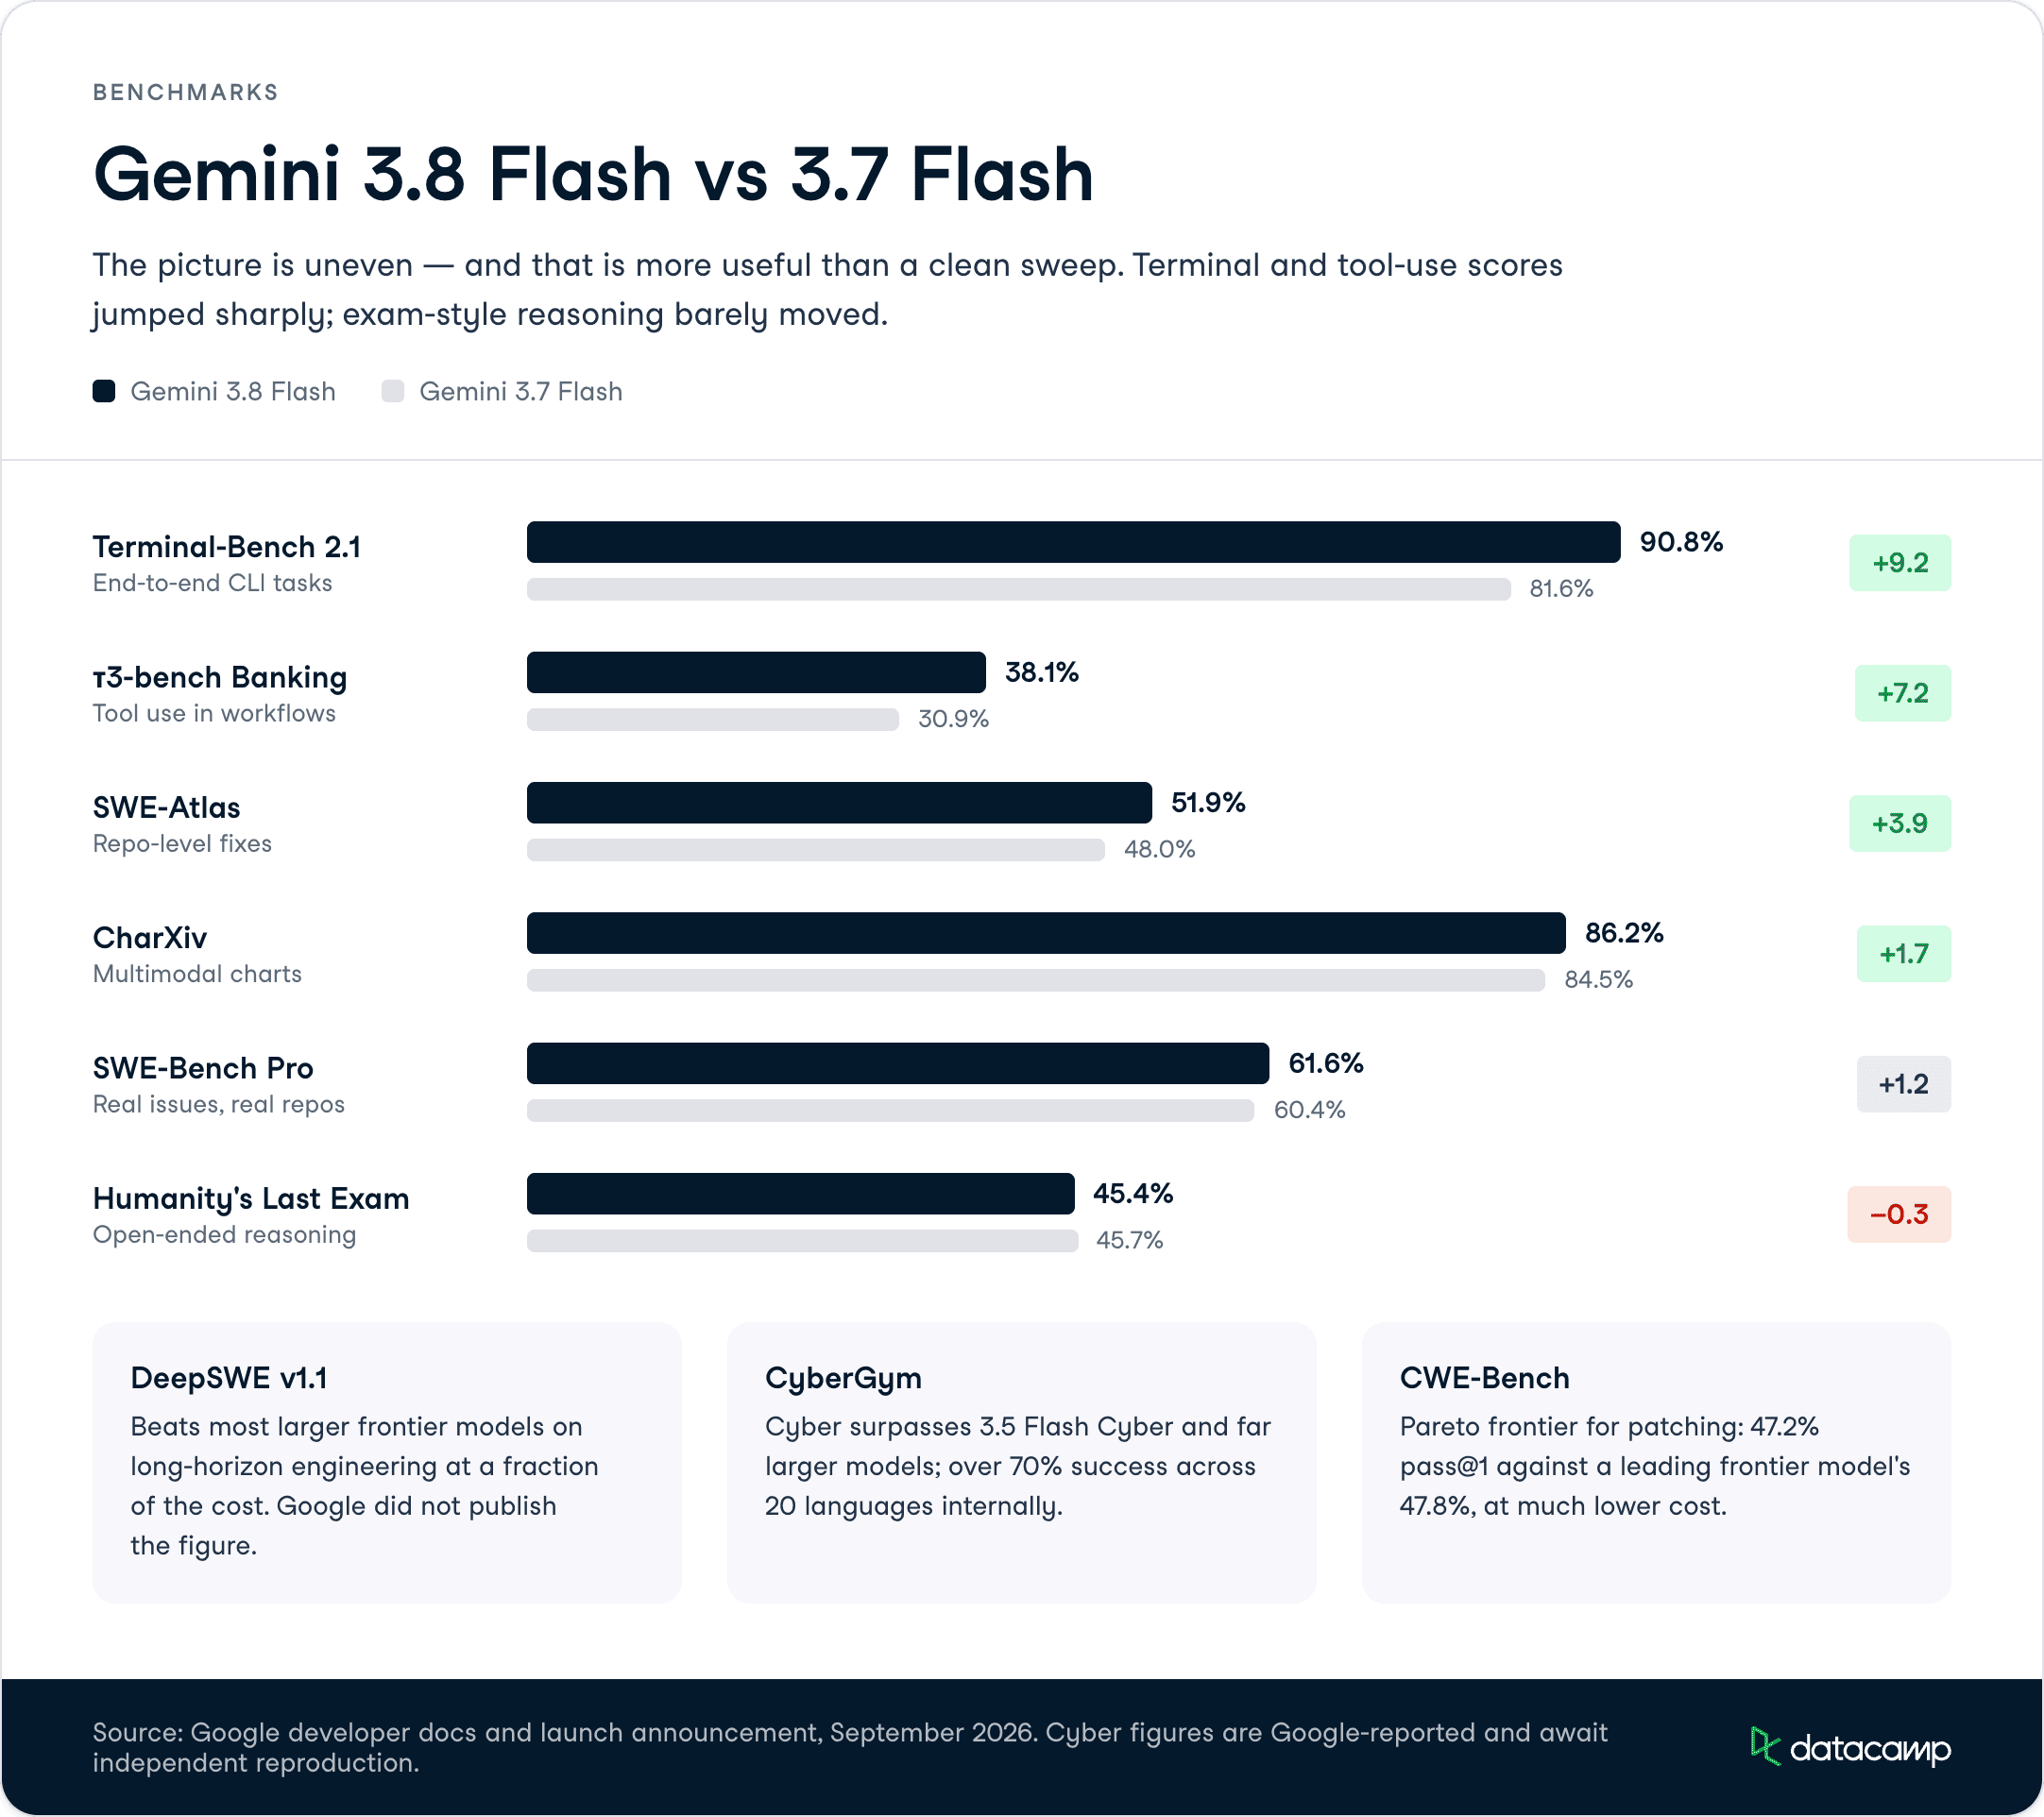
Gemini 3.8 Flash logró un 90,8% en Terminal-Bench 2.1, frente al 81,6% de 3.7 Flash.
Este benchmark mide la fiabilidad con la que un modelo completa tareas reales de línea de comandos y programación de principio a fin, incluyendo ejecutar herramientas y recuperarse de errores.
Como contexto frente a modelos de gama media rivales, en nuestra comparativa GPT-5.6 Terra vs Claude Sonnet 5 vimos que Terra obtuvo un 87,4% en Terminal-Bench 2.1 y Sonnet 5 un 80,4%. Con esos datos, el 90,8% de 3.8 Flash se sitúa por delante de ambos, algo notable para un modelo de la gama Flash a $0,75 de entrada.
En DeepSWE v1.1, un benchmark de ingeniería de software de largo recorrido, 3.8 Flash supera a la mayoría de modelos frontier más grandes por una fracción de su coste.
Google no publicó el porcentaje exacto en las notas extraídas, pero el mensaje es que resuelve problemas de ingeniería complejos de forma autónoma y de extremo a extremo.
Es el benchmark que respalda la promesa de "un agente que termina el trabajo".
Si tu carga implica un agente iterando durante muchos pasos sobre una base de código, DeepSWE se acerca más a tu realidad que una puntuación de código a un solo tiro.
En SWE-Bench Pro, 3.8 Flash obtuvo un 61,6% frente al 60,4% de 3.7 Flash, y en SWE-Atlas alcanzó un 51,9% frente al 48,0%.
Son benchmarks a nivel de repositorio que miden la corrección de incidencias reales en bases de código reales.
La mejora de algo más de 1 punto en SWE-Bench Pro es modesta y conviene destacarla. Los saltos mayores están en Terminal-Bench; si te importa la fiabilidad en terminal y herramientas, ahí es donde 3.8 Flash se separa de su predecesor.
3.8 Flash alcanza un 54,9% en HLE-Verified, una prueba de razonamiento multi-paso en STEM, humanidades y ámbitos profesionales.
Sin embargo, en Humanity's Last Exam, según la documentación de Google, la puntuación se quedó prácticamente igual: 45,4% para 3.8 Flash frente a 45,7% para 3.7 Flash.
El razonamiento general tipo examen no avanzó mucho; si tu caso de uso es razonamiento abierto complejo más que programación y uso de herramientas, el salto de 3.7 a 3.8 Flash puede no compensar los tokens extra.
Gemini 3.8 Flash Cyber ofrece resultados a nivel frontier en descubrimiento y parcheo de vulnerabilidades.
En CyberGym, el benchmark estándar del sector para descubrimiento autónomo de vulnerabilidades, supera a 3.5 Flash Cyber y a modelos frontier significativamente mayores; y en el benchmark interno de Google que abarca 20 lenguajes de programación, supera el 70% de éxito.
En CWE-Bench, un benchmark externo de parcheo dirigido por Collinear, Cyber se sitúa en la frontera de Pareto con un pass@1 del 47,2% frente al 47,8% de un modelo frontier líder, a un coste mucho menor.
Google priorizó deliberadamente la corrección de vulnerabilidades frente a la explotación ofensiva, en línea con cómo Anthropic distribuye Sonnet 5 con salvaguardas cibernéticas activadas por defecto (0,0% en una evaluación de desarrollo de exploits para Firefox, como señalamos en nuestra reseña de Opus 5 vs Sonnet 5).
En la tabla siguiente puedes ver cómo se compara el nuevo modelo con su predecesor de hace unas semanas:
| Benchmark | Gemini 3.8 Flash | Gemini 3.7 Flash |
|---|---|---|
| Terminal-Bench 2.1 | 90,8% | 81,6% |
| SWE-Bench Pro | 61,6% | 60,4% |
| SWE-Atlas | 51,9% | 48,0% |
| τ³-bench Banking | 38,1% | 30,9% |
| CharXiv (multimodal) | 86,2% | 84,5% |
| Humanity's Last Exam | 45,4% | 45,7% |
Gemini 3.8 Flash está disponible de forma general en Google AI Studio y en Gemini Enterprise Agent Platform, lanzado el 2 de septiembre de 2026, con el ID de modelo de la API gemini-3.8-flash.
La variante 3.8 Flash Cyber está restringida a defensores de confianza a través del programa Fairwind y no tiene lanzamiento general.
Los precios mantienen las mismas tarifas de introducción que 3.7 Flash:
Para situarlo frente a rivales en septiembre de 2026: GPT-5.6 Sol ronda los $5 en entrada y $30 en salida por 1M de tokens, y el nuevo Claude Fable 5.1 cuesta $10 en entrada y $50 en salida.
Gemini 3.8 Flash es mucho más barato que ambos, que es justo la propuesta de la gama Flash.
Gemini 3.8 Flash muestra a Google apretando en la franja de valor del mercado de modelos para programar, con una estrategia clara: acercarse al rendimiento casi frontier por $0,75 en entrada mientras lanza un nuevo modelo Flash cada pocas semanas.
El 90,8% en Terminal-Bench 2.1 y el precio por debajo de $1 lo convierten en un candidato serio por defecto para cargas de trabajo de programación con agentes.
Mi lectura es que el lanzamiento es desigual, y Google lo reconoce.
Terminal y uso de herramientas suben con fuerza, DeepSWE y los benchmarks de finanzas y derecho mejoran, pero HLE se queda plano y SWE-Bench Pro apenas se mueve.
Si construyes agentes de programación, es una mejora significativa respecto a 3.7 Flash.
Si necesitas razonamiento abierto complejo, el caso es menos sólido, y quedarse en 3.7 Flash por eficiencia es una opción razonable.
La variante Cyber es la apuesta más interesante a largo plazo. Un >70% en descubrimiento de vulnerabilidades reales y parcheo en frontera de Pareto, con acceso vía Fairwind y sesgo hacia defensa frente a explotación, es una postura defendible para una compañía que ya lo usa para asegurar su propio código.
Querría ver reproducciones independientes antes de dar por buenos los números de CyberGym y CWE-Bench, ya que casi todos los datos vienen de la propia Google.
Si quieres crear agentes y flujos de trabajo de programación con modelos como este, nuestro itinerario de aprendizaje AI Agent Fundamentals es un buen punto de partida.
Cursos destacados de DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Matt Crabtree
12 min
blog
Ryan Ong
8 min
blog
Matt Crabtree
13 min
Tutorial
Moez Ali
11 min
Tutorial
Dimitri Didmanidze
8 min