Programa
Conocí los modelos de generación de vídeo cuando OpenAI lanzó la primera versión de Sora. Desde entonces, he ido descubriendo muchos modelos de primera línea. Eso me animó a recopilar una lista con los mejores. Las posiciones se basan en mi experiencia, el ranking de Artificial Analysis de generación de vídeo y el feedback general de la comunidad.
La generación de vídeo se parece a la de imágenes, pero con una restricción extra: el tiempo. Cada fotograma debe ser coherente con los anteriores, manteniendo la identidad de los personajes, la iluminación, el movimiento de cámara y la disposición de la escena para preservar la coherencia temporal.
Los sistemas actuales van más allá del texto a vídeo: puedes animar una única imagen con tu propio estilo, encadenar planos en secuencias más largas e incluso generar audio sincronizado (música, SFX y diálogos) a partir de indicaciones, creando clips cinematográficos de extremo a extremo.
En este blog, veremos algunos de los modelos de generación de vídeo mejor valorados que están transformando el marketing, el cine, la publicidad y la creación de contenido, abriendo nuevas posibilidades creativas en múltiples sectores.
Imagen del autor | Canva + Google Nano Banana
¿Qué son los modelos de generación de vídeo?
Los modelos de generación de vídeo son sistemas de IA que crean imágenes en movimiento a partir de entradas como texto, imágenes o vídeos existentes. Se basan en los métodos de texto a imagen incorporando el elemento temporal. Además de garantizar realismo y fidelidad a la indicación, estos modelos deben mantener un movimiento fluido, continuidad de los sujetos y coherencia entre fotogramas.
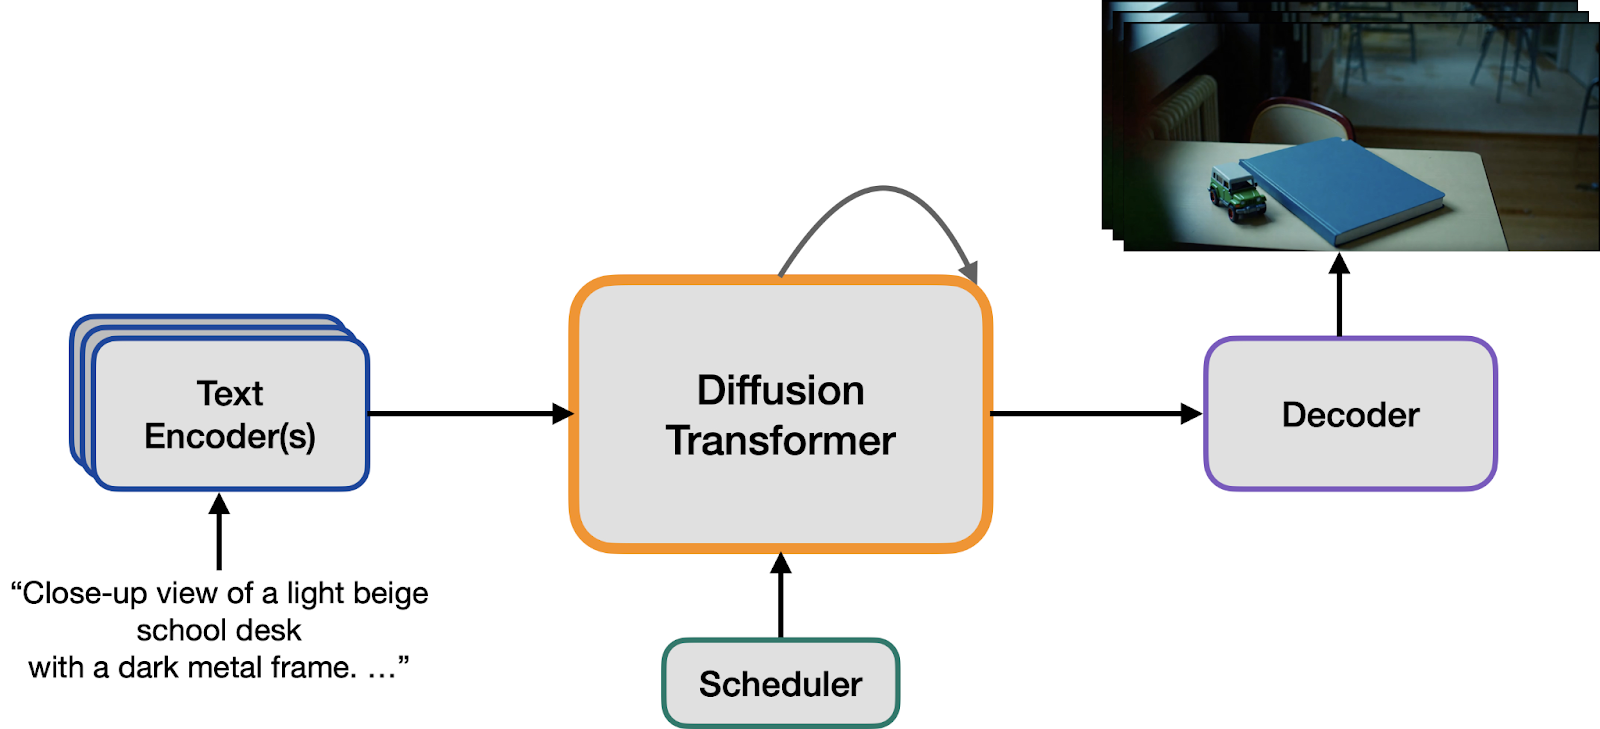
Imagen de State of open video generation models in Diffusers
Un modelo de generación de vídeo convierte una indicación de texto en una representación estructurada con un codificador de texto; después parte de ruido aleatorio y lo refina paso a paso mediante una red de denoising. Un programador guía el proceso, mientras que codificadores y decodificadores alternan entre el espacio de píxeles y un espacio latente comprimido para ganar eficiencia. A diferencia de los modelos de imagen, los de vídeo procesan tokens 3D que capturan detalle espacial y movimiento temporal. Como la decodificación requiere mucha memoria, muchos pipelines usan decodificación fotograma a fotograma para hacer la generación más eficiente.
1. Veo 3
Veo 3 es el modelo de generación de vídeo de última generación de Google. Produce clips de 8 segundos a 720p o 1080p (16:9) con audio nativo siempre activo a 24 fps. Disponible vía la API de Gemini, destaca en escenas con diálogo, realismo cinematográfico y animación creativa, capturando diálogos entrecomillados, efectos de sonido explícitos y paisajes sonoros ambientales directamente desde tu prompt.
Veo 3 convierte indicaciones de texto en planos cinematográficos con iluminación coherente, profundidad de campo y colorimetría fílmica, manteniendo la consistencia temporal entre fotogramas. Genera de forma nativa diálogos, SFX y ambientes sincronizados, con habla sincronizada con labios, acústica acorde a la escena y señales temporales precisas que elevan el realismo.
2. Sora 2
Sora 2 es un sistema versátil de texto a vídeo que ahora genera audio sincronizado junto a lo visual, incluidos diálogos, sonidos ambientales y efectos, todo en una sola pasada. Este avance cierra una brecha importante en los flujos de trabajo anteriores y permite una narrativa más cohesionada entre múltiples planos.
Además del audio, el modelo se centra en crear escenas más realistas, mejorar la plausibilidad física (peso, equilibrio, permanencia de los objetos y relaciones de causa y efecto) y reforzar la continuidad entre múltiples planos (asegurando consistencia en personajes, iluminación y estado general del mundo). También ofrece opciones de estilo flexibles, desde fotorrealista y cinematográfico hasta animado.
Además, Sora 2 incorpora una capacidad sofisticada para simular fallos, como saltos fallidos o resbalones, útil para previsualización y conceptos relacionados con la seguridad.
3. PixVerse V5
PixVerse V5 es una mejora importante respecto a V4.5 que combina generación más rápida de texto a vídeo e imagen a vídeo con visuales más nítidos y cinematográficos. Ofrece movimiento fluido y expresivo, estabilidad de estilo y color, y gran fidelidad al prompt para que tu dirección se plasme limpia en pantalla.
PixVerse V5 apuesta por el realismo a través de tres pilares: movimiento, consistencia y detalle. Sus movimientos de cámara más suaves y animaciones naturales y con peso reducen la rigidez de versiones anteriores, mientras que la consistencia temporal mantiene estilo, color y sujetos coherentes entre fotogramas para un flujo con acabado de cine. El resultado son imágenes nítidas y cinematográficas que muchos creadores describen como «dignas de estreno», con una obediencia fiable al prompt en estilo, tono y tema.
4. Kling 2.5 Turbo
Kling 2.5 Turbo es la última mejora del conjunto de generación de vídeo con IA de Kling, creada para ofrecer velocidad de otro nivel y libertad creativa. Avanza tanto en texto a vídeo como en imagen a vídeo con mayor fidelidad al prompt, control de cámara avanzado y realismo consciente de la física, para que tu dirección llegue a resultados cinematográficos con menos iteraciones y latencia.
Kling 2.5 Turbo se centra en una estética de calidad cinematográfica, con fotogramas más nítidos, iluminación equilibrada y gran profundidad de color que aportan una intención visual desde el primer momento. Su mejor fidelidad al prompt y control de cámara traducen con precisión guiones detallados a imágenes concretas, ejecutando con suavidad paneos, zooms y transiciones con un acabado profesional.
El realismo mejora gracias a un movimiento consciente de la física, incorporando elementos como la gravedad y los impactos junto a movimientos de tipo fluido. Esto se complementa con expresiones más verosímiles en los personajes, haciendo que la acción y las interpretaciones resulten creíbles en pantalla.
5. Hailuo 02
El MiniMax Hailuo 02 es un modelo de nueva generación diseñado para salida nativa en 1080p. Destaca por su avanzado seguimiento de instrucciones y una competencia excepcional en física. Impulsado por una nueva arquitectura llamada Noise-Aware Compute Redistribution (NCR), logra aproximadamente 2,5 veces más eficiencia con escalas de parámetros similares.
Este avance permite un modelo tres veces mayor y entrenado con cuatro veces más datos que su predecesor, manteniendo intactos los costes para creadores. El resultado es un sistema más rápido y capaz que interpreta con precisión prompts complejos y genera movimiento de alta fidelidad
Hailuo 02 destaca en escenas que requieren física realista y control preciso. Por ejemplo, puede gestionar coreografías de nivel gimnástico donde movimientos corporales, distribución del peso y tiempos deben sentirse auténticos. Su mayor escala de entrenamiento y la eficiencia NCR se traducen en fotogramas más claros, consistencia temporal estable y alta precisión al seguir prompts, asegurando que las instrucciones complejas se ejecuten en pantalla con un desvío mínimo.
6. Seedance 1.0
Seedance 1.0 es el último modelo de vídeo de alta calidad de ByteDance, diseñado para crear movimiento fluido y estable e incorporar narrativas multi‑plano de forma nativa. Gestiona con solvencia los flujos de trabajo de texto a vídeo (T2V) e imagen a vídeo (I2V).
Este modelo ofrece un amplio rango dinámico, lo que permite movimientos fluidos y de gran escala manteniendo la estabilidad y el realismo físico. Es capaz de capturar desde expresiones sutiles hasta escenas muy activas.
Además de sus capacidades de movimiento, Seedance 1.0 permite crear vídeos narrativos con múltiples planos, garantizando consistencia en el sujeto principal, el estilo y la atmósfera general durante las transiciones y cambios de espacio y tiempo. Esta consistencia es clave para una narrativa cohesionada y flujos de producción eficientes.
Seedance 1.0 también ofrece una gran variedad estilística y control preciso. Puede gestionar interacciones multiagente, secuencias de acción complejas y movimientos de cámara dinámicos mientras sigue con exactitud prompts detallados. Esto permite traducir fielmente el texto a vídeo cinematográfico. Asimismo, admite salidas en alta definición, incluido 1080p, garantizando un movimiento fluido y gran detalle visual que contribuyen a un acabado con aspecto de cine tanto en T2V como en I2V.
7. Wan2.2
Wan-AI/Wan2.2 es un modelo de vídeo generativo a gran escala y de código abierto. Basado en Wan 2.1, incorpora una arquitectura de difusión Mixture‑of‑Experts (MoE) que enruta de forma eficiente expertos especializados a lo largo de los pasos de denoising, ampliando la capacidad sin aumentar las exigencias computacionales.
Lo mejor es que es completamente abierto: el equipo de Wan‑AI ha publicado código y pesos para uso práctico, incluido un modelo híbrido TI2V de 5B con un VAE de alta compresión (16×16×4) que admite 720p a 24 fps tanto para texto a vídeo como para imagen a vídeo en GPUs de consumo (por ejemplo, la 4090). También hay modelos A14B T2V/I2V disponibles para salidas de 480p y 720p.
Wan2.2 crea vídeos con control cinematográfico y un movimiento complejo y verosímil. El diseño MoE asigna un experto de alto ruido para el trazado global inicial y un experto de bajo ruido para las etapas finales de detalle. Esta combinación da como resultado composiciones limpias, texturas nítidas y una coherencia temporal estable que se percibe realista en pantalla. Las etiquetas estéticas curadas permiten estilos visuales precisos y controlados, abarcando iluminación, etalonaje y encuadre.
8. Mochi 1
genmo/mochi-1 es un modelo de generación de vídeo avanzado y de código abierto que muestra movimiento de alta fidelidad y gran obediencia a los prompts en evaluaciones iniciales, reduciendo notablemente la brecha entre sistemas cerrados y abiertos.
Mochi 1 destaca al convertir lenguaje natural en movimiento coherente y cinematográfico, captando con eficacia la intención del usuario. Los vídeos resultantes son pulidos, deliberados y fieles a las descripciones. Al acercar la calidad a la de los modelos cerrados líderes y seguir siendo totalmente abierto con licencia Apache, Mochi 1 permite a investigadores, creadores y desarrolladores experimentar, afinar e integrar tecnología puntera de texto a vídeo en proyectos reales sin grandes limitaciones ni barreras de coste.
9. LTX-Video
LTX-Video es el sistema de generación de vídeo entrenado con difusión (DiT) de Lightricks, conocido por entregar vídeos de alta calidad en tiempo real. Produce 30 fotogramas por segundo (FPS) a una resolución de 1216×704, más rápido que la propia reproducción. Entrenado con un conjunto masivo y diverso de vídeos, LTX‑Video se centra en convertir imágenes en vídeos con condicionamiento opcional mediante imágenes y clips cortos.
Ofrece varios modelos para equilibrar calidad y coste: un modelo de 13.000 millones de parámetros para la máxima fidelidad; variantes destiladas y en FP8 para menor uso de VRAM y mayor velocidad; y una opción de 2.000 millones de parámetros para despliegues ligeros. El resultado es un sistema práctico y orientado a creadores que combina velocidad con visuales realistas y de alta resolución.
LTX‑Video transforma imágenes estáticas en movimiento fluido y coherente a 30 FPS, con texturas nítidas, sujetos estables y una dinámica de cámara creíble, dando la sensación de material rodado y no sintetizado. Su arquitectura DiT y su entrenamiento a gran escala contribuyen a la consistencia temporal y a un contenido variado y verosímil, mientras que los prompts detallados en inglés te brindan un control estilístico preciso.
10. Marey
Marey es el modelo de vídeo fundacional de Moonvalley, específicamente diseñado para cumplir los estándares de la cinematografía de primer nivel. Está pensado para cineastas que necesitan precisión en cada fotograma, con énfasis en control, consistencia y fidelidad. Así tu visión creativa se materializa fielmente desde el concepto hasta el montaje final. De la definición del look a la edición, Marey se integra sin fricciones en flujos profesionales y ofrece imágenes de alta calidad que resisten el escrutinio.
Marey convierte indicaciones detalladas en secuencias precisas listas para producción, garantizando sujetos estables, iluminación consistente y movimiento suave con calidad cinematográfica. Al priorizar el control a nivel de fotograma y la consistencia temporal, ayuda a mantener el tono, el estilo y el ritmo a lo largo de distintos planos. Esto permite a los creadores producir con confianza tráilers, escenas y campañas.
Conclusión
Los modelos de generación de vídeo avanzan a gran velocidad, y creadores de publicidad, e‑commerce, marketing, cine, YouTube y formatos cortos ya los están usando. Las ventajas son claras: iteración más rápida, calidad cinematográfica y nuevas posibilidades creativas antes inalcanzables. Sin embargo, el realismo que logran también conlleva riesgos reales, como anuncios engañosos, estafas de productos y deepfakes muy convincentes de figuras públicas.
A medida que adoptamos estas herramientas, es esencial combinar innovación con responsabilidad: ser transparentes sobre el uso de IA, verificar fuentes y seguir pautas éticas y legales claras.
En este blog hemos repasado diez modelos líderes que convierten texto e imágenes en metraje altamente realista, con demos en YouTube para mostrar los puntos fuertes de cada uno. También he señalado opciones de código abierto que puedes ejecutar en local, ideales para aprender, experimentar y afinar resultados acordes a tu marca o historia.
Soy un científico de datos certificado que disfruta creando aplicaciones de aprendizaje automático y escribiendo blogs sobre ciencia de datos. Actualmente me centro en la creación de contenidos, la edición y el trabajo con grandes modelos lingüísticos.