{count, plural, one {Programa} other {Programas}}
Eu conheci os modelos de geração de vídeo quando a OpenAI lançou a primeira versão do Sora. A partir daí, comecei a me deparar com muitos modelos de ponta para geração de vídeo. Isso me inspirou a reunir uma lista dos melhores modelos disponíveis. Os rankings se baseiam na minha experiência, no ranking de geração de vídeo do Artificial Analysis e no feedback geral dos usuários.
A geração de vídeo é parecida com a de imagens, mas com uma restrição extra: o tempo. Cada quadro precisa manter consistência com os anteriores, preservando a identidade dos personagens, a iluminação, o movimento de câmera e a composição da cena para garantir coerência temporal.
Os sistemas modernos vão além do texto para vídeo: você pode animar uma imagem única no seu estilo, unir tomadas em sequências mais longas e até gerar áudio sincronizado (música, efeitos sonoros e diálogos) a partir de prompts, criando clipes cinematográficos de ponta a ponta.
Neste blog, vamos explorar alguns dos modelos de geração de vídeo mais bem avaliados que estão transformando os mundos do marketing, do cinema, da publicidade e da criação de conteúdo, abrindo novas possibilidades criativas em diversos setores.
Imagem do autor | Canva + Google Nano Banana
O que são modelos de geração de vídeo?
Modelos de geração de vídeo são sistemas de IA que criam imagens em movimento a partir de entradas como texto, imagens ou vídeos existentes. Eles evoluem os métodos de texto para imagem ao incorporar o elemento do tempo. Além de garantir realismo e aderência aos prompts, esses modelos também precisam manter movimentos suaves, continuidade dos sujeitos e coerência de um quadro para o outro.
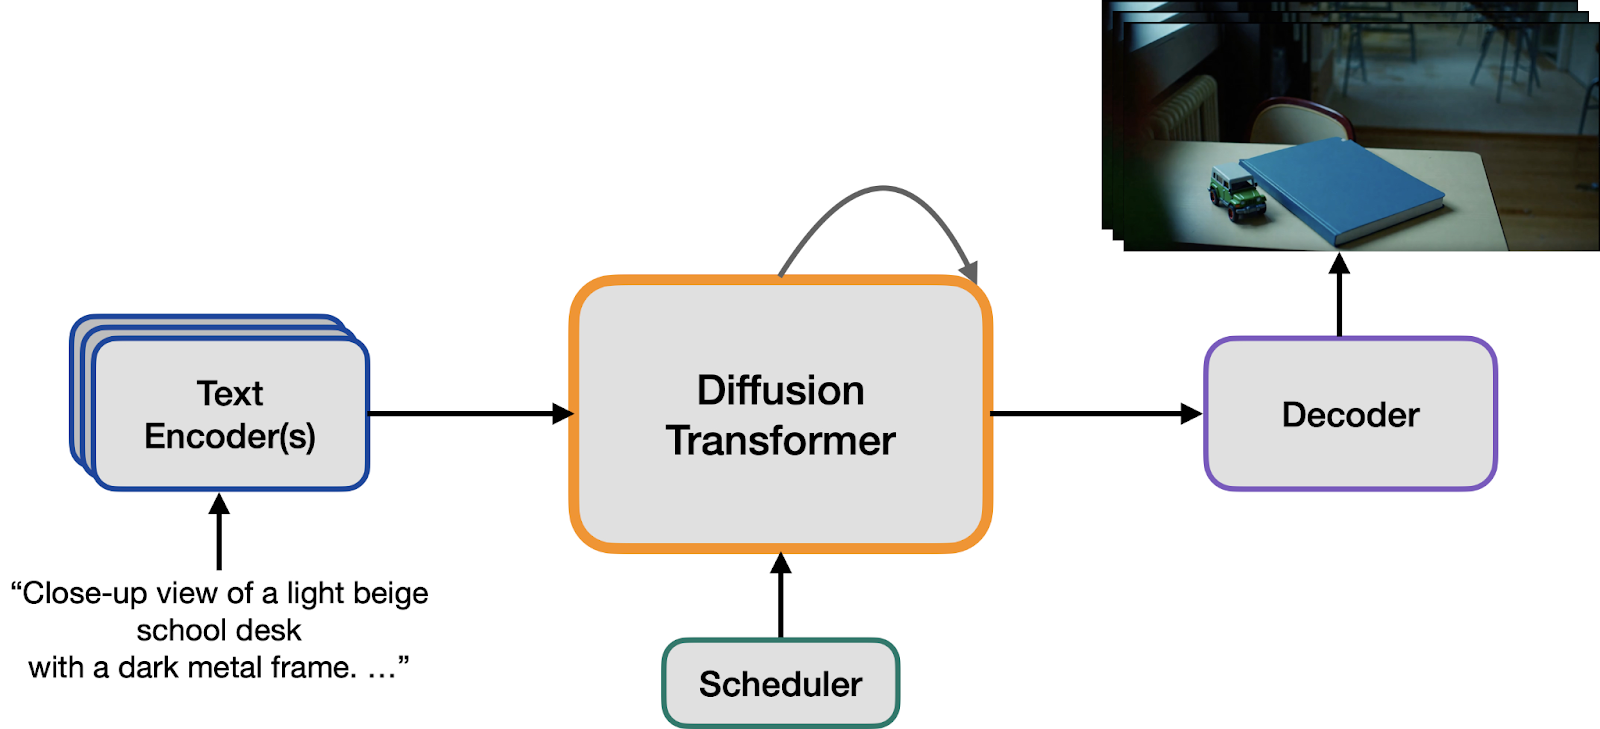
Imagem de State of open video generation models in Diffusers
Um modelo de geração de vídeo funciona transformando um prompt de texto em uma representação estruturada com um codificador de texto e, depois, partindo de ruído aleatório e refinando-o passo a passo por meio de uma rede de remoção de ruído. Um scheduler orienta esse processo, enquanto codificadores e decodificadores alternam entre o espaço de pixels e um espaço latente comprimido para ganhar eficiência. Diferente dos modelos de imagem, os modelos de vídeo processam tokens 3D que capturam detalhes espaciais e movimento temporal. Como a decodificação exige muita memória, muitos pipelines usam decodificação quadro a quadro para tornar a geração mais eficiente.
1. Veo 3
Veo 3 é o modelo de geração de vídeo de última geração do Google, produzindo clipes de 8 segundos em alta fidelidade, 720p ou 1080p (16:9), com áudio nativo sempre ligado a 24 fps. Disponível via Gemini API, se destaca em cenas com diálogos, realismo cinematográfico e animação criativa, capturando falas entre aspas, efeitos sonoros explícitos e paisagens sonoras ambientes direto do seu prompt.
O Veo 3 traduz prompts de texto em tomadas cinematográficas com iluminação coerente, profundidade de campo e cor com estética de filme, mantendo consistência temporal quadro a quadro. Ele renderiza de forma nativa diálogos, SFX e ambiência sincronizados, possibilitando fala com sincronia labial, acústica adequada à cena e marcações temporais precisas que elevam o realismo.
2. Sora 2
Sora 2 é um sistema versátil de texto para vídeo que agora gera áudio sincronizado junto com os visuais, incluindo diálogos, sons ambientes e efeitos sonoros, tudo em uma única passagem. Esse avanço elimina uma lacuna importante nos fluxos anteriores e permite narrativas mais coesas em múltiplas tomadas.
Além do áudio, o modelo foca em criar cenas mais realistas, melhorando a plausibilidade física (como peso, equilíbrio, permanência de objetos e relações de causa e efeito) e aumentando a continuidade entre múltiplas tomadas (garantindo consistência de personagens, iluminação e estado geral do mundo). Ele também oferece estilos flexíveis, atendendo a estéticas fotorrealistas, cinematográficas e animadas.
Além disso, o Sora 2 introduz uma capacidade sofisticada de simular falhas, como saltos perdidos ou escorregões, algo valioso para pré-visualização e conceitos ligados à segurança.
3. PixVerse V5
PixVerse V5 é uma grande evolução em relação ao V4.5, unindo geração mais rápida de texto para vídeo e de imagem para vídeo com visuais mais nítidos e cinematográficos. Entrega movimento suave e expressivo, estilo e cor estáveis e forte aderência ao prompt para que sua direção apareça limpa na tela.
O PixVerse V5 busca realismo a partir de três pilares: movimento, consistência e detalhe. Seus movimentos de câmera mais suaves e animações naturais, com sensação de peso, reduzem a rigidez vista em versões anteriores, enquanto a consistência temporal mantém estilo, cores e sujeitos coerentes entre os quadros para um fluxo coeso, com cara de cinema. O resultado são imagens nítidas e cinematográficas que muitos criadores descrevem como “dignas de filme”, com obediência confiável ao prompt para estilo, tom e assunto.
4. Kling 2.5 Turbo
Kling 2.5 Turbo é a atualização mais recente da suíte de vídeo com IA da Kling, construída para velocidade de outro nível e liberdade criativa. Avança texto‑para‑vídeo e imagem‑para‑vídeo com maior aderência ao prompt, controle de câmera avançado e realismo sensível à física, para que sua direção vire resultados cinematográficos com menos iteração e atrasos.
O Kling 2.5 Turbo prioriza estética de nível cinematográfico, com quadros mais nítidos, iluminação equilibrada e rica profundidade de cor, dando às cenas uma qualidade intencional e cinematográfica desde o início. Sua aderência aprimorada ao prompt e o controle de câmera traduzem com precisão roteiros detalhados em visuais exatos, executando pans, zooms e transições de forma suave e com acabamento profissional.
O realismo é reforçado por movimentos que consideram a física, incorporando elementos como gravidade e impactos, além de dinâmicas semelhantes a fluidos. Isso é complementado por expressões de personagens mais verossímeis, tornando as ações e atuações críveis na tela.
5. Hailuo 02
O MiniMax Hailuo 02 é um modelo de geração de vídeo de nova geração projetado para saída nativa em 1080p. Ele traz instrução following de ponta e domínio excepcional de física. Impulsionado por uma nova arquitetura chamada Noise-Aware Compute Redistribution (NCR), alcança cerca de 2,5 vezes mais eficiência em escalas de parâmetros semelhantes.
Esse avanço possibilita um modelo três vezes maior e treinado com quatro vezes mais dados do que seu antecessor, mantendo inalterados os custos para criadores. O resultado é um sistema mais rápido e mais capaz, que interpreta com precisão prompts complexos e gera movimentos de alta fidelidade
O Hailuo 02 se destaca na criação de cenas que exigem física realista e controle preciso. Por exemplo, ele lida com coreografias em nível de ginástica, em que movimentos do corpo, distribuição de peso e timing precisam soar autênticos. Sua escala de treino ampliada e a eficiência do NCR resultam em quadros mais nítidos, consistência temporal estável e alta precisão no seguimento de prompts, garantindo que instruções detalhadas sejam executadas na tela com mínimo desvio.
6. Seedance 1.0
Seedance 1.0 é o mais novo modelo de geração de vídeo de alta qualidade da ByteDance, projetado para criar movimento suave e estável com narrativa nativa multi‑shot. Ele atende bem aos fluxos de trabalho de texto‑para‑vídeo (T2V) e imagem‑para‑vídeo (I2V).
O modelo tem ampla faixa dinâmica, permitindo movimentos fluidos em grande escala, mantendo estabilidade e realismo físico. Ele captura desde expressões sutis até cenas altamente ativas.
Além das capacidades de movimento, o Seedance 1.0 dá suporte à criação de vídeos narrativos com múltiplas tomadas, garantindo consistência do protagonista, do estilo e da atmosfera geral durante transições e mudanças de espaço e tempo. Essa consistência é essencial para narrativas coesas e fluxos de produção eficientes.
O Seedance 1.0 também oferece expressão estilística diversa e controle preciso. Ele gerencia interações entre múltiplos agentes, sequências de ação complexas e movimentos dinâmicos de câmera enquanto segue com precisão prompts detalhados. Isso permite uma tradução fiel do texto para vídeo cinematográfico. Além disso, suporta saídas em alta definição, incluindo 1080p, garantindo movimento suave e forte detalhamento visual que contribuem para um acabamento polido, com aparência de filme, tanto em T2V quanto em I2V.
7. Wan2.2
Wan-AI/Wan2.2 é um modelo aberto e avançado de geração de vídeo em larga escala. Construído sobre o Wan 2.1, traz uma arquitetura de difusão Mixture‑of‑Experts (MoE) que distribui especialistas ao longo dos passos de denoising, ampliando a capacidade sem aumentar as exigências computacionais.
O melhor de tudo é que ele é totalmente aberto: a equipe da Wan-AI liberou código e pesos para uso prático, incluindo um modelo híbrido TI2V de 5B com VAE de alta compactação (16×16×4) que suporta 720p a 24 fps tanto para texto‑para‑vídeo quanto imagem‑para‑vídeo em GPUs de consumo (por exemplo, a 4090). Também há modelos A14B T2V/I2V disponíveis para saídas em 480p e 720p.
O Wan2.2 cria vídeos com controle cinematográfico e movimento complexo e crível. O design MoE aloca um especialista de alto ruído para o layout global inicial e um especialista de baixo ruído para as fases finais detalhadas. Essa combinação gera composições limpas, texturas nítidas e coerência temporal estável que parecem realistas na tela. Os rótulos estéticos curados permitem estilos visuais precisos e controlados, abrangendo iluminação, correção de cor e enquadramento.
8. Mochi 1
genmo/mochi-1 é um modelo aberto e avançado de geração de vídeo que apresenta movimento de alta fidelidade e forte aderência aos prompts nas avaliações iniciais, reduzindo significativamente a distância entre sistemas fechados e abertos.
O Mochi 1 se destaca em converter prompts em linguagem natural em movimento coerente e cinematográfico, capturando com eficácia a intenção do usuário. Os vídeos resultantes são polidos, intencionais e fiéis às descrições fornecidas. Ao reduzir a lacuna de qualidade frente aos principais modelos fechados e permanecer totalmente aberto e licenciado sob Apache, o Mochi 1 permite que pesquisadores, criadores e desenvolvedores experimentem, ajustem e integrem tecnologia de texto‑para‑vídeo de ponta em projetos reais sem grandes restrições ou barreiras de custo.
9. LTX-Video
LTX-Video é o sistema de geração de vídeo treinado por difusão (DiT) da Lightricks, conhecido por entregar vídeos de alta qualidade em tempo real. Ele produz 30 quadros por segundo (FPS) na resolução de 1216×704, mais rápido que a velocidade de reprodução. Treinado em um conjunto amplo e diverso de vídeos, o LTX‑Video foca em converter imagens em vídeos com condicionamento opcional usando imagens e clipes curtos.
Ele oferece uma variedade de modelos para equilibrar qualidade e custo: um modelo com 13 bilhões de parâmetros para máxima fidelidade, variantes destiladas e em FP8 para menor uso de VRAM e processamento mais rápido, e uma opção com 2 bilhões de parâmetros para implantações leves. O resultado é um sistema prático e amigável para criadores, que combina velocidade com visuais realistas e de alta resolução.
O LTX‑Video transforma imagens estáticas em movimento suave e coerente a 30 FPS, com texturas nítidas, sujeitos estáveis e dinâmicas de câmera críveis, fazendo os resultados parecerem filmados de propósito, não sintetizados. Sua arquitetura DiT e o treinamento abrangente contribuem para consistência temporal e conteúdo variado e realista, enquanto prompts detalhados em inglês oferecem a você controle estilístico preciso.
10. Marey
Marey é o modelo de vídeo com IA da Moonvalley, criado para atender aos padrões da cinematografia de classe mundial. Ele é pensado para cineastas que exigem precisão em cada quadro, com ênfase em controle, consistência e fidelidade. Assim, sua visão criativa é realizada fielmente do conceito ao corte final. Do desenvolvimento do look à edição, o Marey se integra sem atritos a fluxos de trabalho profissionais e entrega imagens de alta qualidade que resistem ao escrutínio.
O Marey transforma direções detalhadas em sequências precisas e prontas para produção, garantindo sujeitos estáveis, iluminação consistente e movimento suave para uma qualidade cinematográfica. Ao enfatizar o controle em nível de quadro e a consistência temporal, ele ajuda a manter o tom, o estilo e o ritmo entre diferentes tomadas. Isso permite que criadores produzam trailers, cenas e campanhas com confiança.
Conclusão
Os modelos de geração de vídeo estão avançando rapidamente, e criadores na publicidade, no e-commerce, no marketing, no cinema, no YouTube e em narrativas de curta duração já estão colocando-os em prática. Os benefícios são grandes: iteração mais rápida, qualidade cinematográfica e novas possibilidades criativas que antes eram inalcançáveis. No entanto, o realismo que esses sistemas atingem também traz riscos reais, como anúncios enganosos, golpes com produtos e deepfakes altamente convincentes de figuras públicas.
À medida que adotamos essas ferramentas, é essencial unir inovação e responsabilidade. Isso significa ser transparente sobre o uso de IA, verificar fontes e seguir diretrizes éticas e legais claras.
Neste blog, exploramos dez modelos líderes que convertem textos e imagens em filmagens altamente realistas, acompanhados de demos no YouTube para mostrar os pontos fortes de cada um. Também destaquei opções open source que você pode rodar localmente, excelentes para aprender, experimentar e ajustar os resultados ao seu branding ou à sua história.
Sou um cientista de dados certificado que gosta de criar aplicativos de aprendizado de máquina e escrever blogs sobre ciência de dados. No momento, estou me concentrando na criação e edição de conteúdo e no trabalho com modelos de linguagem de grande porte.