
मुख्य सामग्री पर जाएं

2026 के शीर्ष 10 वीडियो जेनरेशन मॉडल

ओपन-सोर्स और स्वामित्व वाले शीर्ष-रेटेड वीडियो जेनरेशन मॉडल जो सिनेमा, विज्ञापन और कंटेंट क्रिएशन में रचनात्मकता की परिभाषा बदल रहे हैं।
अपडेट किया गया 25 सित॰ 2026  · 9 मि॰ पढ़ें

AI के साथ खोजें

ChatGPTClaudePerplexity

मेरा परिचय वीडियो जेनरेशन मॉडलों से तब हुआ जब OpenAI ने Sora का पहला संस्करण लॉन्च किया। उसी क्षण से, मैंने कई उच्च-स्तरीय वीडियो जेनरेशन मॉडल देखना शुरू किया। इसने मुझे उपलब्ध बेहतरीन मॉडलों की सूची तैयार करने के लिए प्रेरित किया। रैंकिंग मेरे निजी अनुभव, Artificial Analysis वीडियो जेनरेशन लीडरबोर्ड और समग्र उपयोगकर्ता फीडबैक पर आधारित है।

वीडियो जेनरेशन, इमेज जेनरेशन जैसा ही है, लेकिन एक अतिरिक्त बाधा के साथ: समय। हर फ्रेम को पूर्ववर्ती फ्रेम्स के अनुरूप रहना चाहिए—चरित्र की पहचान, लाइटिंग, कैमरा मोशन और सीन लेआउट को बनाए रखते हुए—ताकि टेम्पोरल कोहेरेंस बनी रहे। 

आधुनिक सिस्टम टेक्स्ट-टू-वीडियो से आगे बढ़ चुके हैं: आप एक अकेली इमेज को अपनी शैली में एनिमेट कर सकते हैं, शॉट्स को जोड़कर लंबी सीक्वेंस बना सकते हैं, और प्रॉम्प्ट से सिंक्रोनाइज़्ड ऑडियो (म्यूज़िक, SFX, डायलॉग) भी जेनरेट कर सकते हैं, जिससे एंड-टू-एंड सिनेमैटिक क्लिप्स तैयार होते हैं।

इस ब्लॉग में, हम कुछ शीर्ष-रेटेड वीडियो जेनरेशन मॉडलों को देखेंगे जो मार्केटिंग, सिनेमा, विज्ञापन और कंटेंट क्रिएशन की दुनिया को बदल रहे हैं और विभिन्न उद्योगों में नई रचनात्मक संभावनाएं खोल रहे हैं।
लेखक द्वारा छवि | Canva + Google Nano Banana

वीडियो जेनरेशन मॉडल क्या हैं?

वीडियो जेनरेशन मॉडल ऐसे एआई सिस्टम हैं जो टेक्स्ट, इमेज या मौजूदा वीडियो जैसे इनपुट से मूविंग इमेजेज बनाते हैं। वे टेक्स्ट-टू-इमेज विधियों पर समय के तत्व को जोड़कर आधारित होते हैं। यथार्थता और प्रॉम्प्ट के पालन के साथ-साथ, इन मॉडलों को स्मूद मोशन, सब्जेक्ट्स की निरंतरता और फ्रेम-टू-फ्रेम कोहेरेंस भी बनाए रखना होता है। 
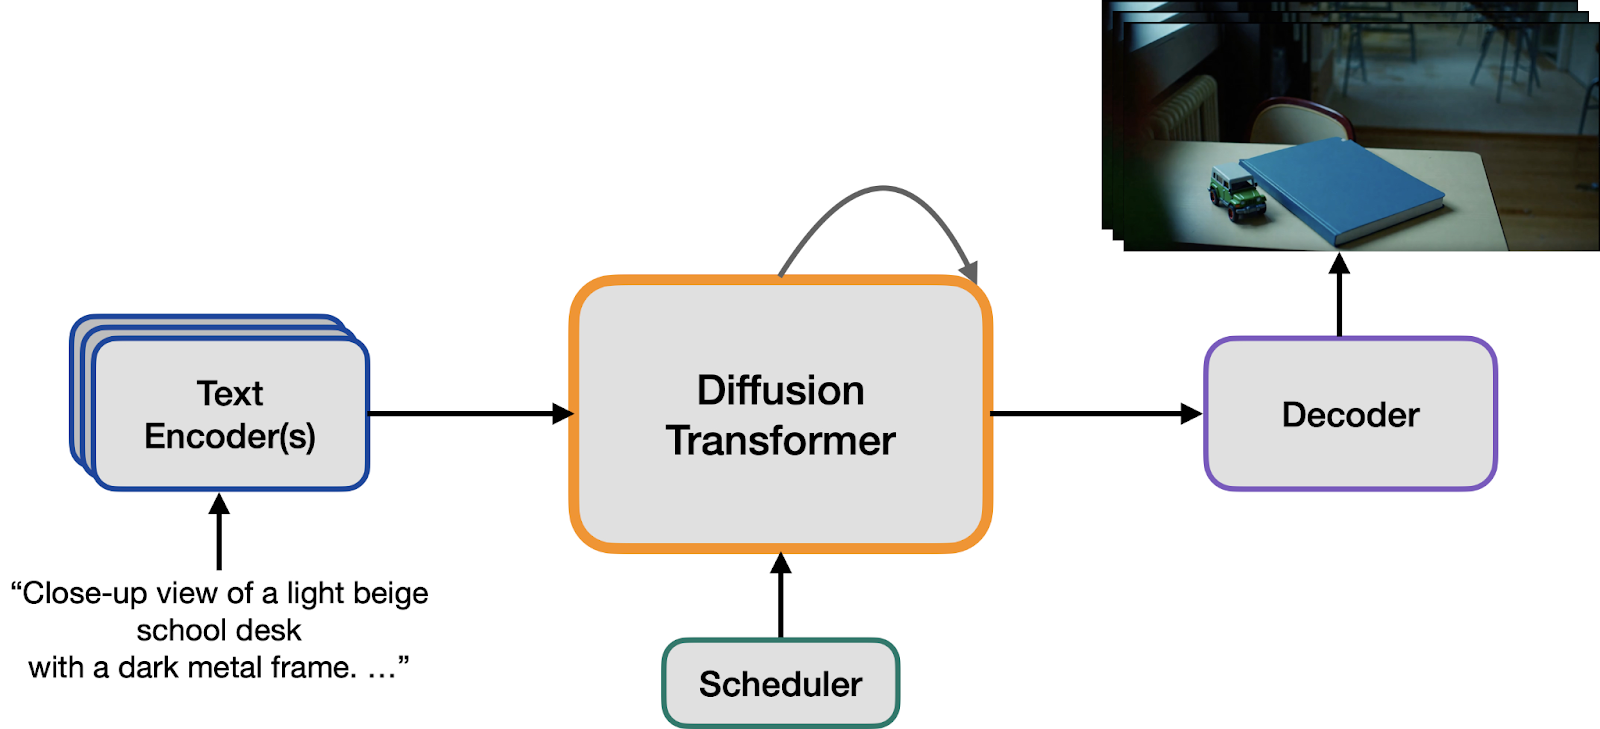
text-to-video diagram of video diffusion model

छवि स्रोत: Diffusers में ओपन वीडियो जेनरेशन मॉडलों की स्थिति

एक वीडियो जेनरेशन मॉडल, टेक्स्ट एन्कोडर का उपयोग करके टेक्स्ट प्रॉम्प्ट को एक संरचित रिप्रेजेंटेशन में बदलता है, फिर रैंडम नॉइज़ से शुरू करके डीनॉइज़िंग नेटवर्क के जरिए चरणबद्ध रूप से उसे परिष्कृत करता है। एक शेड्यूलर इस प्रक्रिया का मार्गदर्शन करता है, जबकि एन्कोडर और डिकोडर दक्षता के लिए पिक्सल स्पेस और कंप्रेस्ड लैटेंट स्पेस के बीच आगे-पीछे जाते हैं। इमेज मॉडलों के विपरीत, वीडियो मॉडल 3D टोकन प्रोसेस करते हैं जो स्पैटियल डीटेल और टेम्पोरल मोशन दोनों को कैप्चर करते हैं। चूंकि डिकोडिंग में बहुत मेमोरी लगती है, कई पाइपलाइनें जेनरेशन को अधिक कुशल बनाने के लिए फ्रेम-बाय-फ्रेम डिकोडिंग का उपयोग करती हैं।

1. Veo 3

Veo 3 Google का अत्याधुनिक वीडियो जेनरेशन मॉडल है, जो 720p या 1080p (16:9) पर 8-सेकंड के हाई-फिडेलिटी क्लिप्स 24fps पर नेटिव, हमेशा‑ऑन ऑडियो के साथ बनाता है। Gemini API के जरिए उपलब्ध, यह डायलॉग-ड्रिवन सीन, सिनेमैटिक रियलिज़्म और क्रिएटिव एनीमेशन में उत्कृष्ट है, और आपके प्रॉम्प्ट से सीधे उद्धृत संवाद, स्पष्ट साउंड इफेक्ट्स और एंबियंट साउंडस्केप्स को कैप्चर करता है।

Veo 3 टेक्स्ट प्रॉम्प्ट्स को सिनेमैटिक शॉट्स में बदलता है, जिसमें कोहेरेंट लाइटिंग, डेप्थ-ऑफ-फील्ड और फिल्मिक कलर होते हैं, जबकि फ्रेम-टू-फ्रेम टेम्पोरल कंसिस्टेंसी बनी रहती है। यह नैटिव रूप से सिंक्रोनाइज़्ड डायलॉग, SFX और एंबियंस रेंडर करता है, जिससे लिप-अवेयर स्पीच, सीन‑मैच्ड एकॉस्टिक्स और टाइमिंग‑एक्युरेट क्यूज़ संभव होते हैं जो यथार्थता को और ऊंचा उठाते हैं।

2. Sora 2

Sora 2 एक बहुमुखी टेक्स्ट-टू-वीडियो सिस्टम है जो अब विज़ुअल्स के साथ सिंक्रोनाइज़्ड ऑडियो—डायलॉग, एंबियंट साउंड्स और साउंड इफेक्ट्स सहित—एक ही पास में जेनरेट करता है। यह प्रगति पिछले वर्कफ्लोज़ की एक बड़ी कमी को दूर करती है और मल्टी‑शॉट स्टोरीटेलिंग को अधिक सुसंगत बनाती है।

ऑडियो के अलावा, मॉडल और अधिक यथार्थपरक सीन बनाने, भौतिक विश्वसनीयता (जैसे वजन, संतुलन, ऑब्जेक्ट पर्मनेंस और कारण‑और‑प्रभाव संबंध) में सुधार, और कई शॉट्स में कंटिन्युटी बढ़ाने (सुसंगत चरित्र, लाइटिंग और समग्र वर्ल्ड स्टेट सुनिश्चित करने) पर ध्यान केंद्रित करता है। यह फोटोरियलिस्टिक, सिनेमैटिक और एनीमेटेड एस्थेटिक्स को समायोजित करते हुए लचीले शैली विकल्प भी प्रदान करता है।

इसके अलावा, Sora 2 असफलताओं का सिमुलेशन करने की परिष्कृत क्षमता प्रस्तुत करता है—जैसे जंप मिस होना या फिसलना—जो प्रीविज़ुअलाइज़ेशन और सेफ्टी-संबंधित कॉन्सेप्ट्स के लिए उपयोगी है। 

3. PixVerse V5

PixVerse V5 V4.5 पर एक बड़ा अपग्रेड है, जो तेज़ टेक्स्ट‑टू‑वीडियो और इमेज‑टू‑वीडियो जेनरेशन को और अधिक शार्प तथा सिनेमैटिक विज़ुअल्स के साथ जोड़ता है। यह स्मूद, अभिव्यंजक मोशन, स्थिर स्टाइल और रंग, और मज़बूत प्रॉम्प्ट पालन देता है ताकि आपका निर्देश स्क्रीन पर साफ़‑सुथरे तरीके से अनुवादित हो।

PixVerse V5 यथार्थवाद पर तीन स्तंभों के माध्यम से केंद्रित है: मोशन, कंसिस्टेंसी और डिटेल। इसके स्मूद कैमरा मूव्स और नैचुरल, वेटी एनीमेशन पहले के संस्करणों में दिखने वाली कठोरता को कम करते हैं, जबकि टेम्पोरल कंसिस्टेंसी स्टाइल, रंग और सब्जेक्ट्स को फ्रेम्स में कोहेरेंट रखती है, जिससे एक समेकित, फिल्म‑जैसा फ्लो बनता है। नतीजा है क्रिस्प, सिनेमैटिक इमेजरी जिसे कई क्रिएटर्स “फिल्म‑योग्य” बताते हैं, साथ ही स्टाइल, टोन और सब्जेक्ट के लिए भरोसेमंद प्रॉम्प्ट फॉलोइंग। 

4. Kling 2.5 Turbo

Kling 2.5 Turbo Kling के एआई वीडियो जेनरेशन सूट में नवीनतम अपग्रेड है, जिसे अगले‑स्तर की स्पीड और क्रिएटिव स्वतंत्रता के लिए बनाया गया है। यह टेक्स्ट‑टू‑वीडियो और इमेज‑टू‑वीडियो दोनों को आगे बढ़ाता है—मज़बूत प्रॉम्प्ट पालन, उन्नत कैमरा कंट्रोल और फिजिक्स‑अवेयर रियलिज़्म के साथ—ताकि कम इटरेशन और लैग में आपका निर्देश सिनेमैटिक परिणामों में बदल जाए।

Kling 2.5 Turbo फिल्म-ग्रेड एस्थेटिक्स पर केंद्रित है, जिसमें और अधिक शार्प फ्रेम्स, संतुलित लाइटिंग और रिच कलर डेप्थ शामिल है, जो शुरुआत से ही दृश्यों को उद्देश्यपूर्ण और सिनेमैटिक गुणवत्ता देता है। इसके बेहतर प्रॉम्प्ट पालन और कैमरा कंट्रोल विस्तृत स्क्रिप्ट्स को सटीक विज़ुअल्स में अनुवादित करते हैं, पैन, ज़ूम और ट्रांज़िशन्स को प्रोफेशनल अंदाज में स्मूदली निष्पादित करते हुए।

फिजिक्स‑अवेयर मोशन के कारण यथार्थवाद बढ़ता है, जिसमें ग्रैविटी और इम्पैक्ट्स जैसे तत्वों के साथ द्रव‑समान गतियां शामिल हैं। इसे और अधिक जीवंत कैरेक्टर एक्सप्रेशन्स द्वारा पूरक किया गया है, जिससे एक्शन और परफॉर्मेंसेज़ स्क्रीन पर विश्वसनीय दिखाई देते हैं।

5. Hailuo 02

 MiniMax Hailuo 02 एक नेक्स्ट‑जेनरेशन वीडियो जेनरेशन मॉडल है, जिसे नेटिव 1080p आउटपुट के लिए डिज़ाइन किया गया है। इसमें अत्याधुनिक इंस्ट्रक्शन फॉलोइंग और फिजिक्स में असाधारण दक्षता है। Noise‑Aware Compute Redistribution (NCR) नामक नई आर्किटेक्चर द्वारा संचालित, यह समान पैरामीटर स्केल पर लगभग 2.5 गुना दक्षता प्राप्त करता है।

यह प्रगति, पिछले संस्करण की तुलना में तीन गुना बड़े मॉडल और चार गुना अधिक डेटा पर प्रशिक्षण की अनुमति देती है—वो भी क्रिएटर लागत बदले बिना। नतीजा है तेज़, अधिक सक्षम सिस्टम जो जटिल प्रॉम्प्ट्स को सटीक रूप से समझता है और उच्च-फिडेलिटी मोशन जेनरेट करता है

Hailuo 02, यथार्थवादी फिजिक्स और सटीक नियंत्रण वाली सीन बनाने में उत्कृष्ट है। उदाहरण के लिए, यह जिम्नास्टिक्स-स्तरीय कोरियोग्राफी को संभाल सकता है, जहां बॉडी मूवमेंट्स, वेट डिस्ट्रीब्यूशन और टाइमिंग सभी प्रामाणिक महसूस होने चाहिए। इसके उन्नत ट्रेनिंग स्केल और NCR दक्षता का परिणाम है और भी स्पष्ट फ्रेम्स, स्थिर टेम्पोरल कंसिस्टेंसी, और प्रॉम्प्ट्स के पालन में उच्च सटीकता—यह सुनिश्चित करते हुए कि जटिल निर्देश न्यूनतम ड्रिफ्ट के साथ स्क्रीन पर निष्पादित हों।

6. Seedance 1.0

Seedance 1.0 ByteDance का नवीनतम उच्च-गुणवत्ता वाला वीडियो जेनरेशन मॉडल है, जिसे स्मूद और स्थिर मोशन के साथ नेटिव मल्टी‑शॉट स्टोरीटेलिंग को शामिल करने के लिए डिज़ाइन किया गया है। यह टेक्स्ट‑टू‑वीडियो (T2V) और इमेज‑टू‑वीडियो (I2V) दोनों वर्कफ्लो को प्रभावी ढंग से संभालता है।

इस मॉडल में वाइड डायनमिक रेंज है, जो बड़े पैमाने की फ्लुइड मूवमेंट्स को स्थिरता और भौतिक यथार्थवाद बनाए रखते हुए संभव बनाता है। यह सूक्ष्म अभिव्यक्तियों से लेकर अत्यधिक सक्रिय दृश्यों तक सब कुछ कैप्चर कर सकता है।

मोशन क्षमताओं के अतिरिक्त, Seedance 1.0 मल्टी‑शॉट नैरेटिव वीडियो बनाने का समर्थन करता है, शॉट ट्रांज़िशन और स्पेस‑टाइम में बदलाव के दौरान मुख्य सब्जेक्ट, शैली और समग्र माहौल में कंसिस्टेंसी सुनिश्चित करता है। यह कंसिस्टेंसी सुसंगत स्टोरीटेलिंग और कुशल प्रोडक्शन वर्कफ्लोज़ के लिए आवश्यक है।

Seedance 1.0 विविध शैलीगत अभिव्यक्ति और सटीक नियंत्रण भी प्रदान करता है। यह मल्टी‑एजेंट इंटरेक्शंस, जटिल एक्शन सीक्वेंसेज़ और डायनेमिक कैमरा मूवमेंट्स को संभाल सकता है, जबकि विस्तृत प्रॉम्प्ट्स का सटीकता से पालन करता है। इससे टेक्स्ट का सिनेमैटिक वीडियो में विश्वसनीय अनुवाद संभव होता है। साथ ही, यह 1080p सहित हाई‑डेफिनिशन आउटपुट का समर्थन करता है, जो स्मूद मोशन और मजबूत विज़ुअल डिटेल सुनिश्चित करता है—T2V और I2V दोनों कार्यों में एक परिष्कृत, फिल्म‑जैसा लुक देने के लिए।

7. Wan2.2

Wan-AI/Wan2.2 एक ओपन‑सोर्स और उन्नत बड़े‑पैमाने का वीडियो जनरेटिव मॉडल है। Wan 2.1 पर आधारित, इसमें Mixture‑of‑Experts (MoE) डिफ्यूज़न आर्किटेक्चर है जो डीनॉइज़िंग टाइमस्टेप्स में विशेषज्ञों को कुशलतापूर्वक रूट करता है, जिससे कम्प्यूटेशनल डिमांड बढ़ाए बिना क्षमता का विस्तार संभव होता है।

सबसे अच्छी बात यह है कि यह पूरी तरह ओपन है—Wan‑AI टीम ने व्यावहारिक उपयोग के लिए कोड और वेट्स जारी किए हैं, जिनमें 5B हाइब्रिड TI2V मॉडल शामिल है, जो हाई‑कंप्रेशन VAE (16×16×4) के साथ 24fps पर 720p का समर्थन करता है—टेक्स्ट‑टू‑वीडियो और इमेज‑टू‑वीडियो दोनों टास्क्स के लिए—कंज्यूमर GPUs (जैसे 4090) पर। 480p और 720p आउटपुट के लिए A14B T2V/I2V मॉडल भी उपलब्ध हैं।

Wan2.2 सिनेमैटिक कंट्रोल और जटिल, विश्वसनीय मोशन के साथ वीडियो बनाता है। MoE डिज़ाइन, शुरुआती ग्लोबल लेआउट के लिए हाई‑नॉइज़ एक्सपर्ट और अंतिम विस्तृत चरणों के लिए लो‑नॉइज़ एक्सपर्ट आवंटित करता है। यह संयोजन साफ़ कंपोज़िशन, क्रिस्प टेक्सचर्स और स्थिर टेम्पोरल कोहेरेंस देता है जो स्क्रीन पर वास्तविक लगते हैं। क्यूरेटेड एस्थेटिक लेबल्स, लाइटिंग, कलर ग्रेडिंग और फ्रेमिंग सहित सटीक और नियंत्रित विज़ुअल स्टाइल्स सक्षम करते हैं। 

8. Mochi 1

genmo/mochi-1 एक उन्नत, ओपन‑सोर्स वीडियो जेनरेशन मॉडल है, जो शुरुआती आकलनों में हाई‑फिडेलिटी मोशन और प्रॉम्प्ट्स के प्रति मजबूत पालन दिखाता है, जिससे क्लोज़्ड और ओपन सिस्टम्स के बीच का अंतर काफी कम हो जाता है।

Mochi 1 प्राकृतिक भाषा प्रॉम्प्ट्स को कोहेरेंट, सिनेमैटिक मोशन में बदलने में उत्कृष्ट है और उपयोगकर्ता के इरादे को प्रभावी ढंग से कैप्चर करता है। परिणामी वीडियो पॉलिश्ड, उद्देश्यपूर्ण और दी गई विवरणों के प्रति सच्चे होते हैं। अग्रणी क्लोज़्ड मॉडलों के साथ गुणवत्ता के अंतर को पाटते हुए भी पूरी तरह ओपन और Apache‑लाइसेंस्ड रहते हुए, Mochi 1 शोधकर्ताओं, क्रिएटर्स और डेवलपर्स को बिना भारी प्रतिबंधों या लागत बाधाओं के अत्याधुनिक टेक्स्ट‑टू‑वीडियो तकनीक पर प्रयोग, फाइन‑ट्यून और वास्तविक प्रोजेक्ट्स में एकीकरण करने में सक्षम बनाता है।

9. LTX-Video

LTX-Video Lightricks का डिफ्यूज़न‑ट्रेंड (DiT) वीडियो जेनरेशन सिस्टम है, जो रियल टाइम में उच्च‑गुणवत्ता वाले वीडियो देने के लिए जाना जाता है। यह 1216×704 रेज़ोल्यूशन पर 30 फ्रेम प्रति सेकंड (FPS) बनाता है, जो प्लेबैक स्पीड से तेज़ है। बड़े और विविध वीडियो डेटासेट पर प्रशिक्षित, LTX‑Video वैकल्पिक रूप से इमेज और शॉर्ट क्लिप्स के कंडिशनिंग के साथ इमेजेज को वीडियो में बदलने पर केंद्रित है। 

यह गुणवत्ता और लागत के बीच संतुलन के लिए विभिन्न मॉडल प्रदान करता है: सर्वोच्च फिडेलिटी के लिए 13 बिलियन‑पैरामीटर मॉडल, कम VRAM उपयोग और तेज़ प्रोसेसिंग के लिए डिस्टिल्ड और FP8 वेरिएंट, और हल्की डिप्लॉयमेंट्स के लिए 2 बिलियन‑पैरामीटर विकल्प। नतीजा है एक व्यावहारिक, क्रिएटर‑फ्रेंडली सिस्टम जो स्पीड को यथार्थवादी, हाई‑रेज़ोल्यूशन विज़ुअल्स के साथ जोड़ता है।

LTX‑Video स्थिर इमेजेज को 30 FPS पर स्मूद, कोहेरेंट मोशन में बदलता है—क्रिस्प टेक्सचर्स, स्थिर सब्जेक्ट्स और विश्वसनीय कैमरा डायनेमिक्स के साथ—जिससे परिणाम सिंथेटिक के बजाय इरादतन फिल्माए गए महसूस होते हैं। इसकी DiT आर्किटेक्चर और व्यापक प्रशिक्षण टेम्पोरल कंसिस्टेंसी और विविध, जीवंत कंटेंट में योगदान करते हैं, जबकि अंग्रेज़ी में डिटेल्ड प्रॉम्प्ट्स आपको सटीक स्टाइलिस्टिक कंट्रोल देते हैं।

10. Marey

Marey Moonvalley का फाउंडेशनल एआई वीडियो मॉडल है, जिसे विश्व‑स्तरीय सिनेमैटोग्राफी के मानकों को पूरा करने के लिए विशेष रूप से डिज़ाइन किया गया है। यह उन फिल्ममेकर्स के लिए अनुकूलित है जिन्हें हर फ्रेम में प्रिसीज़न चाहिए—कंट्रोल, कंसिस्टेंसी और फिडेलिटी पर जोर देते हुए—ताकि आपकी रचनात्मक दृष्टि कॉन्सेप्ट से फाइनल कट तक ईमानदारी से साकार हो। लुक डेवलपमेंट से लेकर एडिटिंग तक, Marey प्रोफेशनल वर्कफ्लोज़ में सहजता से एकीकृत होता है और उच्च‑गुणवत्ता की इमेजेज देता है जो करीबी निरीक्षण पर भी खरी उतरती हैं।

Marey विस्तृत निर्देशों को सटीक, प्रोडक्शन‑रेडी सीक्वेंसेज़ में बदल देता है—स्थिर सब्जेक्ट्स, सुसंगत लाइटिंग और स्मूद मोशन सुनिश्चित करते हुए—जिससे सिनेमैटिक गुणवत्ता मिलती है। फ्रेम‑लेवल कंट्रोल और टेम्पोरल कंसिस्टेंसी पर जोर देकर, यह अलग‑अलग शॉट्स में टोन, शैली और पेसिंग बनाए रखने में मदद करता है। इससे क्रिएटर्स आत्मविश्वास के साथ ट्रेलर्स, सीन और कैंपेन तैयार कर पाते हैं।

निष्कर्ष

वीडियो जेनरेशन मॉडल तेज़ी से आगे बढ़ रहे हैं, और विज्ञापन, ई‑कॉमर्स, मार्केटिंग, सिनेमा, YouTube और शॉर्ट‑फॉर्म स्टोरीटेलिंग के क्रिएटर्स पहले से ही उनका उपयोग कर रहे हैं। फायदे उल्लेखनीय हैं: तेज़ इटरेशन, सिनेमैटिक गुणवत्ता, और नई रचनात्मक संभावनाएं जो पहले पहुंच से बाहर थीं। हालांकि, इन सिस्टम्स द्वारा हासिल किया गया यथार्थवाद वास्तविक जोखिम भी लाता है—जैसे भ्रामक विज्ञापन, प्रोडक्ट स्कैम, और सार्वजनिक हस्तियों के अत्यंत प्रभावशाली डीपफेक्स। 

जैसे‑जैसे हम इन टूल्स को अपनाते हैं, नवाचार के साथ जिम्मेदारी को जोड़ना आवश्यक है। इसका मतलब है एआई के उपयोग के बारे में पारदर्शिता, स्रोतों का सत्यापन, और स्पष्ट नैतिक तथा कानूनी दिशानिर्देशों का पालन। 

इस ब्लॉग में, हमने दस अग्रणी वीडियो मॉडलों का अन्वेषण किया जो टेक्स्ट और इमेजेज को अत्यंत यथार्थपरक फुटेज में बदलते हैं, प्रत्येक मॉडल की ताकत दिखाने के लिए YouTube डेमो के साथ। मैंने ऐसे ओपन‑सोर्स विकल्प भी रेखांकित किए हैं जिन्हें आप लोकली चला सकते हैं—जो सीखने, प्रयोग करने और अपने ब्रांड या कहानी के अनुसार परिणामों को फाइन‑ट्यून करने के लिए उत्कृष्ट हैं।


Abid Ali Awan's photo
Author
Abid Ali Awan
LinkedIn
Twitter

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।

विषय
कृत्रिम बुद्धिमत्ता

शीर्ष DataCamp पाठ्यक्रम

लर्निंग पाथ

एआई मूलभूत बातें

10 घंटा
AI की मूल बातें जानें, काम के लिए AI का प्रभावी उपयोग करना सीखें, और ChatGPT जैसे मॉडल्स में गहराई से उतरकर गतिशील AI परिदृश्य को समझें।
विवरण देखेंRight Arrow
पाठ्यक्रम शुरू करें
और देखेंRight Arrow